Catatan pengantar untuk IF4031 - Pengembangan Aplikasi Terdistribusi, membahas konsep dasar aplikasi terdistribusi: keterbatasan sumberdaya, hal-hal yang harus diperhatikan saat mendesain (komunikasi, koordinasi, skalabilitas, resiliensi, operasional), anatomi sistem terdistribusi, jenis-jenis aplikasi terdistribusi, hingga load balancer. Materi ini relevan sebagai fondasi untuk memahami komunikasi & arsitektur proses (I/O, RPC, serialization) dan untuk memahami reliabilitas, konsistensi, skalabilitas sistem terdistribusi di pertemuan-pertemuan berikutnya.
Pengertian Aplikasi Terdistribusi
Aplikasi terdistribusi didefinisikan sebagai aplikasi yang:
- Terdiri atas multiple proses, yang berjalan pada satu atau lebih komputer/node.
- Komunikasi antar prosesnya dilakukan di atas infrastruktur tertentu, misalnya Socket/TCP/UDP, HTTP, WebSocket, dsb.
- Bisa berjalan pada lingkungan yang heterogen — mobile, Linux, Windows, Internet, LAN, dsb.
- Dikembangkan dengan bahasa/teknologi yang berbeda-beda, misalnya kombinasi Python, C, dan Javascript dalam satu sistem.
Poin heterogenitas ini penting: aplikasi terdistribusi tidak mengasumsikan semua bagian sistem “seragam”. Justru karena komponennya bisa berbeda platform dan bahasa, dibutuhkan mekanisme komunikasi dan format data yang disepakati bersama (lihat bagian serialization di bawah).
Karakteristik Sumberdaya Komputasi
Setiap node/server memiliki keterbatasan sumberdaya maksimum yang bisa disediakan:
- CPU/processing power — terbatas jumlah instruksi yang bisa diproses per satuan waktu.
- Memory — kapasitas data yang bisa diakses cepat (RAM) terbatas.
- Storage — contoh: SSD hanya mampu menangani sekitar 3.000-100.000 IOPS (I/O Operations Per Second).
- Network — bandwidth membatasi jumlah request yang bisa ditangani. Contoh perhitungan dari slide: jika setiap request memerlukan 1 KB traffic, maka bandwidth 1 Gbps secara teoritis hanya mampu menangani maksimal 1.000.000/8 = 125.000 request/detik. Namun dengan adanya overhead protokol dan software, angka riilnya akan jauh lebih kecil dari itu.
Konsekuensi ketika beban melebihi kapasitas: akan terjadi antrian (queue).
- Jika volume request lebih besar dari kapasitas I/O, terjadi antrian I/O.
- Jika jumlah request konkuren lebih besar dari jumlah worker/thread yang tersedia, terjadi antrian pemrosesan request.
Antrian ini mengakibatkan waktu pemrosesan (latency) bertambah lama, dan pada akhirnya menurunkan throughput sistem secara keseluruhan. Ini adalah alasan mendasar mengapa desain arsitektur terdistribusi (load balancing, scaling, dsb.) menjadi penting — bukan sekadar soal “menambah server”, tapi soal mengelola antrian dan keterbatasan sumberdaya secara sistematis.
Hal yang Perlu Diperhatikan dalam Aplikasi Terdistribusi
Slide merangkum lima aspek utama yang harus diperhatikan ketika mendesain aplikasi terdistribusi:
| Aspek | Fokus Perhatian |
|---|---|
| Komunikasi | Mekanisme pengiriman data antar node |
| Koordinasi | Penanganan siapa melakukan apa, dan bagaimana jika ada node yang gagal |
| Skalabilitas | Efisiensi dalam menangani beban — throughput dan latency/response time |
| Resiliensi | Kemampuan sistem tetap beroperasi meskipun terjadi kegagalan |
| Operations | Proses pengelolaan sistem: mulai dari development, testing, deployment, hingga maintain |
Komunikasi
Karena sistem terdistribusi berarti ada kebutuhan komunikasi antar proses yang berjalan pada node yang sama atau berbeda, muncul beberapa problem mendasar:
- Reliability: apa yang terjadi jika jaringan putus, paket hilang di jalan, atau sender/receiver crash saat komunikasi berlangsung?
- Keamanan: bagaimana supaya data aman dan tidak dibaca pihak lain saat transit di jaringan?
- Isu komunikasi di Internet: domain resolution — perubahan DNS bisa menyebabkan DNS stale (cache DNS lama belum ter-update) dan ada DNS update propagation time (waktu tunda sebelum perubahan DNS tersebar merata).
Untuk mengatasi problem-problem ini, network library, protocol, dan framework seharusnya bisa menjamin (menyediakan abstraksi atas) hal-hal tersebut:
- TCP: memberikan abstraksi reliable communication (data tidak hilang, urutan pengiriman sesuai).
- HTTP/HTTPS: memberikan abstraksi pola request/reply.
- gRPC: memberikan abstraksi pemanggilan prosedur secara remote (passing parameter dan return value seolah memanggil fungsi lokal).
The Law of Leaky Abstractions
Prinsip penting yang diangkat: “All non-trivial abstractions, to some degree, are leaky.” (Joel Spolsky, joelonsoftware.com)
Artinya, setiap abstraksi (TCP, gRPC, NFS, Object Storage, database query, dll) selalu memiliki peluang kejadian yang tidak menjamin semua abstraksi yang seharusnya disediakan. Contoh konkret:
- Koneksi TCP dapat terputus, atau pemanggilan HTTP request dapat gagal, meskipun sender/receiver tidak crash sama sekali.
- Bisa terjadi delay yang berlebihan di luar ekspektasi normal.
Implikasinya: seorang pengembang aplikasi terdistribusi tidak boleh hanya mengandalkan abstraksi secara membabi-buta — perlu memahami stack protocol yang digunakan di baliknya beserta perilakunya, supaya bisa menangani kasus-kasus ketika abstraksi tersebut “bocor” (leaky).
Koordinasi
Koordinasi diperlukan agar masing-masing komponen dalam sistem terdistribusi berfungsi sebagaimana mestinya. Problem utamanya adalah reliability: bagaimana jika terjadi kegagalan di tengah proses koordinasi?
FLP Impossibility: sebuah hasil teoritis penting yang menyatakan bahwa consensus tidak bisa diimplementasikan secara pasti (deterministic) pada sistem asynchronous jika ada kemungkinan satu proses saja gagal. Ini adalah dasar teoritis mengapa membangun algoritma consensus (seperti Paxos, Raft) itu sulit dan selalu melibatkan trade-off tertentu.
Karena itu, perlu ada penanganan khusus untuk kejadian kegagalan pada setiap komponen/interaksi, terutama jika terkait dengan state dari sistem — misalnya integritas data yang bisa rusak jika sebuah operasi gagal di tengah jalan.
Skalabilitas (Scalability)
Kinerja sebuah aplikasi/sistem merepresentasikan seberapa efisien aplikasi/sistem tersebut dapat menangani beban.
Beban (load) adalah sesuatu yang menggunakan sumber daya sistem (CPU, memory, network, I/O), yang bisa diukur dari:
- Jumlah user/request konkuren
- Jumlah request per satuan waktu (throughput)
- Rasio update/write dibanding read
Desain sistem yang baik harus memungkinkan peningkatan skalabilitas, dengan dua pendekatan:
- Scale up: meningkatkan kapasitas dengan hardware yang lebih baik (mesin lebih besar/kuat).
- Scale out: menambah jumlah hardware/komponen (menambah mesin/instance).
Resiliensi (Resiliency)
Resilient system adalah sistem yang tetap berfungsi meskipun terjadi kegagalan, biasanya dicapai lewat redundancy (duplikasi komponen).
Konsep penting lainnya adalah cascading failure: kegagalan pada satu komponen dapat mengakibatkan kegagalan pada komponen lain, sehingga kegagalan “menjalar”. Solusinya adalah fault isolation — mengisolasi dampak kegagalan supaya tidak menyebar.
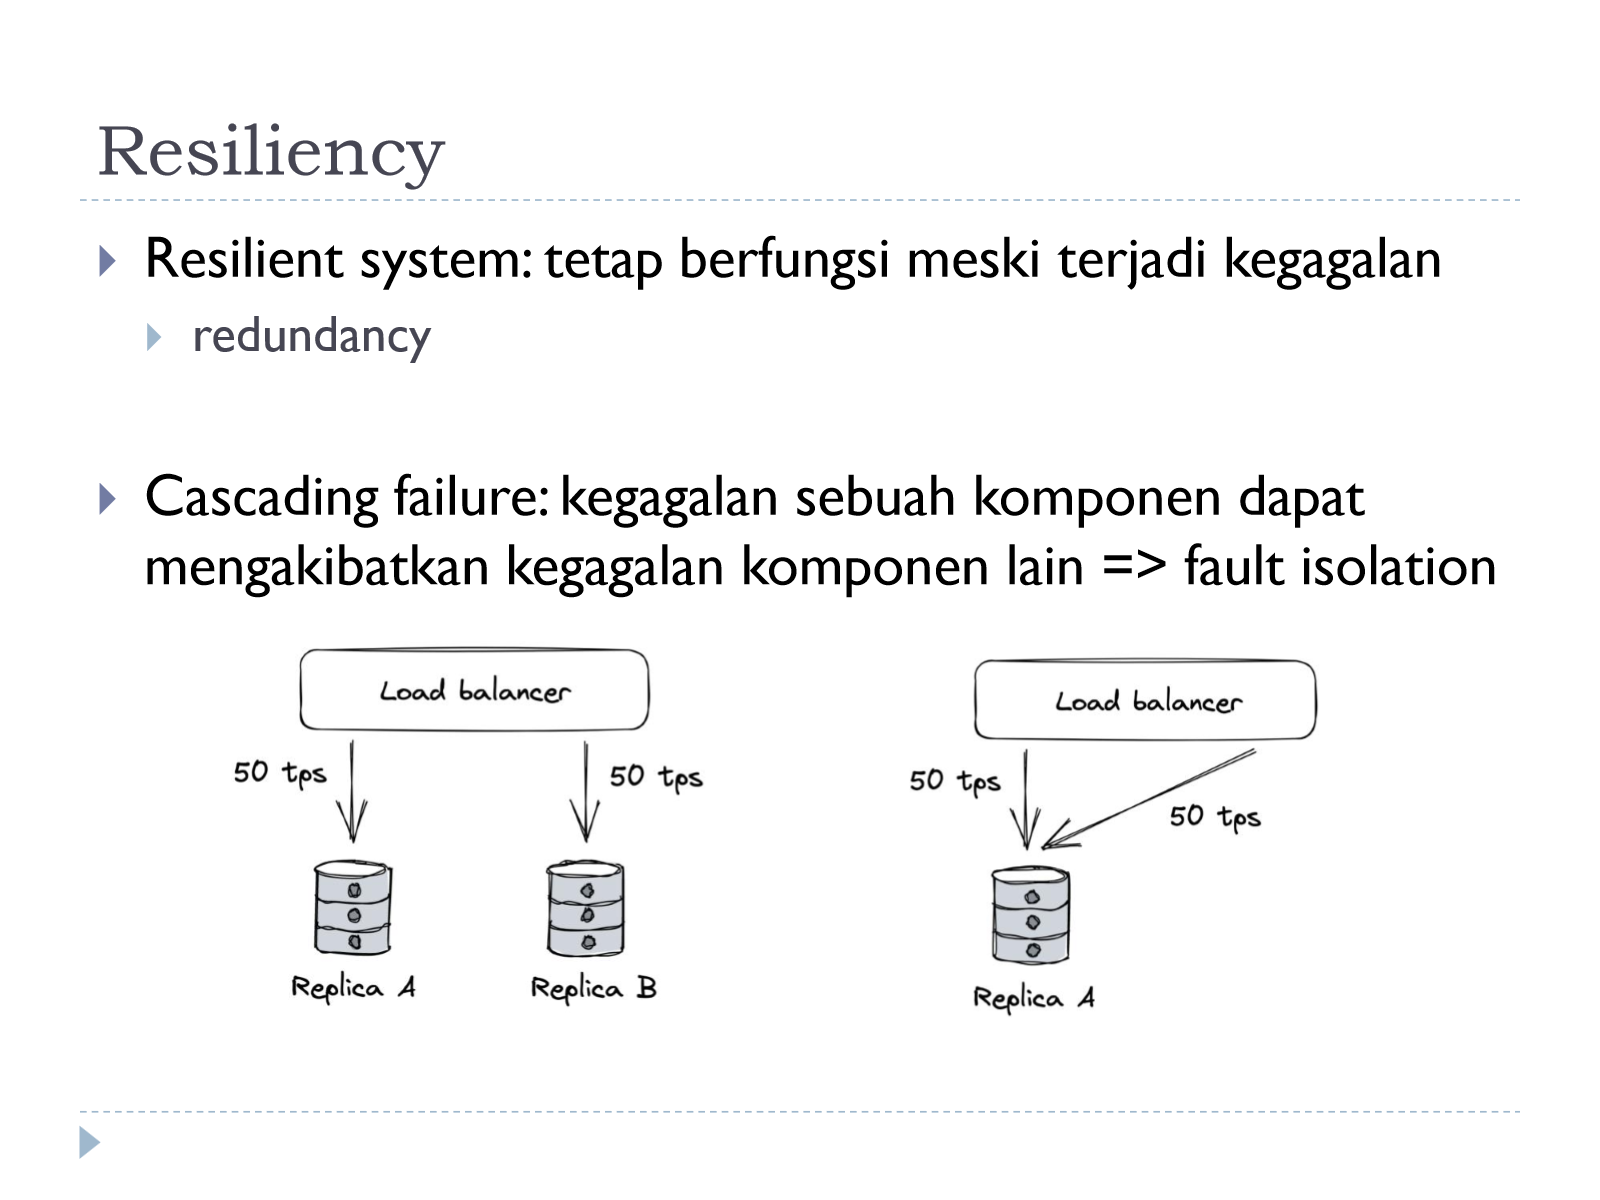
Ilustrasi di atas menunjukkan contoh cascading failure: dua replica database (A dan B) masing-masing menangani 50 tps di belakang sebuah load balancer. Jika Replica B gagal, seluruh 100 tps akan dialihkan ke Replica A — yang mungkin tidak didesain untuk menangani beban dua kali lipat, sehingga Replica A pun berisiko ikut gagal (kegagalan yang menjalar).
Kutipan yang relevan dari Jeff Dean (Google): “Things will crash. Deal with it!” Slide menyertakan data nyata dari pengalaman operasional Google berjudul “The Joys of Real Hardware” tentang apa yang tipikal terjadi di tahun pertama sebuah cluster baru:
- ~0.5 kali overheating (mematikan sebagian besar mesin dalam <5 menit, 1-2 hari untuk pulih)
- ~1 kali PDU (Power Distribution Unit) failure (~500-1000 mesin tiba-tiba hilang, ~6 jam untuk kembali)
- ~1 kali rack-move (~500-1000 mesin dimatikan terjadwal, ~6 jam)
- ~1 kali network rewiring (rolling ~5% mesin down selama rentang 2 hari)
- ~20 kali rack failures (40-80 mesin hilang seketika, 1-6 jam untuk pulih)
- ~5 kali racks go wonky (40-80 mesin mengalami 50% packet loss)
- ~8 kali network maintenance (4 di antaranya bisa menyebabkan ~30 menit koneksi acak terputus)
- ~12 kali router reloads (mengganggu DNS dan external VIP selama beberapa menit)
- ~3 kali router failures (harus segera mengalihkan traffic selama satu jam)
- Puluhan blip DNS minor 30 detik
- ~1000 kegagalan mesin individual
- Ribuan kegagalan hard drive
- Ditambah disk lambat, memory buruk, mesin misconfigured, mesin flaky, dll.
Poin dari data ini: pada skala besar, kegagalan bukan pengecualian, melainkan hal yang pasti terjadi secara rutin — sehingga sistem harus didesain untuk mengasumsikan dan menangani kegagalan sejak awal, bukan diperlakukan sebagai kasus langka.
Common Failures (Kegagalan Umum)
- Process crash: bisa disebabkan hardware failure atau unhandled exception.
- Network delay: variasi delay pada jaringan menyulitkan penentuan nilai timeout yang optimal (terlalu pendek berisiko false positive kegagalan, terlalu panjang memperlambat deteksi kegagalan nyata).
- Unsynchronized clock: perbedaan waktu antara dua atau lebih mesin dapat mengakibatkan error, misalnya pada penentuan urutan kejadian (ordering) atau validasi timestamp.
- DNS problems
- Cache problems
Operations & Maintainability
Biaya terbesar sebuah sistem sebenarnya terjadi setelah fase pengembangan awal selesai, mencakup:
- Bug fixing
- Penambahan fitur
- Penyesuaian flow/fitur
- Operation (operasional harian)
Untuk mendukung maintainability yang baik, dibutuhkan:
- Mekanisme testing berlapis: unit testing, integration testing, end-to-end testing.
- DevOps: praktik yang menyatukan development dan operations.
- System monitoring dan observability: kemampuan memantau kondisi sistem secara real-time untuk mendeteksi masalah sedini mungkin.
Anatomi Sistem Terdistribusi
Sistem terdistribusi bisa dilihat dari tiga sudut pandang:
- Secara fisik: umumnya adalah sekumpulan mesin yang terhubung melalui jaringan.
- Saat run-time: terdiri atas sejumlah proses software yang berkomunikasi melalui mekanisme interprocess communication (IPC), misalnya HTTP.
- Dari perspektif implementasi: terdiri atas sekumpulan loosely-coupled components yang dapat di-deploy dan di-scale secara independen, yang disebut sebagai services.
Service mengimplementasikan bagian tertentu dari keseluruhan kapabilitas sistem. Di dalam sebuah service terdapat business logic, yang menyediakan interface untuk berkomunikasi dengan komponen lain. Interface ini bisa berupa:
- Inbound (misalnya API yang diekspos untuk diakses pihak lain)
- Outbound (API call yang dilakukan oleh service tersebut ke pihak lain)
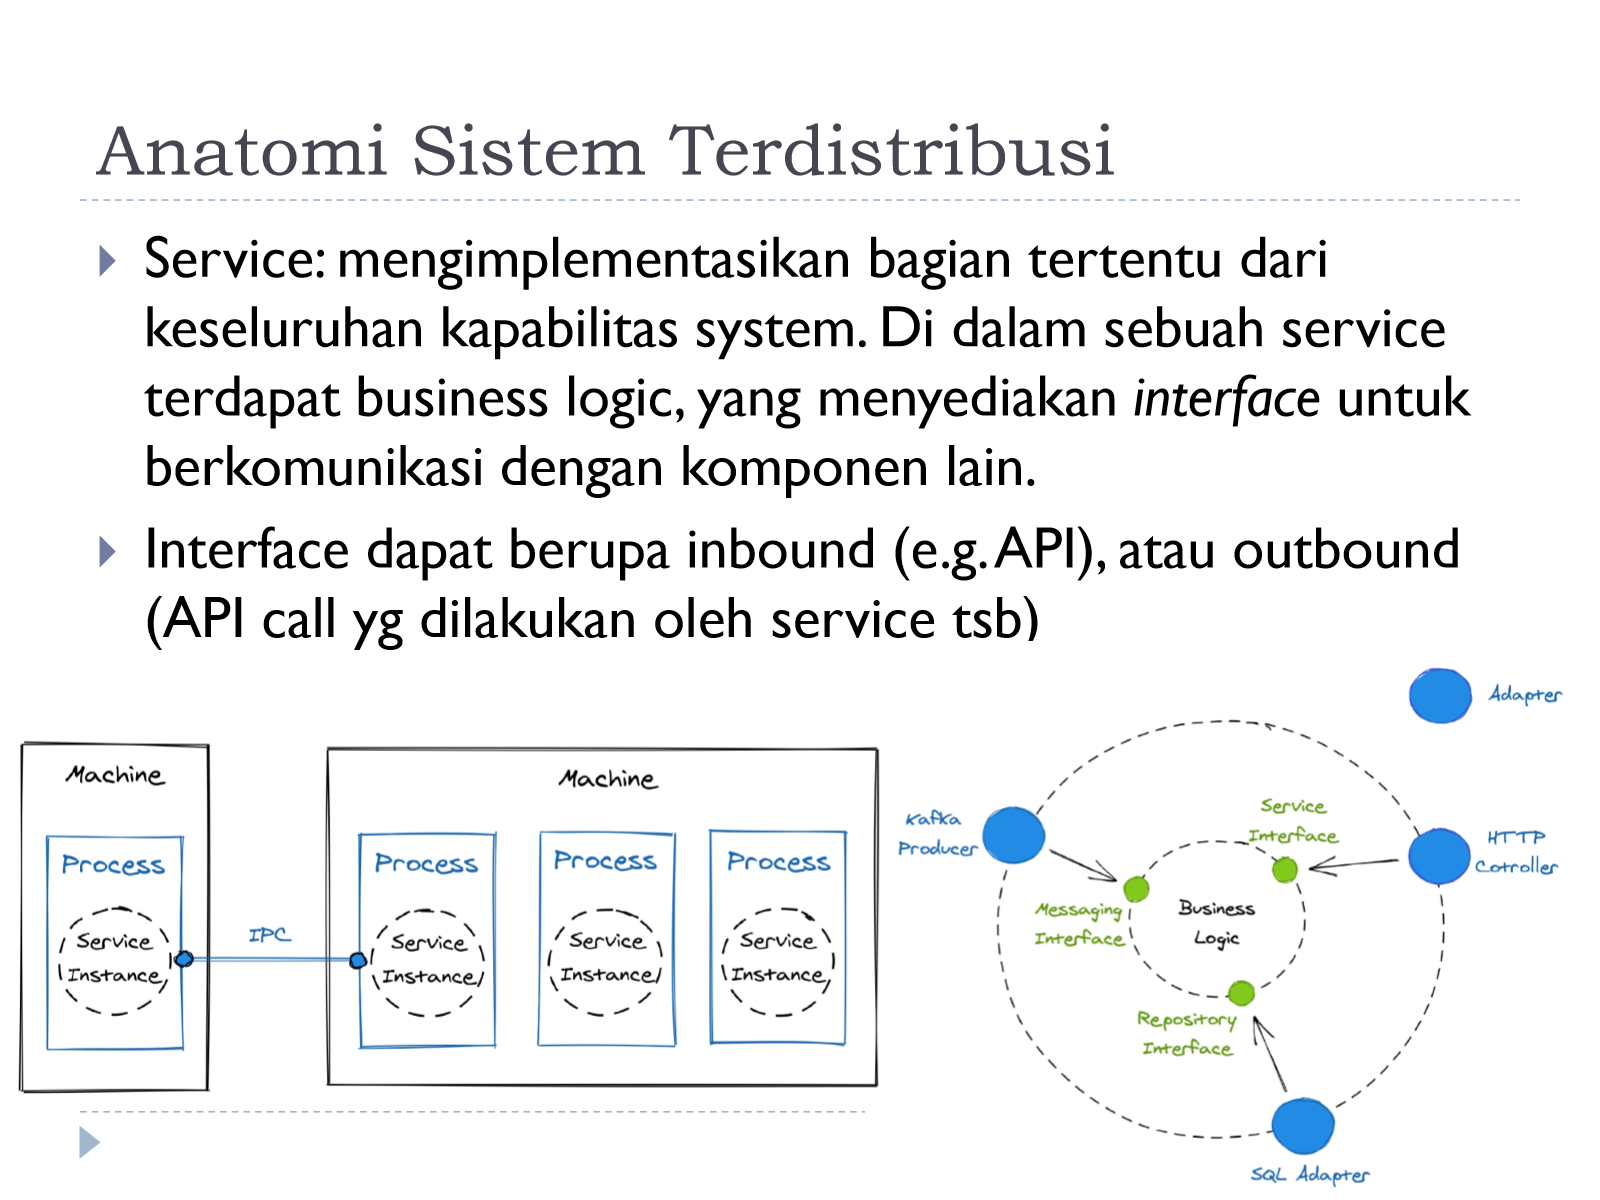
Diagram di atas menggambarkan dua pandangan: (kiri) beberapa mesin yang masing-masing menjalankan satu atau lebih proses, di mana setiap proses berisi satu service instance, dan komunikasi antar proses/mesin dilakukan lewat IPC. (kanan) anatomi internal sebuah service — business logic di tengah dikelilingi oleh berbagai jenis interface: Service Interface (diakses lewat gRPC atau HTTP Controller), Messaging Interface (diakses lewat Kafka Producer/Consumer), dan Repository Interface (diakses lewat SQL Adapter), dengan Adapter sebagai lapisan penghubung ke dunia luar.
API
Sebuah service menyediakan layanannya sebagai interface, yang diakses melalui adapter. Komunikasi bisa dilakukan secara:
- Direct: client mengirim request, server membalas response secara langsung.
- Indirect: melalui broker (perantara pesan).
Pada pola direct, reply-response message berisi data yang di-serialisasi dengan format yang language-agnostic (tidak terikat pada satu bahasa pemrograman saja), sehingga service yang ditulis dengan bahasa berbeda tetap bisa saling berkomunikasi.
Ketika client mengirim request dan terblok menunggu response, ini disebut synchronous communication. Pola ini tidak efisien karena memblok thread yang seharusnya bisa melakukan aktivitas lain selagi menunggu. Teknologi yang umum digunakan untuk pola ini: gRPC, REST, GraphQL.
Infrastruktur Komunikasi
Infrastruktur komunikasi menangani transmisi data dan event di atas jaringan. Umumnya diwujudkan dalam bentuk:
- Libraries, misalnya socket library, Boost Asio.
- Fitur bawaan bahasa pemrograman, misalnya Java RMI.
- Layanan spesifik platform, misalnya layanan komunikasi khas Android, Unix, atau Windows.
Library, dukungan bahasa, dan dukungan platform ini diciptakan untuk memberikan abstraksi lebih tinggi dan menyembunyikan detail komunikasi yang rumit. Namun, karena seringkali bergantung pada teknologi tertentu dan memiliki pola interaksi yang berbeda-beda, pemilihan teknologi komunikasi menjadi penentu penting dalam desain aplikasi terdistribusi.
Pemilihan teknologi memberikan constraint/batasan pada:
- Arsitektur sistem secara keseluruhan.
- Implementasi sistem: idiom, pattern, dan cara koding yang harus diikuti.
- Bisa membatasi teknik pengembangan tertentu, misalnya penggunaan thread, pemrograman asynchronous, atau kompatibilitas dengan teknologi lain.
Middleware
Middleware (“middleman” = perantara) adalah penghubung antara satu komponen software dengan komponen software lain, yang bisa berjalan pada sistem berbeda, menyediakan layanan tertentu, dengan fokus pada integrasi dan interoperability.
Layanan yang umum disediakan middleware:
- Transparent location services — client tidak perlu tahu lokasi fisik server.
- Standardized communication services
- Network and platform independent
- Reliability, scalability, availability
Contoh middleware/teknologi komunikasi berdasarkan kategorinya:
| Kategori | Contoh Teknologi |
|---|---|
| Stack protocol (TCP/IP) | Socket library, tersedia di berbagai platform/bahasa |
| RPC & serialization | RMI, Apache Thrift, Google Protobuf, Apache Avro |
| Message-oriented middleware | JMS, AMQP, XMPP, Apache Kafka |
| Enterprise messaging | SOAP, Web Services |
| Application servers | JSP servers, EJB container |
| Database access | ORM, Hibernate, JPA |
Stack Protocol
Stack protocol biasanya tersedia dalam bentuk library atau dukungan bahasa, menyediakan API untuk mengakses jaringan pada level aplikasi. Melalui stack protocol ini, aplikasi bisa mengakses berbagai layer jaringan: network, transport, dan aplikasi.
RPC/Serialization
Framework RPC (Remote Procedure Call) menyediakan:
- Framework yang memudahkan pendefinisian prosedur/method yang bisa dipanggil dari jarak jauh.
- Mekanisme serialisasi untuk mengubah data menjadi format yang bisa dikirim lewat jaringan.
- Penyembunyian detail komunikasi dari programmer.
- Abstraksi natural untuk pemanggilan fungsi remote — seolah-olah memanggil fungsi lokal biasa.
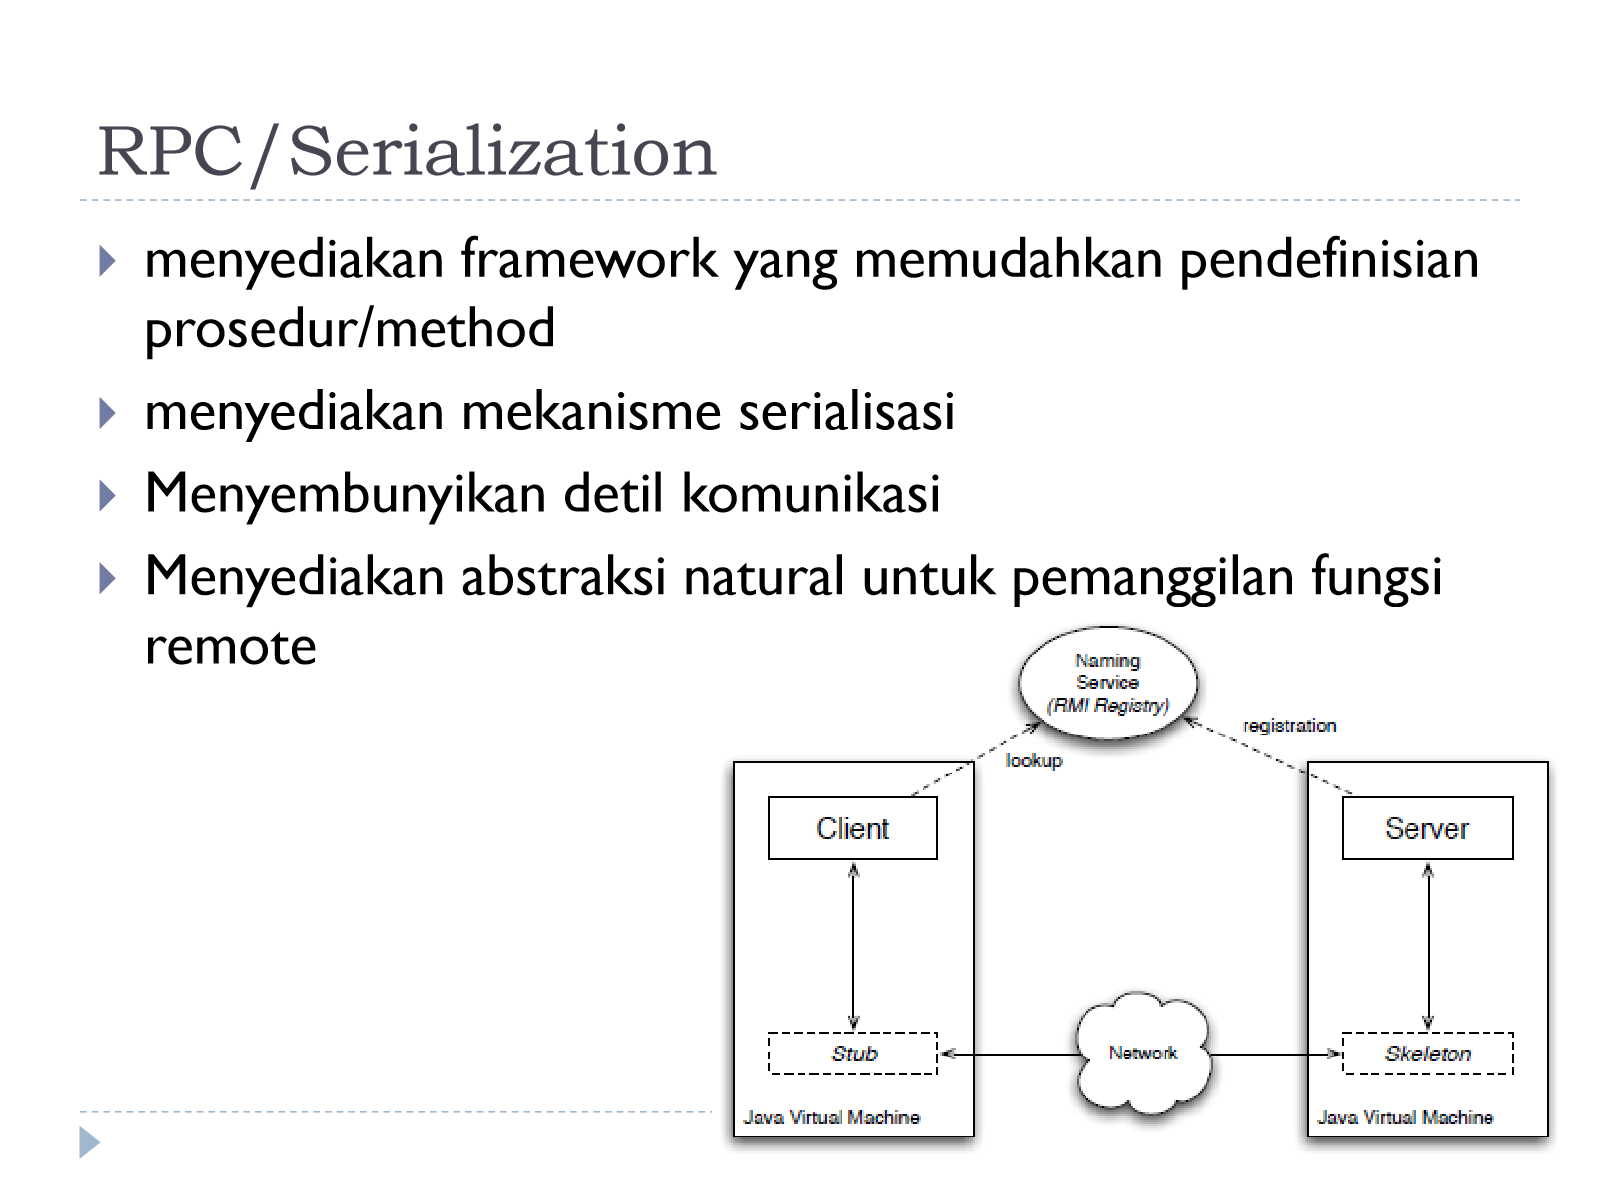
Diagram di atas mencontohkan arsitektur Java RMI: Client memiliki Stub (representasi lokal dari objek remote) dan Server memiliki Skeleton (penerima panggilan dari stub). Keduanya berkomunikasi lewat jaringan. Server melakukan registration ke Naming Service (RMI Registry), dan Client melakukan lookup ke Naming Service tersebut untuk menemukan referensi objek remote yang dicari — inilah wujud konkret dari “transparent location service” yang disebutkan sebelumnya.
Messaging
Messaging menyediakan infrastruktur untuk komunikasi menggunakan message (pesan), dengan dua pola komunikasi utama:
- Point-to-point
- Publish-subscribe
Model ini mengharuskan komunikasi dimodelkan melalui message channel, dan memerlukan cara tertentu untuk mengakses infrastruktur message tersebut.
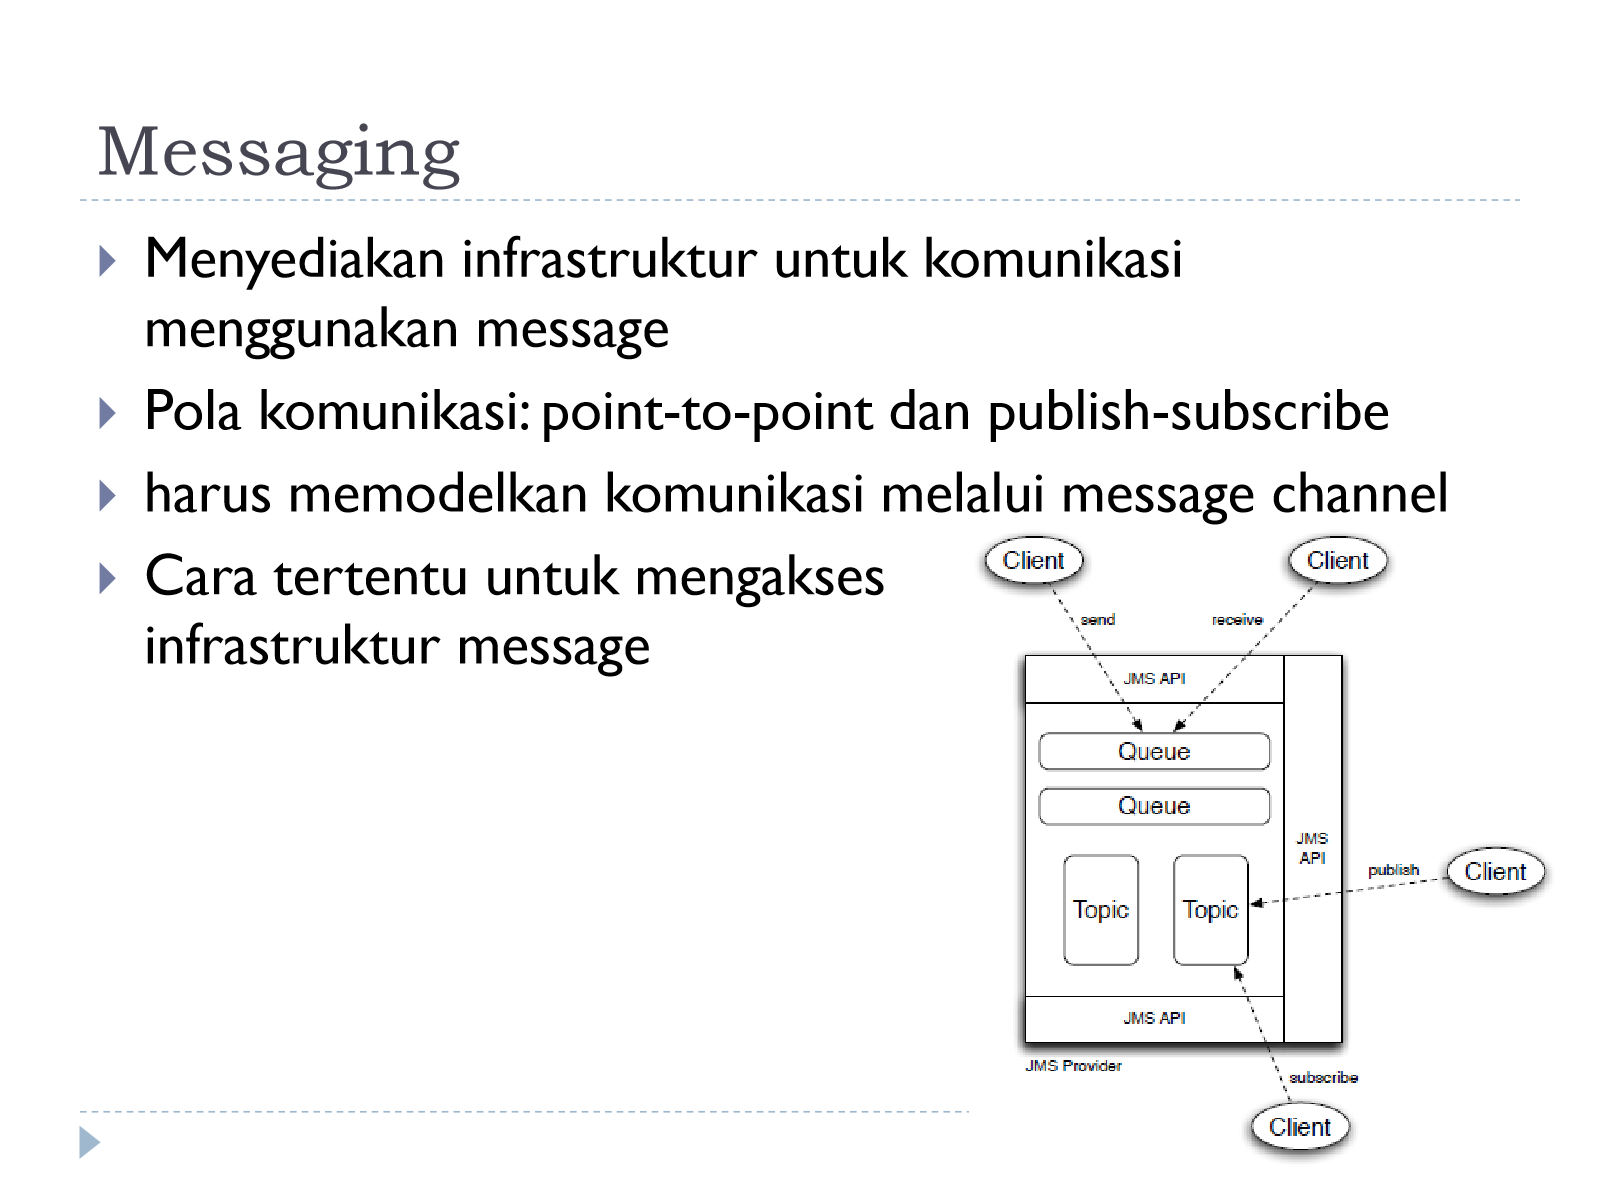
Diagram di atas mengilustrasikan arsitektur JMS (Java Message Service): Client dapat melakukan send/receive melalui Queue (pola point-to-point, cocok untuk satu pengirim-satu penerima per pesan), atau melakukan publish/subscribe melalui Topic (pola publish-subscribe, satu pesan bisa diterima banyak subscriber). Semua diakses melalui JMS API yang disediakan oleh JMS Provider.
Application Server
Application server menyediakan lingkungan untuk menjalankan aplikasi, lengkap dengan fitur kompleks seperti penanganan persistensi, transaksi, dan distribusi. Aplikasi/komponen yang berjalan di dalamnya dibatasi oleh aturan tertentu (lifecycle komponen, akses ke luar, threading, blocking, dll) — contohnya JSP server dan EJB container.
Database Access
Lapisan ini menyediakan:
- API untuk mengakses database, misalnya JDBC, ODBC.
- Konversi ke model data lain, misalnya konversi SQL ke Object model (ORM).
- Gateway untuk mengakses database lain.
Jenis-Jenis Aplikasi Terdistribusi
Slide mengelompokkan jenis aplikasi terdistribusi menjadi:
- Aplikasi client/server klasik
- Web applications
- File and information sharing
- Distributed databases
- Enterprise applications
- Cloud computing
- Multi-agent distributed systems
Aplikasi Klasik
Contoh: FTP, Web browser, remote shell, remote desktop. Karakteristiknya:
- Menyediakan fitur spesifik/khusus.
- Bergantung pada protokol standar (sudah dibakukan luas).
- Memiliki dedicated client dan server.
- Komponennya dapat diimplementasikan oleh berbagai pihak/vendor berbeda (karena mengikuti protokol standar yang sama).
- Tersedia luas, dengan banyak versi implementasi dari vendor berbeda.
Web Application
Karakteristik:
- Menggunakan protokol HTTP.
- Client berjalan di atas browser.
- Biasanya fungsi utama diimplementasikan di sisi server.
- Session management menjadi kompleks, karena HTTP pada dasarnya bersifat stateless — server perlu mekanisme tambahan (seperti cookie) untuk mengenali user yang sama di request berikutnya.
Slide menyertakan komik xkcd #869 sebagai ilustrasi humor tentang betapa rumitnya server modern harus mengenali dan menyesuaikan diri dengan berbagai jenis client (desktop vs smartphone browser) sekaligus menjaga state percakapan/sesi.
Social networks umumnya diimplementasikan sebagai web app, atau sebagai native app di platform mobile.
File/Information Services
Karakteristik:
- Seringkali menggunakan arsitektur Peer-to-peer.
- Robust terhadap failure.
- Minimal centralization (tidak terlalu bergantung pada satu titik pusat).
- Cocok untuk distribusi data skala besar, contohnya penyebaran distribusi Linux.
- Bisa juga digunakan untuk keperluan streaming.
Distributed Database
Database yang menggunakan storage pada lebih dari satu node, menggunakan replikasi dan duplikasi untuk menjaga konsistensi data antar node.
Keuntungan:
- Reliabilitas dan availabilitas lebih tinggi.
- Skalabilitas lebih baik.
- Distribusi data dapat disesuaikan dengan kebutuhan spesifik terhadap data (misalnya menaruh data dekat dengan pengguna yang paling sering mengaksesnya).
Kerugian:
- Kompleksitas implementasi meningkat signifikan.
- High maintenance (perawatan lebih berat).
- Isu security yang lebih kompleks (permukaan serangan lebih luas).
Enterprise Application
Enterprise app adalah software yang digunakan di lingkungan perusahaan, umumnya berskala besar. Jenisnya:
- Dibangun in-house (dikembangkan sendiri oleh perusahaan).
- Custom-made oleh pihak ketiga (dipesan khusus).
- Software as a Service (SaaS).
Karakteristik umum enterprise app:
- Menggunakan arsitektur three-tier atau n-tier.
- Menggunakan platform software khusus.
- Dituntut high performance dan scalable.
- Maintenance dan support bersifat kritikal — downtime bisa berdampak besar pada bisnis.
Cloud Computing
Cloud computing adalah model software yang tidak memerlukan keterlibatan pengguna dalam hal deployment, konfigurasi, dan hosting. Berbasis model utility computing (dibayar sesuai pemakaian, seperti listrik/air), layanan disediakan online, dan pengguna hanya memerlukan resource minimal untuk menggunakan layanan tersebut.
Layanan cloud dapat disediakan dalam bentuk:
- Aplikasi web
- Layanan web
- API
Contoh layanan cloud: storage, email/komunikasi/social networking, office tools, virtual servers. Layanan ini disediakan dan dikendalikan sepenuhnya oleh vendor, dan client membayar berdasarkan penggunaan aktual (pay-as-you-go).
Monolithic vs Service/Microservice Architecture
Monolithic architecture: seluruh logic aplikasi (frontend dan backend) digabung menjadi satu kesatuan Web Server, yang terhubung ke Database dan Storage.
| Aspek | Monolithic |
|---|---|
| Kelebihan | Mudah dibangun, di-deploy, ditest, dikoordinasikan, dan berbagi data. Pilihan terbaik untuk aplikasi sederhana. Bahkan beberapa layanan sangat besar (misalnya Facebook) tetap menggunakan desain monolithic. |
| Kekurangan | Menciptakan bottleneck dalam proses pengembangan software — banyak developer bekerja pada satu codebase sehingga butuh banyak koordinasi/merging. Satu codebase besar dapat menyebabkan kode menjadi berantakan dan rapuh (fragile) — perubahan di satu bagian bisa memicu bug tak terduga di bagian lain. Seluruh aplikasi harus di-redeploy meskipun hanya menambah fitur kecil. Harus memilih satu bahasa pemrograman, build system, dan runtime environment untuk seluruh aplikasi. |
Service/Microservice architecture: frontend dan backend dipecah menjadi komponen-komponen terpisah (misalnya Service A, Service B, Service C) yang masing-masing independen namun tetap terhubung ke Database dan Storage bersama.
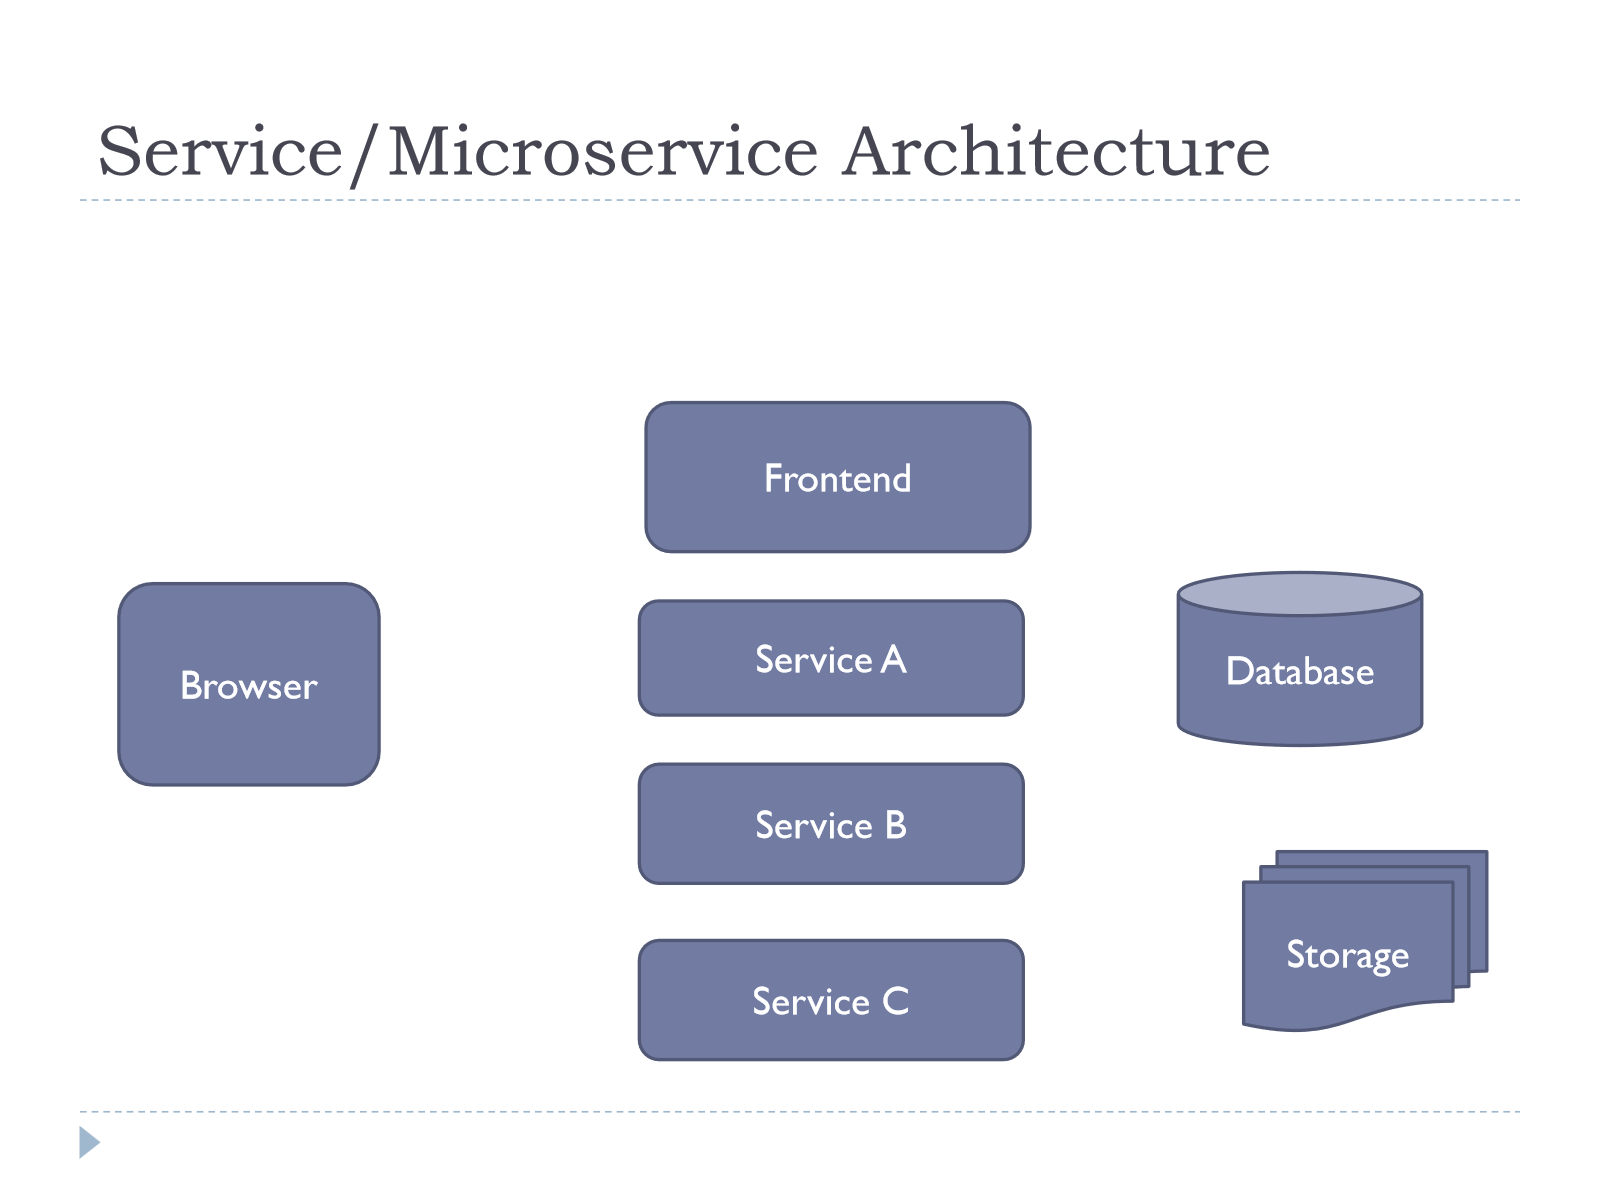
Diagram di atas menunjukkan evolusi dari backend tunggal menjadi beberapa service terpisah (Service A, B, C) yang masing-masing bisa dikembangkan dan di-deploy secara independen, sementara Frontend tetap menjadi satu komponen yang mengakses service-service tersebut.
Microservice
Pada arsitektur microservice, layanan dipecah menjadi layanan-layanan kecil dengan antarmuka yang jelas (API), umumnya menggunakan HTTP. Deployment biasanya berbasis container, di mana setiap “micro” service dapat di-deploy secara independen — ini memberikan fleksibilitas untuk skalabilitas dan deployment.
Motivasi memecah aplikasi menjadi sejumlah microservice yang berjalan pada beberapa container:
- Membatasi penggunaan resource pada masing-masing komponen (isolasi resource).
- Memungkinkan pembagian tim yang bertanggung jawab terhadap masing-masing komponen.
- Menerapkan prinsip separation of concerns.
Stateless vs Stateful
Ini adalah salah satu konsep desain paling penting untuk skalabilitas sistem terdistribusi. Beberapa aspek yang perlu diperhatikan dalam desain service:
- Stateless service: memungkinkan scale out karena service dapat di-duplikasi bebas. Storage, session, dan data disimpan di luar komponen service itu sendiri. Khusus pada HTTP, karena protokolnya stateless, perlu ada mekanisme untuk maintain user identity/session information, misalnya lewat cookie.
- Cache & Proxy: state dapat di-push ke lokasi di luar service, misalnya ke CDN atau cache service.
- Load Balancing
- Sharding/partition data
- Push notification
- Asynchronous processing
Stateless vs Stateful Worker Threads
- Stateless thread/process/service tidak mengingat apa pun dari request-request sebelumnya. Perilakunya murni ditentukan oleh: (1) input request yang diterima, dan (2) request handling code. Karena itu, redundant service (banyak salinan) dapat menjalankan kode yang sama tanpa masalah, karena tidak memiliki local state yang perlu disinkronkan.
- Stateful thread (atau service) berubah seiring berjalannya waktu, sebagai efek dari penanganan request — biasanya berupa persistent/global variable yang diubah oleh kode pemrosesan request.
Stateless code dianalogikan mirip dengan “pure function” dalam bahasa pemrograman: output tidak dipengaruhi oleh input/pemanggilan sebelumnya. Namun ini bukan berarti outputnya murni deterministik dari current input saja — bisa saja perilakunya nondeterministic (misalnya melibatkan random). Contoh fungsi stateless: float cosine(float x), int sum(int a, int b), List sort(List myList), List<T> listAppend(List<T> myList, T newItem), float generateRandomNumber().
Studi Kasus: Desain chess.com WebApp
Slide memberi studi kasus konkret untuk mengilustrasikan trade-off stateless vs stateful pada skalabilitas horizontal, menggunakan contoh website catur (mirip chess.com) yang perlu melakukan tracking state banyak game catur secara bersamaan (misal menampilkan halaman https://chess.com/game/23).
Desain paling sederhana: simpan game state pada memory satu mesin (misalnya dalam sebuah dictionary). Semua user (User1-User6) terhubung ke satu mesin yang sama.
Pendekatan 1 — Horizontal scaling naif (stateful): jalankan kode yang sama pada beberapa server, di mana setiap game hanya berjalan pada salah satu server tertentu (server menyimpan game state lokal). Masalah yang muncul:
- User harus terhubung kembali ke server yang sama untuk melanjutkan game — perlu mekanisme routing/affinity khusus untuk mengatur hal ini.
- Jika ada satu server gagal, sekitar 1/n dari total game (di mana n adalah jumlah server) akan hilang karena state-nya hanya ada di memory server yang gagal tersebut.
- Ini adalah contoh nyata dari stateful web app.
Pendekatan 2 — Stateless design: push semua game state ke central, shared database, sehingga user dapat terhubung ke sembarang instance untuk memainkan game (tidak perlu affinity ke server tertentu). Untuk mengarahkan user ke salah satu instance, diperlukan load balancer.
Masalah yang tersisa pada pendekatan ini: database menjadi resource terpusat yang membatasi scalability — meskipun layer aplikasi sudah stateless dan bisa di-scale out bebas, database tetap menjadi potensi bottleneck/single point of failure baru jika tidak didesain untuk terdistribusi juga.
Load Balancer
Konsep Dasar
Load balancer membuat sebuah cluster komputer terlihat seperti sebuah superior server tunggal. Load balancer menyediakan interface yang sama seperti single server (misalnya sebuah HTTP server yang beroperasi pada satu alamat IP), padahal di baliknya request tersebut didistribusikan ke banyak worker.
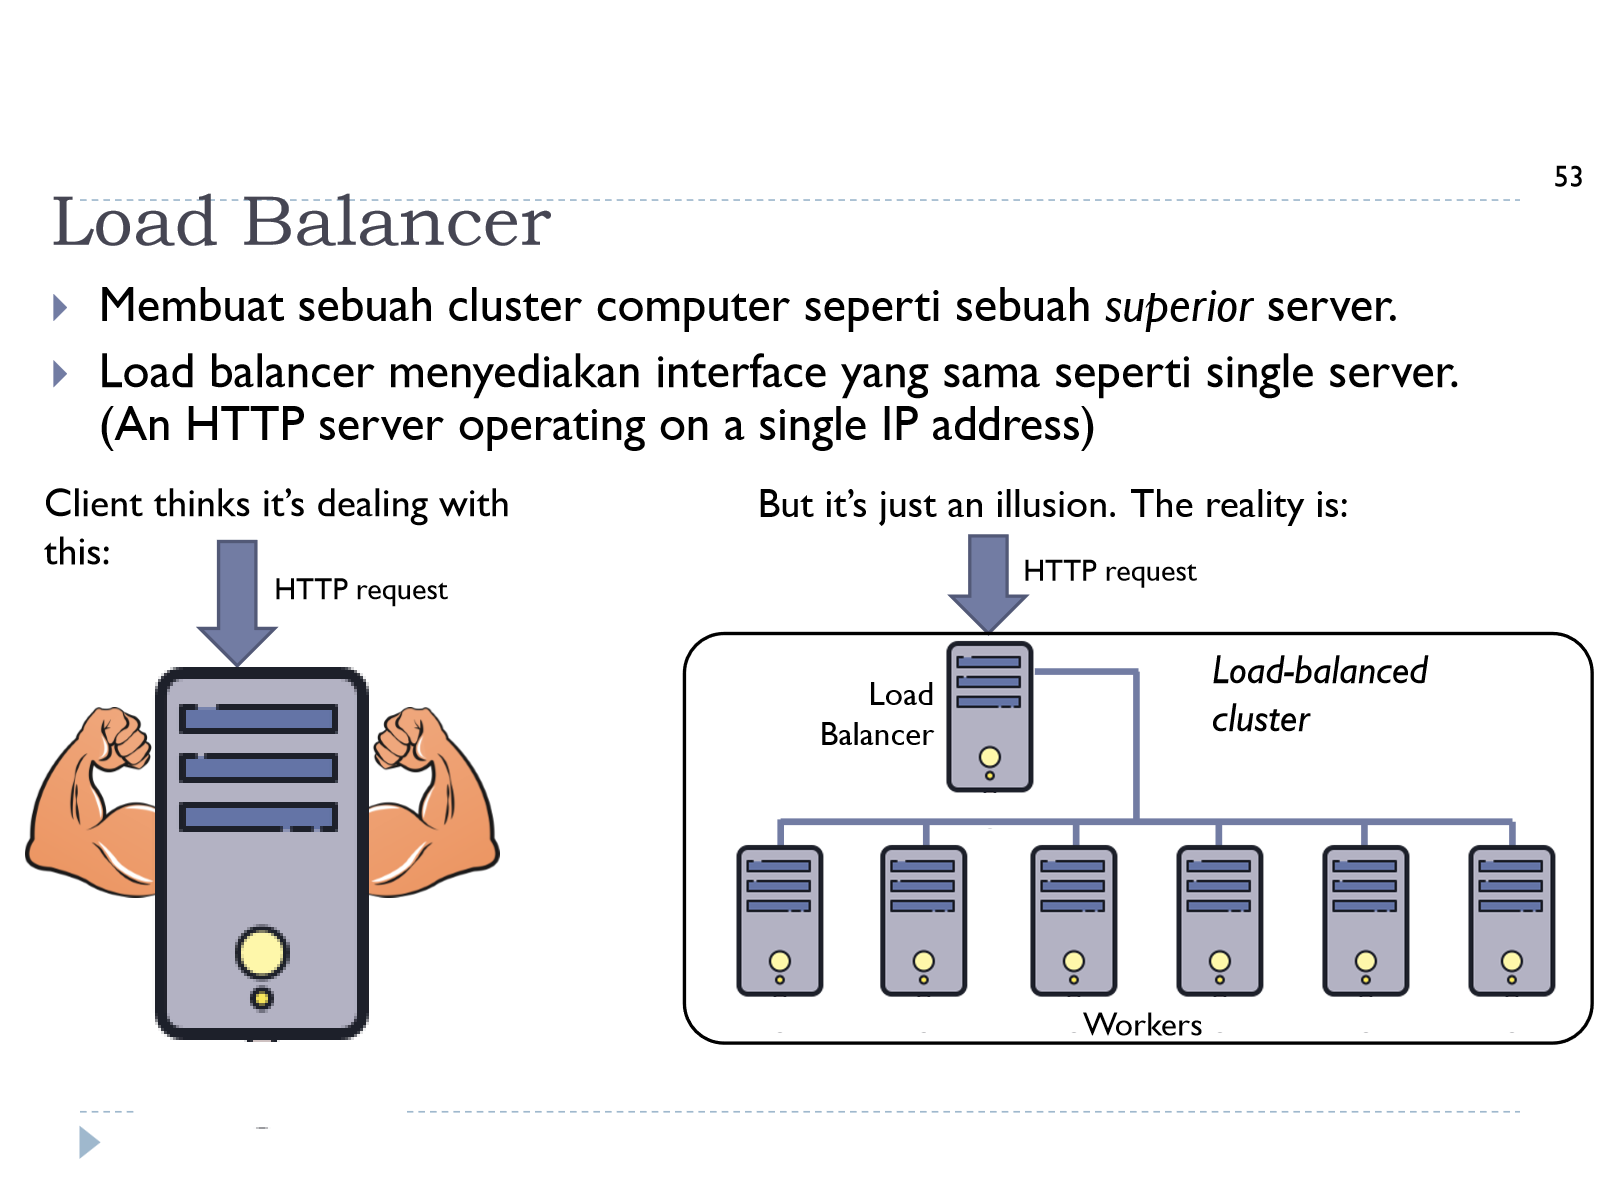
Ilustrasi di atas menegaskan poin ini: dari sudut pandang client, seolah-olah berhadapan dengan satu server yang sangat kuat (“superior server”), padahal realitanya adalah sebuah load-balanced cluster — request masuk ke Load Balancer terlebih dahulu, baru kemudian didistribusikan ke sejumlah Workers di belakangnya.
Keuntungan Tambahan dari Load Balancer
Selain membagi beban, load balancer memberi keuntungan operasional:
- Upstream servers dapat diganti tanpa mengganggu layanan — bisa dilakukan lewat “rolling” app update (update server satu per satu secara bergilir sambil load balancer terus mengarahkan traffic ke server yang masih versi lama), atau lewat synchronized update (menyiapkan VM baru dengan software baru, lalu mengalihkan konfigurasi load balancer sekaligus ke semua VM baru).
- Health check: proxy/load balancer dapat memonitor health dari server-server di belakangnya, dengan cara mengirim “health check” request secara periodik (biasanya sebuah simple GET API call). Jika request tersebut gagal, berarti server dianggap crash, dan load balancer akan berhenti meneruskan request ke server tersebut sampai server itu pulih kembali.
Dua Jenis Local Load Balancer
| Aspek | Network Address Translation (NAT) | Reverse Proxy |
|---|---|---|
| Layer kerja | IP layer | HTTP layer |
| Cara kerja | Meneruskan (forward) paket satu per satu, namun mengingat server mana yang ditugaskan untuk tiap client | Menyimpan (menampung) full request/response sebelum diteruskan |
| Kompatibilitas | Kompatibel dengan tipe layanan apa pun, tidak terbatas HTTP | Hanya untuk HTTP |
| Fitur tambahan | - | SSL termination, caching, compression |
| Contoh implementasi | Perangkat hardware NAT (umumnya mahal) | Nginx, Squid (open-source, murah) |
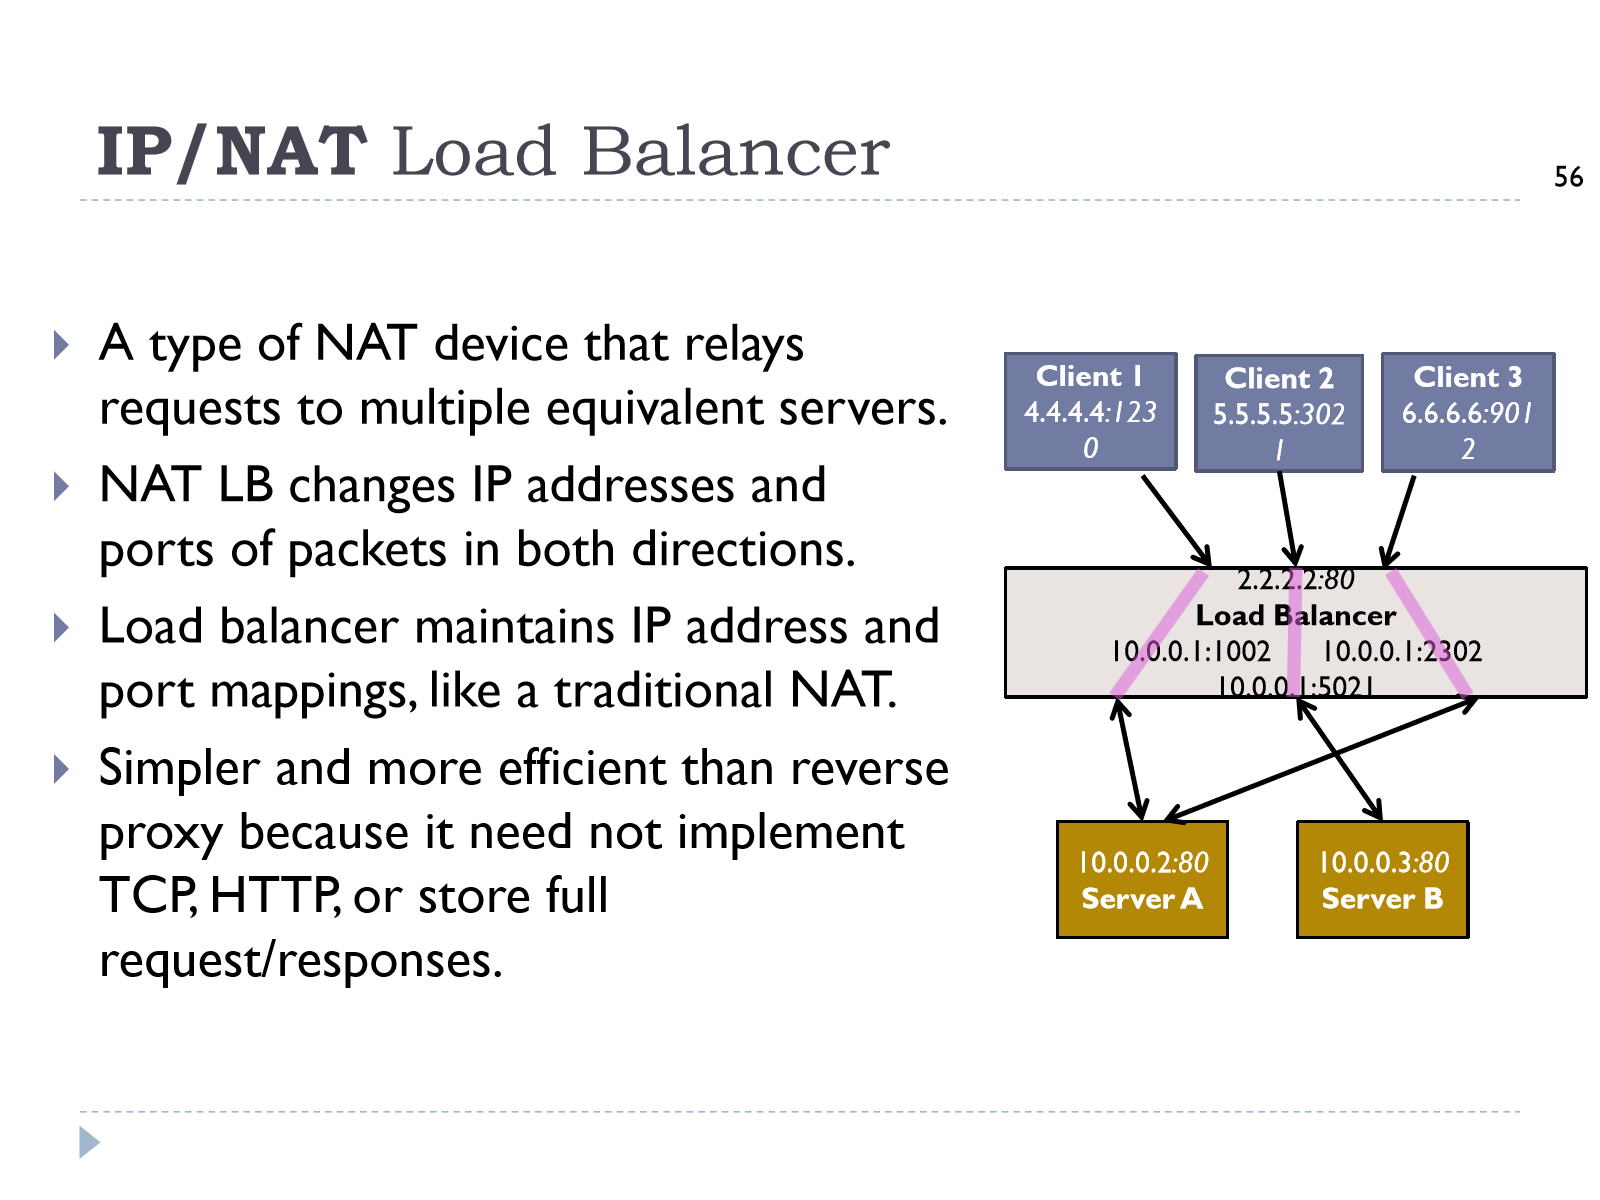
Diagram IP/NAT Load Balancer di atas menunjukkan bagaimana NAT LB mengubah alamat IP dan port dari paket di kedua arah (request dan response). Client-client (Client 1, 2, 3) mengirim request ke satu alamat IP publik load balancer (2.2.2.2:80), lalu load balancer memetakan tiap koneksi ke salah satu server backend (Server A di 10.0.0.2:80 atau Server B di 10.0.0.3:80) sambil mengingat pemetaan IP:port setiap client. Pendekatan ini lebih sederhana dan efisien dibanding reverse proxy karena tidak perlu mengimplementasikan TCP, HTTP, atau menyimpan full request/response.
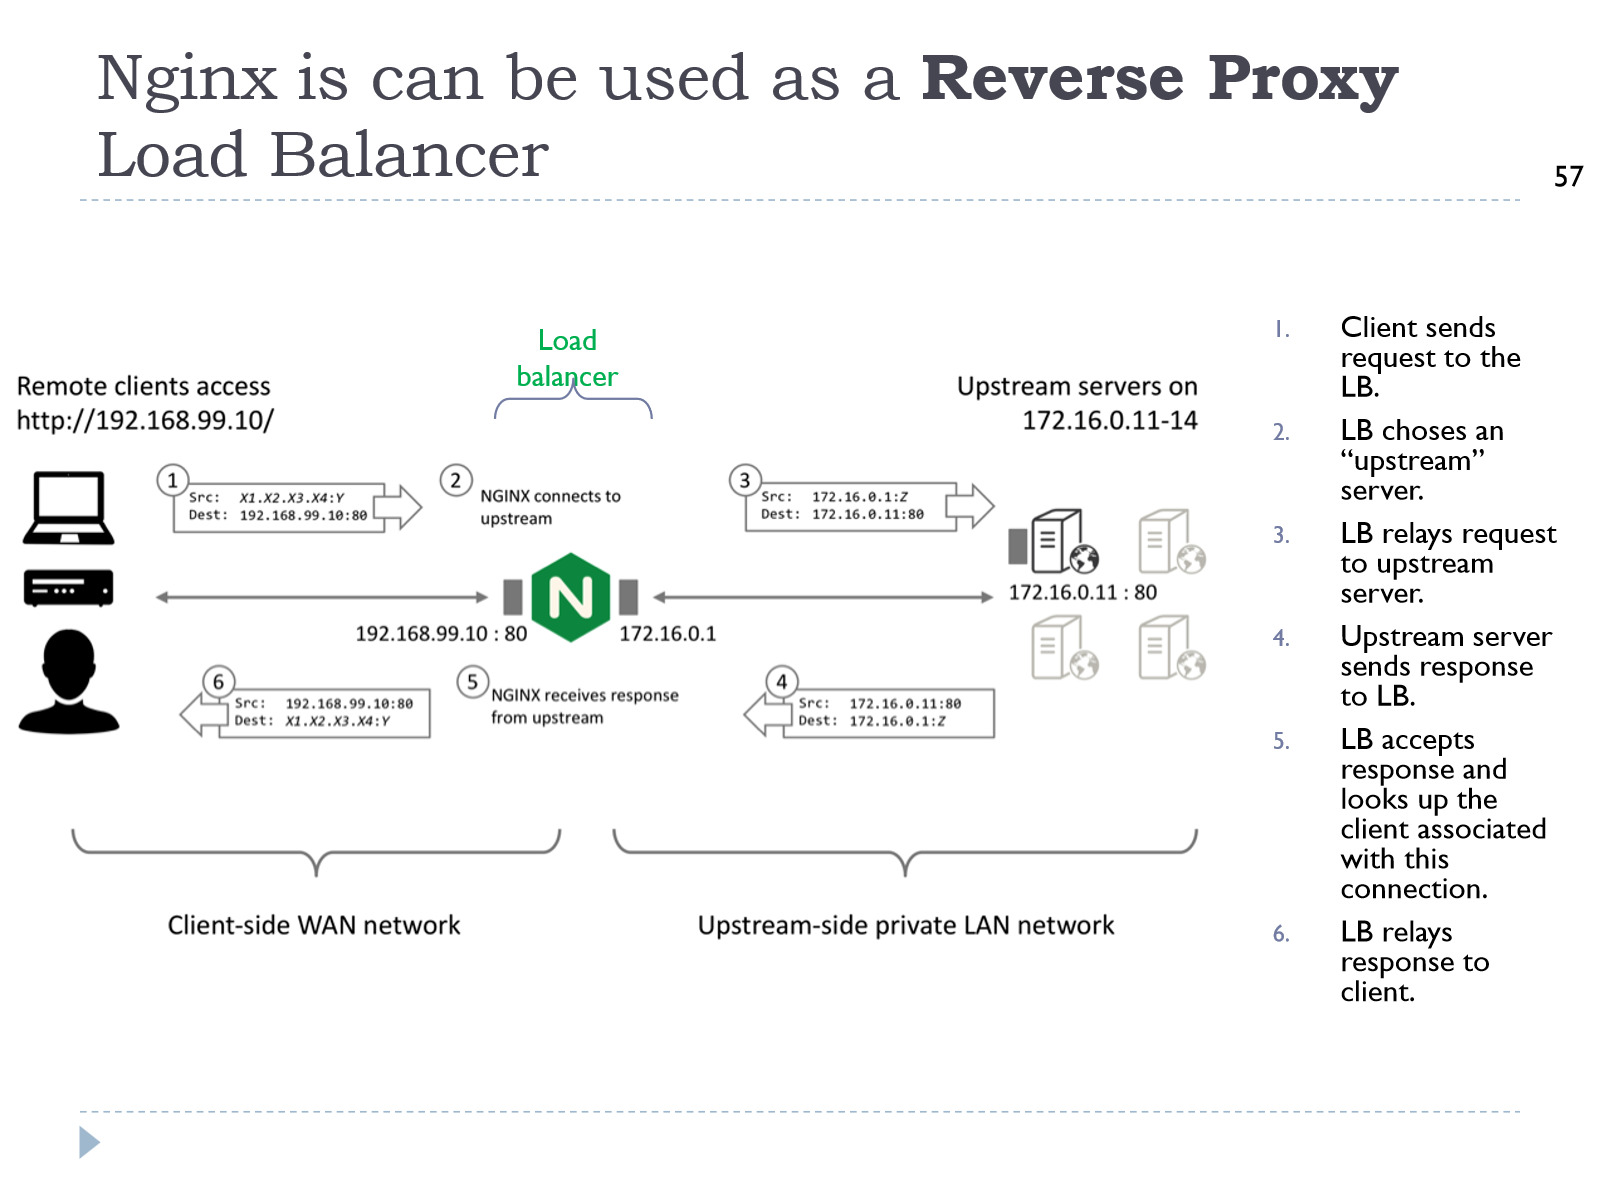
Diagram di atas menunjukkan Nginx sebagai Reverse Proxy Load Balancer, dengan alur kerja 6 langkah:
- Client mengirim request ke Load Balancer (misalnya ke
http://192.168.99.10/). - Load Balancer (Nginx) memilih salah satu “upstream” server.
- Load Balancer meneruskan (relay) request ke upstream server yang dipilih (misalnya di jaringan privat 172.16.0.11-14).
- Upstream server mengirimkan response kembali ke Load Balancer.
- Load Balancer menerima response dan mencari tahu client mana yang berhubungan dengan koneksi tersebut.
- Load Balancer meneruskan response tersebut kembali ke client.
Perhatikan bahwa terdapat dua segmen jaringan berbeda: client-side WAN network (jaringan publik tempat client berada) dan upstream-side private LAN network (jaringan privat tempat server-server backend berada) — reverse proxy menjadi jembatan antara keduanya.
Keuntungan Reverse Proxy Load Balancer
- SSL certificate cukup disimpan di proxy saja — komunikasi internal (antara proxy dan upstream server) boleh tidak dienkripsi (unencrypted), karena sudah berada dalam jaringan privat yang dianggap aman.
- Proxy juga dapat melakukan caching response, namun perlu diperhatikan bahwa hal ini dapat membatasi skalabilitasnya (karena proxy jadi perlu menyimpan lebih banyak state/data cache).
Perbandingan Local Load Balancing Options
| Aspek | NAT | Reverse Proxy |
|---|---|---|
| Routing dilakukan oleh | IP address/port translation | HTTP proxy |
| Skala | ~1-10 juta request/detik | ~100 ribu - 1 juta request/detik |
| Layanan yang didukung | Semua jenis layanan | Hanya HTTP |
| Fitur tambahan | Tidak ada | SSL termination, caching |
Keterbatasan Load Balancer
Meski bermanfaat, load balancer memiliki keterbatasan:
- Load balancer sendiri berpotensi menjadi single point of failure.
- Hanya mampu menangani sekitar ~1 juta request/detik (batas atas praktis).
- Berada pada satu data center: mungkin lokasinya tidak dekat dengan customer, dan data center itu sendiri juga menjadi single point of failure.
Untuk layanan skala sangat besar, dibutuhkan lebih dari sekadar local load balancer. Muncul pertanyaan: bagaimana client dapat menemukan service replica tanpa melalui central bottleneck? Ini disebut sebagai masalah distributed service discovery, yang solusinya mengarah ke load balancing tingkat global menggunakan DNS atau IP Anycast.
Domain Name Service (DNS) sebagai Load Balancer Global
DNS adalah direktori terdistribusi yang memetakan hostname ke IP address. DNS menggunakan arsitektur distributed, hierarchical, dan caching untuk mencapai skalabilitas. Local DNS resolver menyimpan cache jawaban dari domain-domain yang sering diakses (misalnya gmail.com, facebook.com), dan hanya akan bertanya ke hierarki di atasnya jika jawaban tidak ditemukan di cache lokal.
Round-Robin DNS
DNS memungkinkan beberapa jawaban diberikan untuk satu query (banyak IP address untuk satu domain name). Client bisa memilih salah satu IP secara acak dari daftar tersebut. Bahkan lebih canggih lagi, DNS server bisa menyimpan banyak jawaban namun memberikan respons berbeda ke user berbeda (baik secara acak/random maupun bergiliran/cyclic — inilah asal nama “round-robin”). Karena DNS pada dasarnya adalah sistem cached dan terdistribusi, tidak ada batas skala untuk pendekatan ini, setidaknya pada sisi frontend.
Geographic Load Balancing dengan DNS
Lebih dari sekadar membagi beban, DNS juga dapat menghubungkan user ke replica terdekat dari sebuah layanan. DNS server yang cerdas memeriksa IP address dari requester dan meng-resolve ke server yang dianggap paling dekat secara geografis dengan client tersebut (teknik ini disebut IP address geolocation). Dengan kata lain, jawaban IP address yang diberikan tidak hanya berbeda-beda, tapi disesuaikan (customized) untuk client tertentu.
Content Delivery Network (CDN)
CDN adalah kumpulan web server yang tersebar secara global, yang meng-cache response untuk client lokal di dekatnya. Secara konsep, CDN pada dasarnya adalah sebuah distributed caching HTTP reverse proxy yang menggunakan DNS (dan teknik lainnya) untuk melakukan geographic load-balancing. Contoh penyedia CDN: Akamai, Cloudflare, Cloudfront — masing-masing memiliki jaringan “edge server” yang tersebar di banyak kota besar di seluruh dunia.
Geographic Load Balancing dengan IP Anycast
Contoh kasus: 8.8.8.8 adalah satu-satunya alamat IP untuk layanan DNS publik raksasa milik Google, yang menangani lebih dari 400 miliar request DNS per hari. Karena layanan ini adalah DNS server itu sendiri, ia tidak bisa mengandalkan DNS untuk load balancing-nya sendiri (tidak bisa “menggunakan dirinya sendiri” untuk membagi beban ke dirinya sendiri).
Solusinya: IP Anycast load balancing, yang diimplementasikan menggunakan BGP (Border Gateway Protocol). Ide dasarnya: banyak router milik Google di seluruh dunia semuanya mengiklankan (advertise) ke router tetangga mereka bahwa mereka bisa mencapai 8.8.8.8 hanya dalam satu hop. Akibatnya, traffic yang ditujukan ke 8.8.8.8 akan dikirim ke router Google mana pun yang paling dekat secara topologi jaringan dengan customer tersebut.
Catatan penting: secara teknis, pendekatan ini melanggar prinsip bahwa satu alamat IP seharusnya merujuk pada satu destinasi yang spesifik dan tunggal. Namun untuk kasus DNS hal ini tidak menjadi masalah, karena protokol yang digunakan adalah UDP dan bersifat stateless — tidak ada koneksi yang perlu dijaga konsistensinya sepanjang waktu ke server yang sama persis.
Perbandingan Global Load Balancing Options
| Aspek | DNS | IP Anycast |
|---|---|---|
| Routing dilakukan oleh | Domain Name Service | BGP |
| Batas skala maksimum | Dibatasi oleh Internet itu sendiri | Dibatasi oleh Internet itu sendiri |
| Kecepatan perubahan diterapkan | DNS TTL (Time To Live) — dalam hitungan menit hingga jam | BGP convergence — sekitar satu menit |
| Kemudahan deployment | Memerlukan software/konfigurasi DNS tingkat lanjut | Harus mengoperasikan Autonomous System sendiri (harus jadi ISP) |
DNS adalah pilihan paling umum digunakan karena kemudahannya. Sedangkan IP Anycast hanya realistis digunakan oleh perusahaan raksasa teknologi (Google, Facebook, Amazon, Microsoft, dll) yang memang sudah mengoperasikan infrastruktur jaringan sendiri berskala besar (menjadi Autonomous System/ISP-nya sendiri).
Perbandingan Level Load Balancing: Local vs Global
| Aspek | Local | Global |
|---|---|---|
| Routing dilakukan oleh | NAT atau HTTP Proxy | DNS atau BGP |
| Batas skala maksimum | Dibatasi kecepatan satu mesin | Dibatasi Internet itu sendiri |
| Kecepatan perubahan diterapkan | Milidetik | Menit hingga jam |
| Kemudahan deployment | Sederhana, menggunakan software/hardware siap pakai | Memerlukan software/konfigurasi DNS tingkat lanjut |
Kesimpulannya, mayoritas layanan skala besar melakukan load balancing pada dua level sekaligus:
- Local — untuk menyediakan operasi berkelanjutan dan skalabilitas di dalam satu data center, termasuk fitur health check dan rolling update.
- DNS/Global — untuk skalabilitas global dan latency rendah, dengan mengarahkan user ke data center terdekat secara geografis.
Flashcard
flashcards Mengapa “The Law of Leaky Abstractions” penting dipahami saat mendesain komunikasi aplikasi terdistribusi? :: Karena semua abstraksi non-trivial (TCP, gRPC, NFS, dsb) pada dasarnya “leaky” — selalu ada peluang kejadian di mana abstraksi tersebut gagal menjamin jaminannya (koneksi terputus, request gagal, delay berlebihan) meski sender/receiver tidak crash, sehingga developer tetap perlu memahami stack protocol di baliknya, bukan hanya bergantung pada abstraksi. Apa isi utama dari FLP Impossibility dan mengapa relevan untuk koordinasi sistem terdistribusi? :: FLP Impossibility menyatakan bahwa consensus tidak bisa diimplementasikan secara pasti pada sistem asynchronous jika ada kemungkinan satu proses saja gagal. Ini adalah dasar teoritis mengapa mendesain algoritma koordinasi/consensus yang menangani kegagalan itu secara inheren sulit dan selalu melibatkan trade-off. Apa perbedaan mendasar antara stateless service dan stateful service, dan mengapa stateless lebih disukai untuk scalability? :: Stateless service tidak menyimpan state lokal apa pun dari request sebelumnya — perilakunya murni ditentukan oleh input request dan kode pemrosesan, sehingga service dapat dengan mudah diduplikasi (scale out) tanpa perlu sinkronisasi state. Stateful service menyimpan state yang berubah seiring waktu (persistent/global variable), sehingga request harus diarahkan ke instance yang sama (affinity) dan lebih rentan kehilangan data jika instance tersebut gagal. Pada studi kasus desain chess.com, apa masalah yang muncul jika game state disimpan lokal di tiap server (pendekatan stateful), dan bagaimana pendekatan stateless mengatasinya? :: Pada pendekatan stateful, user harus terhubung ke server yang sama untuk melanjutkan game, dan jika satu server gagal maka sekitar 1/n game akan hilang. Pendekatan stateless mengatasinya dengan memindahkan semua game state ke shared database terpusat, sehingga user bisa terhubung ke instance mana pun lewat load balancer — namun ini memunculkan masalah baru yaitu database menjadi resource terpusat yang membatasi scalability. Jelaskan perbedaan cara kerja NAT load balancer dan Reverse Proxy load balancer, termasuk trade-off keduanya. :: NAT load balancer bekerja di IP layer, meneruskan paket satu per satu sambil mengingat pemetaan client-server, kompatibel dengan tipe layanan apa pun, dan memiliki skala lebih tinggi (~1-10 juta request/detik) karena tidak perlu mengimplementasikan TCP/HTTP. Reverse Proxy bekerja di HTTP layer, menyimpan full request/response sebelum diteruskan, hanya mendukung HTTP, skalanya lebih rendah (~100rb-1juta request/detik), namun menawarkan fitur tambahan seperti SSL termination, caching, dan compression. Mengapa load balancer lokal saja tidak cukup untuk layanan skala global, dan apa solusi yang ditawarkan? :: Load balancer lokal memiliki keterbatasan: menjadi single point of failure, hanya mampu menangani ~1 juta request/detik, dan berada di satu data center yang mungkin jauh dari customer serta menjadi single point of failure tersendiri. Solusinya adalah load balancing tingkat global menggunakan DNS (round-robin DNS, geographic load balancing, CDN) atau IP Anycast (menggunakan BGP), yang keduanya dibatasi skalanya hanya oleh Internet itu sendiri. Bagaimana IP Anycast memungkinkan load balancing geografis pada layanan seperti Google Public DNS (8.8.8.8), dan mengapa pendekatan ini valid meski melanggar prinsip pengalamatan IP? :: IP Anycast diimplementasikan dengan BGP: banyak router Google di berbagai lokasi mengiklankan bahwa mereka bisa mencapai 8.8.8.8 dalam satu hop, sehingga traffic otomatis diarahkan ke router terdekat secara topologi. Ini secara teknis melanggar prinsip bahwa satu IP address merujuk pada satu destinasi tunggal, tetapi valid untuk kasus DNS karena menggunakan UDP yang stateless, sehingga tidak masalah jika request berbeda dilayani oleh server fisik yang berbeda-beda. Sebutkan lima aspek utama yang harus diperhatikan dalam mendesain aplikasi terdistribusi menurut materi ini. :: Komunikasi (mekanisme pengiriman data antar node), Koordinasi (penanganan siapa melakukan apa dan penanganan kegagalan), Skalabilitas (efisiensi menangani beban: throughput dan latency), Resiliensi (kemampuan tetap beroperasi meski terjadi kegagalan), dan Operations (pengelolaan mulai dari development hingga maintenance). Mengapa arsitektur monolithic tetap menjadi pilihan valid untuk sejumlah kasus, meski microservice sering dianggap lebih modern? :: Karena monolithic lebih mudah dibangun, di-deploy, ditest, dikoordinasikan, dan berbagi data — cocok untuk aplikasi sederhana, dan bahkan layanan sangat besar seperti Facebook tetap menggunakan desain monolithic. Microservice membawa manfaat separation of concerns dan skalabilitas independen, namun juga menambah kompleksitas koordinasi antar service yang tidak selalu dibutuhkan.