Materi ini membahas bagaimana sebuah server (khususnya web server) mendesain penanganan proses/thread dan I/O agar mampu melayani banyak koneksi klien secara bersamaan (high performance server architecture). Fokus utamanya ada pada C10K problem, strategi implementasi penanganan klien (process/thread per connection), lima model I/O, serta perdebatan klasik thread-based vs event-based server.
C10K Problem
C10K problem: bagaimana mendesain sebuah socket server yang mampu menangani jumlah klien yang sangat besar secara bersamaan (concurrent 10 ribu koneksi). Masalah ini muncul karena pada skala besar, hal-hal berikut menjadi bottleneck:
- Data copies — banyaknya penyalinan data antar buffer (misalnya user-space ke kernel-space).
- Context switches — perpindahan konteks eksekusi antar proses/thread yang costly jika jumlahnya sangat banyak.
- Memory allocation — alokasi memori untuk tiap koneksi/thread/proses membengkak seiring jumlah klien.
- Lock contention — persaingan akses terhadap resource yang dilindungi lock saat banyak thread/proses berjalan concurrent.
Perdebatan besar terkait C10K ini direpresentasikan lewat dua paper yang saling bertolak belakang judulnya:
- “On the Duality of Operating System Structures” (Lauer & Needham) — mengelompokkan desain OS menjadi dua kategori besar: message-oriented system (proses sedikit, statis, komunikasi via pesan eksplisit) vs procedure-oriented system (proses banyak, dinamis, sinkronisasi via shared data).
- “Why Threads Are A Bad Idea (for most purposes)” (Ousterhout) vs “Why Events Are A Bad Idea (for high-concurrency servers)” (von Behren, Condit, Brewer) — dua pandangan berlawanan soal mana yang lebih baik untuk server dengan concurrency tinggi: thread atau event.
Flow Pemrosesan Request pada Web Server
Alur umum yang dilalui sebuah request di web server:
- Accept the incoming TCP connection — menerima koneksi TCP yang masuk.
- Read the request — membaca raw bytes dari socket (I/O bound), lalu melakukan parsing terhadap request tersebut (CPU bound). Jika request membawa data (misalnya POST request), server juga harus membaca raw bytes body dari socket.
- Dispatch request — misalnya membaca dari file untuk static files, atau meneruskan request ke backend/CGI/FastCGI/WSGI. Tahap ini I/O bound.
- Write generated response to socket, begitu response tersedia.
Penting dicatat: sebagian besar tahapan bersifat I/O bound, hanya parsing request yang murni CPU bound. Ini menjadi dasar kenapa desain penanganan I/O sangat menentukan performa server.
Strategi Implementasi Penanganan Client
One Process per Client
Model paling sederhana: listener process membuka socket dan menunggu koneksi dari client. Setiap kali ada koneksi baru masuk, server membuat (fork) proses baru untuk menanganinya.
while (1) {
  newsock = accept(listensock, NULL, NULL);
  if ((pid = fork()) == 0) {
    // child process
  } else {
    // parent process
    close(newsock);
  }
}
Parent process (listener) terus menunggu koneksi baru, sementara setiap child process yang di-fork menangani satu koneksi klien secara independen.
One Process per Client dengan Preforking (1p1c prefork)
Alih-alih fork proses baru setiap ada koneksi (yang costly), server melakukan preforking: sejumlah nchildren proses dibuat di awal (sebelum ada koneksi masuk), lalu masing-masing child langsung masuk ke loop accept() menunggu koneksi pada listensock yang sama (shared listening socket).
for (x = 0; x < nchildren; x++) {
  if ((pid = fork()) == 0) {
    while (1) {
      newsock = accept(listensock, NULL, NULL);
      printf("client connected to child process %i.\n", getpid());
      nread = recv(newsock, buffer, 25, 0);
      buffer[nread] = '\0';
      printf("%s\n", buffer);
      send(newsock, buffer, nread, 0);
      close(newsock);
      printf("client disconnected from child process %i.\n", getpid());
    }
  }
}
Keuntungan preforking: overhead fork() per koneksi dihindari karena pool proses sudah siap sejak awal, sehingga latensi penerimaan koneksi baru berkurang.
One Thread per Client (Pre-threaded, 1t1c prethread)
Variasi lain: alih-alih proses, gunakan thread. Sejumlah thread dibuat di awal (pthread_create), masing-masing menjalankan thread_proc yang menunggu koneksi pada listensock yang sama.
for (x = 0; x < nchildren; x++) {
  result = pthread_create(&thread_id, NULL, thread_proc,
                           (void *) listensock);
  if (result != 0) {
    printf("Could not create thread.\n");
  }
  sched_yield();
}
Thread lebih ringan dibanding proses (berbagi address space, tidak perlu duplikasi memory penuh seperti fork), tapi tetap punya masalah skalabilitas serupa saat jumlah koneksi sangat besar.
Problem dari Model 1 Process/Thread per Client
Model 1 thread/client atau 1 process/client menggunakan resource yang besar secara agregat, meskipun tiap unit terlihat ringan.
Contoh kasus HTTP server: untuk response berukuran 100 KB (tipikal), server hanya butuh waktu sangat singkat (jauh di bawah 1 detik) untuk mengambil file dari disk, namun bisa butuh waktu jauh lebih lama (misalnya sampai 10 detik) untuk benar-benar mengirimkan seluruh response ke client (tergantung kecepatan jaringan client). Artinya proses/thread tersebut “menganggur” menunggu I/O selama sebagian besar waktu hidupnya.
Jika ada 1000 client yang terhubung bersamaan, dan tiap thread/process dialokasikan 1 MB memori, maka dibutuhkan 1 GB memori hanya untuk menangani 1000 concurrent connection. Masalah ini makin parah karena modern HTTP server mendukung persistent connection (koneksi tetap terbuka untuk beberapa request berurutan), sehingga jumlah concurrent connection yang harus ditangani server jadi jauh lebih besar dibanding jumlah request aktif pada satu waktu.
Akar masalahnya: karakteristik aplikasi jaringan/terdistribusi pada dasarnya I/O bound — sebagian besar waktu proses/thread dihabiskan menunggu I/O event (bukan melakukan komputasi). Model 1-proses/1-thread-per-koneksi memboroskan resource justru pada saat resource itu tidak dipakai untuk komputasi apa pun, hanya untuk “menahan” state koneksi yang idle.
Model-Model I/O
Sistem operasi umumnya menyediakan 5 model I/O:
- Blocking I/O
- Non-blocking I/O
- I/O Multiplexing (select, poll, epoll, kqueue)
- Signal-driven I/O
- Asynchronous I/O
Untuk memahami perbedaannya, setiap operasi input (misalnya menerima data dari socket) pada dasarnya melewati 2 fase:
- Waiting for the data to be ready — menunggu data benar-benar tersedia di kernel (misalnya paket sudah sampai dan diproses kernel).
- Copying data from kernel to process — menyalin data yang sudah siap tersebut dari kernel-space ke buffer di user-space (process).
Kelima model I/O di atas berbeda dalam bagaimana masing-masing fase ini ditangani — apakah proses di-blok, di-poll berulang, atau diberi notifikasi.
Blocking I/O
Proses akan ter-blok sepenuhnya sejak memanggil recvfrom hingga data benar-benar diterima (baik fase menunggu data maupun fase copy data ke user space, keduanya membuat proses blok).
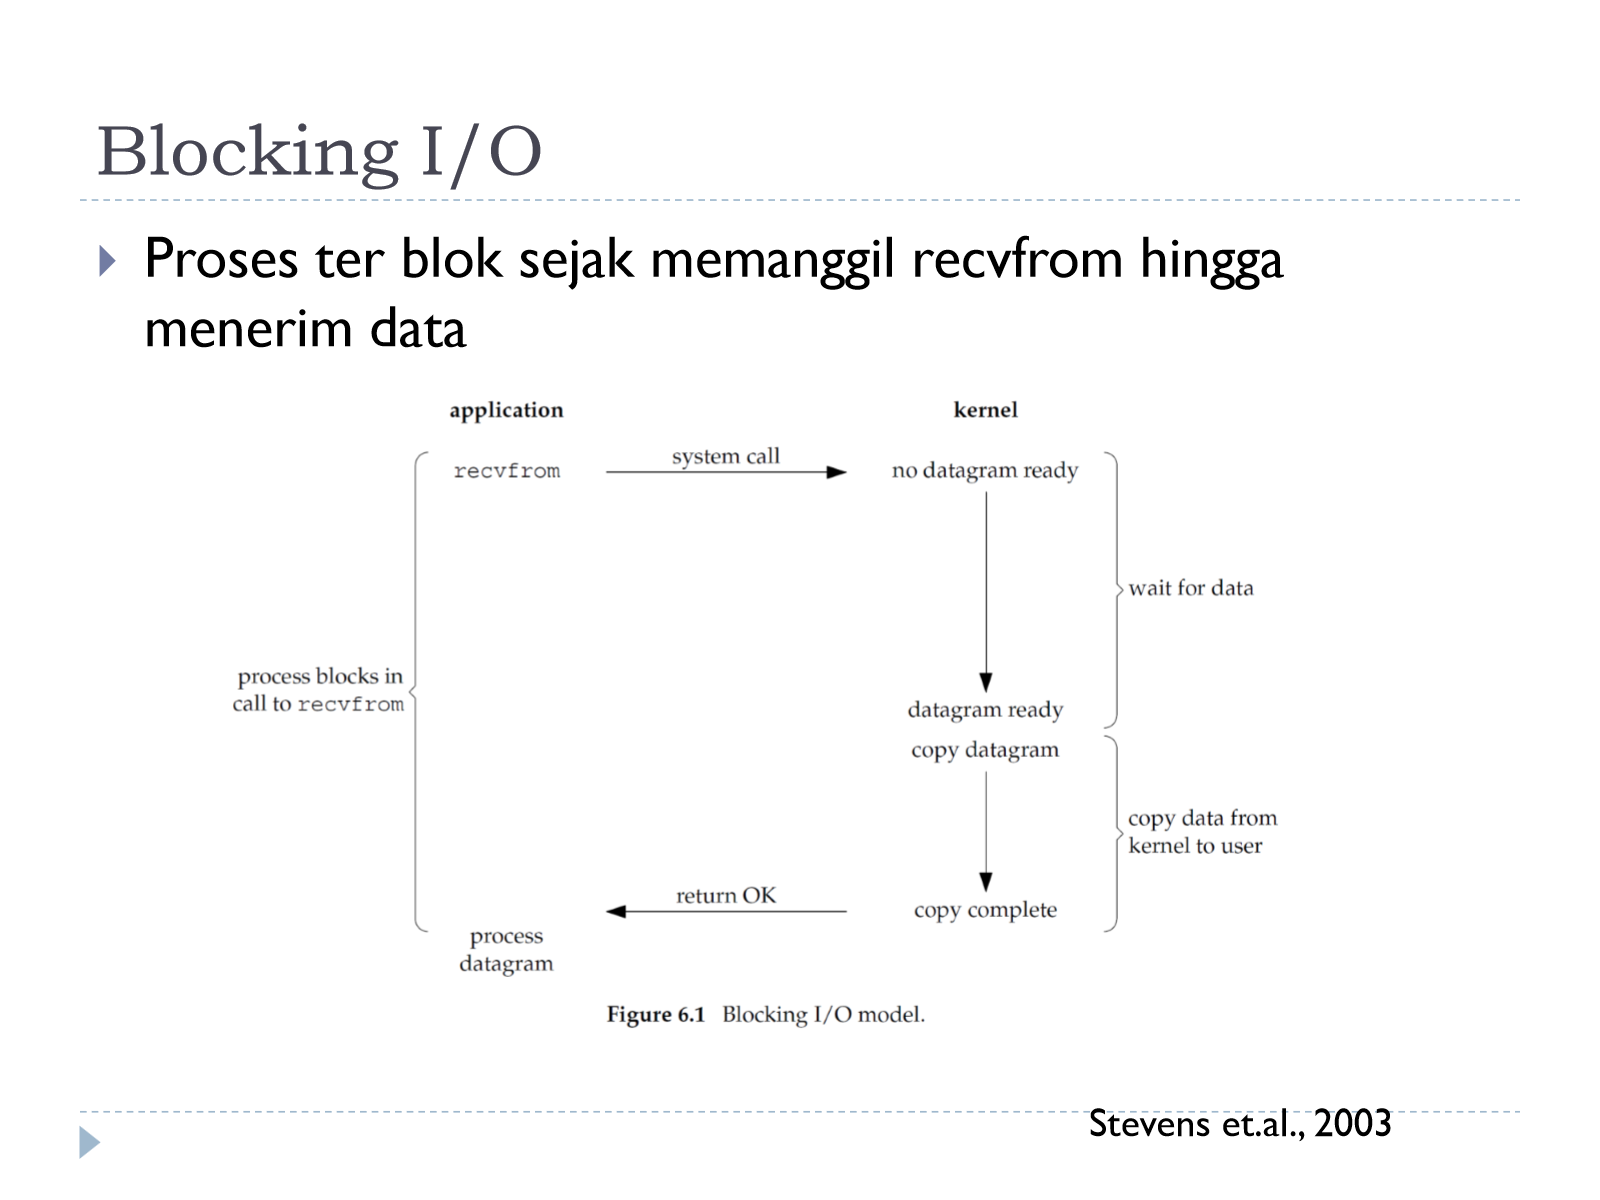
Alur: recvfrom dipanggil → kernel belum punya datagram (no datagram ready) → proses menunggu (blocked) → datagram siap → kernel copy datagram ke user buffer (proses tetap blocked) → copy selesai → recvfrom return OK → proses lanjut mengolah datagram.
Non-blocking I/O
Proses memanggil recvfrom dan langsung mendapat error EWOULDBLOCK jika data belum tersedia (proses tidak diblok, langsung dikembalikan kontrolnya). Proses biasanya melakukan polling — memanggil recvfrom berulang kali sampai mendapat status OK. Begitu data tersedia, panggilan recvfrom akan menunggu (blok) hanya selama fase copy data dari kernel ke user space.
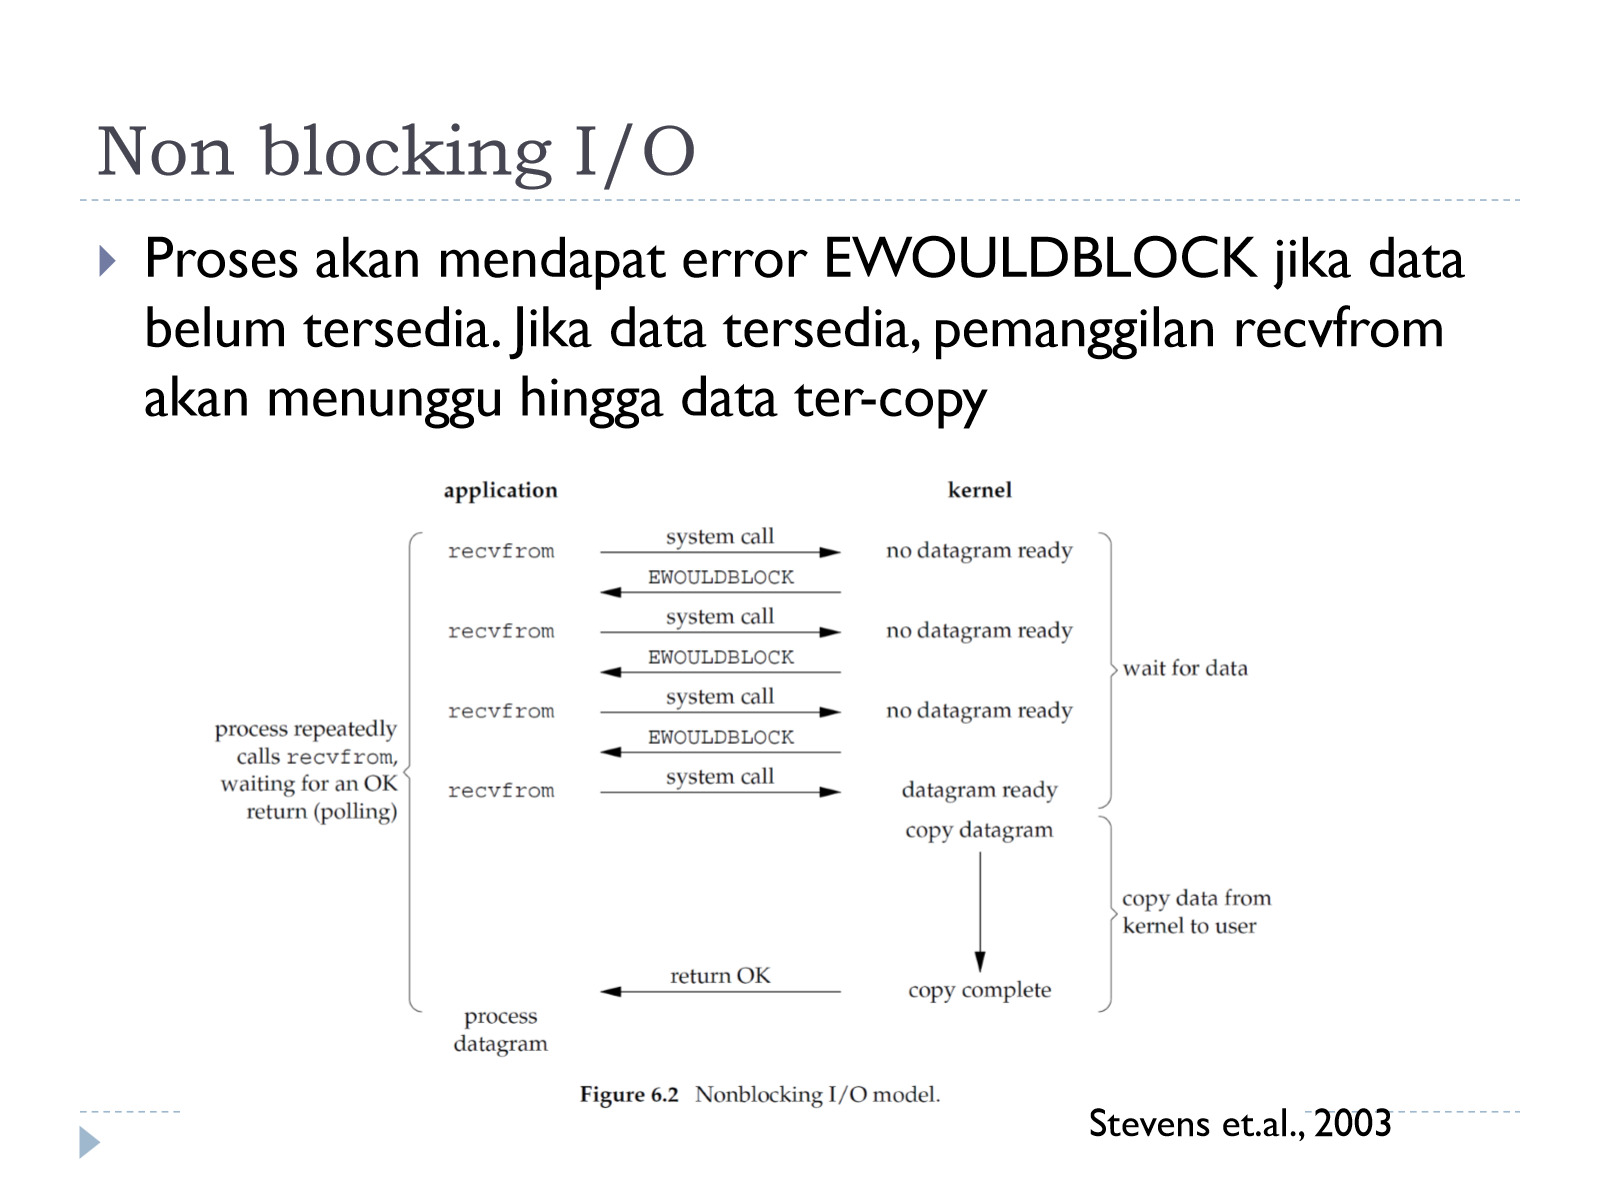
Jadi bedanya dengan blocking I/O: pada fase wait for data, proses tidak diblok melainkan berulang kali mengecek (busy polling) — konsekuensinya proses tetap “sibuk” (menghabiskan CPU cycle) meski tidak sedang benar-benar bekerja produktif.
I/O Multiplexing
Menggunakan pemanggilan select atau poll yang akan blocking hingga ada data yang tersedia pada salah satu dari beberapa socket yang dipantau. Keunggulan utamanya: satu proses bisa menunggu event dari beberapa sumber/socket sekaligus, bukan hanya satu.
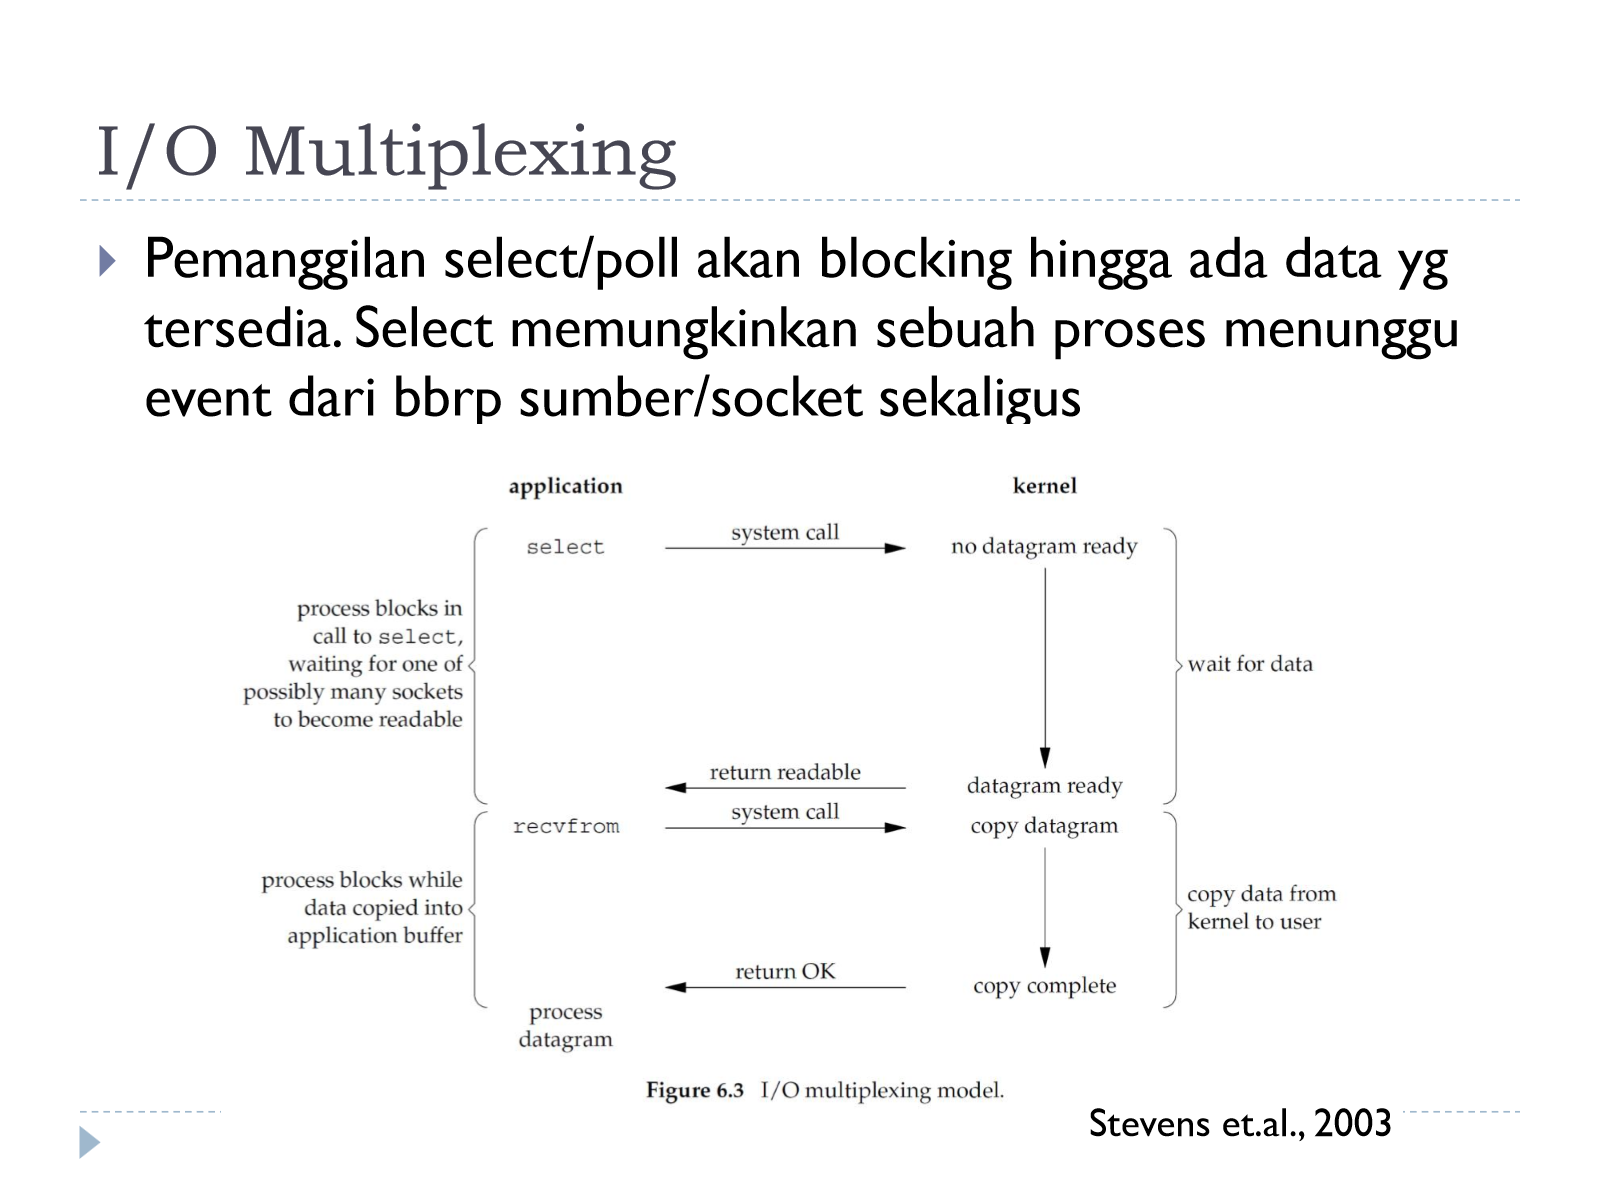
Alur: select dipanggil dengan sekumpulan socket yang ingin dipantau → proses blok di dalam select menunggu salah satu socket menjadi readable → begitu ada socket yang ready, select return dan memberi tahu socket mana yang readable → proses baru memanggil recvfrom pada socket tersebut (blok lagi selama fase copy data).
Catatan penting: I/O multiplexing tidak menghilangkan blocking sepenuhnya, hanya memungkinkan satu titik tunggu untuk banyak descriptor sekaligus, sehingga satu thread/proses bisa melayani banyak koneksi tanpa perlu satu thread per koneksi.
Signal-driven I/O
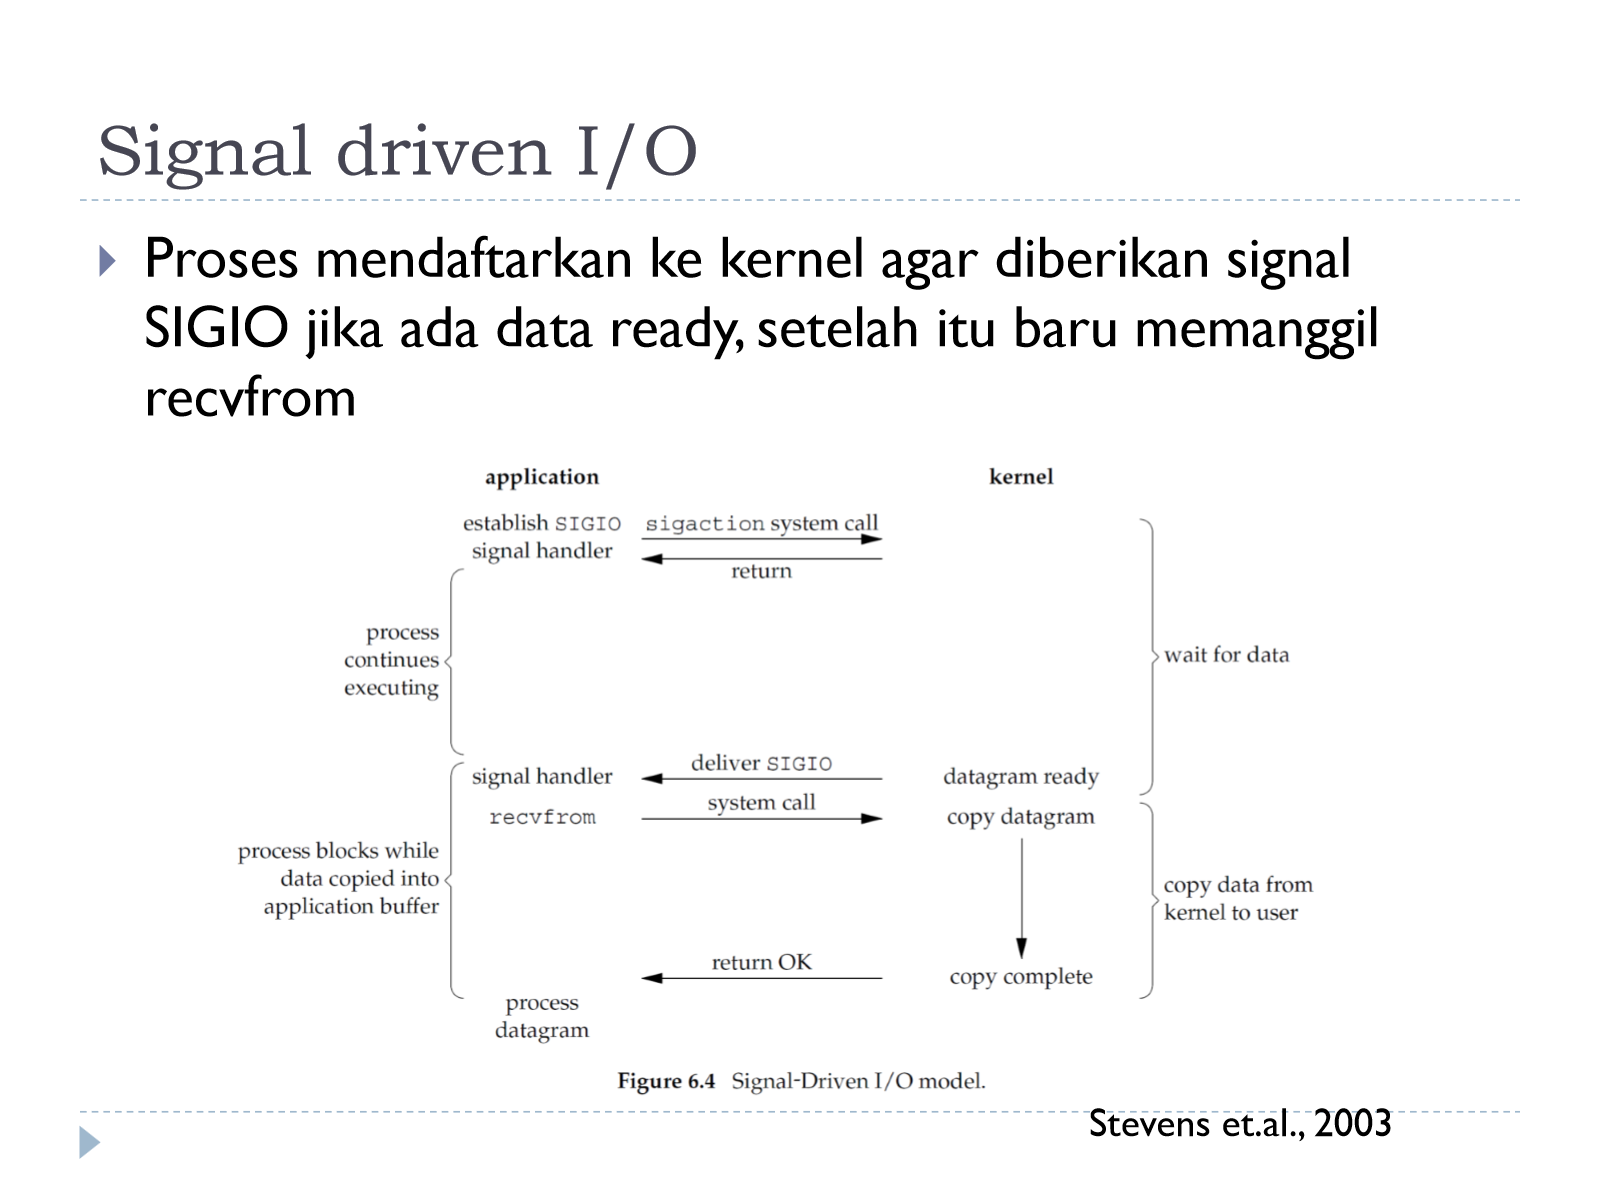
Proses mendaftarkan diri ke kernel (via sigaction) agar diberikan signal SIGIO ketika data sudah ready. Setelah pendaftaran, proses bisa melanjutkan eksekusi lain (tidak blok) sambil menunggu signal tersebut datang. Begitu SIGIO diterima (lewat signal handler), barulah proses memanggil recvfrom untuk benar-benar mengambil data (fase ini tetap blok selama proses copy data).
Asynchronous I/O
Proses memanggil aio_read yang langsung return (tidak blok sama sekali). Kernel akan mengerjakan kedua fase (menunggu data DAN meng-copy data ke buffer user) secara mandiri di background, dan proses hanya menerima notifikasi (via signal handler yang ditentukan) setelah seluruh operasi I/O benar-benar selesai (data sudah ada di buffer user, siap dipakai).
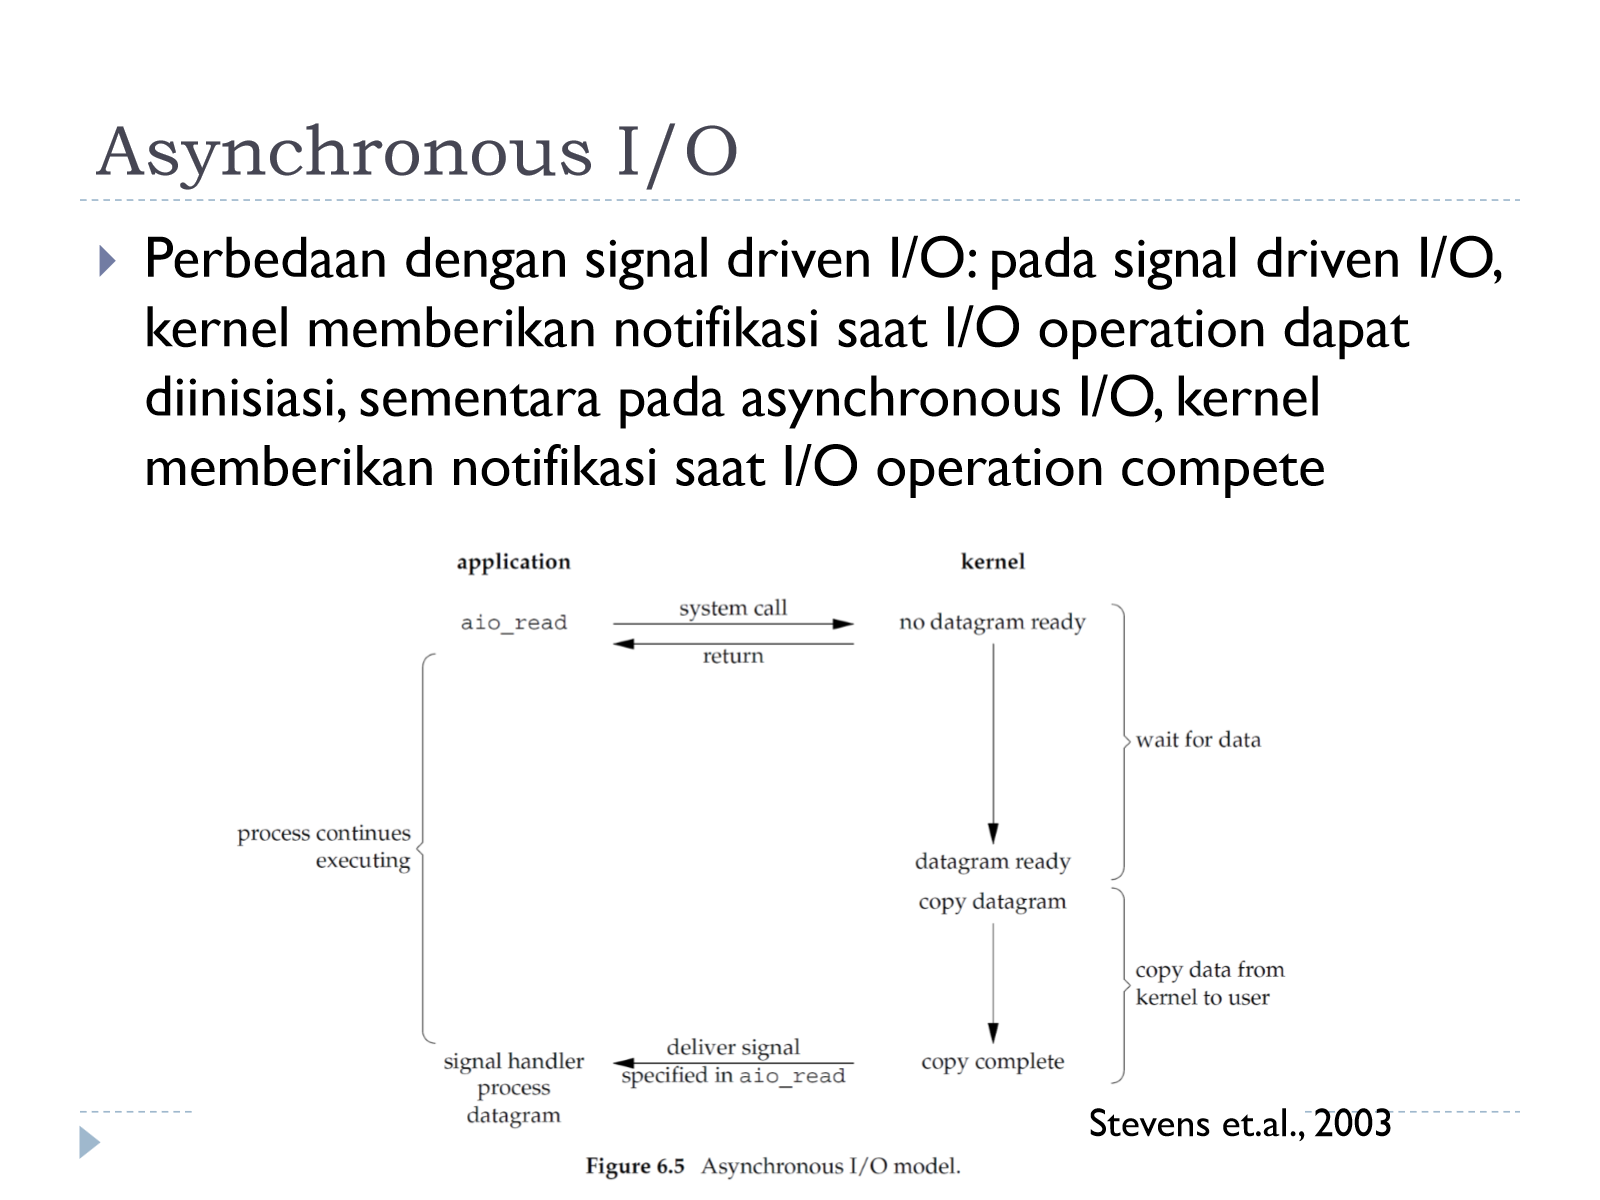
Perbedaan krusial dengan signal-driven I/O: pada signal-driven I/O, kernel memberi notifikasi saat I/O operation dapat diinisiasi (data baru siap dibaca, proses masih harus memanggil recvfrom sendiri dan menunggu fase copy). Pada asynchronous I/O, kernel memberi notifikasi saat I/O operation sudah complete (data sudah di-copy penuh ke user buffer, tidak ada lagi yang perlu dilakukan proses).
Perbandingan 5 Model I/O
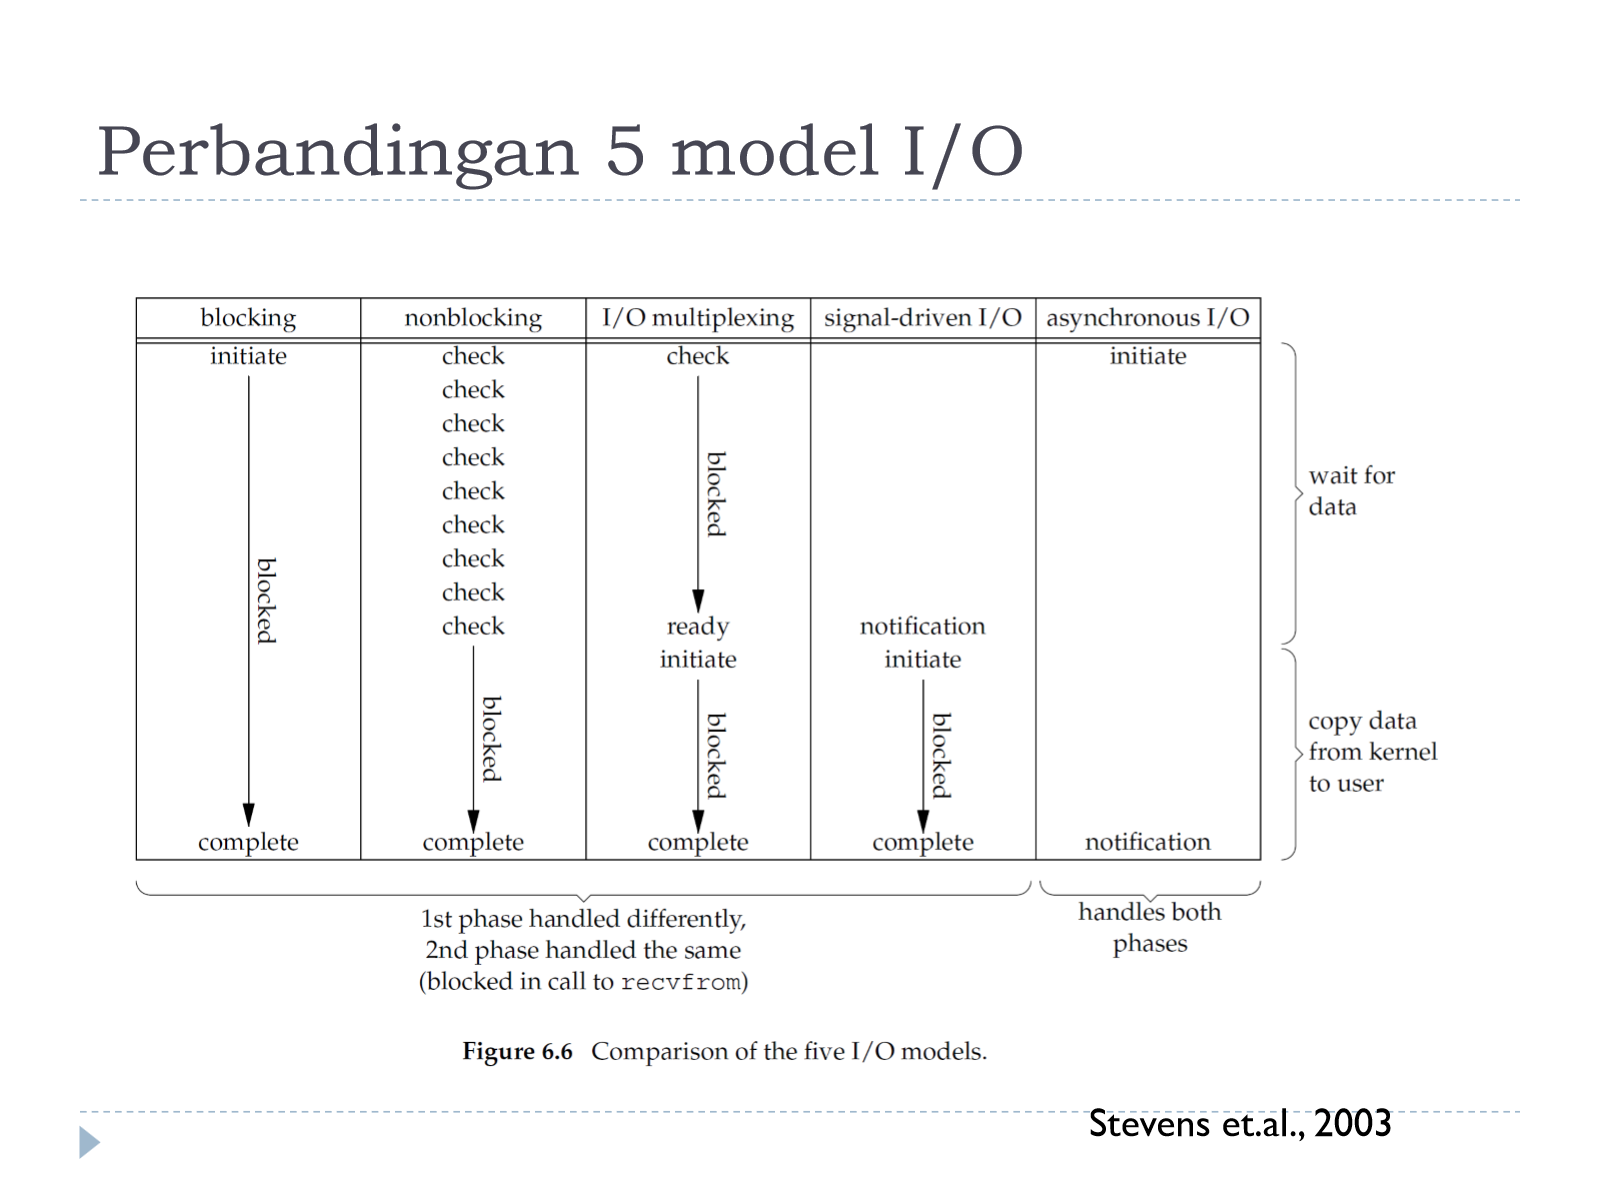
Diagram di atas menunjukkan bahwa 4 model pertama (blocking, non-blocking, I/O multiplexing, signal-driven) menangani fase pertama (wait for data) secara berbeda-beda, namun fase kedua (copy data dari kernel ke user) selalu ditangani sama: proses blok di panggilan recvfrom. Hanya asynchronous I/O yang menangani kedua fase sekaligus secara non-blocking penuh — proses baru mendapat notifikasi setelah semuanya (termasuk copy) selesai.
| Model I/O | Cara Kerja (fase wait for data) | Respons Saat Data Belum Siap | Efisiensi |
|---|---|---|---|
| Blocking I/O | Proses memanggil recvfrom dan langsung diblok kernel sampai data siap | Proses tidak melakukan apa-apa (blocked), tidak ada CPU cycle terbuang, tapi proses tidak bisa mengerjakan tugas lain | Sederhana, tapi 1 proses/thread hanya bisa menangani 1 koneksi pada satu waktu → tidak scalable untuk banyak koneksi |
| Non-blocking I/O | Proses memanggil recvfrom berulang (polling) | Kernel langsung mengembalikan error EWOULDBLOCK, proses bisa lanjut kerja lain lalu polling lagi | Boros CPU karena polling terus-menerus (busy-wait), meski proses “terlihat” tidak blok |
| I/O Multiplexing (select/poll/epoll/kqueue) | Satu panggilan (select/poll) memantau banyak descriptor sekaligus, proses blok di panggilan tsb | Proses blok sampai salah satu dari sekian banyak socket ready (bukan busy-wait) | Efisien untuk banyak koneksi dengan 1 thread, tapi select/poll punya overhead pemeriksaan linear terhadap seluruh descriptor set |
| Signal-driven I/O | Proses daftar handler SIGIO ke kernel lalu lanjut kerja lain, tidak blok menunggu | Kernel mengirim signal SIGIO begitu data siap dibaca; baru setelah itu proses memanggil recvfrom (blok saat copy) | Tidak ada busy-wait maupun blok saat menunggu, tapi implementasi/handling signal lebih rumit dan kurang umum dipakai untuk high-volume I/O |
| Asynchronous I/O | Proses memanggil aio_read dan langsung lanjut kerja lain; kernel menangani wait+copy sepenuhnya | Tidak ada blok sama sekali di kedua fase; notifikasi baru datang setelah I/O (termasuk copy) selesai total | Paling efisien secara teori (tidak ada blocking maupun busy-wait sama sekali), namun dukungan OS/API-nya historisnya lebih terbatas/rumit |
Implementasi I/O Multiplexing
select()
#include <sys/select.h>
int select(int n, fd_set *readfds, fd_set *writefds,
           fd_set *exceptfds, struct timeval *timeout);
select mengembalikan jumlah descriptor yang ready. fd_set adalah array integer yang merepresentasikan kumpulan socket descriptor sebagai kumpulan bit — bit bernilai 1 jika descriptor tersebut sedang diperlukan/dipantau. Manipulasi fd_set dilakukan lewat macro:
void FD_ZERO(fd_set *fdset);
void FD_SET(int fd, fd_set *fdset);
void FD_CLR(int fd, fd_set *fdset);
int  FD_ISSET(int fd, fd_set *fdset);
Contoh membuat fd_set yang berisi descriptor 1, 4, dan 5:
fd_set rset;

FD_ZERO(&rset);      /* initialize the set: all bits off */
FD_SET(1, &rset);    /* turn on bit for fd 1 */
FD_SET(4, &rset);    /* turn on bit for fd 4 */
FD_SET(5, &rset);    /* turn on bit for fd 5 */
Pola penggunaan select: saat pemanggilan, developer menentukan socket mana saja yang dicek untuk kesiapan read, write, dan error. Setelah select return, developer harus memeriksa satu-persatu tiap socket (pakai FD_ISSET) untuk tahu socket mana yang benar-benar punya event.
Contoh penggunaan (menunggu event dari socket dan dari stdin sekaligus):
FD_SET(fileno(fp), &rset);
FD_SET(sockfd, &rset);
maxfdp1 = max(fileno(fp), sockfd) + 1;
Select(maxfdp1, &rset, NULL, NULL, NULL);

if (FD_ISSET(sockfd, &rset)) {   /* socket is readable */
    if (Readline(sockfd, recvline, MAXLINE) == 0)
        err_quit("str_cli: server terminated prematurely");
    Fputs(recvline, stdout);
}

if (FD_ISSET(fileno(fp), &rset)) {  /* input is readable */
    if (Fgets(sendline, MAXLINE, fp) == NULL)
        return;                  /* all done */
    Writen(sockfd, sendline, strlen(sendline));
}
Cara kerja multiplexing secara umum: setiap ada koneksi client baru, server memasukkannya ke dalam daftar watchlist, lalu select dipakai untuk menunggu event dari seluruh koneksi dalam watchlist tersebut sekaligus.
Problem dengan select
selectmengharuskan aplikasi mengirim ulang seluruh set descriptor yang ingin dipantau pada setiap pemanggilan — ini berarti ada two memory copies (user↔kernel) tiap kaliselectdipanggil.- Setelah
selectreturn, aplikasi harus iterasi seluruh descriptor pada list untuk mencari tahu mana saja yang punya event (linear scan, tidak langsung ditunjuk). - Pemanggil harus membangun ulang set descriptor untuk setiap pemanggilan berikutnya.
selectterbatas untuk memantau descriptor saja (socket, file) — signal dan jenis event lain butuh mekanisme terpisah.- Alternatif yang mengatasi keterbatasan ini: poll, epoll, kqueue.
poll
#include <poll.h>
int poll(struct pollfd fds[], nfds_t nfds, int timeout);
// Returns number of ready file descriptors, 0 on timeout, or -1 on error
Descriptor, event yang diminati, dan hasilnya dinyatakan sebagai array of pollfd:
struct pollfd {
    int   fd;        /* File descriptor */
    short events;    /* Requested events bit mask */
    short revents;   /* Returned events bit mask */
};
poll mengatasi sebagian keterbatasan select (tidak dibatasi ukuran fixed seperti fd_set), tapi tetap butuh scan linear atas seluruh array pollfd untuk mencari event yang terjadi.
kqueue
kqueue adalah mekanisme penanganan event yang dikenalkan pada BSD, lebih efisien dan bersifat general purpose (bisa memantau bukan cuma socket/file, tapi juga signal, timer, child process, dll).
Struktur data kevent merepresentasikan sebuah event/interest terhadap event tertentu:
#include <sys/types.h>
#include <sys/event.h>
#include <sys/time.h>

int kqueue(void);
int kevent(int kq, const struct kevent *changelist, int nchanges,
           struct kevent *eventlist, int nevents,
           const struct timespec *timeout);
void EV_SET(struct kevent *kev, uintptr_t ident, short filter,
            u_short flags, u_int fflags, intptr_t data, void *udata);

struct kevent {
    uintptr_t ident;   /* identifier for this event */
    short     filter;  /* filter for event */
    u_short   flags;   /* action flags for kqueue */
    u_int     fflags;  /* filter flag value */
    intptr_t  data;    /* filter data value */
    void      *udata;  /* opaque user data identifier */
};
Poin penting struktur kevent:
- Pasangan
<ident, filter>merepresentasikan identitas sebuah kevent.identbisa berupa file descriptor, process id, atau signal number. filtermengidentifikasikan kernel filter yang dipakai untuk memproses event, misalnyaEVFILT_READatauEVFILT_WRITE.flagsmenyatakan operasi yang diinginkan terhadap kevent, misalnyaEV_ADD,EV_DELETE,EV_ENABLE,EV_ONESHOT,EV_ERROR.keventdapat diset menggunakan macroEV_SET, contoh:
kevent ev;
EV_SET(&ev, sckfd, EVFILT_READ, EV_ADD, 0, 0, 0);
Alur penggunaan kqueue:
- Buat kqueue (menyimpan list event yang ingin dimonitor):
int kq;
if ((kq = kqueue()) == -1) {
    perror("kqueue");
    exit(EXIT_FAILURE);
}- Gunakan
kevent()untuk memanipulasi (mendaftarkan minat) dan sekaligus memonitor kqueue tersebut:
kevent chlist[N]; /* events we want to monitor */
kevent evlist[N]; /* events that were triggered */
int nev, i;

/* populate chlist with the events we are interested in */
/* ... */

/* loop forever */
for (;;) {
    nev = kevent(kq, chlist, N,
                 evlist, N,
                 NULL); /* block indefinitely */

    if (nev == -1) {
        perror("kevent()");
        exit(EXIT_FAILURE);
    } else if (nev > 0) {
        for (i = 0; i < nev; i++) {
            /* handle events */
        }
    }
}
Contoh lengkap memantau timer 5 detik yang berulang, lalu setiap kali timer trigger, melakukan fork dan menjalankan perintah date di child process:
int main(void) {
    struct kevent change; /* event we want to monitor */
    struct kevent event;  /* event that was triggered */
    pid_t pid;
    int kq, nev;

    /* create a new kernel event queue */
    if ((kq = kqueue()) == -1)
        diep("kqueue()");

    /* initalise kevent structure */
    EV_SET(&change, 1, EVFILT_TIMER, EV_ADD | EV_ENABLE, 0, 5000, 0);

    /* loop forever */
    for (;;) {
        nev = kevent(kq, &change, 1, &event, 1, NULL);

        if (nev < 0)
            diep("kevent()");
        else if (nev > 0) {
            if (event.flags & EV_ERROR) { /* report any error */
                fprintf(stderr, "EV_ERROR: %s\n", strerror(event.data));
                exit(EXIT_FAILURE);
            }

            if ((pid = fork()) < 0)      /* fork error */
                diep("fork()");
            else if (pid == 0)           /* child */
                if (execlp("date", "date", (char *)0) < 0)
                    diep("execlp()");
        }
    }
}
Contoh lain: memantau dua sumber sekaligus (socket dan stdin) untuk membangun client interaktif sederhana:
struct kevent chlist[2]; /* events we want to monitor */
struct kevent evlist[2]; /* events that were triggered */
char buf[BUFSIZE];
int sckfd, kq, nev, i;

/* open a connection to a host:port pair */
sckfd = tcpopen(argv[1], atoi(argv[2]));

/* create a new kernel event queue */
if ((kq = kqueue()) == -1)
    diep("kqueue()");

/* initialise kevent structures */
EV_SET(&chlist[0], sckfd, EVFILT_READ, EV_ADD | EV_ENABLE, 0, 0, 0);
EV_SET(&chlist[1], fileno(stdin), EVFILT_READ, EV_ADD | EV_ENABLE, 0, 0, 0);

/* loop forever */
for (;;) {
    nev = kevent(kq, chlist, 2, evlist, 2, NULL);

    if (nev < 0)
        diep("kevent()");
    else if (nev > 0) {
        if (evlist[0].flags & EV_EOF)   /* read direction of socket has shutdown */
            exit(EXIT_FAILURE);

        for (i = 0; i < nev; i++) {
            if (evlist[i].flags & EV_ERROR) {   /* report errors */
                fprintf(stderr, "EV_ERROR: %s\n", strerror(evlist[i].data));
                exit(EXIT_FAILURE);
            }

            if (evlist[i].ident == sckfd) {     /* we have data from the host */
                memset(buf, 0, BUFSIZE);
                if (read(sckfd, buf, BUFSIZE) < 0)
                    diep("read()");
                fputs(buf, stdout);
            } else if (evlist[i].ident == fileno(stdin)) { /* we have data from stdin */
                memset(buf, 0, BUFSIZE);
                fgets(buf, BUFSIZE, stdin);
                sendbuftosck(sckfd, buf, strlen(buf));
            }
        }
    }
}
epoll
epoll adalah mekanisme setara kqueue tapi khusus Linux:
#include <sys/epoll.h>

int epoll_create(int size);
// Returns file descriptor on success, or -1 on error

int epoll_ctl(int epfd, int op, int fd, struct epoll_event *ev);
// Returns 0 on success, or -1 on error

int epoll_wait(int epfd, struct epoll_event *evlist, int maxevents, int timeout);
// Returns number of ready file descriptors, 0 on timeout, or -1 on error
Pola pemakaian mirip kqueue: epoll_create membuat epoll instance, epoll_ctl dipakai untuk mendaftar/menghapus/mengubah minat terhadap suatu descriptor, dan epoll_wait dipakai untuk menunggu (blok) hingga ada descriptor yang ready — mengembalikan langsung daftar descriptor yang ready (tidak perlu scan linear seperti select).
Level-Triggered vs Edge-Triggered
Ketika sebuah paket datang berisi N bytes, sistem memberi notifikasi ke aplikasi. Jika aplikasi hanya membaca B < N bytes, maka tersisa N−B bytes yang belum terbaca. Ini memunculkan dua model triggering:
- Level-triggered: event dibangkitkan berdasarkan level/status — selama masih ada data yang belum dibaca (buffer belum kosong), notifikasi akan terus muncul setiap kali dicek.
- Edge-triggered: event dibangkitkan hanya berdasarkan perubahan level/status — notifikasi hanya muncul sekali saat status berubah (misalnya dari “tidak ada data” menjadi “ada data”), sehingga aplikasi wajib membaca seluruh data yang tersedia dalam satu kesempatan, kalau tidak sisa data tidak akan memicu notifikasi baru.
Event Handling Library
Untuk menyederhanakan pemakaian berbagai mekanisme event handling OS yang berbeda-beda (select/poll/epoll/kqueue), tersedia library pembungkus seperti libevent dan libev.
Pada libev, konsep utamanya adalah watcher — catatan tentang minat terhadap suatu event tertentu. Jenis-jenis event yang didukung antara lain:
- I/O (
ev_io) - Timer (
ev_timer) - Periodic (
ev_periodic) - Signal (
ev_signal) - Child process (
ev_child) - File status (
ev_stat)
Thread vs Event
Perdebatan mendasar dalam mendesain server berkonkurensi tinggi: gunakan satu thread per koneksi (thread-based) atau satu event loop yang menangani banyak koneksi (event-based)?
Model Thread
- Satu thread per sequence of related events (misalnya satu thread per koneksi TCP client).
- Ketika I/O berikutnya belum ready, thread tersebut diblok sampai ready.
- State machine implisit dalam alur program sekuensial — misalnya: parse HTTP request → kirim query DB → baca dari disk → kirim HTTP response, ditulis sebagai kode linear biasa.
- Thread hanya perlu melacak operasi I/O berikutnya yang relevan (tidak perlu state eksplisit).
- Shared state apa pun harus disinkronisasi (karena banyak thread berjalan concurrent).
- Secara teori, scaling dilakukan dengan menambah satu thread per koneksi.
Model Event
- Satu event loop menunggu event berikutnya (dari semua sumber event).
- Ketika sebuah event datang, event tersebut ditangani hingga selesai (“completion”) — misalnya kembali ke event handler alih-alih blok.
- Event loop melacak state machine secara eksplisit — cara menangani sebuah event tergantung pada state saat ini.
- Satu thread bisa menangani jumlah event konkuren yang (secara teori) tak terbatas.
- Secara teori, tidak perlu sinkronisasi karena tiap event handler mengakses state secara non-concurrent (satu handler jalan sampai selesai sebelum handler berikutnya jalan).
- Secara teori, scaling dilakukan dengan menambah satu event loop per CPU core.
Perbandingan Thread vs Event per Aspek
Perbandingan dilakukan dari sudut pandang usability: mana yang lebih mudah diprogram, ditinjau dari 5 aspek: performance, control flow, synchronization, state management, dan scheduling.
| Aspek | Thread | Event |
|---|---|---|
| Performance | Abstraksi lebih berat terhadap hardware — blocking I/O secara alami “menerjemahkan” ke polling (padahal itu bukan yang diinginkan); context switching bisa mahal; operasi sistem untuk thread sering O(n), meski ini bukan hal yang fundamental (bisa diperbaiki) | Abstraksi memetakan lebih rapi ke sebagian besar hardware (dengan interrupt dimatikan, sebuah CPU core pada dasarnya adalah sistem event); hasilnya lebih mudah diimplementasi secara efisien; kompleksitas dilempar ke level aplikasi (bisa jadi baik untuk aplikasi); operasi bisa O(n) terhadap jumlah tipe event, tapi ini sudah diperbaiki dalam dekade terakhir |
| Control Flow | Linear control flow tersirat (lakukan I/O ini, lalu itu, lalu itu) — ini pola paling umum dan mudah didukung (call/return, parallel calls, pipelines); flow yang lebih kompleks (dynamic fan-in/fan-out) tidak cocok dengan model ini | Tidak ada control-flow tertentu yang tersirat — mendukung call/return, parallel, pipelines, maupun fan-in/fan-out; namun dalam praktiknya control-flow kompleks jarang dipakai, sedangkan control-flow sederhana justru “lebih sulit” diprogram dengan event (exception & error handling jadi sangat sulit) |
| Synchronization | Sinkronisasi antar thread itu sulit (locks, condition variables, channels), sulit dinalar, dan sangat sulit di-test; sinkronisasi kadang diperlukan meski secara fundamental tidak perlu (misalnya pada uniprocessor) | Sinkronisasi “gratis” pada single thread of execution — tidak perlu sinkronisasi atas shared state; TAPI ini hanya benar untuk uniprocessor — server yang scalable biasanya multi-core, dan event-loop multi-core tetap butuh sinkronisasi eksplisit |
| State Management | State terenkapsulasi otomatis di stack — programmer tidak perlu memikirkan state apa yang harus dilacak antar I/O (tersirat di local variable); tapi tiap thread butuh stack sendiri — masalah menentukan ukuran stack yang pas (terlalu kecil → stack overflow, terlalu besar → boros memori) | Programmer harus melacak state secara eksplisit (disebut “stack ripping”) menggunakan variabel global/shared — bisa membuat state sulit dilacak terutama jika state-space besar; namun tidak perlu stack terpisah per “thread of control”, sehingga penggunaan memori bisa optimal |
| Scheduling | Biasanya dijadwalkan preemptively oleh sistem — memberi isolasi performa (thread dengan komputasi panjang tidak membuat thread lain starvation); programmer tidak perlu memikirkan scheduling; tapi butuh worst-case context switching, dan keputusan scheduling sistem bisa suboptimal untuk kebutuhan aplikasi | Dijadwalkan secara cooperative — event handler “menyerahkan” kontrol dengan cara return ke event loop; handler berikutnya baru jalan setelah handler sebelumnya selesai; keputusan scheduling diserahkan ke aplikasi (event loop bisa memprioritaskan event yang menguntungkan) — tapi ini hanya berlaku jika kita menulis event loop sendiri; fairness sulit dicapai dan sulit di-debug/test regresinya |
Ringkasan Trade-off Threads vs Events
Event-based programming unggul dalam hal:
- Sinkronisasi murah, karena multitasking dilakukan secara kooperatif — tidak perlu menyimpan informasi konteks yang tidak perlu.
- Overhead ringan untuk pengelolaan state (tidak butuh banyak stack).
- Scheduling dan locality yang lebih baik, karena bisa memanfaatkan informasi level aplikasi.
- Control flow lebih fleksibel (tidak hanya call/return).
Thread-based programming unggul dalam hal:
- Abstraksi yang lebih natural (mengikuti alur berpikir sekuensial manusia).
- Peluang improvement dari compiler dan runtime system untuk mencapai performa lebih baik ke depannya (thread bukan secara fundamental lebih lambat, hanya implementasinya historisnya lebih berat).
Contoh Perbandingan Desain Server Nyata
Apache
Apache mendukung kombinasi multiprocess–multithreads: konfigurasi mengatur jumlah proses dan jumlah thread yang dibuat pada thread pool. Implementasi alokasi proses ini disediakan lewat MPM (Multi-Processing Modules), yang punya beberapa varian:
- MPM prefork — menggunakan preforking process, non-threaded (dipakai Apache 1.3).
- MPM worker — menggunakan server multi-process multi-threaded.
- MPM event — menggunakan pendekatan event based/multiplexing.
Ini menunjukkan bagaimana satu server yang sama bisa mendukung ketiga model (1p1c prefork, prethread, hingga event-based) tergantung modul yang dipilih.
Nginx
Nginx dirancang khusus untuk menangani concurrent request dalam jumlah besar, dengan pendekatan event based. Nginx menggunakan sejumlah worker threads, di mana masing-masing worker mampu menerima multiple connections sekaligus (bukan 1 thread = 1 koneksi).
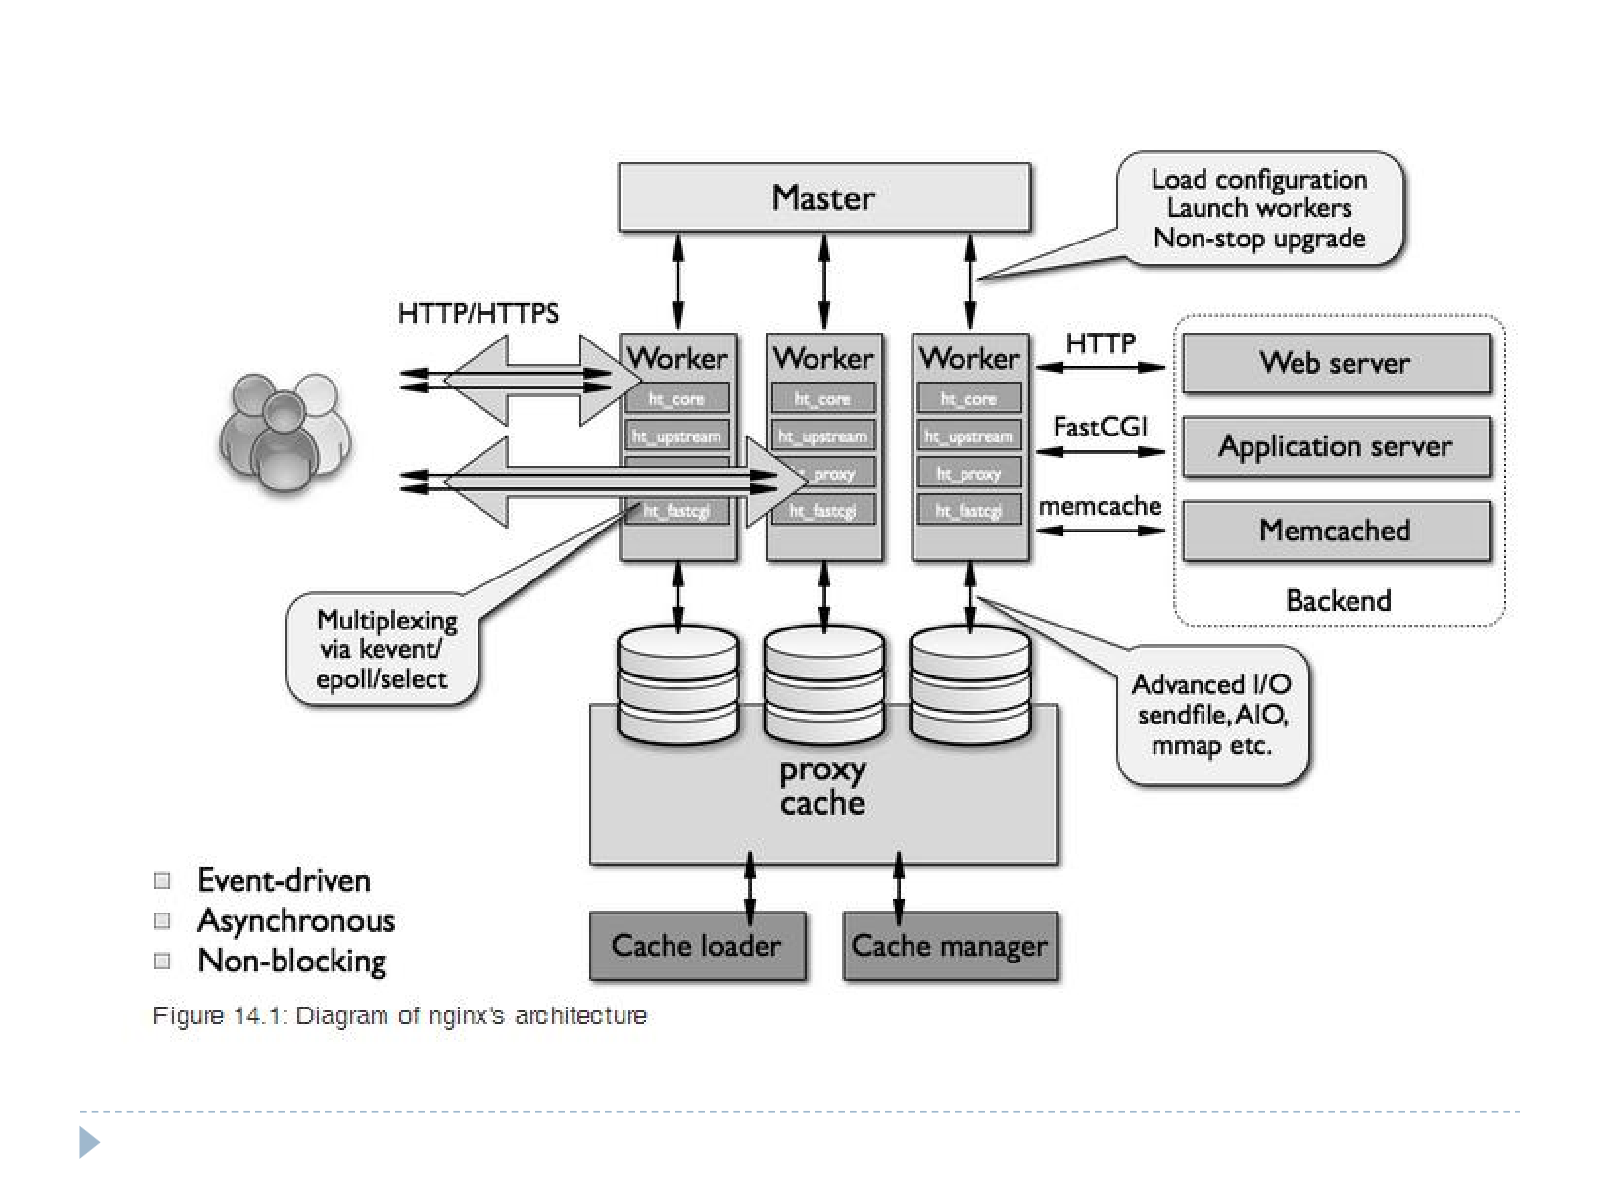
Karakteristik arsitektur Nginx (dari diagram di atas):
- Event-driven — worker menggunakan multiplexing (
kevent/epoll/select) untuk memantau banyak socket sekaligus. - Asynchronous dan non-blocking.
- Ada satu proses Master yang bertugas load configuration, launch workers, dan menangani non-stop upgrade.
- Setiap worker memiliki run loop yang mengecek aktivitas pada sejumlah socket yang di-share bersama (shared listening socket antar worker).
- Worker berkomunikasi ke backend (web server, application server, memcached) via HTTP, FastCGI, atau protokol memcache, serta memakai fitur advanced I/O (sendfile, AIO, mmap) untuk efisiensi akses proxy cache.
Perbandingan implisit Apache vs Nginx: Apache secara tradisional condong ke model process/thread-per-connection (meski kini juga punya mode event), sedangkan Nginx sejak awal didesain event-based — sejalan dengan argumen bahwa event-based lebih hemat resource untuk menangani concurrent connection dalam jumlah sangat besar (mengatasi C10K problem), karena tidak perlu mengalokasikan satu thread/proses penuh untuk tiap koneksi yang sebagian besar waktunya idle menunggu I/O.
Flashcard
flashcards Apa itu C10K problem? :: Masalah mendesain socket server yang mampu menangani concurrent connection dalam jumlah sangat besar (sekitar 10 ribu koneksi bersamaan), dengan bottleneck utama pada data copies, context switches, memory allocation, dan lock contention. Apa perbedaan 1 process/client biasa dengan 1 process/client dengan preforking? :: Pada model biasa, server melakukan fork() setiap kali ada koneksi baru masuk (overhead fork per koneksi). Pada preforking, sejumlah proses child sudah dibuat di awal sebelum ada koneksi, masing-masing langsung menunggu (accept) pada listening socket yang sama, sehingga tidak ada overhead fork saat koneksi baru datang. Mengapa model 1 thread/1 process per client tidak scalable untuk banyak koneksi? :: Karena aplikasi jaringan bersifat I/O bound — sebagian besar waktu thread/process idle menunggu I/O (misalnya menunggu client menerima response), sehingga resource (memori) yang dialokasikan per thread/proses banyak terbuang percuma saat jumlah koneksi besar; ditambah lagi persistent connection membuat jumlah koneksi aktif makin besar. Sebutkan 2 fase yang selalu ada dalam sebuah operasi input, dan bagaimana kelimanya model I/O berbeda menanganinya? :: (1) Waiting for the data to be ready, (2) Copying data from kernel ke user process. Blocking, non-blocking, I/O multiplexing, dan signal-driven menangani fase pertama secara berbeda-beda namun fase kedua selalu blocking (via recvfrom); hanya asynchronous I/O yang menangani kedua fase secara non-blocking penuh, notifikasi baru datang setelah keduanya selesai. Apa perbedaan mendasar antara Non-blocking I/O dan I/O Multiplexing? :: Non-blocking I/O mengharuskan proses melakukan polling berulang (memanggil recvfrom berkali-kali, menerima EWOULDBLOCK sampai data siap) — boros CPU. I/O multiplexing (select/poll) memakai satu panggilan yang blok menunggu sampai salah satu dari banyak socket menjadi ready, tanpa perlu busy-polling, dan bisa memantau banyak socket sekaligus dalam satu panggilan. Apa perbedaan signal-driven I/O dan asynchronous I/O? :: Signal-driven I/O: kernel mengirim notifikasi (SIGIO) saat data SUDAH BISA MULAI dibaca, tapi proses tetap harus memanggil recvfrom sendiri dan blok selama fase copy data. Asynchronous I/O: kernel menangani seluruh proses (menunggu data + copy data ke user buffer) sendiri, dan proses baru diberi notifikasi setelah SELURUH operasi (termasuk copy) benar-benar selesai. Sebutkan 3 kelemahan utama select() dibanding epoll/kqueue. :: (1) Harus mengirim ulang seluruh set descriptor pada setiap pemanggilan (two memory copies user-kernel tiap kali), (2) aplikasi harus iterasi/scan seluruh descriptor list untuk menemukan yang ready, (3) terbatas hanya untuk descriptor (socket/file), tidak bisa memantau signal atau event lain secara langsung. Mengapa model event dianggap lebih scalable dibanding model thread untuk server dengan concurrency tinggi? :: Karena satu thread/event loop bisa menangani banyak koneksi sekaligus tanpa perlu stack terpisah per koneksi (memori lebih optimal), sinkronisasi menjadi murah/tidak perlu selama single-threaded (multitasking kooperatif), dan tidak ada overhead context-switching antar thread — cocok dengan sifat aplikasi jaringan yang I/O bound. Sebutkan trade-off utama thread vs event dari sisi state management. :: Thread: state otomatis terenkapsulasi di stack sehingga programmer tidak perlu melacak state secara eksplisit, tapi harus menentukan ukuran stack yang tepat per thread. Event: programmer harus melacak state secara eksplisit (“stack ripping”) lewat variabel global/shared yang bisa sulit dikelola pada state-space besar, tapi tidak butuh stack terpisah sehingga memori lebih optimal. Bagaimana Apache dan Nginx merepresentasikan pendekatan yang berbeda dalam menangani concurrency? :: Apache secara tradisional mendukung model multiprocess-multithread lewat MPM (prefork = process-based non-threaded, worker = multi-process multi-threaded, event = event-based). Nginx sejak awal didesain event-based dengan sejumlah worker thread yang masing-masing mampu menangani banyak koneksi sekaligus menggunakan multiplexing (epoll/kqueue/select), lebih sesuai untuk concurrent request skala besar. Apa perbedaan level-triggered dan edge-triggered pada mekanisme notifikasi event I/O? :: Level-triggered: notifikasi terus muncul selama status/level masih terpenuhi (misal masih ada data belum dibaca di buffer). Edge-triggered: notifikasi hanya muncul sekali saat terjadi perubahan status (misal dari tidak-ada-data menjadi ada-data), sehingga aplikasi wajib membaca semua data yang tersedia dalam satu kesempatan atau sisa data tidak akan memicu notifikasi baru.