Materi ini menggabungkan dua sumber tentang Microservices (varian slide tahun berbeda): satu berfokus pada definisi formal dan pattern-pattern arsitektural (decomposition, composition, database, observability, cross-cutting concern), satu lagi adalah studi kasus praktis dari Netflix (skala, tantangan nyata, best practice, dan tools open source seperti Eureka, Hystrix, Ribbon). Topik ini adalah inti dari capaian mendesain layanan terdistribusi & microservices — hampir semua pattern di sini sangat sering muncul di ujian.
Masalah Monolithic Architecture
Pembagian typical aplikasi umumnya terdiri dari Front End, Back End, dan Database. Pada aplikasi besar, modul-modul dalam tier frontend dan backend sering tightly coupled meski dikembangkan oleh tim berbeda. Penambahan fitur mengharuskan koordinasi antar tim, membuat proses deployment menjadi lebih kompleks dan lama.
Contoh arsitektur monolith (kasus Netflix, sebelum migrasi ke microservices): satu Monolithic App berisi banyak komponen (Account, Catalog, Recommendation, Customer Service) yang semuanya duduk di belakang satu Load Balancer dan berbagi satu Database.
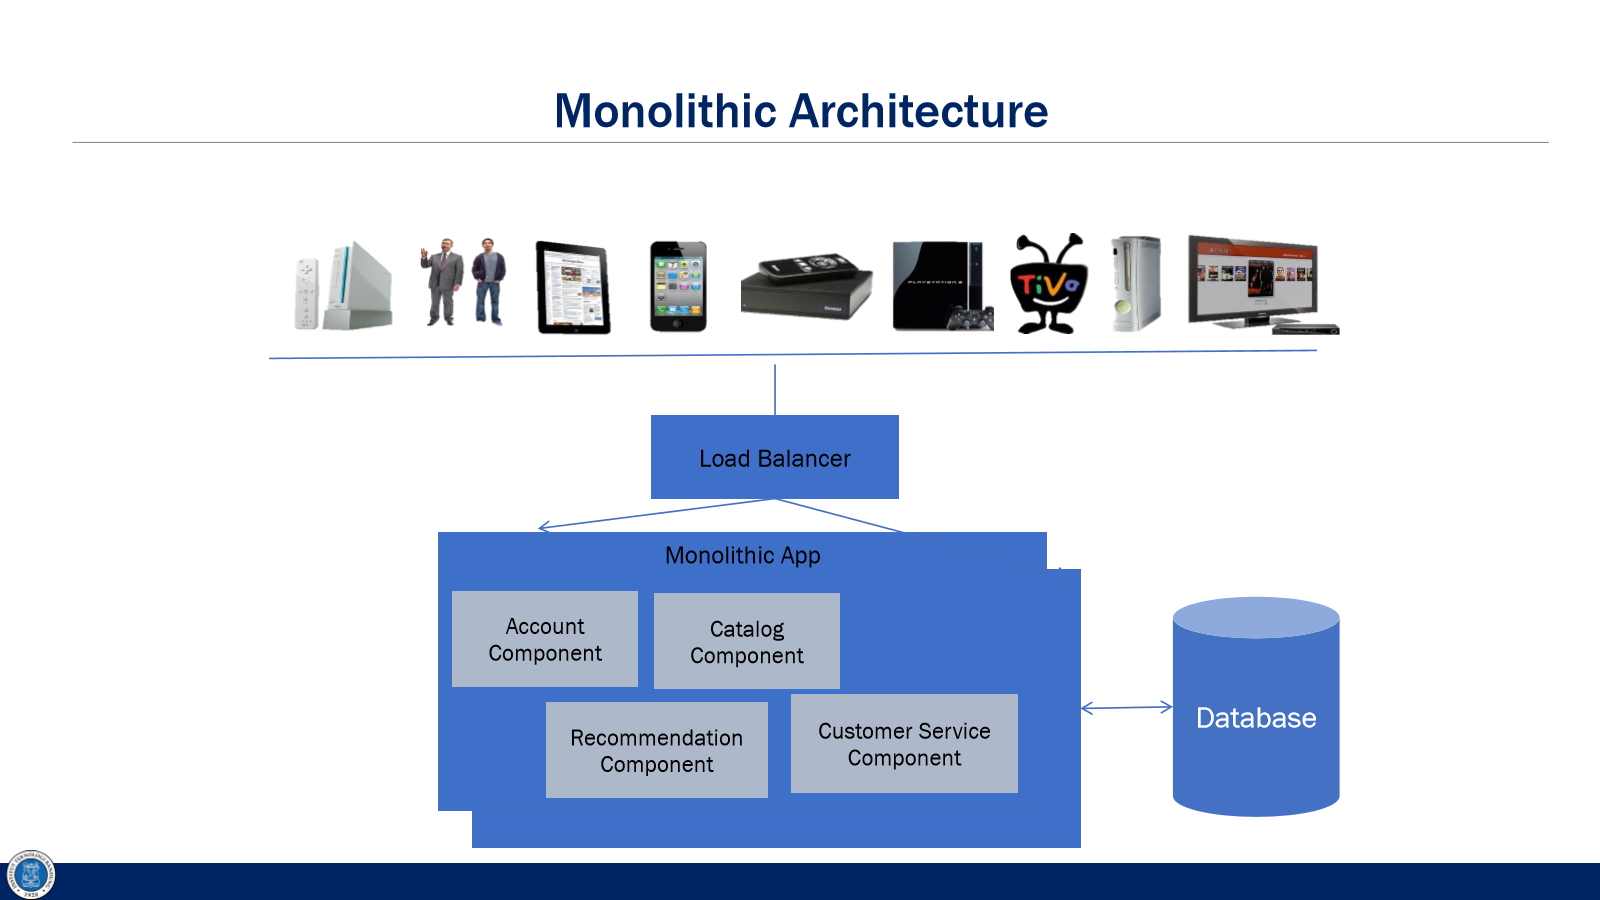
Karakteristik monolith:
- Large codebase — satu basis kode besar untuk seluruh aplikasi.
- Many components, no clear ownership — banyak komponen tanpa kepemilikan yang jelas.
- Long deployment cycles — siklus deployment panjang karena semua komponen harus di-build & dirilis bersamaan.
Kelebihan (Pros) monolith:
- Single codebase → mudah develop/debug/deploy, dukungan IDE baik.
- Mudah di-scale horizontal, meski hanya secara “un-differentiated” (semua komponen di-scale bersamaan, tidak bisa dipilih-pilih).
- Satu tim Ops terpusat dapat mengelola dengan efisien.
Mengapa monolith bermasalah (Why not Monolith):
- Sulit untuk frequent deployment dan continuous delivery.
- Sulit untuk pengelolaan dan perawatan; umumnya harus memakai teknologi yang sama di seluruh komponen.
- Less reliability — perubahan oleh 1 tim membutuhkan koordinasi dan approval dari tim lain.
- Scalability memerlukan cost lebih besar (karena scaling tidak bisa selektif — “Cant scale Product Catalog differently from Customer Service”).
- Bug tracking dan perbaikan lebih sulit.
- Seiring bertambahnya codebase, komponen cenderung semakin tightly coupled — seperti gerbong-gerbong kereta yang harus memakai bahasa/rel yang sama.
- Availability rapuh: sebuah bug sekecil satu tanda titik-koma (
;) yang hilang pernah membuat seluruh website Netflix down selama berjam-jam (~2008) — satu request yang buruk/lambat bisa memblokir seluruh app container karena semua thread berbagi resource yang sama.
Tipping point menuju microservices biasanya terjadi karena kombinasi: organizational growth (tim makin besar), diverse functionality (fitur makin beragam), dan bottleneck pada monolithic stack. Pada Amazon, hal ini melahirkan Bezos Platform Mandate: semua tim wajib meng-ekspos data lewat interface, tidak ada bentuk komunikasi antar-proses lain yang diizinkan, semua interface harus externalizable — siapa yang tidak mengikuti akan dipecat.
Catatan penting: skala Netflix di tahun 2008 masih berupa satu .war file di data center; sekitar 2010 mereka pindah ke AWS Cloud dengan ratusan fine grained services. Saat ini Netflix memiliki >500 microservices, dikelola oleh ~30 tim engineering, melayani ~2 miliar edge API request/hari.
Apa Itu Microservices
“…the microservice architectural style .. is an approach to developing a single application as a suite of small services, each running in its own process and communicating with lightweight mechanisms, often an HTTP resource API…” — Martin Fowler
Definisi lain: microservices adalah “small, independently deployed components that deliver one or a small number of bounded digital capabilities”. Driver utamanya adalah koordinasi antar tim — prinsip 1 microservice : 1 team, mengikuti Amazon two-pizza rule (satu tim cukup diberi makan oleh dua pizza).
Microservices bukan soal:
- Ukuran tim
- Jumlah baris kode
- Jumlah API/endpoint
Melainkan soal bounded context, karena bisa saja ada “MegaService” yang tetap disebut microservice selama ia satu tanggung jawab dan independen.
Karakteristik microservices:
- Banyak service kecil (fine grained) dengan cakupan jelas — Single Responsibility Principle.
- Domain Driven Development dan Bounded Context.
- Independently managed, dengan kepemilikan (ownership) yang jelas per service.
- Umumnya mengadopsi model DevOps.
Composability — filosofi Unix: “Write programs that do one thing and do it well. Write programs to work together.” Sama seperti pipeline command Unix (tr | sort | uniq | comm), microservices idealnya adalah unit kecil yang dikomposisikan menjadi kapabilitas lebih besar.
Key Enabler Microservices
- Ketersediaan teknologi container, container orchestration, dan platform manajemen container — deployment time container jauh lebih cepat dibanding VM atau bare metal.
- Ketersediaan model komunikasi yang beragam & efisien: synchronous & asynchronous, berbagai format data (JSON, XML, binary, Protobuf, Avro), serta tooling API modern (Thrift, gRPC).
Evolusi dari Monolith ke SOA ke Microservices
- Monolith → tightly coupled, monolithic scaling.
- SOA (Service-Oriented Architecture) membawa pemisahan tapi little empowerment: service lebih course-grained, reusable, dan lebih scalable, tapi masih coupled melalui orkestrasi, dan masih berbagi server/DB/data yang sama. SOA service umumnya diperlakukan sebagai proyek — tim pindah setelah scope proyek selesai.
- Microservices membawa platform for the business: agility, tidak terikat pada server/tools/DB tertentu tiap tim bebas memilih. Microservices dan API-nya harus dikelola sebagai produk — “Build it, Run it, Own it”: satu tim produk memiliki service-nya dari awal (conception) sampai pensiun (retirement).
Smart Endpoints, Dumb Pipes
Prinsip loose coupling sejati pada microservices tercermin dari desain Public API:
- Simple & stateless (RESTful) — sedikit coupling terhadap proses (berbeda dari SOAP/Web services klasik), didesain outside-in berdasarkan cara ia dikonsumsi.
- Bullet proof — punya built-in error handling/checking.
- Didesain dari luar ke dalam (product-first), berubah sangat lambat agar mengisolasi consumer dari perubahan internal.
- Self described — dokumentasi API standar (mis. Swagger), mudah dicari lewat repository, self-testing.
- All reuse dikonfigurasi, bukan di-coding — security, identity, composition, policy/SLA, auditing, analytics semua diatur via konfigurasi.
Untuk komunikasi private API antar service internal, prinsipnya adalah “smart endpoints, dumb pipes”: kecerdasan/logic ada di endpoint (service), bukan di middleware transportnya — no intelligent middleware. Konsekuensinya, microservices harus didesain untuk gagal (designed for failure): service lain bisa dan akan gagal, jangan bergantung pada ketersediaannya, uji dengan stress test & simulasi kegagalan (lihat circuit breaker di bagian pattern).
Desain security juga harus mengasumsikan API bersifat publik (design security assuming it’s public): threat protection (OWASP top 10), identity management (AAA, OAuth 2.0), jangan asumsikan akses internal otomatis aman, serta pastikan auditability & compliance — “the real firewall” justru ada di lapisan microservices itu sendiri, bukan cuma di edge.
Perbandingan Monolithic vs Microservices
| Aspek | Monolithic Architecture | Microservices Architecture |
|---|---|---|
| Codebase | Satu codebase besar, semua komponen jadi satu | Banyak codebase kecil, satu per service |
| Deployment | Deploy seluruh aplikasi sekaligus, siklus panjang | Deploy independen per service, siklus cepat |
| Scaling | Undifferentiated — semua komponen discale bersamaan | Selektif — tiap service discale sesuai kebutuhannya |
| Database | Umumnya satu database bersama | Idealnya database per service |
| Teknologi | Harus seragam (1 bahasa/stack) untuk semua komponen | Polyglot — tiap service bebas memilih bahasa/stack |
| Kegagalan/Availability | Satu bug bisa menjatuhkan seluruh aplikasi | Fault isolation — kegagalan 1 service tidak otomatis menjatuhkan semua (bila diarsitekturkan dengan benar) |
| Ownership tim | Banyak tim mengerjakan 1 basis kode, perlu banyak koordinasi | 1 service dimiliki 1 tim (product ownership) |
| Kompleksitas | Kompleksitas ada di dalam 1 aplikasi (internal) | Kompleksitas berpindah ke pengelolaan banyak service (operasional/distributed system) |
| Komunikasi | In-process (function call langsung) | Antar proses via jaringan (REST/gRPC), ada overhead network |
| Testing | Relatif sederhana, satu unit untuk diuji | Lebih sulit, butuh entire ecosystem untuk pengujian end-to-end |
| DevOps | Central Ops team bisa cukup | DevOps model per tim/service hampir mutlak diperlukan |
Mengapa Memilih Microservices (Why)
- Faster & simpler deployment and rollback — independent speed of delivery oleh tim berbeda.
- Right framework/tool/language untuk tiap domain — misalnya Recommendation service pakai Python, Catalog service pakai Java.
- Greater resiliency melalui fault isolation.
- Better availability — tapi hanya “if architected right” (lihat catatan availability di bawah).
- Cross-service coupling minimal — mengikuti prinsip smart endpoints, dumb pipes tanpa intelligent middleware.
Catatan penting: microservices tidak otomatis berarti availability lebih baik — kecuali arsitekturnya benar-benar fault tolerant (lihat bagian Dependency Resiliency & Circuit Breaker).
Kekurangan dan Tantangan Microservices (Why Not)
- Kompleksitas pengelolaan sejumlah besar service — “can lead to chaos if not designed right”.
- Multiple database menyulitkan pengelolaan data & penanganan transaksi lintas service.
- Security vulnerabilities — beragam teknologi & komponen yang saling terhubung memperluas attack surface.
- Testing lebih sulit — perlu entire ecosystem untuk menguji end-to-end, bukan cuma satu unit.
- Overhead network communication — panggilan antar service melalui jaringan, bukan lagi in-process call.
- Kompleksitas DevOps — operational overhead meningkat drastis pada ratusan service; DevOps model absolutely required.
- Reduced performance akibat serialization/deserialization data berulang kali di sepanjang rantai pemanggilan (lihat “Data Serialization Overhead” di bawah).
- Service discovery — dengan ratusan service, dibutuhkan Service Metadata Registry.
- Service interface versioning — potensi mismatch antar versi API antar service.
- Distributed systems secara inheren kompleks: network latency, fault tolerance, retry storms.
Data Serialization Overhead
Setiap kali data melewati batas antar service, ia harus di-transform/serialize-deserialize ulang (mis. JSON di client A, lalu diubah ke XML untuk service B, lalu ke Avro untuk service C) — setiap transformasi menambah overhead CPU dan latency dibanding pemanggilan in-process pada monolith.
Tradeoff Monolith vs Microservices
Memilih microservices berarti menerima trade-off berikut:
- Strong service boundary vs performance — independent deployment dan interface yang jelas antar service mengakibatkan overhead komunikasi (network call) antar service.
- Individual deployment vs eventual consistency — independent microservices memerlukan database masing-masing, mengakibatkan problem pengelolaan konsistensi, transaksi, dan performance.
- Independent deployment vs operational complexity — testing, debugging, monitoring microservices pada distributed environment memerlukan automation dan tools yang sesuai.
- Technology diversity vs cost of interface issues — setiap service dapat dikembangkan dengan teknologi berbeda (polyglot), tapi integrasi antar teknologi menjadi lebih kompleks.
12 Factor App
12 Factor App (https://12factor.net/) adalah metodologi membangun aplikasi modern yang cocok untuk microservices agar:
- Menggunakan format declarative untuk setup automation, meminimalkan waktu & biaya onboarding developer baru;
- Memiliki clean contract dengan OS yang mendasarinya, memberi maksimum portability antar execution environment;
- Cocok untuk deployment di platform cloud modern, tanpa perlu mengelola server/administrasi sistem sendiri;
- Meminimalkan divergensi antara development dan production, memungkinkan continuous deployment;
- Bisa scale up tanpa perubahan signifikan pada tooling, arsitektur, atau development practice.
| # | Faktor | Penjelasan |
|---|---|---|
| 1 | Codebase | Satu codebase yang dilacak version control, banyak deploy |
| 2 | Dependencies | Deklarasikan & isolasi dependency secara eksplisit |
| 3 | Config | Simpan konfigurasi di environment, bukan hardcoded di kode |
| 4 | Backing Service | Perlakukan backing service (DB, queue, cache, dst) sebagai attached resource yang bisa ditukar |
| 5 | Build, Release, Run | Pisahkan tegas tahap build dan run |
| 6 | Processes | Jalankan aplikasi sebagai satu atau lebih stateless process |
| 7 | Port binding | Ekspor service via port binding |
| 8 | Concurrency | Scale out via process model |
| 9 | Disposability | Maksimalkan robustness dengan startup cepat & graceful shutdown |
| 10 | Dev/Prod parity | Jaga agar development, staging, dan production semirip mungkin |
| 11 | Logs | Perlakukan log sebagai event stream |
| 12 | Admin processes | Jalankan task admin/manajemen sebagai one-off process |
Pattern-Pattern Microservices
Klasifikasi pattern yang sering dipakai pada Microservices Architecture (MSA) mencakup: Decomposition patterns, Composition patterns, Database patterns, Observability patterns, Cross-cutting concern patterns, serta additional database architecture patterns dan deployment patterns.
Decomposition Patterns
Pattern untuk memecah aplikasi menjadi microservices:
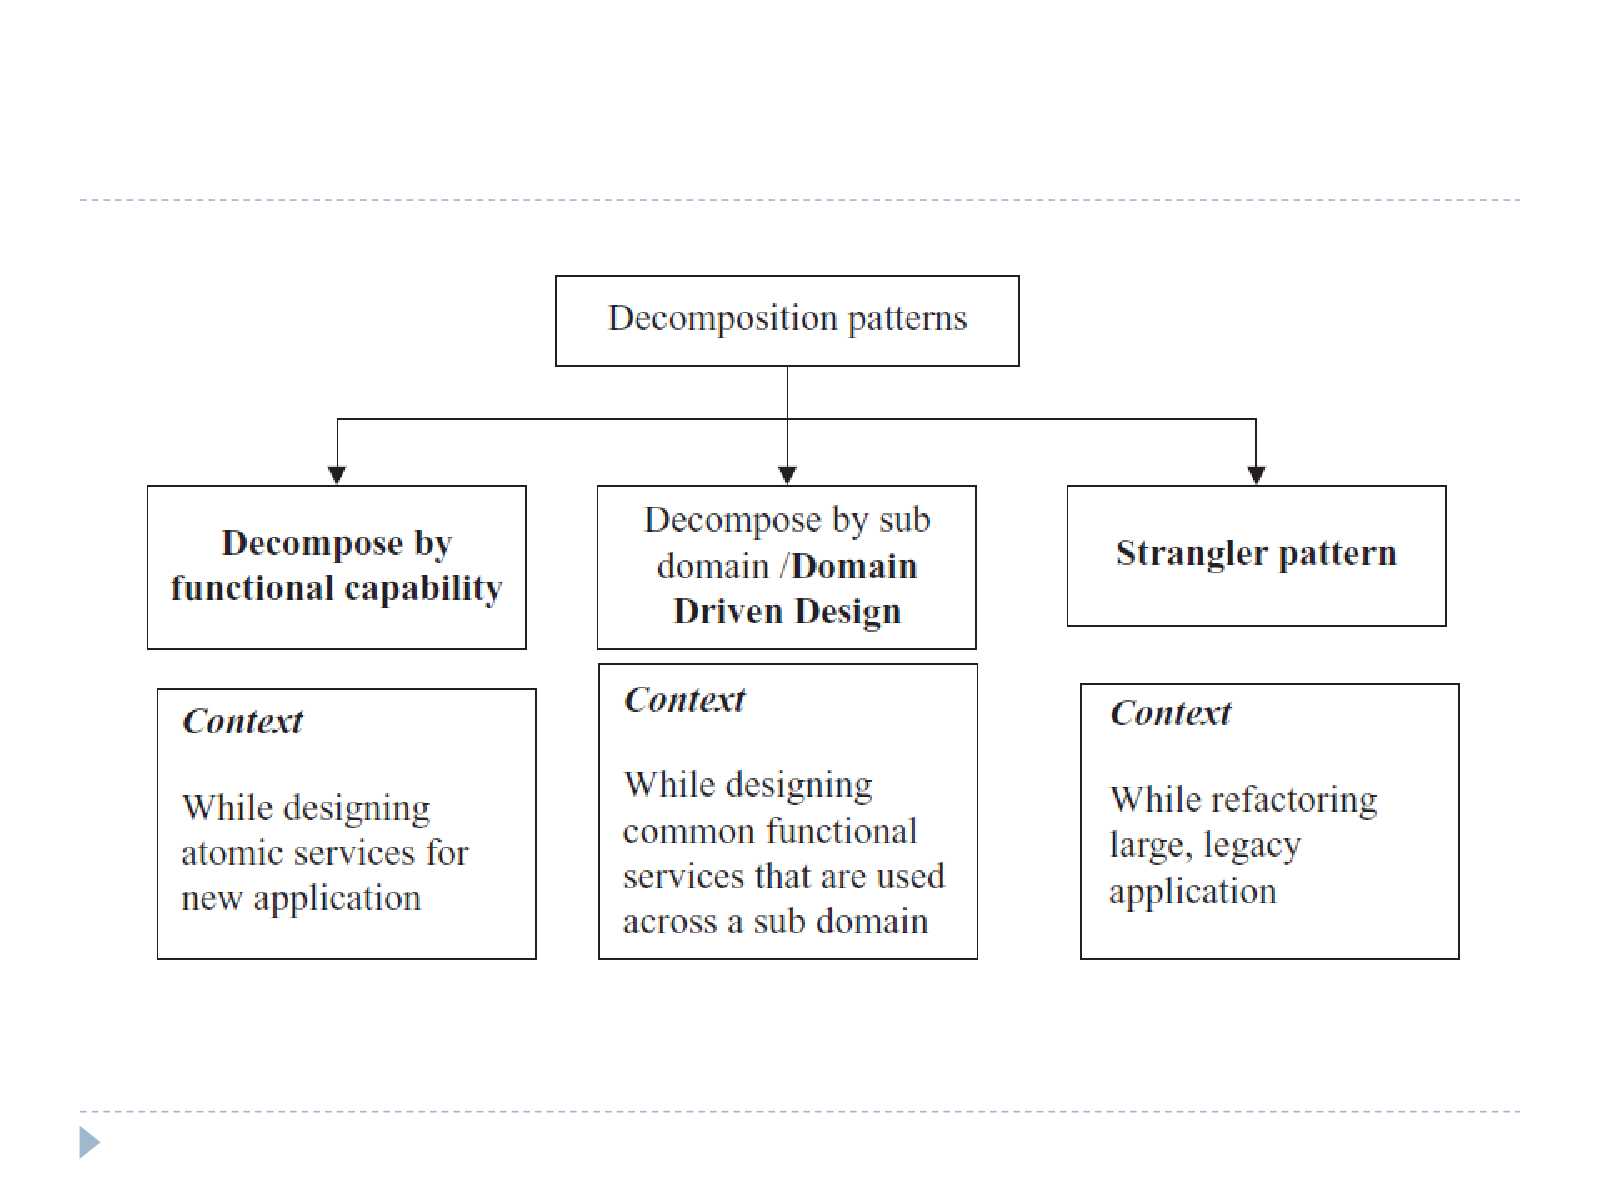
- Decompose by functional capability — konteks: saat mendesain atomic service untuk aplikasi baru. Setiap service dipetakan langsung ke satu kapabilitas fungsional bisnis.
- Decompose by sub-domain / Domain Driven Design (DDD) — konteks: saat mendesain common functional services yang dipakai lintas sub-domain. Menggunakan konsep bounded context dari DDD untuk menentukan batas service.
- Strangler pattern — konteks: saat merefactor aplikasi legacy besar. Fitur baru dibangun sebagai microservice terpisah yang berangsur-angsur “mencekik” (menggantikan) fungsi lama pada monolith, hingga monolith bisa dipensiunkan secara bertahap tanpa big-bang rewrite.
Composition Patterns
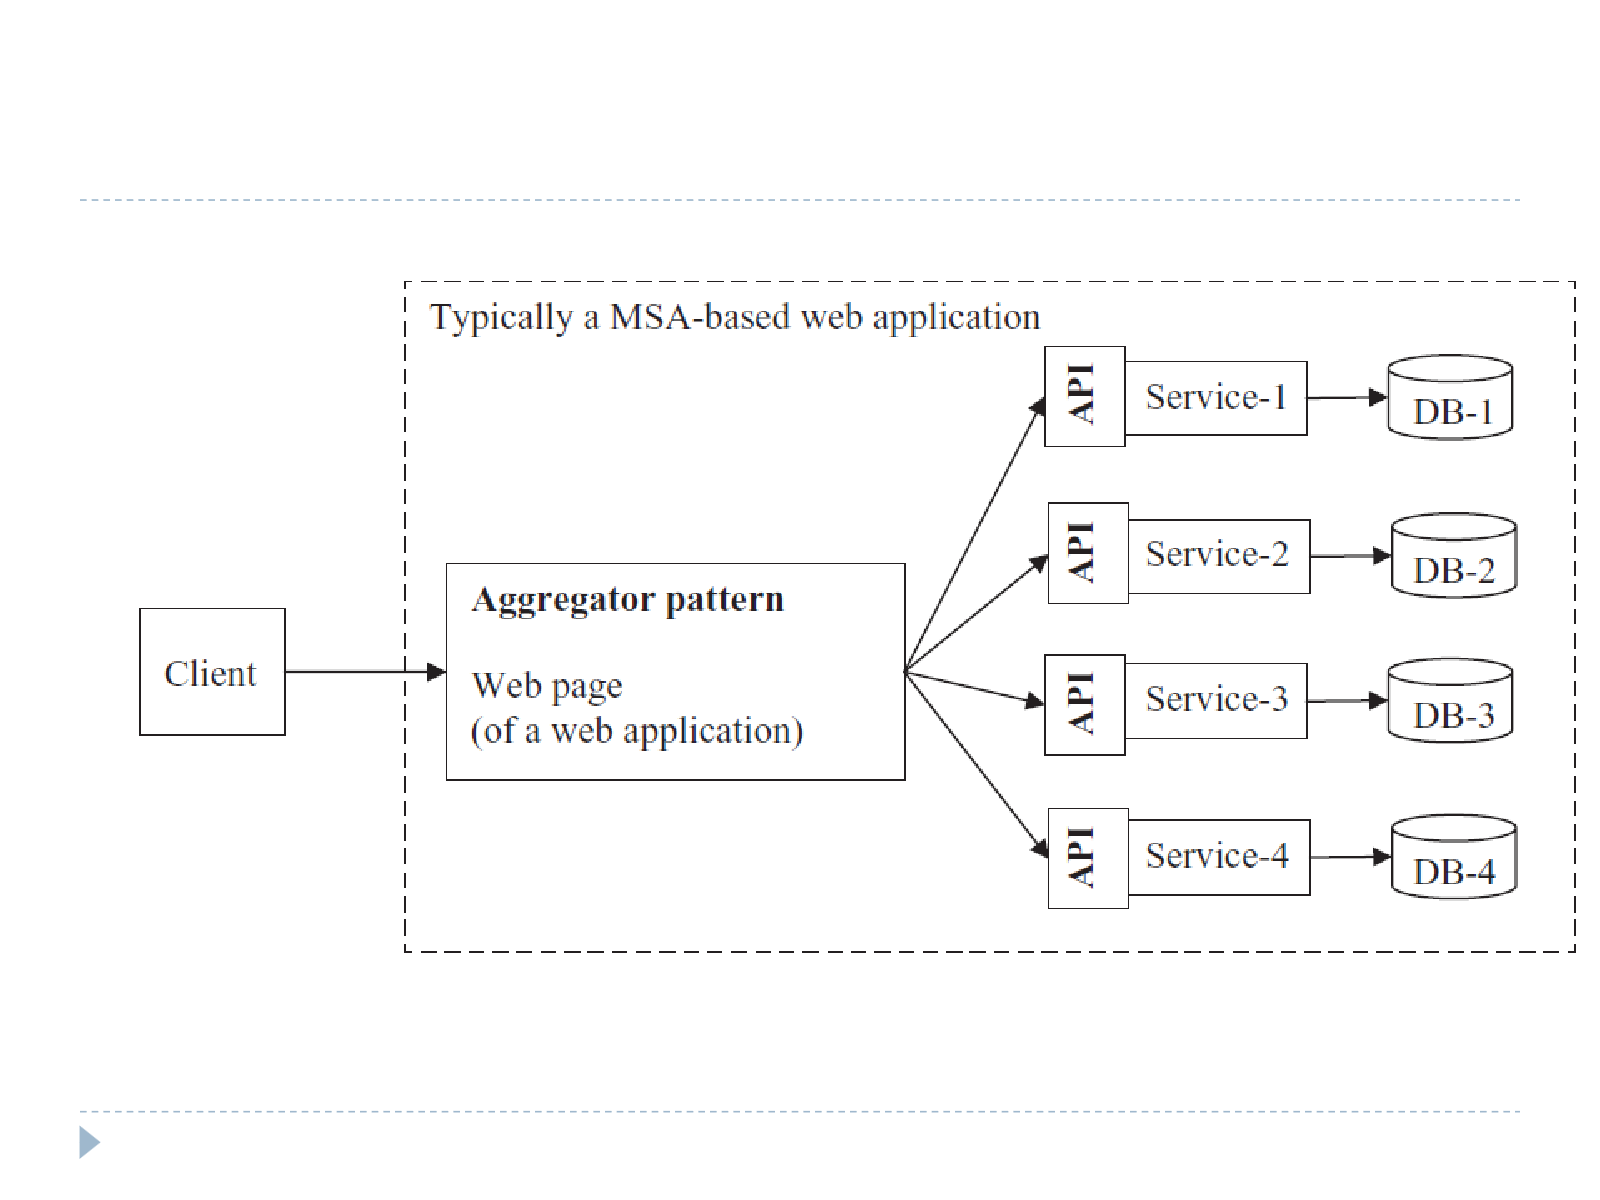
Pattern untuk mengomposisikan/mengintegrasikan banyak microservice menjadi satu response/aplikasi bagi client:
- (i) Aggregator pattern — sebuah komponen (mis. web page) memanggil beberapa service dan basis datanya masing-masing lalu menggabungkan hasilnya untuk client.
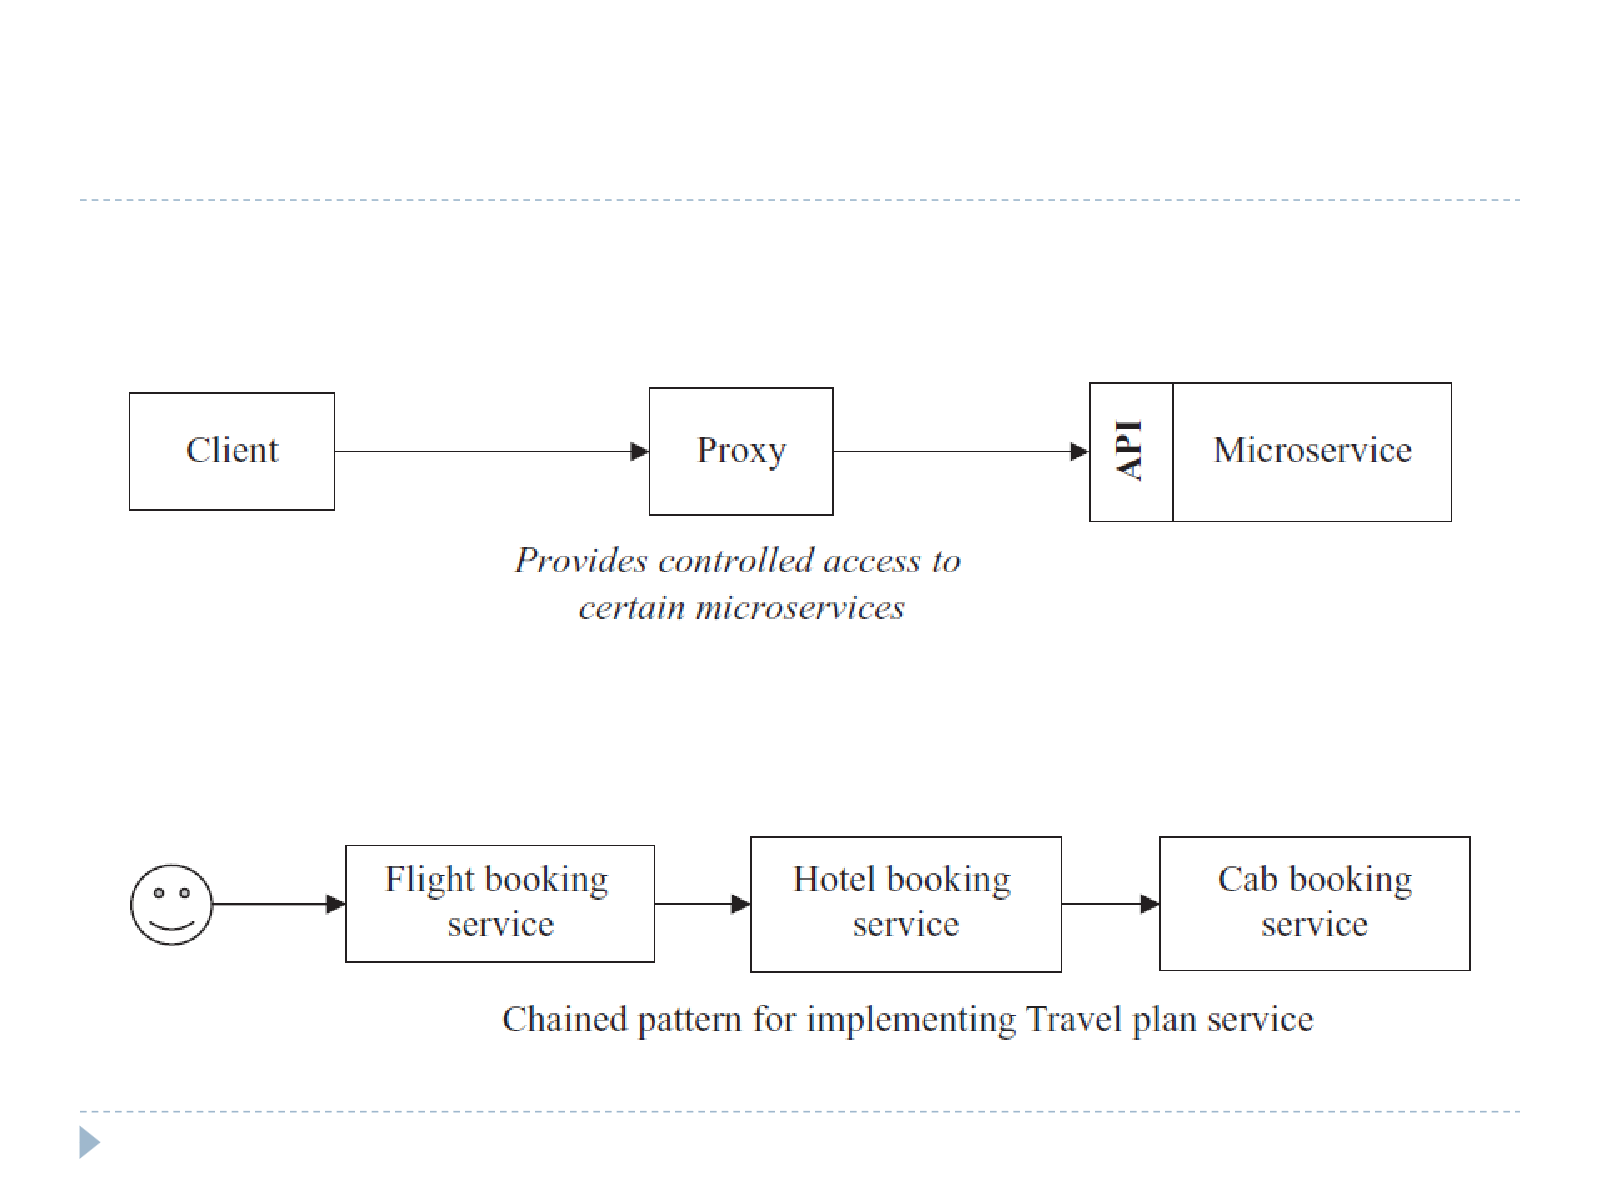
- (ii) Proxy pattern — proxy memberikan controlled access ke microservice tertentu; client tidak memanggil service secara langsung.
- (iii) Chained pattern — beberapa service dipanggil berurutan, output satu service menjadi input service berikutnya. Contoh: Travel plan service memanggil Flight booking service → Hotel booking service → Cab booking service secara berantai.
- (iv) Branch microservice pattern — kombinasi aggregator & chained, memanggil beberapa cabang rantai service secara paralel.
- (v) Shared resource pattern — beberapa service berbagi resource yang sama (mis. shared library/DB) untuk kasus tertentu.
- (vi) API Gateway pattern — satu titik masuk (single entry point) di depan seluruh microservice, menyediakan:
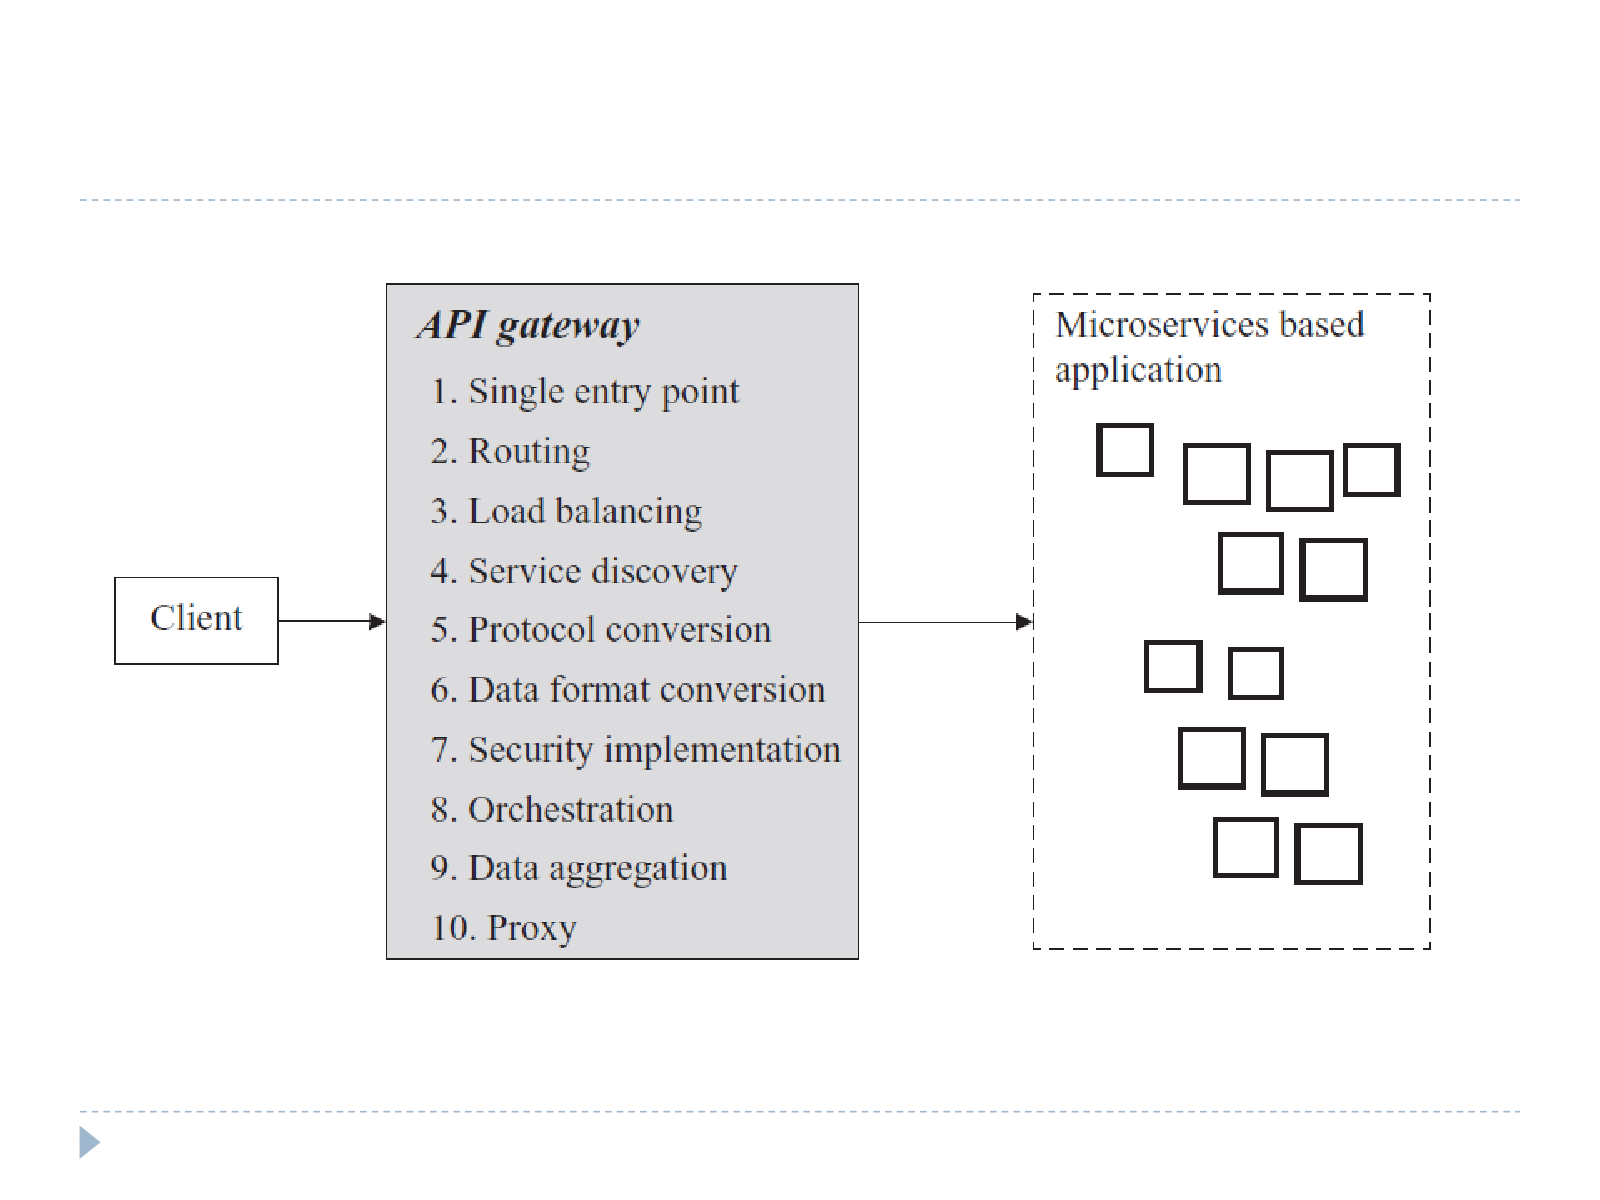
- Single entry point
- Routing
- Load balancing
- Service discovery
- Protocol conversion
- Data format conversion
- Security implementation
- Orchestration
- Data aggregation
- Proxy
- (vii) Client-side UI composition pattern — tiap tim memiliki UI-nya sendiri (mis. tiap microservice punya fragmen UI-nya), yang dikomposisikan di sisi client. Karakteristik pola ini: seluruh komunikasi antar service bersifat asynchronous, mayoritas berupa resource-based REST API, database tidak dibagi antar partisi (masing-masing punya skema sendiri), memakai elemen Event Driven Architecture, tiap service bebas memilih teknologi, dan UI harus resilient terhadap service yang gagal/tidak tersedia.
Database Patterns
- Database per service — tiap microservice memiliki database sendiri (idealnya), menghindari tight coupling melalui shared schema.
- Shared database per service — beberapa service berbagi satu database (kompromi ketika database-per-service sulit diterapkan, tapi mengorbankan sebagian independensi).
CQRS (Command Query Responsibility Segregation)
Pada microservices, database per service membuat pengelolaan read/write menjadi kompleks. CQRS memisahkan jalur command (write) dan query (read) menjadi dua model/database berbeda:
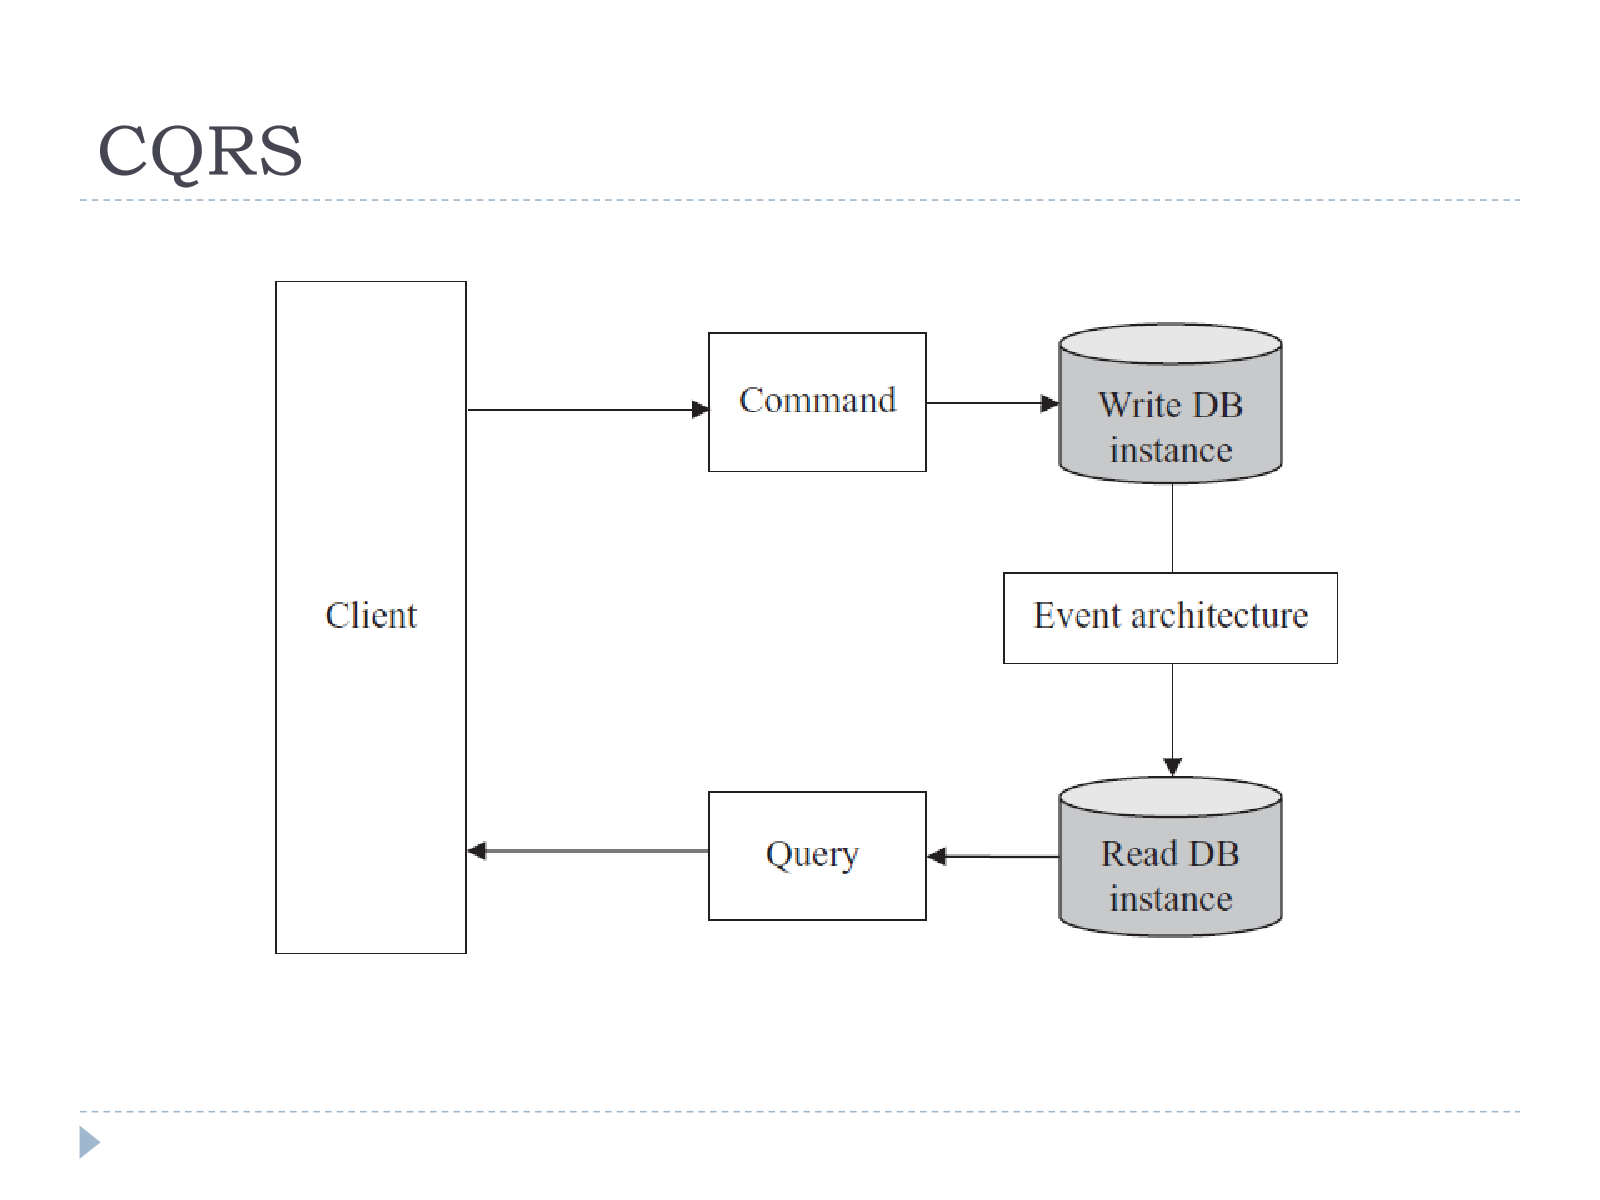
Alurnya: Client mengirim Command → ditulis ke Write DB instance → perubahan disebarkan lewat event architecture → mengupdate Read DB instance → Client membaca lewat Query dari Read DB. Dengan begini, sisi baca dan tulis bisa di-scale dan dioptimasi secara independen (mis. read DB didenormalisasi untuk kecepatan query, write DB dinormalisasi untuk konsistensi).
Saga Pattern
Pada microservices dengan database per service, pengelolaan transaksi lintas microservices menjadi sulit (tidak ada distributed transaction/2PC yang murah). Saga menjalankan transaksi per service, dan menyediakan compensating transaction jika terjadi kegagalan di salah satu langkah.
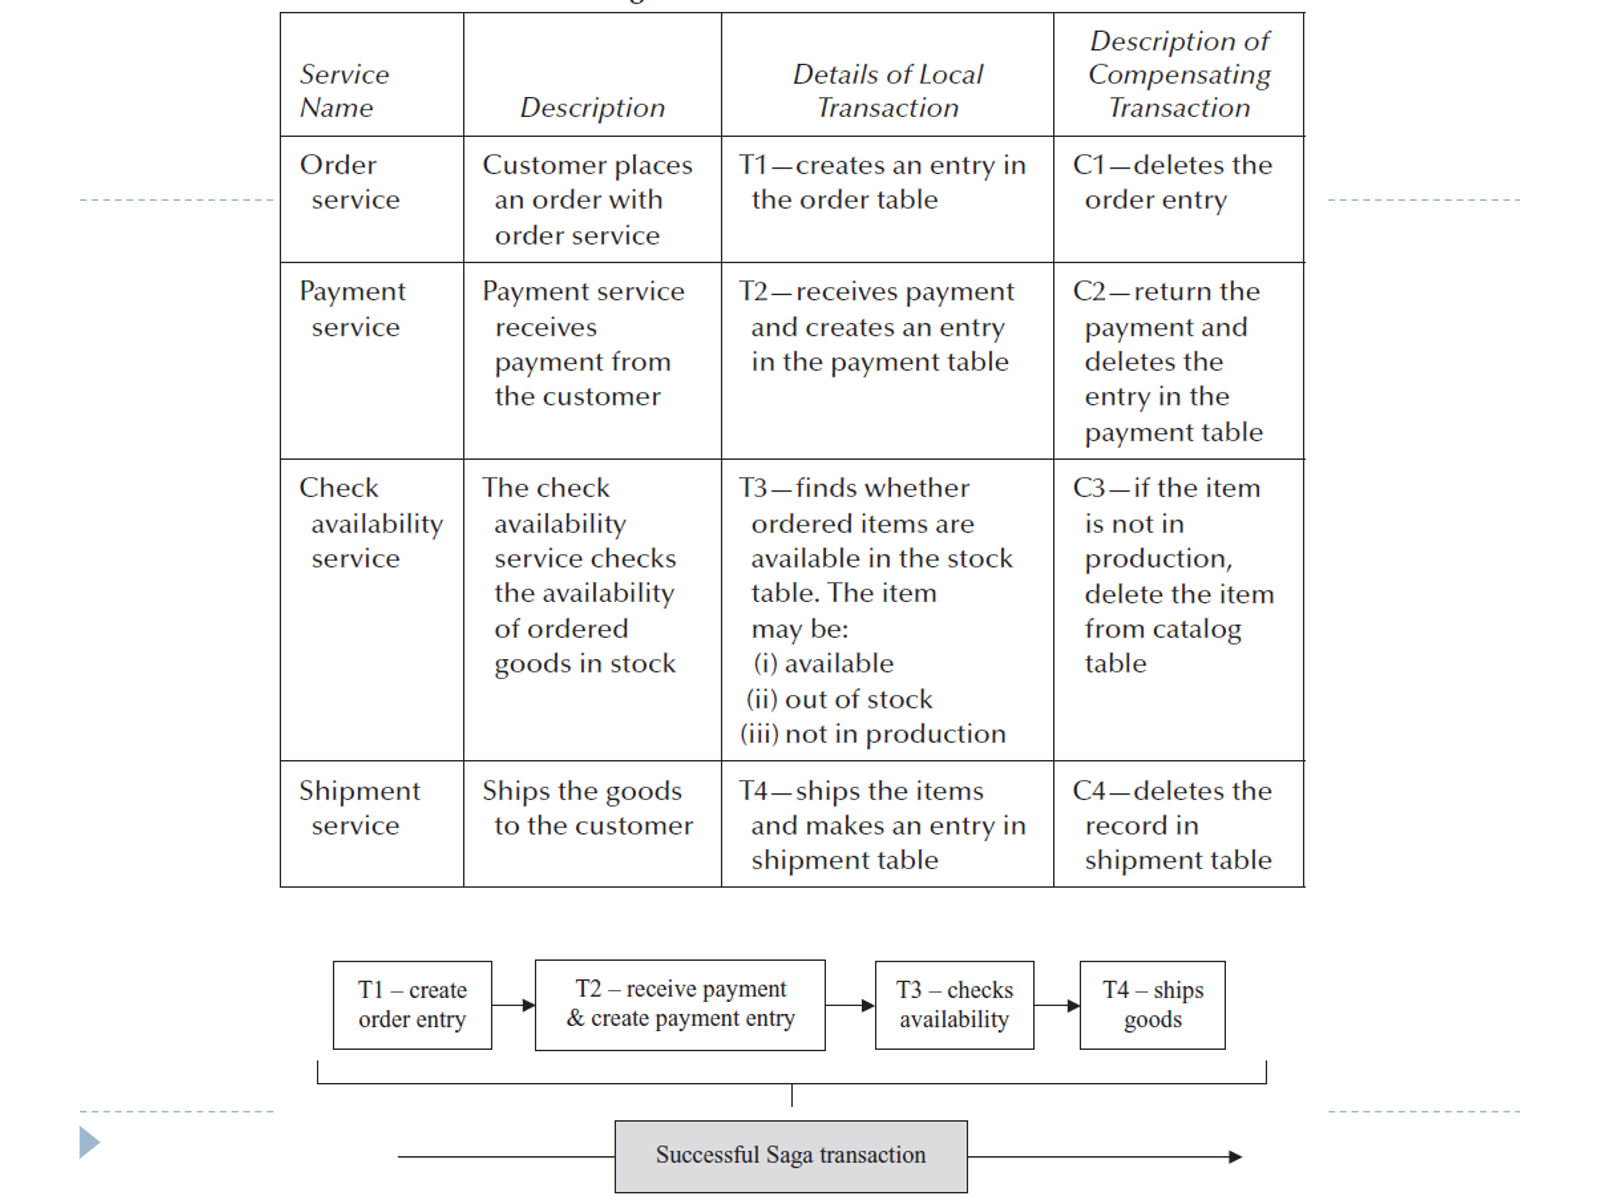
Contoh kasus pemesanan (order processing) dengan 4 service:
| Service Name | Description | Local Transaction | Compensating Transaction |
|---|---|---|---|
| Order service | Customer places an order | T1 — creates entry in order table | C1 — deletes the order entry |
| Payment service | Menerima pembayaran dari customer | T2 — receives payment & creates entry in payment table | C2 — return payment & deletes entry in payment table |
| Check availability service | Mengecek ketersediaan barang di stok | T3 — cek status barang: (i) available (ii) out of stock (iii) not in production | C3 — jika item tidak diproduksi, hapus item dari catalog table |
| Shipment service | Mengirim barang ke customer | T4 — ships items & membuat entry di shipment table | C4 — deletes record di shipment table |
Jika seluruh langkah T1→T2→T3→T4 berhasil, transaksi Saga dianggap sukses (successful Saga transaction):
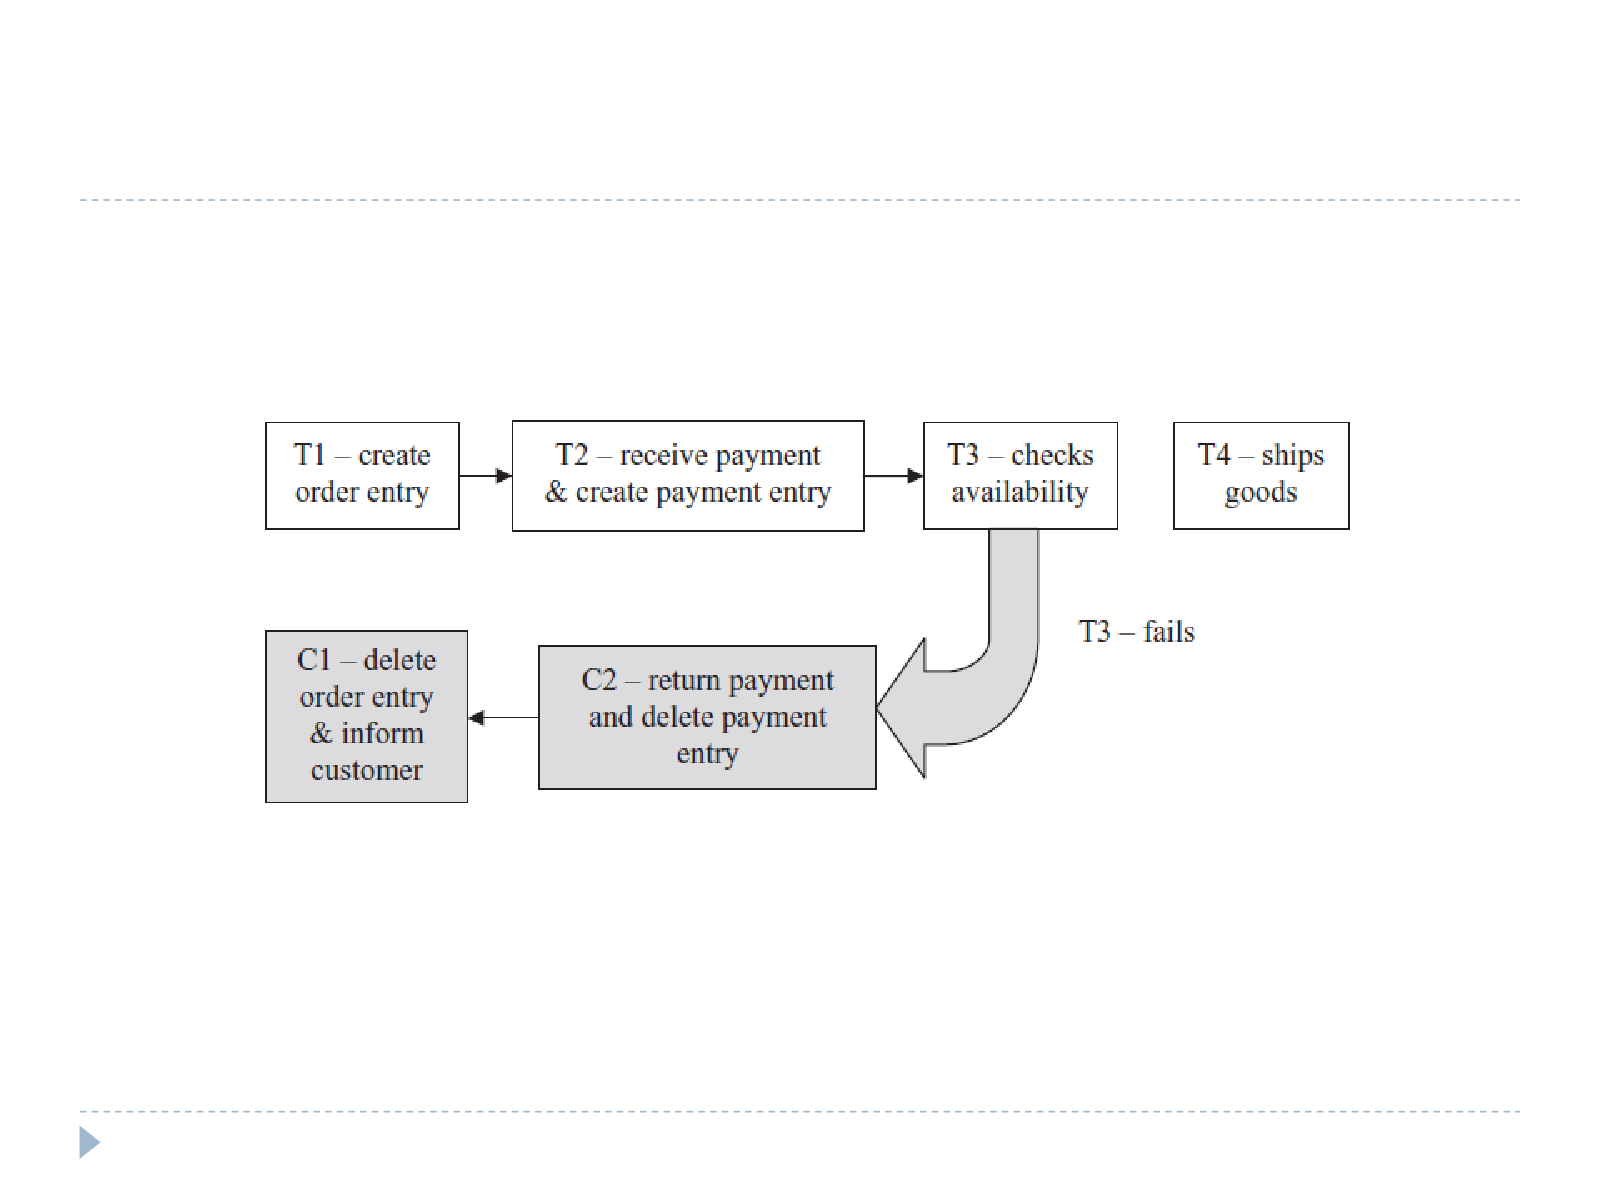
Namun bila salah satu langkah gagal (mis. T3 gagal karena stok habis), sistem harus menjalankan compensating transaction secara mundur untuk membatalkan efek langkah-langkah sebelumnya (mis. C2 mengembalikan pembayaran & menghapus entry payment, lalu C1 menghapus order entry & memberi tahu customer):
Mekanisme implementasi Saga — Choreography vs Orchestration:
| Aspek | Events / Choreography | Command / Orchestration |
|---|---|---|
| Koordinasi | Tidak ada koordinator pusat | Ada satu coordinator service terpusat |
| Cara kerja | Setiap service memproduksi & mendengarkan event dari service lain, lalu memutuskan sendiri apakah suatu aksi perlu diambil | Coordinator service bertanggung jawab mensentralisasi pengambilan keputusan Saga & mengurutkan business logic |
| Coupling | Lebih loosely coupled antar service (via event) | Lebih mudah dipahami alurnya karena logic terpusat di satu tempat, tapi coordinator jadi titik ketergantungan |
Observability Patterns
- (i) Centralized logging service pattern — mengumpulkan log dari semua service ke satu tempat terpusat. Contoh stack: Logstash (collect & transform) → Elasticsearch (search & analyze) → Kibana (visualize & manage).
- (ii) Application performance metrics pattern — mengumpulkan metrik performa aplikasi (latency, throughput, error rate) secara terpusat.
- (iii) Distributed tracing pattern — melacak jejak satu request yang melintasi banyak service (trace ID dipropagasi antar service).
- (iv) Health check pattern — endpoint khusus di tiap service untuk memberi tahu status kesehatannya (up/down/degraded) ke sistem monitoring/orchestrator.
Cross-Cutting Concern Patterns
Fungsionalitas yang dibutuhkan lintas banyak/semua service, sehingga sebaiknya tidak di-embed berulang di tiap service melainkan ditangani oleh infrastruktur/middleware bersama (mis. API Gateway):
- (i) External configuration store pattern — konfigurasi disimpan terpusat di luar kode, bisa diubah tanpa redeploy.
- (ii) Service registry pattern — direktori/registry berisi lokasi (host/port) tiap instance service yang sedang aktif.
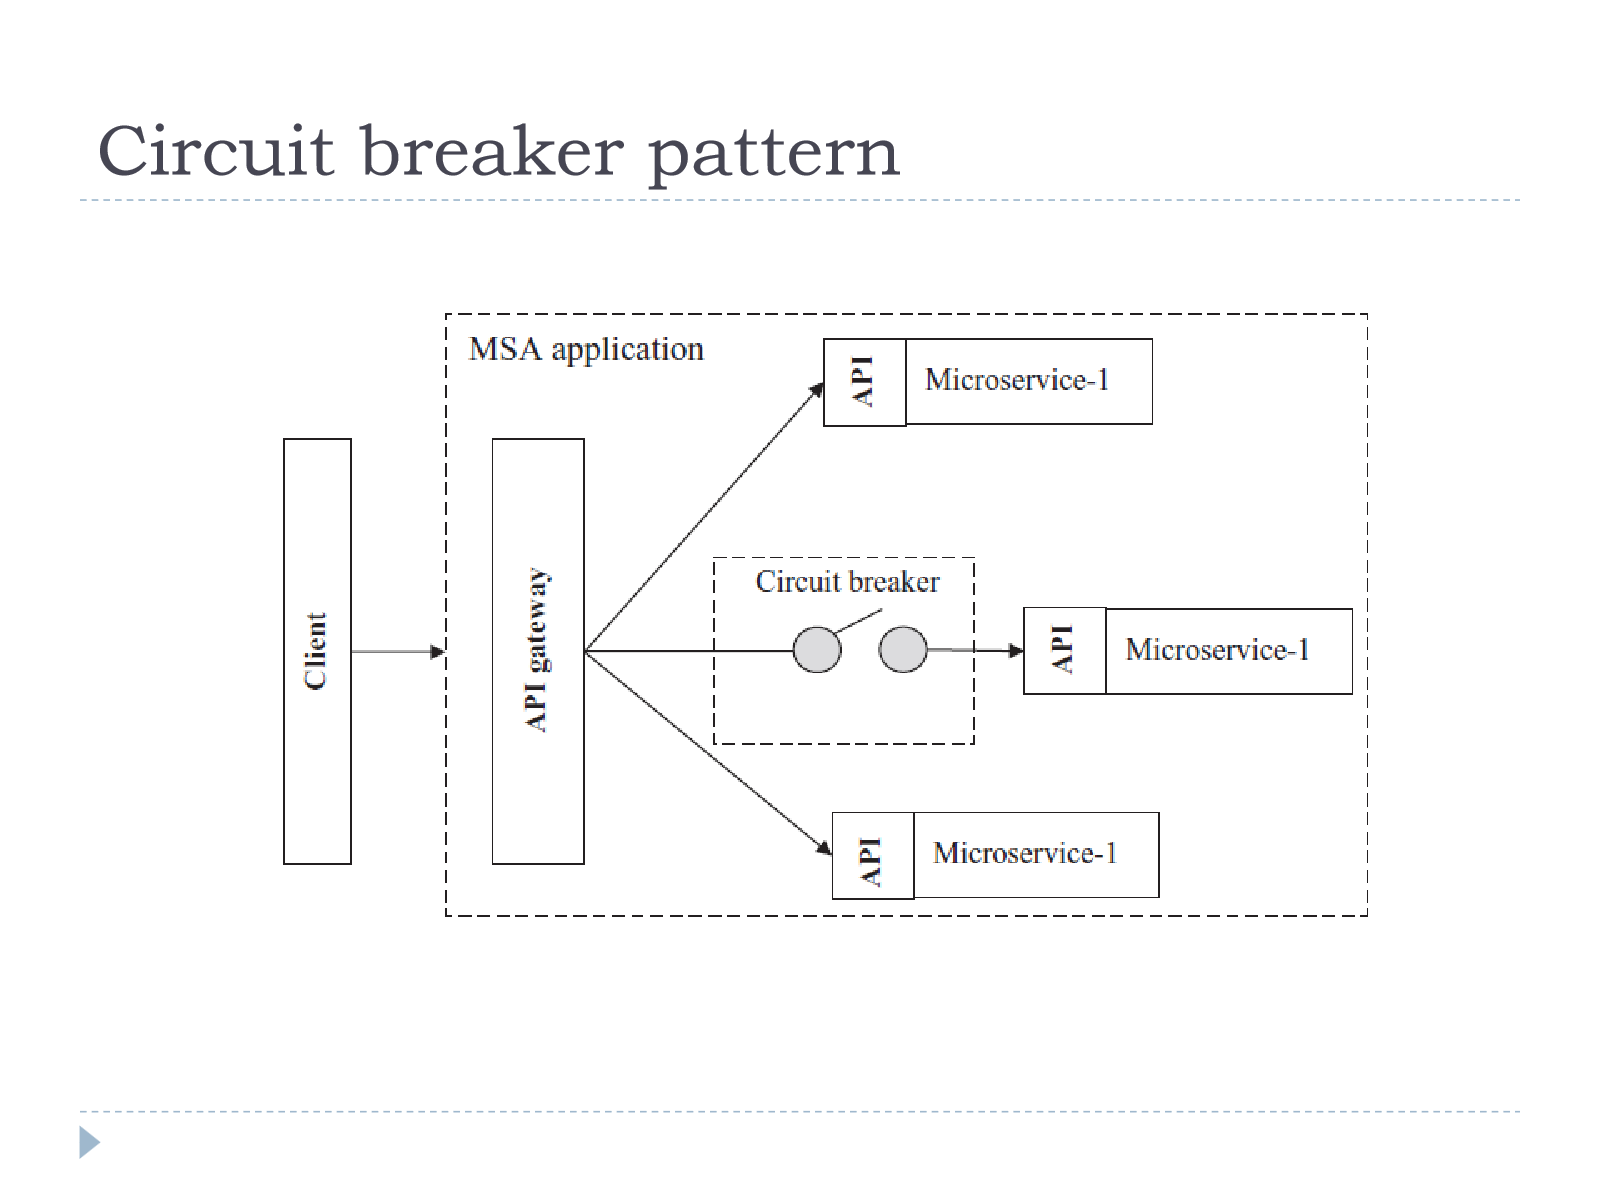
- (iii) Circuit breaker pattern — mencegah kegagalan satu service merambat (cascading failure) ke service lain. API Gateway/client memantau tingkat kegagalan pemanggilan ke suatu service; jika melewati ambang batas, “circuit” dibuka (diputus) sehingga pemanggilan berikutnya langsung gagal cepat (fail fast) atau diarahkan ke fallback, tanpa terus membebani service yang sedang bermasalah.
- (iv) Blue-green deployment — teknik deployment dengan dua environment identik (blue = versi lama yang sedang live, green = versi baru), trafik dialihkan sepenuhnya dari blue ke green setelah green terverifikasi sehat, meminimalkan downtime dan mempermudah rollback.
Contoh Microservices Architecture (Kasus Netflix)
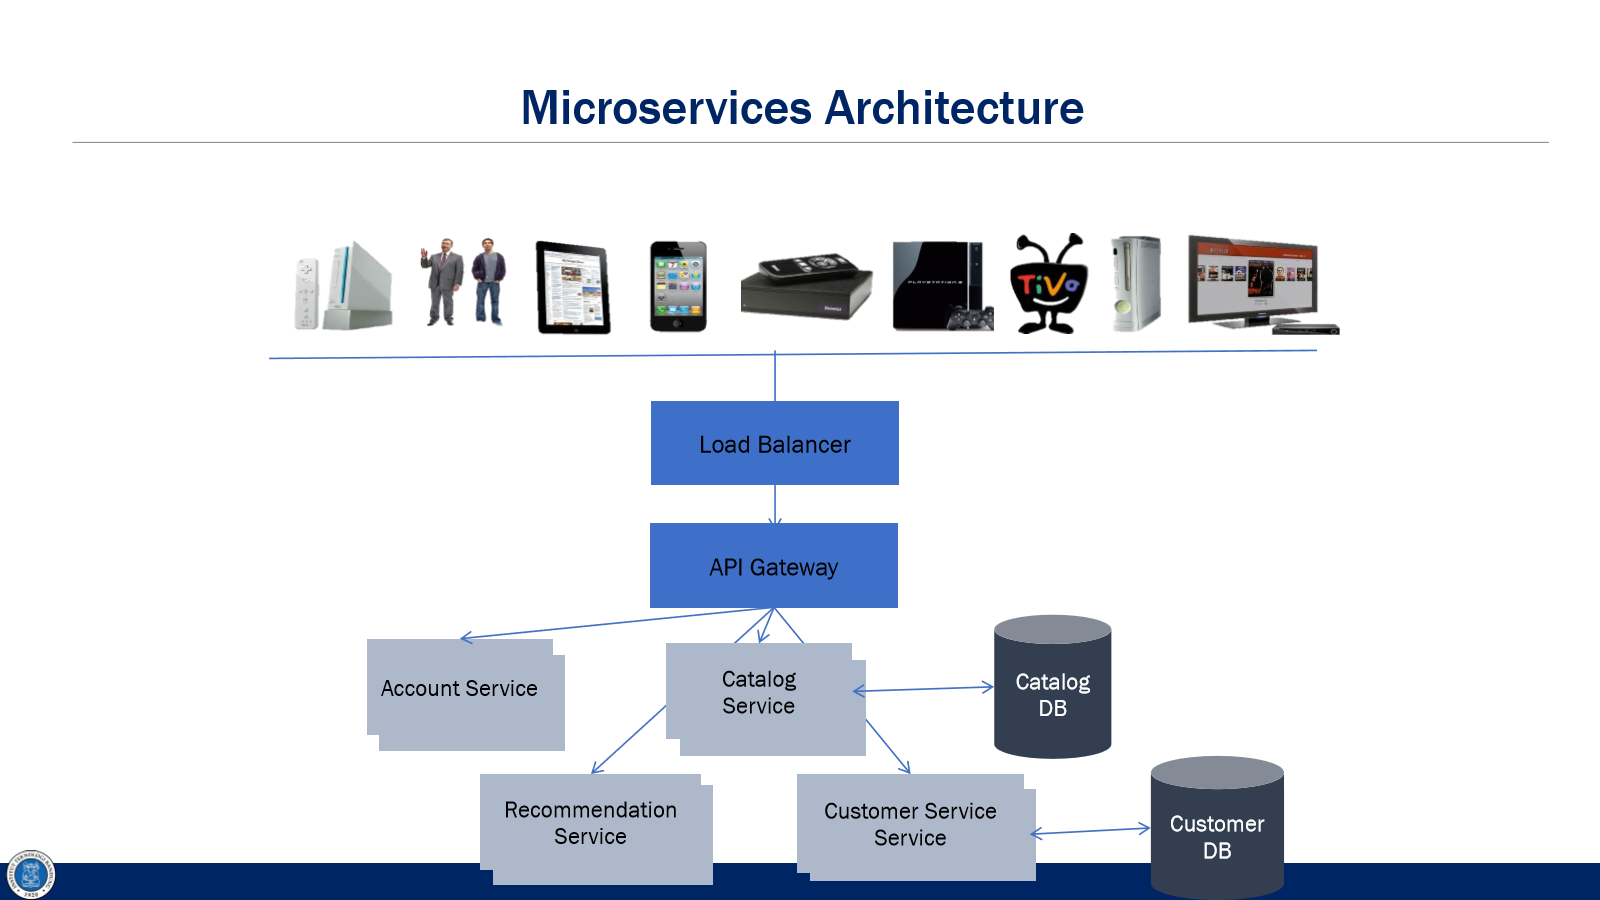
Setelah dipecah menjadi microservices, arsitektur Netflix berubah dari satu monolith menjadi kumpulan service kecil (Account Service, Catalog Service, Recommendation Service, Customer Service) yang masing-masing punya database sendiri (Catalog DB, Customer DB), diakses melalui satu API Gateway di belakang Load Balancer:
Service Dependency Graph
Setiap service pada microservices architecture punya rantai dependency ke service lain (Concept → Service Dependency Graph): App/Service Anda memanggil Service X, Y, Z, yang masing-masing bisa memanggil service lain lagi (Service L, M), membentuk graf dependency yang kompleks — inilah alasan service dependency visualization menjadi penting (lihat bagian Tools Deployment).
Service Discovery
Dengan ratusan microservices, dibutuhkan Service Metadata Registry (Discovery Service) — setiap service mendaftarkan dirinya (registrasi) dan mencari lokasi service lain lewat registry ini, bukan lewat alamat hardcoded. Contoh implementasi: Netflix Eureka.
Chattiness dan Fan-Out Problem
Pada monolith, 1 request user = 1 pemrosesan internal (in-process call). Pada microservices, 1 request yang masuk ke edge service bisa fan out menjadi banyak request ke service-service downstream. Pada skala Netflix: ~2 miliar request/hari di Edge Service menghasilkan ~20 miliar fan-out request ke ~100 microservices.
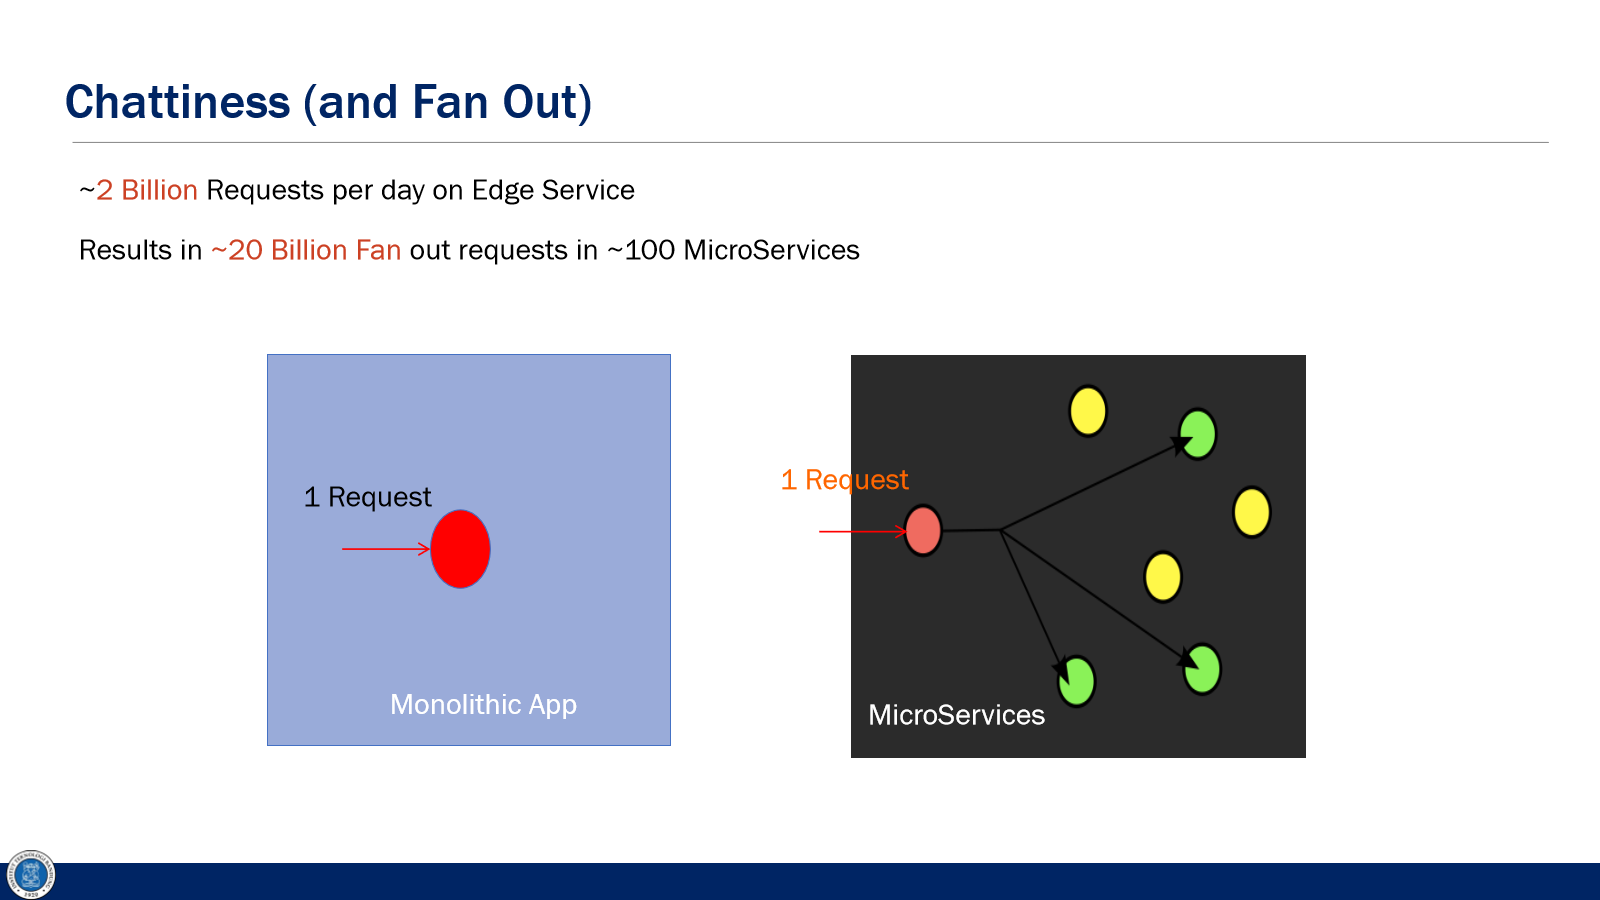
Fenomena chattiness ini memperbesar risiko: N/W latency menumpuk, satu dependency yang lambat bisa memblokir banyak thread request secara bersamaan (“Service Hosed” — satu service “buruk” bisa tetap menjatuhkan keseluruhan service meski sudah dipecah menjadi microservices, karena semua thread request bisa terblokir menunggu 1 dependency yang lambat dalam hitungan detik pada beban 50+ request/detik).
Isolasi dan Load Balancing
Best practice isolasi/akses: gunakan mekanisme seperti Security Groups (di AWS) untuk mengisolasi/membatasi akses antar microservices — jangan asumsikan semua service saling percaya secara default.
Pilihan arsitektur load balancer:
- Central (proxy) load balancer — satu load balancer (hardware/software) terpusat, biasanya per jenis service (mis. Account Service Load Balancer, Customer Service Load Balancer), semua diakses lewat API Gateway.
- Client-side load balancer — logic load balancing dipindah ke sisi client/caller, tiap client tahu cara memilih instance service tujuan sendiri (tanpa hop tambahan ke LB terpusat).
- Client-based smart load balancer — pengembangan client-side LB yang memperhitungkan kondisi real-time tiap instance (jumlah outstanding request, instance yang sedang “tripped”/circuit-open, zona yang sedang bermasalah) untuk memilih instance tujuan yang paling sehat. Contoh implementasi: Ribbon (Netflix OSS) — menghitung average active requests per instance dan menghindari instance yang circuit-nya sudah “tripped” atau zona yang sudah “dropped”.
Tip: gunakan client-side smart load balancer, karena lebih adaptif terhadap kegagalan instance individual dibanding LB terpusat yang statis.
Dependency Resiliency
Sebuah request dari user bisa memicu rantai panjang dependency call ke banyak service backend. Untuk menjaga resiliensi:
- Guard your dependency calls — batasi/isolasi setiap pemanggilan dependency (mis. dengan thread pool terpisah & timeout per dependency, seperti pola Hystrix: setiap dependency dijalankan lewat Command dengan thread pool sendiri, sehingga dependency yang lambat/gagal tidak menghabiskan seluruh thread aplikasi — bila thread pool/queue penuh, request langsung gagal cepat atau memakai fallback, bukan menunggu tanpa batas).
- Cache your dependency call results — kurangi pemanggilan berulang ke service yang sama.
- Server caching: aplikasi menyimpan hasil panggilan ke Service X/Y/Z pada cache cluster, sehingga panggilan berikutnya cukup diambil dari cache. Tip: atur TTL sesuai toleransi terhadap data staleness.
- Composite (materialized view) caching: hasil gabungan dari beberapa service (Fn{A,B,C}) langsung disimpan sebagai satu entri cache, bukan meng-cache tiap service terpisah.
- Consider batching your dependency calls — gabungkan beberapa pemanggilan kecil menjadi satu batch call untuk mengurangi jumlah round-trip.
- Increase throughput via Async/ReactiveX patterns — gunakan pemanggilan asynchronous/reactive (mis. RxJava/RxNetty) agar thread tidak diblokir menunggu I/O.
Bottleneck/hotspot & tip pass data via header: pada beberapa kasus, satu service “hub” (mis. User Account Service) dipanggil berulang oleh banyak service lain untuk data yang sama pada satu request (mis. 4 kali per request user). Solusinya: teruskan data tersebut lewat HTTP header (mis. Usr=XX; AbCell=103) di sepanjang rantai pemanggilan, sehingga service-service downstream tidak perlu memanggil ulang service hub tersebut — mengurangi beban dan dependency pada service yang jadi bottleneck.
Menguji Resiliensi (Test Resiliency)
Microservices harus diuji ketahanannya terhadap kegagalan nyata, bukan cuma jalur sukses:
- Latency/error tests — mensimulasikan latency tinggi dan error pada service tertentu.
- Dependency service unavailability — mensimulasikan dependency yang mati total.
- Network errors — mensimulasikan gangguan jaringan.
Contoh tooling: Simian Army (Netflix OSS) — kumpulan tool chaos engineering untuk menguji resiliensi terhadap kegagalan infrastruktur secara acak/terkontrol di production.
Tools untuk Deployment
- Auto scaling — mis. AWS Auto Scaling Groups, menambah/mengurangi instance otomatis berdasarkan metrik seperti RPS (request per second) atau CPU/Load Average (via CloudWatch).
- Canary release & Red/Black (Blue-Green) push — mekanisme deployment bertahap: versi baru (canary/“green”/“black”) awalnya tidak menerima trafik live, lalu divalidasi kesehatannya, baru trafik dialihkan penuh dari versi lama ke versi baru. Tooling contoh: NetflixOSS Asgard untuk mengelola cluster Auto Scaling Group dan switch trafik antar versi.
- Service dependency visualization — dashboard yang menampilkan graf dependency antar service secara real-time, untuk menjawab pertanyaan seperti: berapa banyak dependency yang dimiliki service saya, berapa call volume-nya, apakah ada dependency service yang “running hot”, apa saja top N slowest business transactions, dan sample request/response yang menghasilkan error 5xx dalam 30 menit terakhir.
Polyglot Ecosystem dan Sidecar Pattern
Karena tiap tim bebas memilih bahasa/framework (polyglot: Java, Python/Django, Node.js, Ruby on Rails, Go, R, dst), muncul tantangan homogenitas pada layer Platform Services (registry, config, metrics, dsb) yang perlu diakses seragam oleh semua bahasa tersebut.
Sidecar pattern menjawab ini: sebuah komponen operasional/infrastruktur (sidecar) dijalankan berdampingan dengan aplikasi utama (biasanya non-JVM), menyediakan akses homogen ke platform services lewat HTTP, tanpa aplikasi utama perlu mengimplementasikan ulang integrasi ke tiap platform service secara native per bahasa.
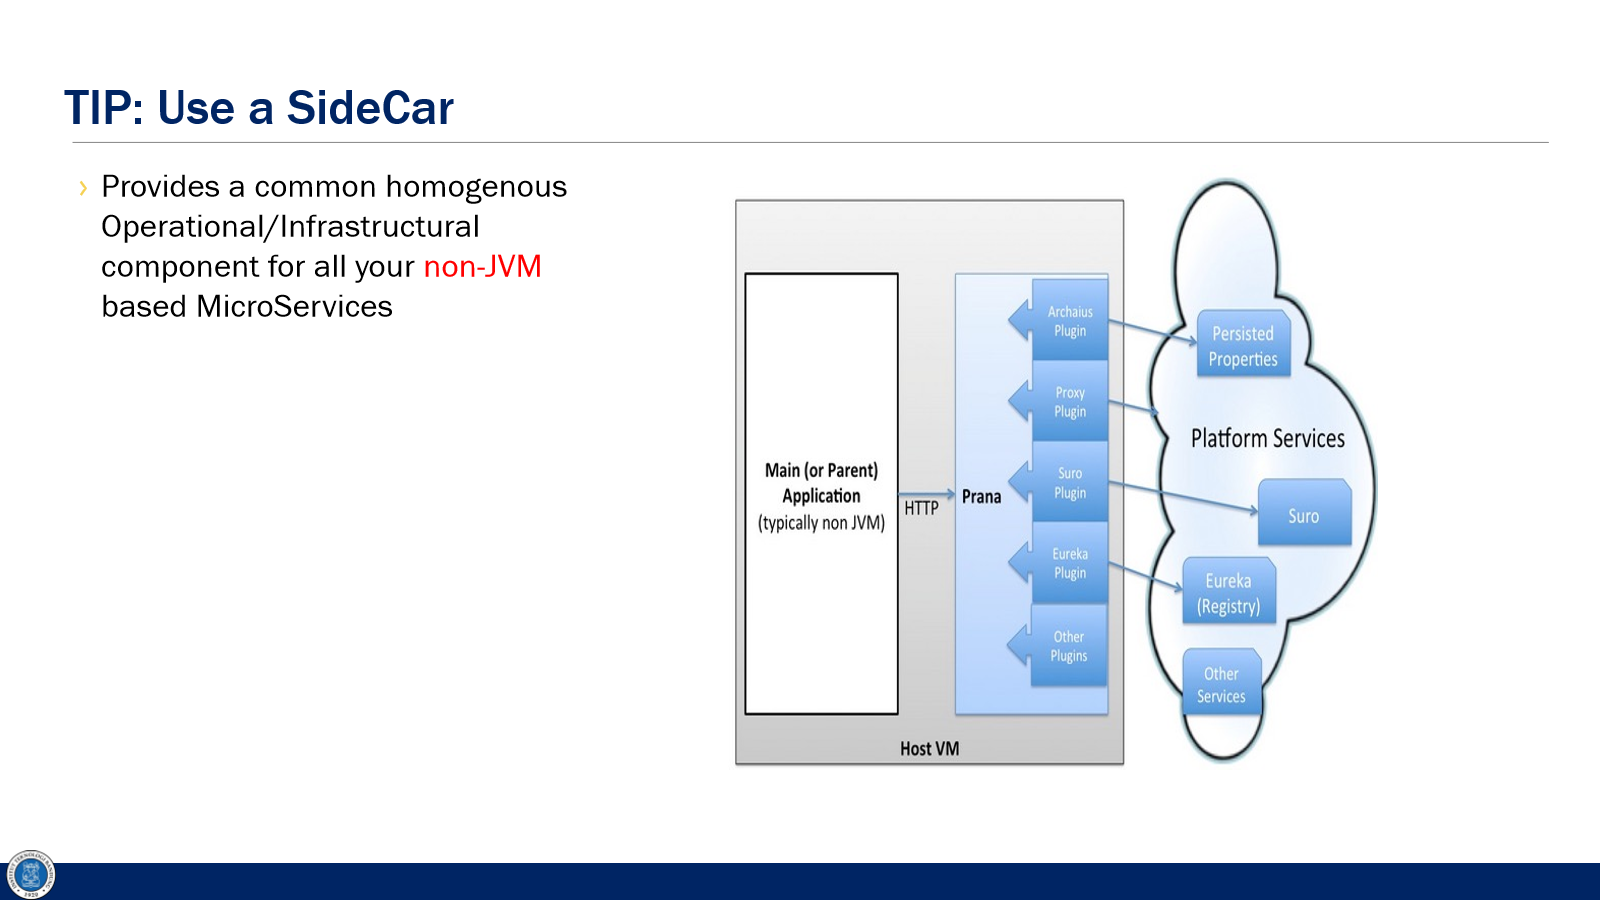
Contoh implementasi: Prana (Netflix OSS) — sidecar yang menjembatani aplikasi non-JVM ke platform services seperti Archaius (persisted properties), Suro, dan Eureka (registry) lewat plugin (Archaius Plugin, Proxy Plugin, Suro Plugin, Eureka Plugin) yang diakses via HTTP dari aplikasi utama.
Inter-Process Communication (IPC) Stack — Evolusi di Netflix
Sebagai ilustrasi evolusi teknis IPC pada microservices skala besar:
- IPC Stack 1.0 — arsitektur blocking: client menggunakan Apache HTTP Client, dengan Ribbon (load balancing + integrasi Eureka), Hystrix (fault tolerance), EVCache, di atas server berbasis Apache Tomcat (Karyon).
- IPC Stack 2.0 — arsitektur fully reactive: client (Ribbon 2.0) dan server (Karyon) dibangun di atas RxNetty (Reactive Extensions + Netty), mendukung UDP/TCP/WebSockets/SSE, non-blocking di semua layer. Hasil benchmark menunjukkan RxNetty memberikan throughput (req/sec) lebih tinggi dibanding Tomcat NIO pada skenario “Hello Netflix” dengan dependency call, meski trade-off pada CPU usage/request dan max latency perlu dievaluasi sesuai kasus.
NetflixOSS menyediakan banyak library pendukung microservices yang sudah disebut di atas, di antaranya:
- Eureka — service registry/discovery
- Karyon — server (reactive atau threaded/servlet container)
- Ribbon — IPC client + fault tolerant smart load balancer
- Hystrix — fault tolerance & resiliency (circuit breaker, thread pool isolation, fallback)
- Archaius — distributed/dynamic properties
- Servo — metrics/insight terpadu
- EVCache — distributed cache
- Curator/Exhibitor — operasi berbasis Zookeeper
Ringkasan
Microservices architecture pada dasarnya adalah:
- Kumpulan tren, pattern, dan praktik terkini (bukan satu teknologi tunggal).
- Menambah kompleksitas demi kesederhanaan di level lain (kesederhanaan pengembangan/deployment per tim, dengan cost kompleksitas operasional/distributed system).
- Bukan silver bullet — cocok untuk aplikasi bisnis modern yang butuh skala & kecepatan delivery tinggi, tapi monolith masih cocok untuk organisasi kecil.
- Merupakan perjalanan (journey), bukan tujuan sekali jadi, untuk mencapai manfaatnya — pertimbangkan adopsi saat organisasi sudah cukup besar/kompleks untuk membutuhkannya, dan manfaatkan best practice serta platform cloud elastis (auto scaling, dsb) sebagai fondasinya.
Flashcard
flashcards Apa perbedaan utama antara pendekatan monolithic dan microservices dalam hal deployment dan scaling? :: Monolith di-deploy dan di-scale sebagai satu kesatuan (undifferentiated scaling, tidak bisa scale komponen tertentu saja), sedangkan microservices di-deploy dan di-scale independen per service, memungkinkan scaling selektif sesuai beban tiap service. Sebutkan 3 pattern utama pada Decomposition Pattern beserta konteks pemakaiannya. :: Decompose by functional capability (untuk mendesain atomic service pada aplikasi baru), Decompose by sub-domain/DDD (untuk service fungsional umum yang dipakai lintas sub-domain), dan Strangler pattern (untuk merefactor aplikasi legacy besar secara bertahap tanpa big-bang rewrite). Jelaskan cara kerja CQRS pada microservices. :: CQRS (Command Query Responsibility Segregation) memisahkan jalur command (write) dan query (read) menjadi model/database berbeda — command menulis ke Write DB, perubahan disebarkan lewat event architecture ke Read DB, dan query membaca dari Read DB, sehingga sisi baca dan tulis bisa dioptimasi serta di-scale secara independen. Apa itu Saga pattern dan mengapa dibutuhkan pada microservices? :: Saga adalah pattern untuk mengelola transaksi lintas microservices (yang masing-masing punya database sendiri) dengan menjalankan transaksi per service dan menyediakan compensating transaction untuk membatalkan efek langkah-langkah sebelumnya jika salah satu langkah gagal, karena distributed transaction/2PC klasik tidak praktis diterapkan lintas service. Jelaskan perbedaan Saga Choreography dan Saga Orchestration. :: Choreography tidak memiliki koordinator pusat — setiap service memproduksi dan mendengarkan event service lain lalu memutuskan sendiri aksi yang harus diambil (loosely coupled). Orchestration memiliki satu coordinator service yang mensentralisasi pengambilan keputusan Saga dan mengurutkan business logic (lebih mudah dipahami alurnya tapi bergantung pada coordinator). Apa fungsi circuit breaker pattern pada microservices? :: Mencegah kegagalan satu service merambat (cascading failure) ke service lain, dengan memantau tingkat kegagalan pemanggilan ke suatu service dan memutus (open circuit) pemanggilan berikutnya secara otomatis jika melewati ambang batas, sehingga request gagal cepat (fail fast) atau diarahkan ke fallback alih-alih terus membebani service bermasalah. Apa yang dimaksud dengan “smart endpoints, dumb pipes” pada microservices? :: Prinsip bahwa kecerdasan/logic bisnis harus berada di endpoint (service) itu sendiri, bukan di infrastruktur middleware/transport yang menghubungkannya (no intelligent middleware) — berbeda dengan arsitektur ESB pada SOA klasik yang menaruh banyak logic di bus komunikasi. Apa itu chattiness dan fan-out problem pada microservices, dan bagaimana contohnya di skala Netflix? :: Chattiness/fan-out adalah fenomena di mana satu request masuk ke edge service memicu banyak request turunan ke service-service downstream; pada skala Netflix, ~2 miliar request/hari di edge service menghasilkan ~20 miliar fan-out request ke ~100 microservices, meningkatkan risiko latency menumpuk dan satu dependency lambat memblokir banyak thread sekaligus. Sebutkan dua pendekatan dependency resiliency untuk mengurangi beban pada service yang jadi bottleneck. :: (1) Caching hasil dependency call (server caching per service, atau composite/materialized view caching untuk hasil gabungan beberapa service) dengan TTL sesuai toleransi data staleness; (2) meneruskan data yang dibutuhkan lewat HTTP header di sepanjang rantai pemanggilan, sehingga service downstream tidak perlu memanggil ulang service hub yang sama. Apa fungsi sidecar pattern pada arsitektur microservices yang polyglot? :: Sidecar menyediakan komponen operasional/infrastruktur (mis. Prana pada NetflixOSS) yang berjalan berdampingan dengan aplikasi utama non-JVM, memberi akses homogen ke platform services (registry, config, metrics) lewat HTTP, tanpa aplikasi harus mengimplementasikan ulang integrasi native ke tiap platform service per bahasa pemrograman. Sebutkan isi 10 fungsi API Gateway pattern pada composition pattern. :: Single entry point, routing, load balancing, service discovery, protocol conversion, data format conversion, security implementation, orchestration, data aggregation, dan proxy. Mengapa client-side smart load balancer (seperti Ribbon) lebih disarankan dibanding central load balancer pada microservices? :: Karena client-side smart load balancer dapat memperhitungkan kondisi real-time tiap instance (jumlah outstanding request, instance yang circuit-nya sedang open/tripped, zona yang bermasalah) untuk memilih instance tujuan paling sehat, lebih adaptif terhadap kegagalan instance individual dibanding central load balancer yang cenderung statis.