Catatan ini membahas berbagai data model yang digunakan dalam sistem terdistribusi/big data, mulai dari model relational tradisional hingga berbagai varian NoSQL (key-value, document, column-oriented/wide-column, graph). Materi menjadi fondasi untuk topik pemrosesan data skala besar terdistribusi (pemilihan storage) serta reliabilitas dan skalabilitas sistem terdistribusi, sebelum masuk ke pembahasan storage engine internal (B-tree/LSM) yang dibahas pada catatan terpisah.
Relational Database
Relational Database dengan dukungan SQL adalah database yang paling sering digunakan saat ini. Relational database pada dasarnya dirancang untuk berjalan pada single node, sehingga strategi peningkatan kapasitasnya berbeda dengan sistem terdistribusi native.
Scale Up
Scale up dilakukan dengan menambah kapasitas node tunggal — menggunakan core, memory, dan storage yang lebih besar (misal dari 16 core/128 GB memory menjadi 96 core/768 GB memory). Pendekatan ini punya batas fisik/biaya karena bergantung pada satu mesin.
Scale Out: Read Replicas
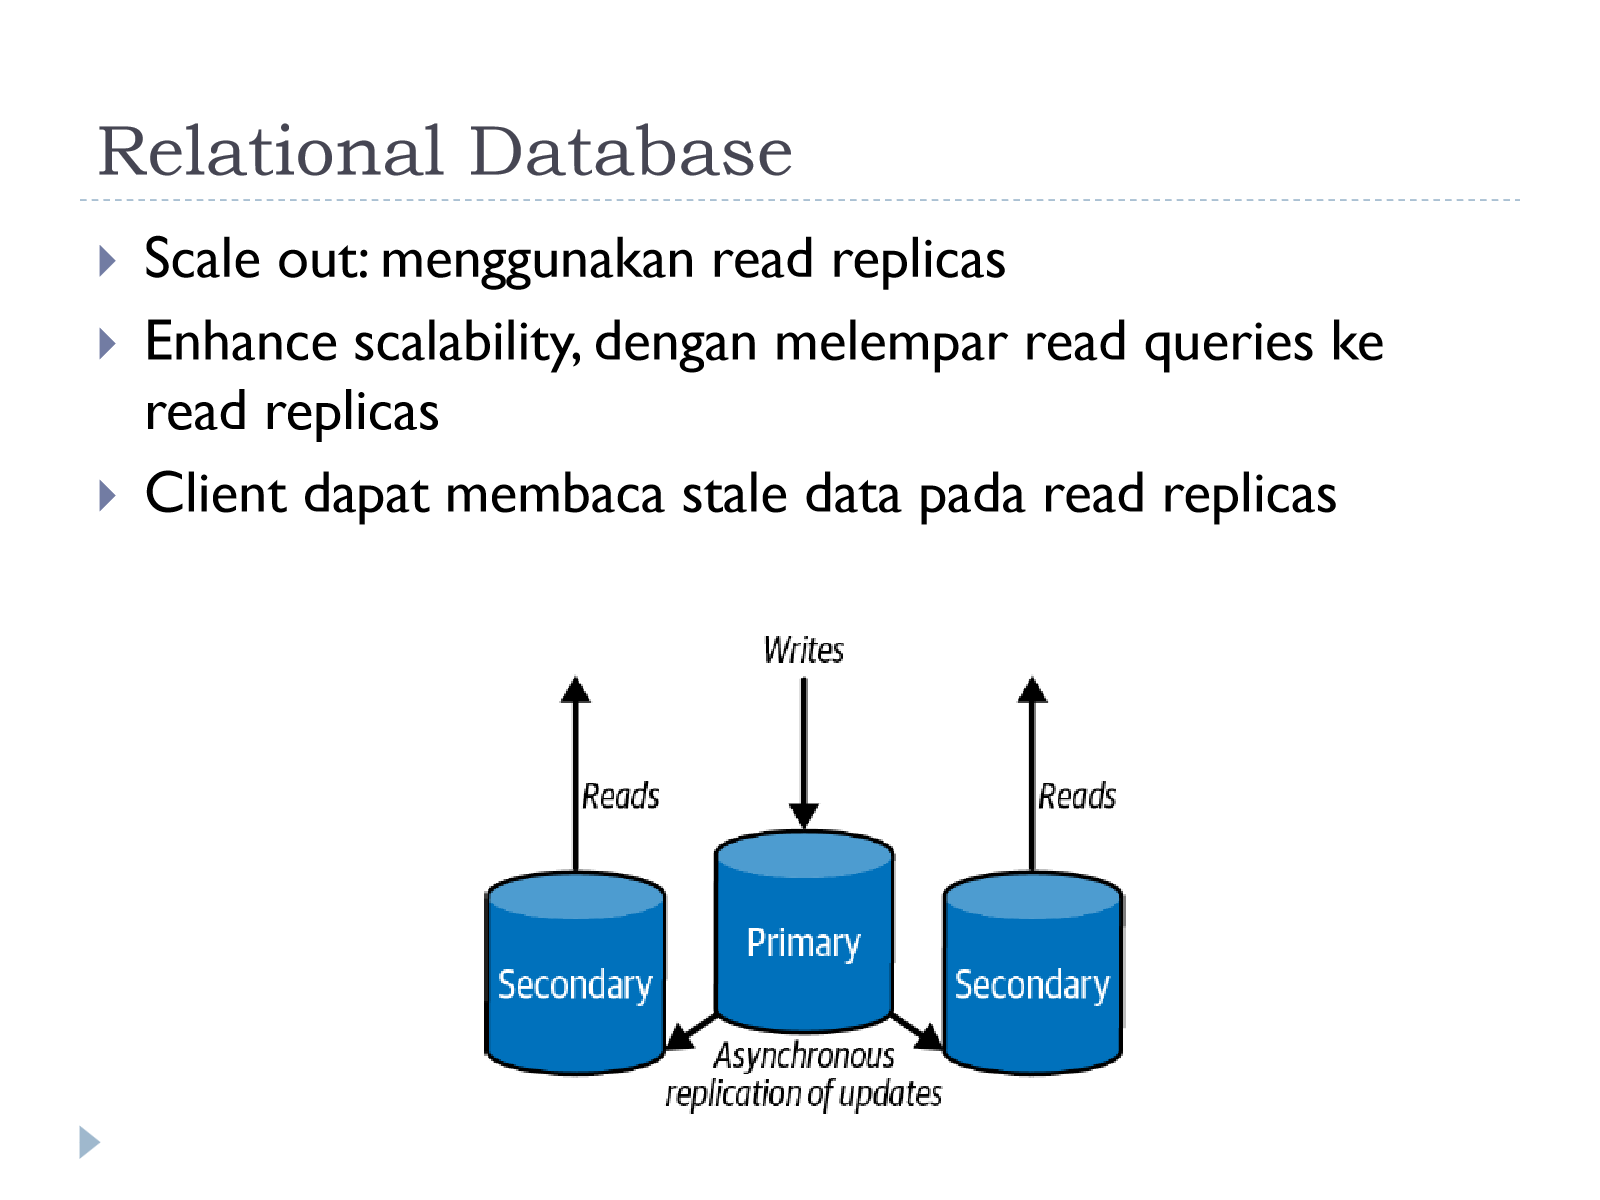
Scale out dapat dilakukan dengan menggunakan read replicas: enhance scalability dengan melempar read queries ke read replicas, sementara write tetap ditangani oleh primary. Replikasi dari primary ke secondary bersifat asynchronous, sehingga client dapat membaca stale data pada read replicas (data yang dibaca belum tentu merupakan hasil update terbaru).
Scale Out: Partitioning
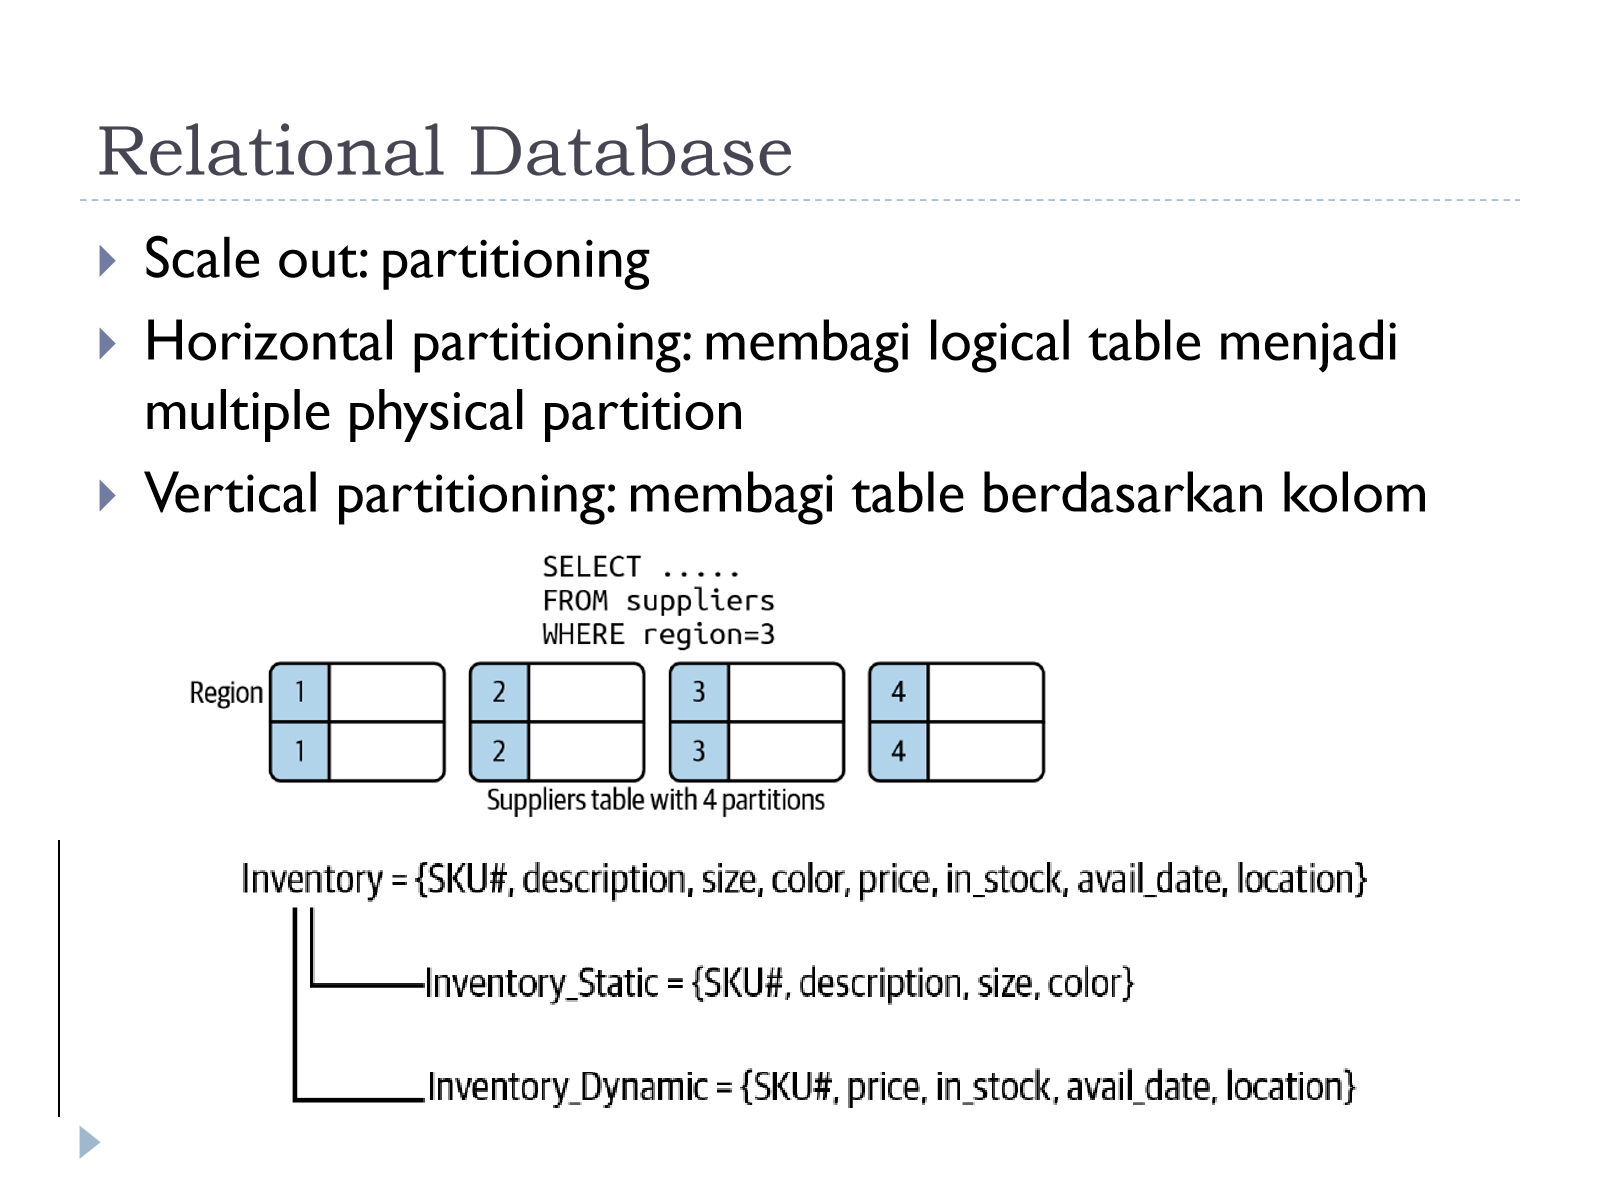
Selain read replicas, scale out dapat dilakukan melalui partitioning:
- Horizontal partitioning: membagi logical table menjadi beberapa physical partition berdasarkan baris (misal tabel suppliers dipartisi menjadi 4 partisi berdasarkan
region, sehingga queryWHERE region=3cukup diarahkan ke partisi region 3). - Vertical partitioning: membagi table berdasarkan kolom. Contoh: tabel
Inventory = {SKU#, description, size, color, price, in_stock, avail_date, location}dipecah menjadiInventory_Static = {SKU#, description, size, color}(kolom yang jarang berubah) danInventory_Dynamic = {SKU#, price, in_stock, avail_date, location}(kolom yang sering berubah).
Cost Partitioning (Distributed Join)
Ketika data terpartisi, eksekusi query yang melibatkan banyak partisi memerlukan distributed join, yang mengakibatkan high traffic & coordination antar node. Desain partisi dan distributed join harus mempertimbangkan agar pertukaran data minimal dan latency berkurang, dengan strategi:
- Reference table yang jarang berubah dan berukuran kecil dapat dikopikan pada setiap mesin (menghindari perlunya join lintas partisi).
- Menggunakan partition key pada joins, sehingga join dapat dilakukan secara lokal per partisi.
- Memastikan salah satu sisi join memiliki highly selective filter, sehingga jumlah row yang dipertukarkan berkurang signifikan.
Contoh Pemodelan Data: Relational vs Dokumen
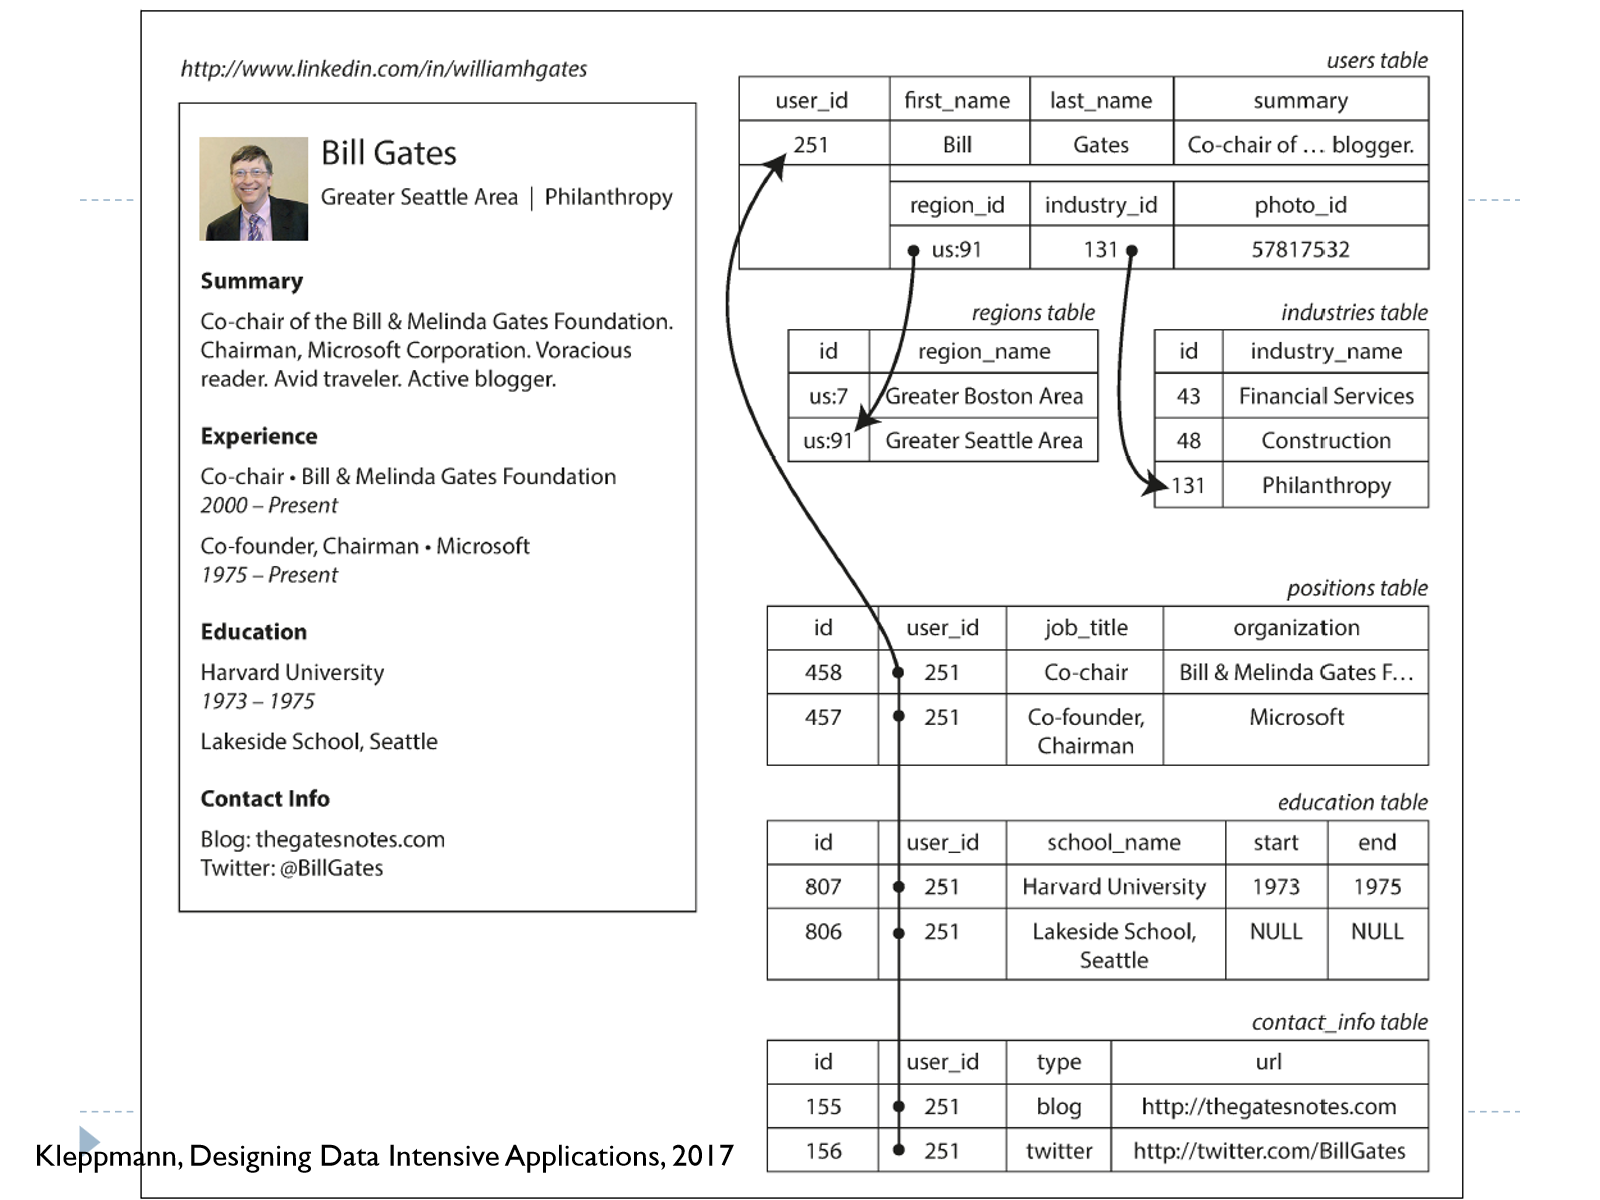
Sebagai ilustrasi, diambil contoh resume pada LinkedIn profile yang berisi informasi pengguna, pekerjaan, pendidikan, alamat, kontak, dsb.
Pemodelan Relational
Pada model relational, data dinormalisasi, sehingga informasi pekerjaan (positions), pendidikan (education), dan kontak (contact_info) disimpan pada tabel-tabel terpisah yang dihubungkan melalui user_id sebagai foreign key. Referensi lain seperti region dan industry juga disimpan sebagai tabel lookup terpisah.
Representasi JSON / Dokumen
Data yang sama dapat direpresentasikan sebagai satu dokumen JSON yang menyatukan seluruh informasi (termasuk array positions dan education) dalam satu struktur:
{
  "user_id": 251,
  "first_name": "Bill",
  "last_name": "Gates",
  "summary": "Co-chair of the Bill & Melinda Gates... Active blogger.",
  "region_id": "us:91",
  "industry_id": 131,
  "photo_url": "/p/7/000/253/05b/308dd6e.jpg",
  "positions": [
    {"job_title": "Co-chair", "organization": "Bill & Melinda Gates Foundation"},
    {"job_title": "Co-founder, Chairman", "organization": "Microsoft"}
  ],
  "education": [
    {"school_name": "Harvard University", "start": 1973, "end": 1975},
    {"school_name": "Lakeside School, Seattle", "start": null, "end": null}
  ],
  "contact_info": {
    "blog": "http://thegatesnotes.com",
    "twitter": "http://twitter.com/BillGates"
  }
}
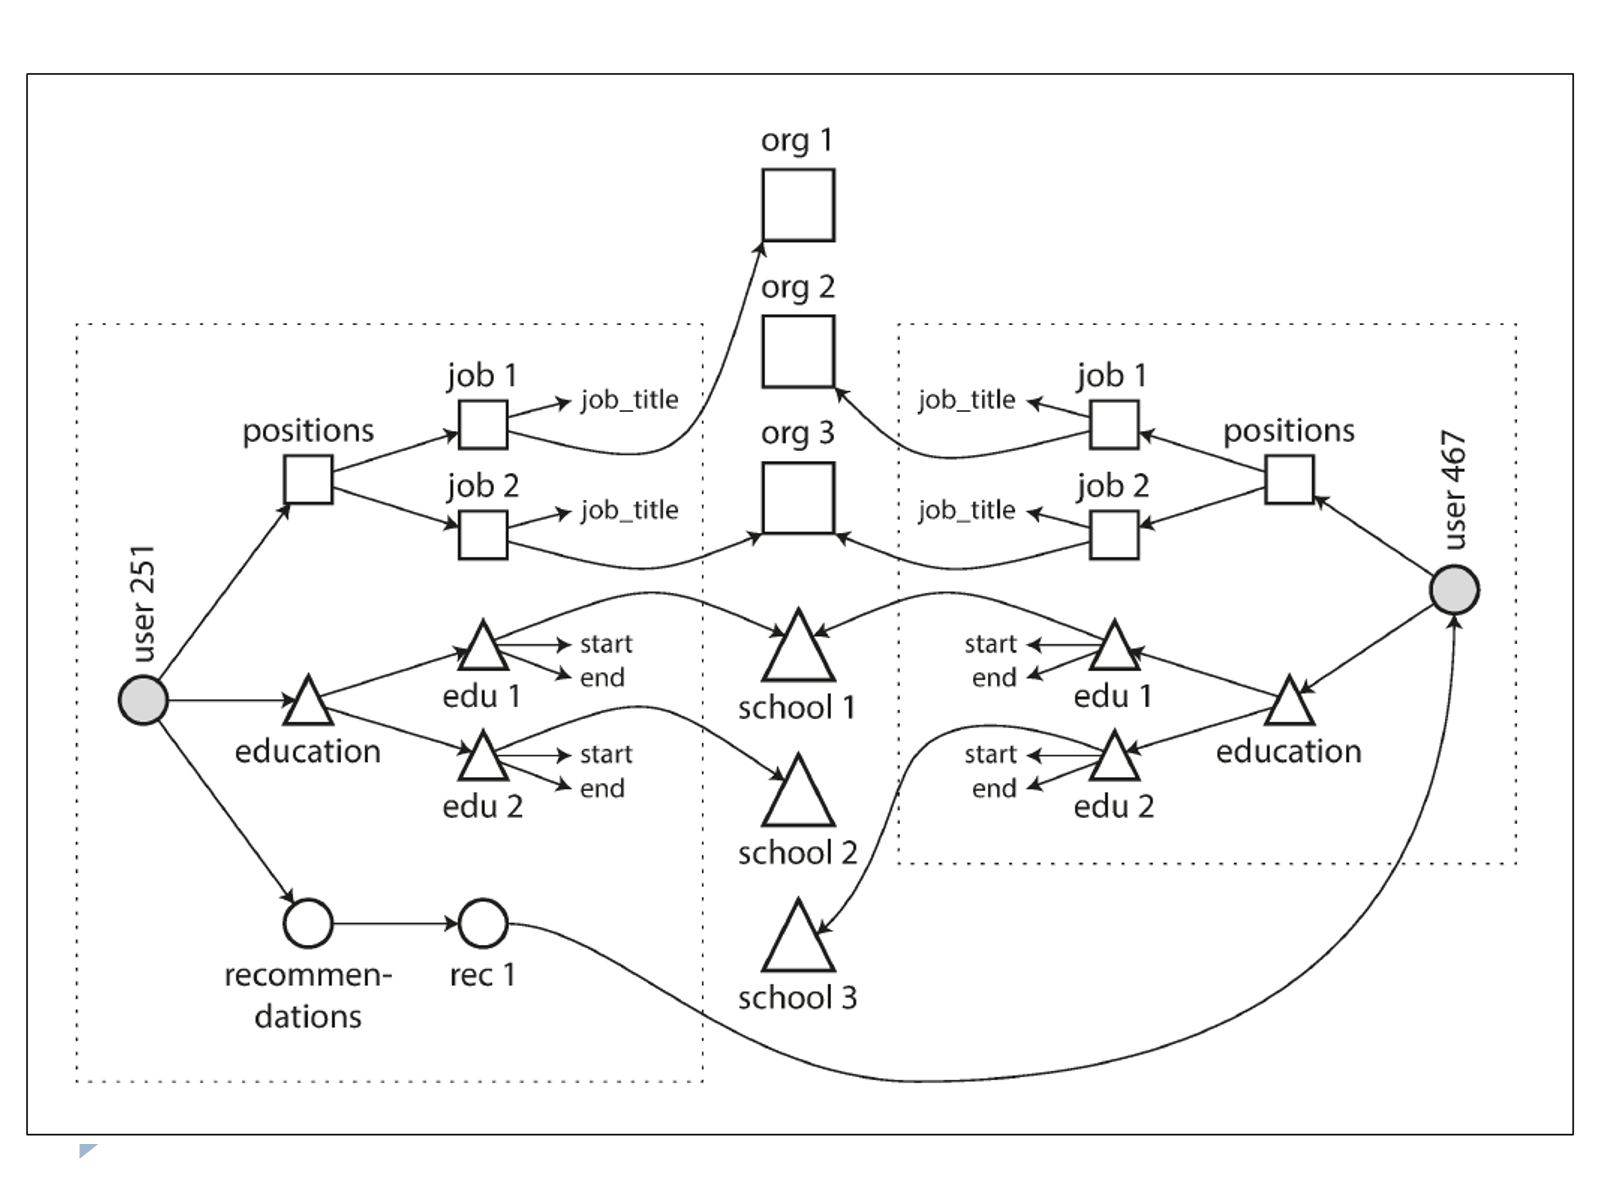
JSON memiliki lokalitas (data locality) yang lebih baik, karena hirarki/struktur data dapat diakses langsung dari parent-nya tanpa perlu join — mulai dari user 251 sebagai root, bercabang ke positions (job 1, job 2, …) dan education (edu 1, edu 2, …) sebagai sub-tree yang tersimpan bersama dalam satu dokumen.
Representasi Dokumen dan Kebutuhan Join
Struktur profil seorang pengguna dapat dimodelkan sebagai sebuah dokumen. Namun, atribut sebuah dokumen dapat pula dimodelkan sebagai dokumen terpisah — misalnya untuk organisasi/kantor dan untuk sekolah — sehingga tetap ada kebutuhan melakukan join antar jenis dokumen yang berbeda (misal untuk menghubungkan positions milik user ke dokumen org, atau education ke dokumen school). Ilustrasi berikut menunjukkan dua user (user 251 dan user 467) yang masing-masing punya positions/education sendiri, namun keduanya merujuk ke dokumen org/school yang sama, plus relasi recommendations antar user.
Relational vs Document Database
Pemilihan antara relational dan document model dapat dipertimbangkan dari beberapa aspek:
- Kesesuaian dengan aplikasi
- Aplikasi dengan kebutuhan data bersifat dokumen/tree oriented, dengan one-to-many relationship, lebih cocok dengan document model.
- Aplikasi yang memerlukan many-to-many relationship, lebih cocok dengan relational model.
- Schema flexibility
- Relational umumnya schema-strict; document dapat schemaless/tidak di-enforce.
- Data locality
- Document dibaca sebagai 1 kesatuan, sehingga pembacaan atribut/tree dalam 1 dokumen akan lebih efisien (tidak perlu join).
Query Language: Deklaratif vs Imperatif
Cara mengakses data dapat bersifat deklaratif (mendefinisikan pola data yang diinginkan tanpa eksplisit memberikan how) atau imperatif (menyatakan langkah-langkah eksplisit untuk mendapatkan data). Sebagai ilustrasi, query “ambil semua hewan dari family Sharks” dapat dinyatakan dalam tiga bentuk:
Relational algebra (deklaratif):
sharks = σfamily = "Sharks" (animals)
SQL (deklaratif):
SELECT * FROM animals WHERE family = 'Sharks';JavaScript (imperatif):
function getSharks() {
  var sharks = [];
  for (var i = 0; i < animals.length; i++) {
    if (animals[i].family === "Sharks") {
      sharks.push(animals[i]);
    }
  }
  return sharks;
}
Keunggulan pendekatan deklaratif:
- Lebih concise dan mudah dibaca/ditulis.
- Performance improvement dilakukan oleh engine (bukan oleh programmer) — misalnya ordering tidak perlu dinyatakan eksplisit pada urutan eksekusi, cukup dinyatakan pada query.
- Engine dapat melakukan optimasi eksekusi parallel tanpa mengubah kode aplikasi.
Graph-Like Data Model
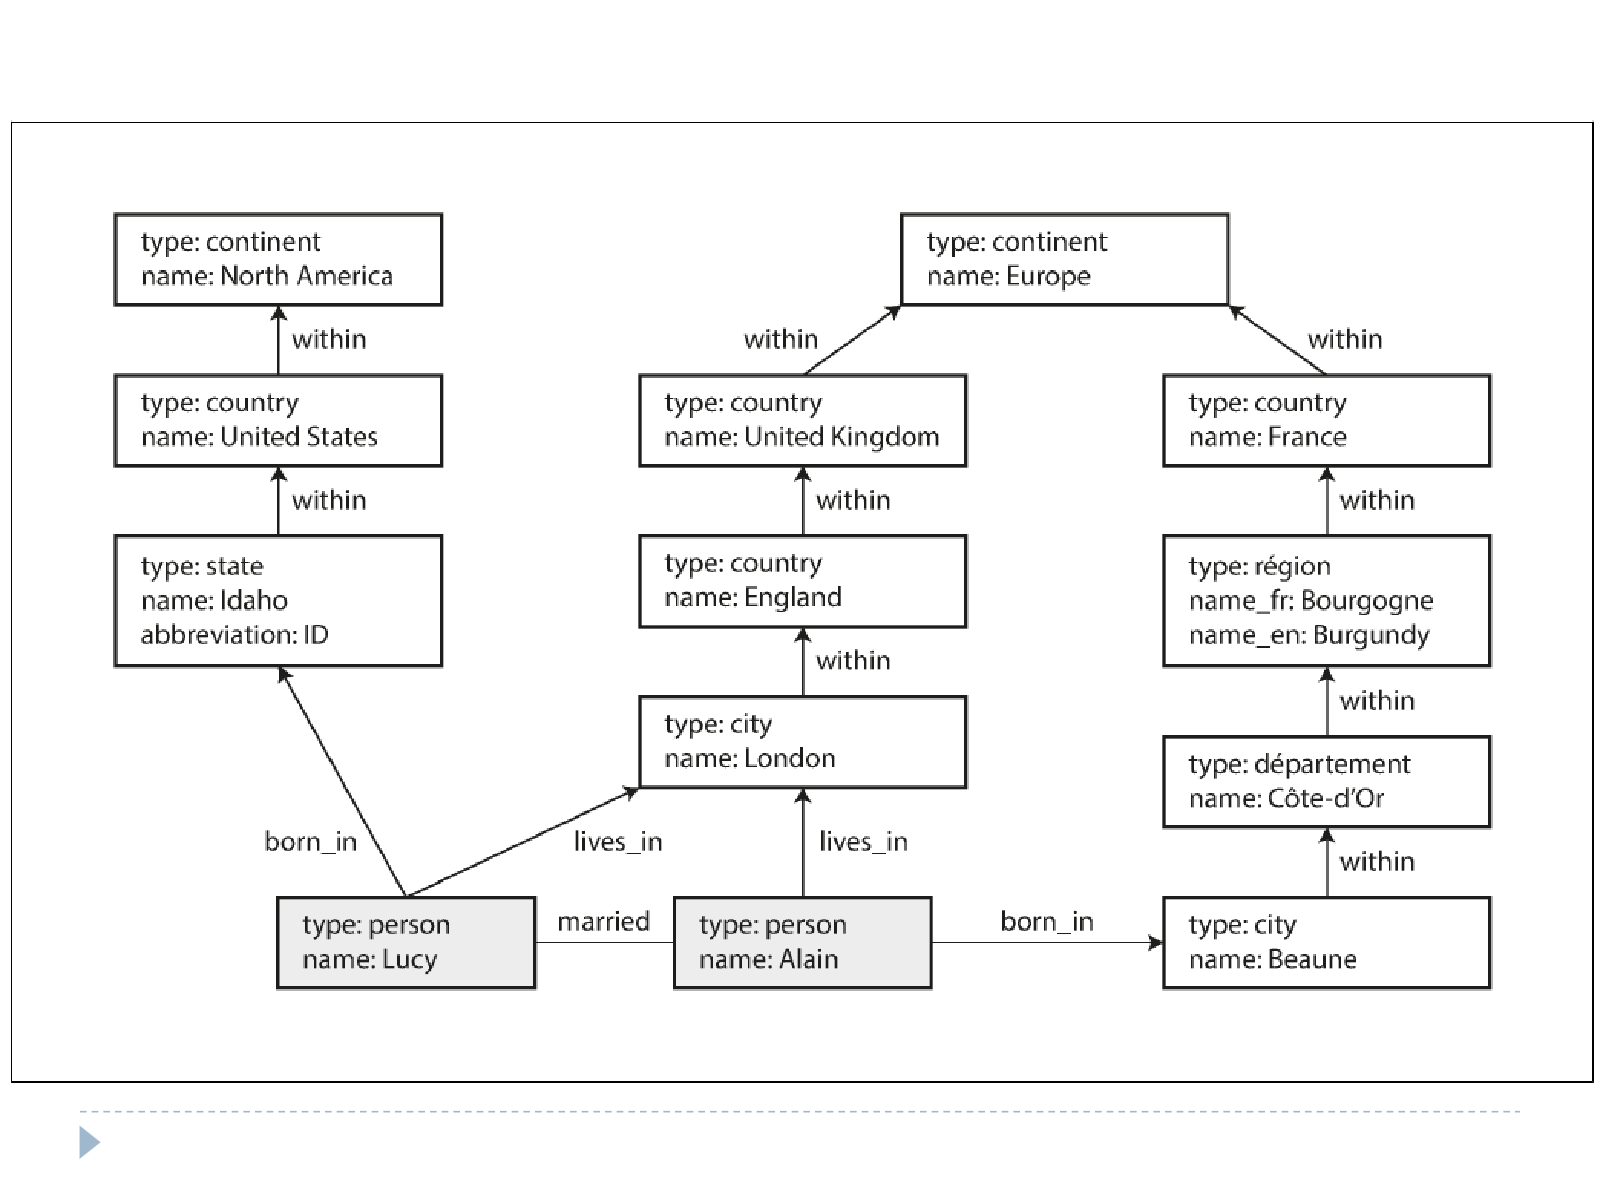
Relasi many-to-many dapat dimodelkan secara natural sebagai graph, yang terdiri atas:
- Vertices/nodes
- Edges/links/relationships/arcs
Vertices dapat bertipe sama (homogeneous), atau beragam (heterogeneous) — misalnya kombinasi vertex bertipe continent, country, state, city, dan person, yang saling terhubung lewat edge berlabel within, born_in, lives_in, married.
Property Graph Model
Struktur dan query graph dapat diimplementasikan dengan dua pendekatan utama: property graph model (contoh: Neo4j, Titan, InfiniteGraph) dan triple-store model (contoh: Datomic, AllegroGraph, SPARQL, Datalog).
Pada property graph model:
- Vertex terdiri atas: unique id, set of outgoing edges, set of incoming edges, collection of properties.
- Edge terdiri atas: unique id, tail vertex (asal edge), head vertex (akhir edge), label, collection of properties.
Model ini bisa direpresentasikan di atas relational database dengan skema berikut:
CREATE TABLE vertices (
  vertex_id integer PRIMARY KEY,
  properties json
);

CREATE TABLE edges (
  edge_id integer PRIMARY KEY,
  tail_vertex integer REFERENCES vertices (vertex_id),
  head_vertex integer REFERENCES vertices (vertex_id),
  label text,
  properties json
);

CREATE INDEX edges_tails ON edges (tail_vertex);
CREATE INDEX edges_heads ON edges (head_vertex);
Karakteristik property graph model:
- Any vertex dapat memiliki edge ke any vertex lain.
- Diberikan sebuah vertex, dapat ditelusuri ke vertex lain dua arah (mengikuti incoming maupun outgoing edges).
- Dengan menggunakan label berbeda pada edge, dapat dimodelkan beragam informasi relasi antar vertex.
Contoh penggunaan Cypher Query Language (bahasa query deklaratif untuk property graph):
CREATE
(NAmerica:Location {name:'North America', type:'continent'}),
(USA:Location {name:'United States', type:'country' }),
(Idaho:Location {name:'Idaho', type:'state' }),
(Lucy:Person {name:'Lucy' }),
(Idaho) -[:WITHIN]-> (USA) -[:WITHIN]-> (NAmerica),
(Lucy) -[:BORN_IN]-> (Idaho)

MATCH
(person) -[:BORN_IN]-> () -[:WITHIN*0..]-> (us:Location {name:'United States'}),
(person) -[:LIVES_IN]-> () -[:WITHIN*0..]-> (eu:Location {name:'Europe'})
RETURN person.name
Triple-Store Model
Pada triple-store model, informasi disimpan sebagai tuple (subject, predicate, object):
- Subject adalah vertex.
- Object dapat berupa value (predicate dan object memodelkan properties).
- Object dapat berupa vertex lain (predicate memodelkan edge).
Contoh representasi (format Turtle/RDF):
@prefix : <urn:example:>.
_:lucy a :Person.
_:lucy :name "Lucy".
_:lucy :bornIn _:idaho.
_:idaho a :Location.
_:idaho :name "Idaho".
_:idaho :type "state".
_:idaho :within _:usa.
_:usa a :Location.
_:usa :name "United States".
_:usa :type "country".
_:usa :within _:namerica.
_:namerica a :Location.
_:namerica :name "North America".
_:namerica :type "continent".
Query terhadap triple-store dilakukan dengan SPARQL:
PREFIX : <urn:example:>
SELECT ?personName WHERE {
  ?person :name ?personName.
  ?person :bornIn / :within* / :name "United States".
  ?person :livesIn / :within* / :name "Europe".
}
NoSQL: Latar Belakang dan Tujuan
Istilah noSQL awalnya adalah nama sebuah relational DBMS yang tidak menggunakan SQL (dicetuskan oleh Carlo Strozzi, 1998). Istilah NoSQL kemudian mulai digunakan untuk mengacu ke non-relational DBMS seperti Cassandra dan HBase pada tahun 2009.
Goal NoSQL: mencari solusi alternatif untuk kasus jika RDBMS tidak cocok digunakan, terutama terkait:
- Skalabilitas di atas commodity hardware
- High throughput
- Biaya
- Kompleksitas
- Kompromi reliabilitas untuk kinerja yang lebih baik
Goal Layanan Online: ACID vs BASE
Goal layanan online umumnya:
- Scalability: kapasitas mudah ditambahkan dengan menambahkan node.
- Mengutamakan availability, bukan consistency.
- Fleksibel: struktur data dapat ditambahkan dengan mudah, dan data boleh tidak lengkap.
- Performance.
Perbedaan properti transaksional:
| Kepanjangan | Prioritas | |
|---|---|---|
| ACID (tipikal RDBMS) | Atomicity, Consistency, Isolation, Durability | Konsistensi & korektnya transaksi |
| BASE (tipikal NoSQL) | Basic Availability, Soft state, Eventual consistency | Availability & skalabilitas |
Strategi Desain Model Data NoSQL
Karakteristik umum pendekatan NoSQL:
- Tidak relational: umumnya tidak mendukung complex queries (seperti join lintas tabel).
- Column oriented: pada beberapa jenis NoSQL, data disimpan berdasarkan column, bukan row/record.
- Non-transactional, dengan eventual consistency.
- Penanganan join: RDBMS melakukan normalisasi data agar hanya ada 1 entri untuk setiap data (sehingga update cukup dilakukan 1 kali) — pendekatan ini fokus pada problem domain. NoSQL sebaliknya fokus pada solution domain: desain model data didasarkan pada common data access pattern yang diperlukan aplikasi, dengan menggunakan denormalized data model (data yang sama boleh diduplikasi di beberapa tempat demi kecepatan akses).
Klasifikasi NoSQL
Klasifikasi NoSQL cukup beragam. Salah satu yang cukup detail diusulkan oleh Stephen Yen (2009):
- Key Value Cache: Memcached, Repcached, Coherence, JBoss Cache
- Key Value Store: Keyspace, Flare, RAMCloud
- Eventually Consistent Key Value Store: Dynamo, Voldemort, Riak, Dynomite
- Ordered Key Value Store: Tokyo Cabinet, Lightcloud, MemcacheDB
- Data Structure Server: Redis
- Tuple Store: Gigaspaces, Apache River
- Object Database: ZopeDB, DB4O
- Document Store: MongoDB, CouchDB
- Wide Columnar Store: Bigtable, Cassandra, HBase
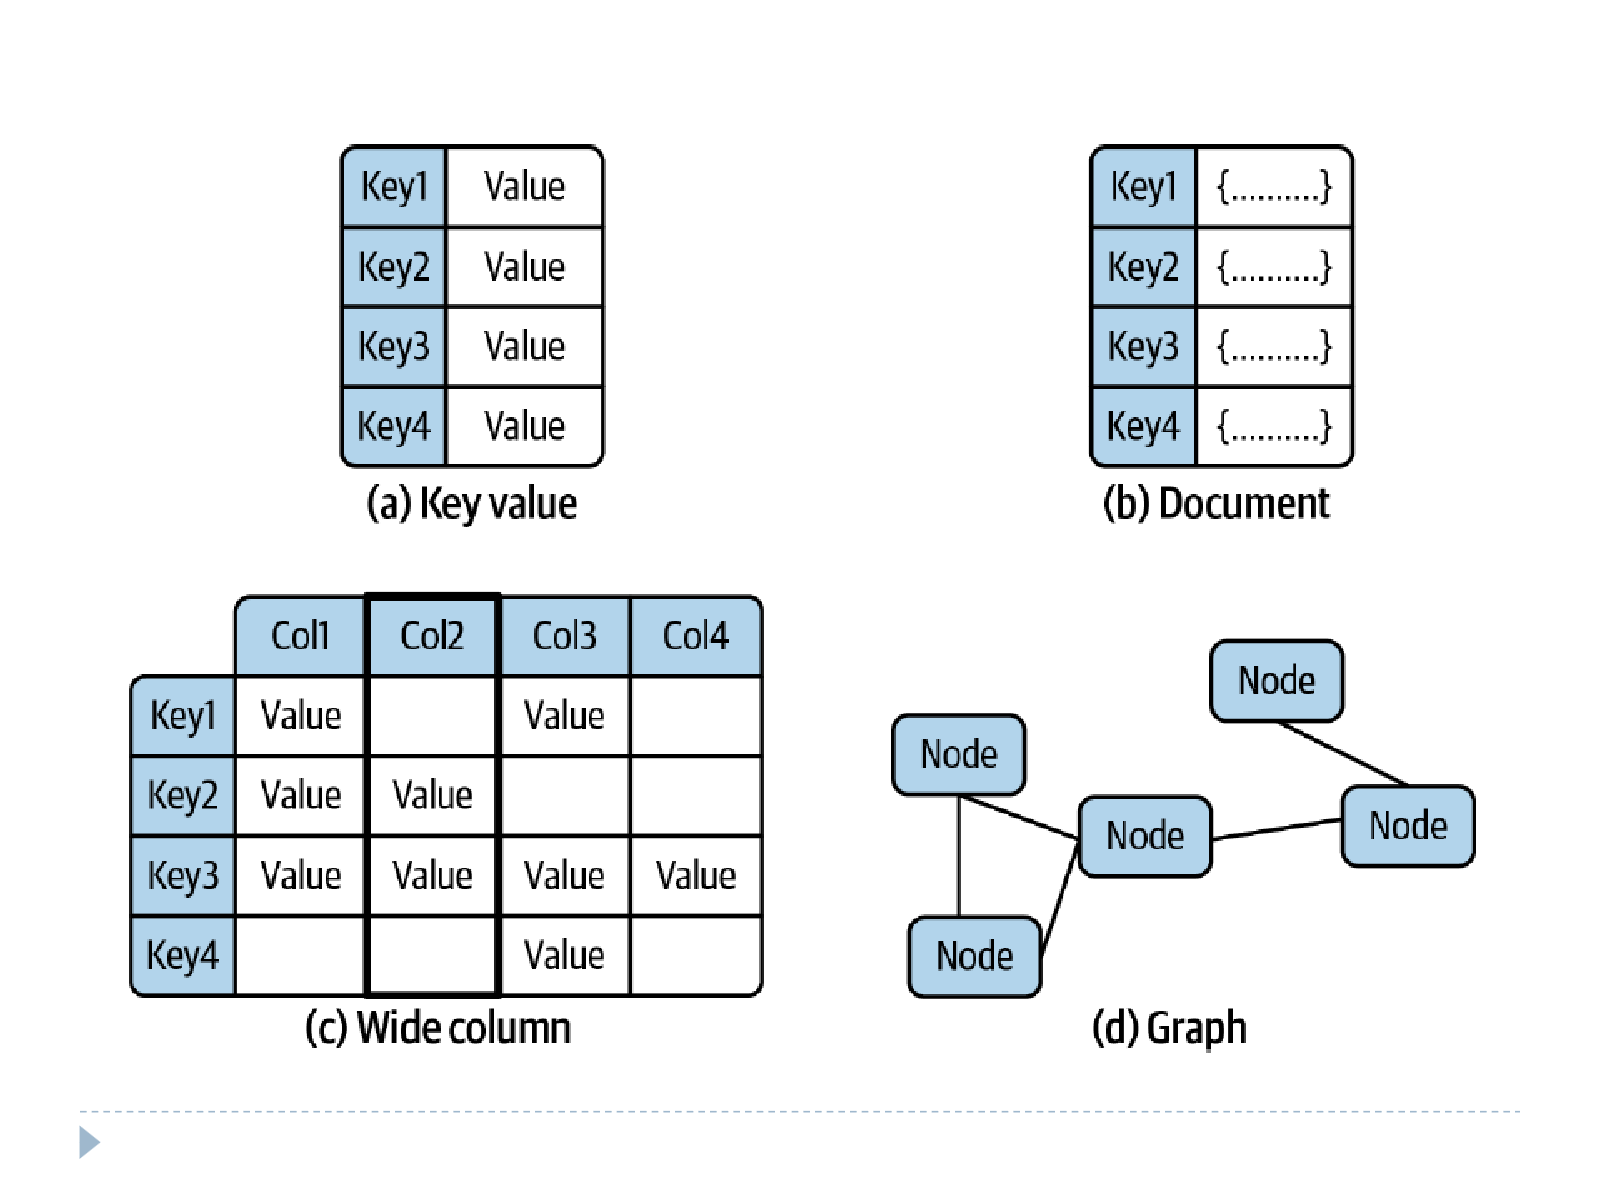
Klasifikasi ini dapat disederhanakan menjadi empat kelompok besar:
- Key-Value: Redis, Membase, Voldemort, MemcacheDB, Riak, BerkeleyDB, HamsterDB
- Column Oriented: HBase, Cassandra, SimpleDB, BigTable, Cloudera
- Document Oriented: MongoDB, CouchDB, RavenDB, Terrastore
- Graph: Neo4J, FlockDB, InfiniteGraph
Perbandingan Jenis Data Model
| Data Model | Struktur Data | Contoh Use Case | Contoh Database |
|---|---|---|---|
| Relational | Tabel (baris/kolom) ternormalisasi, relasi antar tabel via foreign key & join | Aplikasi dengan relasi many-to-many kompleks, transaksi yang butuh ACID (perbankan, inventory) | MySQL, PostgreSQL, Oracle |
| Key-Value | Pasangan key → value (value bisa string, hash, list, set); optimal untuk lookup berdasarkan key | Cache, session store, lookup cepat berdasarkan key | Redis, Membase, Voldemort, Riak, MemcacheDB |
| Document | Dokumen JSON/BSON bersarang (nested), self-contained per dokumen, schemaless | Data hierarkis/tree, profil pengguna, relasi one-to-many | MongoDB, CouchDB, RavenDB |
| Column-Oriented/Wide-Column | Data dikelompokkan berdasarkan column family; row key dengan kolom yang dinamis (tidak semua row punya kolom sama) | Data volume besar, write-heavy, time-series, big data analytics | Cassandra, HBase, BigTable |
| Graph | Vertices (node) & edges (relationship), masing-masing dengan properties | Relasi many-to-many yang kompleks/dalam, social network, rekomendasi | Neo4J, FlockDB, InfiniteGraph |
Key/Value Store
Key/Value store menyediakan fasilitas penyimpanan berdasarkan key (mirip dengan hashtable), misalnya memcachedDB, EHcache, Redis, dan Voldemort. Karakteristik utama:
- Optimasi untuk query terhadap key (bukan berdasarkan value/content).
- Umumnya disimpan pada memory.
- Dapat mendukung beberapa tipe struktur data, seperti set, list, string, hash, dsb.
Contoh: Redis
Redis mendukung tipe data set, hash, list, dan string:
SET company "My Company"          //String
HSET alice firstName "Alice"      //Hash – set field value
HSET alice lastName "Matthews"    //Hash – set field value
LPUSH "alice:sales" "10" "20"     //List create/append
LSET "alice:sales" "0" "4"        //List update
SADD "alice:friends" "f1" "f2"    //Set – create/update
SADD "bob:friends" "f2" "f1"      //Set – create/update
Operasi terhadap tipe Set memanfaatkan operasi himpunan:
//Intersection – Get mutual friends of Alice and Bob
SINTER "alice:friends" "bob:friends"
//Difference – Friends in Alice's list absent in Bob's
SDIFF "alice:friends" "bob:friends"
//Union – All friends that need invitation in their marriage
SUNION "alice:friends" "bob:friends"
Operasi terhadap tipe List:
//Pop the first item, or return null
POP "key:name"
//Blocking pop – pop the first item, or wait until timeout or next
//is available (check across lists – l1, l2, l3)
BLPOP l1 l2 l3
//Pop item from list1, append to list2 and return the value
RPOPLPUSH list1 list2
Column-Oriented Store
Column-oriented store (contoh: HBase, Cassandra, SimpleDB, BigTable, Cloudera) menyimpan data berdasarkan column.
Contoh: Cassandra
Pada Cassandra, dapat didefinisikan keyspace (serupa dengan database) dan column family (serupa dengan tabel):
create keyspace CarDataStore;
use CarDataStore;
create column family Cars;
set Cars['Prius']['make'] = 'toyota';
set Cars['Prius']['model'] = 'prius 3';
set Cars['Corolla']['make'] = 'toyota';
Contoh: HBase
hbase(main):003:0> create 'test', 'cf'
0 row(s) in 1.2200 seconds
hbase(main):003:0> list 'test'
1 row(s) in 0.0550 seconds
hbase(main):004:0> put 'test', 'row1', 'cf:a', 'value1'
0 row(s) in 0.0560 seconds
hbase(main):005:0> put 'test', 'row2', 'cf:b', 'value2'
0 row(s) in 0.0370 seconds
hbase(main):006:0> put 'test', 'row3', 'cf:c', 'value3'
0 row(s) in 0.0450 seconds
Hasil scan menunjukkan bagaimana setiap row menyimpan kolom (dalam column family cf) beserta timestamp-nya:
hbase(main):007:0> scan 'test'
ROW    COLUMN+CELL
row1   column=cf:a, timestamp=1288380727188, value=value1
row2   column=cf:b, timestamp=1288380738440, value=value2
row3   column=cf:c, timestamp=1288380747365, value=value3
3 row(s) in 0.0590 seconds
Document Database
Document DB serupa dengan key/value, namun tanpa spesifik mendefinisikan key, dan query dapat dilakukan terhadap value/isi dokumen. Umumnya digunakan untuk menyimpan data terstruktur dengan format JSON. Contoh: MongoDB, CouchDB.
Contoh: MongoDB
Dua dokumen berikut menunjukkan fleksibilitas schema pada document DB — dokumen kedua memiliki field tambahan (Address, Projects) yang tidak dimiliki dokumen pertama:
{ "EmployeeID": "SM1",
  "FirstName" : "Anuj",
  "LastName" : "Sharma",
  "Age" : 45,
  "Salary" : 10000000
}
{ "EmployeeID": "MM2",
"FirstName" : "Anand",
"Age" : 34,
"Salary" : 5000000,
"Address" : { "Line1" : "123, 4th Street",
"City" : "Bangalore",
"State" : "Karnataka" },
"Projects" : [ "nosql-migration",
"top-secret-007" ]
}Operasi dasar pada MongoDB:
use employeedb
a = { "EmployeeID": "SM1",
  "FirstName" : "Anuj",
  "LastName" : "Sharma",
  "Age" : 45,
  "Salary" : 10000000}
db.employee.save(a)
db.employee.find( {"FirstName":"Anuj" })
Graph Database
Pada graph database, relasi direpresentasikan sebagai graf dengan komponen: Graph mencatat data dalam bentuk Nodes dan Relationships, di mana Relationships mengorganisasi Nodes, dan baik Nodes maupun Relationships memiliki Properties. Contoh: Neo4J dan FlockDB.
Contoh penggunaan Neo4j melalui Java API:
// Assume that we get the underlying database service somehow
GraphDatabaseService db = ...
Node node1 = db.createNode();
node1.setProperty("documentId", "alice");
Node node2 = db.createNode();
node2.setProperty("documentId", "bob");
RelationType friendRel = new RelationType() {
  public String name() { return "friend"; }
};
Relationship reln = node1.createRelationshipTo(node2, friendRel);
reln.setProperty("initatedBy", "alice");
reln.setProperty("createdOn", "1980-01-01T07:30+0530");
Contoh graph query dengan Cypher untuk kasus book review — mencari buku lain yang disukai pembaca-pembaca yang juga menyukai buku ‘Dune’ yang disukai Alice (pola: reader -LIKES-> book <-LIKES- another reader -LIKES-> another book):
MATCH (:Reader {name:'Alice'})-[:LIKES]->(:Book {title:'Dune'})
      <-[:LIKES]-(:Reader)-[:LIKES]->(books:Book)
RETURN books.title
Arsitektur/Teknologi Penyimpanan NoSQL (Ringkas)
Beberapa pendekatan arsitektur penyimpanan pada sistem NoSQL:
- In-Memory Databases: dengan menyimpan data di memori, akses menjadi jauh lebih cepat (contoh: Redis).
- Memtables dan SSTables: operasi write ditulis di memori (sebagai memtable), dan agar durable, juga dituliskan ke append-only log; setelah memtable penuh, isinya ditulis ke disk (disebut SSTable). Contoh: Bigtable, Cassandra. (Detail mekanisme storage engine seperti ini dibahas lebih lanjut pada catatan terpisah.)
- MongoDB: menyimpan dokumen secara internal dengan format BSON (binary encoded JSON); setiap collection document dapat dipartisi secara horizontal (shard).
Pertimbangan Desain Sistem NoSQL
Ketika memilih atau mendesain sistem NoSQL, beberapa aspek yang perlu dipertimbangkan:
- Model data dan query: bagaimana model data dan cara query data yang disediakan.
- Durability: jika ada perubahan, apakah langsung tersimpan durable, apakah ada kopi/replikasi.
- Scalability: apakah data muat dalam 1 server, apakah read/write melibatkan banyak disk/node.
- Partitioning: apakah data harus dibagi ke beberapa server, dan bagaimana mengetahui lokasi data.
- Consistency: jika data terpartisi dan terreplikasi, bagaimana koordinasi antar server dilakukan? Bagaimana jaminan bahwa data yang dibaca adalah data terbaru?
- Transactional semantic: sejauh mana dukungan ACID diberikan.
- Single-server performance: bagaimana potensi bottleneck penulisan dan pembacaan data pada 1 node.
Data Partitioning
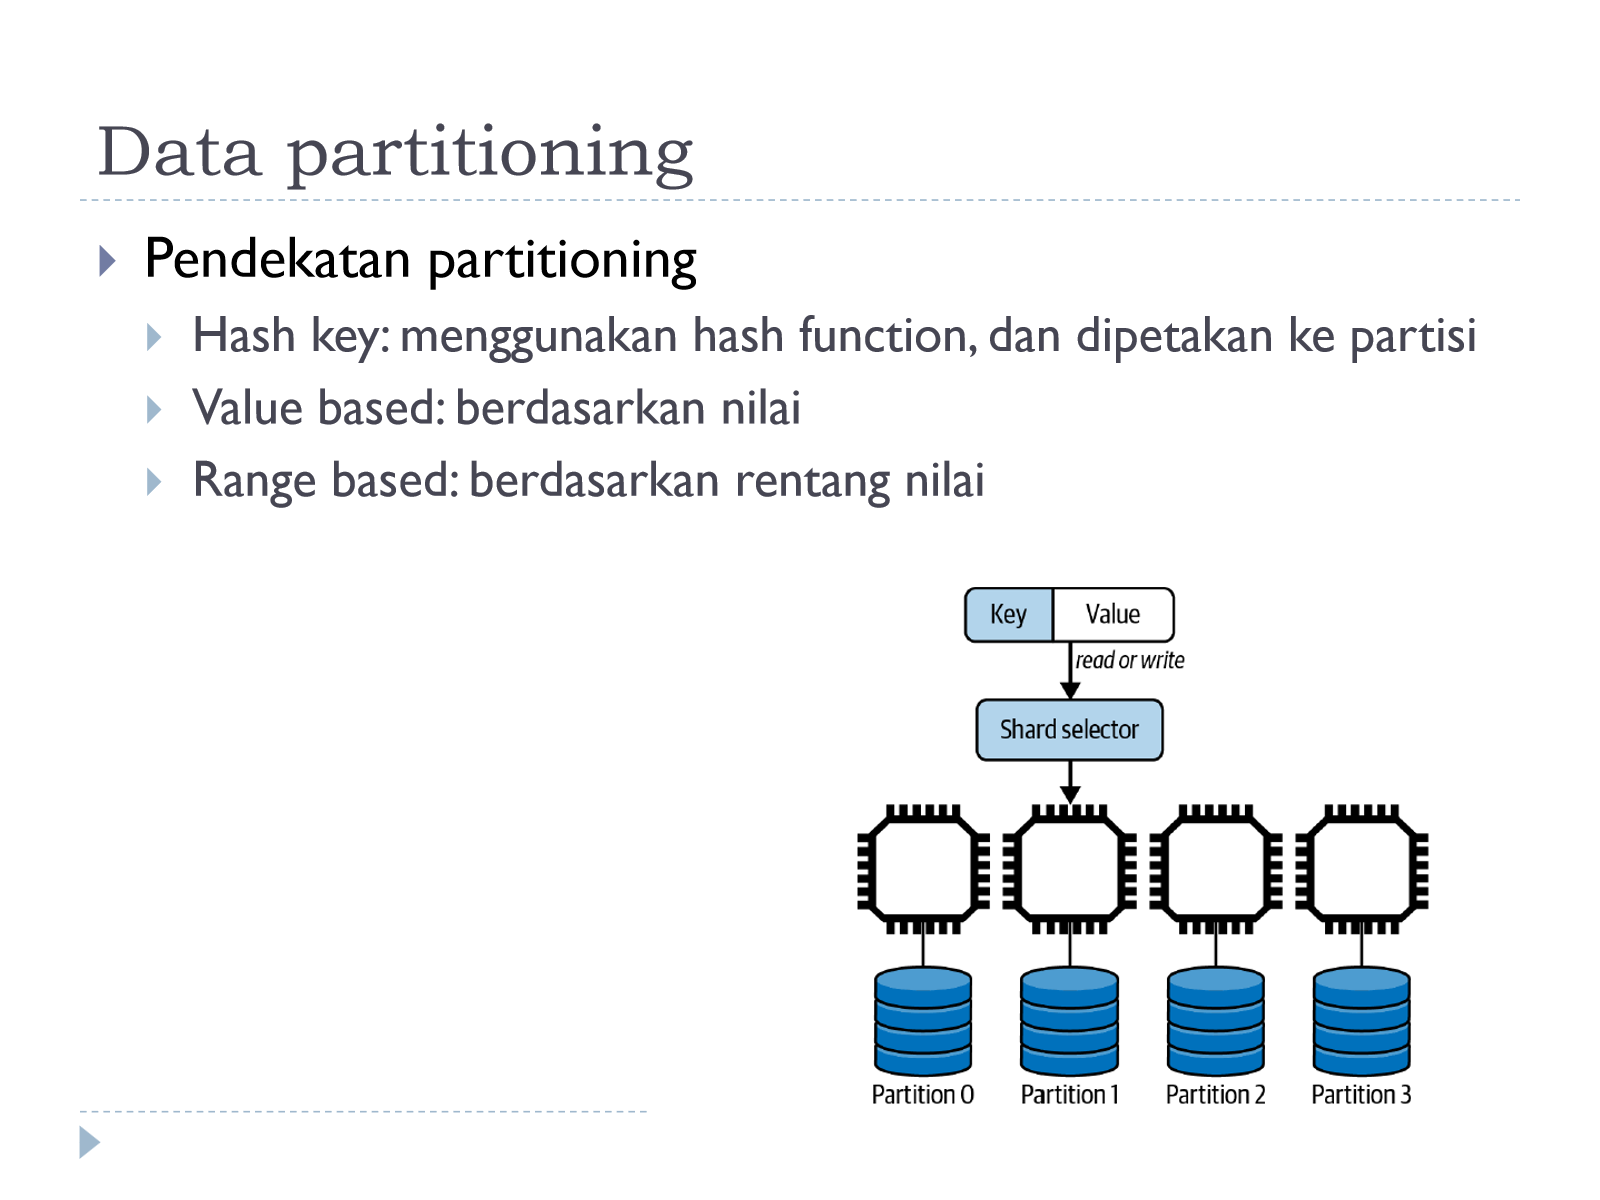
Terdapat beberapa pendekatan partitioning data:
- Hash key: menggunakan hash function terhadap key, hasilnya dipetakan ke partisi tertentu.
- Value based: partisi ditentukan berdasarkan nilai data.
- Range based: partisi ditentukan berdasarkan rentang nilai (range) data.
Secara umum, permintaan read/write terhadap sebuah key akan melalui shard selector yang menentukan ke partisi mana permintaan tersebut harus diarahkan.
Data Replication
Terdapat dua strategi utama replikasi data pada sistem NoSQL:
- Leader – follower: satu replica berperan sebagai leader dan menangani setiap operasi update; replica lain (follower) menerima update dari leader.
- Leaderless: any replica dapat menerima read maupun update. Replica yang menerima update berperan sebagai request coordinator yang bertanggung jawab memastikan replica lain menerima update tersebut dengan benar.
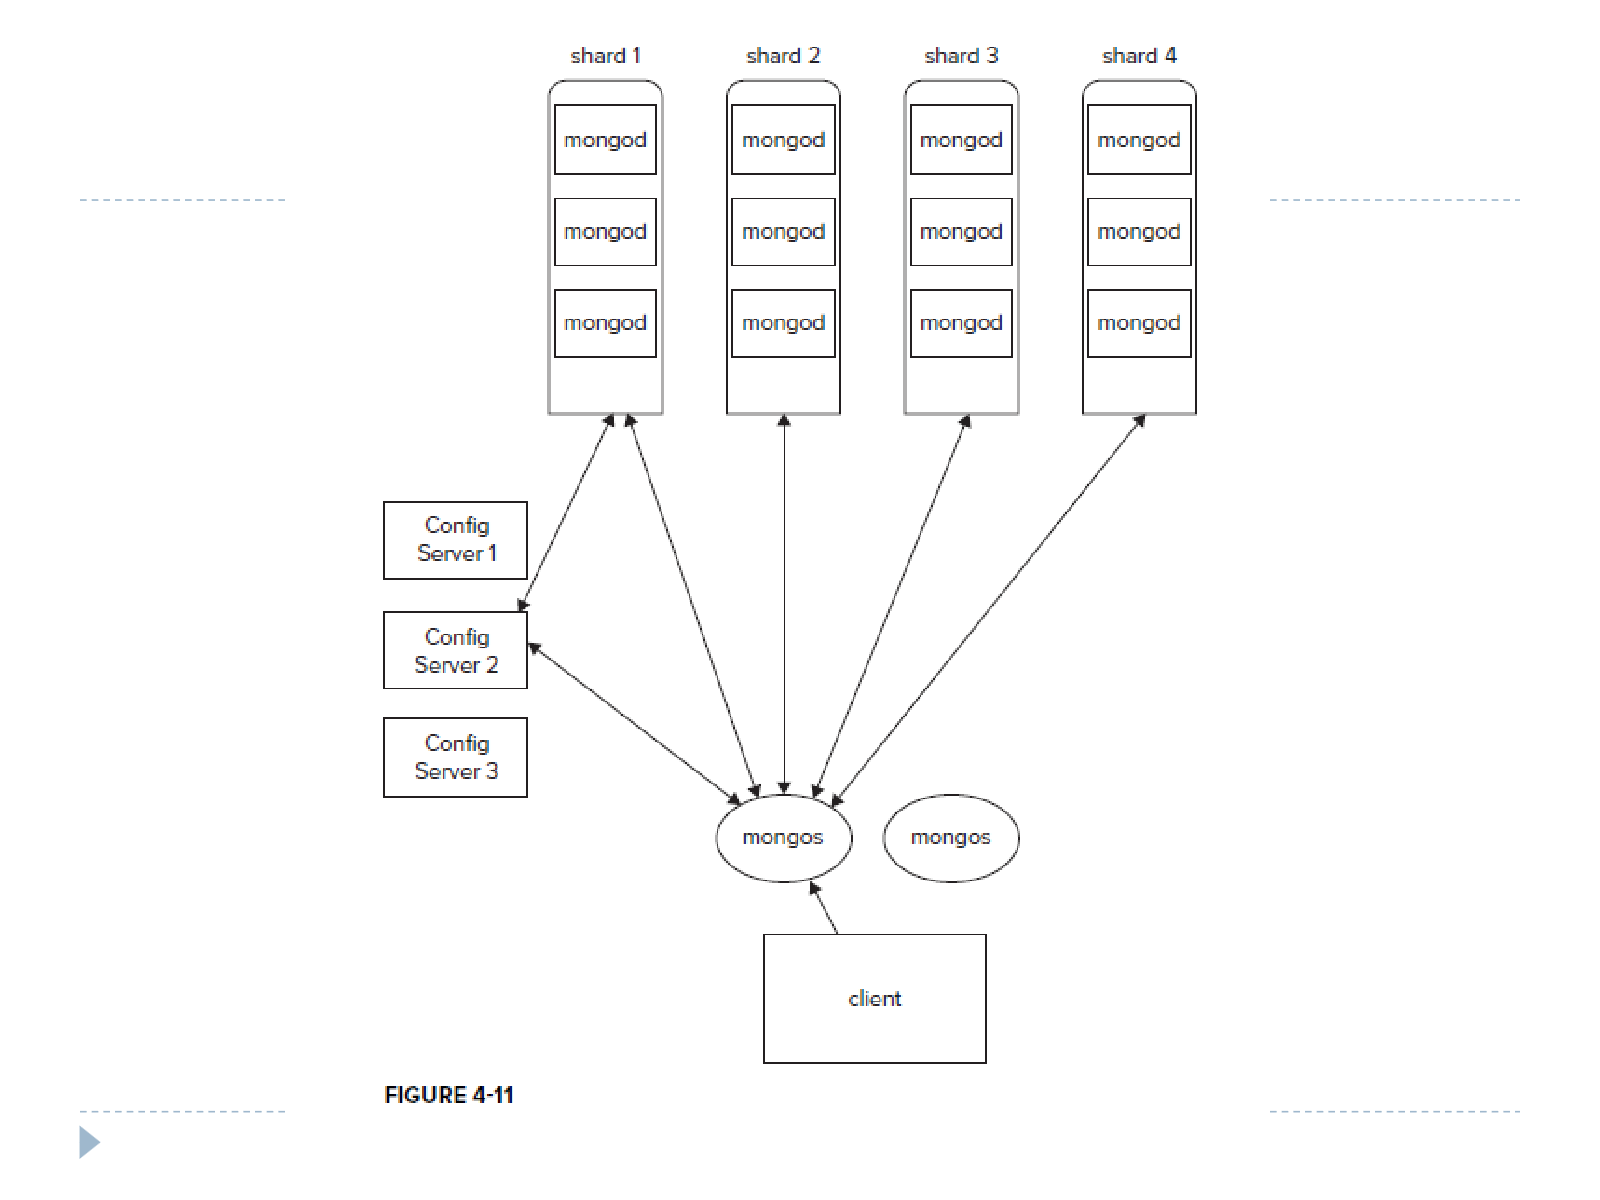
Sebagai ilustrasi arsitektur nyata, MongoDB dengan sharding menggunakan beberapa shard (masing-masing berisi beberapa instance mongod, yang biasanya membentuk replica set), config server untuk menyimpan metadata pemetaan data ke shard, dan mongos sebagai router yang diakses client untuk menentukan shard mana yang harus dituju untuk suatu operasi.
Flashcard
flashcards Apa perbedaan utama scale up dan scale out pada relational database? :: Scale up menambah kapasitas node tunggal (core, memory, storage lebih besar); scale out menambah node melalui read replica atau partitioning. Mengapa client dapat membaca stale data pada arsitektur read replica? :: Karena replikasi dari primary ke secondary bersifat asynchronous, sehingga ada delay sebelum update sampai ke secondary yang melayani read. Apa perbedaan horizontal partitioning dan vertical partitioning pada relational database? :: Horizontal partitioning membagi logical table menjadi beberapa partisi fisik berdasarkan baris (mis. berdasarkan region); vertical partitioning membagi table berdasarkan kolom (mis. kolom statis vs dinamis). Kenapa document model dikatakan memiliki data locality yang lebih baik dibanding relational model? :: Karena seluruh struktur/hirarki data (mis. profil pengguna beserta positions dan education) tersimpan dalam satu dokumen sehingga dapat dibaca sekaligus tanpa perlu join ke tabel lain. Kapan document model lebih cocok digunakan dibanding relational model, dan sebaliknya? :: Document model cocok untuk data yang bersifat tree/hierarkis dengan relasi one-to-many; relational model lebih cocok untuk data dengan relasi many-to-many. Apa perbedaan property graph model dan triple-store model dalam merepresentasikan graph? :: Property graph model menyimpan vertex (id, edges, properties) dan edge (id, tail, head, label, properties) sebagai entitas eksplisit; triple-store model menyimpan informasi sebagai tuple (subject, predicate, object) di mana predicate bisa memodelkan property atau edge. Apa itu BASE dan bagaimana perbedaannya dengan ACID? :: BASE (Basic Availability, Soft state, Eventual consistency) adalah properti tipikal NoSQL yang mengutamakan availability dan skalabilitas, berbeda dengan ACID (Atomicity, Consistency, Isolation, Durability) yang tipikal RDBMS dan mengutamakan konsistensi transaksi. Mengapa NoSQL cenderung menggunakan denormalized data model? :: Karena NoSQL fokus pada solution domain, yaitu mendesain model data berdasarkan pola akses data (data access pattern) yang dibutuhkan aplikasi, bukan pada normalisasi problem domain seperti RDBMS. Sebutkan tiga pendekatan data partitioning pada sistem NoSQL. :: Hash key (pemetaan berdasarkan hash function), value based (berdasarkan nilai), dan range based (berdasarkan rentang nilai). Apa perbedaan strategi replikasi leader-follower dan leaderless? :: Pada leader-follower, satu replica menjadi leader yang menangani semua update; pada leaderless, semua replica dapat menerima read & update, dan replica yang menerima update berperan sebagai coordinator yang memastikan replica lain ikut ter-update.