Materi ini membahas bagaimana database sebenarnya menyimpan data secara fisik: dimulai dari struktur data internal storage engine (log-structured vs page-oriented/B-Tree), lalu naik ke level sistem terdistribusi (bagaimana storage tersebut di-scale lewat replikasi dan partitioning/sharding). Dua slide sumber (“Storage Engine” dan “Database Storage”) saling melengkapi: slide pertama menjelaskan bagaimana satu node database menyimpan data secara efisien, slide kedua menjelaskan bagaimana database tersebut di-scale ke banyak mesin.
Storage Engine
Storage engine adalah komponen database yang bertanggung jawab menangani penyimpanan data ke persistent storage. Desainnya bergantung pada tujuan (goal) penggunaan:
- Transactional workload (relational & key-value stores) → menggunakan struktur log-structured atau page-oriented/B-Trees
- Analytics → menggunakan column-oriented stores
Log-Structured Storage: Append-Only File + Hash Index
Bentuk paling sederhana dari storage engine adalah menyimpan data pasangan key-value pada sebuah file dengan perintah append (data selalu ditambahkan di akhir file) — mirip operasi pada Log. Contoh:
123456,{"name":"London","attractions":["Big Ben","London Eye"]}
42,{"name":"San Francisco","attractions":["Golden Gate Bridge"]}
42,{"name":"San Francisco","attractions":["Exploratorium"]}
Penambahan data (write) menjadi sangat efisien karena hanya append, tapi pengambilan data (read) menjadi berat karena harus scan seluruh file — kompleksitas O(n). Untuk mempercepat read, dibuat index.
Index adalah struktur tambahan untuk mempercepat read, namun menambah overhead saat write. Bentuk paling sederhana: mengelola index sebagai hash map di memory, yang memetakan tiap key ke byte offset lokasi data pada file di disk.
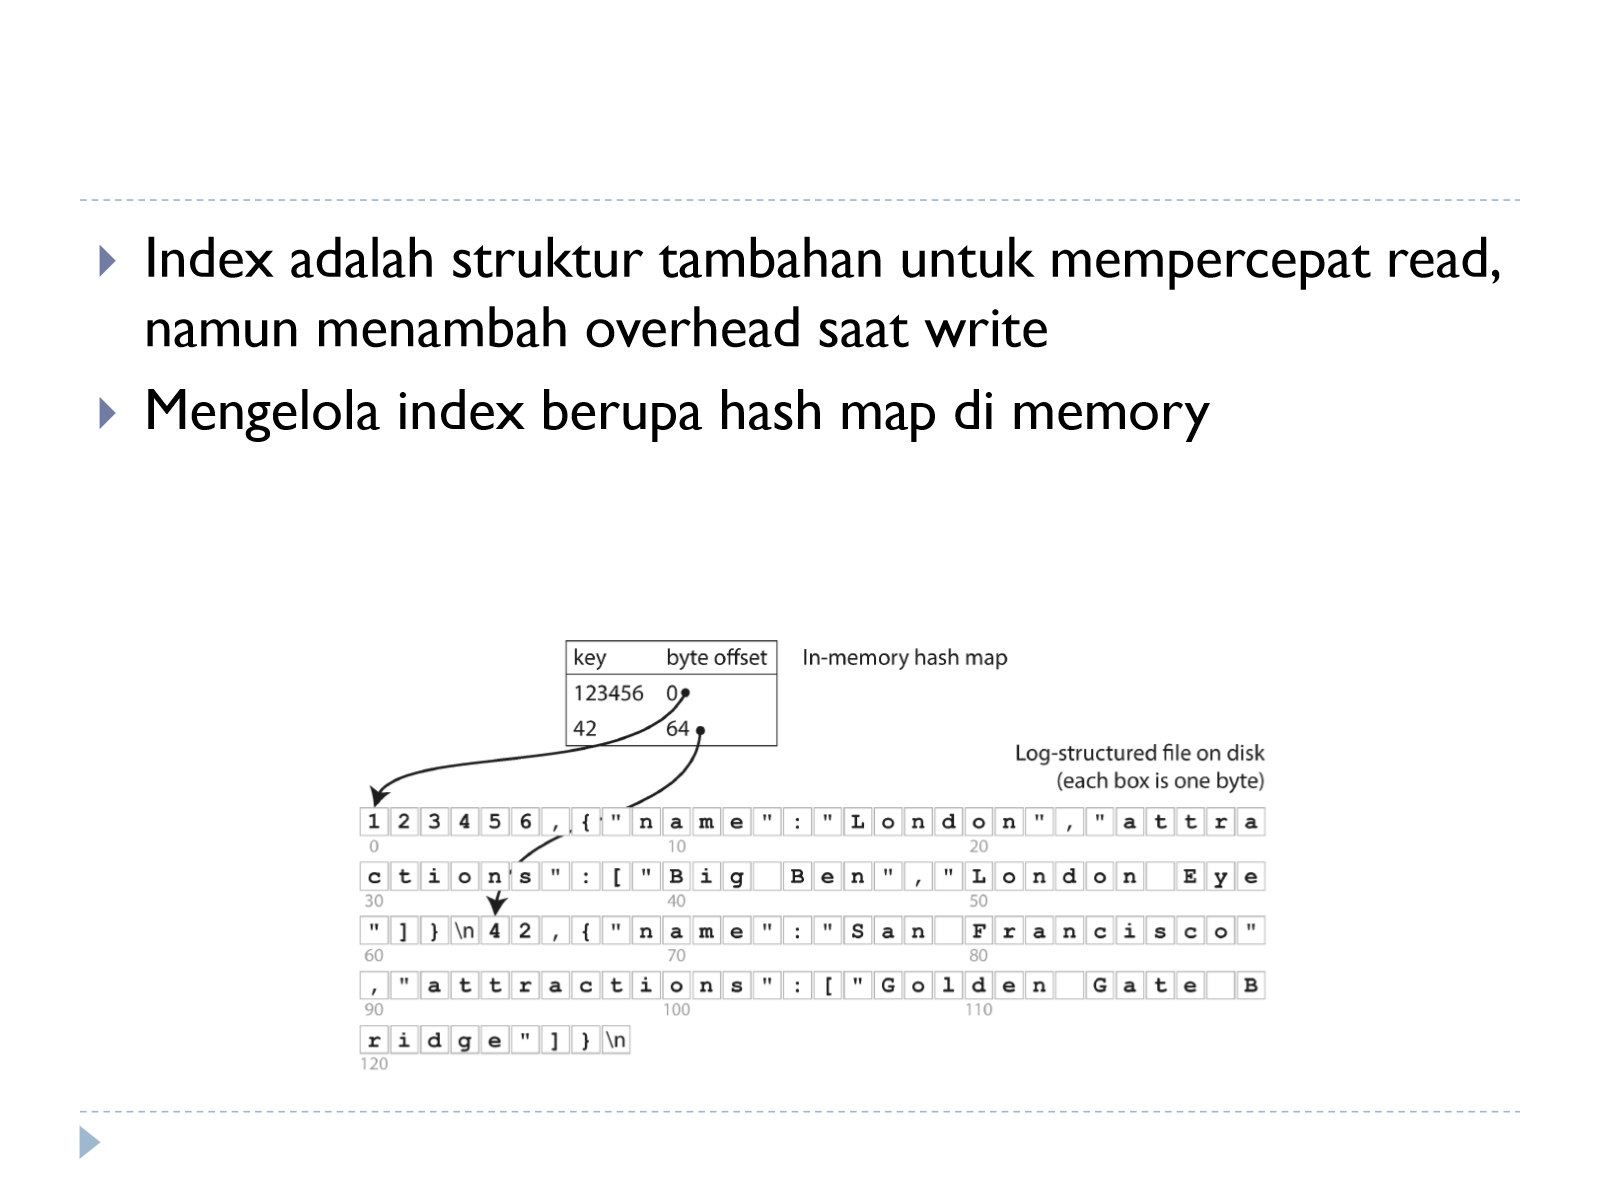
Segmentasi, Compaction, dan Merging
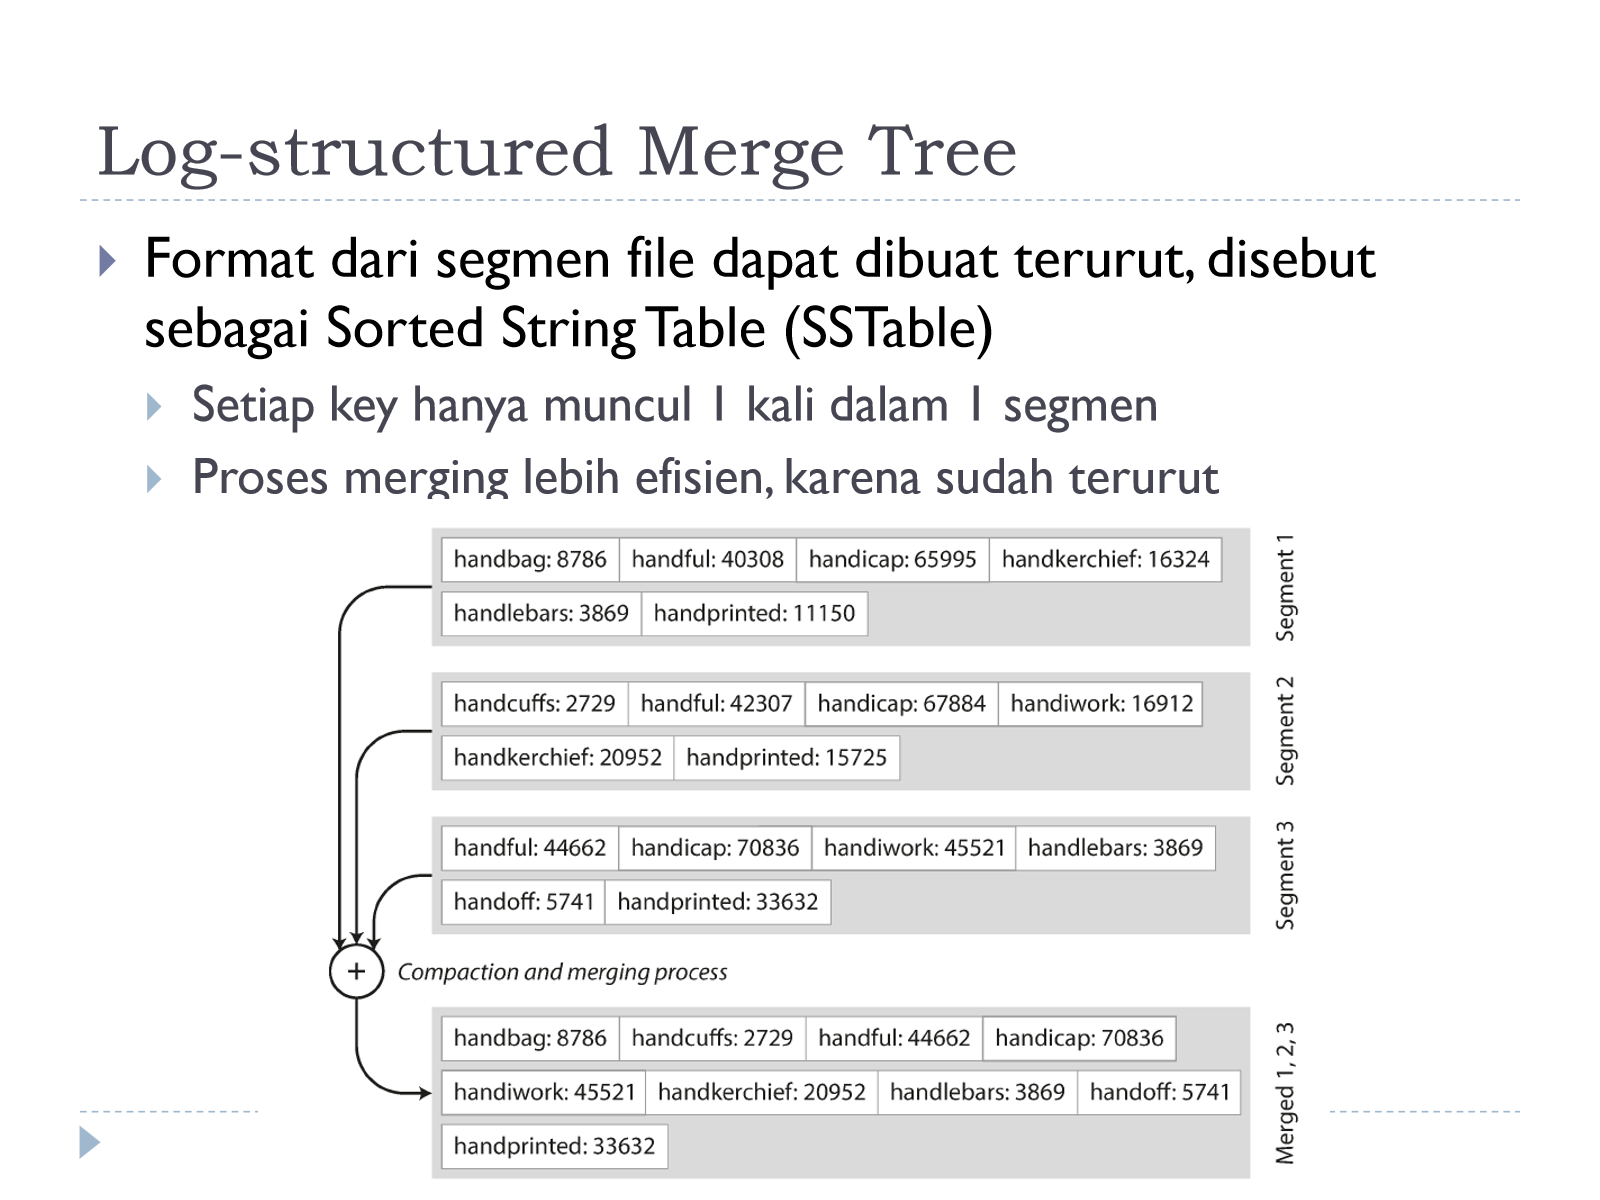
Karena file terus di-append, ketika ukuran segmen mencapai batas tertentu, data mulai dituliskan ke segmen baru. Agar file tidak bertambah besar tak terbatas, dijalankan dua proses di background:
- Compaction: membuang key/data yang tidak terpakai lagi atau duplikat, menyisakan hanya value terbaru per key dalam satu segmen.
- Merging: menggabungkan beberapa data segmen (yang sudah di-compact) menjadi satu segmen baru.
Isu pada Pendekatan Hash Index
- Deleting records: dilakukan dengan meng-append record khusus (tombstone) sebagai penanda bahwa key tersebut sudah dihapus.
- Crash recovery: saat crash, hash index di memory akan hilang karena bersifat volatile. Index dapat dibangun ulang dengan membaca seluruh file segmen dari awal, namun proses ini lambat untuk file besar — untuk mempercepat, snapshot index dapat disimpan secara periodik ke disk.
- Partially written records: untuk menangani crash saat proses penulisan sedang berlangsung (menyisakan record tidak lengkap), ditambahkan checksum pada tiap record.
- Concurrency control: umumnya menggunakan skema single writer, concurrent read — hanya ada satu proses/thread yang boleh menulis (karena berupa append berurutan), sementara pembacaan bisa dilakukan bersamaan oleh banyak reader.
Limitasi
- Index table harus muat di memory — sulit membuat on-disk index map yang efisien.
- Range query tidak efisien, karena harus lookup key satu per satu pada index file (hash tidak memiliki urutan), sehingga tidak bisa memanfaatkan locality untuk scan berurutan.
SSTable dan Log-Structured Merge Tree (LSM-Tree)
Untuk mengatasi limitasi di atas, format segmen file dapat dibuat terurut (sorted) berdasarkan key, disebut Sorted String Table (SSTable). Aturan pada SSTable: setiap key hanya muncul satu kali dalam satu segmen (sudah di-compact).
Karena data terurut, proses merging antar segmen menjadi jauh lebih efisien — mirip algoritma mergesort: cukup membaca beberapa segmen secara sekuensial sambil membandingkan key pertama pada tiap segmen, tanpa perlu menyimpan seluruh data di memory.
Karena file sudah terurut, index tidak perlu menyimpan setiap key — cukup satu key per blok segmen (sparse index), karena begitu ditemukan rentang blok yang tepat, bisa langsung dilakukan scan sekuensial dalam blok tersebut untuk menemukan key yang dicari. Manfaat lain: tiap blok segmen bisa disimpan dalam bentuk terkompresi, menghemat disk space dan I/O bandwidth.
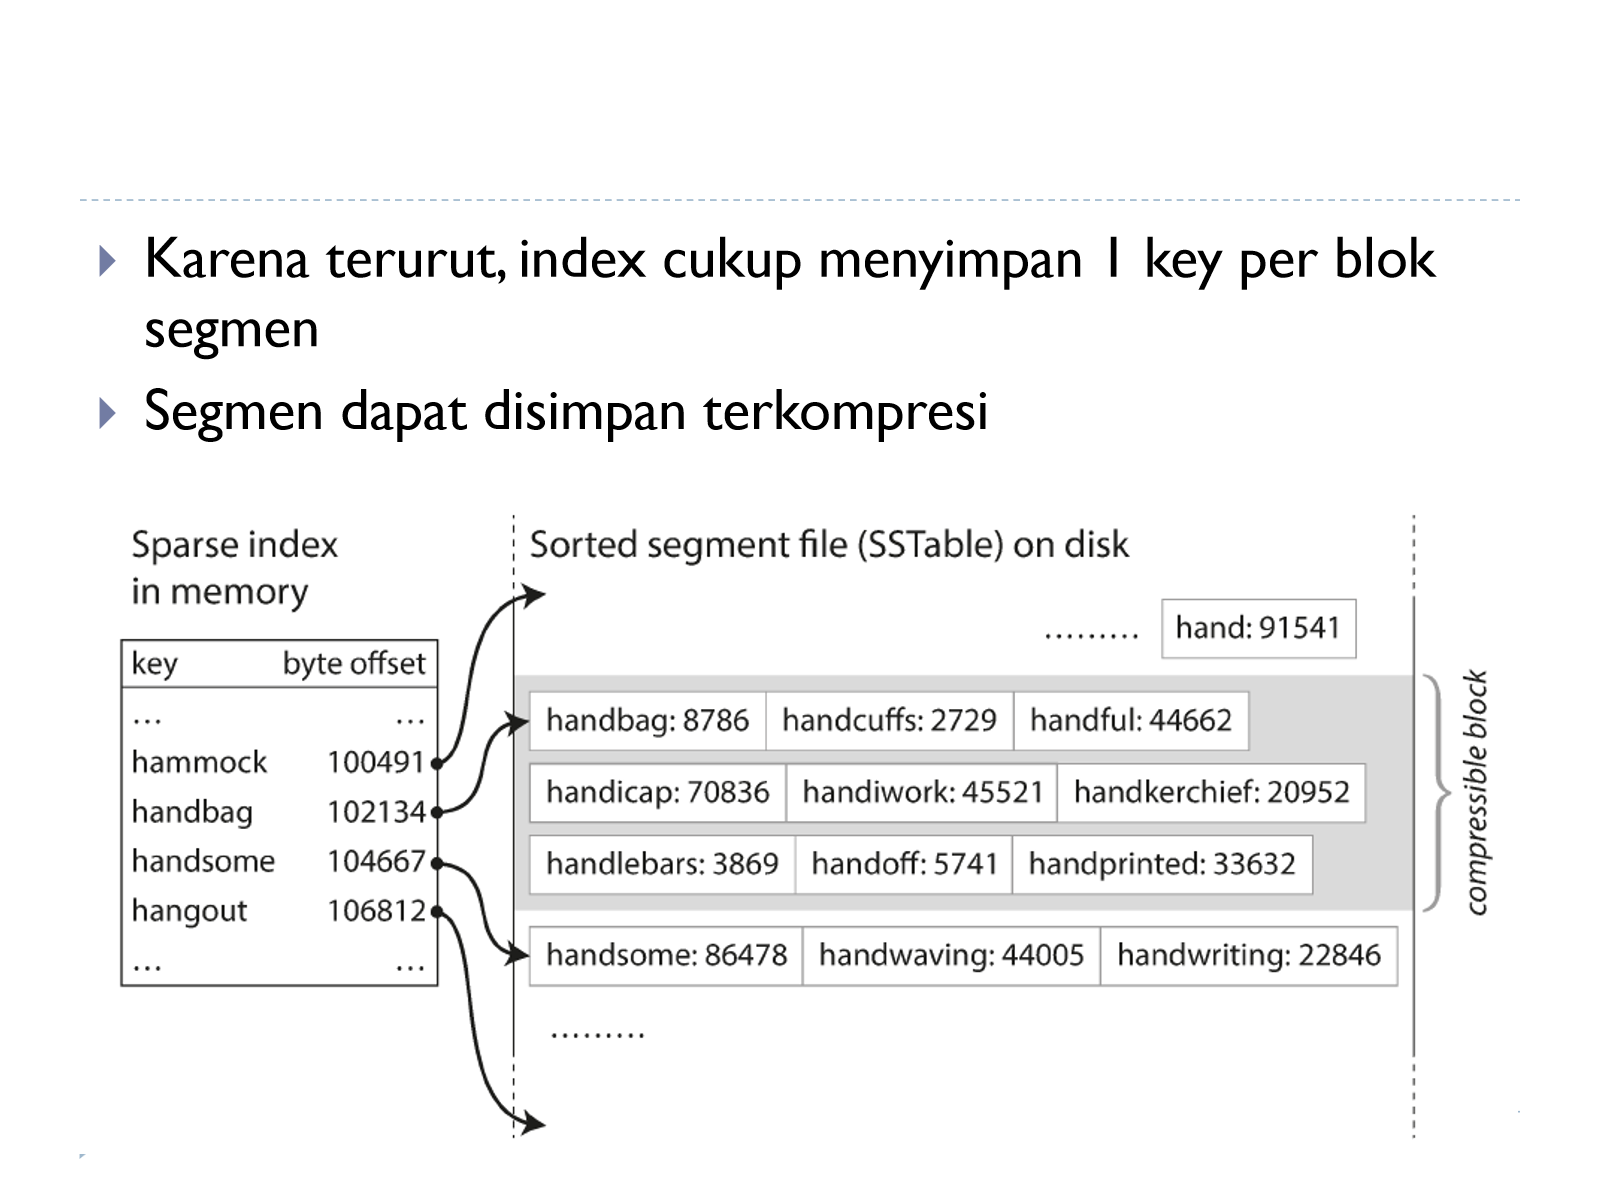
Pengelolaan SSTable — LSM-Tree
Bagaimana data yang masuk (yang awalnya tidak terurut) bisa disimpan dalam format SSTable yang terurut? Mekanismenya:
- Saat write, data dimasukkan ke representasi SSTable di memory yang selalu terurut, menggunakan tree data structure — struktur inilah yang disebut memtable.
- Saat ukuran memtable melewati threshold tertentu, data di-flush ke disk sebagai SSTable baru. Penulisan data berikutnya dilakukan pada memtable baru (yang kosong).
- Proses pembacaan (read) dilakukan dengan mengecek key pada memtable terlebih dulu, kemudian pada disk-segment yang paling baru, lalu segmen berikutnya (dari yang terbaru ke terlama), sampai key ditemukan.
- Proses merging segmen dan compaction dilakukan secara background agar tidak mengganggu proses read/write yang sedang berjalan.
- Untuk menangani crash saat data masih berada di memtable (belum di-flush, sehingga akan hilang karena memory volatile), disimpan separate log (mirip write-ahead log) pada disk yang mencatat setiap write sebelum masuk ke memtable.
Gabungan struktur memtable (in-memory sorted tree) + SSTable (on-disk sorted segments) + proses compaction/merge di background inilah yang disebut Log-Structured Merge Tree (LSM-Tree).
Optimasi SSTable
- Bloom filter: lookup terhadap key yang tidak ada menjadi tidak efisien pada pendekatan SSTable dasar, karena harus mengecek semua segmen file (dari yang terbaru sampai terlama) sebelum bisa memastikan key tersebut tidak ada. Bloom filter (struktur probabilistik untuk mengecek keanggotaan set) digunakan untuk secara cepat menyaring segmen mana saja yang pasti tidak memiliki key tersebut, sehingga segmen itu bisa dilewati saat lookup.
- Strategi compaction & merge dapat dilakukan berdasarkan:
- Size-tiered: segmen yang lebih baru & lebih kecil secara bertahap di-merge ke dalam segmen yang lebih lama & lebih besar.
- Leveled: key range dipecah menjadi beberapa SSTable yang lebih kecil, dan data yang lebih lama dipindahkan ke level lain.
Contoh implementasi nyata: level pada RocksDB — memtable (mis. 64MB) di-flush menjadi SSTable pada Level 0 (mis. 256MB, tiap SST pada level ini masih bisa overlap key range-nya karena hasil flush langsung dari memtable), kemudian data dari Level 0 di-compact ke Level 1 (mis. 2.5GB, SST pada level ini sudah non-overlapping berdasarkan key range) dan seterusnya ke Level N, dengan kapasitas tiap level berikutnya kira-kira 10x lipat level sebelumnya.
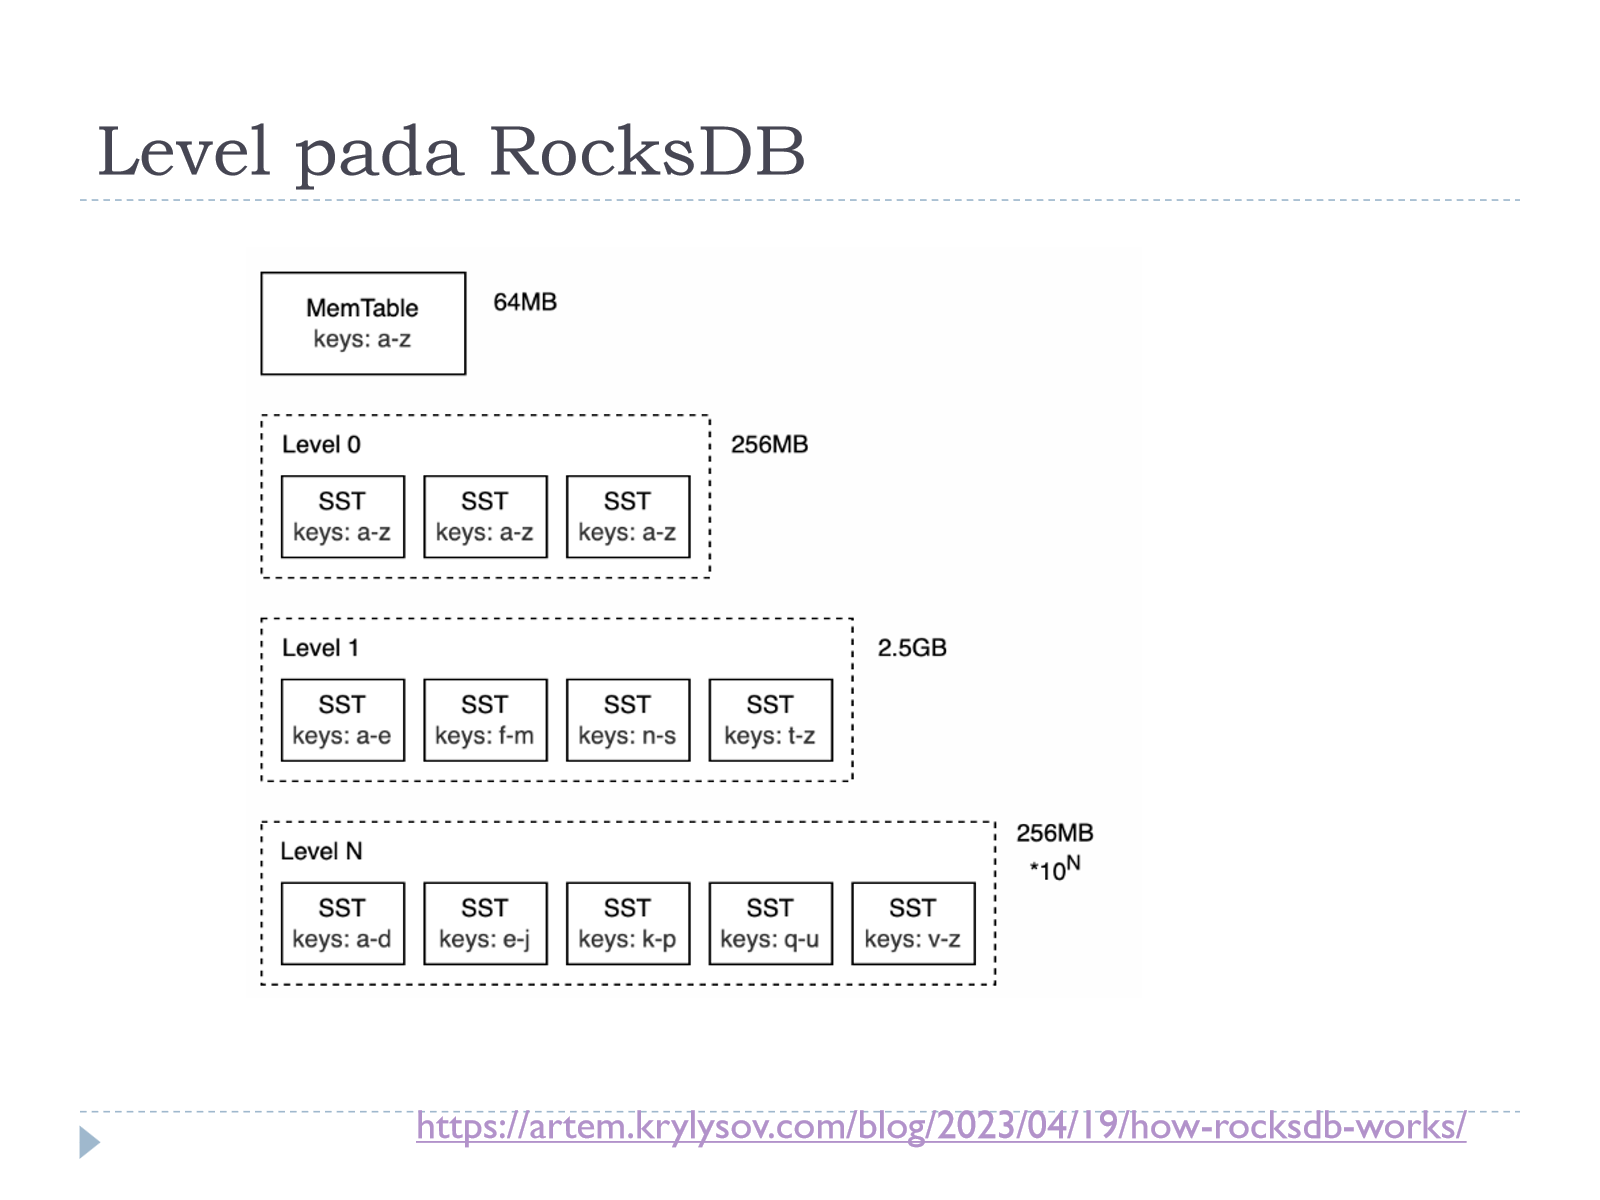
B-Trees
Struktur alternatif untuk indexing, yang jauh lebih umum dipakai pada database relasional tradisional, adalah B-Tree. Karakteristik utamanya:
- Menggunakan fixed-size block yang disebut page untuk menyimpan data.
- Setiap page memiliki address/pointer yang dapat digunakan untuk mereferensikan page lain.
- Pencarian (lookup) key selalu dimulai dari root page, lalu turun ke child page sesuai rentang key, hingga sampai ke leaf page yang berisi key beserta value-nya.
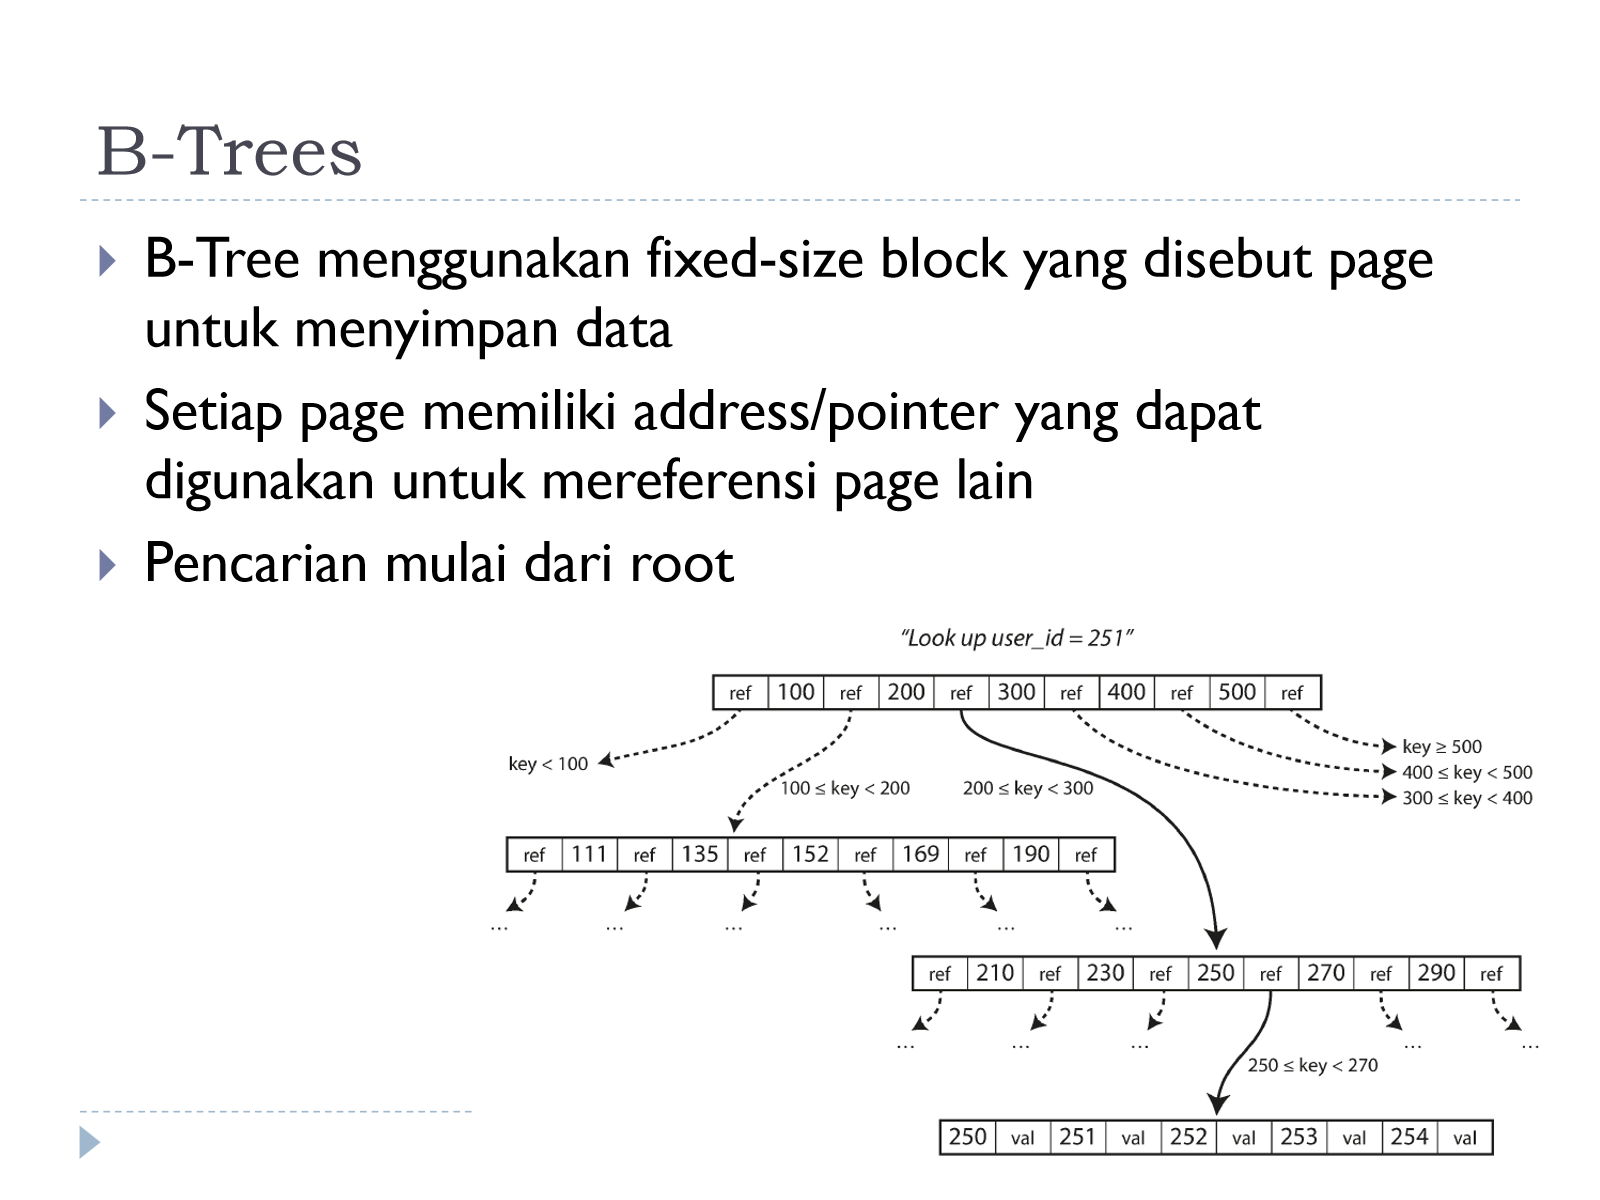
Jumlah referensi dari satu page ke child page-nya disebut branching factor — pada implementasi nyata biasanya bernilai ratusan, membuat B-Tree tetap “pendek”/shallow meski menyimpan sangat banyak data (umumnya cukup 3-4 level untuk mencakup dataset berukuran terabytes).
Operasi pada B-Tree:
- Update: cari page leaf yang berisi key yang dicari, lalu update value pada page tersebut.
- Add (insert): cari page leaf sesuai rentang key yang akan disisipkan, lalu tambahkan pada page tersebut. Jika page sudah penuh, page tersebut di-split menjadi 2 half-size page, dan parent page diperbarui untuk merefleksikan pembagian rentang key yang baru.
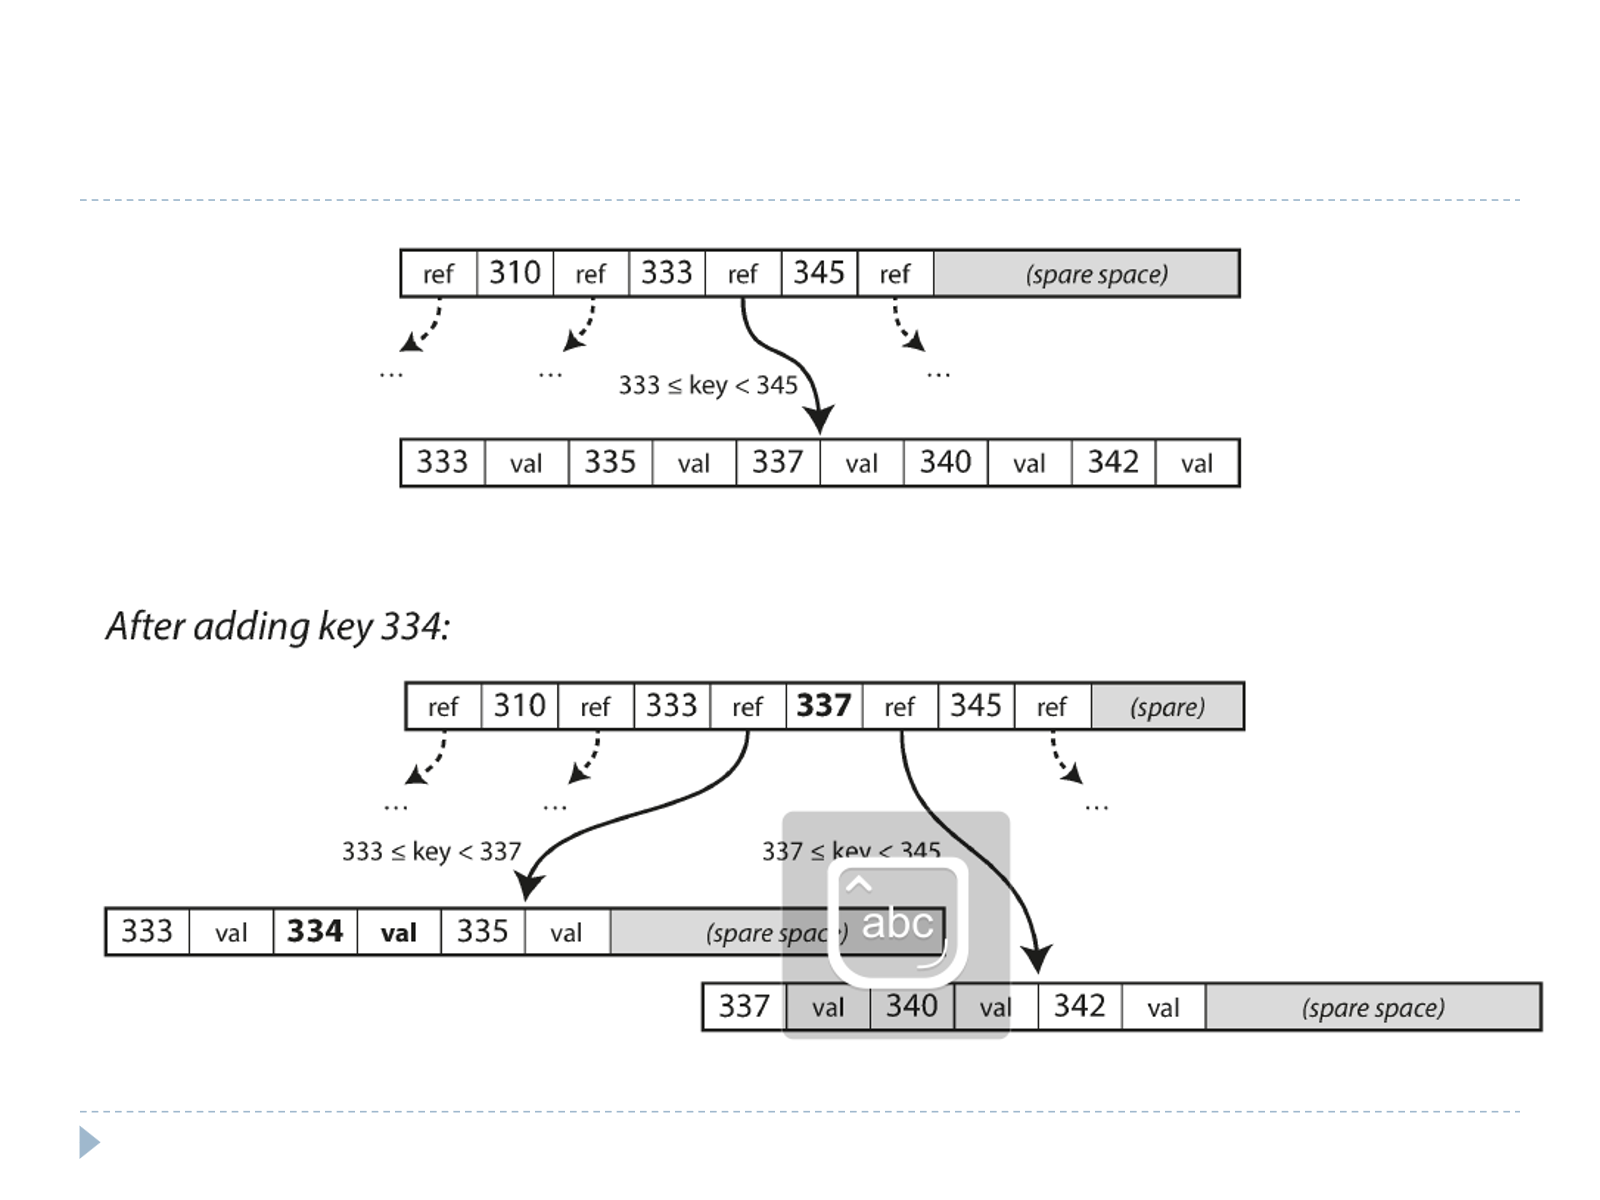
Pada contoh di atas, penambahan key 334 pada page yang sudah penuh (rentang 333-345) menyebabkan page tersebut split menjadi dua page baru (333-337 dan 337-345), sementara parent page mendapat entry baru (337) yang mengarah ke kedua half-page tersebut.
Concurrency & crash recovery pada B-Tree:
- Proses penulisan dapat melibatkan satu atau lebih penulisan/update page (misalnya saat split terjadi minimal 3 page berubah: 2 half-page baru + parent).
- Update pada satu page dilakukan in-place pada lokasi yang sama di disk. Penanganan konkurensi dilakukan dengan lock/latches.
- Karena update dapat melibatkan beberapa page sekaligus, crash di tengah proses dapat membuat page menjadi inconsistent. Untuk mengatasi ini digunakan Write-Ahead Log (WAL): setiap perubahan dicatat ke WAL terlebih dahulu sebelum diterapkan ke page; saat crash, WAL digunakan untuk me-restore B-Tree ke kondisi konsisten.
Optimasi B-Tree:
- Menggunakan skema copy-on-write (bukan update page in-place), sehingga selalu ada versi lama dari page.
- Menyimpan page dengan rentang key yang berdekatan secara berdekatan pula di disk, untuk mempercepat proses range/scan query.
- Menambahkan pointer ke page sibling, sehingga scan berurutan antar leaf tidak perlu naik-turun lewat parent.
Perbandingan LSM-Tree vs B-Tree
| Aspek | LSM-Tree | B-Tree |
|---|---|---|
| Kecepatan write | Lebih cepat (append-only, sequential write) | Lebih lambat |
| Kecepatan read | Lebih cepat untuk B-Tree dibanding LSM-Tree | Lebih cepat |
| Pola penulisan | Berulang kali akibat compaction & merge → write amplification | 2 kali (WAL log & page), plus penulisan keseluruhan page tiap update |
| Kompresi | Lebih baik, karena hanya append dan compaction dilakukan periodic | Menyisakan spare space untuk key yang belum terisi pada page, sehingga kurang padat |
| Gangguan kinerja | Proses compaction dapat mengganggu kinerja penulisan/pembacaan data saat berjalan | Update in-place relatif stabil, tapi dibatasi lock/latches saat konkurensi tinggi |
| Struktur data | Memtable (tree in-memory) + SSTable (sorted segments di disk) | Fixed-size page + pointer antar page |
Kesimpulan singkat dari slide: LSM-Tree lebih cepat untuk write, B-Tree lebih cepat untuk read.
OLTP vs OLAP dan Column-Oriented Storage
Struktur di atas (hash index, LSM-Tree, B-Tree) didesain untuk Transaction Processing (OLTP) — mengambil/mengubah sejumlah kecil record berdasarkan key. Kebutuhan berbeda muncul pada analytics (OLAP), yang perlu meng-agregasi sejumlah besar record sekaligus.
| Property | Transaction processing systems (OLTP) | Analytic systems (OLAP) |
|---|---|---|
| Main read pattern | Sejumlah kecil record per query, fetched by key | Aggregate over large number of records |
| Main write pattern | Random-access, low-latency writes from user input | Bulk import (ETL) atau event stream |
| Primarily used by | End user/customer, via web application | Internal analyst, for decision support |
| What data represents | Latest state of data (current point in time) | History of events that happened over time |
| Dataset size | Gigabytes - terabytes | Terabytes - petabytes |
Karena operasi analytics (scan sejumlah besar row) dapat mengganggu kinerja OLTP, umumnya dibuat Data Warehouse: database terpisah dari OLTP yang berisi read-only copy dari data yang berasal dari berbagai sistem OLTP, melalui proses extract → transform → load (ETL).
Data warehouse umumnya menggunakan star schema, terdiri atas:
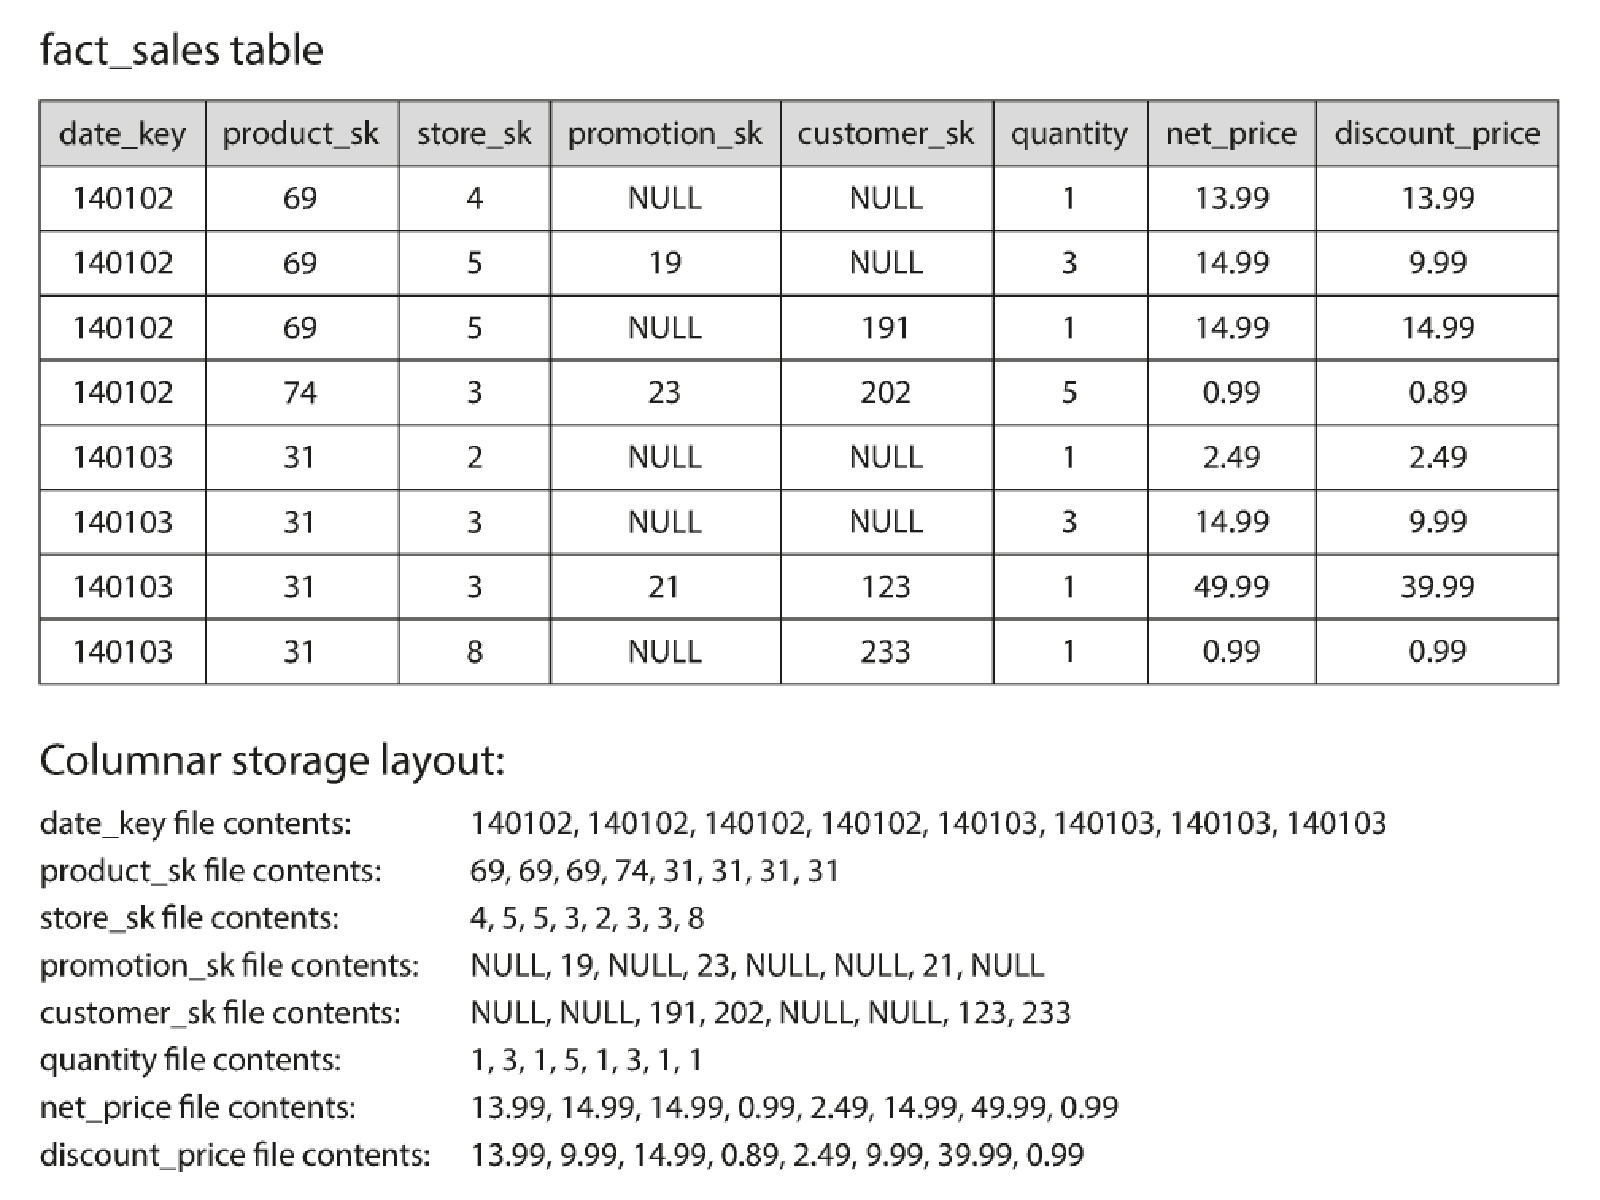
- Fact table: berisi baris-baris event/transaksi (mis.
fact_sales), tiap kolomnya adalah foreign key ke dimension table atau nilai numerik yang diukur (mis.quantity,net_price,discount_price). - Dimensional table: berisi atribut deskriptif terkait fact (mis.
dim_product,dim_store,dim_customer,dim_promotion). - Date & time sering direpresentasikan sebagai dimension tersendiri (
dim_date), agar mudah difilter/agregasi berdasarkan atribut kalender (hari libur, hari kerja, dsb).
Column-oriented storage: karena fact table dapat berisi baris sangat banyak sementara tipikal query hanya melihat beberapa kolom saja, storage untuk OLAP menyimpan data per kolom, bukan per baris — semua nilai dari kolom yang sama disimpan berdekatan (mis. dalam file terpisah per kolom). Dengan begini, query yang hanya membutuhkan beberapa kolom cukup membaca file-file kolom tersebut, tanpa perlu memuat kolom lain yang tidak relevan.
Scaling Storage pada Sistem Terdistribusi
Fondasi: Hierarki Memory/Storage dan RAID
Sebelum membahas scaling ke banyak mesin, perlu dipahami dulu keterbatasan storage pada satu mesin. Terdapat hierarki memory/storage: semakin tinggi hierarki (mendekati CPU), semakin cepat namun semakin kecil kapasitasnya.
| Media | Delay | Kapasitas |
|---|---|---|
| CPU Registers | 0.3ns | 1 kB |
| CPU Caches (L2) | 5ns | 16 MB |
| Random Access Memory (RAM) | 50ns | 16 GB |
| Flash Storage (SSD) | 100μs | 1 TB |
| Magnetic Disk | 5ms | 8 TB |
Disk berkapasitas ~10 milyar kali lebih besar dibanding register, namun latency-nya ~10 juta kali lebih lambat. RAM merupakan volatile memory (hilang saat power mati), sedangkan SSD dan magnetic disk adalah persistent storage. Strategi umum: gunakan sebanyak mungkin hierarki teratas (RAM) untuk data set aktif (data yang sering diakses), dan simpan data besar yang jarang diakses pada hierarki bawah (disk). Selain delay, tiap media juga memiliki keterbatasan bandwidth: pembacaan pada disk hanya bisa dilakukan pada sebagian kecil data setiap saatnya (sesuai posisi head disk), sedangkan memory & SSD dibatasi oleh jumlah pin konektor.
RAID (Redundant Array of Independent Disks) mengatasi keterbatasan satu disk (kapasitas ~12TB, throughput ~150MB/s, serta risiko kegagalan khususnya pada magnetic disk) dengan menggunakan multiple disk sekaligus:
- Kapasitas ditingkatkan dengan menggabungkan kapasitas beberapa disk.
- Throughput ditingkatkan dengan mengakses data secara paralel pada multiple disk.
- Dampak kegagalan dikurangi dengan menyimpan data secara redundan pada multiple disk.
Database sebagai Bottleneck
Database akan beroperasi jauh lebih cepat jika mengakses data yang sudah berada pada cache di RAM (RAM dapat berukuran hingga 1TB), dengan goal mengatur agar data set aktif dapat muat dalam RAM. Meski demikian, database sering menjadi bottleneck performance pada sistem berskala besar — load balancer dan application server dapat dengan mudah di-clone/scale horizontal, tetapi semua clone app tersebut tetap harus mengakses satu shared database yang sama, karena database digunakan untuk shared state dan koordinasi.
Beberapa strategi optimasi database sebelum melakukan scaling arsitektural:
- Menggunakan index
- Optimasi query (mis. mengatur urutan akses tabel)
- Menggunakan RAM untuk menyimpan data penting dan index
- Meng-cache response
- Menghindari query yang tidak perlu (mis. cache pada frontend)
- Menggunakan RAM besar & CPU cepat
- Menggunakan disk cepat (SSD)
- Menggunakan replika dan sharding → horizontal scaling
Database cloning/replication perlu dilakukan dengan hati-hati untuk memastikan state tetap konsisten antar salinan.
Read Replica (Replikasi Leader-Follower)
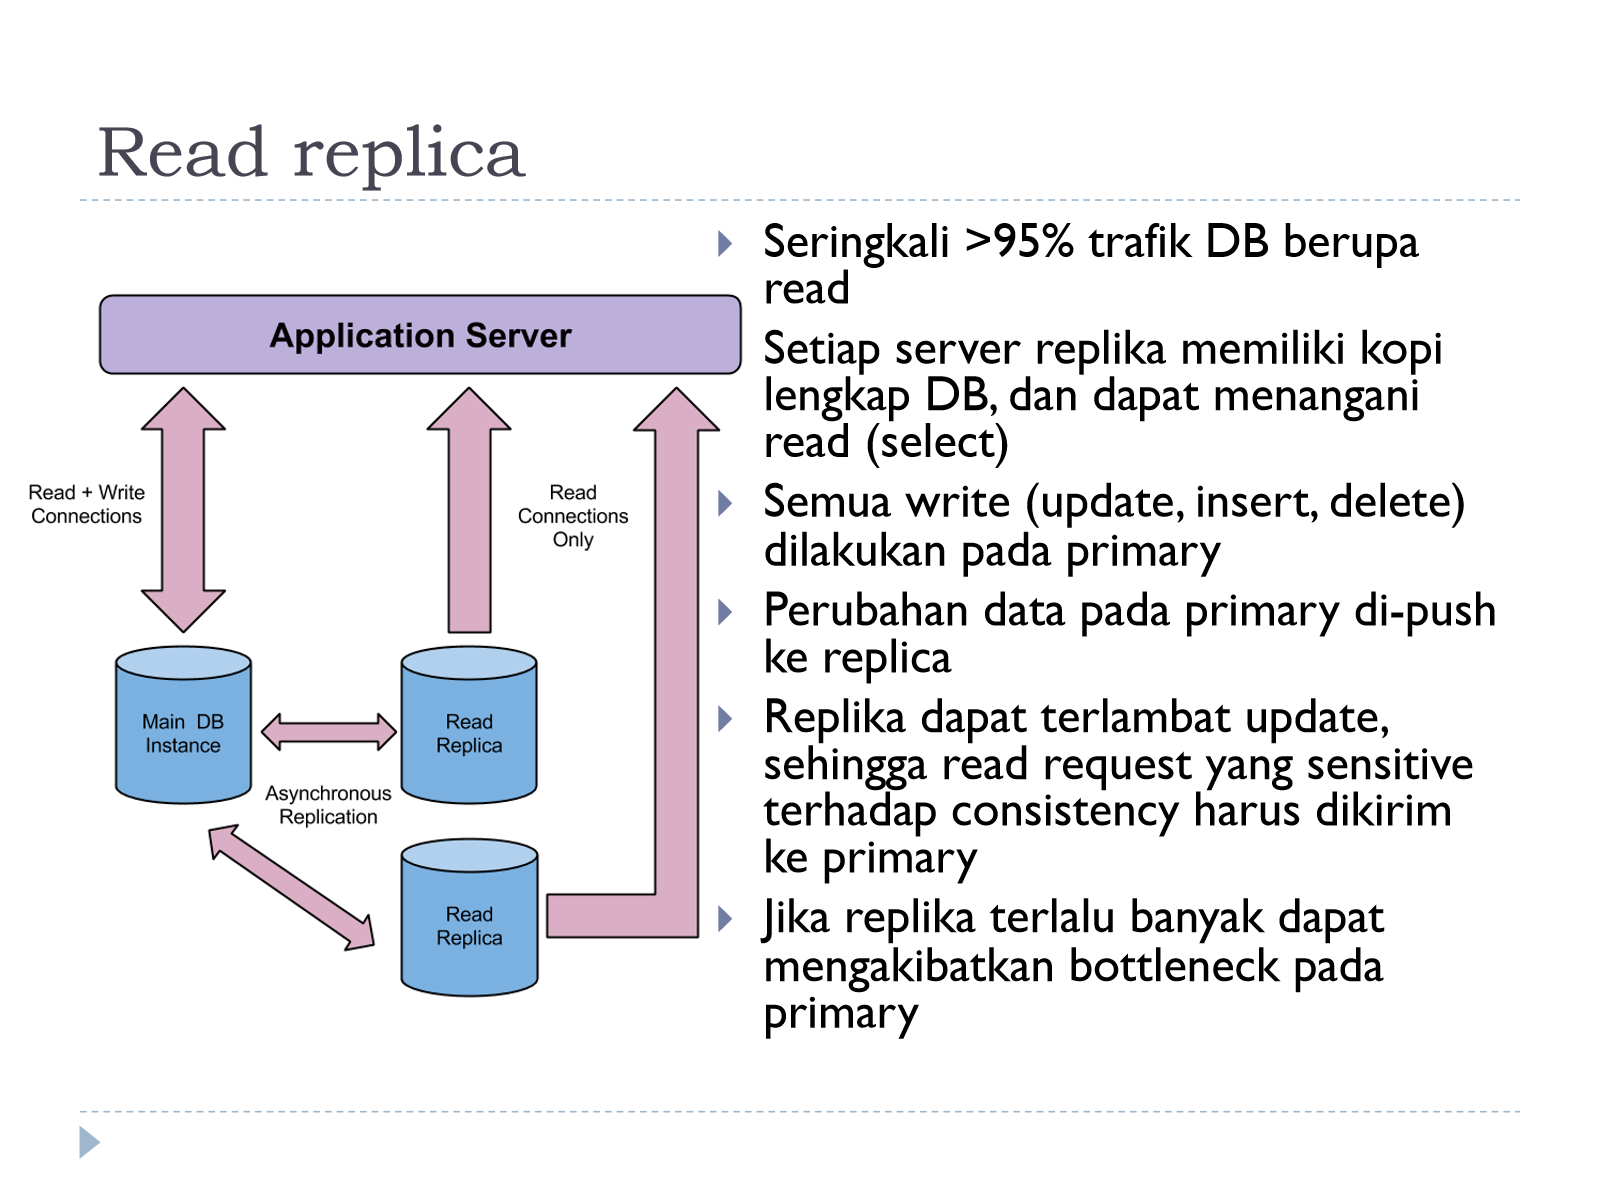
Karena umumnya >95% trafik database berupa read, strategi paling umum untuk scaling adalah menambahkan read replica:
- Setiap server replika memiliki kopi lengkap database, dan dapat menangani operasi read (SELECT).
- Semua write (INSERT, UPDATE, DELETE) hanya dilakukan pada primary (leader).
- Perubahan data pada primary di-push ke seluruh replica secara asynchronous replication.
- Karena replikasi bersifat asynchronous, replika dapat terlambat update — sehingga read request yang sensitif terhadap consistency (butuh data paling baru) harus tetap dikirim ke primary.
- Jika jumlah replika terlalu banyak, proses push perubahan dari primary ke semua replika dapat menjadi bottleneck pada primary itu sendiri.
Batasan jumlah read replica: primary tetap menjadi central bottleneck dan single point of failure. Jika terdapat N replika, primary harus mengirimkan N salinan data untuk setiap write. Jika perbandingan jumlah read terhadap write adalah R, dan ingin mengimbangkan beban antara primary dan replica, maka perkiraan jumlah replika yang dibutuhkan adalah sekitar R.
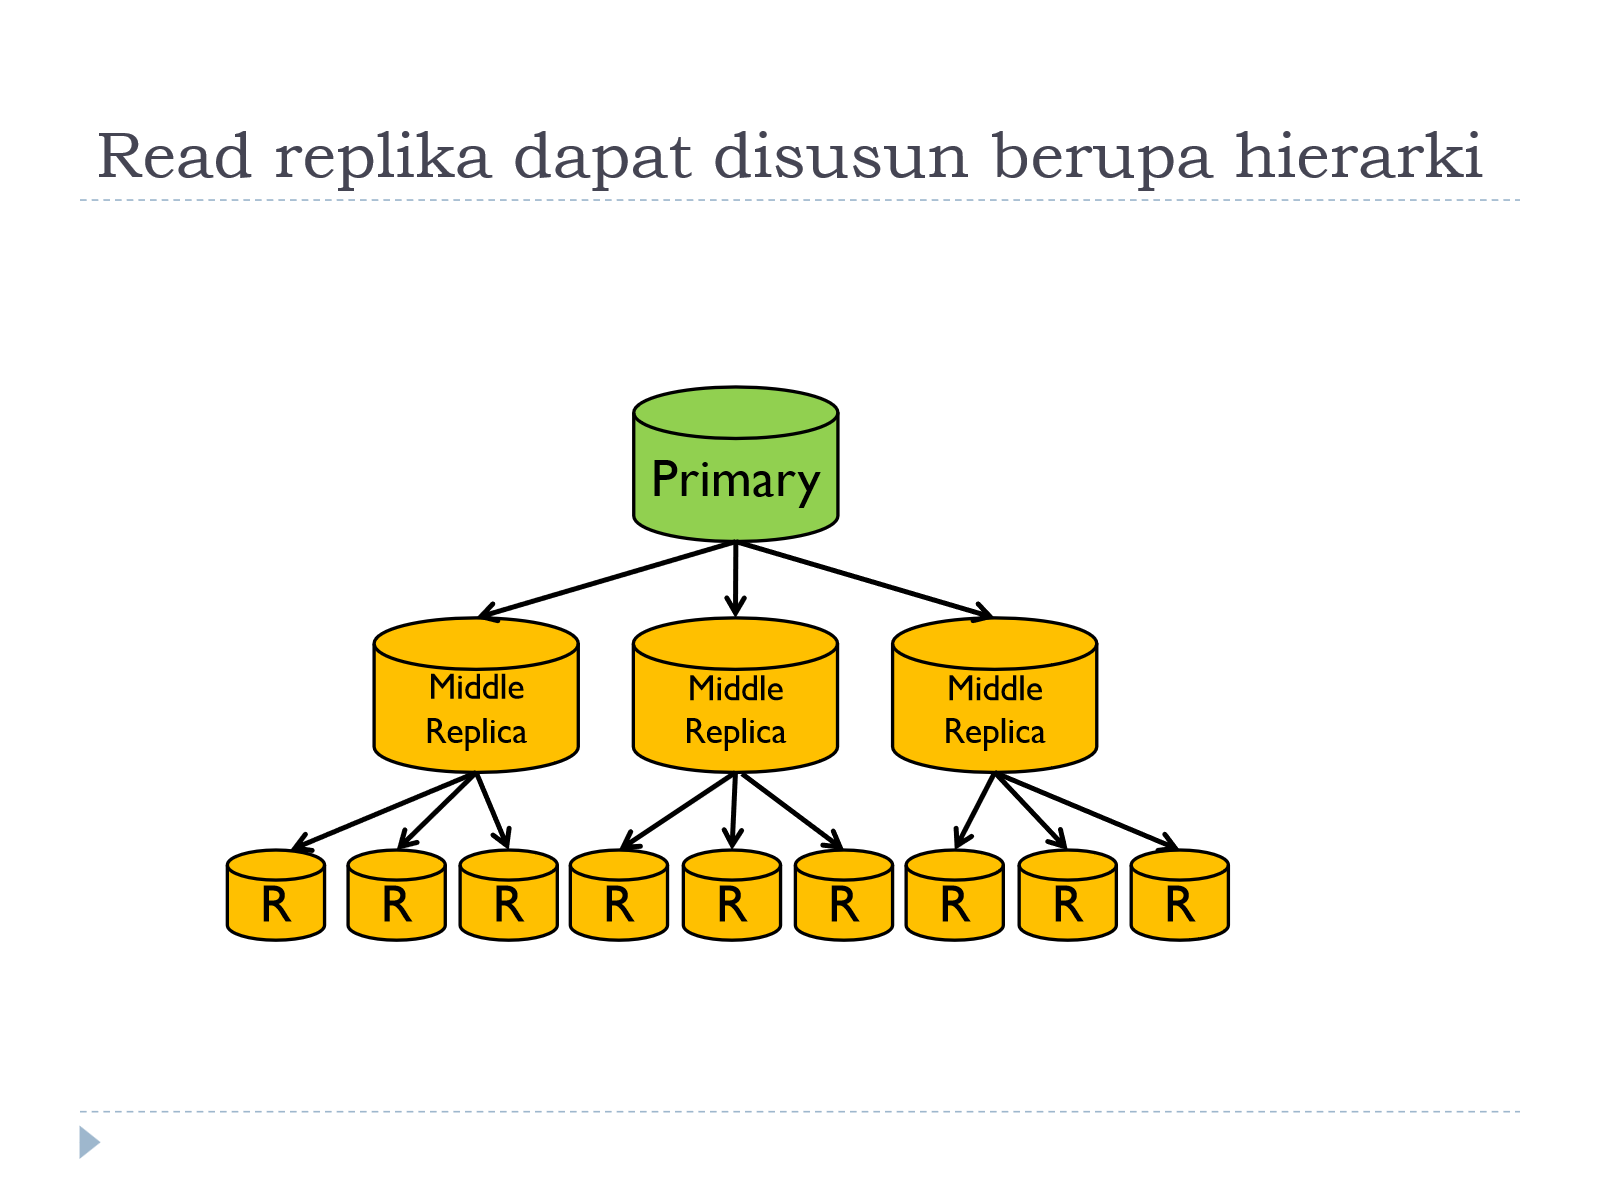
Untuk mengurangi beban push dari satu primary, read replica dapat disusun sebagai hierarki (primary → beberapa middle replica → replica daun), sehingga beban distribusi perubahan data tidak seluruhnya ditanggung primary.
Penggunaan read replica dalam arsitektur aplikasi: ditempatkan load balancer di depan kumpulan read replica (dapat diimplementasikan sebagai NAT load balancer atau lewat library aplikasi) — aplikasi mengirim SQL write (INSERT/UPDATE/DELETE) langsung ke primary, dan SQL read (SELECT) ke load balancer yang akan mendistribusikannya ke salah satu replica.
Kelemahan read replica:
- Write tidak scalable — hanya ditangani oleh satu mesin (primary).
- Capacity tidak scalable — seluruh database harus muat dalam satu mesin, karena tiap replika menyimpan full replication (kopi lengkap).
- Primary tetap single point of failure.
Untuk mengatasi masalah ketersediaan (bukan skalabilitas) dari single primary, dapat digunakan primary-primary failover: mensetup stand-by primary yang siap melakukan takeover jika primary utama mengalami kegagalan — aplikasi akan switch ke standby saat primary gagal.
Partitioning (Scaling Write & Capacity)
Read replica tidak menyelesaikan masalah scaling write dan capacity, karena tetap membutuhkan seluruh data muat dan diproses pada satu mesin primary. Solusinya adalah partitioning, membagi data ke beberapa mesin.
Functional Partitioning
Membuat multiple database untuk menyimpan kategori data yang berbeda. Contoh: memisahkan data akademik/nilai, data mahasiswa, dan data dosen pada DB yang terpisah.
- Kelemahan: membatasi kemampuan query yang melibatkan multiple DB sekaligus (join lintas kategori menjadi sulit); pembagian hanya bisa dilakukan pada beberapa partisi secara fungsional (terbatas jumlah kategori yang masuk akal), sehingga tidak scalable untuk pertumbuhan data yang terus membesar dalam satu kategori.
Data Partitioning (Sharding)
Membagi data berdasarkan row menjadi subset yang saling lepas (disjoint), disebut shards. Contoh: data penduduk Indonesia dibagi berdasarkan provinsi, atau data nilai dibagi berdasarkan fakultas. Sharding key menentukan bagaimana tiap row/record di-assign ke shard tertentu. Umumnya DBMS tidak mendukung sharding secara native — perlu diimplementasikan pada level aplikasi.
| Aspek | Pros | Cons |
|---|---|---|
| Capacity | Scale secara capacity (data tersebar di banyak mesin) | — |
| Konsistensi | Data tetap konsisten | — |
| Distribusi beban | Jika shard key dipilih tepat, data dapat terbagi seimbang; banyak query hanya melibatkan satu/beberapa shard saja, sehingga tidak ada central bottleneck | Jika shard key tidak tepat, data tidak terbagi imbang |
| Query | — | Tidak dapat menggunakan plain SQL; query harus diadaptasi agar sesuai skema sharding; ada query yang melibatkan semua shard, dan performanya dibatasi oleh mesin yang paling lambat |
Catatan: pemilihan sharding key erat kaitannya dengan strategi partitioning yang lebih umum pada sistem terdistribusi (partitioning by key range vs by hash), dan berkaitan pula dengan trade-off konsistensi & availability yang akan dibahas lebih detail pada catatan CAP theorem tersendiri.
Flashcard
flashcards Kapan sebaiknya memilih LSM-Tree dibanding B-Tree untuk storage engine? :: Saat workload didominasi write (write-heavy) dan butuh throughput tulis tinggi serta kompresi lebih baik, karena LSM-Tree hanya melakukan sequential append dan compaction periodik; trade-off-nya read menjadi lebih lambat dan ada write amplification akibat compaction & merge. Mengapa hash index sederhana (in-memory hash map ke byte offset) tidak cocok untuk range query? :: Karena hash index tidak menyimpan key secara terurut, sehingga untuk range query harus melakukan lookup satu per satu ke tiap key pada index file, tidak bisa memanfaatkan scan sekuensial berdasarkan urutan key. Apa fungsi Write-Ahead Log (WAL) pada B-Tree? :: Mencatat setiap perubahan data sebelum diterapkan ke page, sehingga jika terjadi crash di tengah proses update yang melibatkan beberapa page (misalnya saat split), B-Tree dapat di-restore ke kondisi konsisten menggunakan WAL tersebut. Apa perbedaan strategi compaction size-tiered dan leveled pada LSM-Tree? :: Size-tiered menggabungkan (merge) segmen yang lebih baru & kecil secara bertahap ke segmen yang lebih lama & besar; leveled memecah key range menjadi beberapa SSTable yang lebih kecil per level, dan memindahkan data lama ke level berikutnya (mis. skema level pada RocksDB). Apa fungsi bloom filter pada LSM-Tree? :: Mempercepat pengecekan apakah suatu key TIDAK ada pada suatu segmen SSTable, sehingga lookup key yang tidak ada tidak perlu mengecek seluruh segmen file satu per satu. Mengapa replikasi read replica saja tidak menyelesaikan masalah scaling write dan capacity? :: Karena semua write tetap harus melalui satu primary (ditangani satu mesin, tidak scalable), dan tiap replika menyimpan salinan lengkap (full replication) sehingga seluruh dataset tetap harus muat dalam kapasitas satu mesin. Bagaimana cara memperkirakan jumlah read replica yang dibutuhkan agar beban primary dan replica seimbang? :: Jika perbandingan jumlah read terhadap write adalah R, maka jumlah replika yang dibutuhkan sekitar R, karena primary harus mem-push tiap write ke semua replika sehingga biaya push meningkat seiring jumlah replika. Apa perbedaan functional partitioning dan data partitioning (sharding)? :: Functional partitioning memisahkan database berdasarkan kategori/fungsi data (misal data mahasiswa vs data dosen) sehingga membatasi query lintas kategori dan tidak scalable jangka panjang; data partitioning (sharding) membagi data berdasarkan row ke beberapa shard yang disjoint menggunakan sharding key, lebih scalable tapi query harus diadaptasi dan tidak bisa memakai plain SQL. Mengapa pemilihan sharding key yang tepat sangat penting pada sharding? :: Karena jika sharding key tidak tepat, distribusi data antar shard menjadi tidak seimbang, sehingga sebagian mesin menjadi bottleneck sementara mesin lain kurang termanfaatkan.