Materi ini membahas bagaimana database di-scale secara terdistribusi (dari relational DBMS ke NoSQL), lalu masuk ke persoalan inti yang muncul akibat replikasi data di banyak node: consistency (konsistensi) dan availability. Topik ini sangat relevan dengan capaian memahami reliabilitas, konsistensi, dan skalabilitas sistem terdistribusi, karena menjelaskan mengapa sistem terdistribusi tidak bisa menjamin data selalu konsisten dan selalu tersedia secara bersamaan, serta bagaimana trade-off ini ditangani secara praktis lewat client-centric consistency model.
Strategi Scaling Relational DBMS
Ada tiga strategi umum untuk men-scale relational DBMS:
- Read replica — menduplikasi data ke node lain khusus untuk melayani query baca (read), mengurangi beban pada node utama.
- Functional partitioning — membagi tabel-tabel yang berbeda ke db node yang berbeda (misalnya tabel
usersdi satu node, tabelordersdi node lain). - Horizontal partitioning/sharding — membagi row dari satu tabel ke beberapa db node berbeda (setiap node/shard menyimpan sebagian row).
Keterbatasan Horizontal Partitioning pada Relational DB
Horizontal partitioning (sharding) cocok digunakan jika query hanya melibatkan satu shard. Namun, query yang melibatkan semua node menjadi tidak scalable, karena harus menunggu/menggabungkan hasil dari banyak node sekaligus.
Masalahnya, pada model relational, data disimpan dalam bentuk normalized data (tidak ada duplikasi, memakai foreign key untuk merujuk ke data lain melalui tabel-tabel terpisah). Karena itu, banyak query — terutama yang melibatkan JOIN antar tabel — pada akhirnya akan melibatkan banyak node sekaligus, sehingga scalability sharding pada relational DB jadi terbatas.
Solusi yang diambil database NoSQL adalah melakukan denormalisasi data: data yang biasanya tersebar di banyak tabel malah diduplikasi dan digabung menjadi satu, sehingga sebuah query cukup diselesaikan dalam satu node saja tanpa perlu JOIN lintas node.
Sharding sebagai Masalah Graph Partitioning
Untuk memahami kenapa normalized data sulit di-shard secara scalable, slide memodelkan relasi antar row sebagai graph:
- Node pada graph merepresentasikan row data.
- Edge pada graph merepresentasikan reference/foreign key antar row.
- Task-nya: assign setiap node/row ke sebuah partisi (shard), sedemikian sehingga:
- Total edge yang memotong antar partisi minimal — ini penting karena setiap edge yang memotong partisi berarti dibutuhkan fetch data dari partisi/node lain saat melakukan JOIN.
- Jumlah node per partisi tetap seimbang (load balance antar shard).
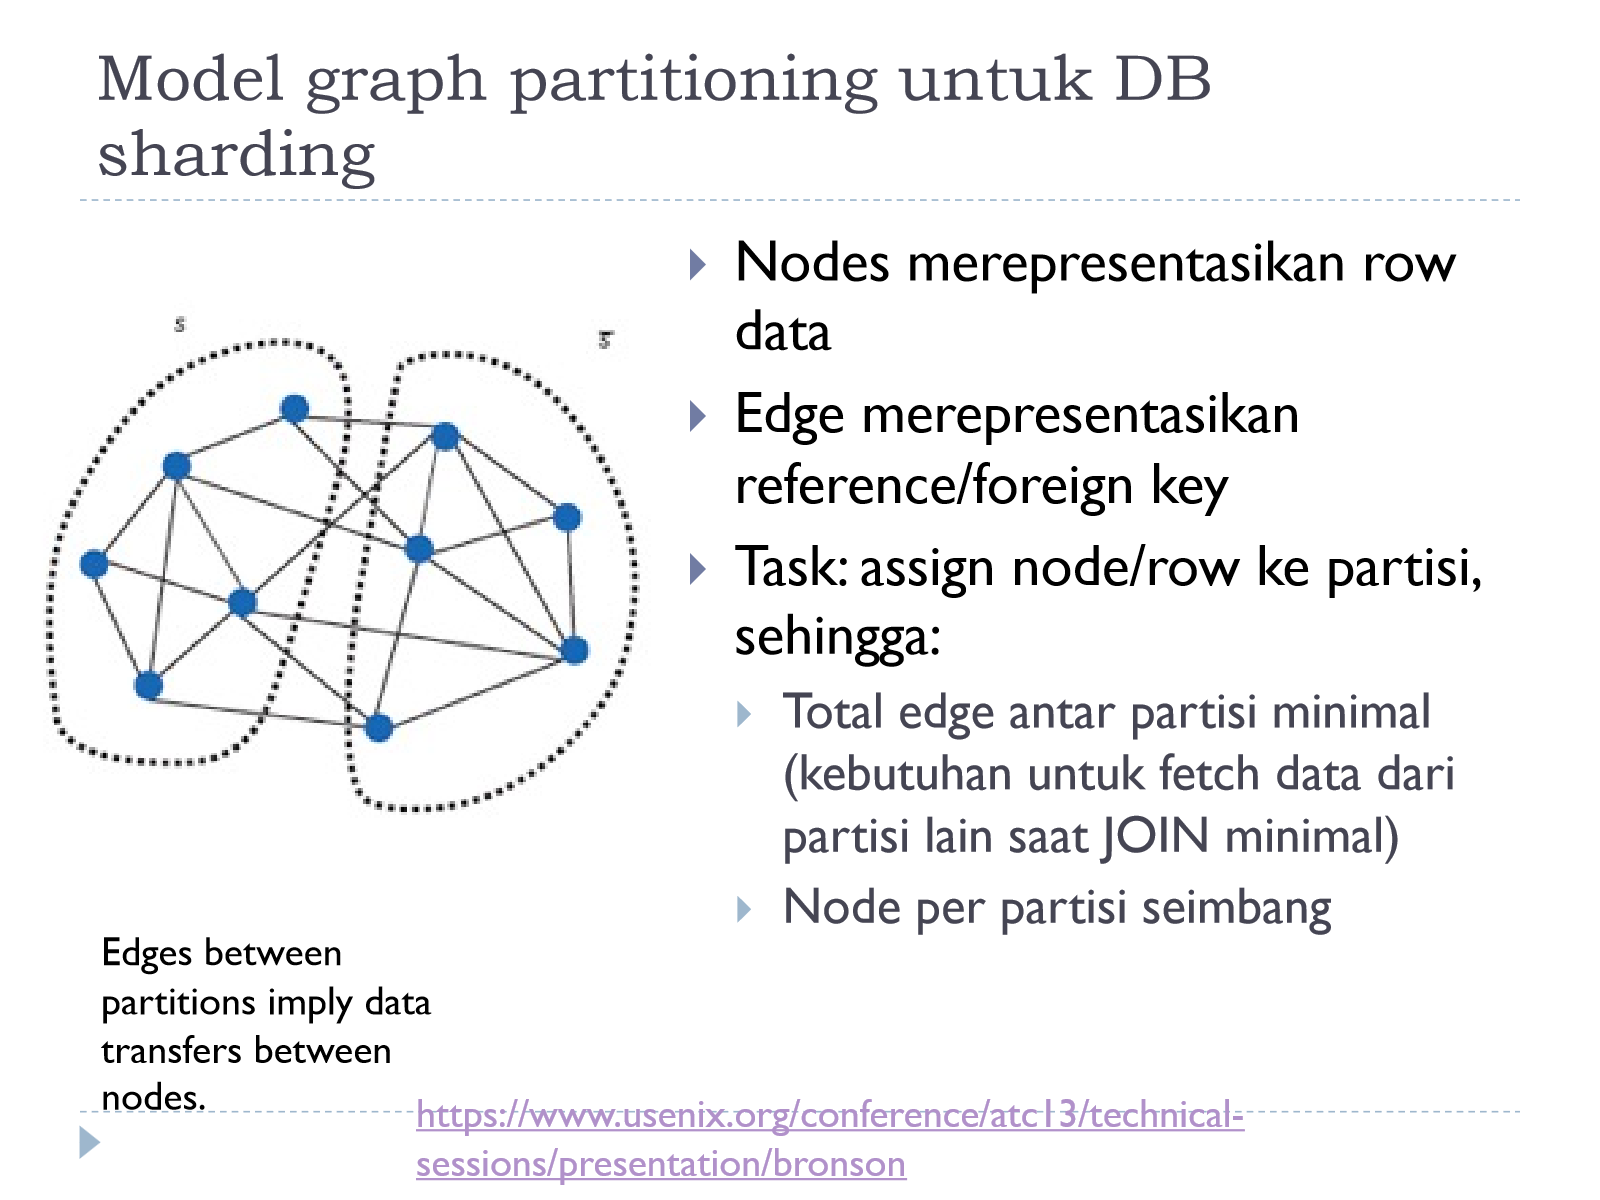
Challenge pada Graph Partitioning
Pendekatan graph partitioning ini punya beberapa kesulitan mendasar:
- Menyelesaikan problem partitioning graph secara optimal adalah NP-complete — secara komputasi mahal untuk graph besar.
- Model graph ini juga masih sangat disederhanakan dibanding realitas:
- Ada row yang jauh lebih sering diakses dibanding row lain (hot row), sesuatu yang tidak tertangkap murni dari struktur edge.
- Satu edge yang memotong partisi dapat memicu fetch transitif ke banyak node lain, sehingga cost reference bisa meningkat sangat besar dari yang terlihat di graph.
- Bahkan jika partitioning sudah optimal, tetap akan selalu ada kebutuhan akses data antar partisi — masalah ini tidak bisa dihilangkan sepenuhnya, hanya diminimalkan.
Dari SQL ke NoSQL: Menghilangkan Edge lewat Denormalisasi
Karena akar masalahnya adalah edge (foreign key/reference antar row), solusi paling mendasar adalah menghilangkan edge itu sendiri — dengan begitu, problem partitioning menjadi trivial (tidak ada lagi kebutuhan mempertimbangkan hubungan antar row saat mempartisi).
Namun, foreign key dan JOIN adalah konsep fundamental pada relational DB. Maka, dengan menghilangkan kemampuan membuat foreign key, sebuah database pada dasarnya berubah menjadi database NoSQL — yang menyimpan denormalized data, dengan data yang sebelumnya direferensikan lewat foreign key kini diduplikasi langsung ke dalam satu record.
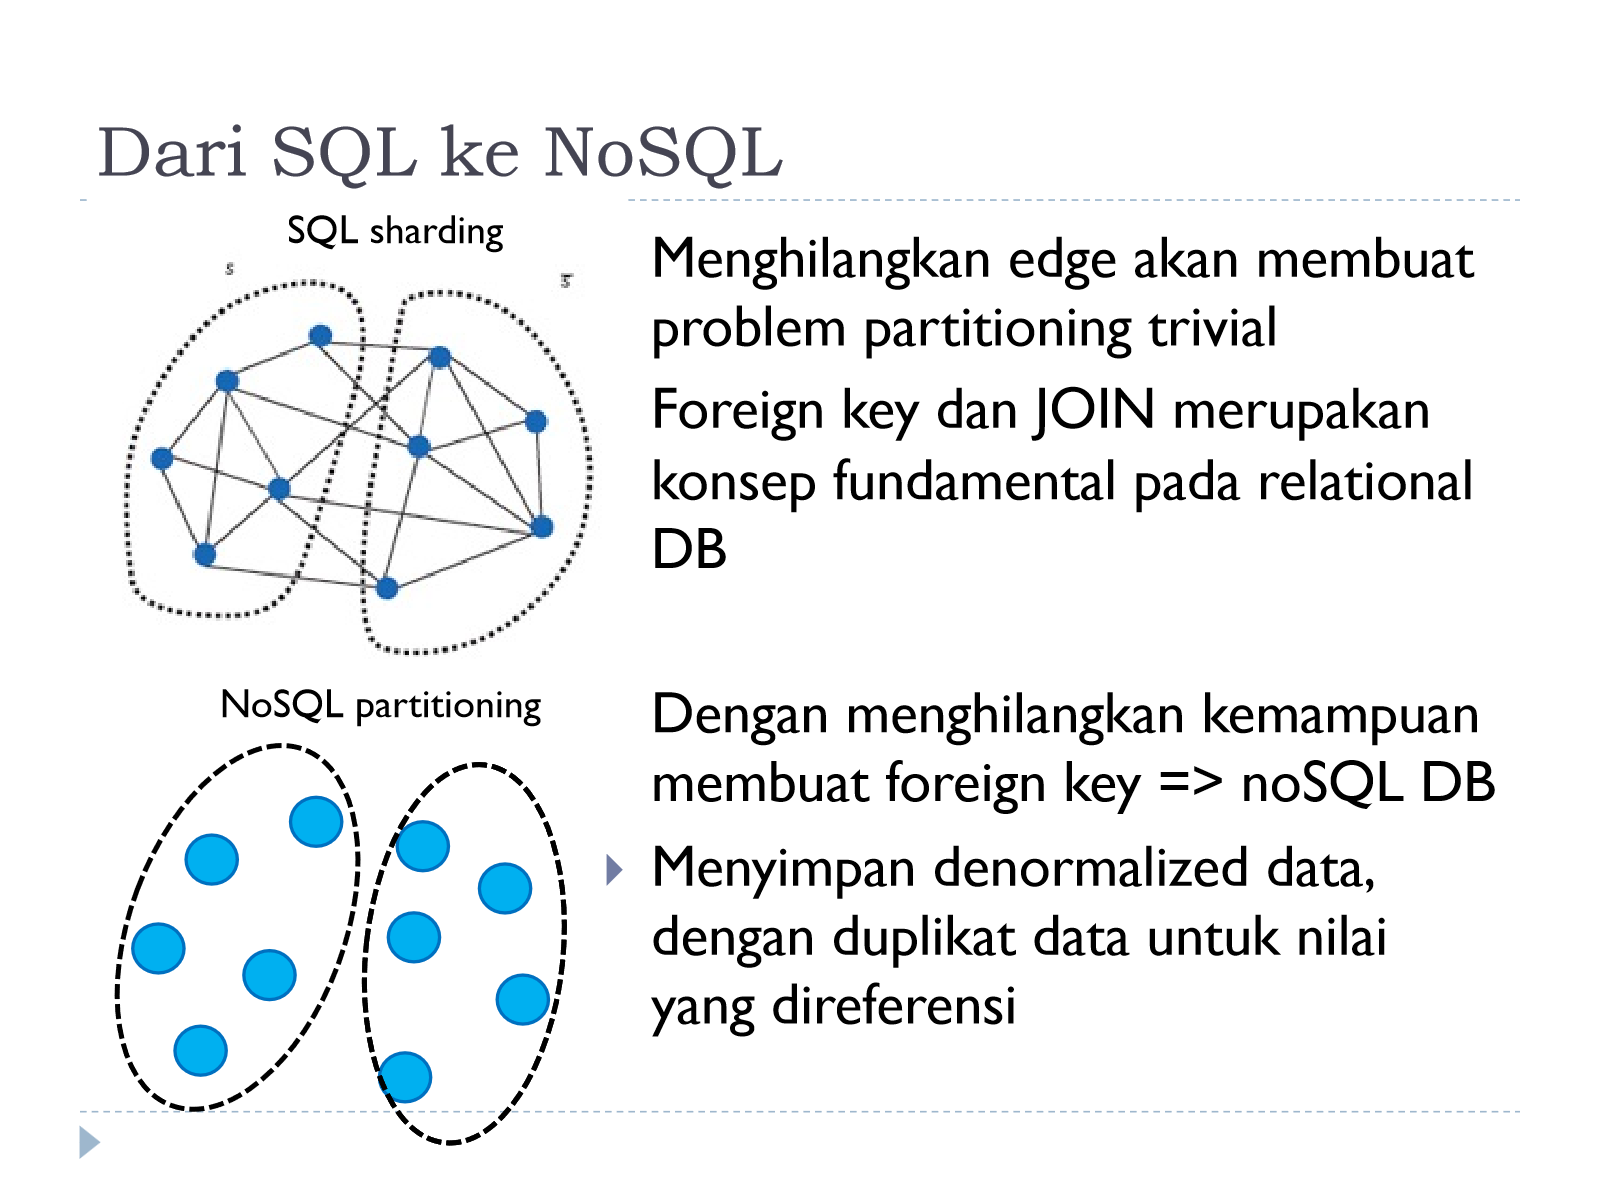
Sebagai ilustrasi, data seorang user yang pada model relasional tersebar di lima tabel (users, regions, industries, positions, education, contact_info) yang saling terhubung lewat foreign key, pada model NoSQL digabung menjadi satu dokumen/value (misalnya JSON) yang berisi semua informasi tersebut sekaligus di bawah satu key (user_id). Dengan begitu, mengambil seluruh data seorang user cukup dengan satu lookup ke satu key, tanpa perlu JOIN ke tabel/node lain.
Kekurangan Pendekatan NoSQL
Denormalisasi menyelesaikan masalah scalability, tetapi menimbulkan trade-off baru:
- Hanya ada satu kolom indeks, yaitu the key — index dibangun menggunakan hash-based partitioning berdasarkan key tersebut, sehingga pencarian berdasarkan atribut lain (selain key) menjadi tidak efisien.
- Denormalized data membuat data terduplikasi, yang berdampak pada:
- Pemborosan space penyimpanan.
- Data tidak dapat diedit di satu tempat — jika satu nilai yang terduplikasi perlu diubah, perubahan harus dipropagasi ke semua salinannya.
- Reference (referensi antar data) masih dimungkinkan, tetapi dengan keterbatasan:
- Penelusuran reference memerlukan query terpisah, dan kemungkinan besar ke node yang berbeda.
- Tidak ada pemeriksaan constraint untuk integrity — reference bisa menjadi invalid setelah data yang direferensikan dihapus, karena tidak ada mekanisme foreign key constraint seperti pada relational DB.
Arsitektur Distributed Shared-Nothing
Database NoSQL umumnya diimplementasikan di atas arsitektur distributed, shared-nothing:
- Dibangun sebuah cluster dari banyak komputer/node yang saling terhubung.
- Setiap node pada cluster hanya menyimpan sebagian (bagian) dari keseluruhan data — tidak ada storage yang dipakai bersama (shared) oleh semua node.
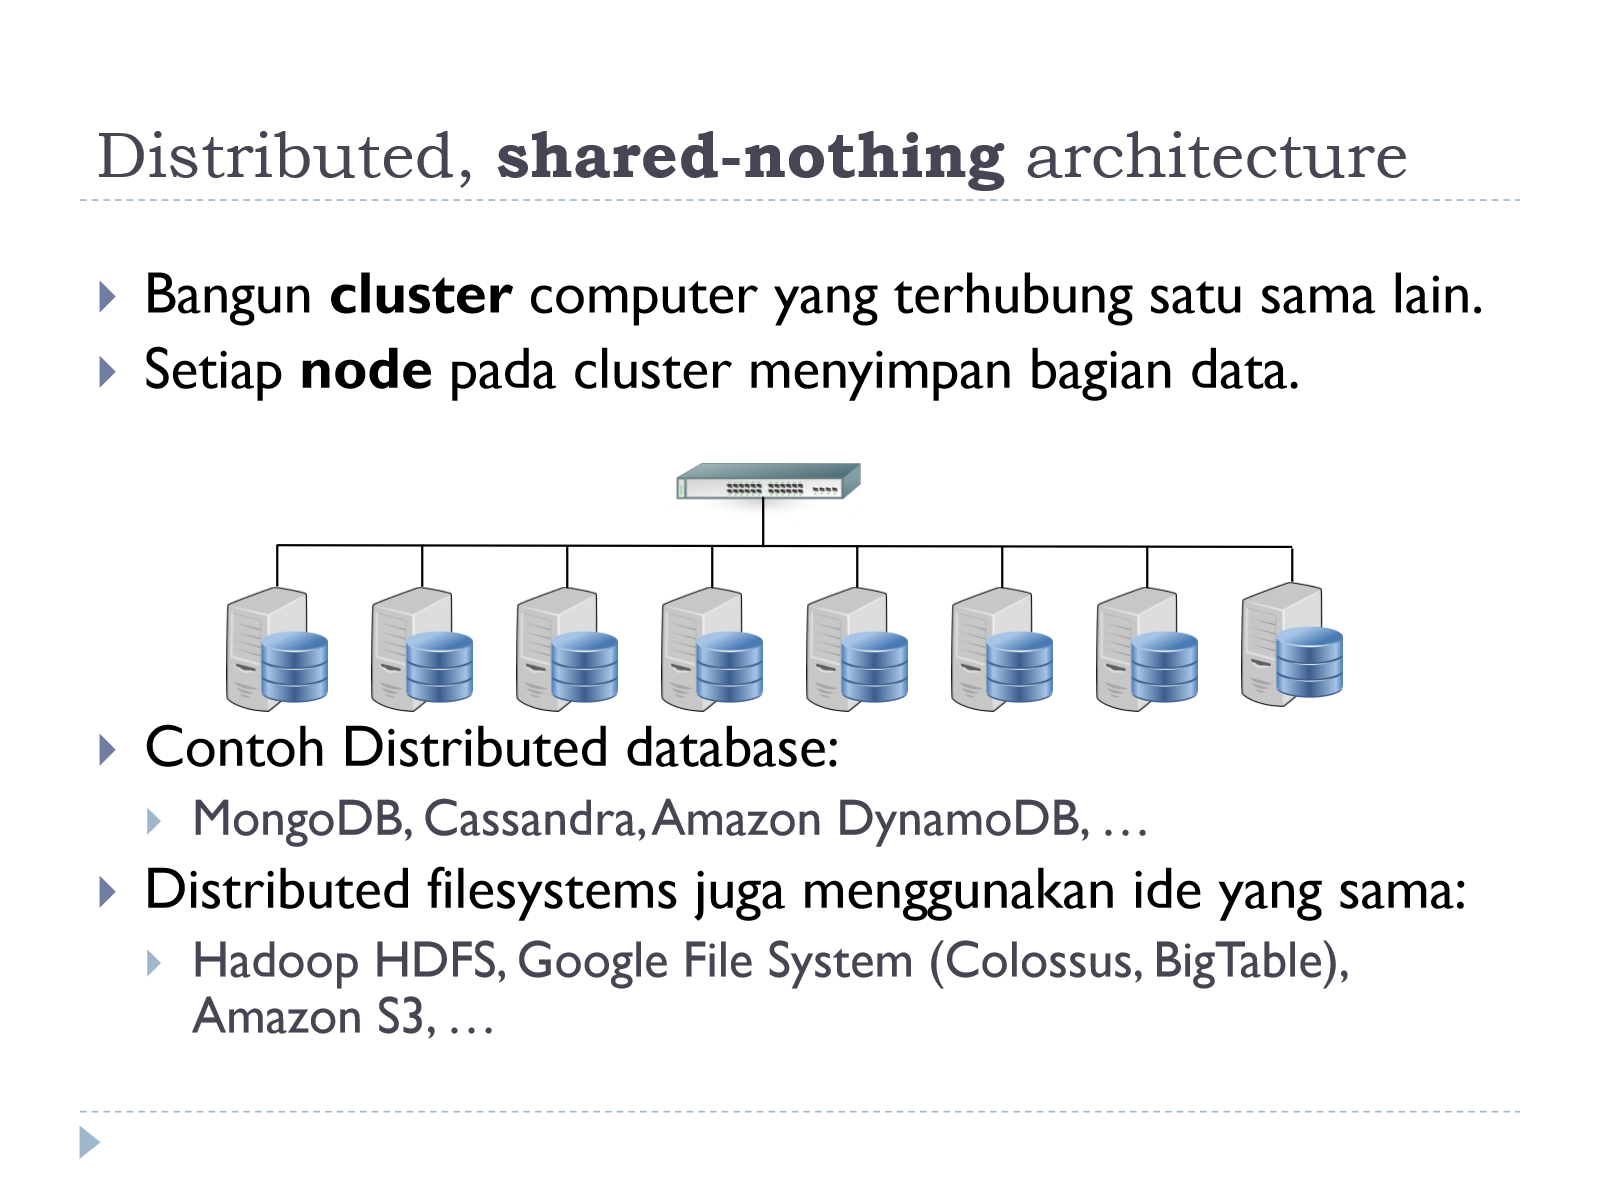
Contoh distributed database dengan arsitektur ini: MongoDB, Cassandra, Amazon DynamoDB. Ide yang sama juga dipakai pada distributed filesystem: Hadoop HDFS, Google File System (yang kemudian berevolusi menjadi Colossus, dipakai BigTable), dan Amazon S3.
Consistency: Masalah saat Data Direplikasi
Ketika data disimpan dengan replikasi ke banyak node (untuk availability dan scalability), muncul potensi inconsistency: pada satu titik waktu, node yang berbeda bisa memiliki nilai yang berbeda untuk data yang sama.
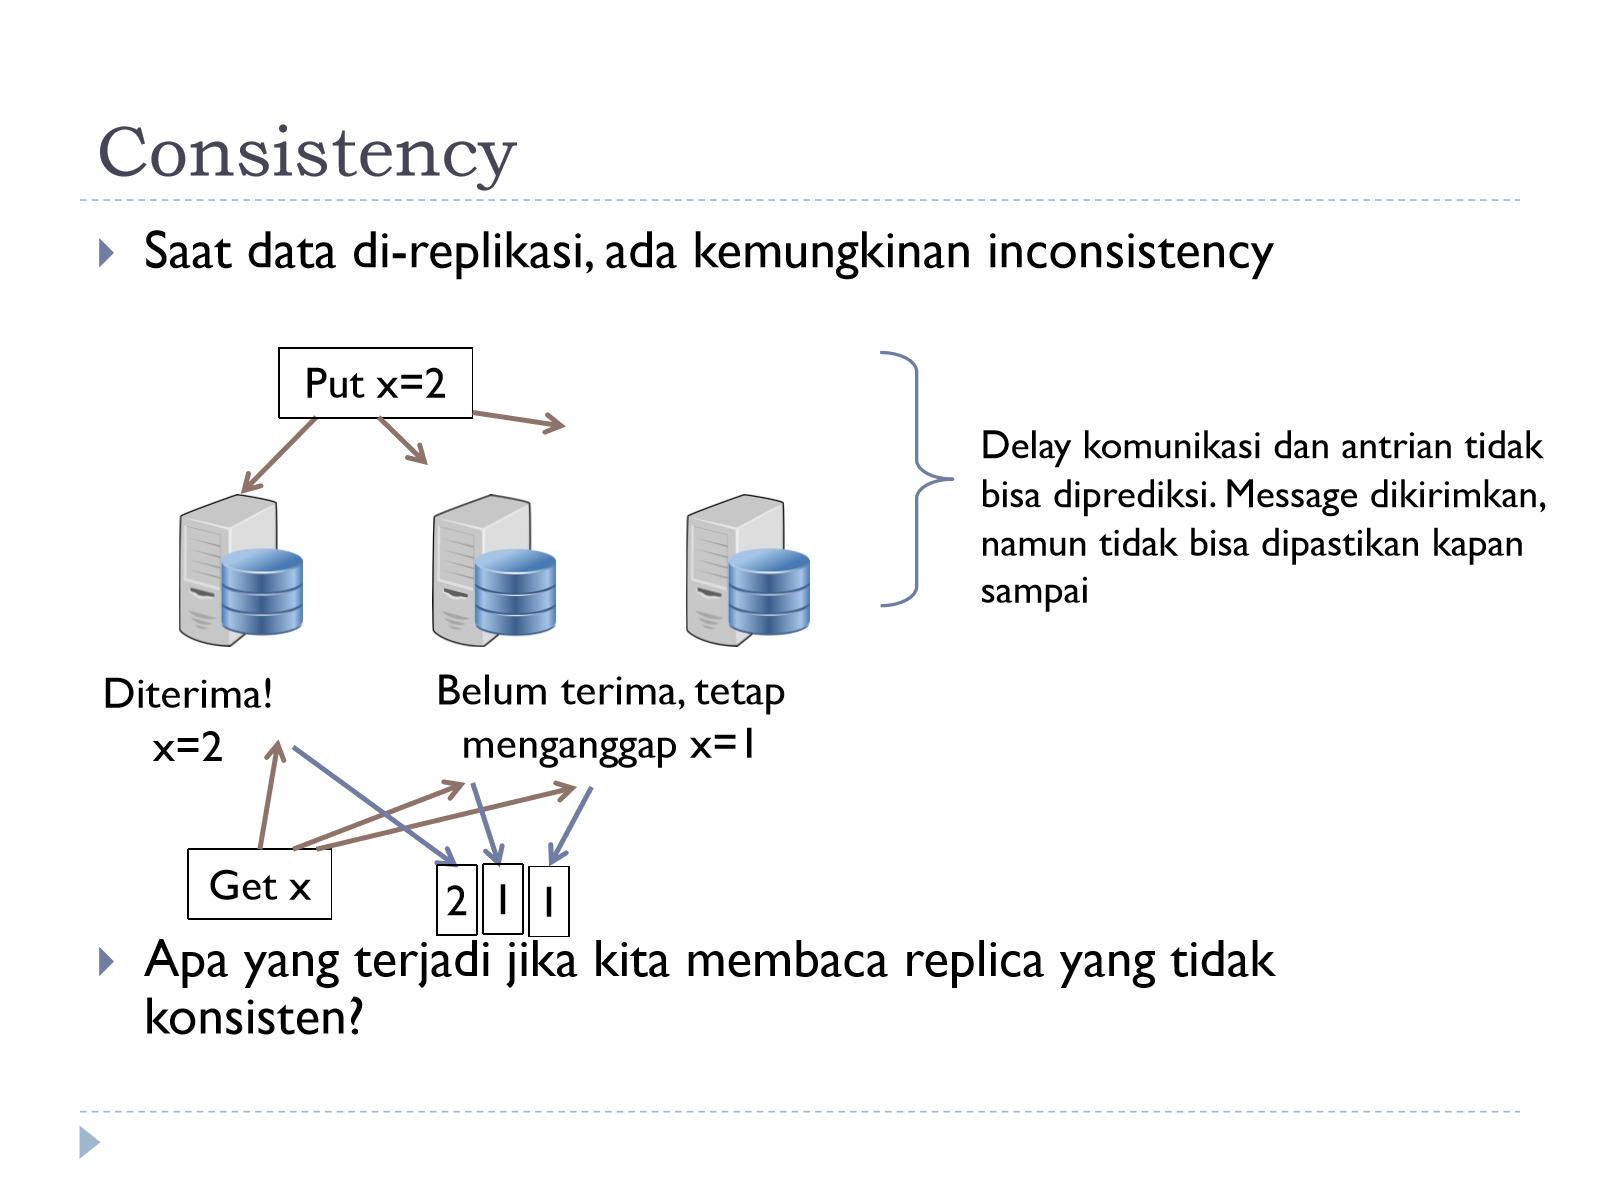
Skenario yang diilustrasikan: sebuah operasi Put x=2 dikirim ke tiga replika sekaligus. Karena delay komunikasi dan antrian tidak bisa diprediksi — pesan pasti dikirim, tetapi tidak bisa dipastikan kapan pesan itu akan sampai — bisa terjadi kondisi di mana:
- Satu replika sudah menerima update dan bernilai
x=2. - Dua replika lain belum menerima update tersebut dan masih menganggap
x=1.
Jika kemudian ada operasi Get x yang dikirim ke ketiga replika, jawabannya bisa berbeda-beda (2, 1, 1) tergantung replika mana yang dihubungi. Pertanyaan kuncinya: apa yang terjadi (dan apa yang seharusnya dijamin ke pengguna) jika kita membaca dari replica yang ternyata belum konsisten?
Trade-off Consistency vs Availability/Delay
Persoalan inconsistency akibat replikasi inilah yang mendasari Teorema CAP. Menurut slide, Teorema CAP membuat kita harus memilih antara consistency dan delay:
Teorema CAP menyatakan bahwa sebuah sistem terdistribusi yang mengalami network partition (P) tidak dapat secara simultan menjamin Consistency penuh (semua node melihat data yang sama pada saat yang sama) dan Availability penuh (setiap request selalu mendapat respons, tanpa error, meski ada node yang tidak bisa dihubungi/di-sync). Karena partition pada jaringan pada dasarnya tidak bisa dihindari sepenuhnya di sistem terdistribusi skala besar, pada praktiknya desainer sistem harus memilih mengutamakan consistency (dengan konsekuensi delay/menunggu, atau bahkan menolak request, sampai data konsisten) atau mengutamakan availability (dengan konsekuensi kemungkinan membaca data yang stale/tidak konsisten, demi tetap merespons dengan cepat).
Beberapa poin penting terkait trade-off ini:
- Inconsistency dapat mengakibatkan beragam bugs pada aplikasi — jika aplikasi mengasumsikan data selalu konsisten padahal ternyata tidak, hasil yang salah bisa merambat ke logic lain.
- Di sisi lain, delay (menunggu konsistensi tercapai) merupakan sesuatu yang masih dapat ditangani oleh aplikasi (misalnya dengan loading state, retry, dsb) — sehingga delay dianggap sebagai kompromi yang lebih “aman” dibanding inconsistency yang silent.
- Jika sebuah sistem benar-benar memerlukan konsistensi dan ketepatan waktu (timeliness) sekaligus, solusi paling aman adalah kembali menggunakan database terpusat (bukan terdistribusi) — karena pada database terpusat tidak ada masalah replikasi lintas node.
- Distributed (NoSQL) DB pada dasarnya menyediakan pilihan bagi pengembang untuk menentukan sendiri titik keseimbangan (trade-off) antara consistency dan delay/availability, sesuai kebutuhan aplikasi masing-masing.
Pertanyaan yang kemudian relevan bagi seorang client yang terhubung ke sebuah DB cluster terdistribusi: jaminan konsistensi seperti apa sebenarnya yang ingin/perlu dijamin ke client tersebut? Pertanyaan inilah yang dijawab oleh client-centric consistency model pada bagian berikut.
Client-Centric Consistency Model
Client-centric consistency model adalah kumpulan jaminan konsistensi yang didefinisikan dari sudut pandang satu client tertentu (bukan dari sudut pandang keseluruhan sistem/semua client sekaligus). Ada tiga properti utama yang dibahas:
Monotonic Reads
Jika seorang client membaca nilai x, maka pembacaan berikutnya terhadap x dari client yang sama akan selalu mengembalikan nilai yang sama atau lebih baru (tidak pernah mundur/lebih lama).
Read your Writes
Jika seorang client menulis nilai ke x, maka pembacaan berikutnya terhadap x dari client yang sama akan selalu mengembalikan nilai yang sama atau lebih baru dari yang baru saja ditulis client tersebut.
Monotonic Writes
Jika seorang client menulis dua kali terhadap x, maka penulisan pertama harus terjadi (ter-apply) sebelum penulisan yang kedua — urutan penulisan dari client yang sama harus tetap terjaga di semua replika.
Tabel berikut merangkum ketiga properti tersebut beserta skenario kegagalannya dan solusi yang ditawarkan slide:
| Properti | Definisi (jaminan ke client) | Skenario Kegagalan | Solusi |
|---|---|---|---|
| Monotonic Reads | Pembacaan berikutnya terhadap x oleh client yang sama selalu mengembalikan nilai sama atau lebih baru dari pembacaan sebelumnya. | Client membaca dari node yang berbeda pada dua request Get x berturut-turut, sementara penulisan (Put x=1) belum sempat direplikasi lengkap ke semua node — request kedua kebetulan mendarat di node yang belum menerima update, sehingga nilai yang dibaca mundur dibanding pembacaan pertama. | Memastikan client selalu terhubung ke node yang sama (sticky session), atau menunda request berikutnya sampai replikasi selesai. |
| Read your Writes | Pembacaan berikutnya terhadap x oleh client yang sama selalu mengembalikan nilai yang sama atau lebih baru dari yang baru saja ditulis client itu sendiri. | Client menulis (Put x=1) ke satu node, lalu langsung membaca (Get x) dari node lain yang belum menerima replikasi write tersebut — client tidak melihat tulisannya sendiri. | Sama seperti Monotonic Reads: memastikan client terhubung ke node yang sama, atau menunda pembacaan berikutnya. |
| Monotonic Writes | Dua penulisan berturut-turut oleh client yang sama harus ter-apply sesuai urutannya (write pertama sebelum write kedua) di semua replika. | Client mengirim Put x=1 lalu Put x=2 ke node yang berbeda; karena delay replikasi tidak terprediksi, ada kemungkinan Put x=2 justru ter-apply lebih dulu di sebuah replika dibanding Put x=1, sehingga urutan penulisan menjadi terbalik di replika tersebut. | Prinsip solusi sama: konsistensi routing client ke node yang sama dan/atau mekanisme yang menjamin urutan (ordering) write tetap terjaga sebelum write berikutnya diterima. |
Ilustrasi Kegagalan Monotonic Reads
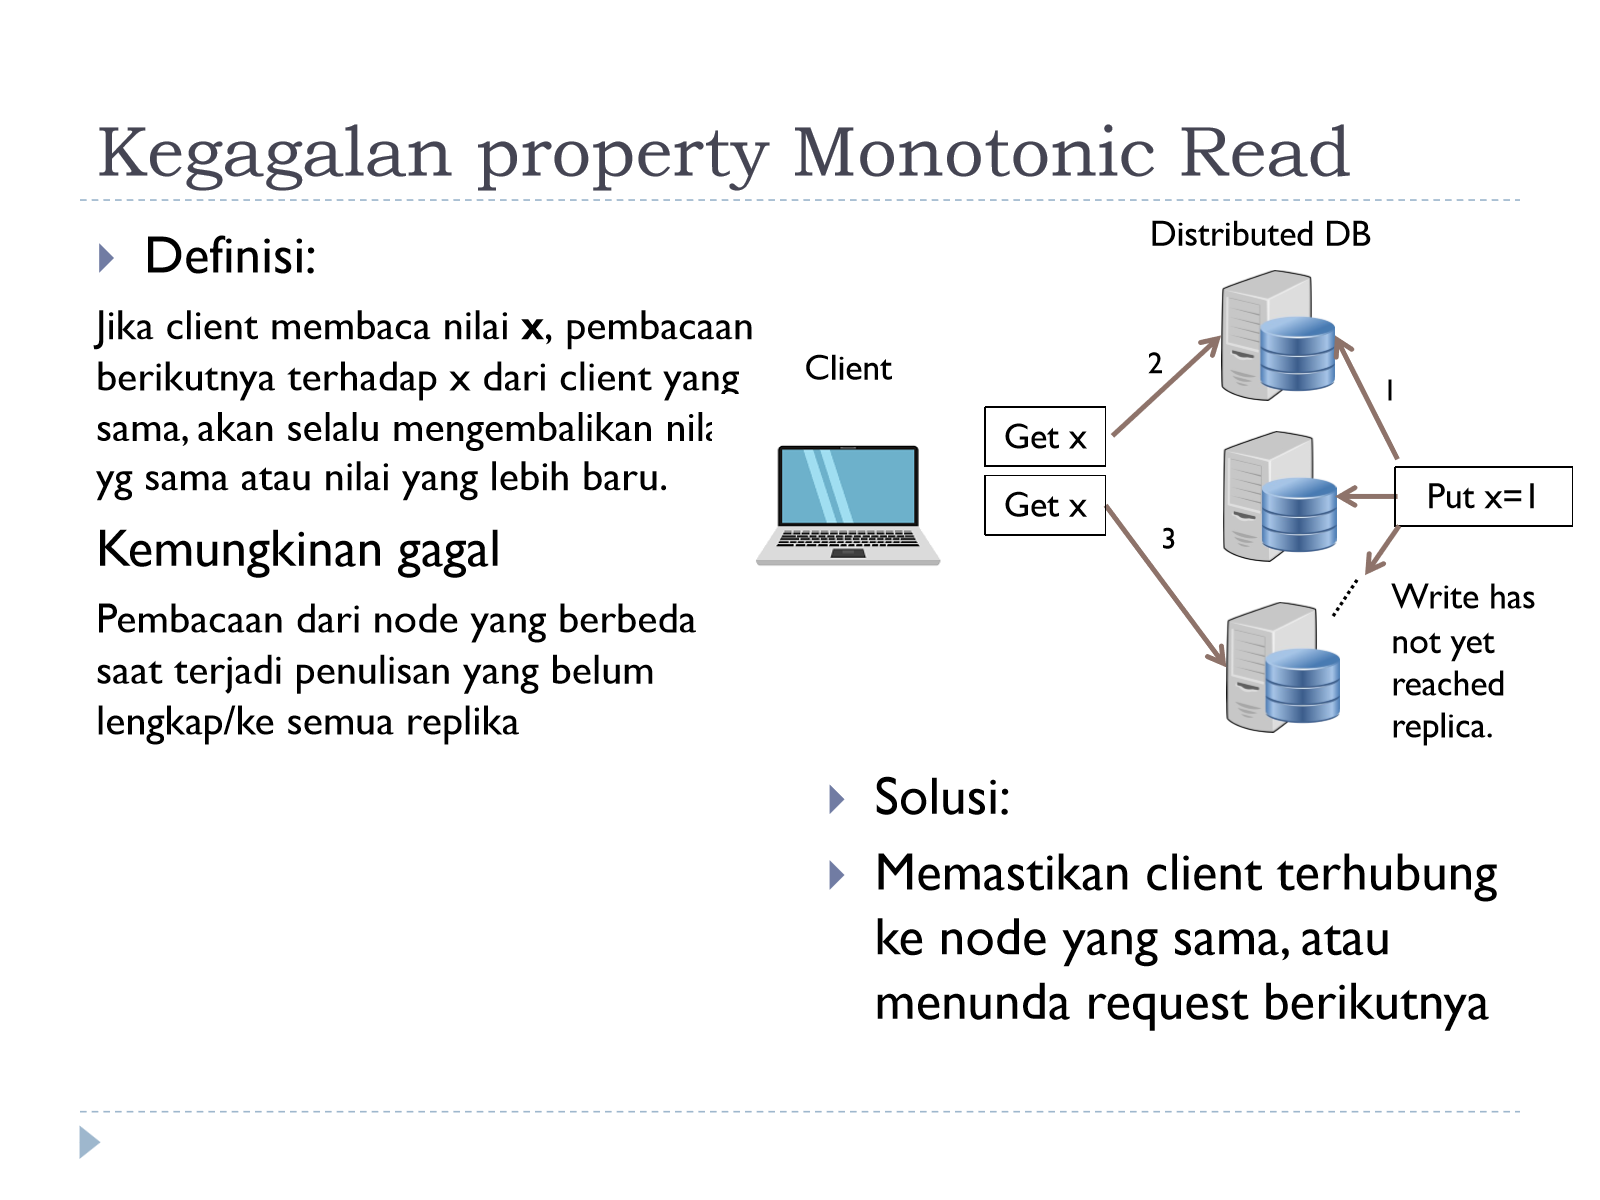
Pada diagram ini, client mengirim Get x pertama ke sebuah node dan mendapat hasil tertentu; hampir bersamaan, ada operasi Put x=1 yang dikirim ke seluruh replika, namun write tersebut belum sampai ke salah satu replika. Ketika client mengirim Get x kedua dan kebetulan diarahkan ke replika yang belum menerima write, client bisa melihat nilai yang lebih lama dibanding yang seharusnya — melanggar jaminan monotonic reads.
Ilustrasi Kegagalan Monotonic Writes
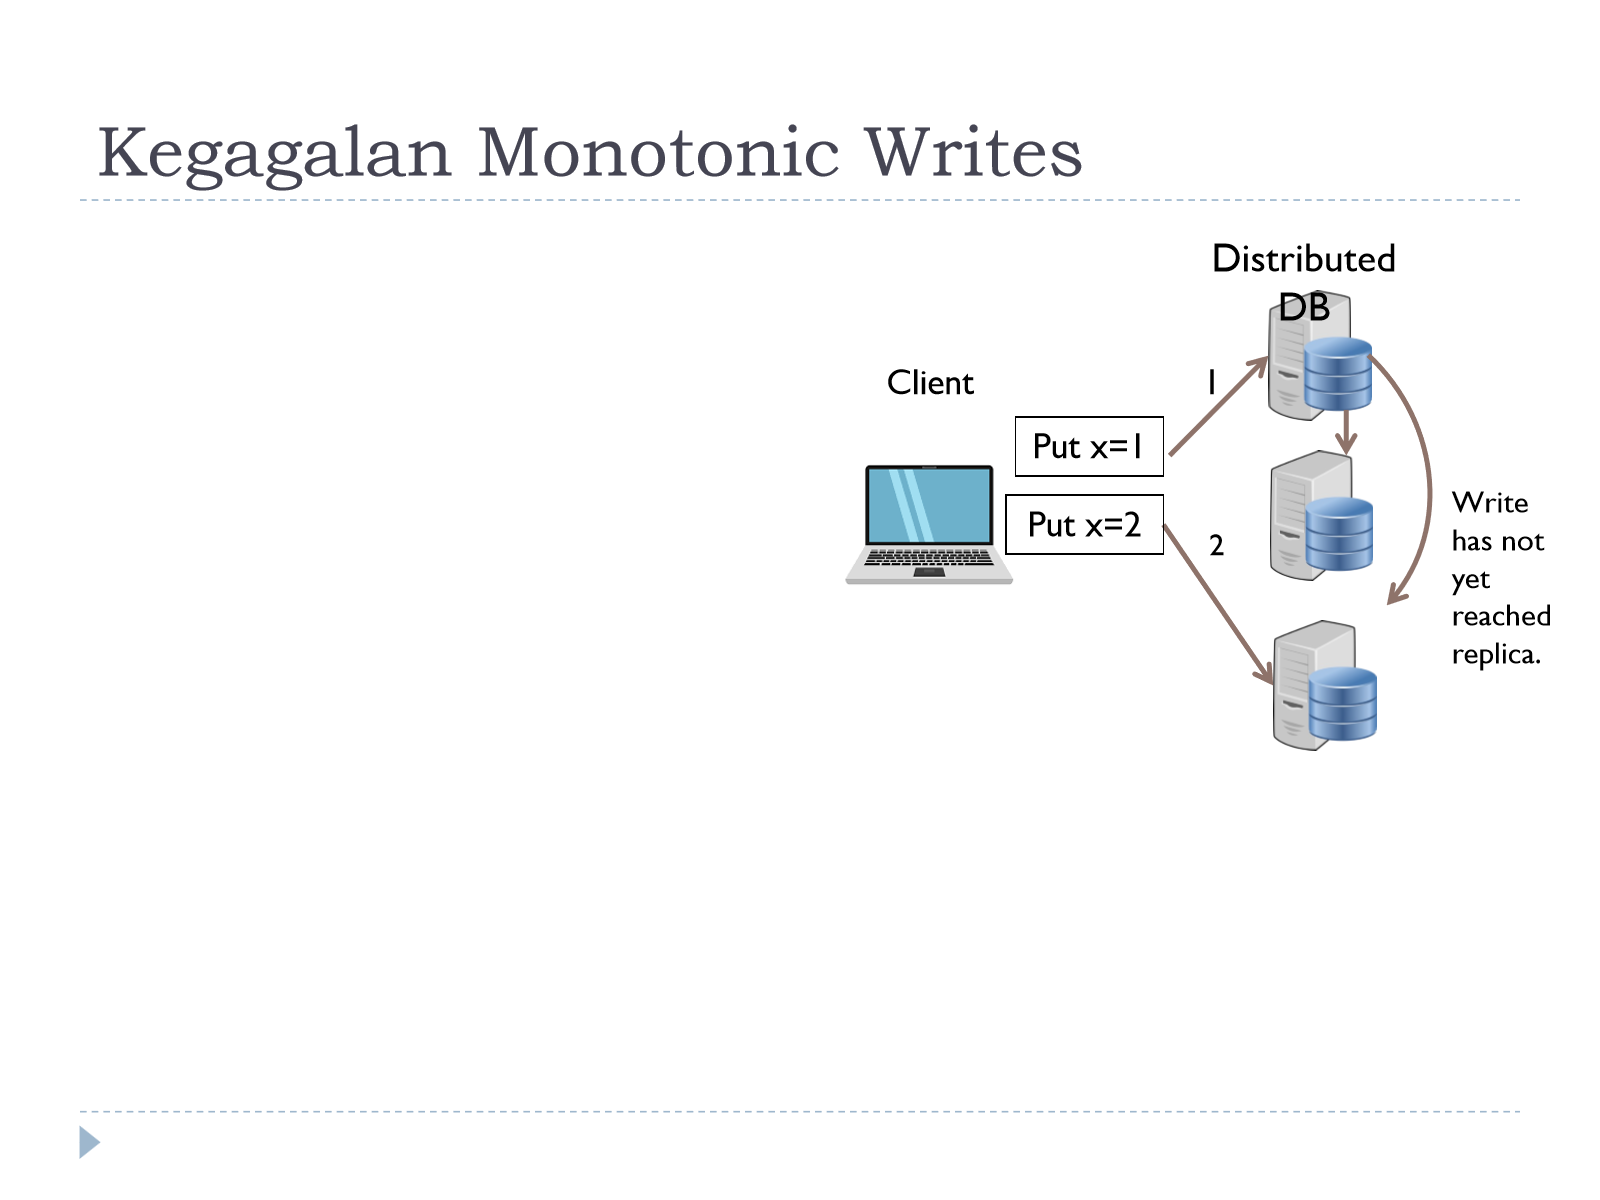
Client mengirim Put x=1 ke satu node lalu Put x=2 ke node lain. Karena write belum tentu sampai ke semua replika dengan urutan yang sama (delay antar-node tidak terprediksi), sebuah replika berisiko menerapkan Put x=2 sebelum Put x=1, sehingga replika tersebut berakhir dengan urutan write yang salah dibanding urutan asli dari sisi client.
Catatan: skenario Read your Writes tidak diilustrasikan ulang di sini karena pola kegagalannya identik — client menulis ke satu node lalu membaca dari node lain yang belum ter-update — dan solusinya pun sama (routing ke node yang sama, atau menunda request).
Flashcard
flashcards Apa inti dari Teorema CAP dalam sistem terdistribusi? :: Saat terjadi network partition (P) — yang tidak bisa dihindari sepenuhnya di sistem terdistribusi skala besar — sebuah sistem tidak dapat secara simultan menjamin Consistency penuh (semua node melihat data sama) dan Availability penuh (setiap request selalu direspons tanpa error); desainer harus memilih mengutamakan consistency (delay/menunggu) atau availability (menerima kemungkinan data stale). Menurut slide, trade-off apa yang sebenarnya dipilih desainer sistem terdistribusi (bukan sekadar C vs A)? :: Trade-off antara consistency dan delay — mengutamakan consistency berarti menerima delay (menunggu data konsisten sebelum merespons), sedangkan mengutamakan availability berarti menerima risiko membaca data yang belum konsisten (stale) demi tetap merespons cepat. Kenapa horizontal partitioning/sharding pada relational DB dengan normalized data sulit di-scale? :: Karena data normalized menyimpan relasi lewat foreign key/JOIN antar tabel; banyak query yang melibatkan JOIN akan melibatkan banyak node/shard sekaligus, sehingga query tersebut menjadi tidak scalable meski data sudah dipartisi. Bagaimana database NoSQL mengatasi masalah scalability sharding pada relational DB? :: Dengan melakukan denormalisasi data — data yang sebelumnya tersebar dan direferensikan lewat foreign key digabung/diduplikasi menjadi satu dokumen/record, sehingga query dapat diselesaikan dalam satu node tanpa perlu JOIN lintas node. Sebutkan tiga kekurangan utama pendekatan NoSQL akibat denormalisasi. :: (1) Hanya satu kolom indeks (the key) berbasis hash-partitioning; (2) data terduplikasi menyebabkan pemborosan space dan tidak bisa diedit di satu tempat; (3) reference antar data masih mungkin tapi memerlukan query terpisah ke node lain dan tidak ada pemeriksaan constraint integrity. Jelaskan properti Monotonic Reads dalam client-centric consistency model. :: Jika seorang client membaca nilai x, maka pembacaan berikutnya terhadap x oleh client yang sama harus selalu mengembalikan nilai yang sama atau lebih baru, tidak pernah mengembalikan nilai yang lebih lama dari pembacaan sebelumnya. Jelaskan properti Read your Writes dan skenario umum kegagalannya. :: Read your Writes menjamin bahwa setelah seorang client menulis nilai ke x, pembacaan berikutnya oleh client yang sama akan mengembalikan nilai itu atau yang lebih baru. Kegagalan umumnya terjadi jika client menulis ke satu node lalu membaca dari node lain yang belum menerima replikasi write tersebut. Apa solusi umum yang ditawarkan slide untuk mengatasi kegagalan Monotonic Reads, Read your Writes, dan Monotonic Writes? :: Memastikan client selalu terhubung (routing) ke node yang sama untuk semua request berikutnya, atau menunda request berikutnya sampai proses replikasi ke semua replika selesai. Mengapa model graph partitioning untuk DB sharding tergolong NP-complete dan tetap punya keterbatasan meski sudah optimal? :: Karena mencari assignment node-ke-partisi yang meminimalkan total edge antar partisi sekaligus menjaga keseimbangan jumlah node per partisi adalah masalah kombinatorial yang NP-complete; selain itu model ini menyederhanakan realita (ada row yang lebih sering diakses, dan satu edge lintas partisi bisa memicu fetch transitif ke banyak node lain), sehingga akses data antar partisi tetap dibutuhkan walau partitioning sudah optimal. Apa itu arsitektur distributed shared-nothing dan berikan contohnya. :: Arsitektur di mana dibangun sebuah cluster dari banyak node yang saling terhubung, dan setiap node hanya menyimpan sebagian data (tidak ada storage yang dipakai bersama). Contoh: MongoDB, Cassandra, Amazon DynamoDB (distributed database); Hadoop HDFS, Google File System/Colossus, Amazon S3 (distributed filesystem).