Catatan ini membahas MapReduce, model pemrograman untuk pemrosesan data skala besar (big data) secara terdistribusi, beserta ekosistem Hadoop dan HDFS yang menjadi implementasi open-source paling populer dari model ini. Materi bersumber dari dua slide: yang pertama membahas konsep umum dan arsitektur MapReduce/HDFS, yang kedua membedah detail internal implementasi Hadoop (YARN, MapTask, ReduceTask, shuffle) berdasarkan sumber http://ercoppa.github.io/HadoopInternals/. Topik ini sangat relevan untuk capaian pemahaman pemrosesan data skala besar terdistribusi.
Batch Processing System
Batch Processing System adalah sistem yang mengambil sejumlah besar data input, menjalankan sebuah job untuk memprosesnya, dan menghasilkan data output. Karakteristiknya:
- Job seringkali berjalan lama (dari beberapa menit hingga beberapa hari)
- Bersifat non-interaktif, biasanya dijalankan terjadwal secara periodik
- Metrik performa yang dipakai adalah throughput, bukan latency
Sebuah job pada batch processing terdiri atas sekumpulan/series tasks, di mana output dari sebuah task menjadi input bagi task berikutnya. Karakteristik ini membuat:
- Job mudah dikomposisi: job baru dibentuk sebagai sederetan task
- Task memiliki interface uniform, sehingga sekumpulan task dapat di-pipeline menjadi sebuah job
- Ada pemisahan logic dan wiring: deskripsi sebuah task tidak bergantung pada bagaimana output-nya nanti diproses oleh task berikutnya
Contoh klasik batch processing pada Linux/Unix adalah rangkaian pipe berikut untuk menghitung 5 baris terbanyak pada access log:
cat /var/log/nginx/access.log |
  awk '{print $7}' |
  sort |
  uniq -c |
  sort -r -n |
  head -n 5
Pola “map → sort/group → reduce” yang muncul pada contoh Unix di atas (awk memetakan tiap baris, sort+uniq mengelompokkan, sort -r -n +head meringkas) adalah cikal-bakal ide di balik model MapReduce.
MapReduce sebagai Model Pemrograman
MapReduce adalah model pemrograman untuk pemrosesan data batch dengan karakteristik:
- Scalable hingga ratusan/ribuan node
- Mampu menangani data hingga orde TB dan PB
- Karena input data tidak muat pada 1 komputer, MapReduce memerlukan Distributed File System (DFS)
- Menggunakan cluster of commodity computers — komputer “biasa” (bukan mainframe mahal) yang jumlahnya banyak, karena rasio price/performance-nya jauh lebih baik dibanding mesin high-end (mis. HP ProLiant commodity server memiliki price/performance 1.28/transaksi per menit)
Filosofi desainnya:
- MapReduce membagi beban kerja menjadi sejumlah task independen, sehingga dapat dijalankan independen pada komputer yang berbeda
- Setiap task dijalankan terisolasi; komunikasi antar task diminimalkan agar sistem tetap scalable
Distribusi Data ke Cluster
Pada cluster MapReduce, data didistribusikan ke semua node saat data di-load ke sistem. Ini memerlukan distributed file system yang sesuai (misalnya GFS/HDFS) yang membagi data menjadi chunks yang dikelola oleh node yang berbeda-beda, namun kumpulan chunks tersebut tetap membentuk single namespace (satu file besar terlihat sebagai satu file logis meskipun fisiknya tersebar).
Alur Data MapReduce: Map, Shuffle, Reduce
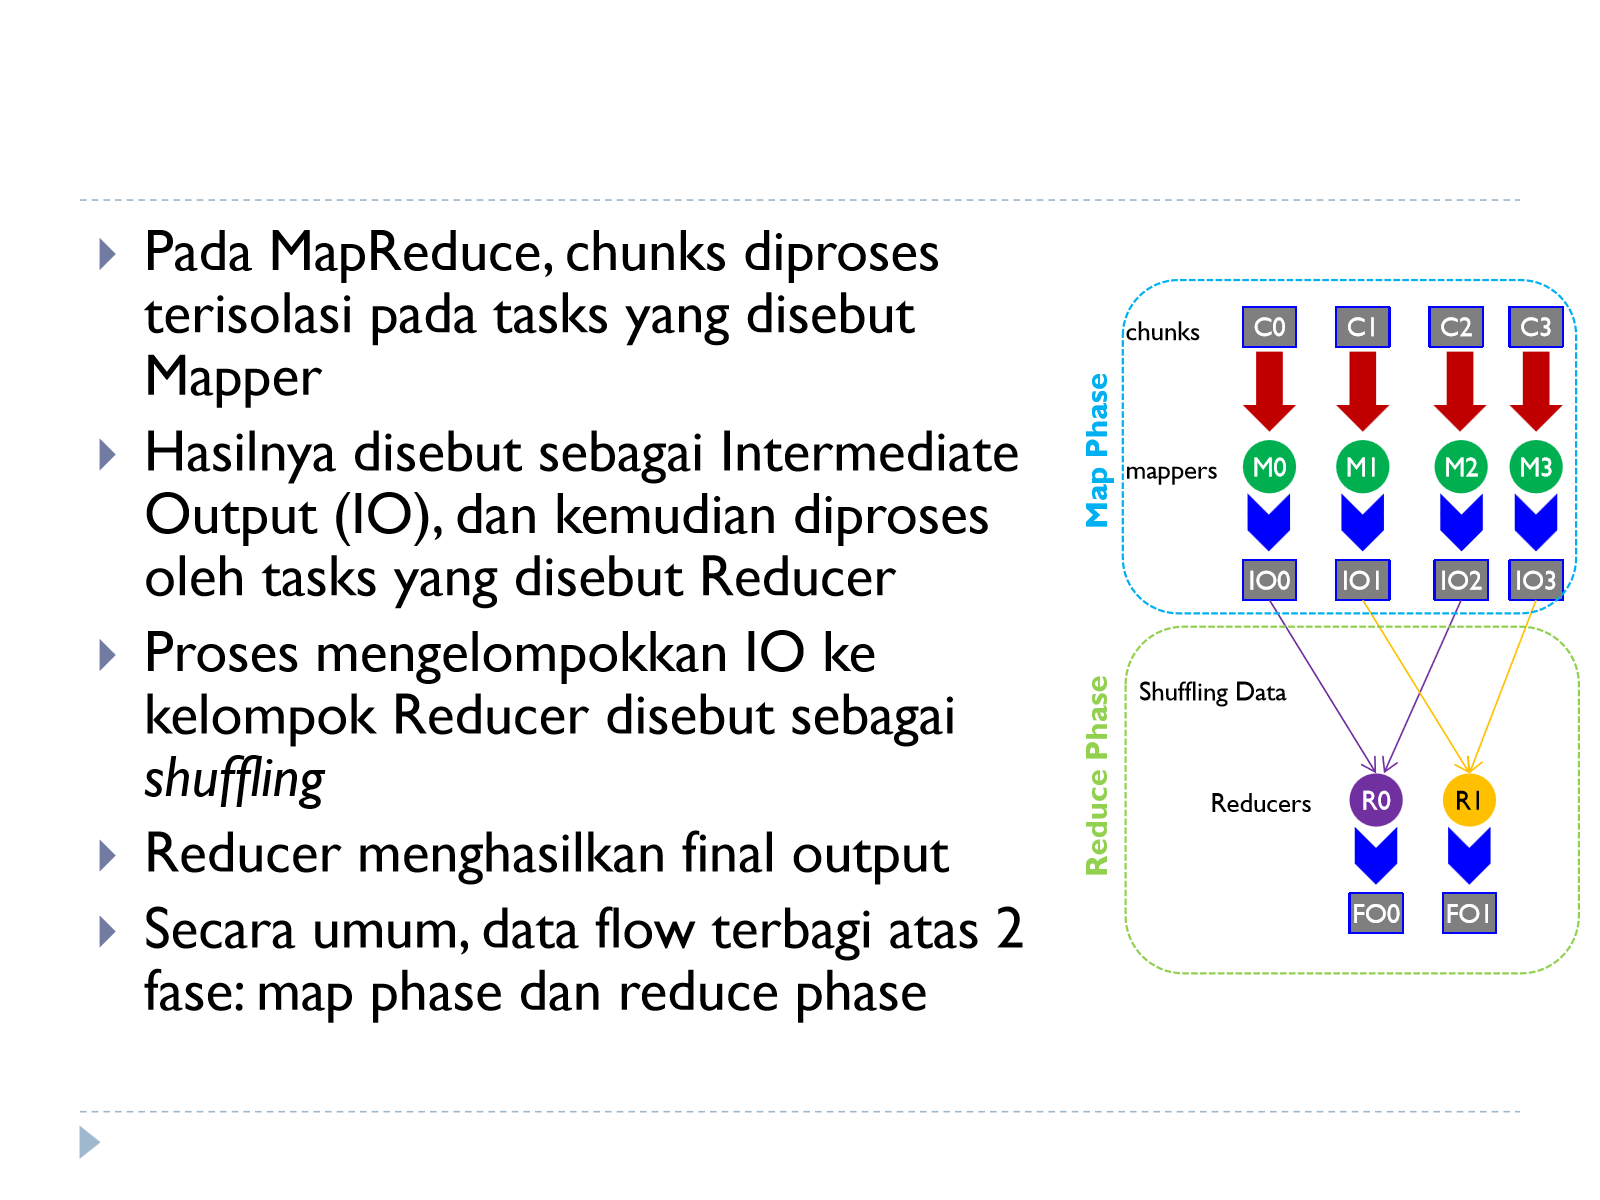
Pada MapReduce, chunks diproses secara terisolasi oleh task yang disebut Mapper. Hasil dari mapper disebut Intermediate Output (IO), yang kemudian diproses oleh task yang disebut Reducer. Proses mengelompokkan IO ke kelompok reducer yang tepat disebut shuffling. Reducer pada akhirnya menghasilkan final output.
Secara umum, data flow MapReduce terbagi atas 2 fase besar: map phase dan reduce phase, dengan proses shuffling di antaranya.
Keys and Values
Developer program MapReduce harus mendefinisikan 2 fungsi: map function dan reduce function, yang masing-masing mengimplementasikan Mapper dan Reducer. Pada MapReduce, setiap elemen data selalu distrukturkan sebagai pasangan key-value (K, V). Fungsi map dan reduce menerima dan mengirimkan pasangan (K, V):
Input Splits (K, V) --map function--> Intermediate Outputs (K', V') --reduce function--> Final Outputs (K'', V'')
Partisi
Pada MapReduce, nilai intermediate output tidak langsung di-reduce. Semua value dari IO yang memiliki key yang sama akan dikumpulkan dan di-reduce bersamaan. Subset dari keyspace pada intermediate output yang dialokasikan ke masing-masing reducer disebut sebagai partisi. Warna-warna berbeda pada IO merepresentasikan key berbeda (berpotensi berasal dari mapper berbeda) — data dengan key yang sama dari berbagai mapper akan dikumpulkan menjadi satu partisi, yang menjadi input bagi satu reducer tertentu.
Network Topology
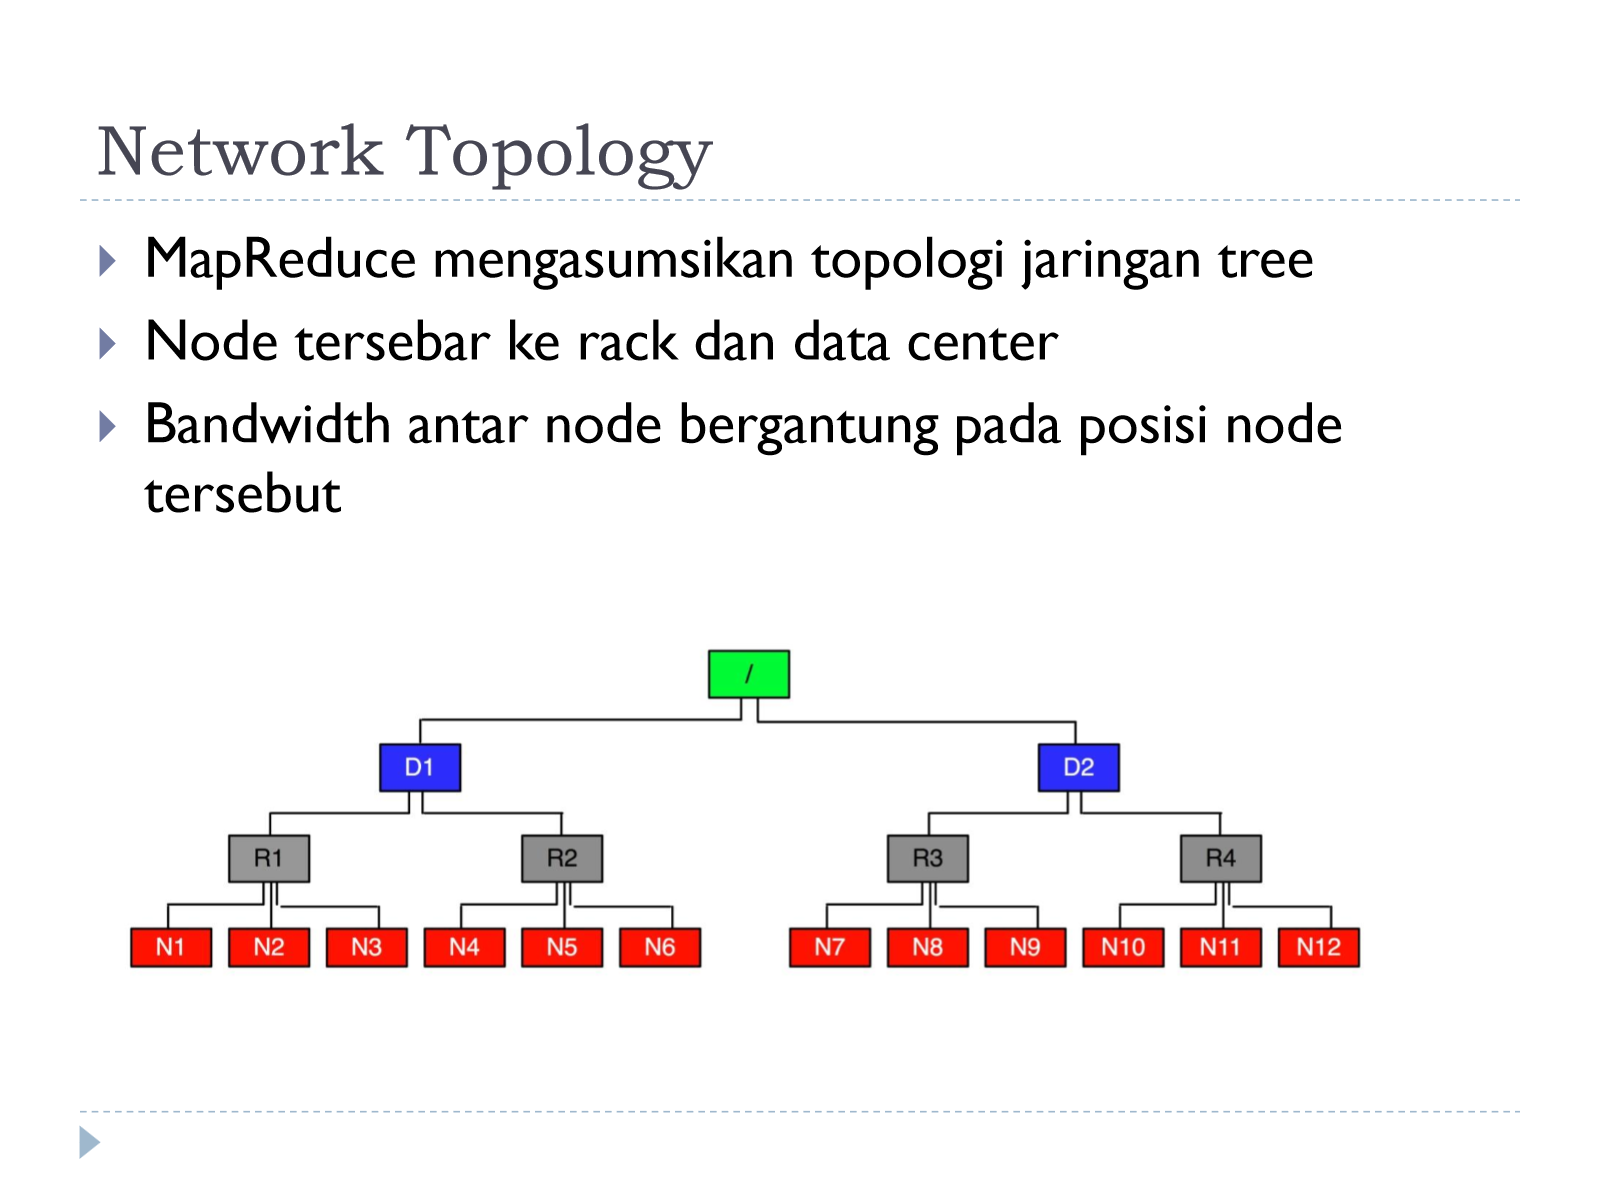
MapReduce mengasumsikan topologi jaringan berbentuk tree: node tersebar ke rack, dan rack tersebar ke data center. Bandwidth antar node bergantung pada posisi kedua node tersebut pada tree ini — node dalam rack yang sama memiliki bandwidth lebih besar dibanding node lintas rack atau lintas data center. Asumsi topologi ini mendasari strategi data locality yang akan dibahas lebih lanjut.
Hadoop dan HDFS
MapReduce pertama kali dikenalkan oleh Google pada paper tahun 2004 (research.google.com/archive/mapreduce.html). Implementasi open-source-nya adalah Hadoop (2006) dan HDFS (2005), yang dikembangkan sebagai pengembangan dari project Apache Nutch.
HDFS (Hadoop Distributed File System) adalah framework untuk distributed storage pada ekosistem Hadoop — perannya setara dengan GFS pada arsitektur Google. Input file program MapReduce umumnya disimpan pada distributed file system seperti HDFS, dengan format input yang beragam: line based log files, binary files, multi-line input, dsb.
Pipeline Eksekusi MapReduce secara Detail
Diagram berikut menunjukkan pipeline lengkap eksekusi MapReduce pada 2 node, mulai dari file yang dimuat dari HDFS lokal hingga proses shuffling antar node:
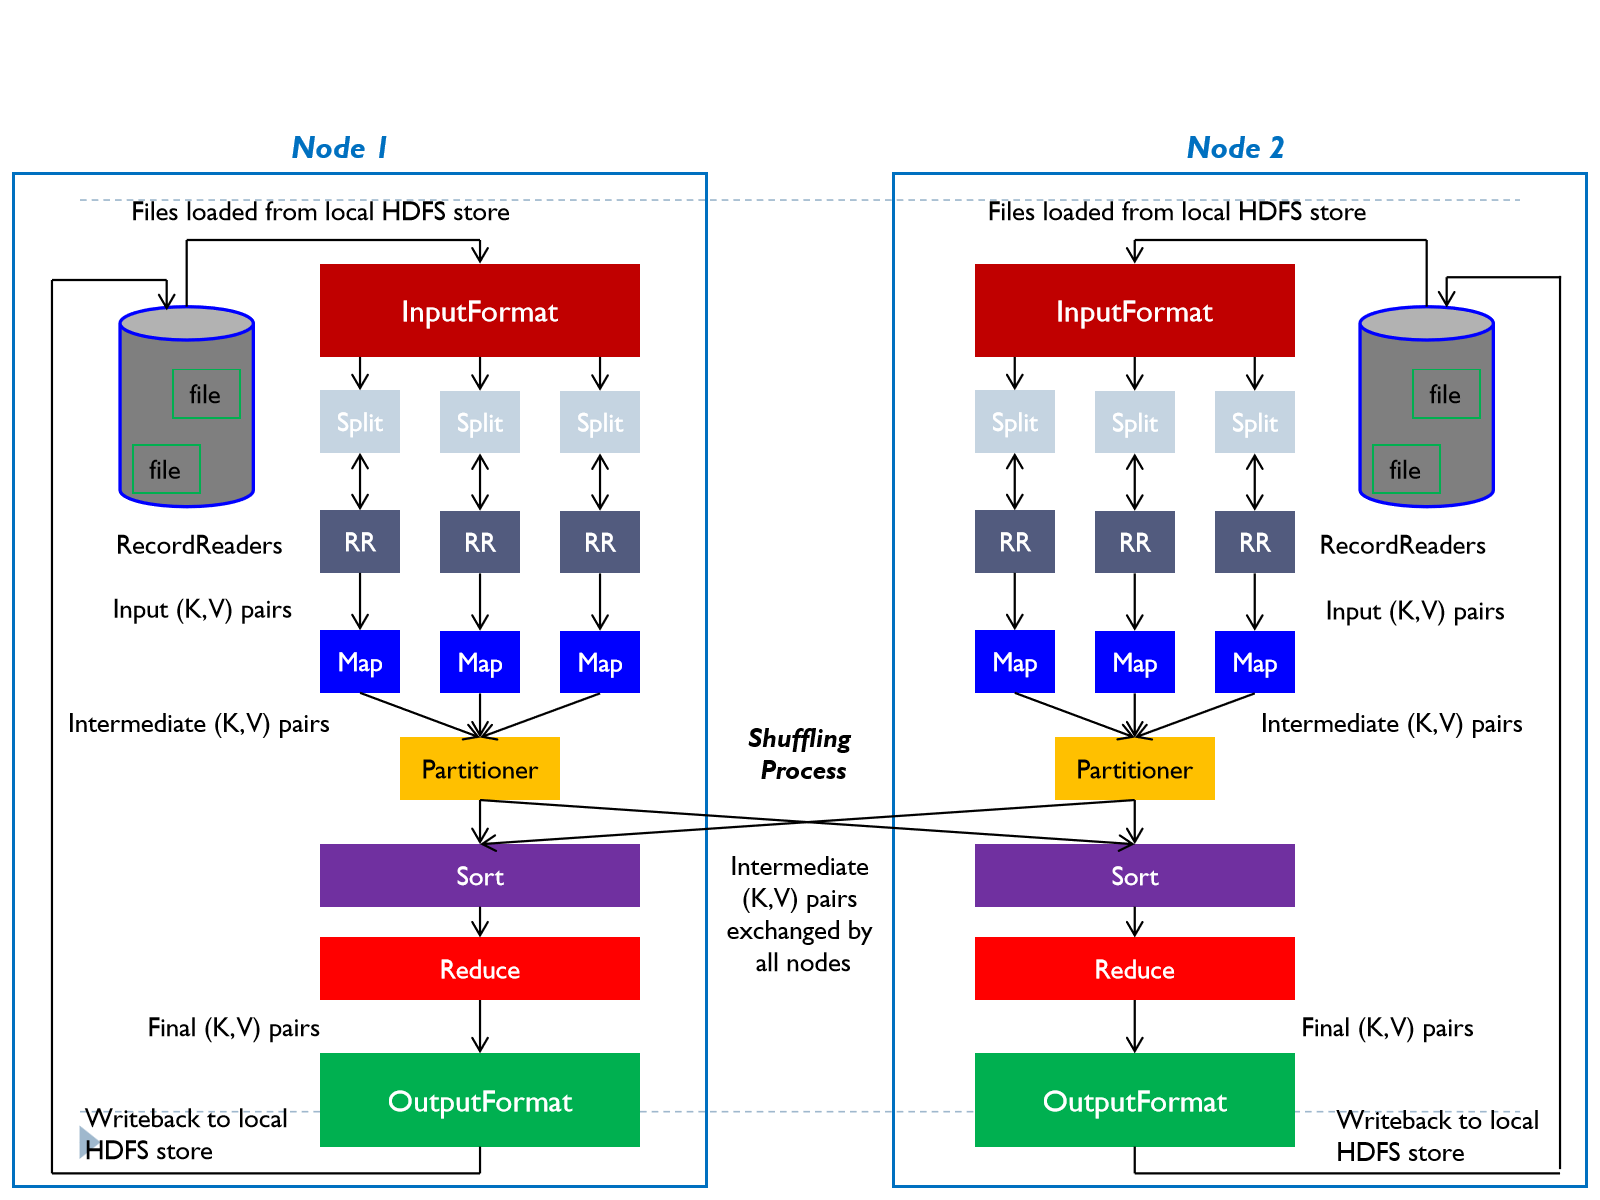
Setiap komponen pada pipeline ini dijelaskan berikut.
InputFormat, InputSplit, dan RecordReader
InputFormat adalah kelas yang menentukan bagaimana input file dibagi dan dibaca. Tugasnya:
- Memilih file yang akan digunakan sebagai input
- Mendefinisikan InputSplit yang memecah file
- Menyediakan factory objek RecordReader untuk membaca file
Jenis InputFormat yang tersedia secara default pada Hadoop:
| InputFormat | Description | Key | Value |
|---|---|---|---|
| TextInputFormat | Default format; membaca baris dari text file | Byte offset dari baris | Isi baris |
| KeyValueInputFormat | Mem-parse baris menjadi pasangan (K,V) | Semua karakter sebelum karakter tab pertama | Sisa dari baris tersebut |
| SequenceFileInputFormat | Format binary berperforma tinggi khas Hadoop | User-defined | User-defined |
Input Split mendefinisikan unit of work yang membentuk sebuah task map. Secara default, InputFormat memecah file menjadi ukuran 64MB (pada implementasi modern default dfs.blocksize adalah 128MB, lihat bagian internal). Dengan membagi file menjadi split, beberapa task map dapat beroperasi terhadap file yang sama secara paralel — setiap map berkorespondensi dengan sebuah split.
Input split hanya mendefinisikan potongan pekerjaan, belum mendefinisikan cara pembacaannya. Kelas RecordReader membaca data dari sumber dan mengubahnya menjadi format (K,V) untuk diolah oleh mapper. RecordReader dipanggil berulang pada input hingga keseluruhan split selesai diproses, dan setiap invokasi RecordReader akan memanggil fungsi map.
Mapper dan Reducer
- Mapper melakukan task untuk fase pertama MapReduce. Sebuah instance mapper dibuat untuk setiap split.
- Reducer melakukan task untuk fase kedua. Sebuah instance reducer dibuat untuk setiap partisi. Untuk setiap key yang ada pada sebuah partisi, fungsi reducer dipanggil sekali.
Partitioner
Setiap mapper mungkin mengirimkan (K,V) ke sebarang partisi, sehingga semua node map harus sepakat kemana data tertentu harus disimpan. Kelas Partitioner menentukan partisi mana yang harus menerima sebuah (K,V). Partitioner default menghitung nilai hash dari sebuah key dan melempar ke partisi yang sesuai (implementasi default: HashPartitioner).
Sort
Setiap reducer bertanggung jawab untuk mereduksi nilai-nilai yang berasosiasi dengan sekumpulan key tertentu. Kumpulan intermediate key yang berada pada sebuah node akan otomatis ter-sort oleh MapReduce sebelum diberikan ke reducer — inilah alasan reducer menerima value-nya dalam kelompok per-key yang sudah terurut.
OutputFormat
Kelas OutputFormat mendefinisikan bagaimana hasil (K,V) yang dikeluarkan Reducer disimpan ke file. Instans OutputFormat menulis file ke local disk atau HDFS. Format yang tersedia:
| OutputFormat | Description |
|---|---|
| TextOutputFormat | Default; menulis baris dalam format “key \t value” |
| SequenceFileOutputFormat | Menulis file binary yang cocok dibaca kembali oleh job MapReduce berikutnya |
| NullOutputFormat | Tidak menghasilkan file output |
Combiner
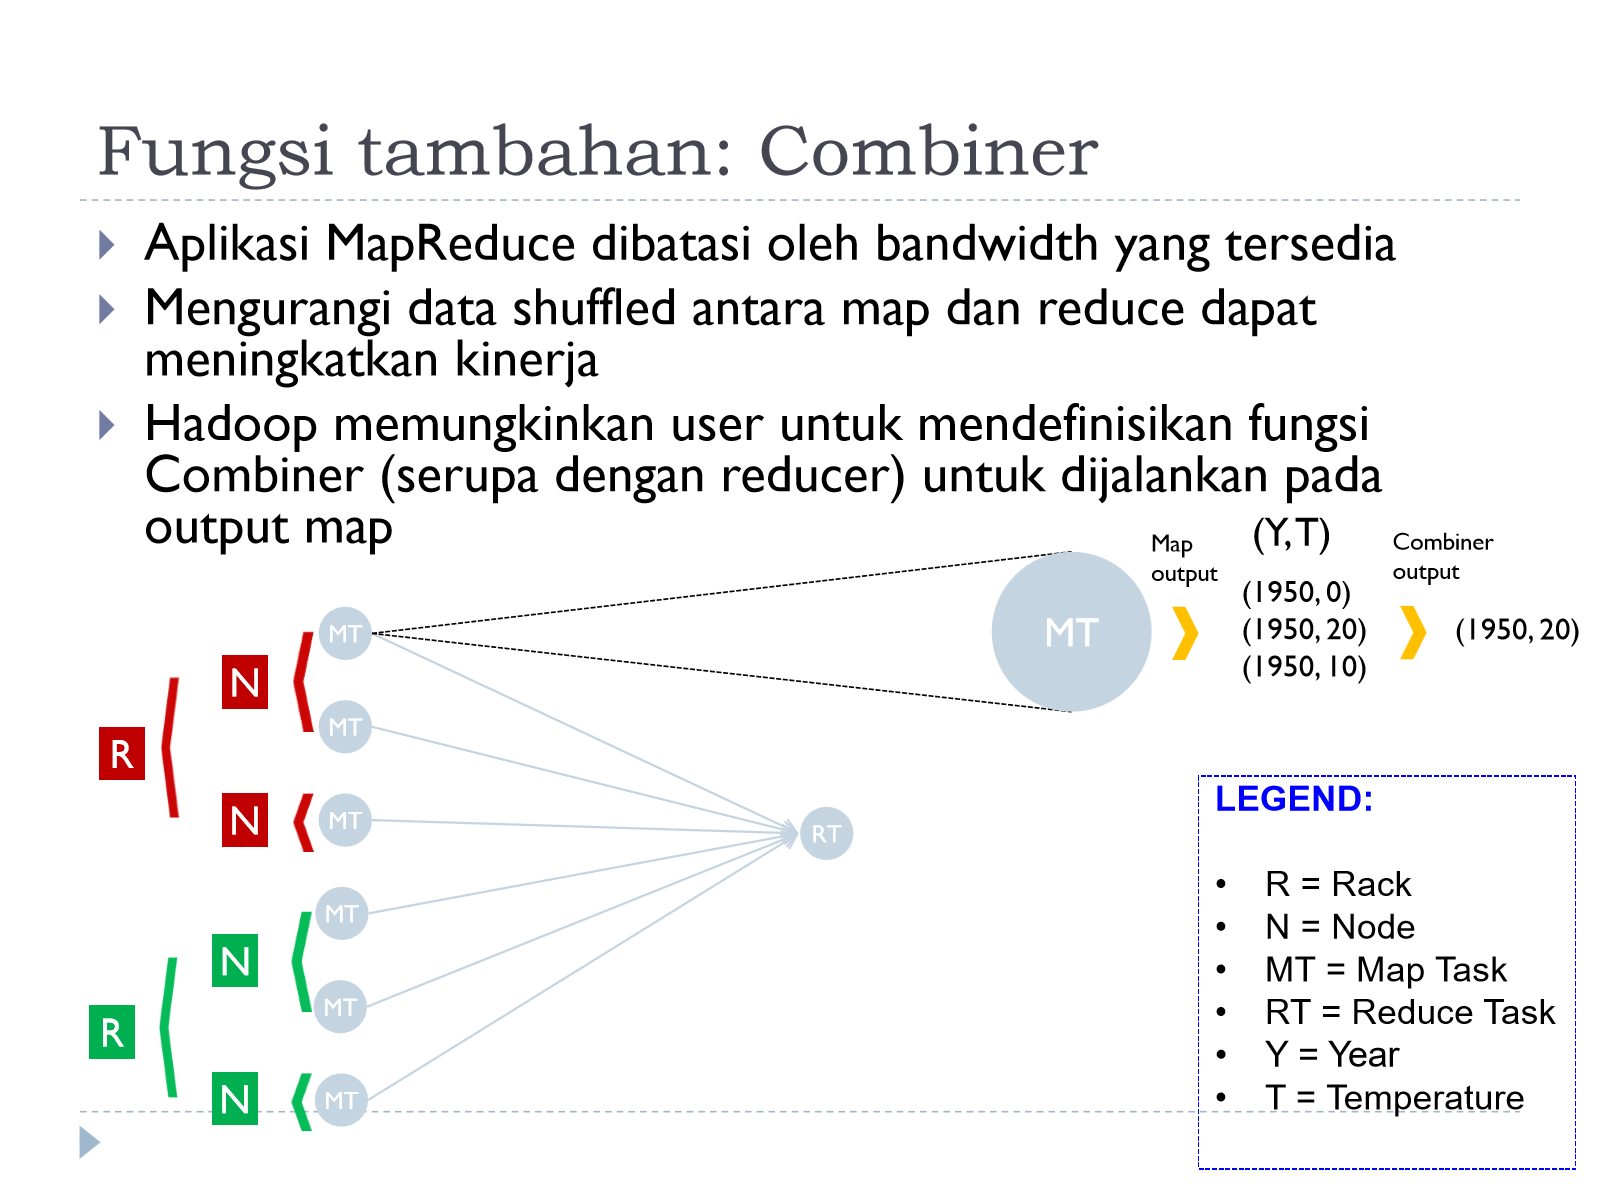
Aplikasi MapReduce dibatasi oleh bandwidth yang tersedia. Mengurangi data yang di-shuffle antara map dan reduce dapat meningkatkan kinerja secara signifikan. Untuk itu, Hadoop memungkinkan user mendefinisikan fungsi Combiner (serupa dengan reducer) yang dijalankan langsung pada output map, sebelum data dikirim melalui jaringan ke reducer.
Contoh: pada kasus menghitung temperatur maksimum per tahun, sebuah map task menghasilkan (1950,0), (1950,20), (1950,10) — combiner dapat langsung meringkasnya menjadi (1950,20) sebelum dikirim ke reduce task, sehingga data yang melewati jaringan jauh lebih sedikit.
Arsitektur & Penjadwalan Task (Model Klasik: JobTracker/TaskTracker)
MapReduce versi klasik mengadopsi arsitektur Master-Slave:
- Master node disebut JobTracker (JT)
- Slave node disebut Task Tracker (TT)
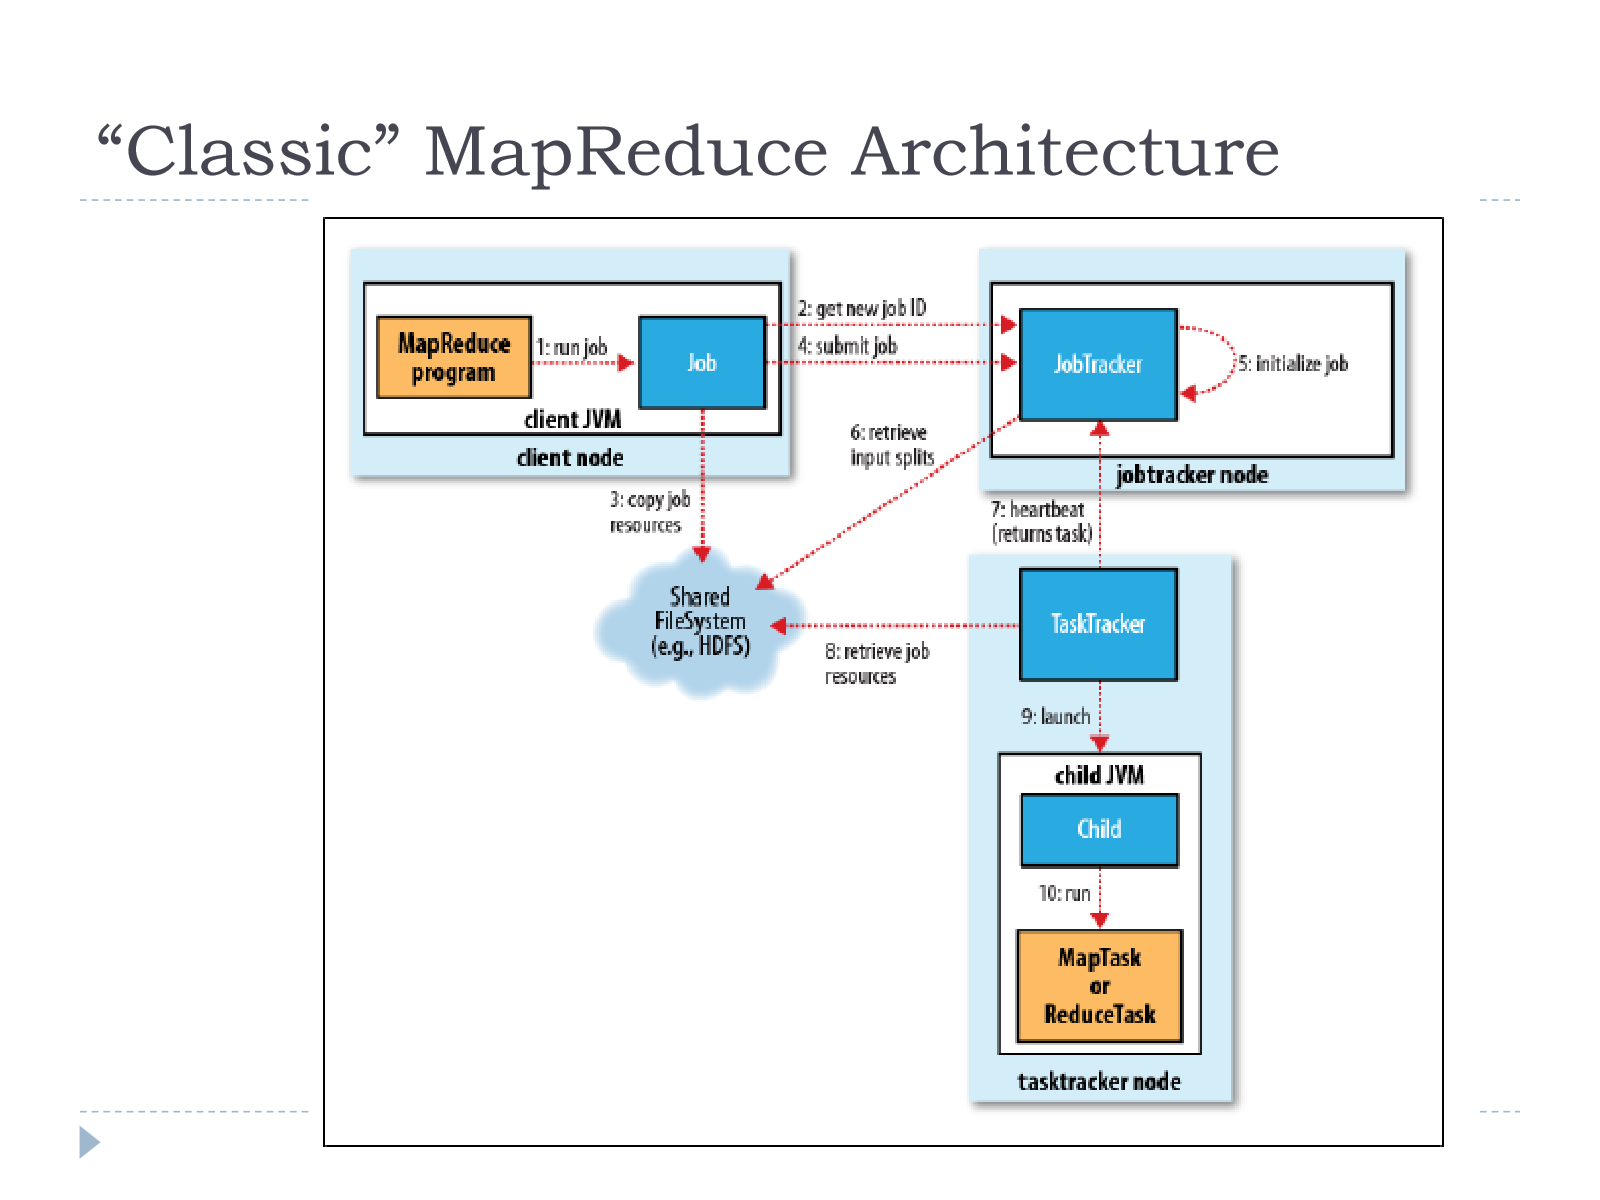
MapReduce menggunakan strategi pull: TT yang menarik (pull) job dari JT, bukan JT yang mendorong (push) job ke TT. Setiap TT mengirim pesan heartbeat periodik ke JT untuk meminta task map atau reduce yang bisa dijalankan.
- Map Task Scheduling: JT memenuhi permintaan task map dengan mencoba menjadwalkan mapper yang dekat dengan lokasi input split (data locality)
- Reduce Task Scheduling: JT langsung melempar task reduce ke node yang meminta, tanpa memperhitungkan kedekatan (karena reducer perlu mengambil data dari banyak mapper yang tersebar, sehingga locality terhadap satu lokasi data tidak relevan)
Alur arsitektur klasik MapReduce (client mengirim job → JobTracker menginisialisasi job → TaskTracker melakukan heartbeat dan mengambil task → menjalankan MapTask/ReduceTask pada child JVM):
Job Scheduling
Pada MapReduce, aplikasi direpresentasikan sebagai job, yang terdiri atas beberapa task map dan reduce. Hadoop MapReduce menyediakan beberapa pilihan scheduler pada level job:
- FIFO scheduler (default): menjadwalkan job sesuai urutan kedatangan
- Fair scheduler: scheduler multi-user yang menjadwalkan setiap user mendapat bagian yang adil (fair) dari kapasitas cluster
Arsitektur Modern: MapReduce di atas YARN
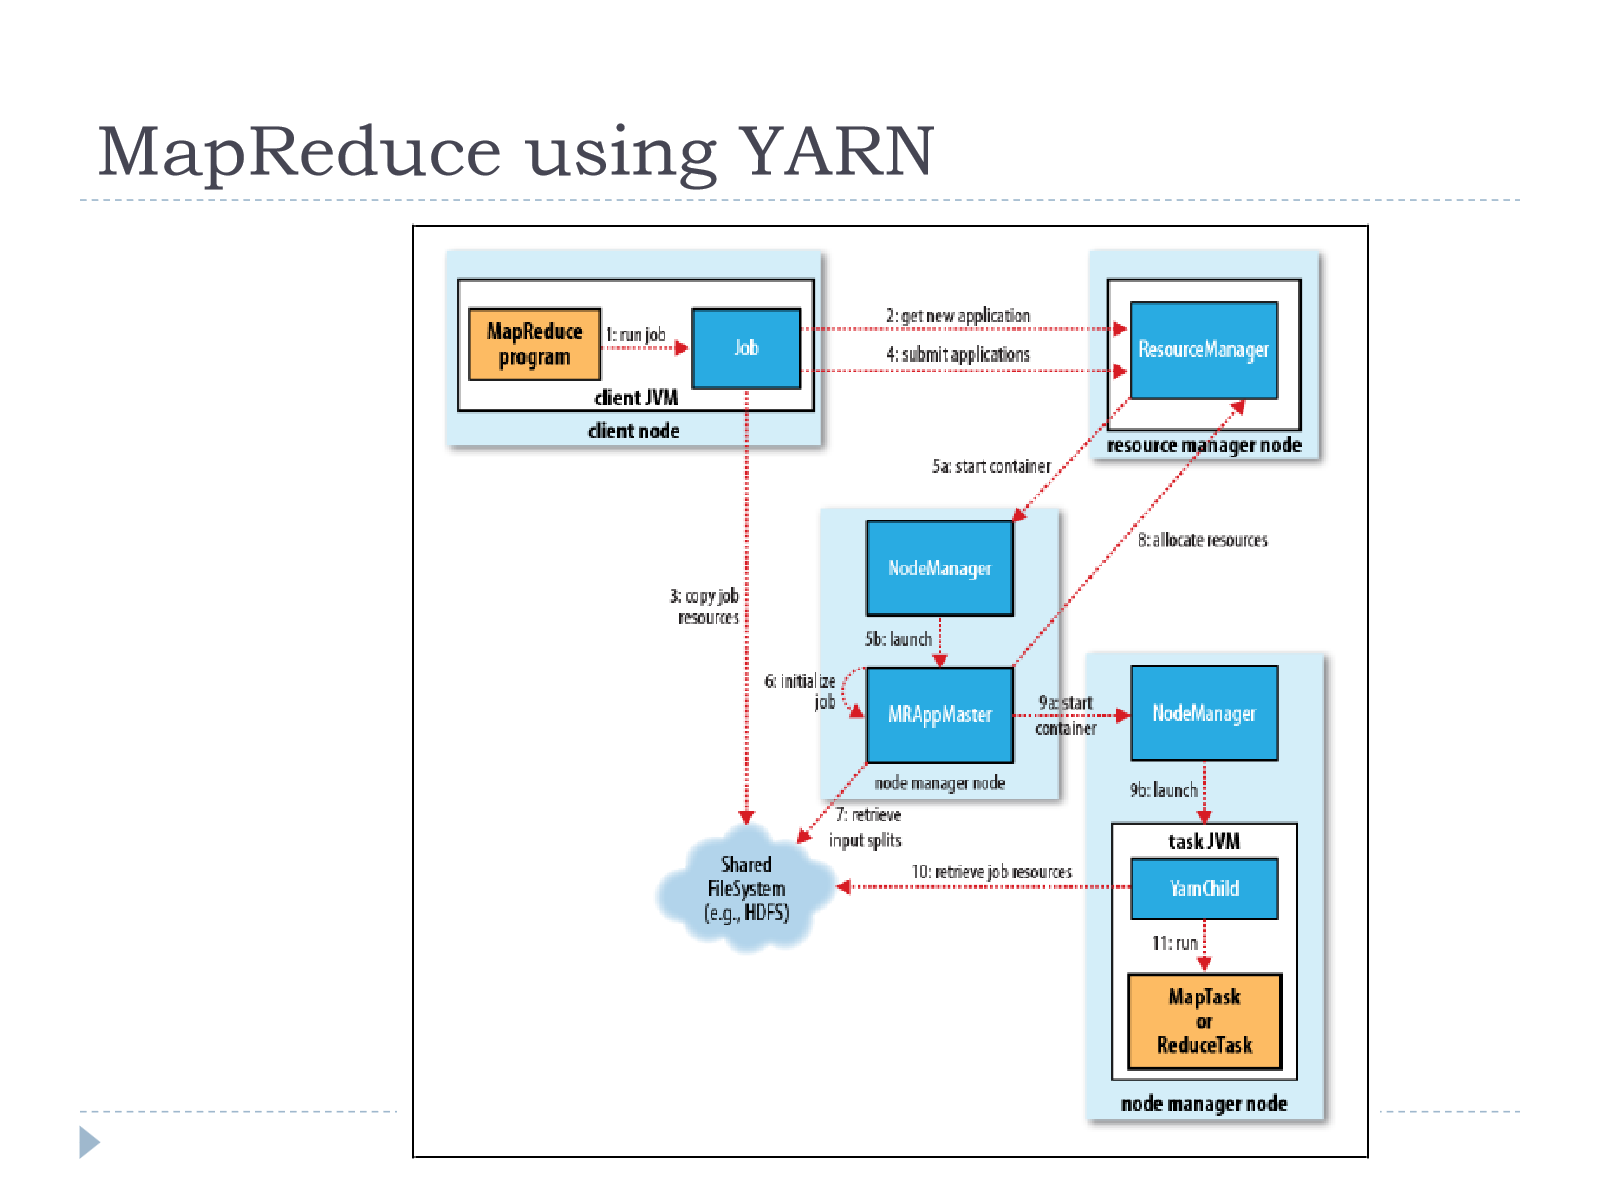
Arsitektur klasik JobTracker/TaskTracker digantikan oleh YARN (Yet Another Resource Negotiator) pada Hadoop versi modern. Alurnya: client mengirim job → ResourceManager membuat aplikasi baru → NodeManager menjalankan container untuk MRAppMaster (application master khusus MapReduce) → MRAppMaster meminta resource tambahan ke ResourceManager → NodeManager lain menjalankan container berisi YarnChild yang menjalankan MapTask atau ReduceTask.
Fault Tolerance pada MapReduce
MapReduce dirancang agar job dapat memandu dirinya sendiri untuk selesai meskipun dijalankan pada cluster besar yang memiliki kemungkinan kegagalan node lebih besar. Cara MapReduce menyediakan fault tolerance adalah dengan menjalankan ulang (re-execute) task, bukan dengan mekanisme checkpoint/recovery yang rumit:
- Jika sebuah TT gagal berkomunikasi dengan JT untuk periode waktu tertentu (default 1 menit pada Hadoop), JT akan menganggap TT tersebut crashed
- Jika job masih berada pada map phase, JT meminta TT lain untuk menjalankan ulang semua Mapper yang sebelumnya berjalan pada TT yang crash
- Jika job berada pada reduce phase, JT meminta TT lain untuk menjalankan ulang semua Reducer yang sedang in-progress pada TT yang crash
Pendekatan ini bekerja karena setiap task didesain independen dan idempotent terhadap input split/partisinya masing-masing, sehingga mengulang eksekusi task yang gagal aman dilakukan tanpa mempengaruhi task lain.
Speculative Execution
Sebuah job MapReduce didominasi oleh task yang paling lambat (straggler) — total waktu job baru selesai setelah task terlambat itu selesai. Untuk mengatasi hal ini, MapReduce berusaha menentukan slow tasks (stragglers) dan menjalankan redundant (speculative) task pada node lain, dengan harapan salah satu copy tersebut akan commit lebih dulu. Proses ini disebut speculative execution.
Aturannya:
- Hanya 1 copy dari sebuah straggler yang boleh dispekulasikan
- Copy mana pun (di antara kedua copy) yang commit lebih dulu akan menjadi copy definitif, dan copy lainnya akan di-kill oleh JT
Mendeteksi Straggler
Hadoop memonitor progres setiap task menggunakan nilai progres antara 0 dan 1. Jika nilai progres sebuah task kurang dari (rata-rata − 0.2), dan task tersebut sudah berjalan paling tidak 1 menit, task tersebut ditandai sebagai straggler.
Contoh: task T1 dengan progres 2/3 (mendekati rata-rata) dianggap normal, sedangkan task T2 dengan progres hanya 1/12 pada waktu yang sama ditandai sebagai straggler.
Contoh Aplikasi MapReduce
Word Count
Kasus klasik: menghitung frekuensi kemunculan setiap kata pada kumpulan dokumen. Input berupa pasangan (url, contents).
map(key=url, val=contents):
    For each word w in contents, emit (w, "1")

reduce(key=word, values=uniq_counts):
    Sum all "1"s in values list
    Emit result "(word, sum)"
Ilustrasi untuk dokumen berisi “see bob throw” dan “see spot run”:
Input:                  Map output:        Reduce output (setelah sort & group by key):
see bob throw           see   1            bob    1
see spot run            bob   1            run    1
                         run   1            see    2   (key='see', values=[1,1])
                         see   1            spot   1
                         spot  1            throw  1
                         throw 1

key = 'see',  values = [1, 1]
key = 'bob',  values = [1]
Grep
Mencari baris yang cocok dengan sebuah regular expression. Input berupa (url+offset, single line).
map(key=url+offset, val=line):
    If contents matches regexp, emit (line, "1")

reduce(key=line, values=uniq_counts):
    Don't do anything; just emit line
Menariknya, pada kasus Grep, reducer tidak melakukan agregasi apa pun — ia hanya meneruskan (emit) baris yang sudah lolos filter di fase map. Ini menunjukkan bahwa fase reduce bersifat opsional secara logika (meski secara arsitektur tetap dijalankan).
Reverse Web-Link Graph
Membalik arah graf tautan web: dari “halaman X menuju ke mana saja” menjadi “halaman mana saja yang menuju ke X”.
Map:
    For each URL linking to target, ...
    Output <target, source> pairs

Reduce:
    Concatenate list of all source URLs
    Outputs: <target, list(source)> pairs
Bagian Internal: Arsitektur Hadoop
Bagian ini membahas detail internal implementasi Hadoop, bersumber dari http://ercoppa.github.io/HadoopInternals/. Secara garis besar, arsitektur Hadoop modern terdiri atas 4 lapisan yang berjalan di atas Cluster (kumpulan node/hardware):
- MapReduce Framework (lapisan teratas): framework implementasi model MapReduce, berjalan di atas YARN dan HDFS
- YARN Infrastructure: framework untuk resource management (CPU, memori, dsb) pada cluster
- HDFS Federation: framework untuk distributed storage
- Storage (S3, dsb.): alternatif penyimpanan lain yang perannya serupa dengan HDFS, berdampingan dengan YARN Infrastructure dan HDFS Federation
- Cluster (lapisan dasar): kumpulan node/hardware fisik
Susunan lapisan ini menegaskan bahwa MapReduce Framework tidak berdiri sendiri — ia bergantung pada YARN untuk resource management dan pada HDFS (atau storage lain seperti S3) untuk penyimpanan data terdistribusi.
YARN: Yet Another Resource Negotiator
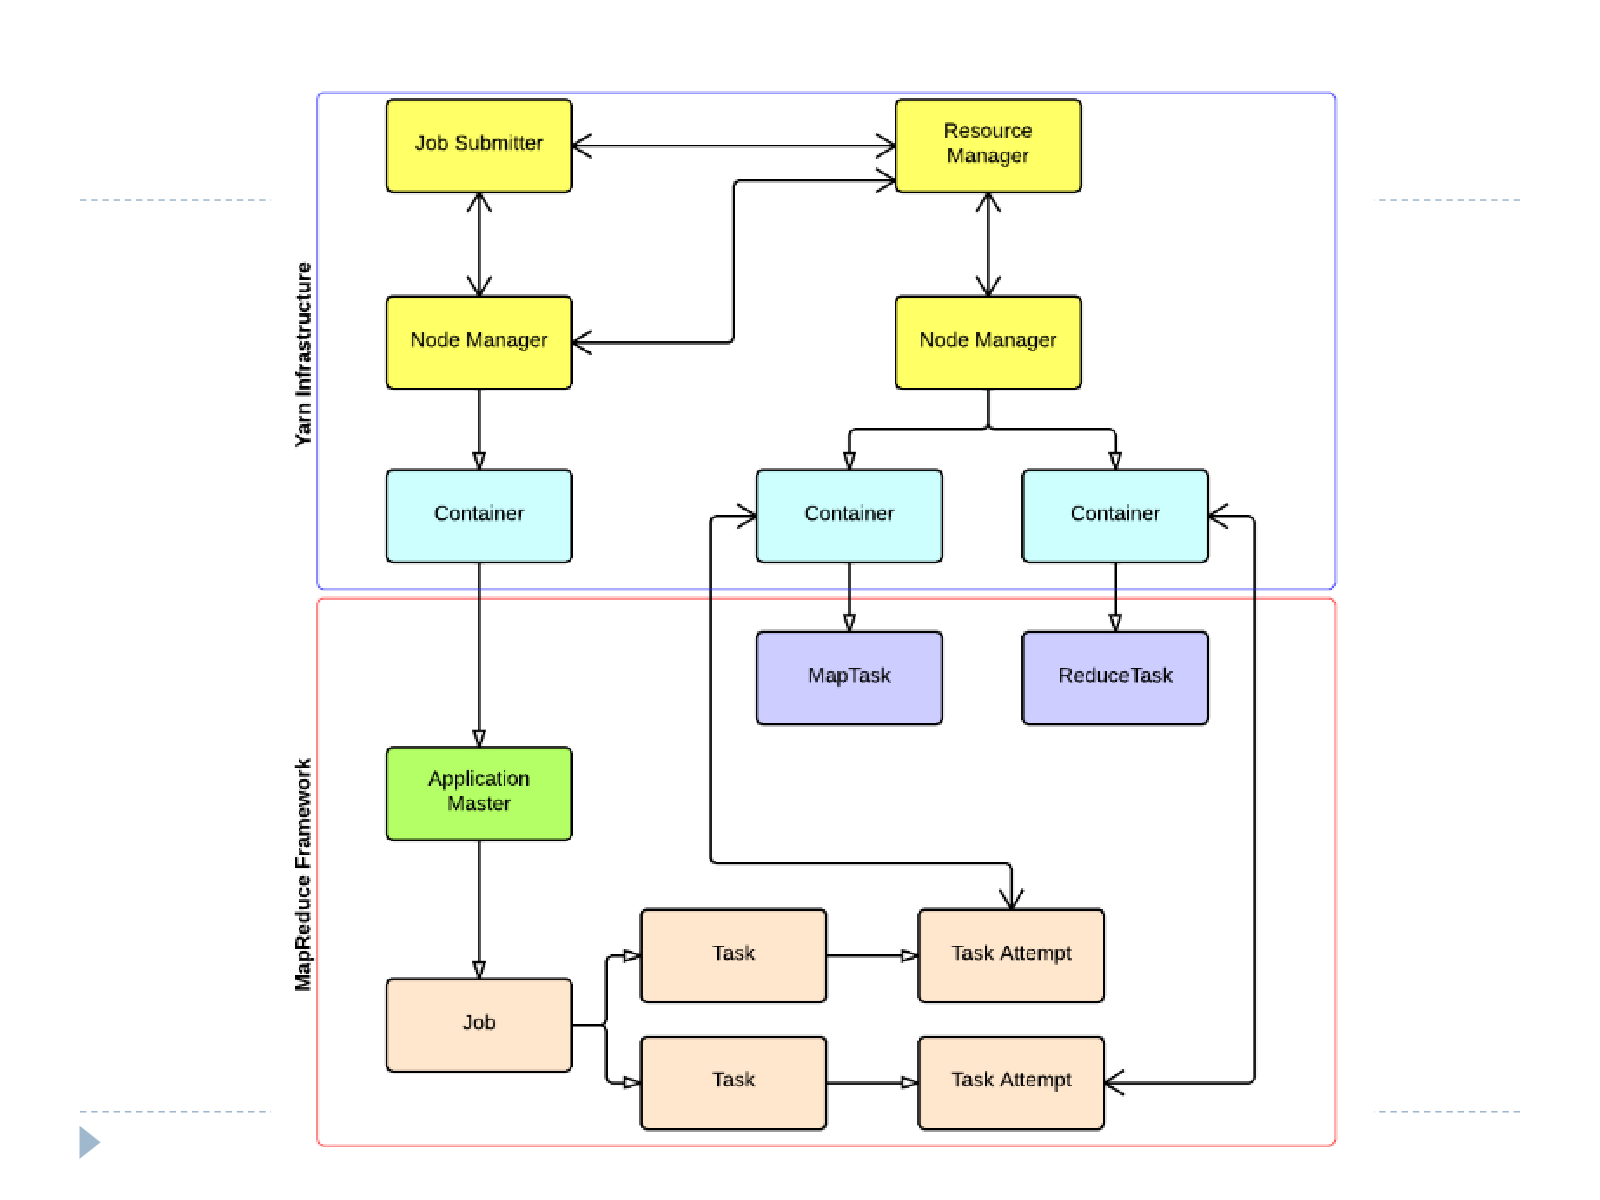
YARN menangani infrastruktur komputasi (CPU, memori, dsb) untuk cluster. Komponennya:
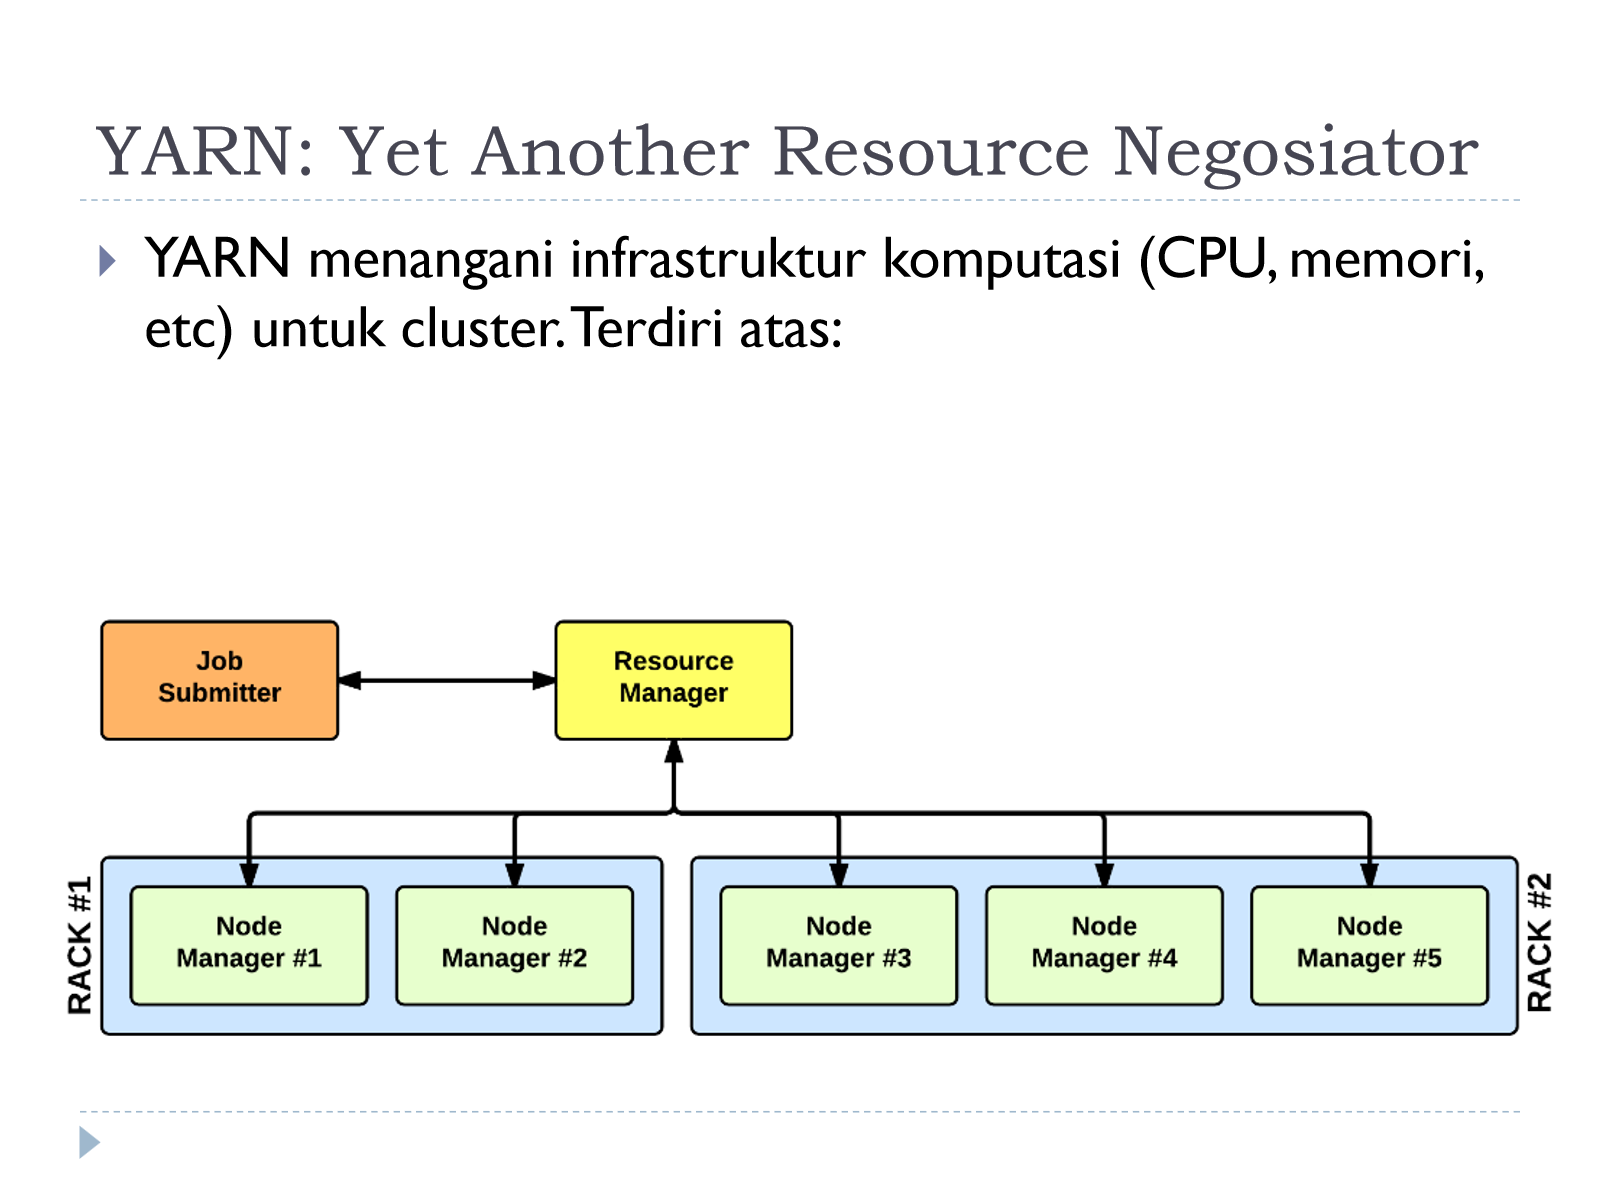
- Job Submitter: client yang mengirimkan job
- Resource Manager (RM): master yang mengelola infrastruktur — mengetahui lokasi semua node dan resource yang dimiliki tiap node. RM menjalankan beberapa service: Resource Scheduler, Application Master Liveness Monitor, Node Manager Liveness Monitor, dan beberapa event handler lain
- Node Manager (NM): slave yang mengelola sebuah node. Saat dijalankan, NM mengumumkan diri ke RM, dan secara periodik mengirim heartbeat ke RM menginfokan kapasitas yang dimilikinya (jumlah vcore dan memori)
- Container: berjalan pada sebuah node, menggunakan sejumlah resource (vcore dan memori). Jumlah container yang bisa berjalan pada satu node dihitung sebagai:
#container = yarn.nodemanager.resource.memory-mb / yarn.scheduler.minimum-allocation-mb
Alur setup aplikasi pada YARN:
- Client mengirimkan job ke RM
- RM mengalokasikan container (melalui Resource Scheduler)
- RM menghubungi NM
- NM menjalankan container
- Container menjalankan Application Master (AM)
Application Master bertanggung jawab menjalankan aplikasi. AM meminta RM sejumlah container yang diperlukan untuk menjalankan aplikasi, lalu menjalankan program tertentu (misalnya main class dari aplikasi) pada container yang didapatkan.
Anatomi Job MapReduce (Internal)
Timeline eksekusi sebuah job MR terdiri atas Map Phase (menjalankan beberapa Map Task) diikuti Reduce Phase (menjalankan beberapa Reduce Task, yang sebagian bisa overlap/mulai lebih awal sebelum map phase benar-benar selesai). Yang menjadi “sutradara” (director) proses ini adalah MRAppMaster.
Sebuah job yang diberikan user terdiri atas:
- Konfigurasi: jika tidak disebutkan, menggunakan konfigurasi default
- jar yang berisi implementasi
map(),combine(), danreduce() - Informasi input dan output: direktori input (dari HDFS, S3, atau lainnya, berapa banyak file) dan direktori output (ke HDFS, S3, atau lainnya)
Perhitungan Jumlah Split (Map Phase)
1 Map Task dijalankan untuk setiap input split. Jumlah split dihitung dengan pseudocode berikut:
num_split = 0
for each input file f:
    remaining = f.length
    while remaining / split_size > split_slope:
        num_splits += 1
        remaining -= split_size

where:
    split_slope = 1.1
    split_size = dfs.blocksize
Perhatikan bahwa ukuran split (split_size) mengikuti dfs.blocksize — yaitu ukuran block pada HDFS (default 128MB) — inilah wujud konkret keterkaitan MapReduce dengan HDFS: unit kerja map task selaras dengan unit penyimpanan block HDFS.
Data Locality pada Penjadwalan Map Task
MRAppMaster meminta container yang diperlukan oleh semua Map Task (sejumlah num_splits). Container yang diminta untuk menjalankan Map Task berusaha memenuhi data locality dengan urutan prioritas:
- Sebuah node tempat input split disimpan (locality penuh)
- Jika tidak tersedia, node yang berada pada rack yang sama
- Jika tidak tersedia juga, node mana pun (any node)
Prinsip inilah yang dikenal sebagai “memindahkan komputasi ke data, bukan memindahkan data ke komputasi” — karena memindahkan program (berukuran kecil) jauh lebih murah dibanding memindahkan data (berukuran besar, hingga TB/PB) melalui jaringan. Setelah container dialokasikan, MapTask dijalankan.
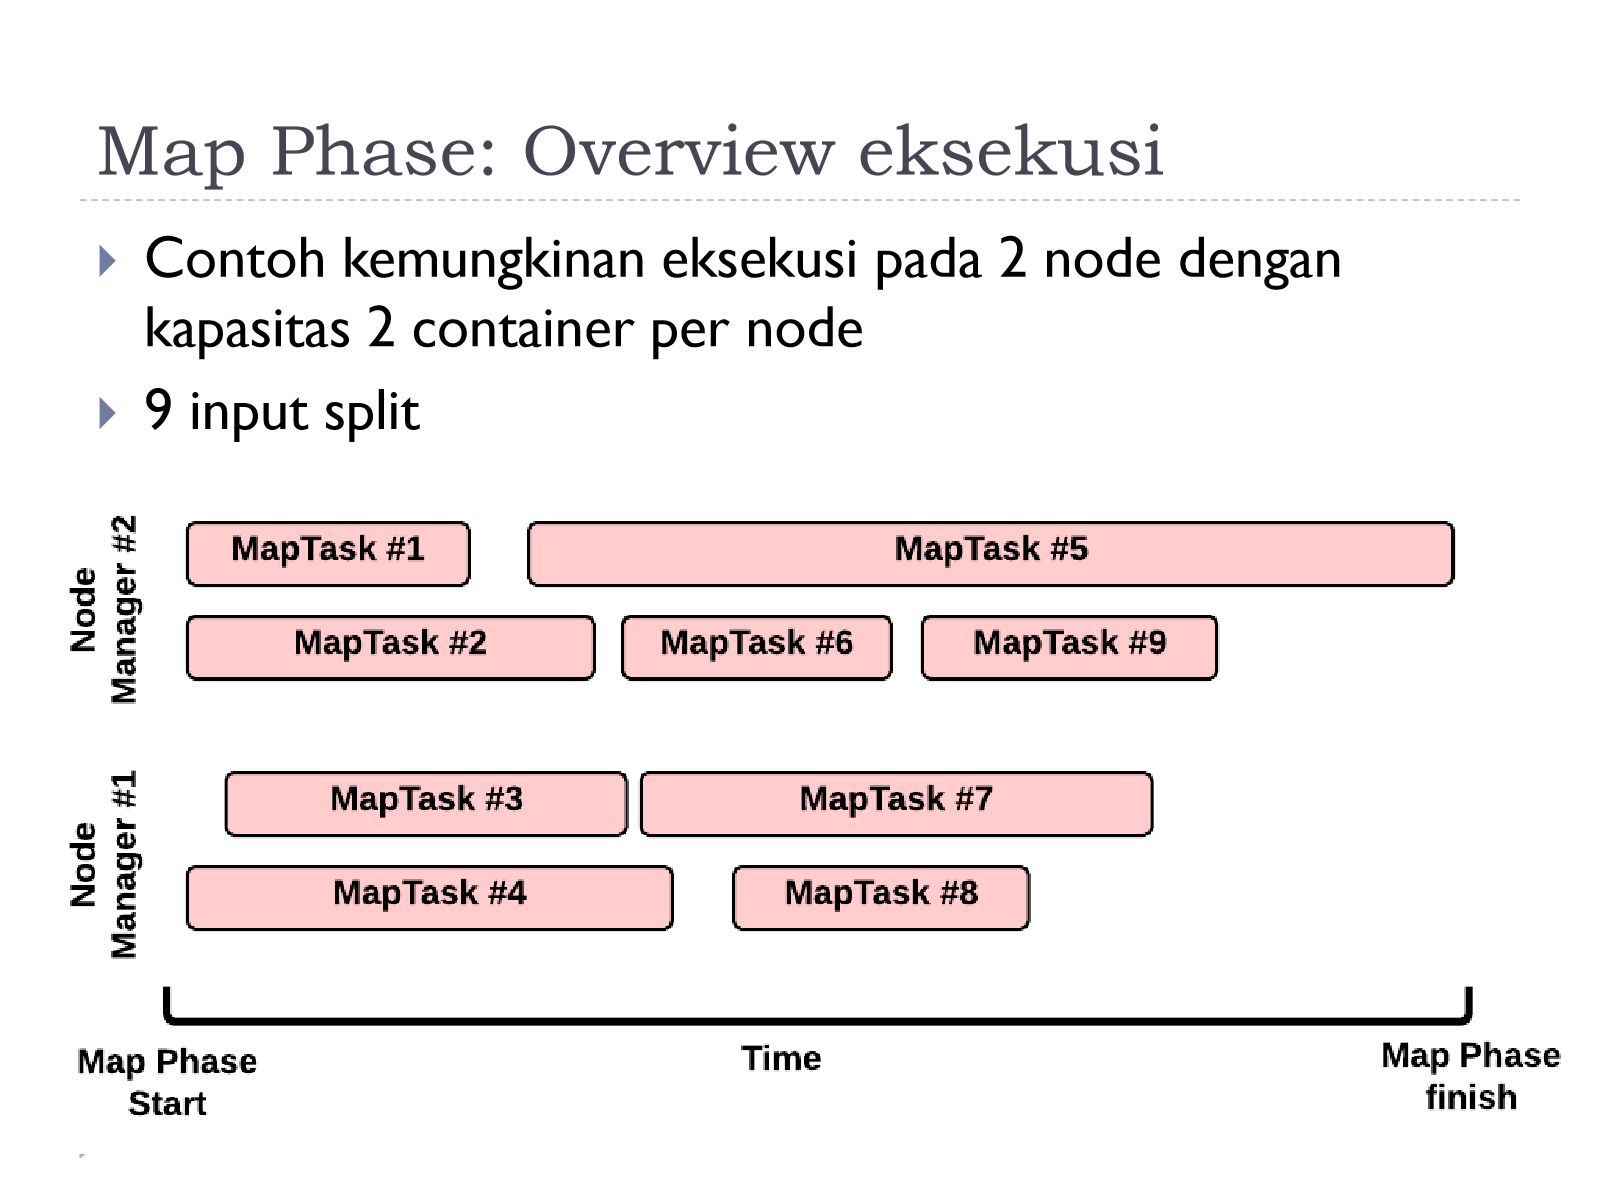
Contoh eksekusi Map Phase pada 2 node dengan kapasitas 2 container per node, memproses 9 input split:
Timeline Internal MapTask
Sebuah MapTask memiliki timeline eksekusi: INIT → EXECUTION (di dalamnya ada sub-fase SPILLING) → SHUFFLE.
Fase INIT melakukan:
- Membuat context (
TaskAttemptContext) - Membuat instance dari kelas Mapper
- Mensetup input (
InputFormat,InputSplit,RecordReader) dan output (NewOutputCollector) - Membuat mapper context (
MapContext,Mapper.Context) - Inisialisasi input: membuat objek
SplitLineReaderdanHdfsDataInputStream
Fase EXECUTION: Mapper.run() memanggil Mapper.setup(), lalu berulang memanggil Mapper.Context.nextKeyValue() (mengambil data dari input) dan memanggil Mapper.map(), hingga tidak ada key lagi, lalu memanggil Mapper.clean(). Fungsi Mapper.Context.write() menuliskan output ke sebuah circular buffer.
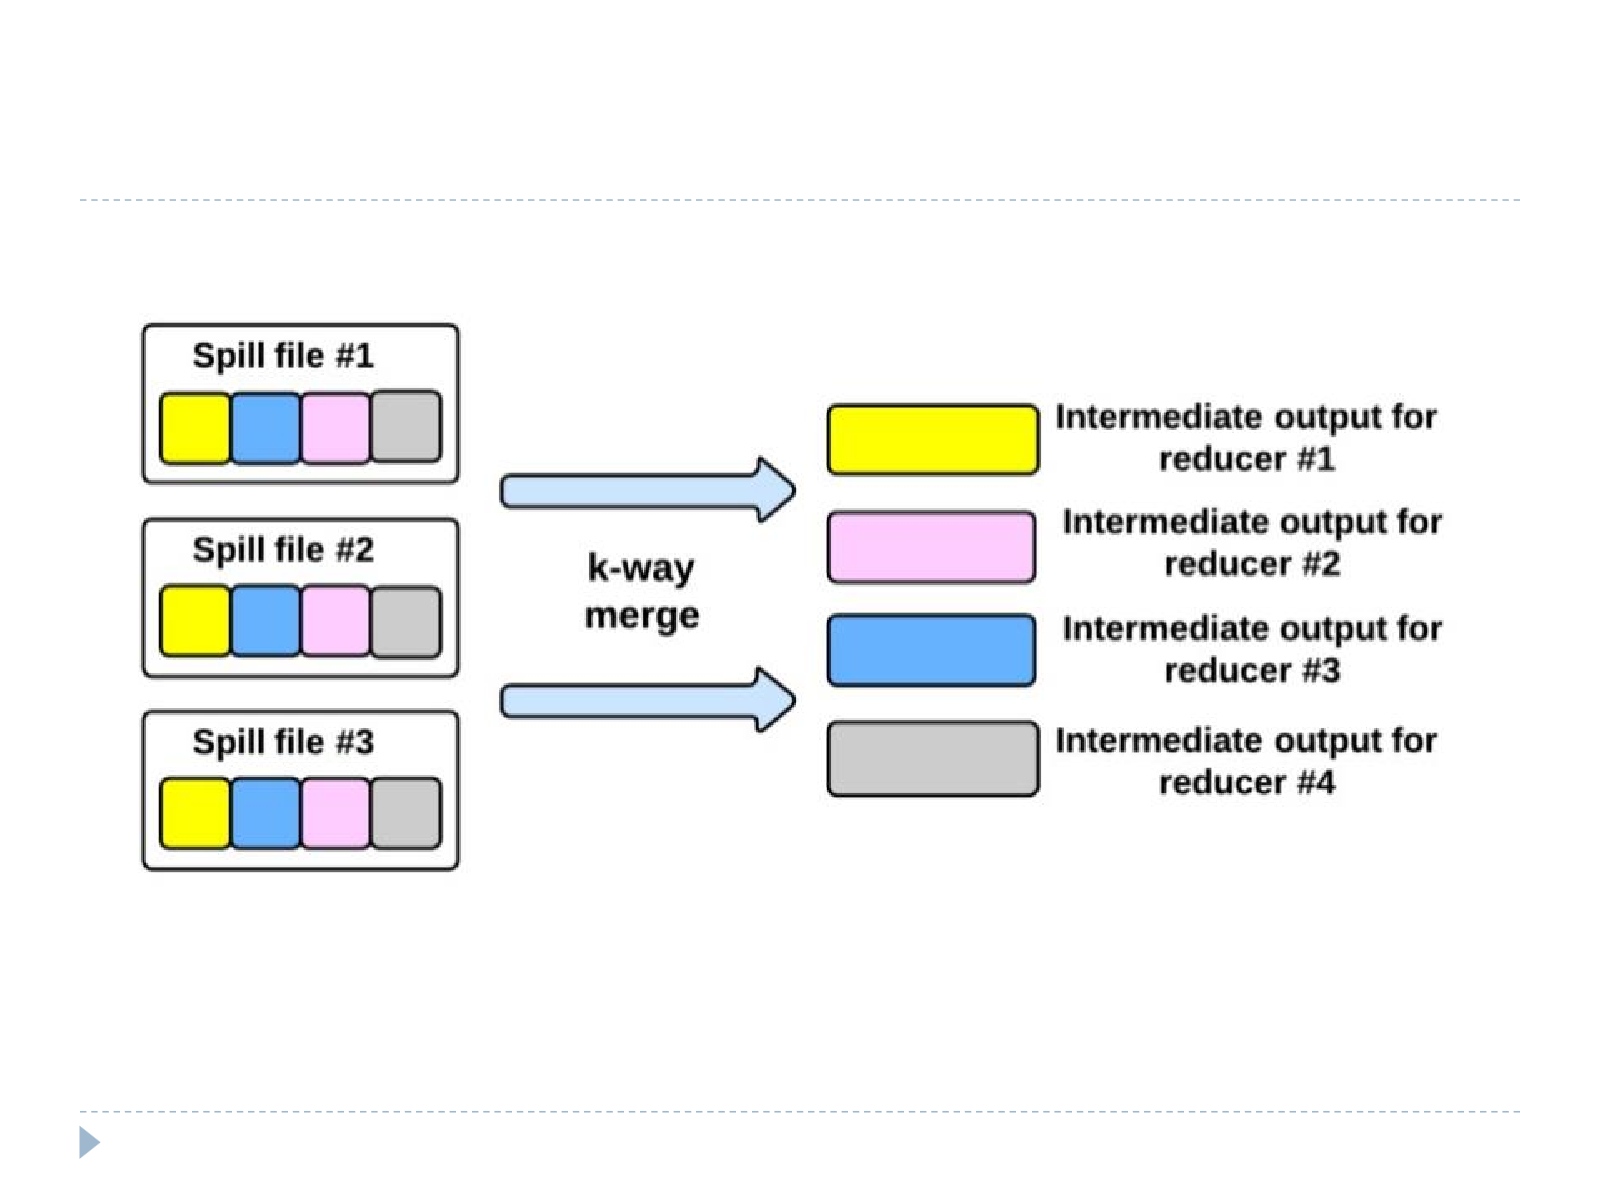
Fase SPILLING: Mapper.Context.write() menulis ke MapOutputBuffer berukuran mapreduce.task.io.sort.mb (default 100MB). Jika buffer sudah terisi sebanyak mapreduce.map.sort.spill.percent (default 80%), fase spilling dijalankan:
- Membuat
SpillRecorddanFSOutputStream - Melakukan sort in-memory pada chunk di buffer, diurutkan berdasarkan
(PartitionIdx, key) - Membagi hasil sort menjadi partisi — 1 partisi untuk setiap reducer (
mapreduce.job.reduces) - Menuliskan setiap partisi ke file (spill file)
Jika user menyediakan combiner, sebelum tuple dituliskan ke file: dibuat instance Reducer, dibuat Reducer.Context dengan output ke local filesystem, lalu reducer.run() dijalankan. Combiner umumnya menggunakan implementasi yang sama dengan fungsi reduce(), sehingga combiner juga disebut local reducer.
Di akhir eksekusi Mapper.run(), sisa tuple yang belum di-spill akan di-sort dan di-spill, lalu fase shuffle dimulai. Karena satu MapTask bisa menghasilkan beberapa spill file, spill file-spill file tersebut digabung melalui k-way merge menjadi satu intermediate output per reducer:
Reduce Phase secara Internal
Kapan Reduce Task Dijalankan
MRAppMaster menunggu hingga sebagian MapTask selesai — sebesar mapreduce.job.reduce.slowstart.completedmaps (default 5%) — sebelum mulai menjadwalkan ReduceTask secara periodik. Ketentuan tambahan:
- Reducer baru dijadwalkan sepenuhnya jika semua MapTask sudah dialokasikan container
- Saat reducer dijalankan, request container-nya tidak mempertimbangkan data locality (berbeda dengan MapTask), karena reducer memang perlu mengambil data dari banyak node mapper yang tersebar
- Request MapTask memiliki prioritas lebih tinggi dibanding request ReduceTask (Hadoop mengutamakan penyelesaian map phase)
Timeline Internal ReduceTask
Timeline eksekusi ReduceTask: INIT → SHUFFLE → EXECUTION.
Fase SHUFFLE terdiri atas 2 langkah:
- Fetch: mengambil map output dari Node Manager tempat MapTask berjalan, dilakukan secara paralel (jumlah transfer paralel diatur oleh
mapreduce.reduce.shuffle.parallelcopies, default 5). Jika ukuran output yang di-fetch kurang dari 25% memori NM, dibuat memory output; jika lebih besar, dibuat disk output. - Merge: hasil fetch (baik yang di memory maupun di disk) digabungkan melalui k-way merge. Jika ada combiner, proses combine juga dijalankan ulang saat merge. Hasil merge pada akhirnya digabung menjadi satu on-disk map output file per reducer.
Fase EXECUTION: serupa dengan Mapper, Reducer.run() memanggil Reducer.setup(), lalu berulang mengecek “has another key?” — jika ya memanggil Reducer.reduce(), jika tidak memanggil Reducer.clean().
Gambaran keseluruhan timeline job MapReduce pada 2 node (Map Phase yang tumpang tindih sebagian dengan awal Reduce Phase, sesuai slowstart.completedmaps):
Job dimulai dengan beberapa MapTask berjalan paralel pada tiap Node Manager; begitu sebagian kecil MapTask selesai, ReduceTask mulai dijadwalkan dan langsung memulai fase shuffle (fetch dari MapTask yang sudah selesai), sehingga total waktu job lebih pendek dibanding menjalankan seluruh map phase dahulu baru reduce phase.
Parameter Konfigurasi Penting
Membuat program MapReduce relatif tidak sulit, namun membuat program MapReduce yang efisien itu sulit, karena: banyaknya parameter konfigurasi (YARN: 115 parameter, MapReduce: 195 parameter, HDFS: 173 parameter, core: 145 parameter), kurangnya kontrol terhadap proses eksekusi, dan banyaknya detail implementasi yang tersembunyi dari developer. Beberapa parameter kunci yang dibahas pada slide:
| Parameter | Arti | Default |
|---|---|---|
mapreduce.framework.name | Runtime framework untuk menjalankan job MapReduce | YARN |
mapreduce.job.reduces | Jumlah reduce task | 1 |
dfs.blocksize | Ukuran block HDFS | 128MB |
yarn.resourcemanager.scheduler.class | Kelas scheduler | CapacityScheduler |
yarn.nodemanager.resource.memory-mb | Memori tersedia pada satu NM untuk container | 8192 |
yarn.scheduler.minimum-allocation-mb | Alokasi minimum untuk setiap request container | 1024 |
mapreduce.map.memory.mb | Permintaan memori untuk satu MapTask | 1024 |
mapreduce.reduce.memory.mb | Permintaan memori untuk satu ReduceTask | 1024 |
mapreduce.task.io.sort.mb | Ukuran circular buffer (map output) | 100MB |
mapreduce.map.sort.spill.percent | Batas terisinya circular buffer sebelum spilling dimulai | 0.80 |
mapreduce.job.partitioner.class | Kelas Partitioner | HashPartitioner |
mapreduce.reduce.shuffle.memory.limit.percent | Persentase maksimum in-memory limit yang bisa dipakai satu shuffle | 0.25 |
mapreduce.reduce.shuffle.input.buffer.percent | Persentase heap yang dialokasikan untuk menyimpan map output saat shuffle | 0.70 |
mapreduce.reduce.shuffle.merge.percent | Persentase penggunaan yang memicu in-memory merge | 0.66 |
mapreduce.map.combine.minspills | Minimum jumlah spill file agar combine diterapkan | 3 |
mapreduce.task.io.sort.factor | Jumlah stream yang digabung sekaligus saat sorting file | 100 |
mapreduce.job.reduce.slowstart.completedmaps | Fraksi map yang harus selesai sebelum reduce dijadwalkan | 0.05 |
mapreduce.reduce.shuffle.parallelcopies | Jumlah transfer paralel saat fase fetch/shuffle | 5 |
Gambaran Utuh Arsitektur
Diagram berikut merangkum keseluruhan hubungan antar komponen YARN Infrastructure (Job Submitter, Resource Manager, Node Manager, Container) dengan komponen MapReduce Framework (Application Master, Job, Task, Task Attempt, MapTask/ReduceTask) yang berjalan di atasnya:
Flashcard
flashcards Apa perbedaan utama antara Map Phase dan Reduce Phase pada MapReduce? :: Map Phase memproses chunk data secara terisolasi menghasilkan Intermediate Output (K’,V’); Reduce Phase mengumpulkan/mengelompokkan IO berdasarkan key (via shuffling) lalu menghasilkan Final Output (K”,V”) Apa fungsi Partitioner pada MapReduce, dan apa strategi default-nya? :: Partitioner menentukan partisi mana yang menerima sebuah pasangan (K,V) intermediate output; strategi default (HashPartitioner) menghitung nilai hash dari key lalu melemparnya ke partisi yang sesuai Mengapa MapReduce mengurutkan (sort) intermediate key sebelum masuk ke Reducer? :: Karena setiap reducer harus mereduksi semua value yang berasosiasi dengan sekumpulan key tertentu secara berkelompok; sorting membuat value dengan key sama berada berurutan sehingga bisa diproses per-grup oleh reduce() Apa itu Combiner dan mengapa disebut sebagai “local reducer”? :: Combiner adalah fungsi (mirip reducer) yang dijalankan langsung pada output map sebelum dikirim ke reducer, untuk mengurangi volume data yang di-shuffle lewat jaringan; disebut local reducer karena umumnya menggunakan implementasi yang sama dengan fungsi reduce() dan berjalan lokal pada node mapper Bagaimana cara MapReduce (arsitektur klasik JobTracker/TaskTracker) menyediakan fault tolerance? :: Dengan menjalankan ulang (re-execute) task pada TaskTracker lain jika sebuah TaskTracker gagal mengirim heartbeat selama periode tertentu (default 1 menit) — semua Mapper pada TT yang crash diulang jika masih map phase, atau semua Reducer in-progress diulang jika sudah reduce phase Apa itu Speculative Execution dan bagaimana Hadoop mendeteksi straggler? :: Speculative execution adalah menjalankan copy redundant dari task yang lambat (straggler) di node lain agar salah satu copy selesai lebih cepat; straggler dideteksi jika nilai progres suatu task kurang dari (rata-rata progres − 0.2) dan task sudah berjalan minimal 1 menit Apa perbedaan penjadwalan Map Task dan Reduce Task terkait data locality? :: Map Task dijadwalkan dengan mengutamakan node yang menyimpan input split-nya (data locality: node lokal, lalu rack sama, lalu node mana pun); Reduce Task langsung dijalankan pada node yang meminta tanpa mempertimbangkan kedekatan data, karena reducer harus mengambil data dari banyak mapper yang tersebar Bagaimana jumlah input split dihitung, dan apa hubungannya dengan HDFS block? :: Jumlah split dihitung dengan membagi ukuran file dengan split_size (=dfs.blocksize, default 128MB), berhenti saat sisa file dibagi split_size sudah di bawah split_slope (1.1); karena split_size mengikuti ukuran block HDFS, unit kerja MapTask selaras dengan unit penyimpanan HDFS sehingga mendukung data locality Apa peran Resource Manager, Node Manager, dan Application Master pada YARN? :: Resource Manager adalah master yang mengelola seluruh infrastruktur cluster dan menjalankan scheduler; Node Manager adalah slave yang mengelola resource pada satu node dan mengirim heartbeat kapasitas ke RM; Application Master bertanggung jawab menjalankan satu aplikasi tertentu dengan meminta container ke RM lalu menjalankan program aplikasi pada container tersebut Terdiri atas 2 tahap apa saja proses shuffle pada Reduce Task, dan kapan output disimpan di memory vs disk? :: Shuffle terdiri atas fetch (mengambil map output dari Node Manager secara paralel) dan merge (menggabungkan hasil fetch via k-way merge); jika ukuran output yang di-fetch kurang dari 25% memori NM disimpan sebagai memory output, jika lebih besar disimpan sebagai disk output