Materi ini membahas Apache Spark, sebuah framework distributed data processing yang muncul sebagai jawaban atas keterbatasan model MapReduce/Hadoop untuk beban kerja iteratif dan interaktif. Fokus utamanya ada pada konsep Resilient Distributed Dataset (RDD) sebagai abstraksi inti — immutability, lineage untuk fault tolerance, transformasi lazy vs aksi — serta arsitektur cluster Spark (Driver, Cluster Manager, Executor) dan bagaimana Spark memecah sebuah job menjadi stages dan tasks lewat DAG scheduling.
Motivasi: Keterbatasan MapReduce untuk Beban Kerja Iteratif dan Interaktif
MapReduce memodelkan komputasi sebagai acyclic data flow dari persistent data (biasanya di disk/HDFS): data dibaca dari storage, diproses lewat serangkaian operator Map dan Reduce, lalu ditulis kembali ke storage. Model ini punya keuntungan run-time bisa mengatur di mana proses dijalankan dan memudahkan penanganan kegagalan (karena setiap tahap punya checkpoint di disk), tapi punya kelemahan mendasar:
- Tidak sesuai untuk iteratif — algoritma seperti machine learning (mis. logistic regression, k-means) memerlukan penggunaan ulang data yang sama berkali-kali antar iterasi. Pada Hadoop, setiap iterasi harus membaca ulang data dari disk/persistent storage karena tidak ada mekanisme built-in untuk menyimpan data di memori antar-job.
- Tidak sesuai untuk interaktif — query ad-hoc berulang terhadap dataset yang sama (mis. eksplorasi data di shell) juga selalu memaksa pembacaan ulang dari disk untuk tiap query.
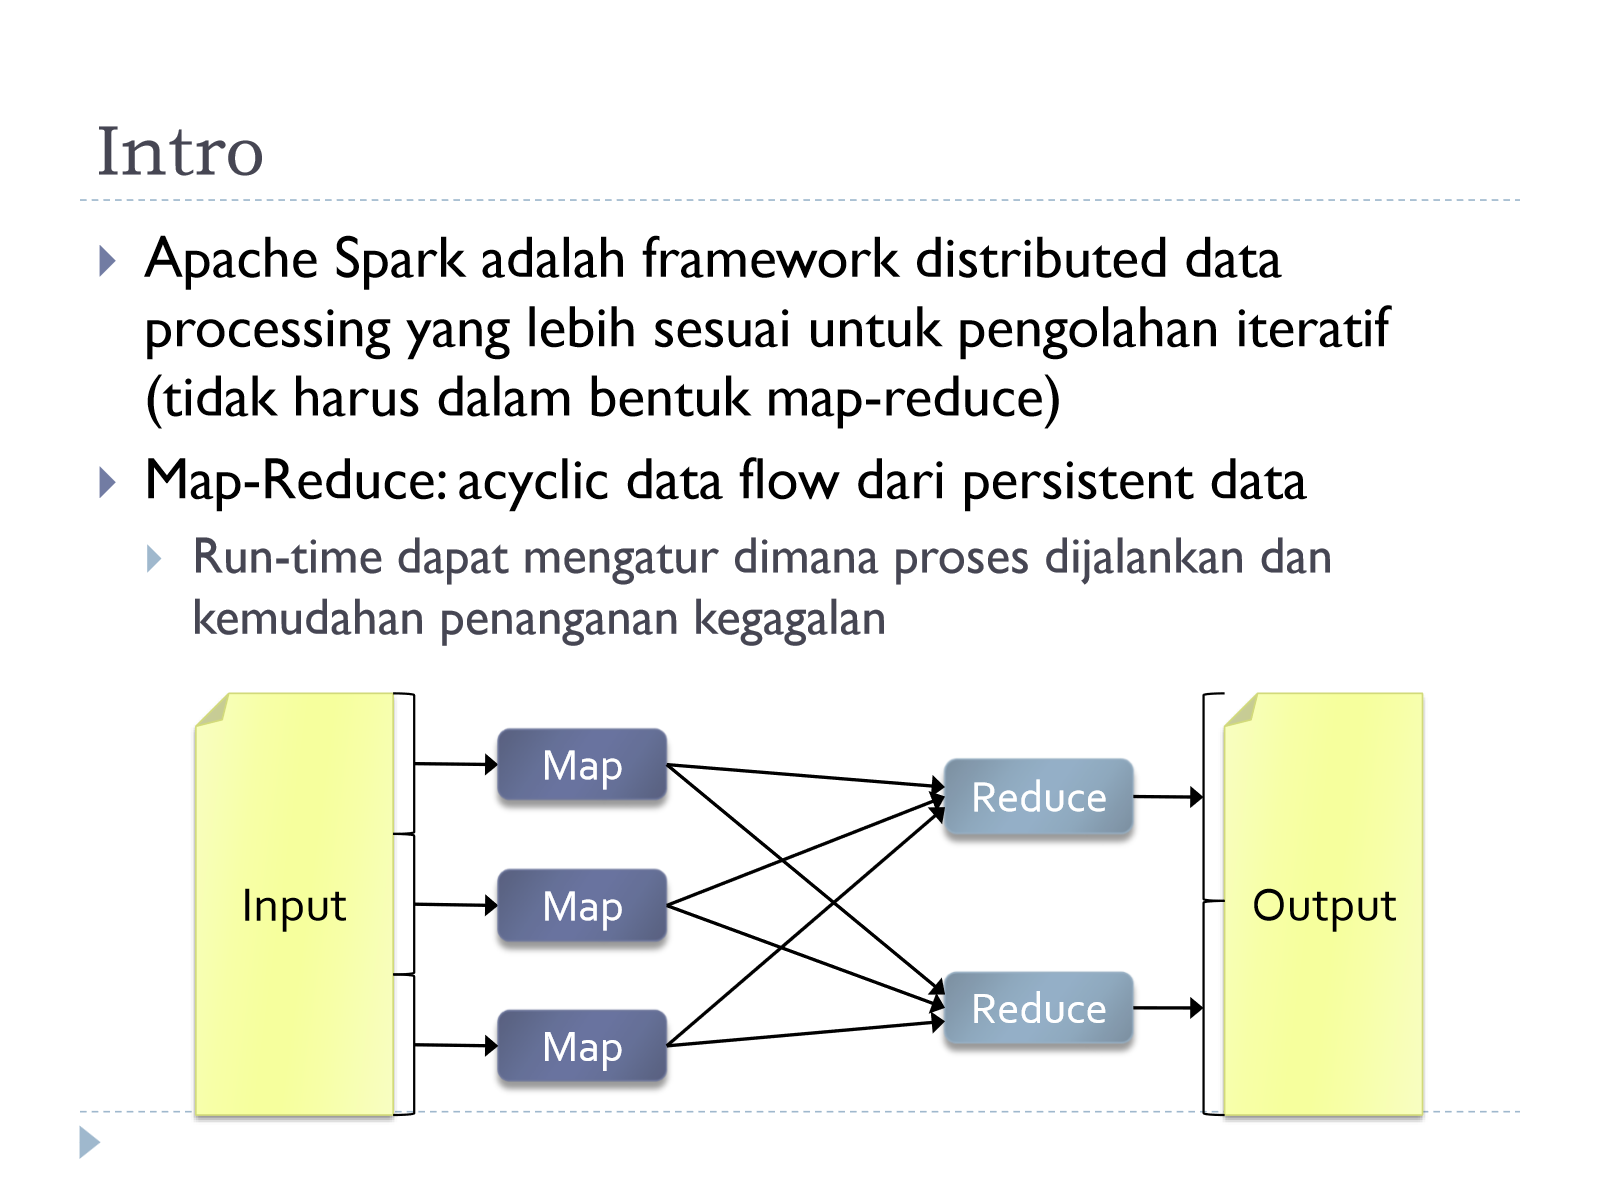
Solusi Spark: Resilient Distributed Datasets (RDD) — RDD memungkinkan aplikasi menyimpan dan menggunakan kembali data di memori (in-memory computing) antar operasi/iterasi, sambil tetap menyediakan tiga properti penting yang biasanya didapat lewat penulisan ke disk pada MapReduce:
- Fault-tolerant
- Locality (data diproses sedekat mungkin dengan lokasinya)
- Scalability
RDD juga dirancang lebih generik dibanding pasangan Map-Reduce yang kaku, sehingga bisa mendukung ragam aplikasi yang lebih luas (bukan cuma bisa dinyatakan sebagai satu pasang map-lalu-reduce).
Perbandingan Operasi Iteratif: MapReduce vs Spark RDD
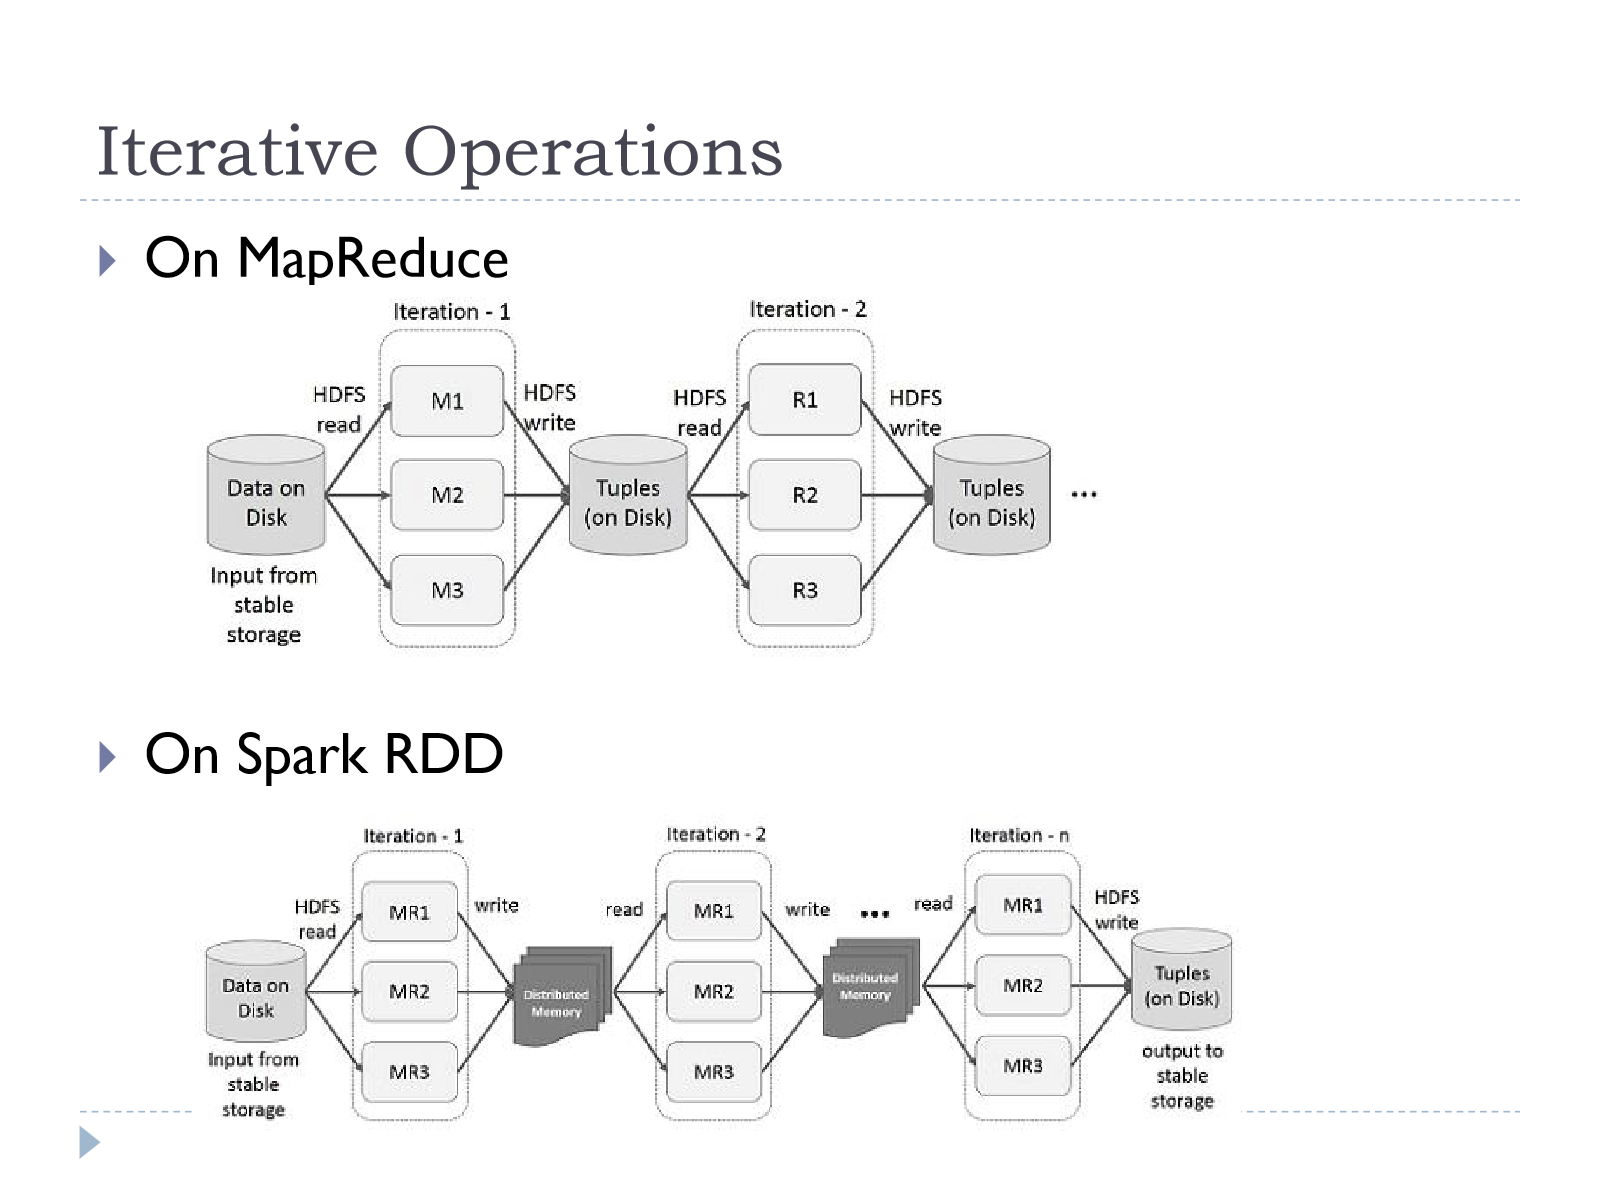
Pada MapReduce, setiap iterasi adalah job MapReduce baru: Data on Disk → HDFS read → tahap Map (M1, M2, M3) → tulis tuple hasil ke disk (HDFS write) → iterasi berikutnya membaca ulang tuple tersebut dari disk untuk tahap Reduce, dan begitu seterusnya. Setiap iterasi selalu diawali dan diakhiri dengan I/O ke disk.
Pada Spark RDD, data awal dibaca sekali dari disk (HDFS read), kemudian setiap iterasi (MR1, MR2, MR3) membaca dan menulis hasil antaranya ke Distributed Memory (bukan disk), dan hanya pada akhir seluruh pipeline hasil akhir ditulis kembali ke storage stabil (HDFS write). Inilah alasan utama Spark jauh lebih cepat untuk beban kerja iteratif: I/O ke disk yang mahal hanya terjadi sekali di awal dan sekali di akhir, bukan pada setiap iterasi.
Perbandingan Operasi Interaktif: MapReduce vs Spark RDD
Pada MapReduce, setiap query interaktif (Query1, Query2, Query3, …) terhadap dataset yang sama selalu memulai dari HDFS read dari awal, karena tidak ada state yang dipertahankan antar query. Pada Spark RDD, data dibaca dan diproses satu kali (One Time Processing) ke Distributed Memory, lalu seluruh query berikutnya bisa langsung dijalankan terhadap data yang sudah ada di memori tersebut — jauh lebih cepat karena tidak perlu pembacaan ulang dari disk untuk tiap query.
Tabel Perbandingan MapReduce vs Spark
| Aspek | MapReduce (Hadoop) | Spark |
|---|---|---|
| Model komputasi | Acyclic data flow dari persistent data (disk), dibatasi bentuk pasangan Map lalu Reduce | Lebih generik, tidak harus berbentuk map-reduce; dinyatakan sebagai transformasi/aksi atas RDD |
| Penyimpanan data antar tahap/iterasi | Ditulis dan dibaca ulang dari disk (HDFS) setiap iterasi/job | Disimpan di distributed memory (in-memory computing), bisa di-cache untuk reuse |
| Kinerja untuk beban iteratif | Lambat — setiap iterasi mahal karena I/O disk berulang (mis. 127 s/iterasi pada Logistic Regression) | Jauh lebih cepat — iterasi pertama butuh baca disk (mis. 174 s), iterasi berikutnya hanya ~6 s karena data sudah di memori |
| Kinerja untuk beban interaktif | Query berulang tetap harus membaca ulang dari disk | Data di-cache di memori sekali, query berikutnya langsung memakainya (mis. full-text search Wikipedia <1 detik vs 20 detik on-disk) |
| Fault tolerance | Replikasi data fisik di disk (HDFS) | Rekonstruksi lewat lineage/DAG RDD (recompute partisi yang hilang dari transformasi asalnya) |
| Fleksibilitas aplikasi | Terbatas pada pola map-reduce | Mendukung aplikasi lebih beragam (graph processing, machine learning iteratif, SQL, streaming) |
Contoh Kinerja: Logistic Regression
val data = spark.textFile(...).map(readPoint).cache()
var w = Vector.random(D)

for (i <- 1 to ITERATIONS) {
  val gradient = data.map(p =>
    (1 / (1 + exp(-p.y*(w dot p.x))) - 1) * p.y * p.x
  ).reduce(_ + _)
  w -= gradient
}

println("Final w: " + w)
Dataset data dibaca dan diubah sekali lalu di-cache, sehingga tiap iterasi loop for tinggal memanfaatkan RDD yang sudah ada di memori untuk menghitung gradient dan meng-update w, tanpa membaca ulang dari disk.
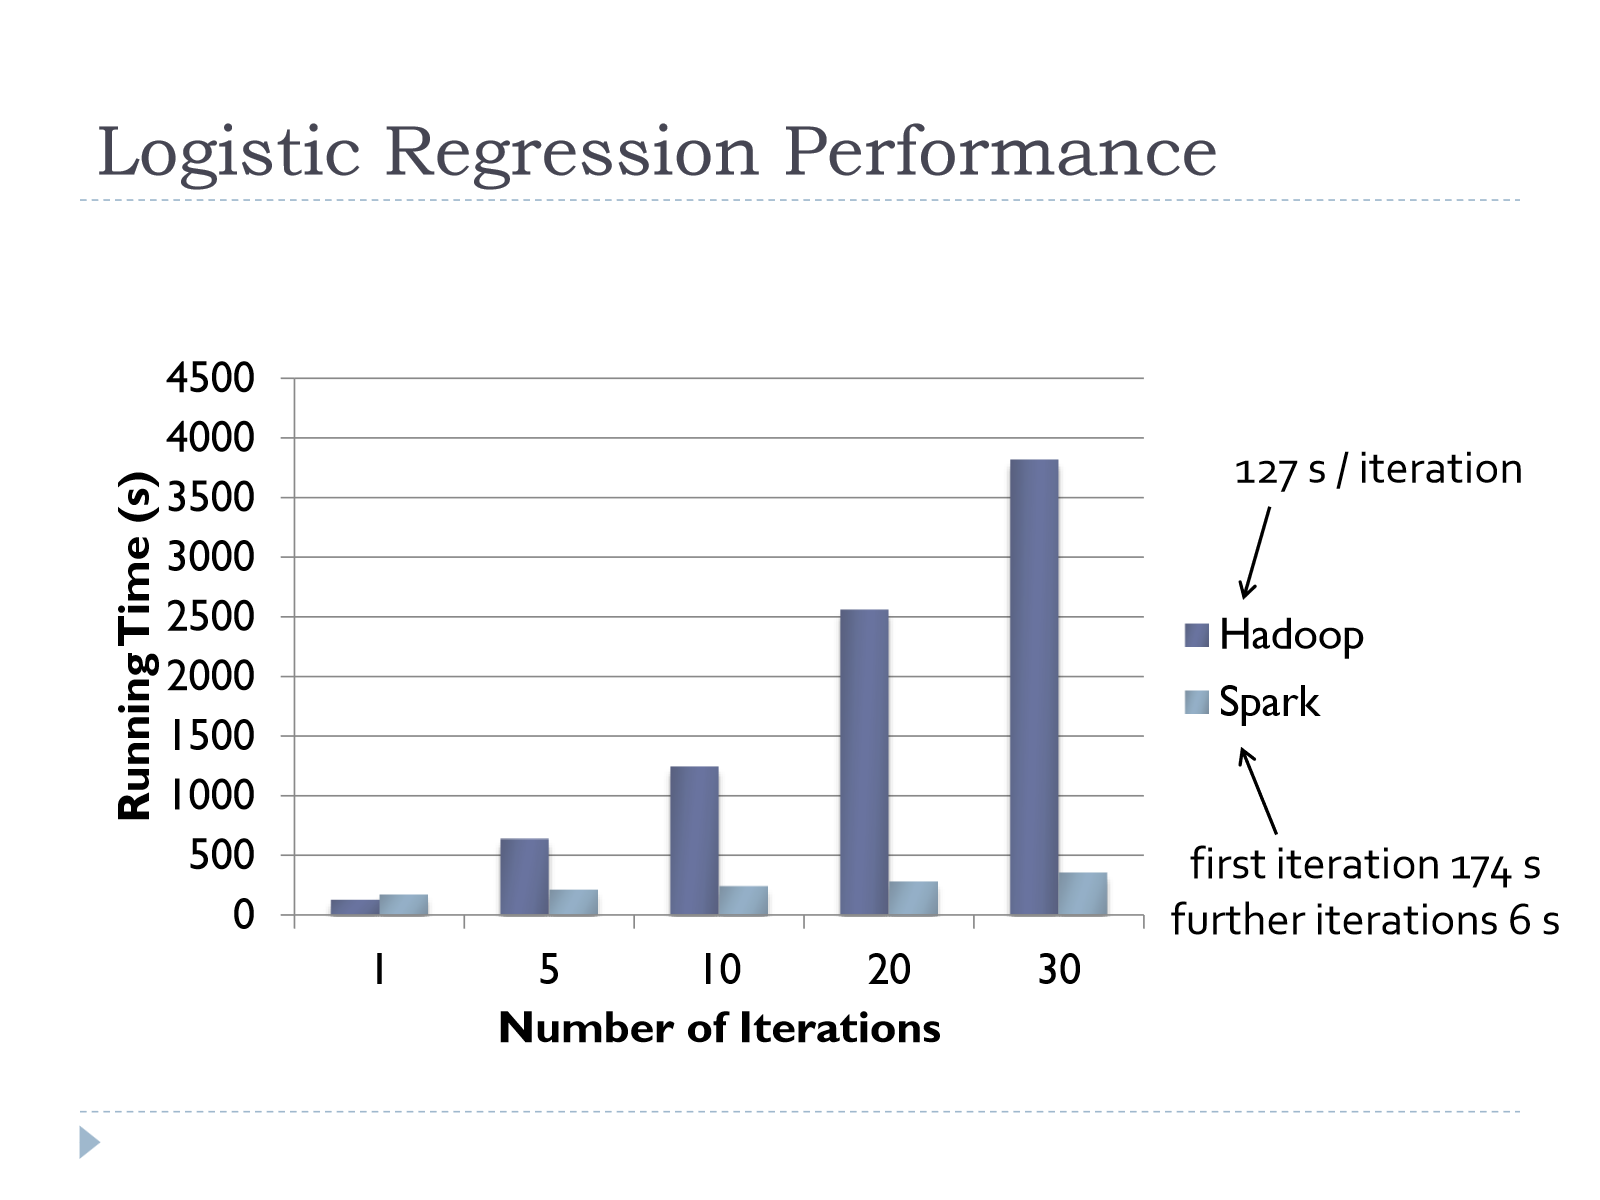
Hasil benchmark: pada Hadoop, tiap iterasi memakan 127 detik. Pada Spark, iterasi pertama (yang masih perlu membaca data dari disk) memakan 174 detik, tetapi iterasi-iterasi selanjutnya hanya 6 detik karena data sudah tersedia di distributed memory — speedup drastis untuk algoritma iteratif seperti ini.
Model Pemrograman: Resilient Distributed Dataset (RDD)
RDD (Resilient Distributed Dataset) adalah abstraksi utama pada Spark: sebuah koleksi elemen yang bersifat:
- Immutable — sekali dibuat, isi RDD tidak bisa diubah; setiap “perubahan” sebenarnya menghasilkan RDD baru.
- Partitioned — data dipecah menjadi sejumlah partisi yang tersebar di seluruh node cluster, memungkinkan pemrosesan paralel.
- Fault tolerant — kehilangan sebagian data (mis. karena node/executor mati) dapat direkonstruksi ulang.
- Dapat dieksekusi secara paralel di banyak node cluster sekaligus.
RDD dibuat melalui parallel transformations (map, filter, groupBy, join, …) yang diterapkan pada data yang terletak di disk/persistent storage, dan hasilnya dapat di-cache untuk digunakan ulang (reuse) tanpa perlu membaca ulang dari sumber aslinya.
Dua Cara Membuat RDD
- Parallelized collections — berasal dari koleksi Scala biasa (mis.
List,Array) yang di-parallelize menggunakan fungsiparallelizeuntuk diubah menjadi RDD terdistribusi. - External datasets — dibuat dari sumber data eksternal seperti file lokal, HDFS, HBase, dan sumber data lain yang didukung Hadoop InputFormat.
RDD Fault Tolerance lewat Lineage
Alih-alih mereplikasi data secara fisik seperti pada HDFS, RDD menyimpan informasi lineage — yaitu riwayat transformasi (dan fungsi yang dipakai) yang membentuk RDD tersebut dari RDD/sumber sebelumnya. Jika sebuah partisi RDD hilang (mis. node executor gagal), Spark dapat merekonstruksi ulang partisi tersebut hanya dengan menjalankan kembali rangkaian transformasi pada lineage-nya, tanpa perlu replikasi data penuh.
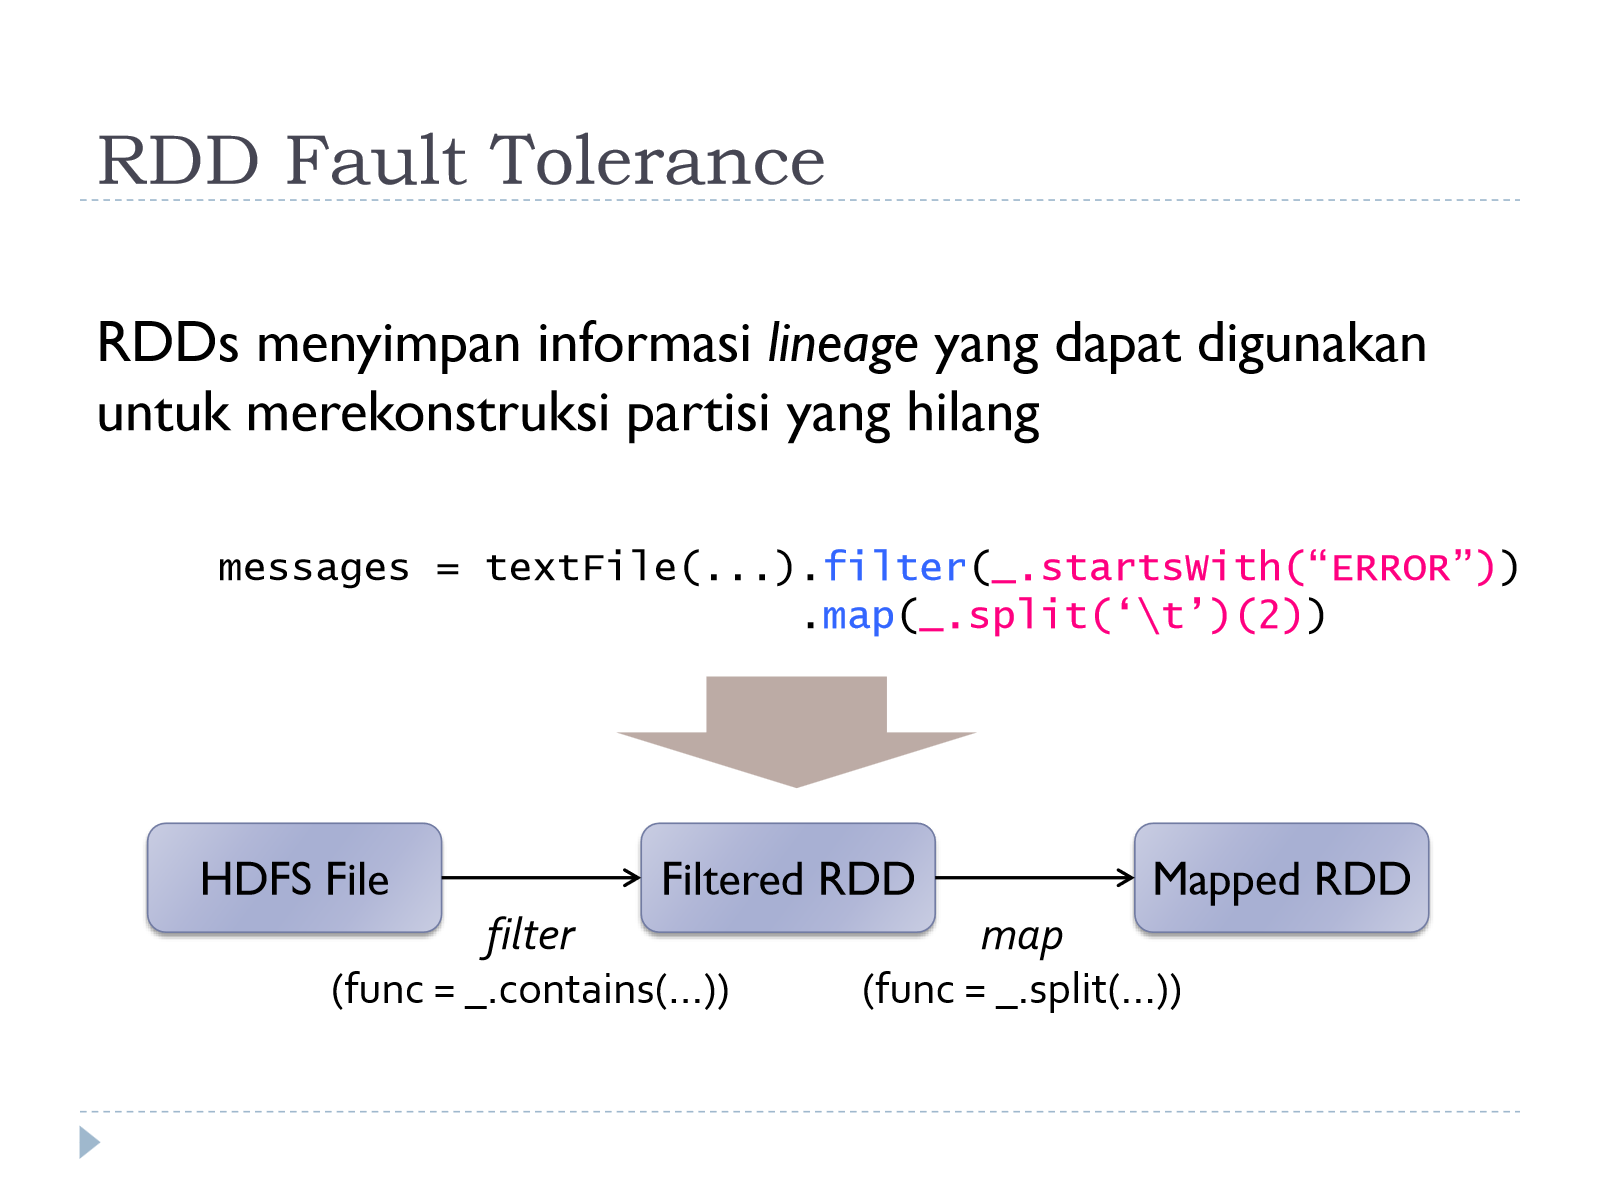
Contoh:
messages = textFile(...).filter(_.startsWith("ERROR"))
                         .map(_.split('\t')(2))
Lineage-nya membentuk graf linear: HDFS File → (transformasi filter dengan func = _.contains(...)) → Filtered RDD → (transformasi map dengan func = _.split(...)) → Mapped RDD. Graf lineage inilah yang berperan sebagai DAG (Directed Acyclic Graph) ketergantungan antar-RDD — jika Mapped RDD kehilangan sebuah partisi, Spark cukup menjalankan ulang filter dan map pada partisi terkait dari HDFS File, bukan memuat ulang seluruh dataset atau bergantung pada salinan replikasi.
Transformasi vs Aksi pada RDD
Terdapat 2 jenis operasi pada RDD, dengan perbedaan fundamental terkait kapan operasi tersebut benar-benar dieksekusi:
- Transformations — mengubah sebuah RDD menjadi RDD lain (mendefinisikan RDD baru). Bersifat lazy: transformasi tidak langsung dieksekusi saat dipanggil, melainkan hanya dicatat sebagai bagian dari lineage/DAG. Transformasi baru benar-benar dikomputasi saat sebuah aksi dilakukan terhadapnya (atau terhadap RDD turunannya).
- Actions — mengembalikan sebuah hasil ke driver program (bukan RDD baru). Pemanggilan aksi inilah yang men-trigger eksekusi seluruh rangkaian transformasi yang menjadi lineage RDD tersebut.
Lazy evaluation ini penting karena memungkinkan Spark melihat keseluruhan rangkaian transformasi sebelum benar-benar mengeksekusinya, sehingga Spark dapat melakukan optimasi eksekusi (mis. menggabungkan beberapa transformasi ke dalam satu stage, menghindari komputasi ulang yang tidak perlu) alih-alih mengeksekusi setiap operasi satu per satu secara langsung.
Tabel Transformasi vs Aksi RDD
| Transformations (define a new RDD, lazy) | Actions (return a result to driver program, trigger eksekusi) |
|---|---|
map — menerapkan fungsi ke tiap elemen | collect — mengambil seluruh elemen RDD ke driver |
filter — menyaring elemen sesuai predikat | reduce — mengagregasi seluruh elemen menjadi satu nilai |
flatMap — map lalu meratakan hasil (flatten) | count — menghitung jumlah elemen |
sample — mengambil sampel data | save — menyimpan RDD ke storage |
groupByKey — mengelompokkan berdasarkan key | lookupKey — mengambil nilai berdasarkan key tertentu |
reduceByKey — mereduksi nilai per key | |
sortByKey — mengurutkan berdasarkan key | |
union — menggabungkan dua RDD | |
join — menggabungkan dua RDD berdasarkan key | |
cogroup — group bersama dari beberapa RDD | |
cross — cartesian product dua RDD | |
mapValues — map hanya terhadap value (untuk pair RDD) |
Contoh: Log Mining (Kombinasi Transformasi dan Aksi)
Kasus penggunaan: membaca error messages dari log ke memory, lalu mencari secara interaktif untuk berbagai pattern tanpa membaca ulang file log tiap kali.
lines = spark.textFile("hdfs://...")
errors = lines.filter(_.startsWith("ERROR"))
messages = errors.map(_.split('\t'))
cachedMsgs = messages.cache()

cachedMsgs.filter(_.contains("foo")).count
cachedMsgs.filter(_.contains("bar")).count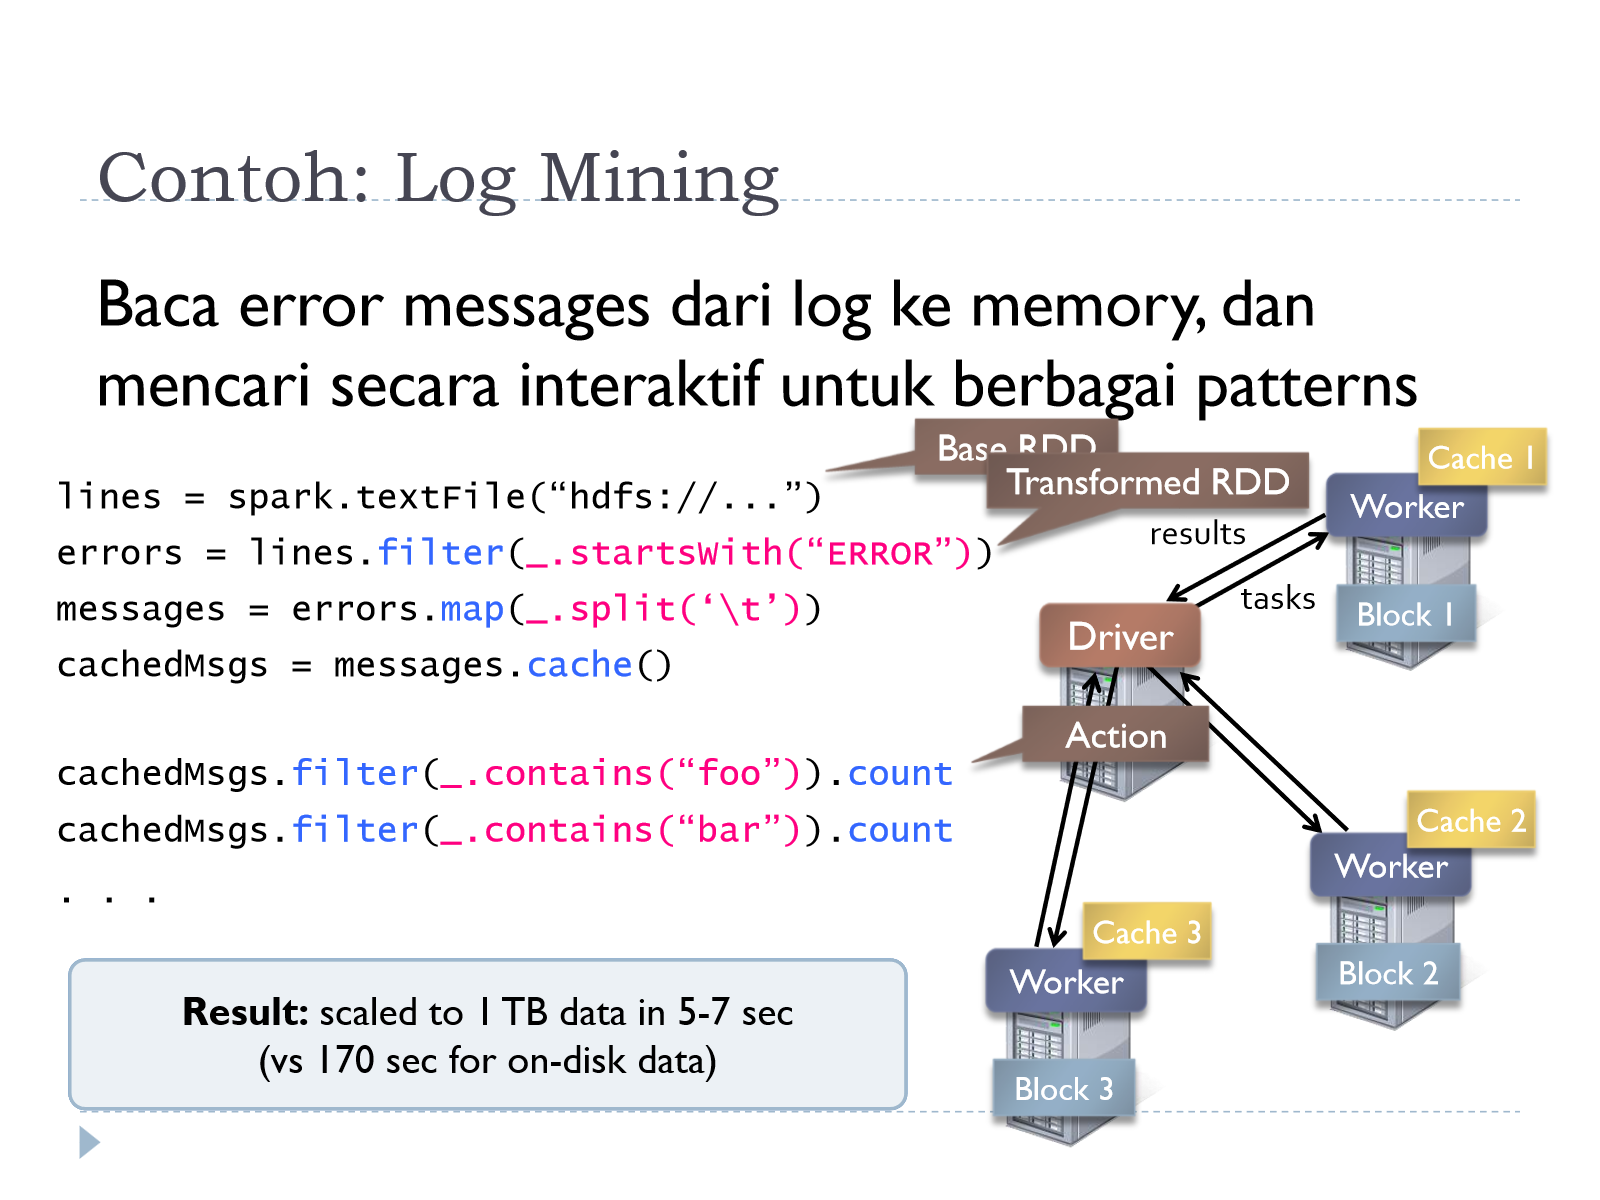
Alur pada diagram: lines adalah Base RDD dibaca dari HDFS, errors dan messages adalah Transformed RDD (lazy, belum dieksekusi), sedangkan cachedMsgs.filter(...).count adalah Action yang memicu Driver mengirim task ke tiap Worker, dan tiap Worker menjalankan task tersebut atas Block data yang menjadi tanggung jawabnya lalu menyimpan hasil transformasi di Cache miliknya sebelum mengembalikan result ke Driver. Karena messages sudah di-cache, panggilan count berikutnya dengan filter pattern berbeda (“bar”) tidak perlu membaca ulang dan mem-filter/map dari awal — cukup memakai data yang sudah ada di cache tiap worker.
Hasil benchmark yang dilaporkan: full-text search Wikipedia dalam <1 detik (vs 20 detik untuk versi on-disk), dan pemrosesan skala 1 TB data dalam 5-7 detik (vs 170 detik untuk versi on-disk) — menunjukkan besarnya keuntungan in-memory caching untuk beban kerja interaktif berulang.
RDD, DataFrame, dan DataSet
RDD telah digunakan sejak Spark versi 1 sebagai representasi komputasi internal Spark — baik untuk DataFrame maupun DataSet sebenarnya tetap dieksekusi lewat mesin RDD di baliknya.
- DataFrame — representasi tabel yang terdiri atas baris dan kolom (mirip tabel relasional/dataframe pada Pandas), diperkenalkan pada Spark 1.3. Memungkinkan operasi query yang lebih deklaratif (mirip SQL) dan optimasi eksekusi otomatis oleh Spark (Catalyst optimizer).
- DataSet — representasi tabel yang type-safe (memanfaatkan tipe data dari bahasa seperti Scala/Java saat kompilasi), diperkenalkan pada Spark 1.6.
- DataSet dan DataFrame dapat saling diubah menjadi satu sama lain, tergantung kebutuhan (fleksibilitas dinamis dari DataFrame vs keamanan tipe dari DataSet).
Arsitektur Spark: Driver, Cluster Manager, dan Executor
Sebuah aplikasi Spark terdiri atas satu proses Driver dan sejumlah proses Executor yang tersebar pada cluster:
- Driver bertanggung jawab atas high-level control flow pekerjaan — driver menjalankan kode utama aplikasi, membangun graf RDD/lineage, dan menentukan bagaimana pekerjaan dipecah menjadi task.
- Executor bertanggung jawab menjalankan pekerjaan tersebut dalam bentuk Task — setiap executor menjalankan task pada partisi data yang menjadi tanggung jawabnya, dan menyimpan hasil antara pada Cache miliknya untuk reuse.
Untuk mengakses cluster Spark, sebuah program Spark memerlukan objek SparkContext. Pada Spark shell interaktif, SparkContext dibuat otomatis dengan nama sc. Objek inilah yang digunakan aplikasi untuk membuat RDD (baik dari parallelized collection maupun external dataset).
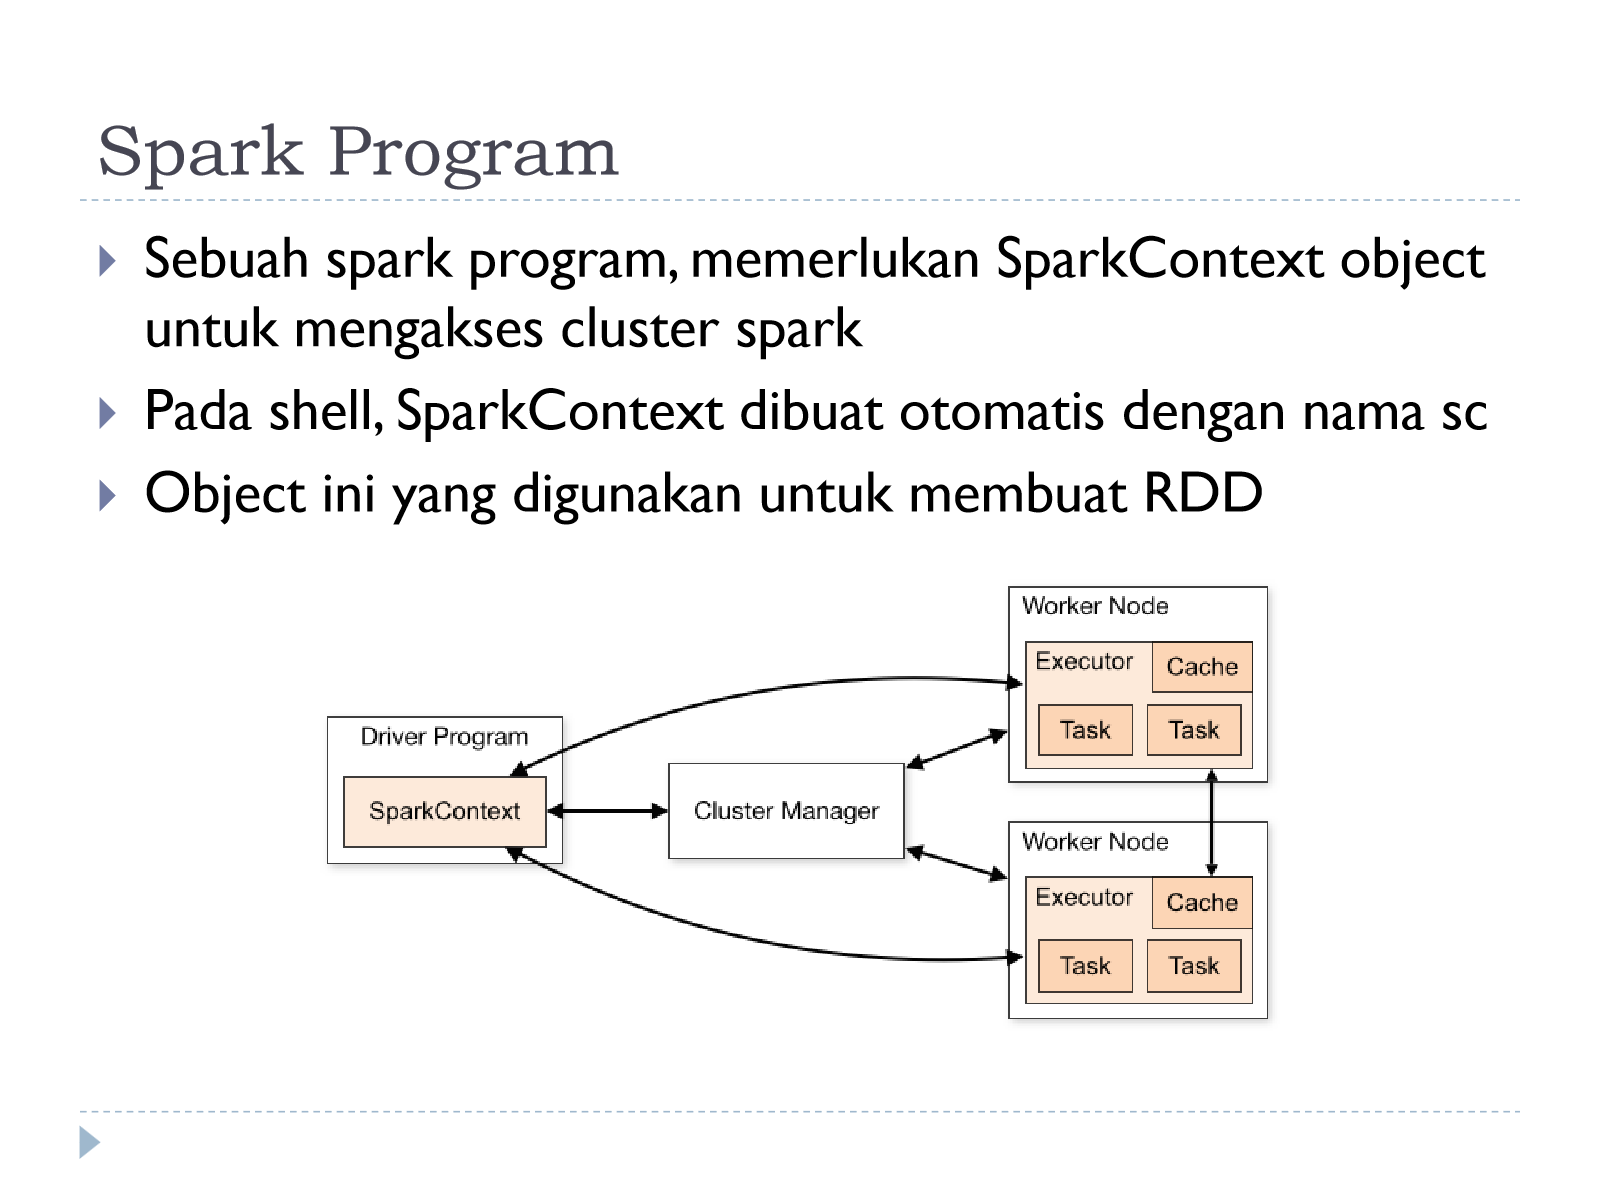
Alur kerja arsitektur:
- Driver Program (berisi
SparkContext) menghubungi Cluster Manager untuk mengalokasikan resources. - Driver mendapatkan Executor pada node-node di cluster (Worker Node).
- Driver mengirimkan kode aplikasi ke tiap Executor.
- Driver mengirimkan task ke Executor untuk dijalankan; tiap Executor menjalankan Task-nya dan menggunakan Cache lokal untuk menyimpan data yang di-persist/di-cache.
Spark Execution Model: Job, Stage, dan Task
Spark mengeksekusi sebuah aplikasi lewat hierarki bertingkat: Job → Stage → Task.
- Job: berada di hierarki eksekusi paling atas. Setiap pemanggilan sebuah Action pada aplikasi akan membuat sebuah job baru. Ketika sebuah job dibuat, Spark melihat graf RDD (lineage/DAG) yang terkait dengan Action tersebut dan menyusun sebuah plan eksekusi.
- Plan eksekusi ini dimulai dari RDD paling jauh — yaitu RDD yang tidak bergantung pada RDD lain (biasanya RDD sumber, hasil pembacaan data eksternal) — dan berakhir pada RDD yang menghasilkan output Action tersebut.
- Stage: plan eksekusi kemudian membagi seluruh rangkaian Transformations pada job menjadi sejumlah Stage. Sebuah stage adalah kumpulan task yang menjalankan kode yang sama pada subset data yang berbeda (pola SPMD — single program, multiple data). Setiap stage berisi sekuens transformasi yang bisa diselesaikan tanpa harus melakukan shuffle data secara keseluruhan antar seluruh partisi.
Narrow vs Wide Transformation dan Kapan Shuffle Diperlukan
Batas antar-stage ditentukan oleh jenis ketergantungan (dependency) transformasi terhadap data parent-nya:
- Narrow transformation — transformasi hanya bergantung pada data dari satu partisi parent yang sama (tidak perlu data dari partisi lain), sehingga tidak perlu shuffle. Contoh:
map,filter. - Wide dependency — transformasi memerlukan data dari banyak partisi yang mungkin tersebar di banyak node, sehingga memerlukan shuffle (data harus dipindahkan/ditata ulang antar-node melalui jaringan). Contoh:
groupByKey,reduceByKey.
Contoh eksekusi dengan 1 stage (semua transformasi bersifat narrow, tidak ada shuffle):
sc.textFile("someFile.txt").
  map(mapFunc).
  flatMap(flatMapFunc).
  filter(filterFunc).count()
Contoh eksekusi dengan lebih dari 1 stage (ada reduceByKey, wide dependency, sehingga terjadi shuffle di antara stage):
val tokenized = sc.textFile(args(0)).flatMap(_.split(' '))
val wordCounts = tokenized.map((_, 1)).reduceByKey(_ + _)
val filtered = wordCounts.filter(_._2 >= 1000)
val charCounts = filtered.flatMap(_._1.toCharArray).map((_, 1)).
                 reduceByKey(_ + _)
charCounts.collect()
Di sini, setiap reduceByKey menandai batas stage baru karena memerlukan shuffle data antar-partisi.
Contoh Transformation Graph dengan Banyak Stage
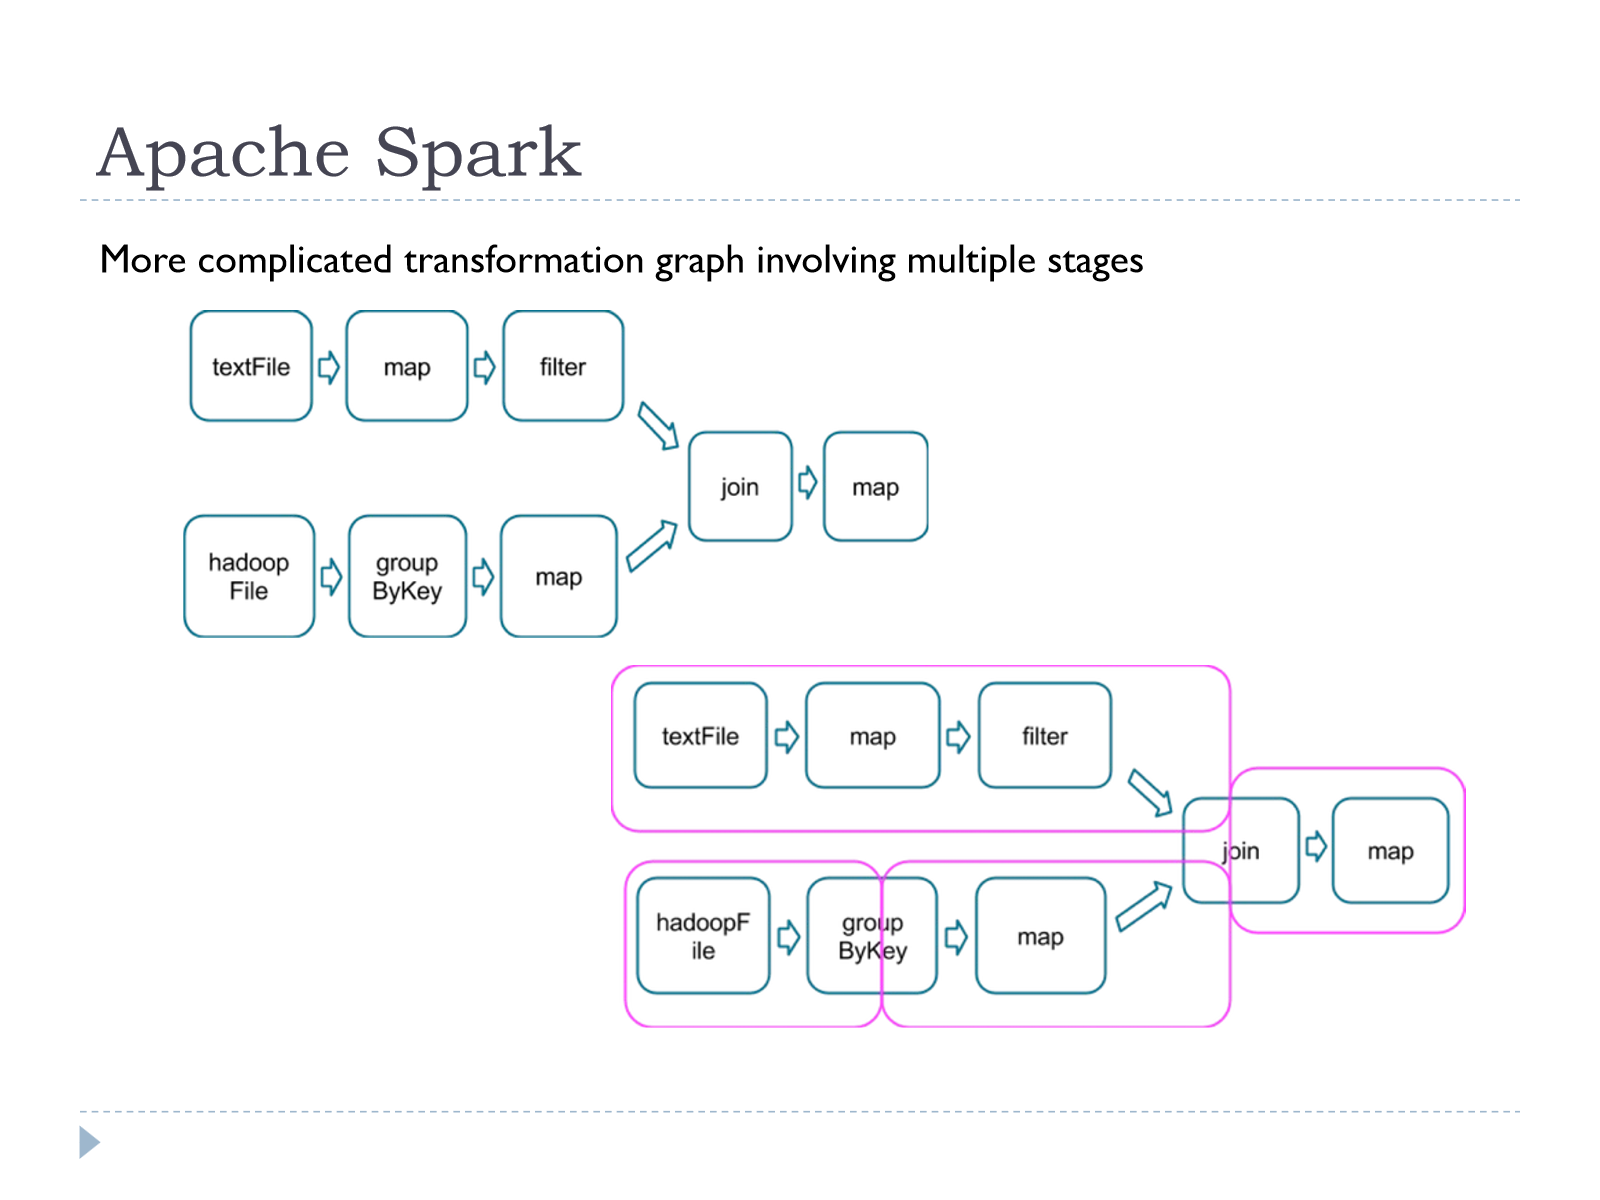
Diagram di atas menunjukkan graf transformasi yang lebih kompleks: dua cabang RDD independen (textFile → map → filter dan hadoopFile → groupByKey → map) yang masing-masing merupakan stage terpisah (karena groupByKey adalah wide dependency), lalu digabung lewat join (juga wide dependency, memerlukan shuffle) dan map menjadi stage ketiga. Boks berwarna pada bagian bawah diagram menunjukkan bagaimana graf tersebut dipartisi menjadi 3 stage: dua stage awal berjalan independen (bisa paralel) dan menghasilkan data yang di-shuffle, lalu stage ketiga men-join hasil kedua stage tersebut.
Stage Boundary dan Shuffle
Pada setiap stage boundary, data hasil dari parent stage dituliskan ke disk, kemudian diambil oleh child stage melalui jaringan (network). Ini berbeda dari data antar-transformasi dalam satu stage yang tetap berada di memori tanpa perlu ditulis ke disk — sehingga meminimalkan boundary stage (shuffle) adalah salah satu kunci performa Spark.
Transformasi yang mengakibatkan stage boundary dapat menggunakan parameter numPartitions untuk menentukan jumlah partisi yang akan dihasilkan pada child stage.
Teknik tuning terkait shuffle:
- Mengurangi jumlah shuffle dan ukuran data yang di-shuffle sebisa mungkin, karena shuffle melibatkan I/O disk dan transfer data lewat jaringan (mahal).
- Operasi-operasi yang menghasilkan shuffle:
repartition,join,cogroup, serta operasi berakhiran*By/*ByKey(mis.groupByKey,reduceByKey,sortByKey).
Spark Tuning: Resource Core CPU dan Memory
Resource utama yang dikonsumsi Spark adalah Core CPU dan Memory. Setiap Spark executor dalam sebuah aplikasi memiliki jumlah core dan heap size tertentu, yang dapat diatur lewat parameter konfigurasi:
--executor-cores— jumlah core CPU per executor.--executor-memory— ukuran heap memory per executor.--num-executors— jumlah total executor yang diminta untuk aplikasi.
Beberapa catatan penting terkait tuning resource:
- Large executor memory tidak selalu menghasilkan kinerja lebih baik — memory heap yang terlalu besar justru dapat memperberat proses garbage collection, yang pada gilirannya menurunkan kinerja aplikasi.
- Jumlah executor yang terlalu kecil mungkin tidak memanfaatkan core CPU secara optimal, karena paralelisme yang tersedia (jumlah task yang bisa dijalankan bersamaan) menjadi terbatas.
Flashcard
flashcards Mengapa MapReduce/Hadoop kurang cocok untuk beban kerja iteratif dan interaktif? :: Karena MapReduce memodelkan komputasi sebagai acyclic data flow dari persistent data — setiap iterasi atau query harus membaca ulang data dari disk/HDFS, tidak ada mekanisme built-in untuk menyimpan data yang sering dipakai ulang di memori antar-job. Apa itu RDD (Resilient Distributed Dataset) dan tiga properti utamanya? :: RDD adalah abstraksi utama Spark berupa koleksi elemen yang immutable, partitioned (tersebar di banyak node), dan dapat dieksekusi secara paralel — dengan properti fault-tolerant, locality, dan scalability tanpa perlu replikasi fisik data ke disk. Bagaimana RDD mencapai fault tolerance tanpa replikasi data fisik seperti HDFS? :: RDD menyimpan informasi lineage (riwayat transformasi dan fungsi yang membentuknya dari RDD/sumber sebelumnya, berbentuk DAG). Jika sebuah partisi hilang, Spark merekonstruksinya dengan menjalankan ulang rangkaian transformasi pada lineage tersebut, bukan menyalin ulang data replika. Apa perbedaan mendasar antara transformation dan action pada RDD? :: Transformation (map, filter, groupByKey, dst) mendefinisikan RDD baru dan bersifat lazy — tidak langsung dieksekusi. Action (collect, reduce, count, save, dst) mengembalikan hasil ke driver program dan memicu (trigger) eksekusi seluruh rangkaian transformasi dalam lineage-nya. Mengapa lazy evaluation pada transformasi RDD menguntungkan? :: Karena Spark dapat melihat keseluruhan rangkaian transformasi sebelum benar-benar mengeksekusinya, sehingga bisa melakukan optimasi (mis. menggabungkan transformasi ke satu stage, menghindari komputasi/pembacaan data yang tidak perlu) alih-alih mengeksekusi tiap operasi satu per satu secara langsung. Sebutkan tiga komponen utama arsitektur cluster Spark dan perannya. :: Driver (menjalankan control flow aplikasi, membangun graf RDD dan plan eksekusi, mengirim task), Cluster Manager (mengalokasikan resource cluster untuk aplikasi), dan Executor pada Worker Node (menjalankan Task pada data yang menjadi tanggung jawabnya serta menyimpan cache lokal). Bagaimana sebuah Job pada Spark terbentuk, dan bagaimana job tersebut dipecah menjadi Stage? :: Setiap pemanggilan Action membuat sebuah Job baru. Spark melihat graf RDD/lineage terkait Action tersebut untuk membuat plan eksekusi, lalu memecah rangkaian transformasi pada job menjadi sejumlah Stage — tiap stage berisi sekuens transformasi yang bisa diselesaikan tanpa shuffle data keseluruhan. Apa perbedaan narrow transformation dan wide dependency, dan kaitannya dengan shuffle serta batas stage? :: Narrow transformation (mis. map, filter) hanya bergantung pada data dari satu partisi parent sehingga tidak perlu shuffle. Wide dependency (mis. groupByKey, reduceByKey, join) memerlukan data dari banyak partisi sehingga memicu shuffle — dan shuffle inilah yang menjadi batas antar-stage (stage boundary), di mana data ditulis ke disk oleh parent stage dan diambil child stage lewat network. Sebutkan operasi-operasi RDD yang umumnya memicu shuffle. :: repartition, join, cogroup, serta operasi berakhiran *By atau *ByKey seperti groupByKey, reduceByKey, dan sortByKey. Apa perbedaan RDD, DataFrame, dan DataSet pada Spark? :: RDD adalah abstraksi dasar sejak Spark 1 yang menjadi mesin komputasi internal. DataFrame (Spark 1.3) adalah representasi tabel berbasis baris-kolom yang lebih deklaratif. DataSet (Spark 1.6) adalah representasi tabel yang type-safe. DataFrame dan DataSet dapat saling dikonversi, dan keduanya tetap dieksekusi lewat RDD di baliknya. Mengapa large executor memory tidak selalu meningkatkan kinerja Spark? :: Karena heap memory yang terlalu besar dapat memperberat proses garbage collection, yang justru menurunkan kinerja aplikasi; di sisi lain, jumlah executor yang terlalu sedikit juga bisa membuat pemanfaatan core CPU menjadi tidak optimal.