Materi ini membahas stream processing, yaitu paradigma pemrosesan data yang mengalir terus-menerus (tidak seperti data yang sudah diam tersimpan di database/file). Topik ini melengkapi materi pemrosesan data skala besar sebelumnya (MapReduce/batch processing) dengan model pemrosesan yang harus menangani data unbounded — data yang tidak pernah “selesai” datang.
Apa itu Stream
Stream memiliki tiga karakteristik utama:
- Unbounded data: bersifat infinite, data terus diproduksi/mengalir tanpa akhir yang jelas. Berbeda dengan bounded data pada batch processing yang jumlahnya finite/tetap.
- Push model: produksi data dikendalikan oleh sumber (bukan oleh consumer yang meminta/pull). Ini biasa disebut publish/subscribe model — sumber mem-publish data begitu tersedia, dan consumer men-subscribe untuk menerimanya.
- Konsep waktu: kadang diperlukan untuk menentukan kapan data diproduksi dan kapan output dihasilkan. Terdapat beberapa variasi konsep waktu: time agnostic, processing time, ingestion time, dan event time (dibahas lebih detail di bagian berikutnya).
Stream vs Database Management (Active Database)
Pada database system, data disimpan untuk merepresentasikan current state. Analisis dilakukan dengan melakukan query pull terhadap data yang tersimpan secara persistent. Ada juga konsep Active Database, yaitu database yang menggunakan trigger untuk mengupdate materialized view/computed results secara otomatis saat data berubah — ini adalah cikal bakal dari ide stream processing di dunia database.
Perbandingan karakteristik inti antara database management dan data stream management:
| Aspek | Database Management | Data Stream Management |
|---|---|---|
| Data access | Pull-based | Push-based |
| Data model | Persistent collection | Ephemeral stream |
| Query execution | Ad hoc, random access | Continuous, sequential |
Slide juga menunjukkan timeline evolusi riset data management selama lima dekade: dari Relational Databases (1970-an: Relation Model, System R, Ingres) → Active Databases (Triggers, HiPAC, Starburst, Rapide) → CEP & Streams (Telegraph, STREAM) sekaligus Big Data & NoSQL (MapReduce, GFS, Bigtable, Dynamo) → hingga Stream Processing modern (Storm, Samza, Spark, Flink) dan Real-Time Databases (Meteor, RethinkDB, Firebase, Baqend) di era sekarang.
Bounded vs Unbounded Data
Konsep ini penting untuk memahami perbedaan mendasar batch processing dan stream processing.
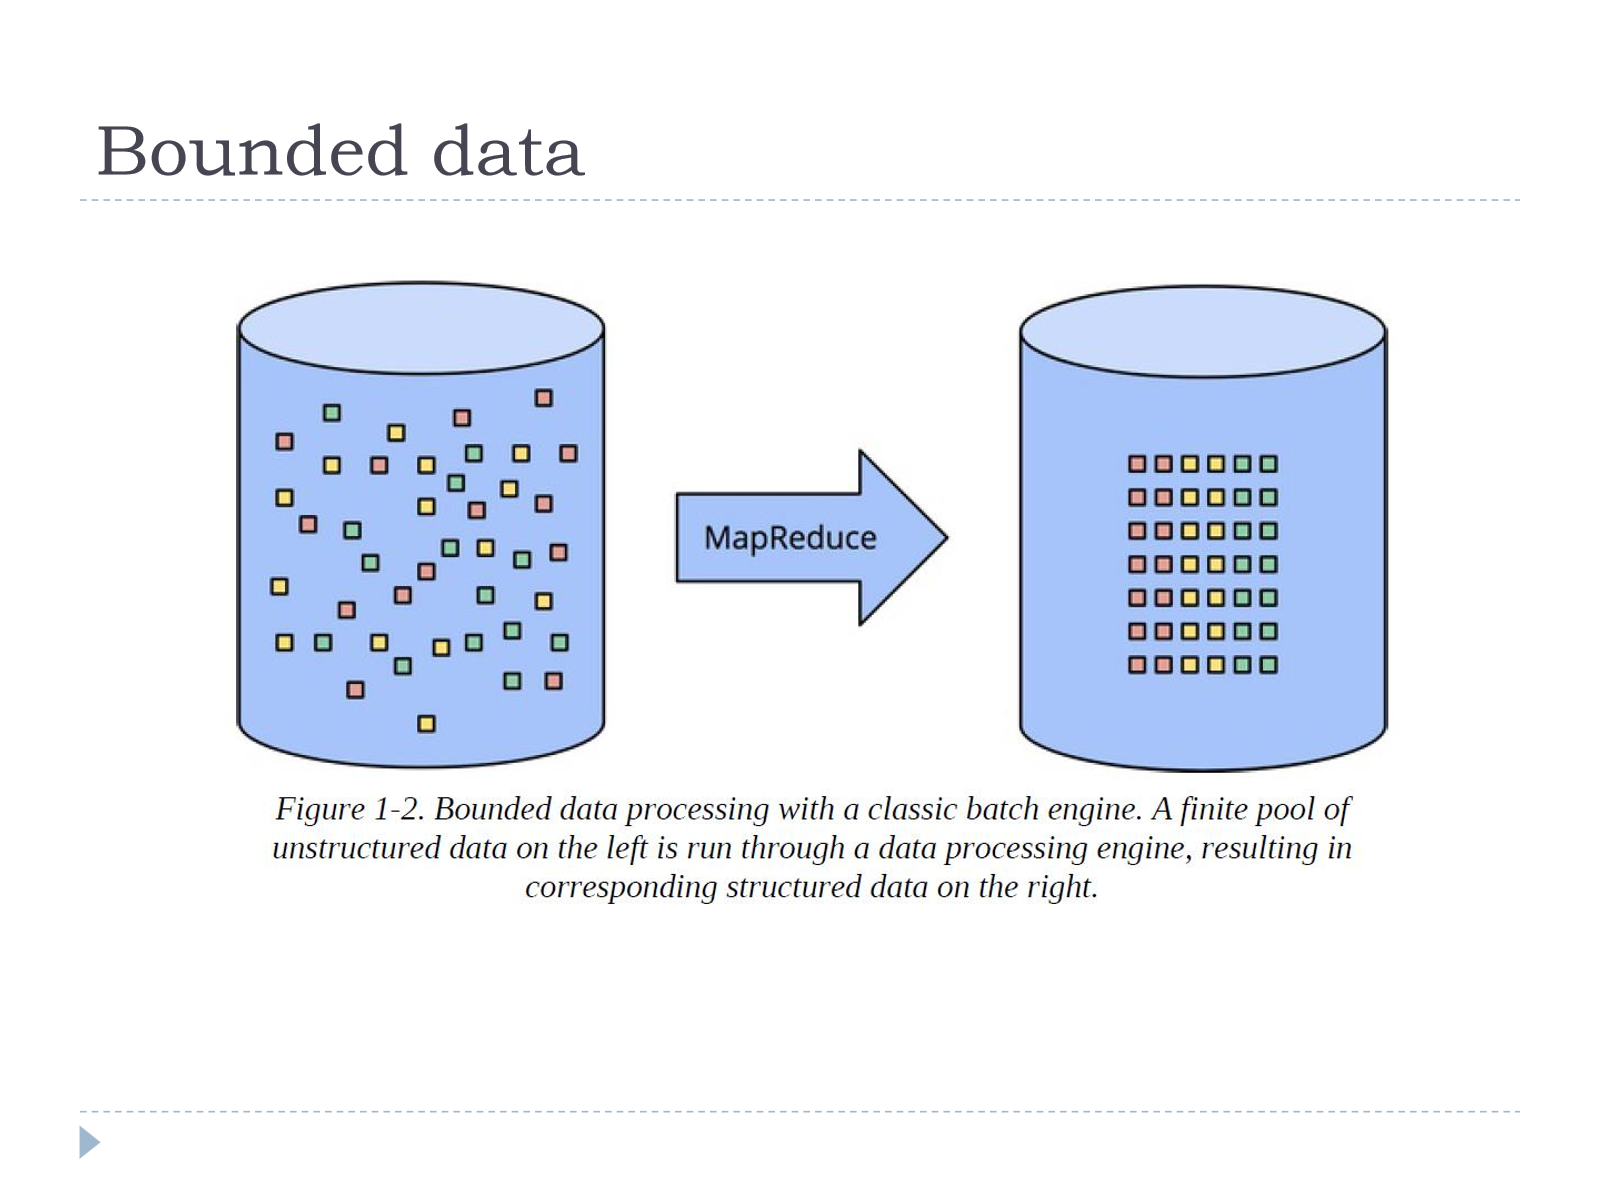
Bounded data adalah data yang jumlahnya sudah pasti/finite (misalnya file yang sudah lengkap tersimpan). Diproses dengan classic batch engine seperti MapReduce: seluruh pool data yang finite dijalankan melalui engine, menghasilkan data terstruktur.
Unbounded data adalah data yang terus mengalir tanpa batas akhir yang jelas. Untuk memprosesnya dengan classic batch engine (yang sebetulnya didesain untuk data bounded), digunakan pendekatan ad hoc fixed windows: dataset unbounded dikumpulkan ke dalam window-window berukuran tetap (misalnya per jam: [10:00-11:00], [11:00-12:00], dst), lalu setiap window diproses secara terpisah menggunakan batch engine secara berulang (successive runs).
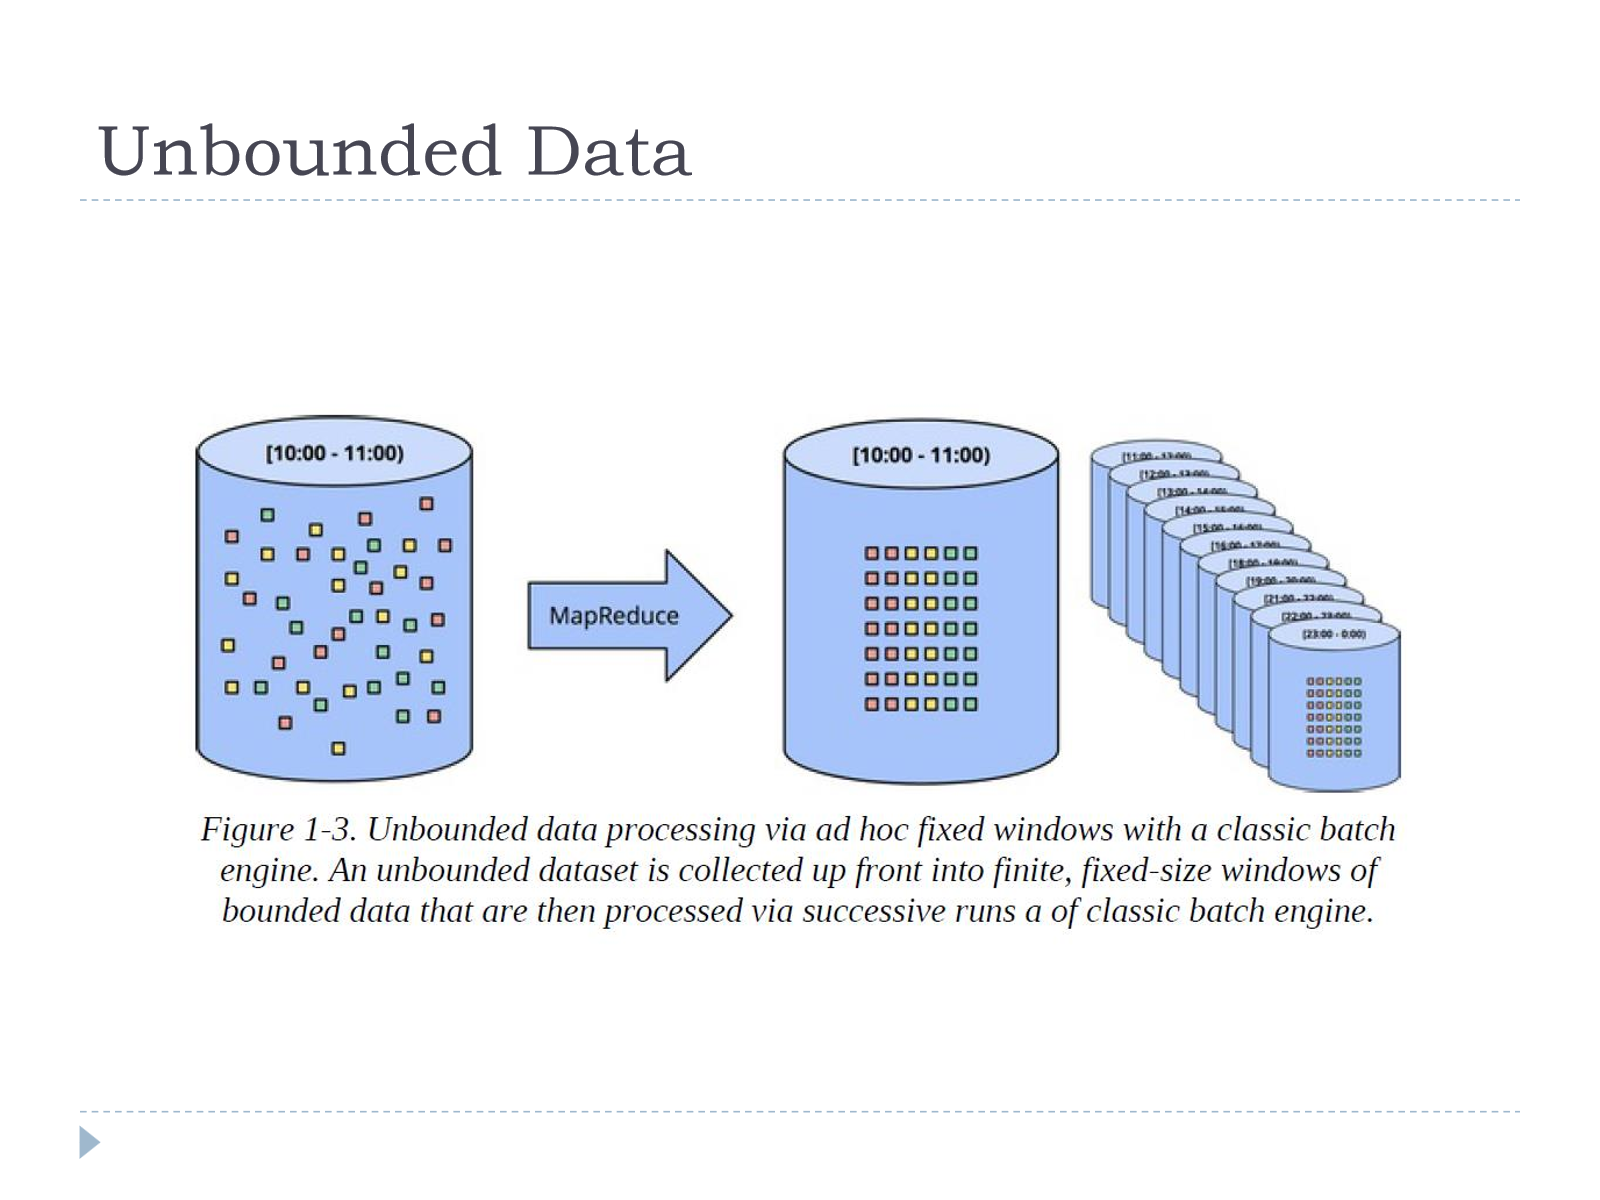
Pendekatan windowing pada data unbounded inilah yang nantinya menjadi cikal bakal konsep windowing pada stream processing modern (dibahas di bagian selanjutnya).
Data Access: Pull vs Push
Spektrum sistem data management dapat dilihat dari sisi pola akses datanya, dari pull-based ke push-based:
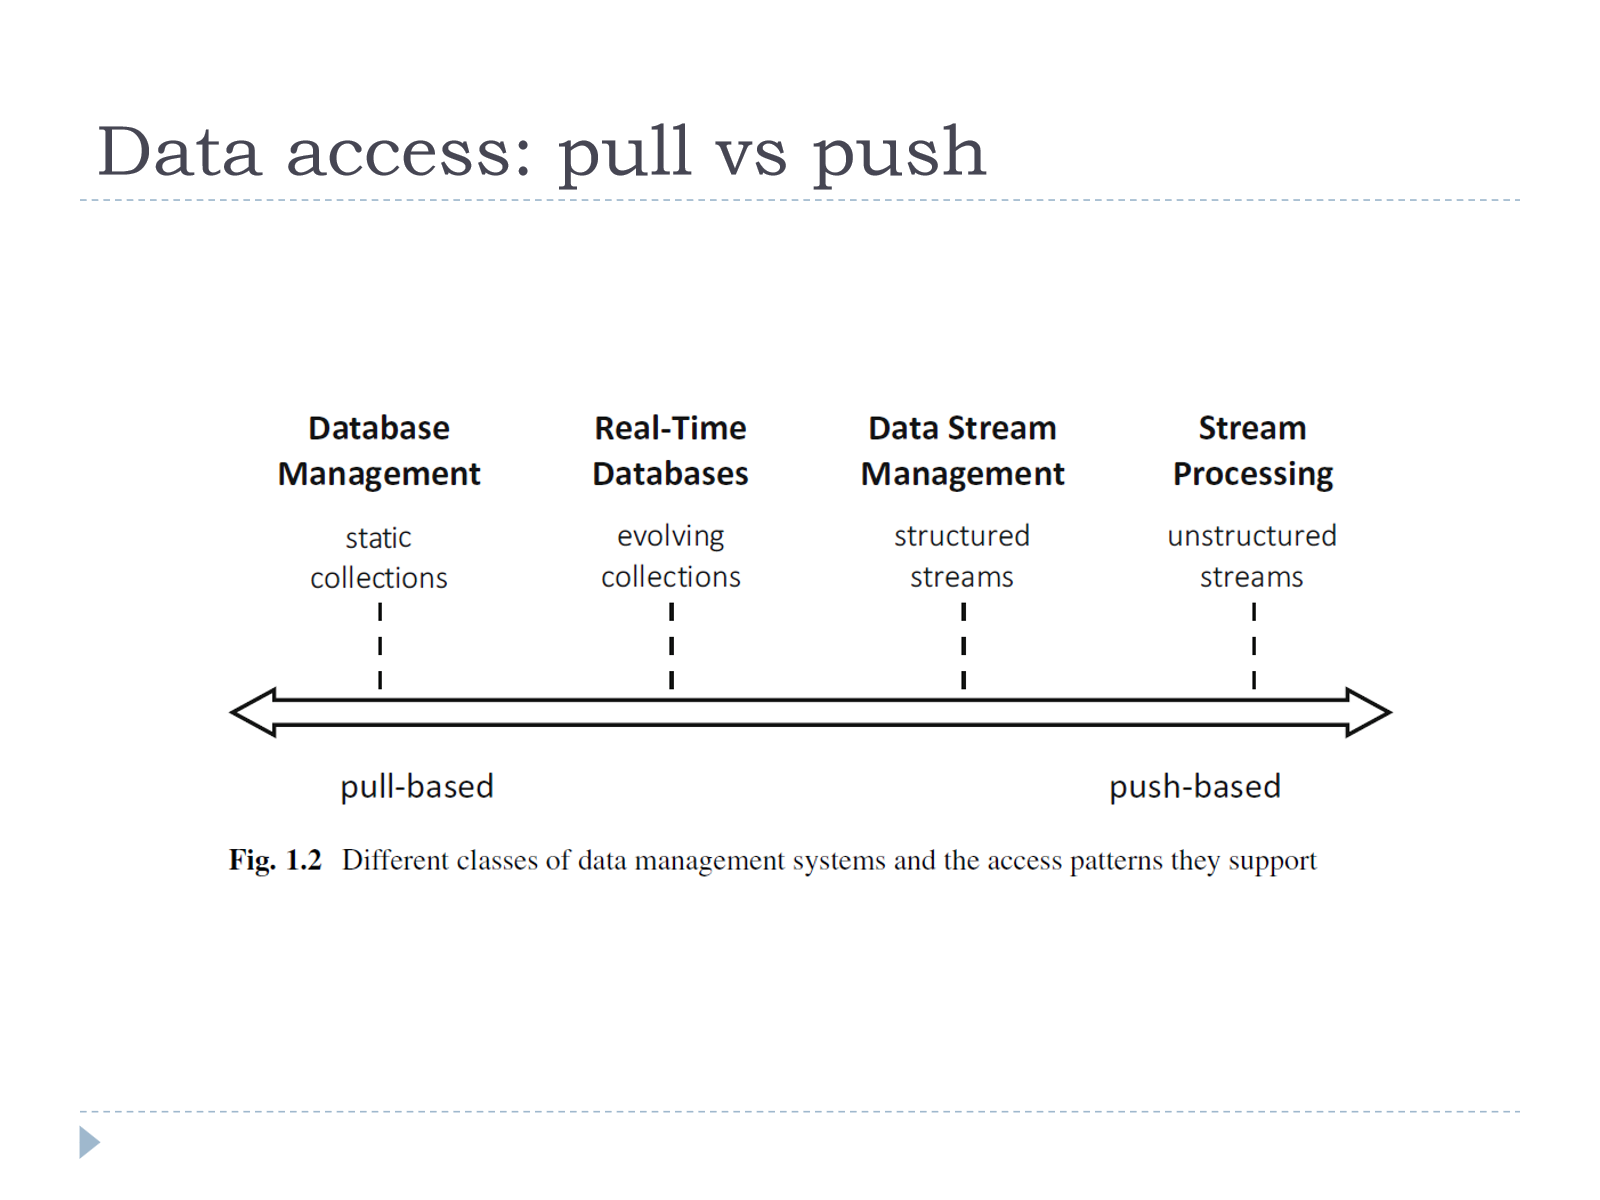
Urutan spektrum (dari pull ke push):
- Database Management — static collections, pull-based
- Real-Time Databases — evolving collections
- Data Stream Management — structured streams
- Stream Processing — unstructured streams, push-based
Query Semantics: Collections vs Streams
Streams dan collections mempromosikan perspektif berbeda terhadap data yang sama:
- Data stream: menangkap perubahan (changes) pada application state — direpresentasikan sebagai log kejadian berurutan berdasarkan timestamp (contoh:
Timestamp, Name, Action— mencatat setiap event login/logout). - Database collection: memberikan akses ke current state aplikasi — direpresentasikan sebagai snapshot terkini (contoh: tabel
Name, First login, Last login, Logged inyang menunjukkan status login masing-masing user saat ini).
Dengan kata lain, stream adalah rekaman histori perubahan, sedangkan collection adalah hasil akumulasi/state akhir dari perubahan-perubahan tersebut.
Stream Model
Secara formal, sebuah stream dimodelkan sebagai:
S = s_i, s_i+1, s_i+2, … dengan S_i = <data item, timestamp>
Artinya, stream adalah barisan tak terbatas dari pasangan (data item, timestamp) yang datang secara berurutan.
Data Stream Management
- Data Stream: abstraksi dari infinite sequence of db records.
- Base stream: raw data stream yang datang/tiba di sistem (input mentah).
- Derived stream: stream hasil dari transformasi data (misalnya hasil query) yang diturunkan dari base stream.
Karena bersifat unbounded/infinite, tidak mungkin menyimpan semua data pada sebuah data stream. Oleh karena itu, incoming records hanya disimpan untuk waktu terbatas, dan setelah periode tersebut data akan dibuang (di-drop).
Queries over Stream
Queries over Stream adalah query yang bersifat long-running dan menghasilkan output baru setiap kali menerima data baru — hasilnya berupa output stream (bukan hasil sekali jalan seperti query pada database biasa).
Sistem stream dapat mendukung dua model:
- Append-only stream: tidak ada record yang diubah atau dihapus setelah ditambahkan.
- Mutable stream: record dapat diubah atau dihapus setelah masuk ke stream.
Salah satu issue utama pada queries over stream adalah penanganan record yang datang terlambat (late-arriving records) — ini berkaitan erat dengan konsep event time yang dibahas berikutnya.
Event Time vs Processing Time vs Ingestion Time
Sebuah record pada stream dapat membawa beberapa jenis informasi waktu:
- Arrival time / ingestion time: waktu record tersebut masuk ke dalam sistem data stream management.
- Event time: waktu ketika event tersebut sebenarnya dibangkitkan pada sumbernya (misalnya waktu sensor merekam data, bukan waktu data itu sampai ke server).
Dalam praktiknya, arrival time dan event time seringkali tidak match:
- Dapat terdelay hingga waktu yang cukup lama (misalnya karena masalah jaringan, device offline, dsb).
- Record dapat datang dengan urutan berbeda dari urutan event time-nya (out-of-order).
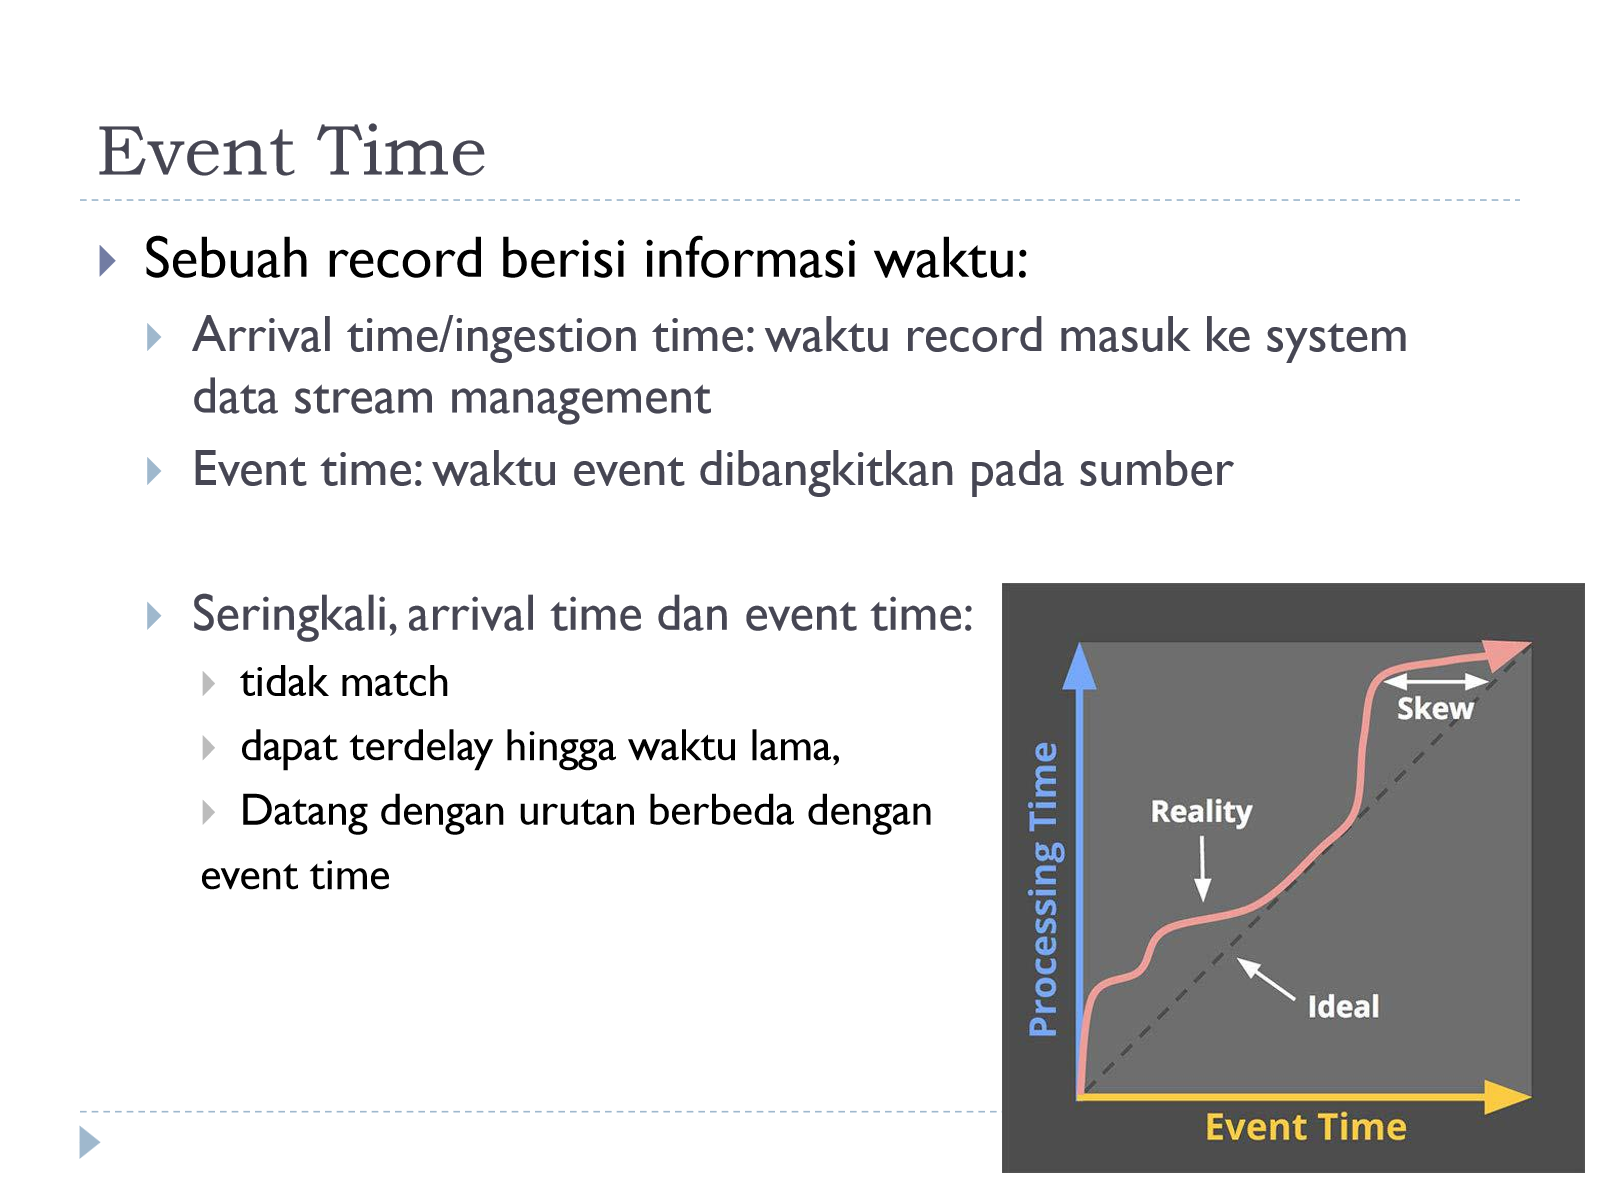
Grafik di atas menggambarkan hubungan Processing Time (sumbu vertikal) terhadap Event Time (sumbu horizontal). Garis putus-putus diagonal adalah kondisi Ideal (processing time = event time, tidak ada delay). Garis merah bergelombang adalah Reality, yang menunjukkan adanya Skew (selisih/pergeseran) antara kapan event terjadi dan kapan event tersebut benar-benar diproses — skew ini bisa membesar/mengecil sepanjang waktu tergantung kondisi jaringan dan beban sistem.
Penanganan Urutan dan Keterlambatan (Watermark)
- Stream umumnya diurutkan berdasarkan arrival time.
- Untuk stream reordering (mengurutkan ulang berdasarkan event time), stream umumnya di-buffer untuk sejumlah waktu tertentu (dinotasikan t∆), dan item di dalam buffer tersebut kemudian diurutkan.
- Record yang datang setelah t∆ akan di-drop (dianggap terlalu terlambat).
- Output stream dapat diupdate saat menerima record yang terlambat, namun ini berisiko menurunkan performance system jika output stream harus disimpan dalam periode yang cukup lama (karena harus terus menunggu kemungkinan update).
- Pembatasan waktu tunggu ini bisa dilakukan dengan: fixed value/time, atau menggunakan mekanisme punctuation / watermark / heartbeat — yaitu sinyal khusus dalam stream yang menandakan “tidak akan ada lagi data dengan event time lebih kecil dari nilai watermark ini”.
Time Agnostic Processing
Beberapa jenis pemrosesan pada stream sebenarnya tidak memerlukan informasi waktu sama sekali (time agnostic):
- Filtering: bersifat stateless, dapat dilakukan per data item secara independen. Implementasi umum: hash table atau bloom filter.
- Inner join: hanya melibatkan elemen-elemen yang current (saat itu berada dalam window kerja), bersifat stateful (perlu menyimpan state sementara untuk mencocokkan pasangan data). Contoh implementasi: hash join.
- Approximate Processing: contohnya streaming k-means dan sketches (struktur data probabilistik untuk estimasi). Karakteristiknya: low overhead, namun tetap memiliki notion of time tertentu untuk membatasi data yang diproses.
Windowing
Windowing adalah teknik membagi stream yang unbounded menjadi potongan-potongan (window) berukuran terbatas, sehingga dapat dilakukan agregasi/komputasi. Terdapat tiga jenis window utama:
| Jenis Window | Nama Lain | Karakteristik |
|---|---|---|
| Fixed | Tumbling | Window dengan ukuran tetap dan tidak overlap — setiap data hanya masuk ke satu window |
| Sliding | Hopping | Window bergerak/bergeser dengan interval tertentu, dapat overlap antar window sehingga satu data bisa masuk ke lebih dari satu window |
| Session | - | Window ditentukan berdasarkan aktivitas (activity-based) — window berakhir ketika terjadi periode “diam”/idle tertentu, sehingga ukurannya dinamis per key |
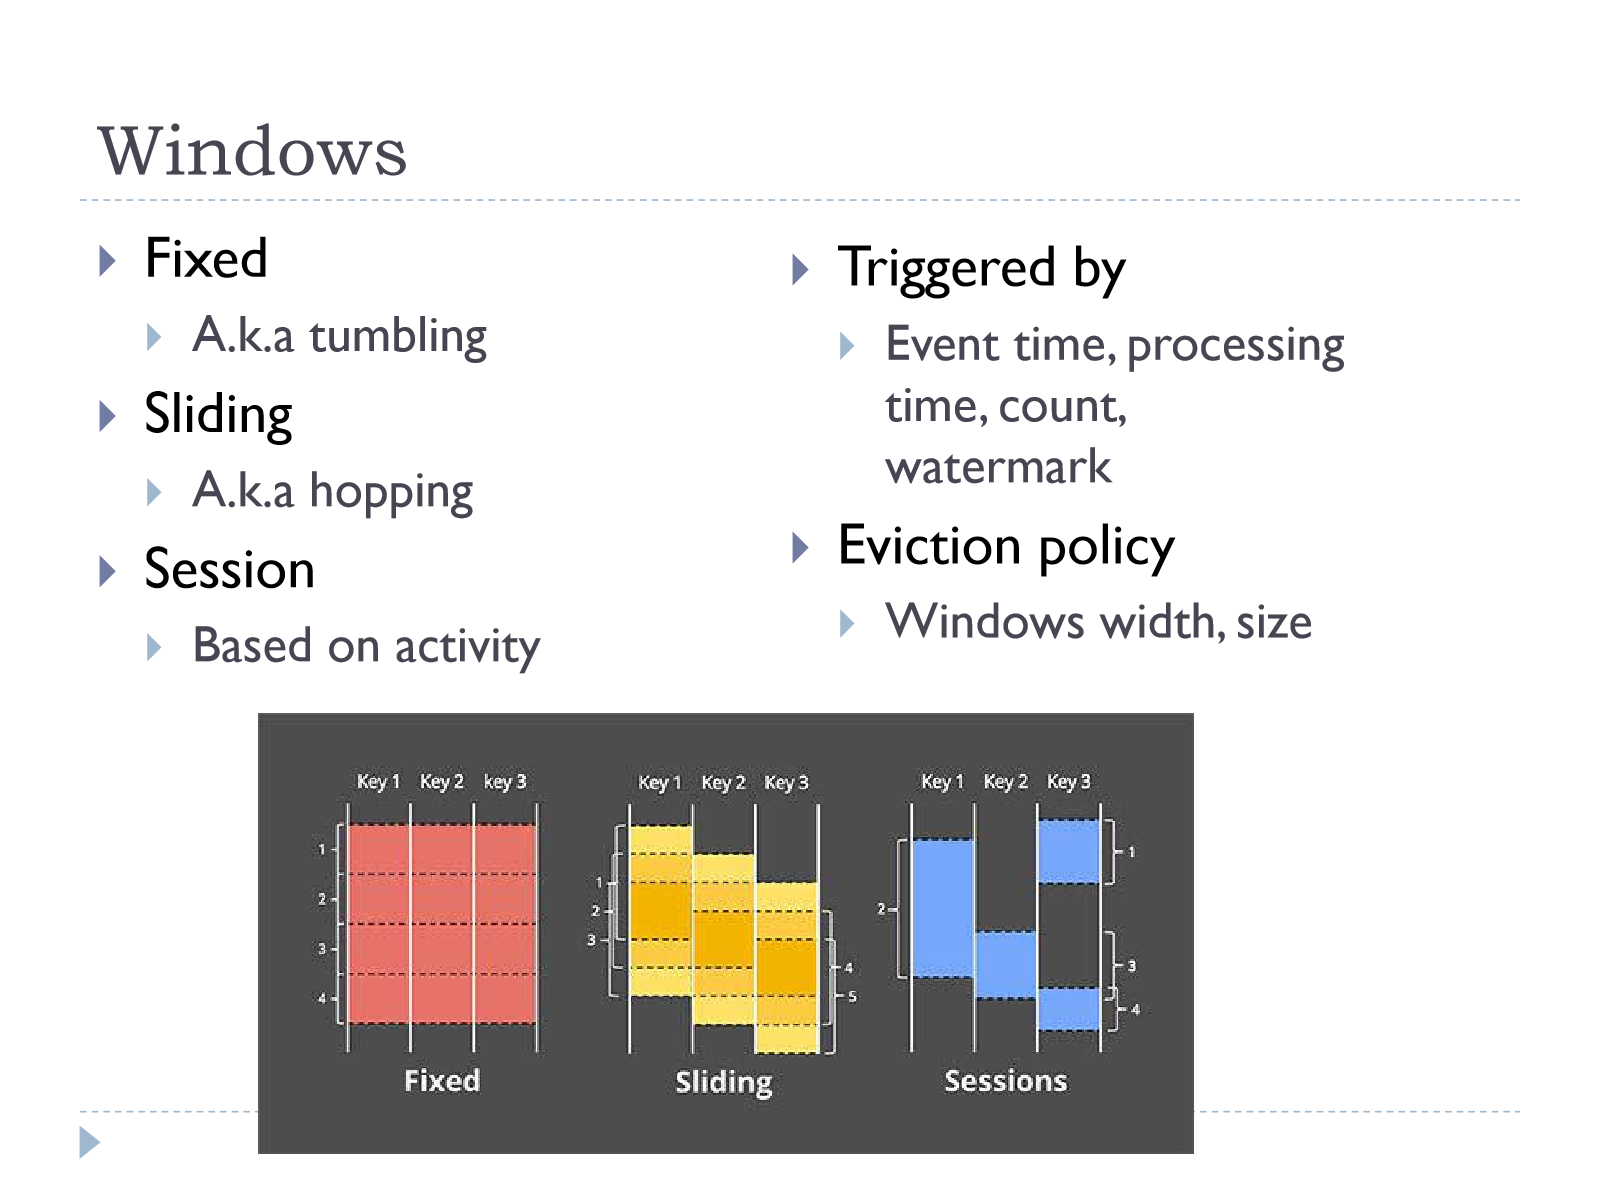
Pada gambar di atas, dapat dilihat perbandingan visual: Fixed window membagi timeline menjadi blok-blok sama besar untuk semua key; Sliding window menghasilkan window yang saling overlap (perhatikan angka 1-5 yang menunjukkan window saling tumpang tindih); Sessions menghasilkan window dengan ukuran bervariasi tergantung pola aktivitas tiap key.
Window juga memiliki dua komponen konfigurasi penting:
- Triggered by: kapan window dianggap “matang”/siap menghasilkan output — bisa berdasarkan event time, processing time, count (jumlah data), atau watermark.
- Eviction policy: kapan data di dalam window dibuang — ditentukan oleh window width (lebar window) dan size.
Processing Time Window
- Sistem menunggu selama x time units, lalu men-trigger komputasi window.
- Sistem yang menentukan bagaimana stream dipartisi ke dalam window (bukan berdasarkan waktu event data itu sendiri).
- Simple, mudah diimplementasikan.
- Kelemahan: mengabaikan informasi waktu yang ada pada stream itu sendiri → hasil agregasi bisa menjadi arbitrary (tidak konsisten, tergantung kapan data tiba, bukan kapan event sebenarnya terjadi).
- Konsep serupa: Counting Windows (window ditentukan berdasarkan jumlah data, bukan waktu).
Event Time Window
- Window dibentuk berdasarkan informasi waktu (event time) yang terkandung dalam stream, bukan waktu kedatangan/processing.
- Adheres to stream semantic — sesuai dengan makna semantik dari data stream itu sendiri.
- Menghasilkan correct calculations (perhitungan yang benar sesuai kapan event sebenarnya terjadi).
- Konsekuensi: memerlukan buffering, karena data yang datang berpotensi unordered/out-of-order terhadap event time-nya.
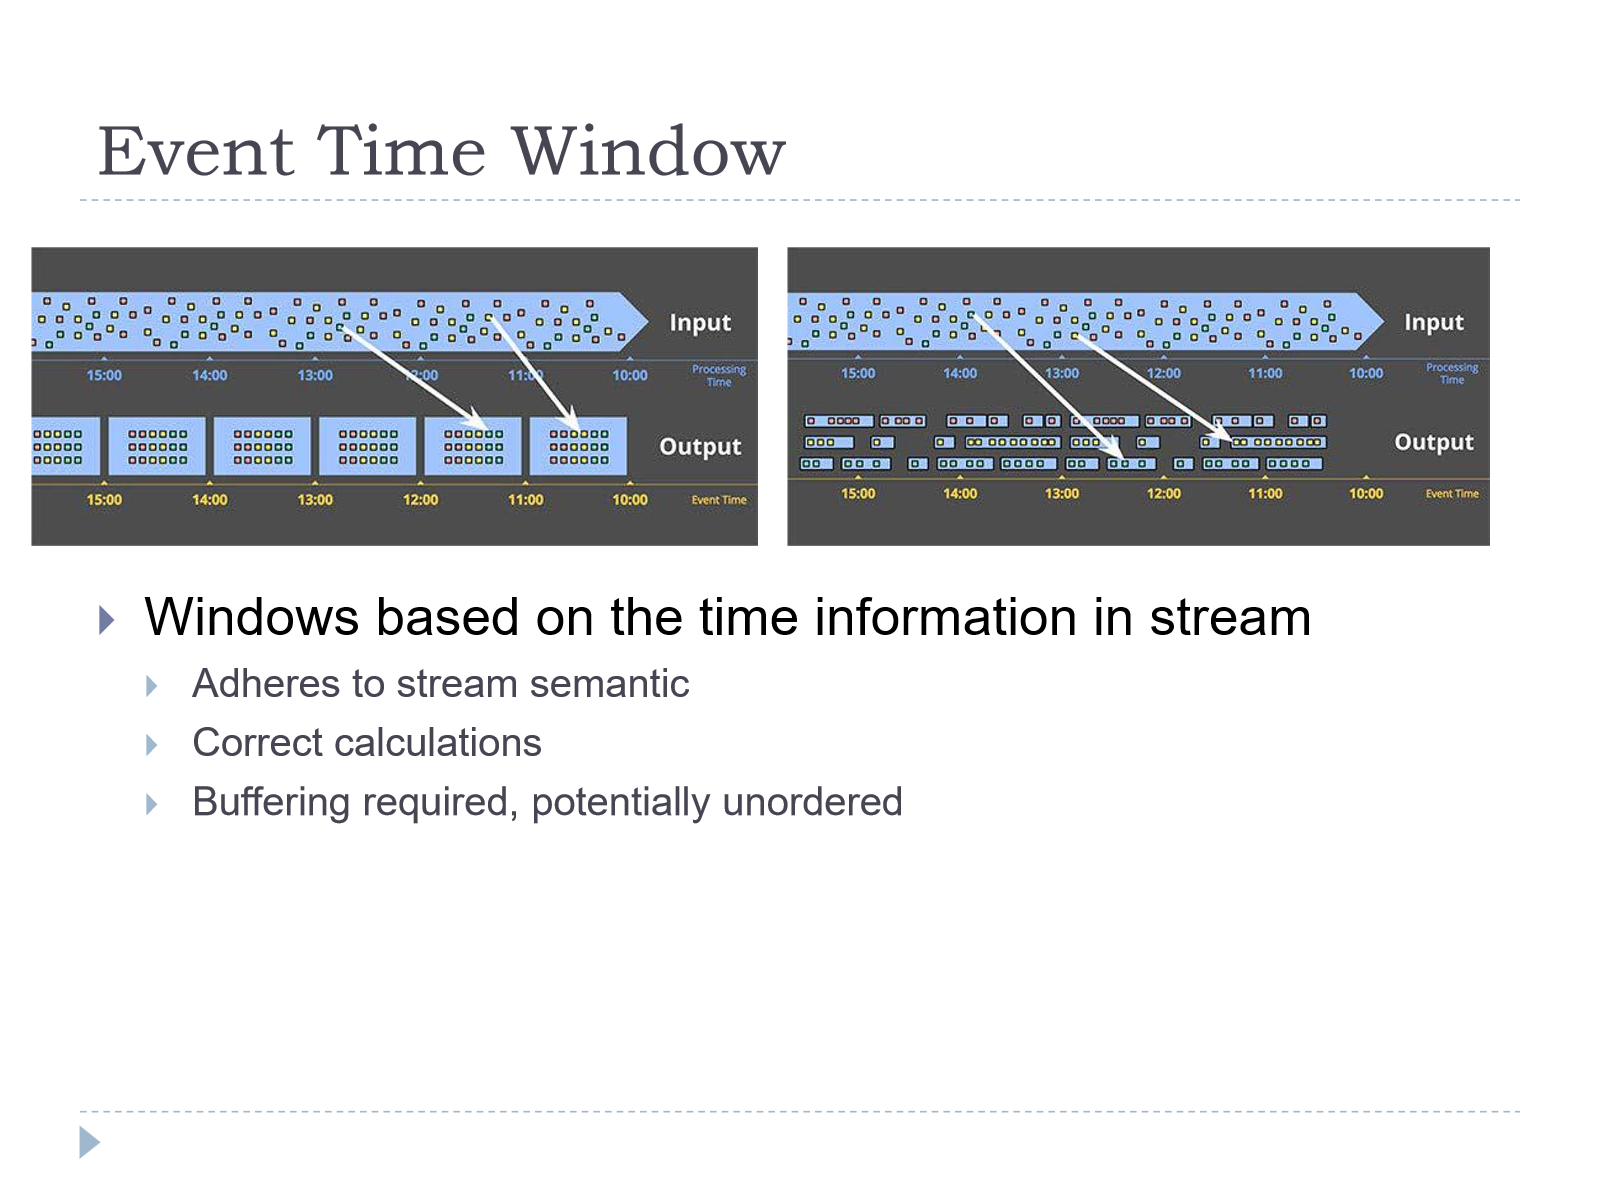
Ilustrasi di atas membandingkan dua kasus: pada gambar kiri, data yang datang terlambat (garis panah melengkung dari processing time 13:00-an) tetap dipetakan ke output window event time yang benar (12:00) — namun window tersebut mungkin sudah “selesai” diproses lebih dulu. Gambar kanan menunjukkan bahwa jika ada data yang datang sangat terlambat, output pada window event time yang bersangkutan (misalnya 12:00) bisa berubah/terupdate karena harus menyesuaikan data yang baru masuk.
Basic Stream Operator
Dua operator dasar yang umum digunakan pada stream processing:
- Windowed Aggregation: menghitung agregasi dalam sebuah window, contoh: rata-rata kecepatan (average speed), jumlah akses URL (sum of URL accesses), atau skor tertinggi harian (daily highscore).
- Windowed Join: menghubungkan observasi yang berkorelasi dalam suatu timeframe tertentu, contoh: data suhu (temperature) dalam rentang waktu tertentu.
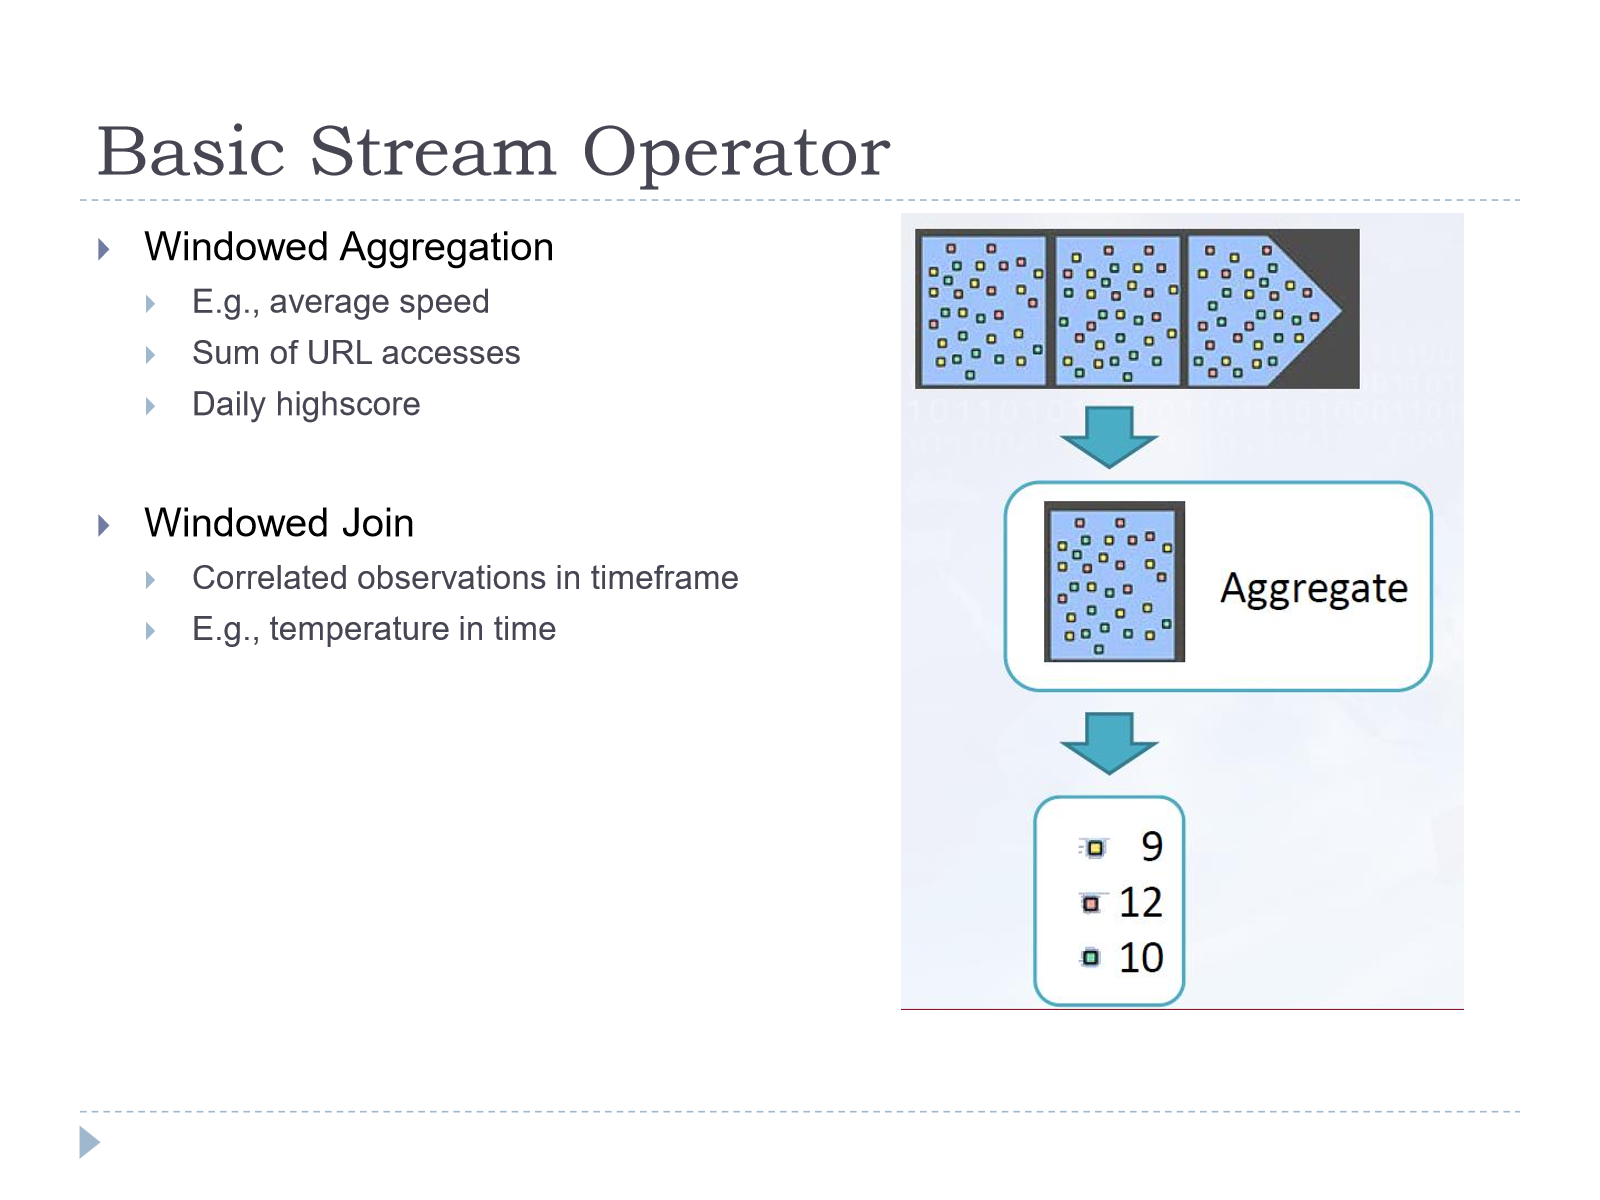
Diagram menunjukkan alur: stream data masuk → dikelompokkan ke dalam window → dilakukan Aggregate → menghasilkan output hasil agregasi per key.
Contoh: Flink’s Windowing API
Pada Apache Flink, window dapat dibentuk dari kombinasi (bahkan multiple) trigger dan eviction:
- Arbitrary tumbling, sliding, session, dsb. dapat dikonstruksi secara fleksibel.
- Trigger/eviction umum sudah tersedia langsung di API: berdasarkan Time (processing vs event time) atau Count.
- Fleksibilitas lebih lanjut: pengguna dapat mendefinisikan UDF (User-Defined Function) trigger/eviction sendiri.
Contoh kode:
dataStream.windowAll(TumblingEventTimeWindows.of(Time.seconds(5)));
dataStream.keyBy(0).window(TumblingEventTimeWindows.of(Time.seconds(5)));
Contoh Analisis: Windowed Aggregation pada Stock Stream
Slide memberikan contoh konkret analisis saham menggunakan window 10 detik yang dievaluasi tiap 5 detik:
val windowedStream = stockStream.window(Time.of(10, SECONDS)).every(Time.of(5, SECONDS))
val lowest = windowedStream.minBy("price")
val maxByStock = windowedStream.groupBy("symbol").maxBy("price")
val rollingMean = windowedStream.groupBy("symbol").mapWindow(mean _)
Dari satu window yang sama, dapat dihasilkan beberapa hasil analisis berbeda secara paralel: MinBy Price (global, harga terendah lintas semua simbol saham), MaxBy Price (per simbol saham, harga tertinggi), dan Mean Price (per simbol saham, rata-rata harga).
Complex Event Processing (CEP)
Complex Event Processing adalah teknik mendeteksi pola (patterns) dalam sebuah stream. Konsepnya:
- Complex event = sebuah sequence of events (rangkaian beberapa event sederhana yang membentuk satu kejadian kompleks).
- Didefinisikan menggunakan kombinasi kondisi:
- Logical: berdasarkan nilai data dan kombinasinya.
- Temporal: harus terjadi dalam periode waktu tertentu.
Contoh kasus: mendeteksi pola kenaikan lalu penurunan suhu drastis dalam window 5 menit pada satu stasiun sensor:
SEQ(A, B, C) WITH
  A.Temp > 23°C &&
  B.Station = A.Station && B.Temp < A.Temp &&
  C.Station = A.Station && A.Temp - C.Temp > 3
Composite events dapat dikonstruksi menggunakan operator seperti SEQ, AND, OR, NEG, misalnya:
SEQ(e1, e2) → (e1, t1) ∧ (e2, t2) ∧ t1 ≤ t2 ∧ e1, e2 ∈ W
Implementasi CEP umumnya dilakukan dengan mengonstruksi sebuah NFA (Non-deterministic Finite Automaton). Contoh untuk SEQ(A, B, C): state berpindah dari state awal (1) melalui transisi A ke state 2, kemudian transisi B ke state 3, lalu transisi C ke state akhir (4) — dengan self-loop (*) pada state 2 dan 3 untuk mengabaikan event lain yang tidak relevan di antaranya.
Big Data Streaming System
Overview Framework
Terdapat banyak sistem stream processing, baik closed source maupun open source:
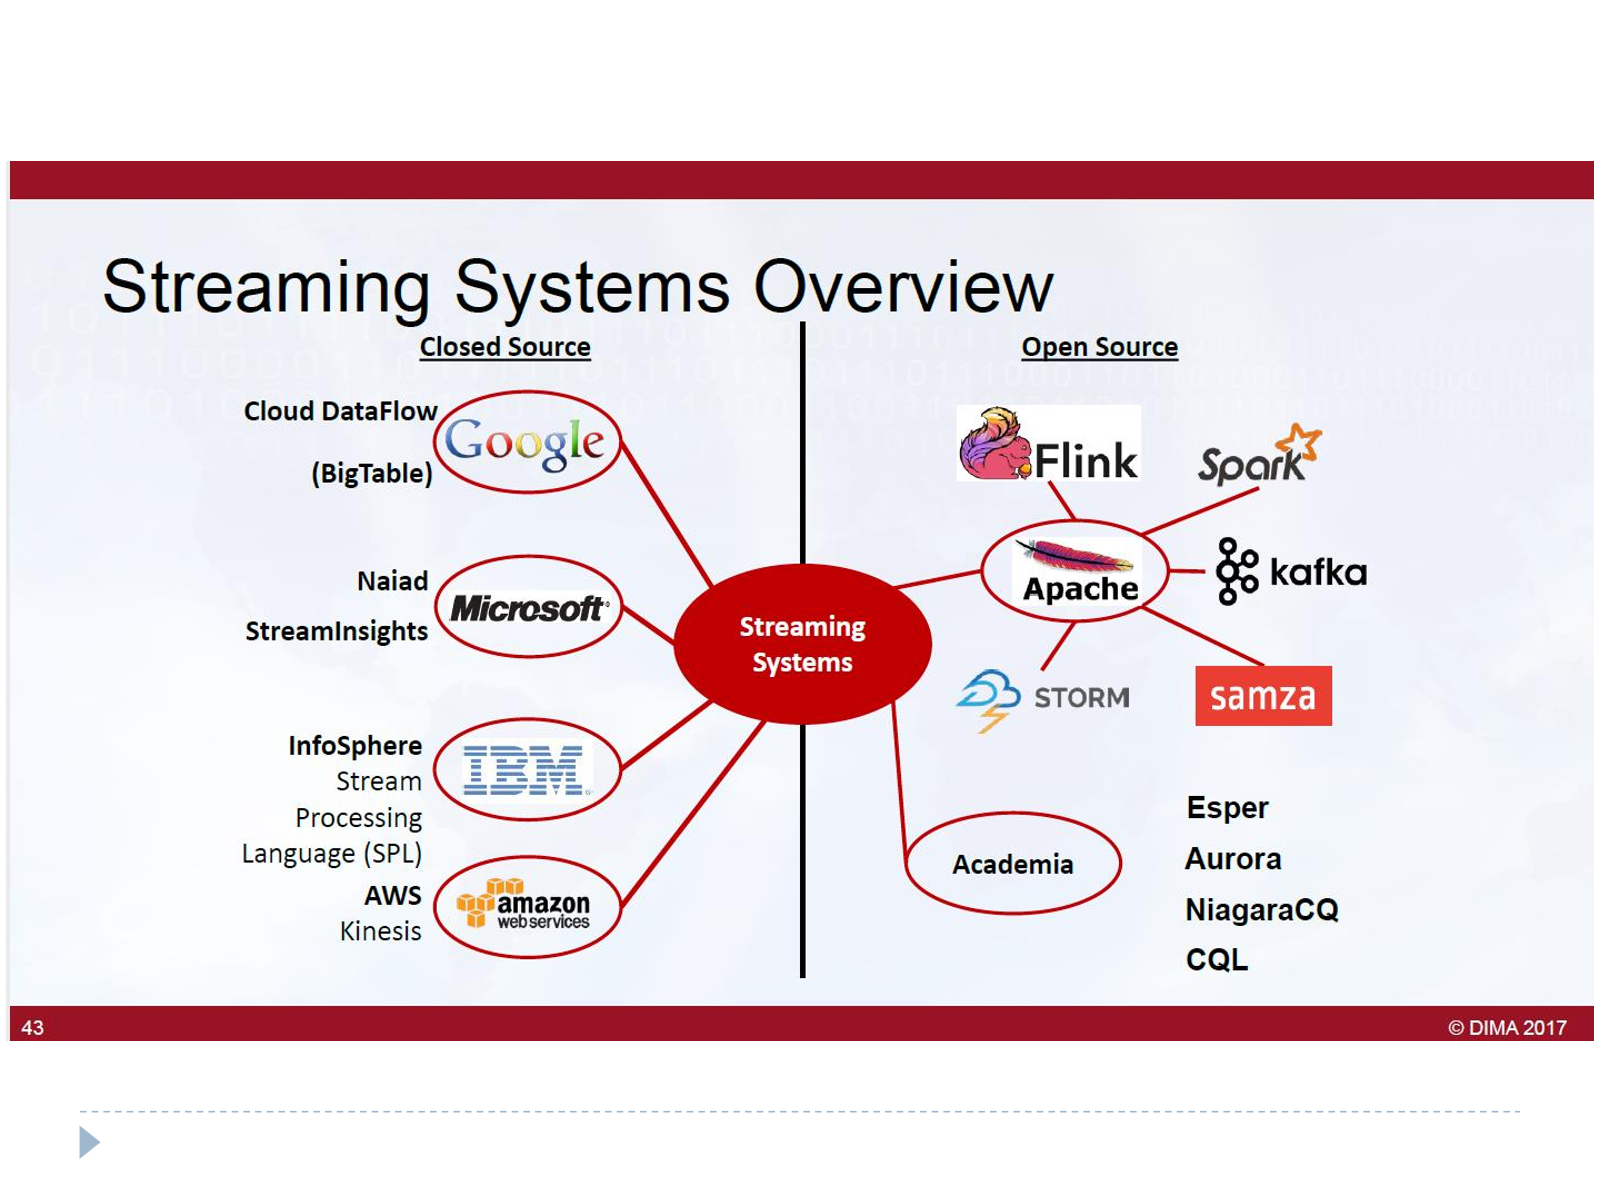
- Closed source: Google (Cloud DataFlow, BigTable), Microsoft (Naiad, StreamInsights), IBM (InfoSphere Stream Processing Language/SPL), AWS (Kinesis).
- Open source (Apache): Flink, Spark, Kafka, Storm, Samza.
- Academia: Esper, Aurora, NiagaraCQ, CQL.
Timeline Perkembangan
Berdasarkan timeline dari buku Akidau, Chernyak, & Lax (2018) — Streaming Systems: perkembangan dimulai dari MapReduce (2003) dan Hadoop (2005), diikuti oleh Flume, Storm, Spark, MillWheel, Kafka, Cloud Dataflow, Flink, hingga Apache Beam (2016) sebagai model pemersatu batch dan streaming.
MapReduce
- Dikembangkan di Google, 2003.
- Masalah utama yang diselesaikan: data processing sulit, scalability sulit, fault tolerance sulit.
- Fokus: Simplicity & Scalability.
- Alur kerja: Prepare → Map → Shuffle → Reduce → Produce.
Hadoop
- Dimulai 2005, awalnya untuk mengembangkan versi terdistribusi dari Nutch Webcrawler.
- Kontribusi utama: menyediakan HDFS dan Hadoop, yaitu versi open source dari MapReduce.
- Berkembang menjadi ekosistem tool: Pig, Hive, HBase, Crunch.
FlumeJava
- Successor MapReduce di Google (catatan: ini berbeda dengan Apache Flume).
- Masalah pada MapReduce: rigid (harus berbentuk Map–Shuffle–Reduce), dan tidak efisien karena banyak job yang seharusnya bisa dioptimasi tapi harus dieksekusi sebagai satu job map-reduce.
- FlumeJava menyediakan composable, high-level API untuk data pipeline, dengan mendefinisikan PCollection dan PTransform.
- Kontribusi: high-level pipeline dan automatic optimization (misalnya fusion optimization — menggabungkan operasi consumer-producer atau sibling menjadi satu operasi fisik).
Apache Storm
- Streaming system yang digunakan luas di industri, dikembangkan oleh Nathan Marz untuk kebutuhan Twitter processing.
- Fokus pada stream processing dengan mengutamakan low latency dibandingkan konsistensi.
- Menyediakan semantik at-most-once dan at-least-once, tanpa dukungan persistence bawaan.
- Untuk mendukung consistency, biasa digunakan bersamaan dengan pipeline Hadoop → membentuk Lambda Architecture.
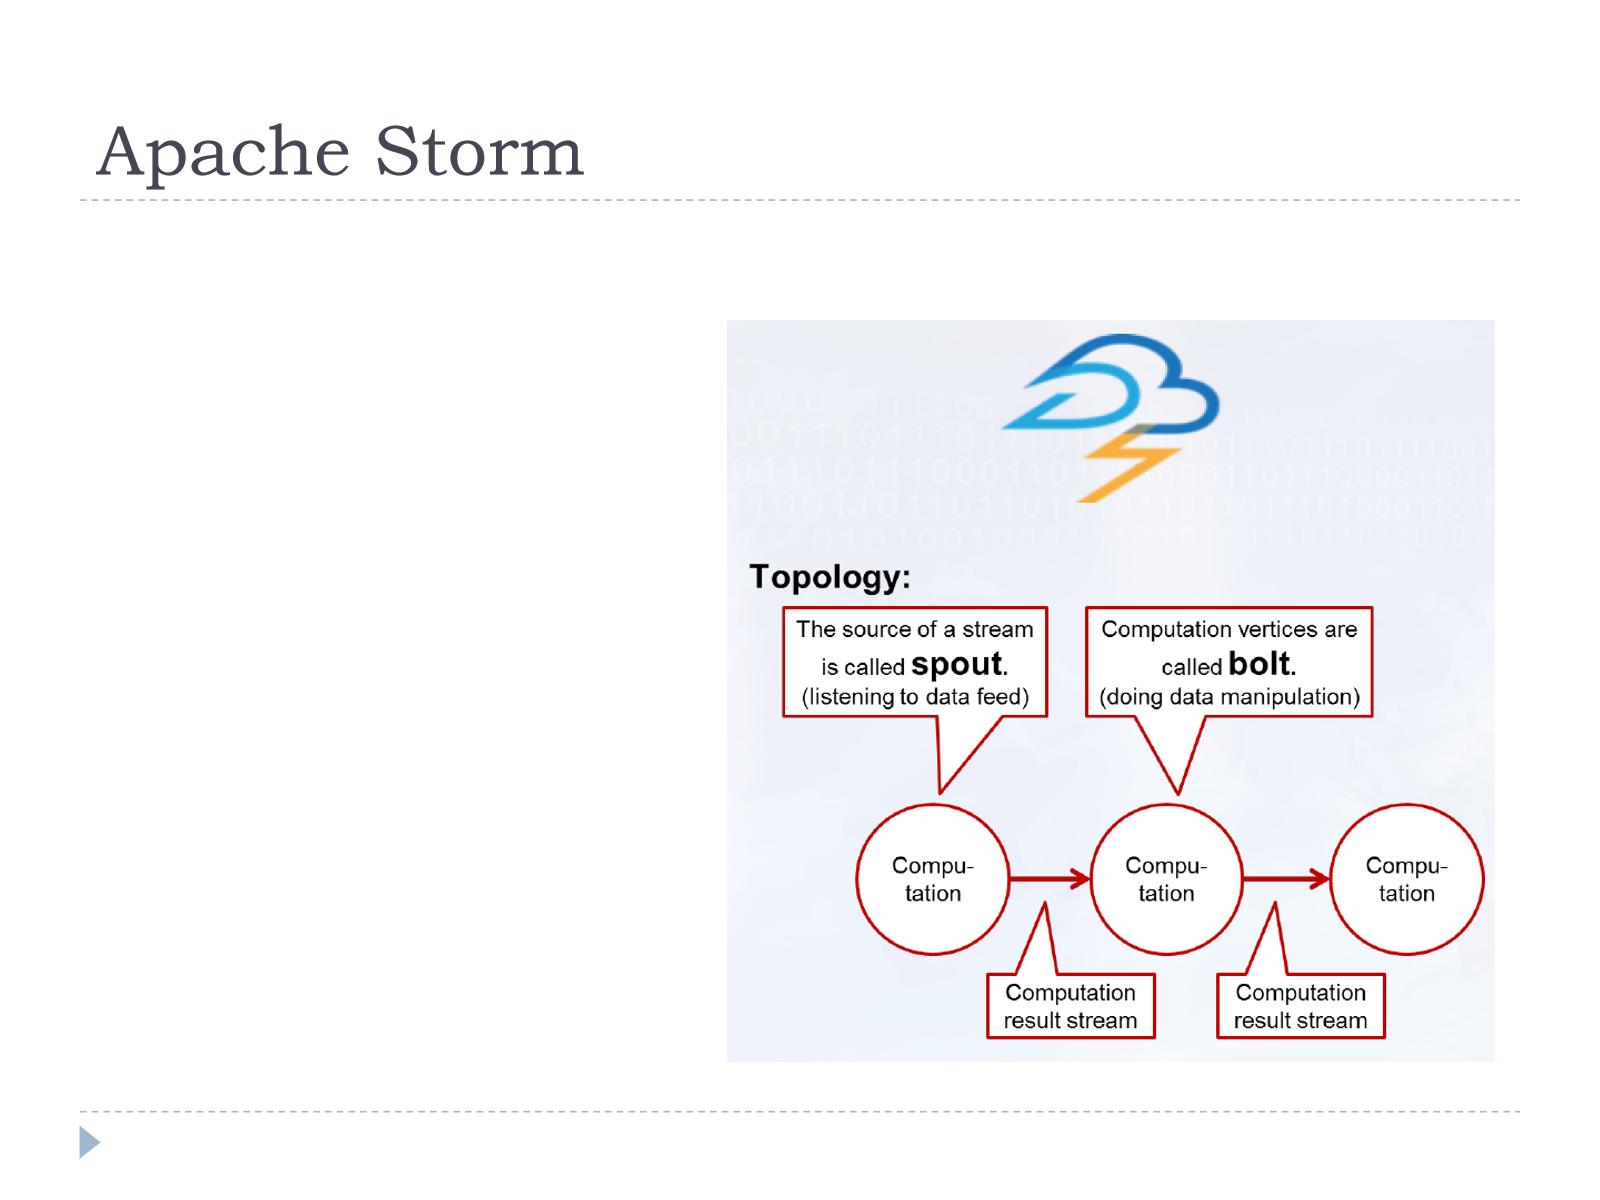
Konsep topologi pada Storm: spout adalah sumber dari stream (listening ke data feed), sedangkan bolt adalah vertex komputasi yang melakukan manipulasi data. Topologi terdiri dari rangkaian komputasi yang saling terhubung dan dapat menghasilkan computation result stream di berbagai titik.
Spark & Spark Streaming
- Dikembangkan di AMPLab, UC Berkeley, 2009.
- Konsep inti: RDD (Resilient Distributed Dataset).
- Dapat melakukan seluruh pipeline di memory, hanya melibatkan disk di awal dan akhir pipeline.
- Mencatat lineage data.
- Input selalu replayable.
- Komputasi bersifat deterministic.
- Spark Streaming: mengeksekusi Spark processing untuk stream sebagai multiple batch (micro-batch).
- Kelemahan pada versi 1.x: hanya mampu memproses berbasis processing time, bukan event time.
- Karakteristik: strong consistency, streaming processing.
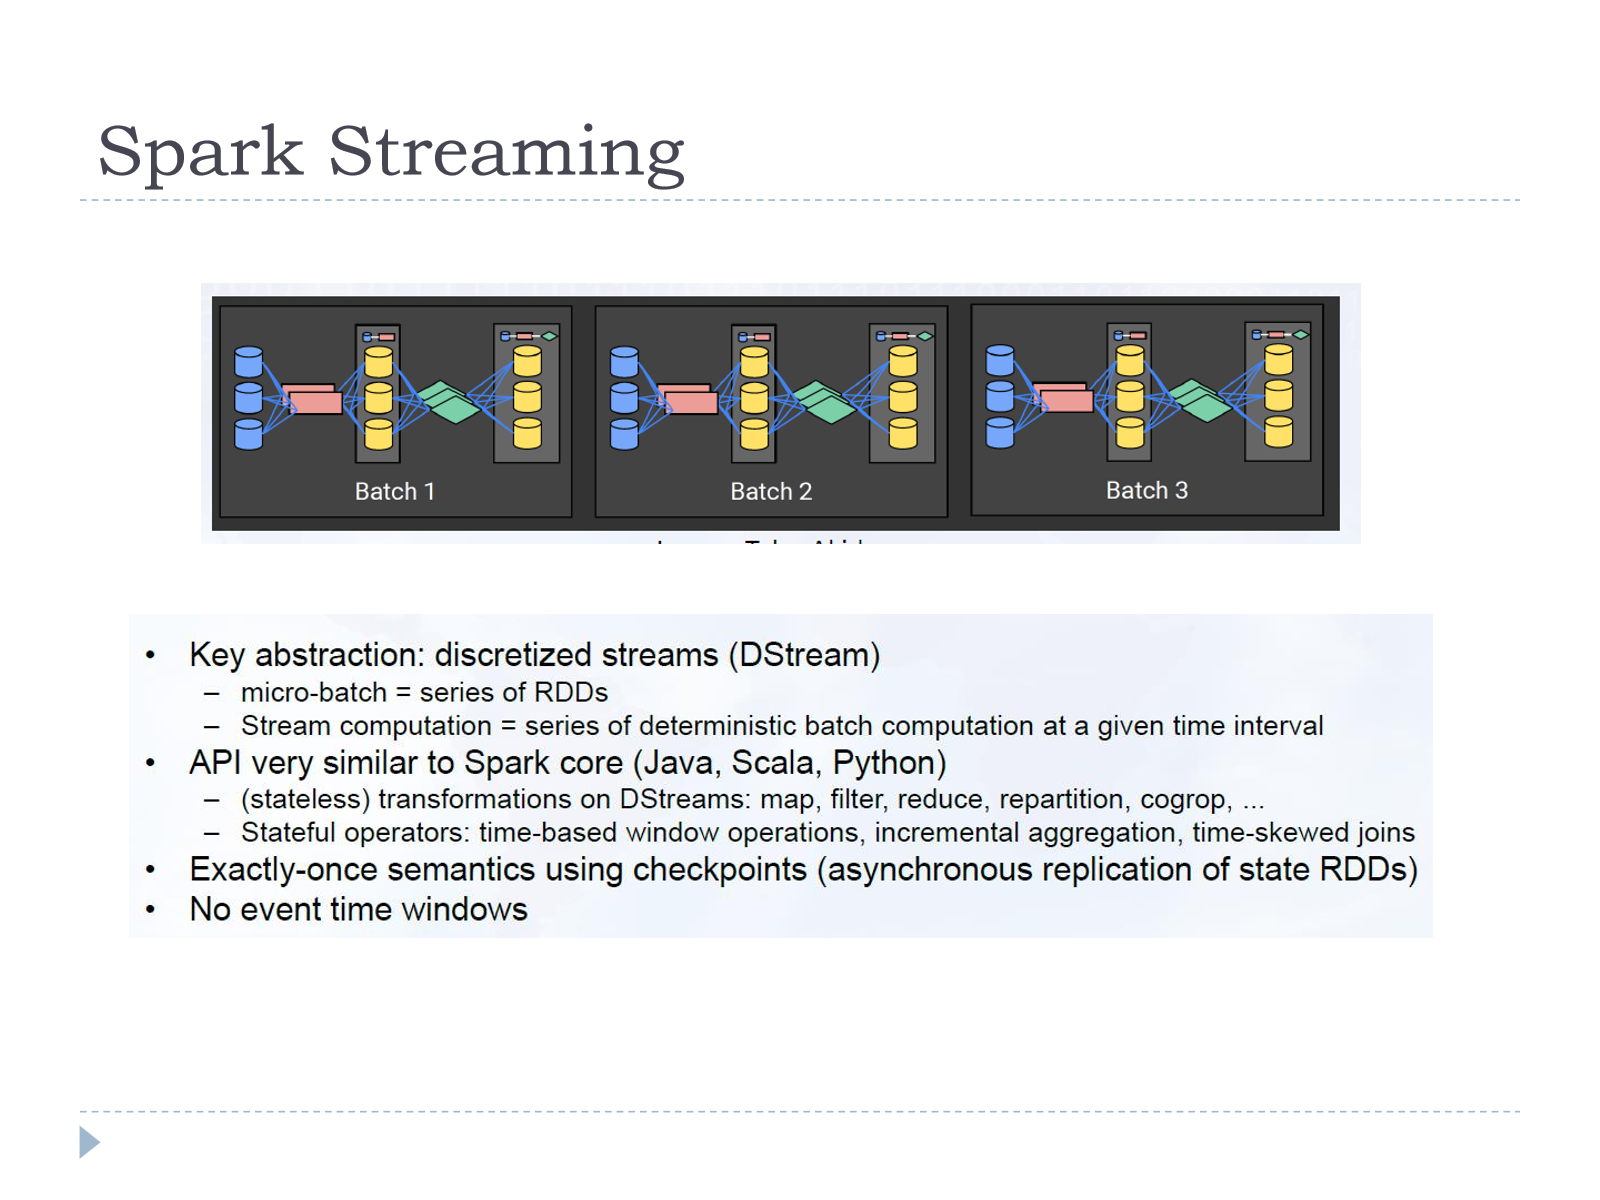
Detail Spark Streaming:
- Key abstraction: discretized streams (DStream) — micro-batch berupa series of RDDs, sehingga komputasi stream = series of deterministic batch computation pada interval waktu tertentu.
- API sangat mirip dengan Spark core (tersedia untuk Java, Scala, Python).
- Transformasi stateless pada DStream:
map,filter,reduce,repartition,cogroup, dsb. - Operator stateful: time-based window operations, incremental aggregation, time-skewed joins.
- Transformasi stateless pada DStream:
- Mendukung exactly-once semantics menggunakan checkpoints (asynchronous replication of state RDDs).
- Tidak mendukung event time windows (no event time windows).
Kafka
- Bukan merupakan data processing framework.
- Berperan sebagai transport layer untuk stream processing.
- Sangat berpengaruh (influential) pada perkembangan stream processing karena:
- Menyediakan durable, replayable input sources.
- Berfungsi sebagai elastic isolation layer antara producer dan consumer.
- Memperkenalkan konsep stream processing as databases.
- Apache Samza: streaming platform yang dibangun di atas Kafka.
Cloud Dataflow
- Layanan pemrosesan data fully managed berbasis cloud dari Google, diluncurkan 2015.
- Menawarkan unified batch & streaming programming model (satu model untuk keduanya).
- Fitur kunci: event time windows, flexible triggering, dan watermark.
- Berbasis pada paper “The Dataflow Model: A Practical Approach to Balancing Correctness, Latency, and Cost in Massive-Scale, Unbounded, Out-of-Order Data Processing”.
Apache Flink
- Menyediakan stateful computations over data stream.
- Mengikuti Dataflow/Beam programming model.
- Bersifat open source.
- Memiliki highly efficient snapshotting implementation (untuk fault tolerance/checkpointing).
- Dapat digunakan untuk tiga jenis kebutuhan: Event-driven Applications, Streaming Pipelines, dan Stream & Batch Analytics — menerima input dari berbagai sumber real-time (Transactions, Logs, IOT, Clicks) maupun dari storage (Database, File System, KV-Store).
Apache Beam
- Open source, mengikuti Dataflow/Beam programming model.
- Menyediakan runner yang dapat berjalan di atas berbagai framework berbeda, seperti Flink, Spark, Google Dataflow — dengan prinsip “write once, run anywhere”.
- SDK tersedia untuk berbagai bahasa: Java, Python, Go, SQL, dan lainnya.
- Mendukung berbagai use case: stream & batch analytics, data enrichment, machine learning, anomaly detection.
Perbandingan Batch Processing vs Stream Processing
Merangkum keseluruhan materi, berikut perbandingan konseptual antara batch processing dan stream processing:
| Aspek | Batch Processing | Stream Processing |
|---|---|---|
| Sifat data | Bounded (finite, sudah lengkap) | Unbounded (infinite, terus mengalir) |
| Pola akses | Pull-based (query terhadap data tersimpan) | Push-based (publish/subscribe) |
| Model data | Persistent collection | Ephemeral stream |
| Eksekusi | Ad hoc, dijalankan sekali per job, hasil final | Continuous, long-running query, output terus diperbarui |
| Latency | Tinggi (menunggu seluruh data terkumpul) | Rendah (near real-time) |
| Konsep waktu | Umumnya tidak relevan (semua data sudah ada) | Krusial: event time vs processing time vs ingestion time |
| Penanganan data terlambat | Tidak relevan (data sudah lengkap) | Perlu watermark/buffering untuk out-of-order data |
| Contoh sistem | MapReduce, Hadoop, FlumeJava | Storm, Spark Streaming, Kafka, Flink, Cloud Dataflow, Beam |
| Contoh use case | Laporan harian/bulanan, ETL periodik | Real-time analytics, fraud detection, monitoring IoT, complex event processing |
Flashcard
flashcards Apa perbedaan utama antara bounded data dan unbounded data? :: Bounded data bersifat finite/terbatas dan dapat diproses selesai dengan batch engine klasik (mis. MapReduce), sedangkan unbounded data bersifat infinite dan terus mengalir sehingga harus diproses menggunakan windowing atau stream processing. Apa itu push model pada stream, dan bagaimana hubungannya dengan publish/subscribe? :: Push model berarti produksi data dikendalikan oleh sumber (bukan diminta consumer melalui pull), yang direalisasikan melalui pola publish/subscribe — sumber mem-publish data begitu tersedia, consumer men-subscribe untuk menerimanya. Apa perbedaan event time dan processing time (ingestion time)? :: Event time adalah waktu ketika event sebenarnya dibangkitkan pada sumber, sedangkan processing time/ingestion time adalah waktu ketika record tersebut masuk/diproses oleh sistem. Keduanya seringkali tidak match karena adanya delay dan out-of-order arrival. Apa fungsi watermark pada stream processing? :: Watermark adalah sinyal/penanda yang menyatakan bahwa tidak akan ada lagi data dengan event time lebih kecil dari nilai watermark tersebut, digunakan untuk membatasi berapa lama sistem harus menunggu/buffer data yang mungkin datang terlambat sebelum sebuah window ditutup. Sebutkan tiga jenis windowing pada stream processing dan perbedaannya. :: (1) Fixed/Tumbling: window berukuran tetap dan tidak overlap; (2) Sliding/Hopping: window bergeser dengan interval tertentu dan dapat overlap; (3) Session: window berdasarkan aktivitas, berakhir saat ada periode idle tertentu sehingga ukurannya dinamis. Apa perbedaan Processing Time Window dan Event Time Window? :: Processing Time Window menunggu selama x waktu tertentu dan mengabaikan informasi waktu pada data (simpel tapi hasil agregasi bisa arbitrary), sedangkan Event Time Window dibentuk berdasarkan waktu event pada data itu sendiri sehingga hasilnya lebih benar (correct) tapi memerlukan buffering karena data bisa datang out-of-order. Mengapa Kafka bukan disebut sebagai data processing framework? :: Karena Kafka berfungsi sebagai transport layer (message broker) yang menyediakan durable dan replayable input sources serta menjadi elastic isolation layer antara producer dan consumer, bukan melakukan komputasi/transformasi data seperti Flink atau Spark Streaming. Apa kelemahan Spark Streaming versi 1.x terkait konsep waktu? :: Spark Streaming v1.x hanya mampu memproses berbasis processing time (micro-batch/DStream), belum mendukung event time windows, sehingga kurang akurat untuk data yang datang out-of-order atau terlambat. Apa yang dimaksud dengan Complex Event Processing (CEP)? :: CEP adalah teknik mendeteksi pola (pattern) dalam sebuah stream, di mana sebuah complex event merupakan sequence of events yang didefinisikan menggunakan kondisi logical (nilai data) dan temporal (rentang waktu), umumnya diimplementasikan dengan NFA. Apa perbedaan filtering dan inner join dalam konteks time agnostic processing? :: Filtering bersifat stateless dan dapat dilakukan per data item secara independen (mis. dengan hash table/bloom filter), sedangkan inner join bersifat stateful karena harus menyimpan state elemen-elemen current untuk dicocokkan (mis. dengan hash join).