Materi ini menggabungkan tiga topik yang saling terkait erat: system reliability, arsitektur scalable, dan system design. Reliability (keandalan sistem tetap berjalan meski ada failure) dan scalability (kemampuan menangani pertumbuhan beban) adalah dua fondasi yang selalu muncul bersamaan saat mendesain sistem terdistribusi skala besar — dan keduanya dipraktikkan langsung lewat studi kasus system design (evolusi arsitektur sebuah web service dari melayani ribuan hingga ratusan ribu pengguna). Topik ini sangat relevan untuk capaian memahami reliabilitas, konsistensi, dan skalabilitas sistem terdistribusi.
System Reliability
Reliability vs Resilience
- Reliability: kualitas untuk dapat dipercaya (trustworthy) atau bekerja secara konsisten baik dari waktu ke waktu.
- Resilience: kapasitas untuk pulih dengan cepat dari kesulitan; ketangguhan, kemampuan sebuah sistem untuk “kembali ke bentuk semula” setelah mengalami gangguan.
Service Reliability Hierarchy
Konsep ini diadaptasi dari Google SRE Book (Mikey Dickerson), digambarkan sebagai piramida kebutuhan reliability dari fondasi ke puncak: Monitoring → Incident Response → Postmortem/Root Cause Analysis → Testing + Release Procedures → Capacity Planning → Development → Product.
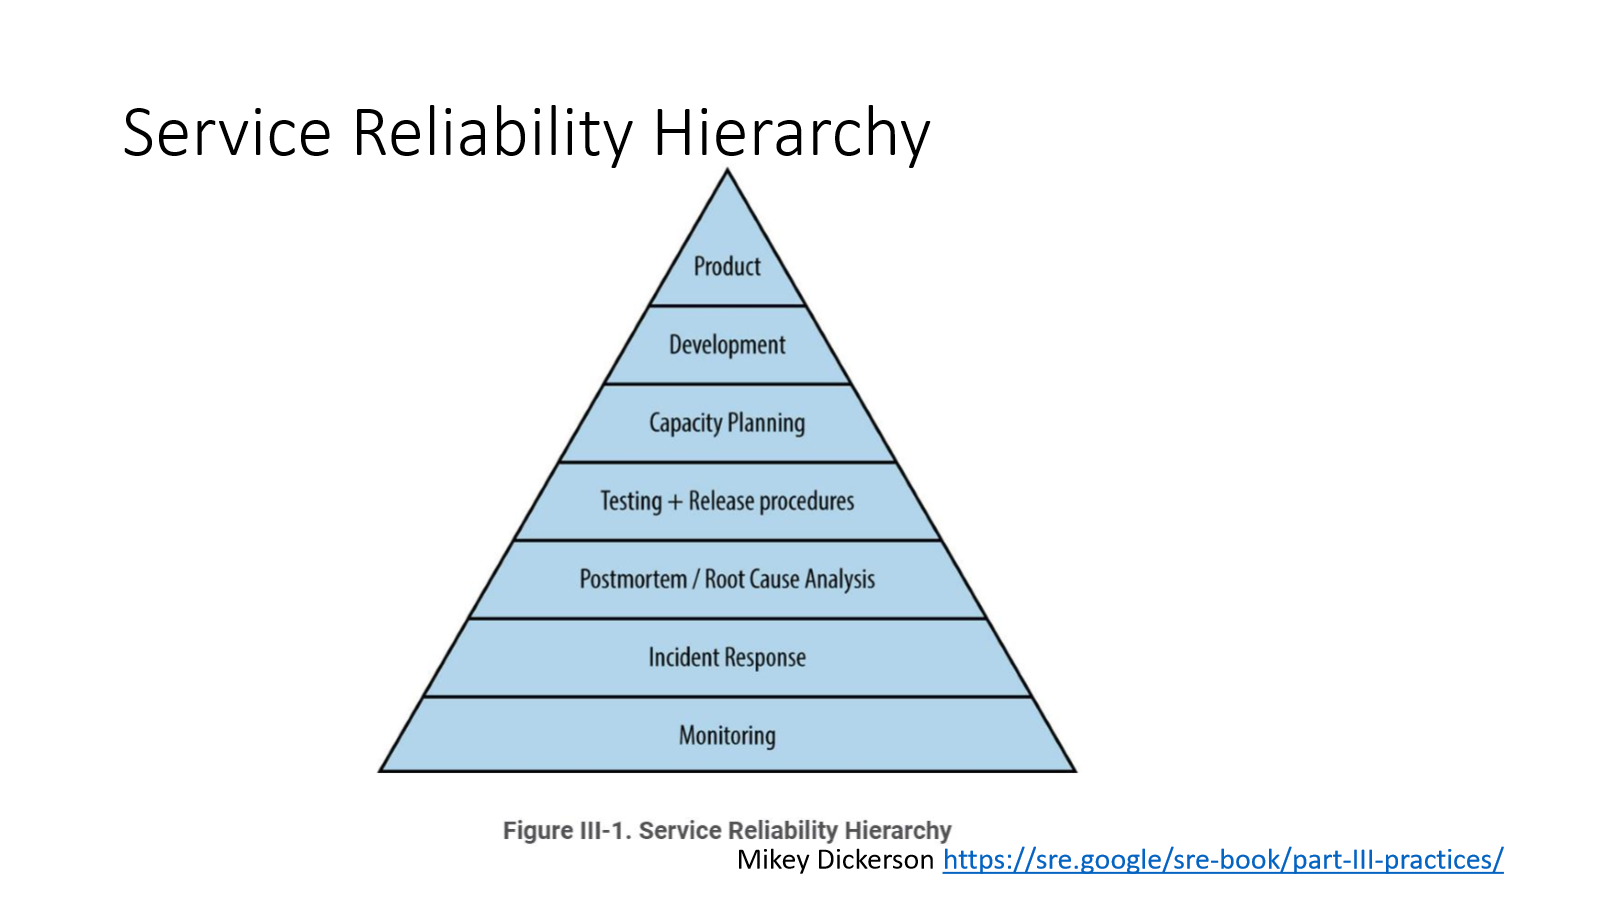
Penjelasan tiap lapisan:
- Monitoring: tanpa monitoring, tidak mungkin diketahui apakah sebuah service berjalan normal atau tidak. Di dalamnya ada Alerting, yaitu mekanisme notifikasi otomatis jika ada masalah.
- Incident Response: penanganan incident yang tepat akan meningkatkan reliability. Mencakup effective troubleshooting, emergency response (“jangan panik”), dan incident management dengan prioritas: resolve problem → restore service → cari root cause. Perlu disiapkan (prepare) dan didokumentasikan incident handling procedure sejak awal.
- Postmortem/Root Cause Analysis: pembelajaran pasca-insiden.
- Testing + Release Procedures: memastikan perubahan tidak merusak sistem.
- Capacity Planning: memastikan resource cukup untuk menjalankan service.
- Development: penanganan critical state seperti distributed consensus.
Incident Response & Emergency Response
Proses troubleshooting umum mengikuti alur: Problem Report → Triage → Examine → Diagnose → Test/Treat → Cure (dengan kemungkinan re-triaging jika situasi berubah).
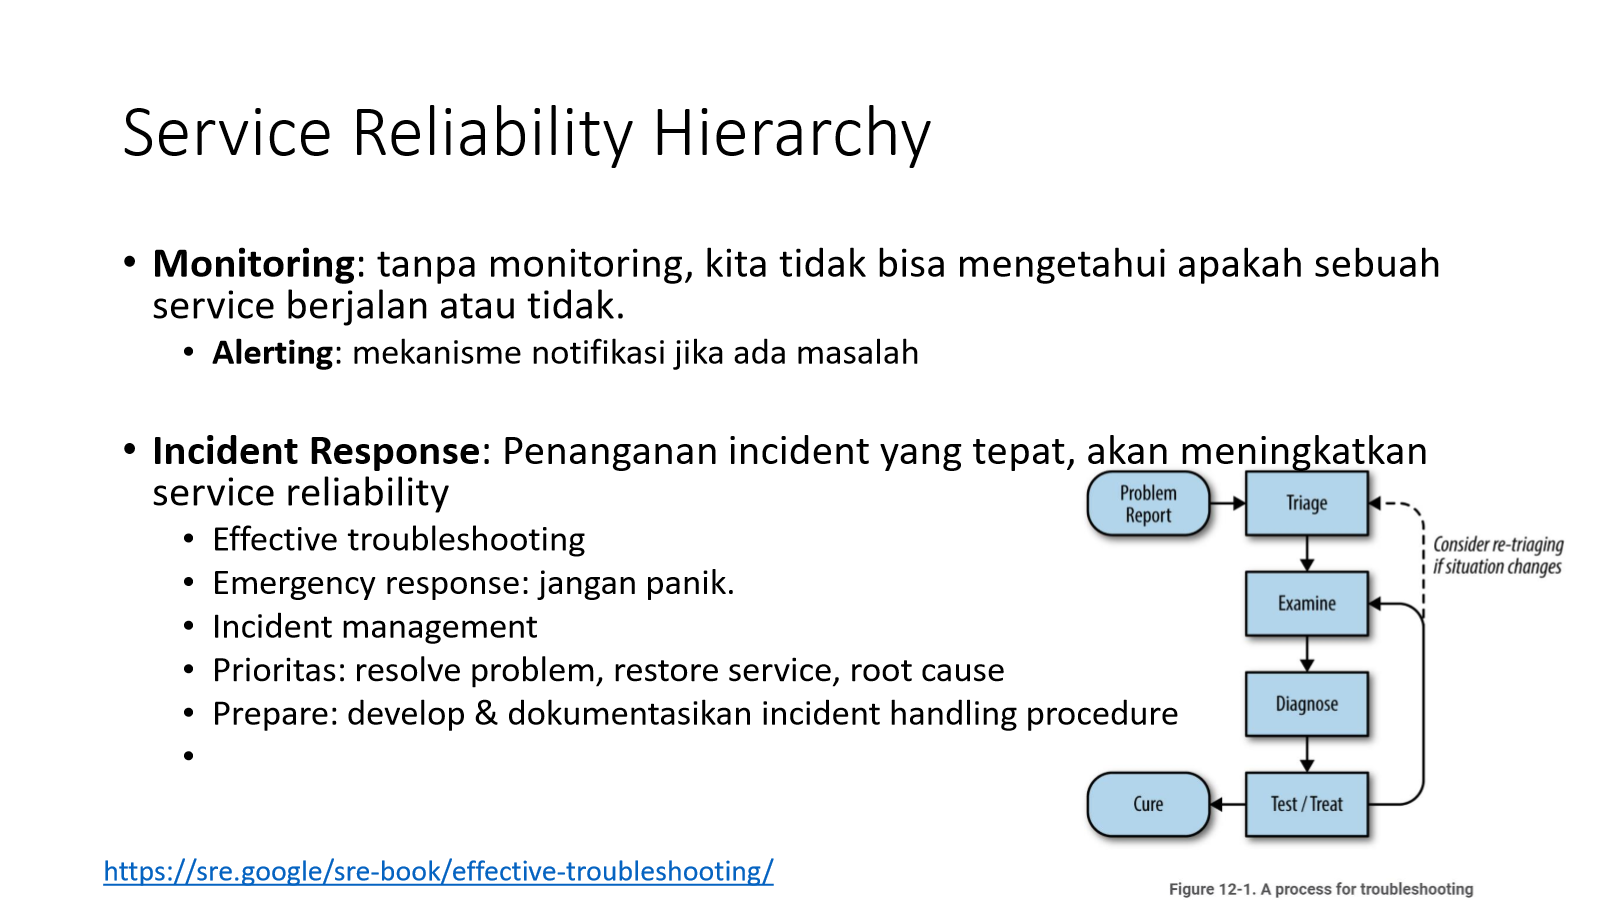
Prinsip emergency response:
- Things break, that’s life — kegagalan adalah hal yang wajar terjadi pada sistem.
- Reaksi yang tepat: jangan panik, sadari “langit tidak sedang runtuh”, fokus mitigate → troubleshoot → fix, dan minta bantuan orang lain jika diperlukan.
- Incident thresholds untuk menentukan kapan sebuah insiden harus dideklarasikan secara resmi: signifikan SLO degradation, ukuran data loss, dan jumlah customer yang meninggalkan layanan.
Incident handling pada sistem produksi memerlukan:
- Rotasi jadwal engineer yang bertanggung jawab menangani incident pada periode tertentu (on-call rotation), agar penanganan tidak bergantung pada satu orang saja.
- Setiap alert yang muncul perlu memiliki playbook penanganan yang menjadi panduan bagi engineer on-call berikutnya.
- Incident/ticket/alert dikategorikan berdasarkan prioritas: P1 (ditangani segera), P2 (ditangani di hari kerja berikutnya), P3 (bersifat informasional saja).
Elements of Incident Handling menekankan recursive separation of responsibilities — pembagian peran yang jelas membuat setiap orang tahu ruang otonominya tanpa perlu menebak tindak lanjut kolega lain:
- Incident Command: bertindak sebagai high-level commander untuk insiden.
- Operational Work: yang melakukan perubahan langsung terhadap sistem.
- Communication: yang berkomunikasi dengan pihak eksternal.
- Planning: mendukung tim operasional untuk isu jangka panjang.
Elemen pendukung lain: Recognized Command Post, Live Incident State Document, dan Clear, Live Handoff antar shift.
Best Practices Incident Management: Prioritize (stop the bleeding → restore service → preserve evidence), Prepare (dokumentasikan prosedur di muka), Trust (beri otonomi penuh sesuai peran masing-masing), Introspect (sadari kondisi emosi sendiri, minta bantuan jika mulai panik/kewalahan), Consider alternatives (evaluasi ulang pendekatan secara berkala), Practice (latih proses secara rutin agar jadi kebiasaan), dan Change it around (bergantian peran agar semua anggota tim familiar dengan tiap peran).
Postmortem Culture
“The cost of failure is education.”
Setiap sistem pasti akan mengalami kegagalan. Saat terjadi outage, kejadian tersebut harus dimanfaatkan sebagai kesempatan belajar untuk mengembangkan langkah tindak lanjut yang mencegah masalah serupa terulang.
Postmortem adalah catatan tertulis yang menjelaskan sebuah insiden: dampaknya, penyebabnya, urutan kejadian, root cause, langkah pencegahan/penanganan, dan tindak lanjutnya. Agar efektif, budaya blameless postmortem harus diterapkan — goal-nya adalah perbaikan sistem, bukan mencari siapa yang salah.
Blameless Postmortem dilandasi alasan berikut:
- Pada sistem berskala besar (baik dari ukuran kode, jumlah engineer, maupun jumlah komponen), pasti akan ada bagian yang mengalami error/break — ini keniscayaan, bukan pengecualian.
- Engineer seharusnya tidak takut dihukum akibat outage; ketakutan seperti itu menimbulkan perasaan unsafe terhadap pekerjaan dan membuat orang menghindari pengambilan risiko yang justru terkontrol dan diperlukan.
- Fokus lebih baik diarahkan pada memahami root cause (misalnya dengan teknik 5 Whys) dan menyusun action plan pencegahan, tanpa mengindikasikan aktor penyebab.
- Human error adalah permasalahan sistem — perbaikan sistem akan membantu manusia mengambil keputusan/tindakan yang benar di kemudian hari.
Template dokumen postmortem umumnya berisi: Date, Author, Summary, Impact (dampak ke pengguna/bisnis/perusahaan), Root Causes, Trigger (event pemicu), Resolution (penanganan penyelesaian), Detection (mekanisme yang mendeteksi insiden), Action Items (daftar tindakan, baik yang berhasil maupun gagal), Lesson Learnt, dan Timeline kronologis kejadian.
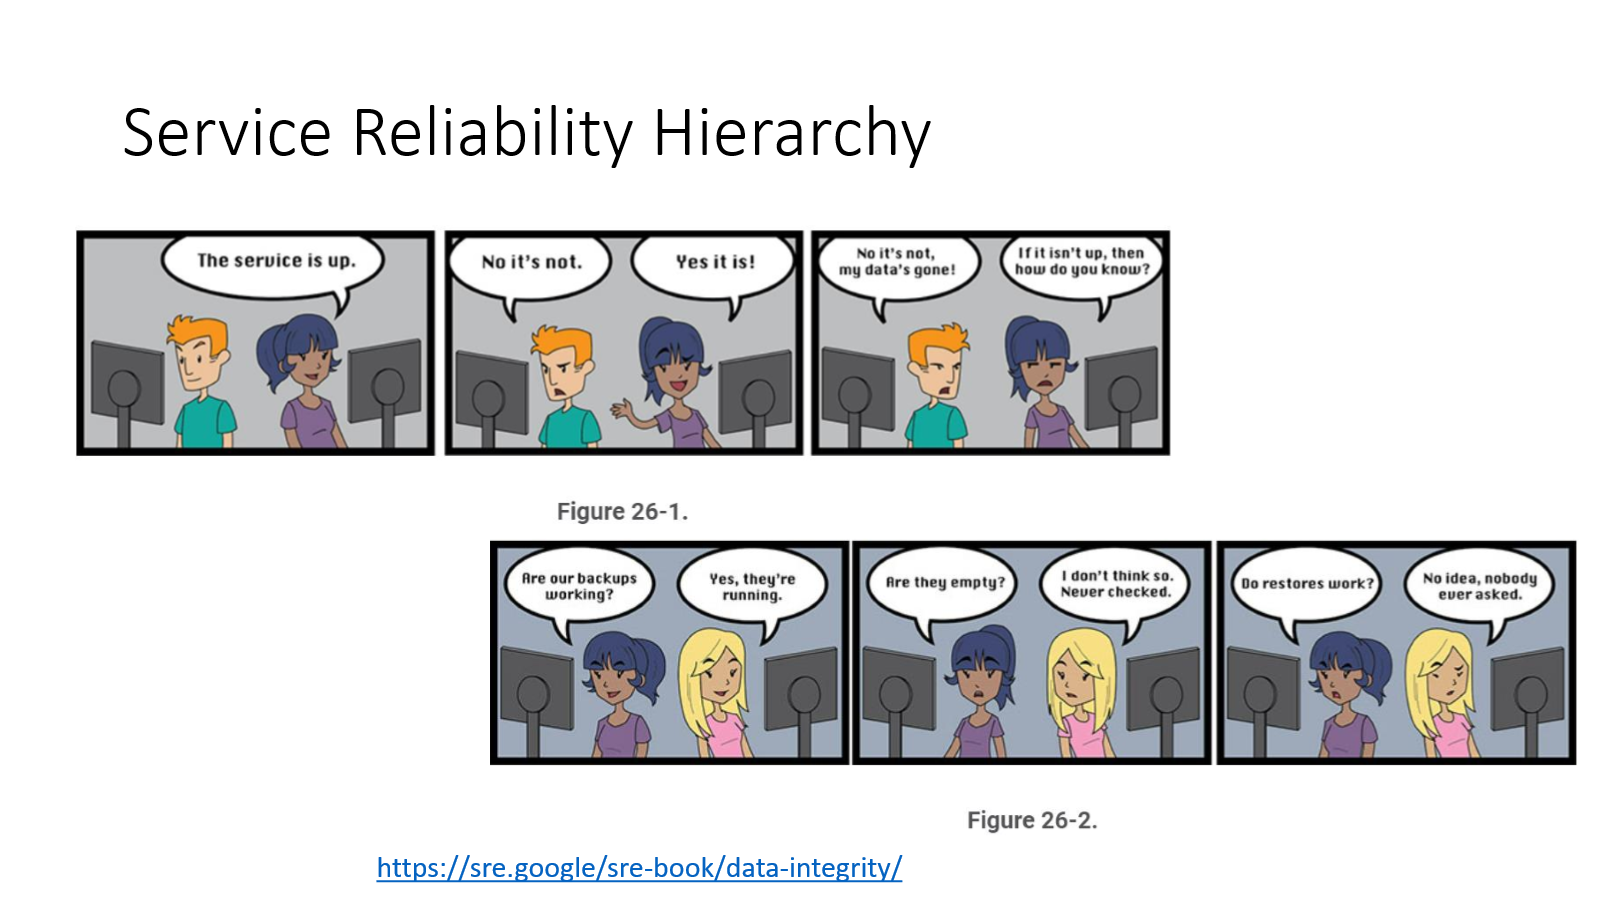
Ilustrasi komik dari SRE Book menggambarkan pentingnya data integrity — sebuah service dianggap “up” hanya jika datanya juga benar-benar utuh, dan pentingnya memverifikasi backup benar-benar berfungsi (backup yang tidak pernah dites restore-nya sama saja tidak berguna):
Testing & Release Procedure
“If you haven’t tried it, assume it’s broken.”
Testing & release procedure memastikan sistem memiliki confidence terhadap reliability-nya: baik dengan tidak melakukan perubahan sama sekali (behaviour tetap sama), maupun dengan mendeskripsikan semua perubahan secara jelas sehingga uncertainty akibat perubahan tersebut dapat dianalisis.
Poin penting soal Testing & Mean Time to Repair (MTTR):
- Lolos tes bukan berarti sistem bebas bug atau pasti reliable.
- Monitoring dapat mendeteksi bug yang lolos, namun bug tersebut tetap ada di produksi.
- Jika test dapat mendeteksi bug sebelum rilis, artinya bug tersebut terdeteksi dengan zero MTTR (tidak sempat berdampak ke pengguna).
Ragam jenis tes yang disebutkan: unit test, integration test, system test, smoke test, performance test, regression test, stress test, dan canary test.
Prinsip-Prinsip Resilience
Lima aturan (Rules of Resilience) dari Astrid Atkinson (Reliability from the Ground Up):
Rule #1: Every node for itself — “Keep doing what you’re doing, unless it’s actively unsafe.” Sebuah node harus bisa pulih dari failure secara mandiri: melalui loop script restarts, validate on startup (baru melaporkan OK jika benar-benar siap), dan meng-cache seluruh state yang dibutuhkan secara lokal. Sebuah node dapat gagal karena dependency yang bermasalah atau karena bad input.
Rule #2: Everything runs on more than one machine — serving component harus stateless, memanfaatkan idempotency dan sharding, serta data harus dipecah (split) antar mesin dan direplikasi. Menjalankan lebih dari satu cluster memberikan redundancy yang lebih baik.
Rule #3: Loosely coupled dependencies — kunci utamanya adalah decoupled architecture untuk membatasi blast radius (dampak kegagalan sebuah komponen) dan menghindari cascading failure, dengan cara: membatasi jumlah retry, membatasi rate request, menghindari Query of Death, menghindari proximity-based failover, dan menghindari long startup time. Pola (pattern) yang relevan:
- Service registry — database yang menyimpan informasi service dan instance mana saja yang tersedia, sehingga alamat service tidak perlu di-hardcode ke dalam aplikasi.
- Circuit breaker pattern — membatasi dampak kegagalan sebuah service agar tidak merambat ke service lain.
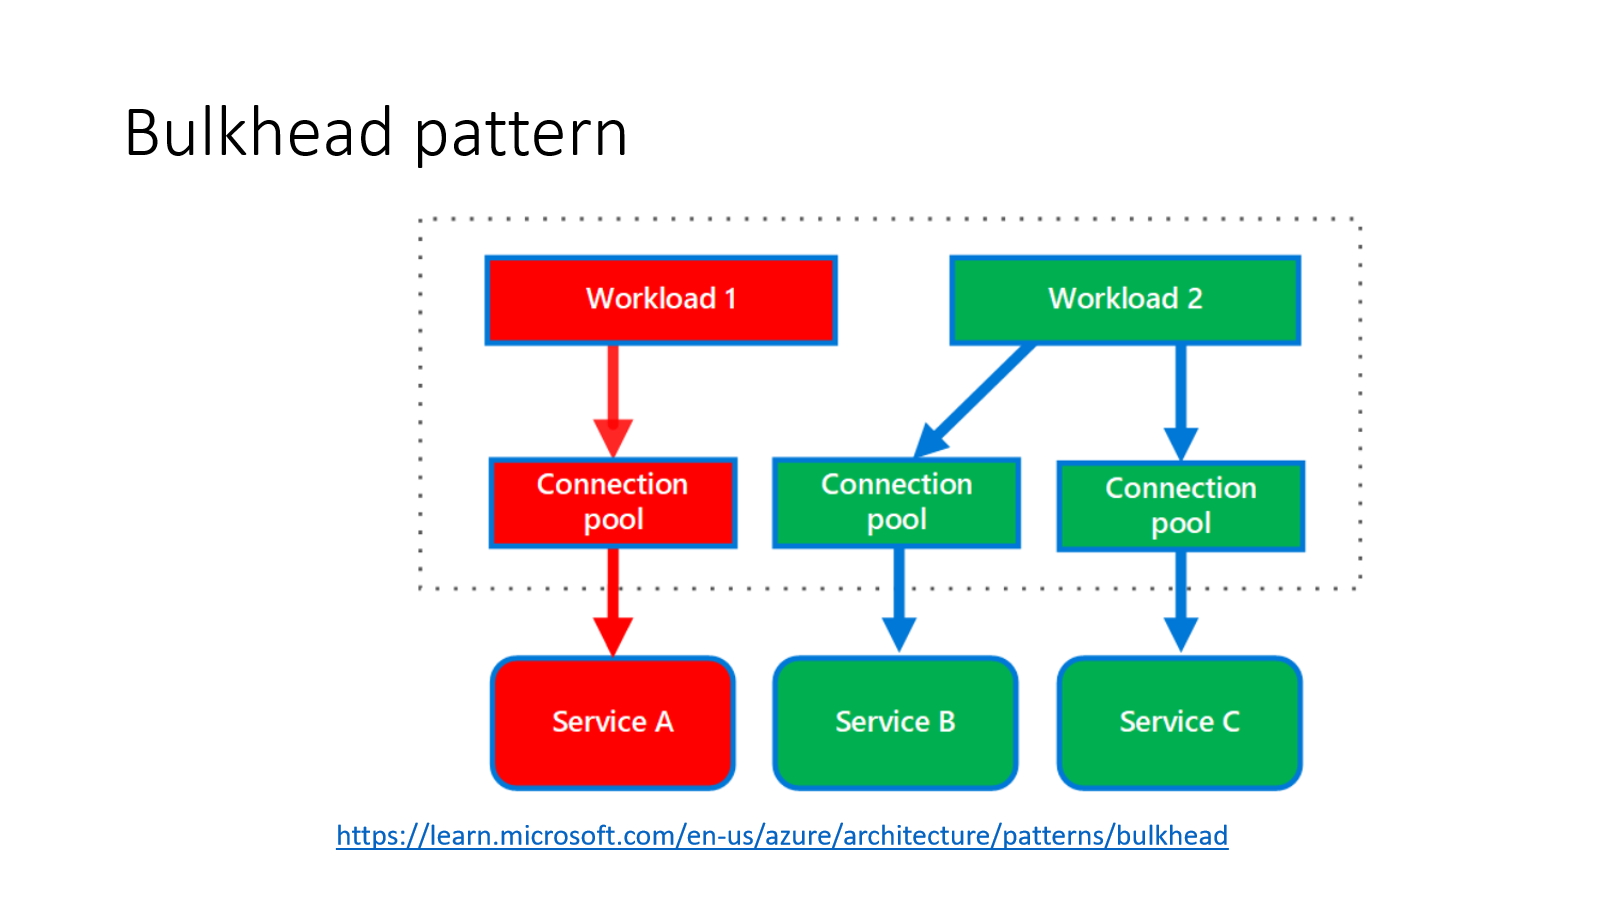
- Bulkhead pattern — mengisolasi resource (misalnya connection pool) per workload/service, sehingga kegagalan satu workload tidak menghabiskan resource bersama untuk workload lain.
Rule #4: Design for change — (1) gunakan tools, bukan proses manual; (2) check in semua konfigurasi ke version control; (3) lakukan canary pada setiap perubahan; (4) rollback harus selalu aman dilakukan kapan pun.
Rule #5: Observe the system, not the components — pilih beberapa metrik level-tinggi yang menggambarkan perilaku keseluruhan sistem (mis. queries, latency, errors) dan pastikan metrik itu “sempurna”; detail metrik komponen individual hanyalah informasi latar belakang pendukung.
Catatan penutup materi ini: aspek terpenting dari reliability tetaplah people — saat terjadi masalah, pada akhirnya tetap dibutuhkan penanganan oleh engineer manusia.
Tabel: Penyebab Unavailability/Failure dan Mitigasinya
Tabel berikut merangkum penyebab gangguan reliability/availability yang dibahas di kedua materi (System Reliability dan Arsitektur Scalable) beserta mitigasinya:
| Penyebab / Jenis Gangguan | Penjelasan | Mitigasi |
|---|---|---|
| Resource exhaustion | Penambahan jumlah user, data, dan trafik mengakibatkan kekurangan resource. | Capacity planning, autoscaling, monitoring beban. |
| Unplanned load-based changes | Kenaikan popularitas mendadak memerlukan perubahan aplikasi/konfigurasi yang sering dilakukan tanpa perencanaan matang. | Load testing, capacity planning proaktif, canary release. |
| Increased number of moving parts | Aplikasi membesar, jumlah developer & perubahan bertambah, meningkatkan risiko error. | Service-based architecture, complexity localization, testing menyeluruh. |
| Outside dependency | Ketergantungan ke pihak eksternal (SaaS, infrastruktur pihak ketiga). | Loosely coupled dependency, circuit breaker, graceful degradation. |
| Technical debt | Kompleksitas yang menumpuk seiring waktu. | Refactoring berkelanjutan, blameless postmortem sebagai pembelajaran. |
| Process/node crash | Sebuah node gagal karena bug, bad input, atau dependency yang gagal. | Redundancy (Rule #2 — everything runs on more than one machine), auto-restart/loop script, validate-on-startup. |
| Cascading failure | Kegagalan satu komponen merambat ke komponen lain yang bergantung padanya. | Circuit breaker pattern, bulkhead pattern, rate limiting, pembatasan jumlah retry. |
| Overload / Query of Death | Request tertentu (atau lonjakan request) membebani/mematikan service. | Handling overload, rate limiting, menghindari query yang mahal (Query of Death). |
| Data corruption / data loss | Data rusak atau hilang karena bug atau kesalahan operasional. | Backup terverifikasi (bukan sekadar backup, tapi dites restore-nya), data integrity checks. |
Arsitektur Scalable
Design to Scale
Karakteristik bisnis saat ini menuntut arsitektur yang scalable: uncertainty, volatility (perubahan cepat baik dari sisi volume, produk, maupun harga), kompetisi, dan tuntutan cost efficiency. Kebutuhan untuk selalu available menjadi prasyarat — tanpa high availability, kebutuhan akan scalability pun menjadi tidak relevan.
Scalability sendiri mencakup tiga dimensi tantangan:
- Handling more data — data yang membesar berdampak pada query yang lebih lama, beban storage lebih besar, dan trafik network yang meningkat.
- Handling more concurrent request — pertambahan user memunculkan isu sinkronisasi.
- Handling higher interaction rates — isu latency menjadi semakin kritikal.
Improve Availability dilakukan dengan: build with failure in mind, always think about scaling, mitigate risk, monitor availability, dan merespons masalah availability secara predictable & terdefinisi.
Scaling Vertikal vs Horizontal
| Aspek | Scaling Vertical | Scaling Horizontal |
|---|---|---|
| Cara kerja | Meningkatkan kapasitas satu mesin (server yang sama diperkuat) | Menambah jumlah mesin/server |
| Contoh teknik | Tambah kapasitas I/O (RAID disk), perbaiki access time (SSD), tambah RAM untuk kurangi I/O, upgrade/tambah network interface, ganti processor lebih kuat | Menambahkan komputer/server baru ke dalam sistem (mis. front cache, front app server, web services server) |
| Batasan | Terbatas pada kapasitas maksimum satu mesin, tetap single point of failure | Skalabilitas lebih besar, namun butuh load balancer & desain stateless |
Konfigurasi awal (single-server) melayani semua trafik dari satu mesin:
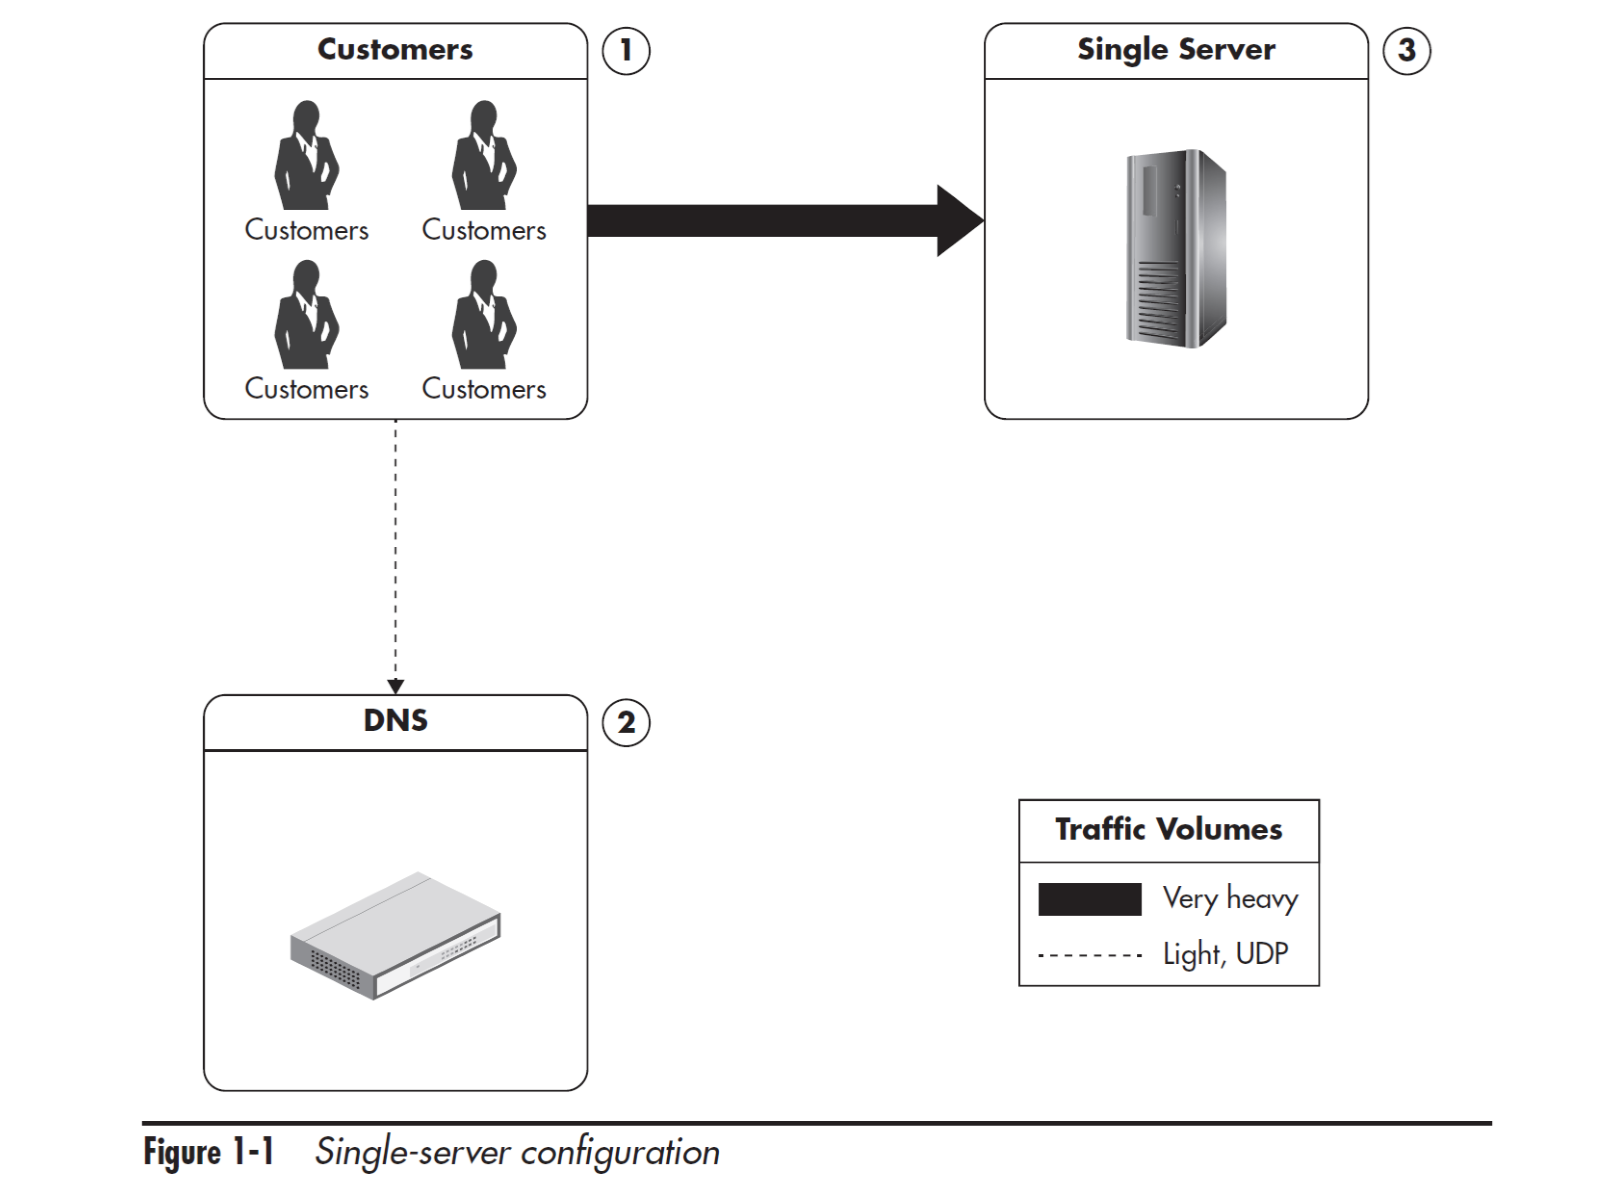
Langkah scaling vertikal sederhana adalah mengganti server dengan mesin yang lebih kuat (“Stronger Server”) tanpa mengubah arsitektur.
Isolation of Services & Service-Based Architecture
Isolation of Services berarti memecah bagian sistem ke server yang berbeda, misalnya web server dipisahkan dari database, atau dipecah per domain/functionality:
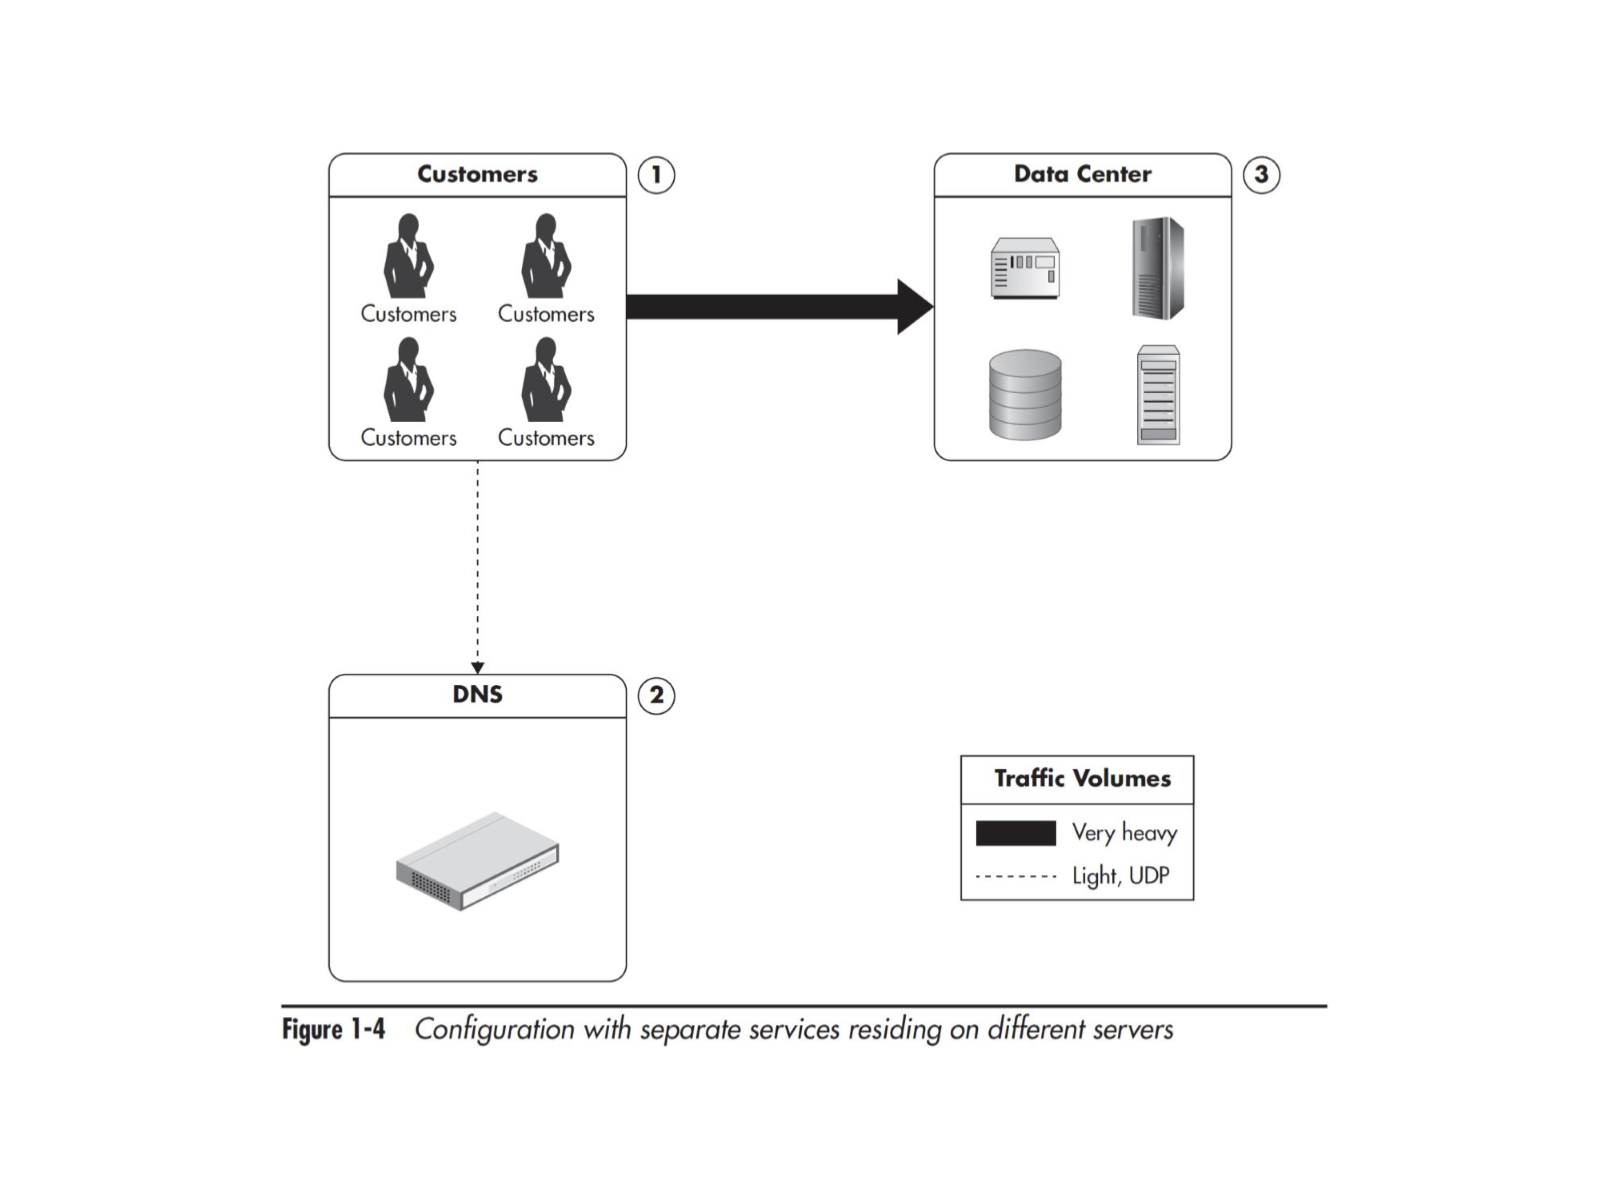
Pada aplikasi monolithic yang kompleks, banyak tim developer mengubah satu codebase besar yang saling terkait erat, menyulitkan koordinasi. Pada service-based architecture, sistem dipecah menjadi service-service yang lebih kecil dan dapat ditangani tim terpisah, dengan manfaat: scaling decision yang lebih presisi per service, team assignment & focus yang lebih jelas, complexity localization, dan kemudahan testing.
Sebuah service dalam arsitektur ini adalah komponen standalone yang: memiliki separate codebase, mengelola datanya sendiri, menyediakan capabilities ke pihak lain, mengonsumsi capabilities dari pihak lain, dan memiliki single owner.
Stateless vs Stateful Service
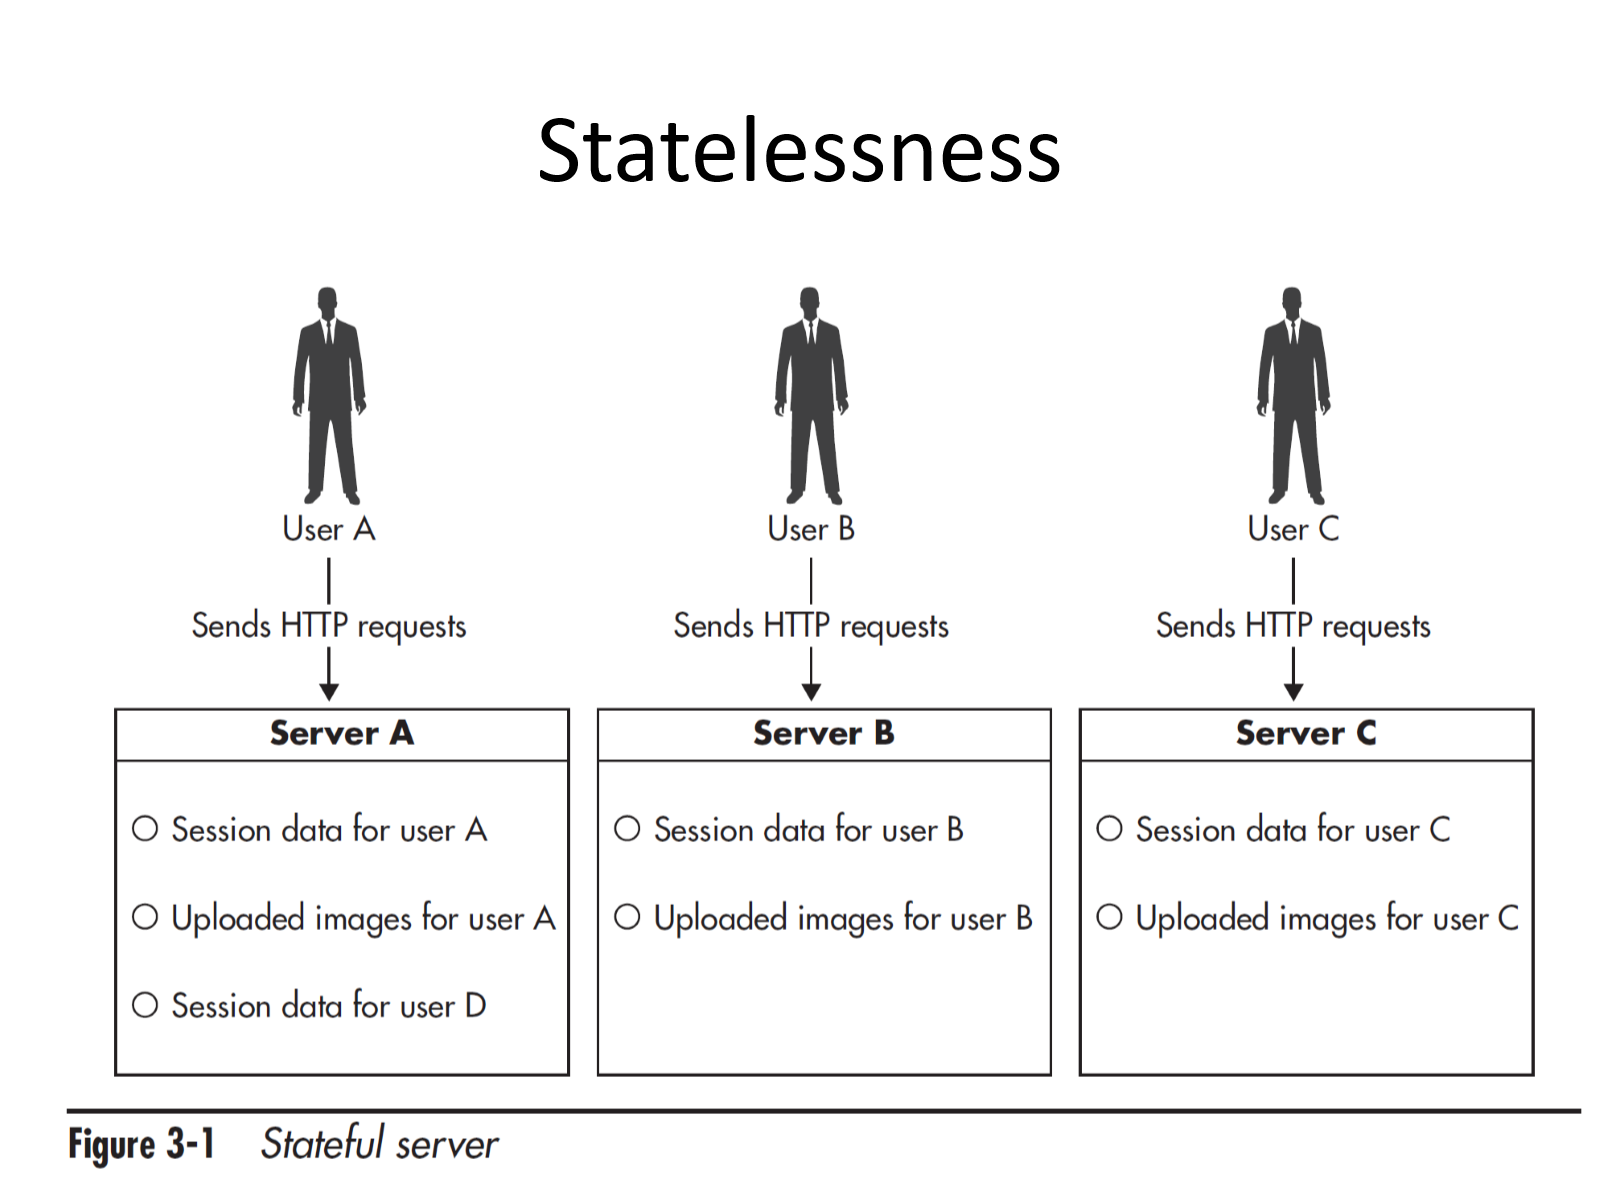
Pada stateful server, setiap server menyimpan session data & file milik user tertentu secara lokal — jika user diarahkan ke server yang berbeda, data tersebut tidak tersedia:
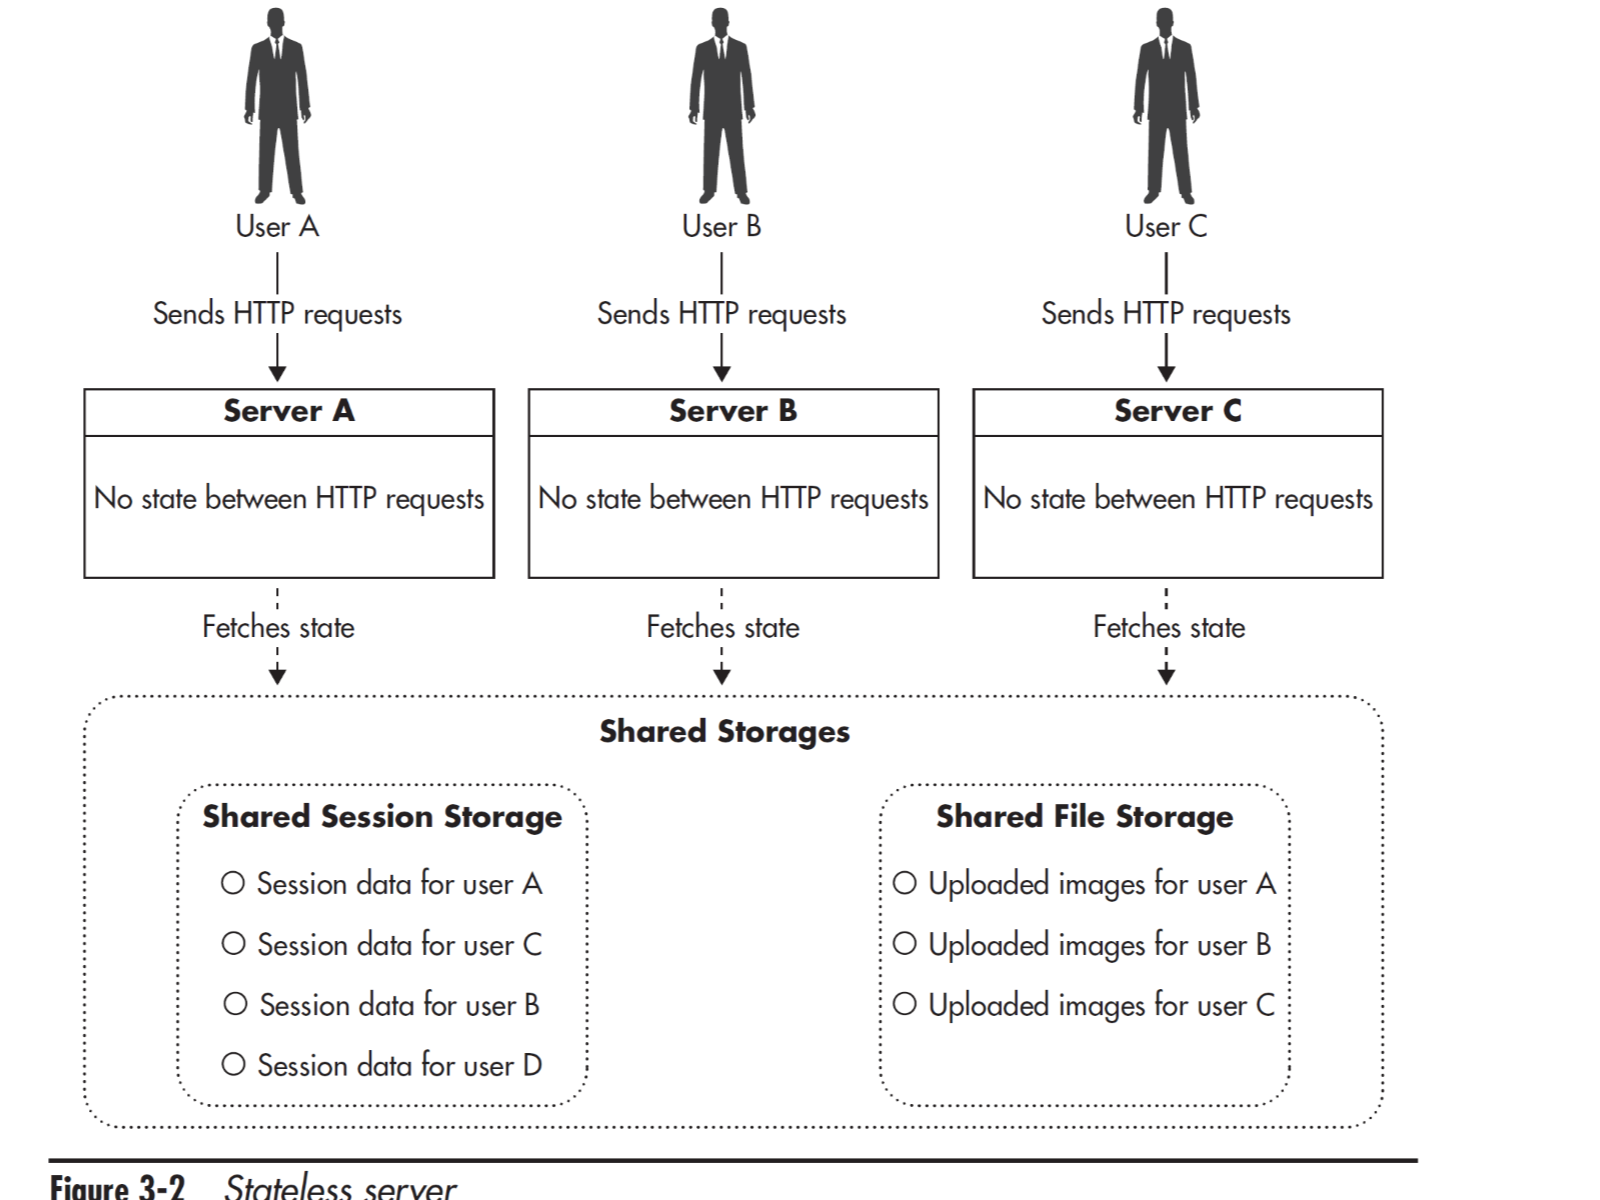
Pada stateless server, server tidak menyimpan state apa pun di antara request; semua state (session, file) diambil dari shared storage (Shared Session Storage, Shared File Storage) sehingga request dari user mana pun dapat dilayani oleh server mana pun:
Untuk stateful service yang tidak dapat sepenuhnya dihindari (misalnya database), prinsipnya adalah localize data as much as possible.
Managing files: web application server tidak menyimpan file secara lokal — file publik didorong (push) ke shared file storage dan dapat di-cache lewat CDN; file privat memerlukan proses authentication & authorization di web server sebelum diambil dari private files storage.
Memanfaatkan CDN
Content Delivery Network (CDN) adalah layanan hosting yang menangani distribusi global file statik (HTML, CSS, JS, images, video) sehingga pengguna dilayani dari lokasi yang lebih dekat secara geografis, mengurangi beban ke data center utama dan mengurangi latency.
Scaling Horizontal: Overview Data Center
Arsitektur data center skala besar melibatkan banyak lapisan komponen yang masing-masing dapat di-scale horizontal secara independen: DNS/geoDNS, load balancer, front cache, front app server, cache servers, message queue servers, web services server, data store servers, search servers, dan batch/queue workers — semuanya terhubung ke CDN untuk konten statis:
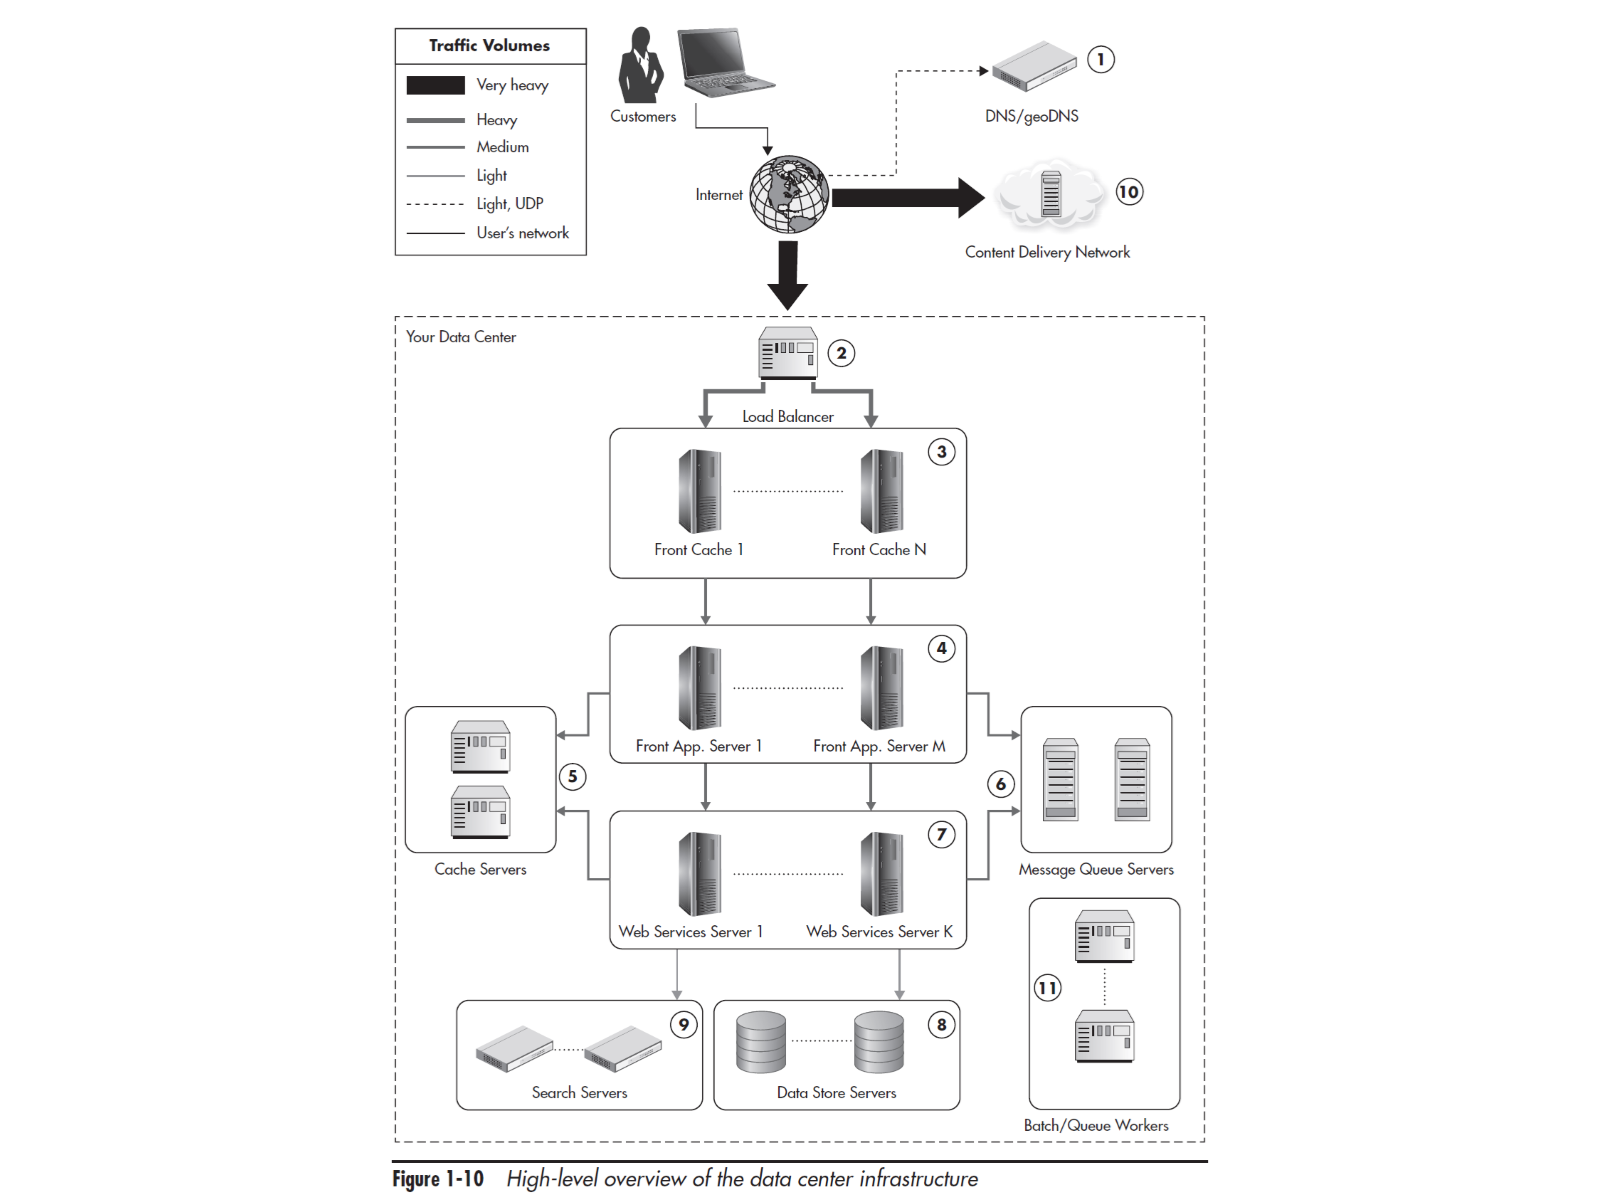
Autoscaling adalah otomatisasi infrastruktur untuk menambah/mengurangi virtual server sesuai beban, umumnya disediakan oleh cloud provider (mis. Amazon Auto Scaling yang memantau metrik lewat CloudWatch) atau menggunakan Kubernetes.
Load Balancer juga dapat dimanfaatkan untuk rolling update (server di-update satu per satu secara bertahap) atau synchronized update (membuat set VM baru dengan software terbaru, lalu mengalihkan load balancer sekaligus), sekaligus memonitor kesehatan tiap server dan mengarahkan trafik menjauh dari server yang unhealthy.
Jenis Load Balancer
| Aspek | NAT (Layer-4) | Reverse Proxy (Application-layer) |
|---|---|---|
| Level kerja | TCP/IP layer | HTTP layer |
| Cara kerja | Forward paket satu per satu, mengingat server yang di-assign ke tiap client | Menyimpan full request/response sebelum meneruskan (mis. Nginx, Squid) |
| Skala | ~1–10 juta request/detik | ~100 ribu – 1 juta request/detik |
| Layanan yang didukung | Semua jenis service | Hanya HTTP |
| Fitur tambahan | Tidak ada | SSL termination, caching, compression |
| Implementasi umum | Hardware load balancer (mahal) | Open-source (murah), mis. Nginx |
Nginx sebagai reverse proxy load balancer bekerja dengan alur: client mengirim request ke LB → LB memilih upstream server → LB meneruskan request ke upstream → upstream mengirim response ke LB → LB mengenali klien terkait koneksi tersebut → LB meneruskan response ke client:
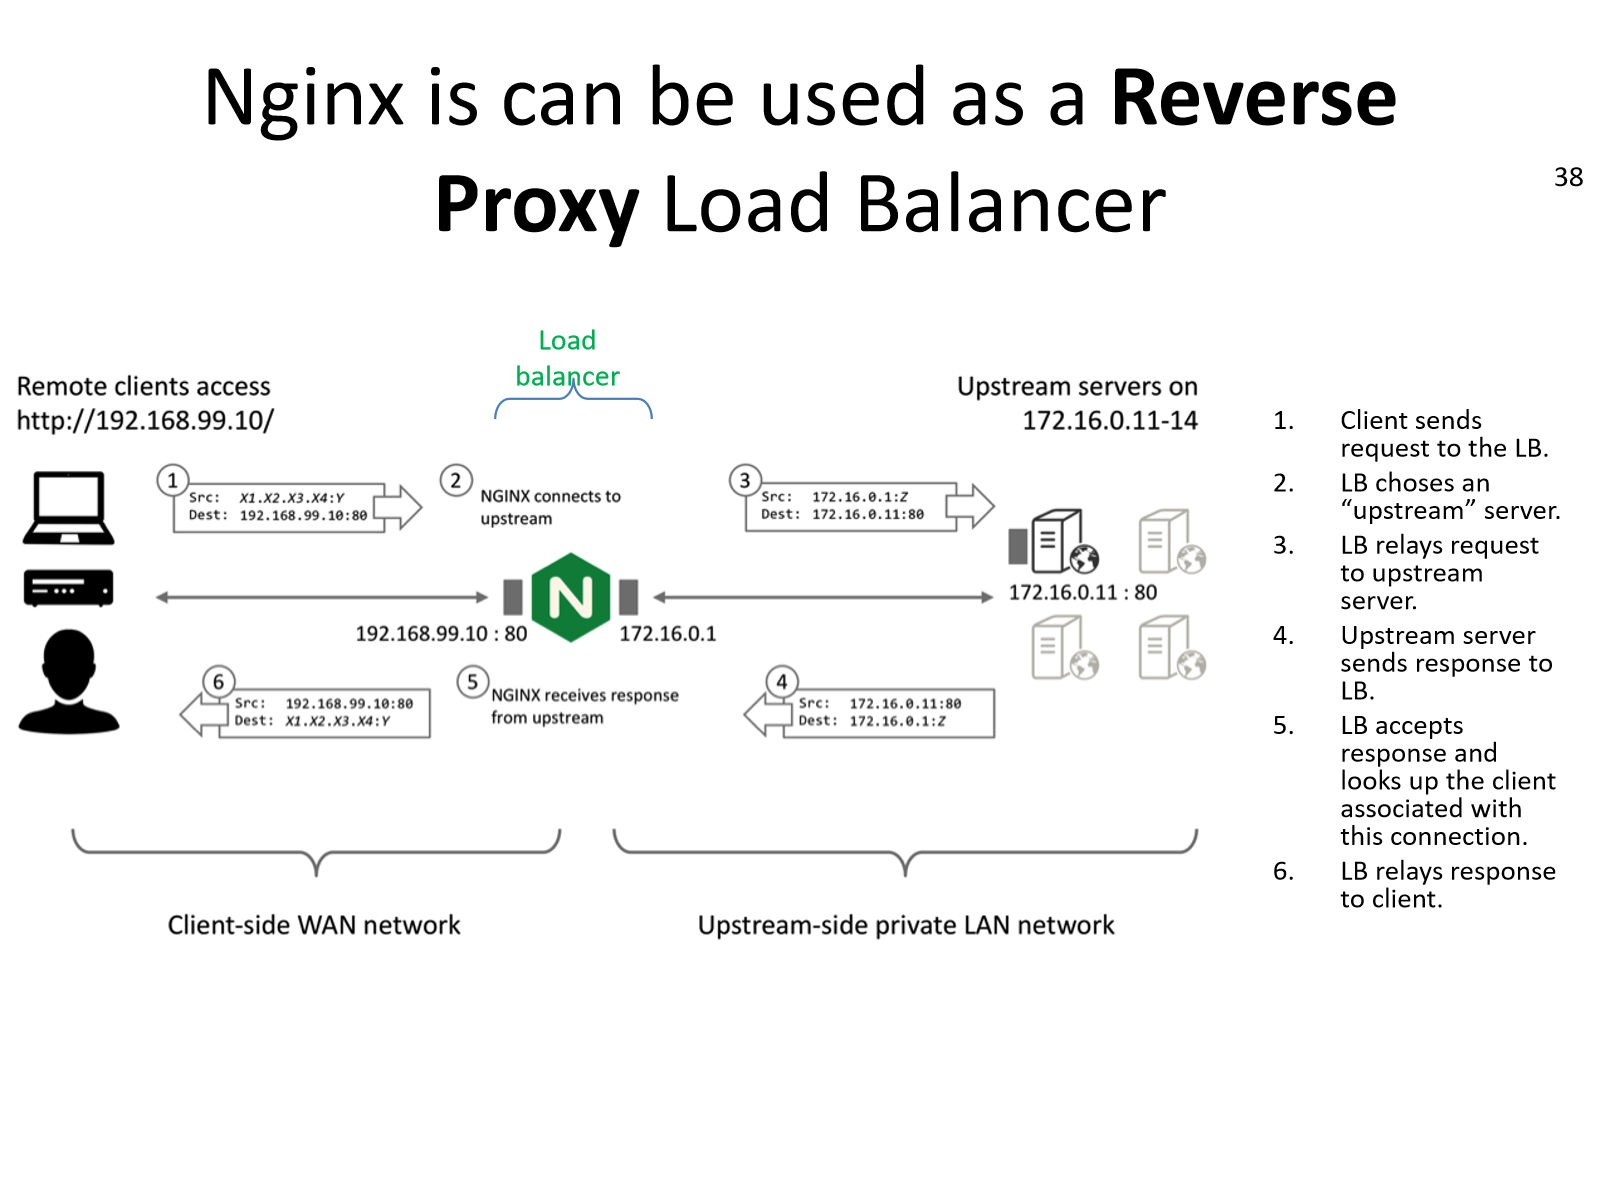
Local load balancer limitations: load balancer sendiri adalah single point of failure, hanya sanggup menangani ~1 juta request/detik, dan berada di satu data center (tidak dekat semua pelanggan, dan data center itu sendiri jadi single point of failure). Untuk layanan sangat besar, dibutuhkan global load balancer — umumnya berbasis DNS (bisa round-robin atau geographic load balancing di mana DNS server memberi respons sesuai IP address client). Ini memunculkan masalah distributed service discovery: bagaimana client menemukan replika service tanpa menghubungi bottleneck terpusat.
CDN pada dasarnya adalah kombinasi caching reverse proxy dengan geographic load balancing berbasis DNS (contoh: Akamai, CloudFront, Cloudflare, Google Cloud CDN).
Persistence Layer & Data Storage
Persistence Layer mencakup: Relational Data Store dengan pendekatan master-slave dan partitioning/sharding, serta Non-relational/specific Data Store (NoSQL).
Ragam pilihan teknologi penyimpanan data beserta use case-nya:
| Jenis Storage | Contoh | Use Case |
|---|---|---|
| SQL Relational DB | MySQL, Oracle | Data terstruktur, data transaksional |
| Column-oriented DB | Snowflake, BigQuery | Query SQL untuk analitik pada dataset besar (OLAP) |
| Search engine | Elasticsearch | Dokumen teks yang dapat dicari |
| Document store | MongoDB | Data semi-terstruktur (dokumen JSON) |
| Distributed cache | Redis | Cache in-memory dengan expiration, sangat cepat |
| NoSQL DB | Cassandra, Dynamo | Data besar yang diakses secara paralel |
| Cloud object store | S3, Azure Blobs | Gambar, video, konten statis lain |
| Cluster filesystem | Hadoop distributed FS | File untuk komputasi paralel skala besar |
| Networked filesystem (NAS) | NFS, EFS, EBS | Aplikasi yang didesain menulis ke local filesystem, tapi butuh storage yang scalable & shared |
Goal umum teknologi penyimpanan data: scalability (data jauh lebih besar dari RAM), persistence (data tidak hilang), indexing (pencarian cepat), concurrency (dapat diakses bersamaan), analysis (query/analisis langsung di mesin storage), separation of concern, integrity, security, dan deduplication.
Authentication, Push Notification, dan API
Interaksi frontend-backend memerlukan authentikasi; mengirim kredensial (username/password) di setiap request tidak aman. Mekanisme umum: auth token (diberikan saat login, durasi umumnya pendek) dan API keys (auth token berjangka panjang, umumnya untuk interaksi antar service). Auth token pada HTTP request dapat diletakkan di query parameters, headers, atau body.
Karena client-server interaction umumnya berbasis request dari client, jika server perlu berinisiatif mengirim informasi (email, SMS, atau push notification), dibutuhkan arsitektur khusus karena client tidak bisa menyediakan REST API sendiri (lokasi dapat berpindah dan biasanya menggunakan private IP).
Arsitektur push notification: client OS membuat satu koneksi untuk semua aplikasi (mis. lewat Apple Push Notification Service/APNs), dan service pengirim mengirim notifikasi melalui pihak ketiga (Apple/Google) tersebut:
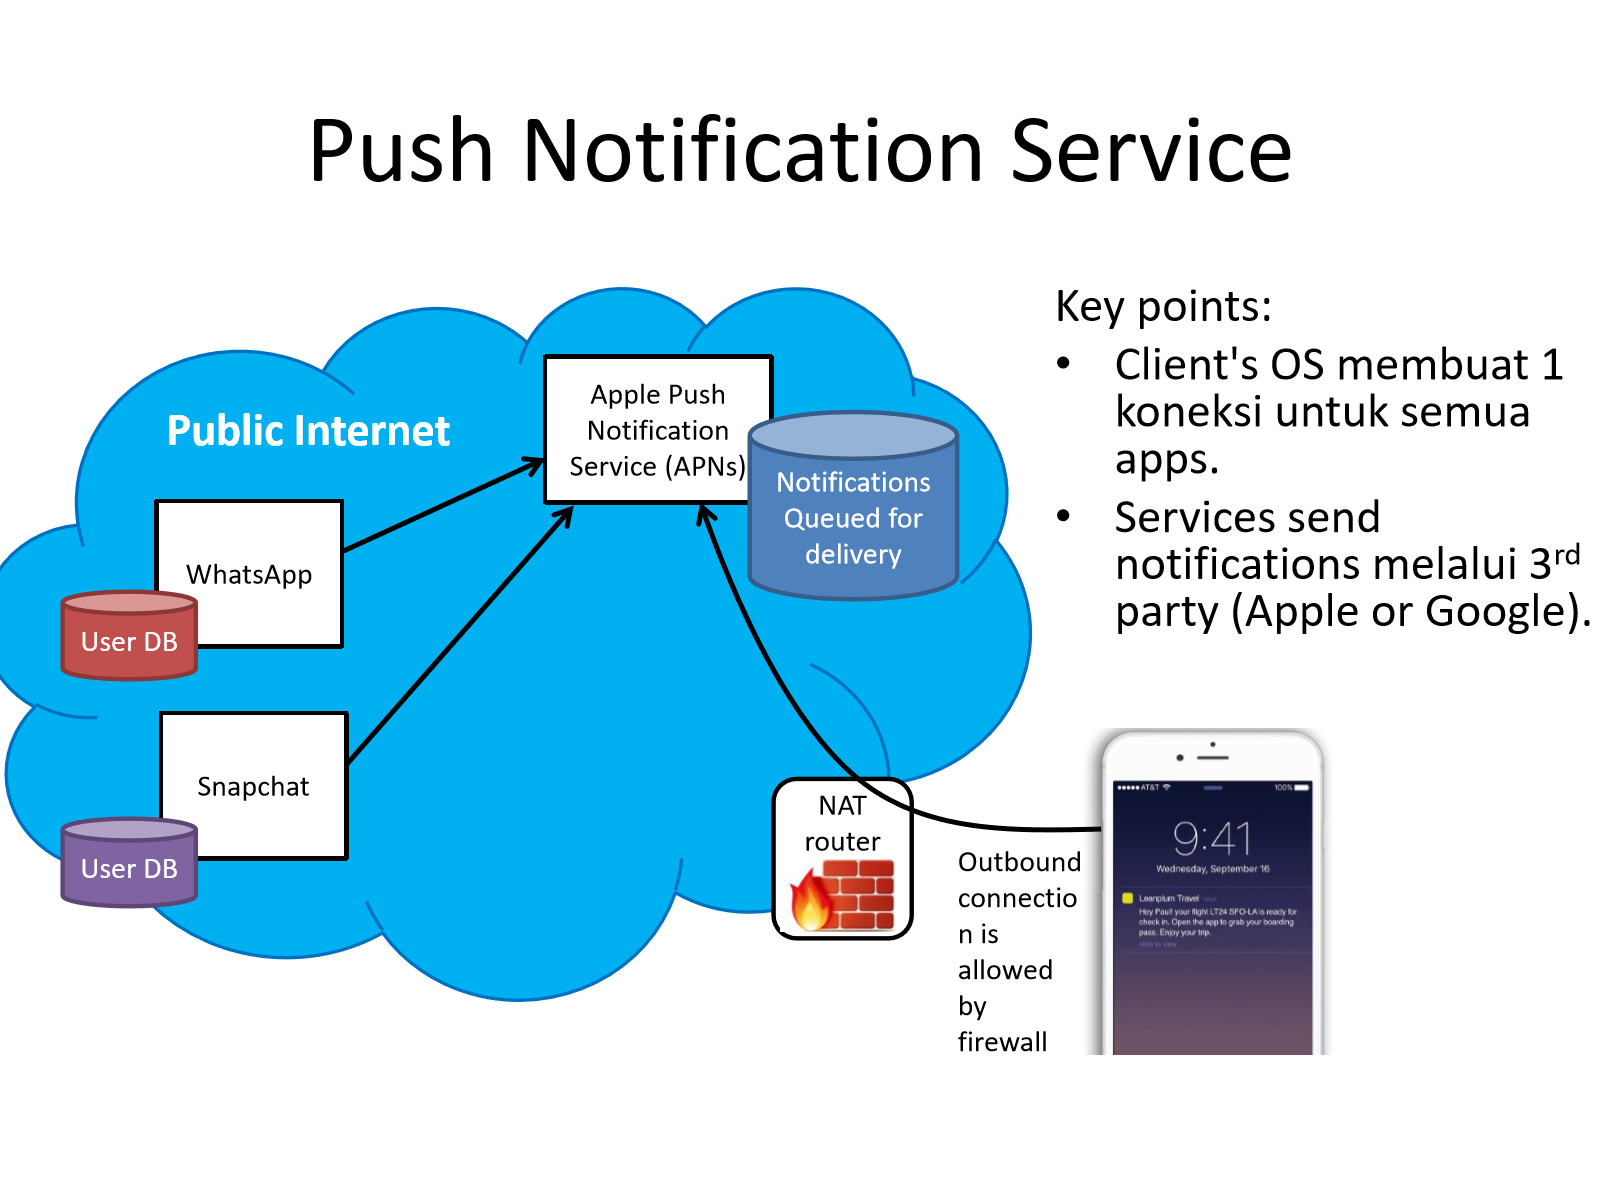
Prinsip arsitekturnya: dibuat push notification service khusus, client diidentifikasi lewat device ID, client meregistrasikan lokasinya saat aktif/berpindah lokasi, service pengirim notifikasi mengirim message ke push notification service, dan client membuka long-lived TCP connection ke push notification service.
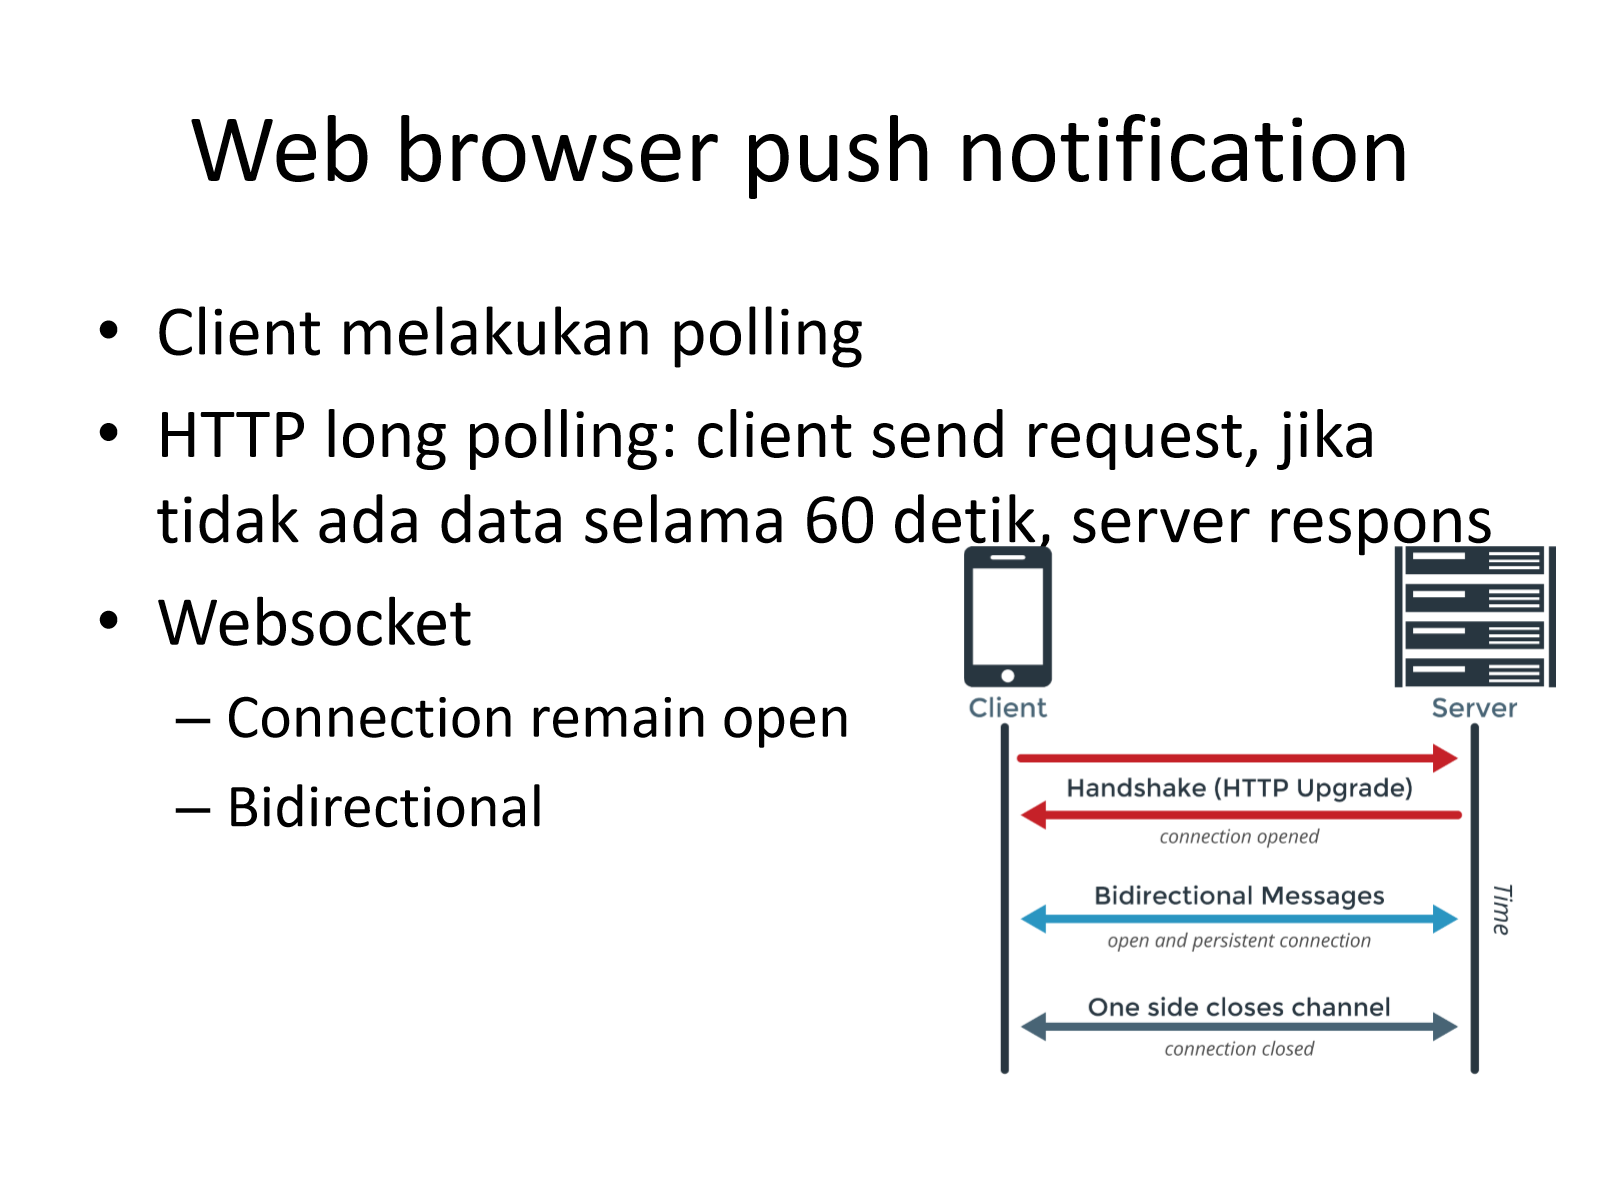
Untuk web browser, mekanisme push notification dapat berupa HTTP long polling (client mengirim request, server merespons setelah data tersedia atau setelah timeout, mis. 60 detik) atau WebSocket (koneksi tetap terbuka dan bidirectional):
Software service umumnya menyediakan RPC API dalam bentuk REST, SOAP, Thrift, Protocol Buffer, atau GraphQL, dengan mekanisme authentication untuk memastikan siapa/apa yang mengakses service.
Monolithic vs Microservices
| Aspek | Monolithic | Microservices |
|---|---|---|
| Development, deploy, test, debug, koordinasi, sharing data | Lebih mudah karena satu codebase | Lebih kompleks karena banyak service terpisah |
| Transaction (ACID) | Lebih mudah didukung | Lebih sulit (transaksi lintas service) |
| Optimasi DB | Lebih mudah (satu DB untuk semua service) | Perlu strategi per service |
| Bottleneck development | Rawan, karena tim besar mengubah codebase yang sama | Lebih rendah, tiap tim punya codebase/service sendiri |
| Struktur kode | Satu codebase besar rawan berantakan | Kode terpisah per service, lebih terkelola |
| Deployment | Seluruh aplikasi harus di-deploy ulang | Tiap service dapat di-deploy independen |
| Bahasa/runtime | Harus seragam (bahasa, build system, runtime yang sama) | Dapat berbeda-beda per service |
Menangani Kegagalan Service
Strategi dealing with service failures: graceful degradation (menurunkan kualitas layanan alih-alih gagal total), graceful backoff, fail as early as possible, dan penanganan khusus untuk customer caused problem.
Service Tier mengklasifikasikan dampak kegagalan sebuah service: Tier 1 (critical), Tier 2 (penting, tapi jika gagal hanya menurunkan kualitas layanan ke customer), Tier 3 (dampak terbatas), Tier 4 (tidak ada dampak signifikan).
Load Balancer secara umum berperan sebagai titik kontak tunggal dari sebuah service: request diteruskan ke workers/backend, user hanya melihat satu server/IP, sementara load balancer dapat menangani puluhan hingga ratusan backend server sekaligus.
System Design
Tipe Arsitektur
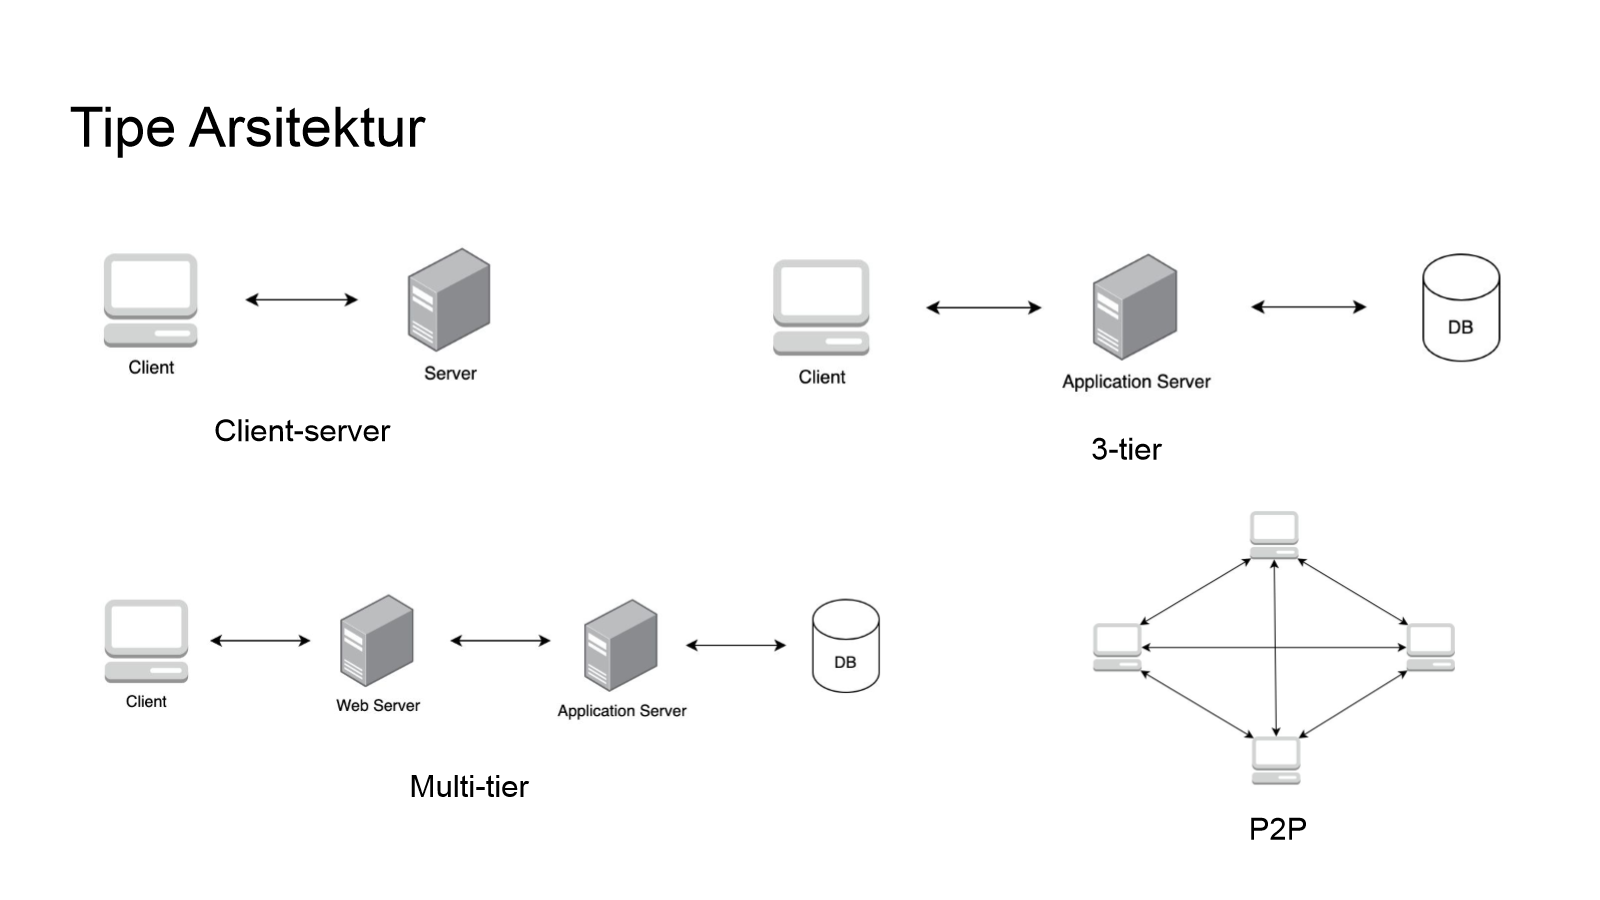
Empat pola arsitektur dasar yang menjadi building block system design: client-server (client langsung terhubung ke satu server), 3-tier (client → application server → DB), multi-tier (client → web server → application server → DB), dan P2P (peer-to-peer, semua node saling terhubung tanpa server pusat).
Studi Kasus: Evolusi Arsitektur “myweb.com” dari Zero hingga 100K+ Users
Studi kasus ini (dibawakan oleh Samuel Simon, Senior Software Architect @ GovTech Edu) mendemonstrasikan secara bertahap bagaimana sebuah arsitektur sederhana berkembang menjadi arsitektur scalable ketika jumlah pengguna bertambah — mempraktikkan langsung konsep reliability dan scalability yang dibahas di dua bagian sebelumnya.
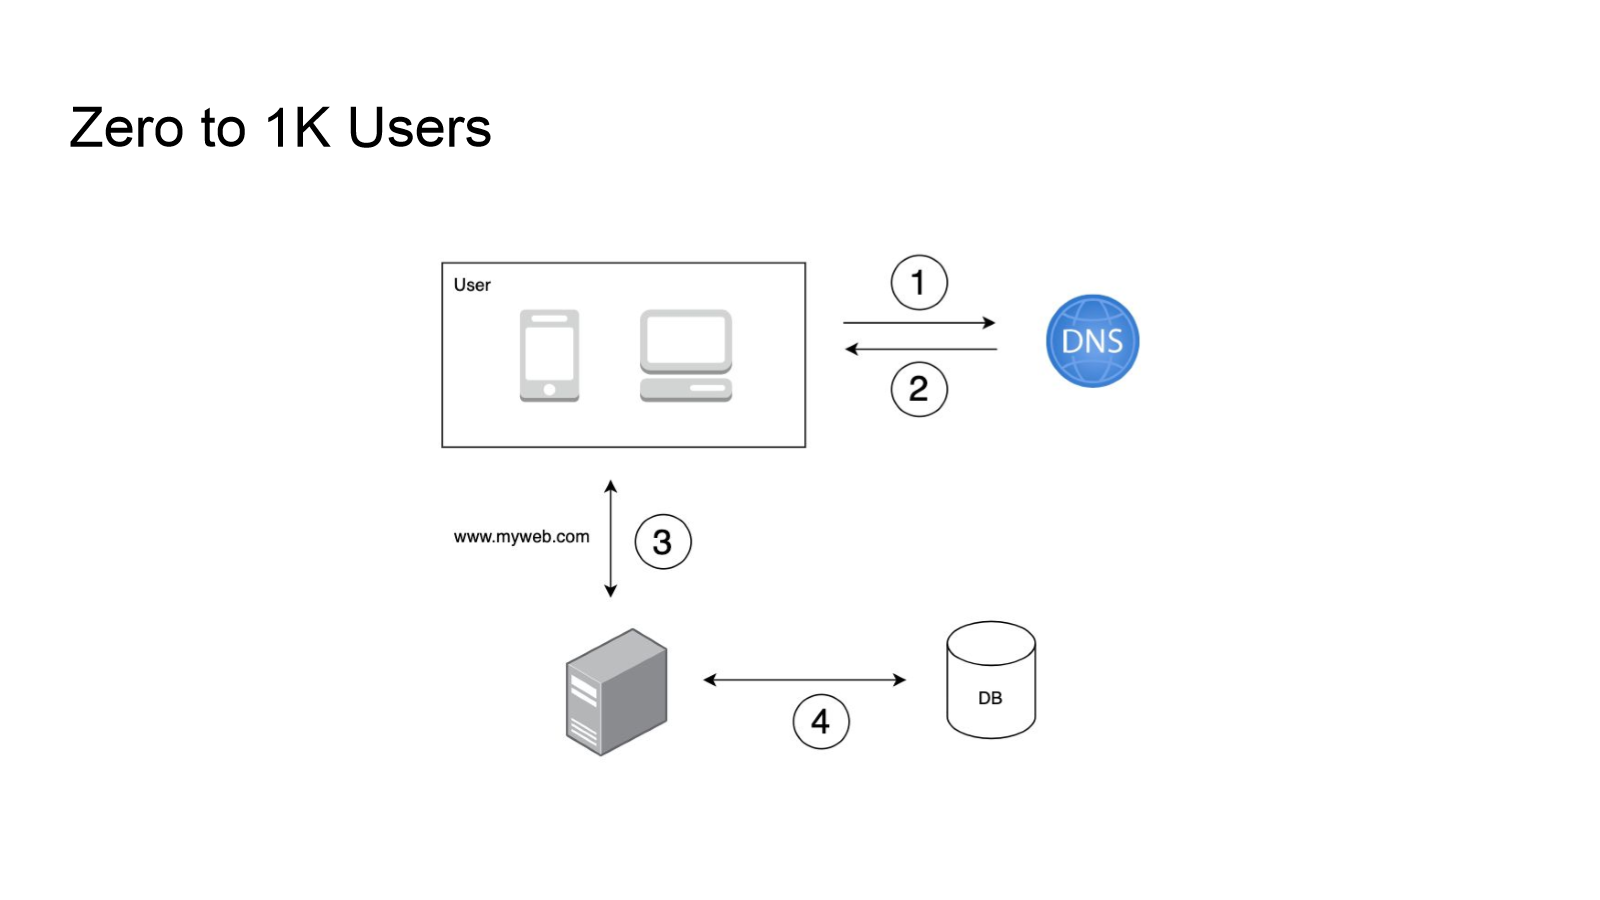
Tahap 1 — Zero to 1K Users. Arsitektur paling sederhana: user melakukan resolusi DNS untuk www.myweb.com (langkah 1–2), lalu mengakses satu server aplikasi tunggal (langkah 3) yang terhubung ke satu database (langkah 4).
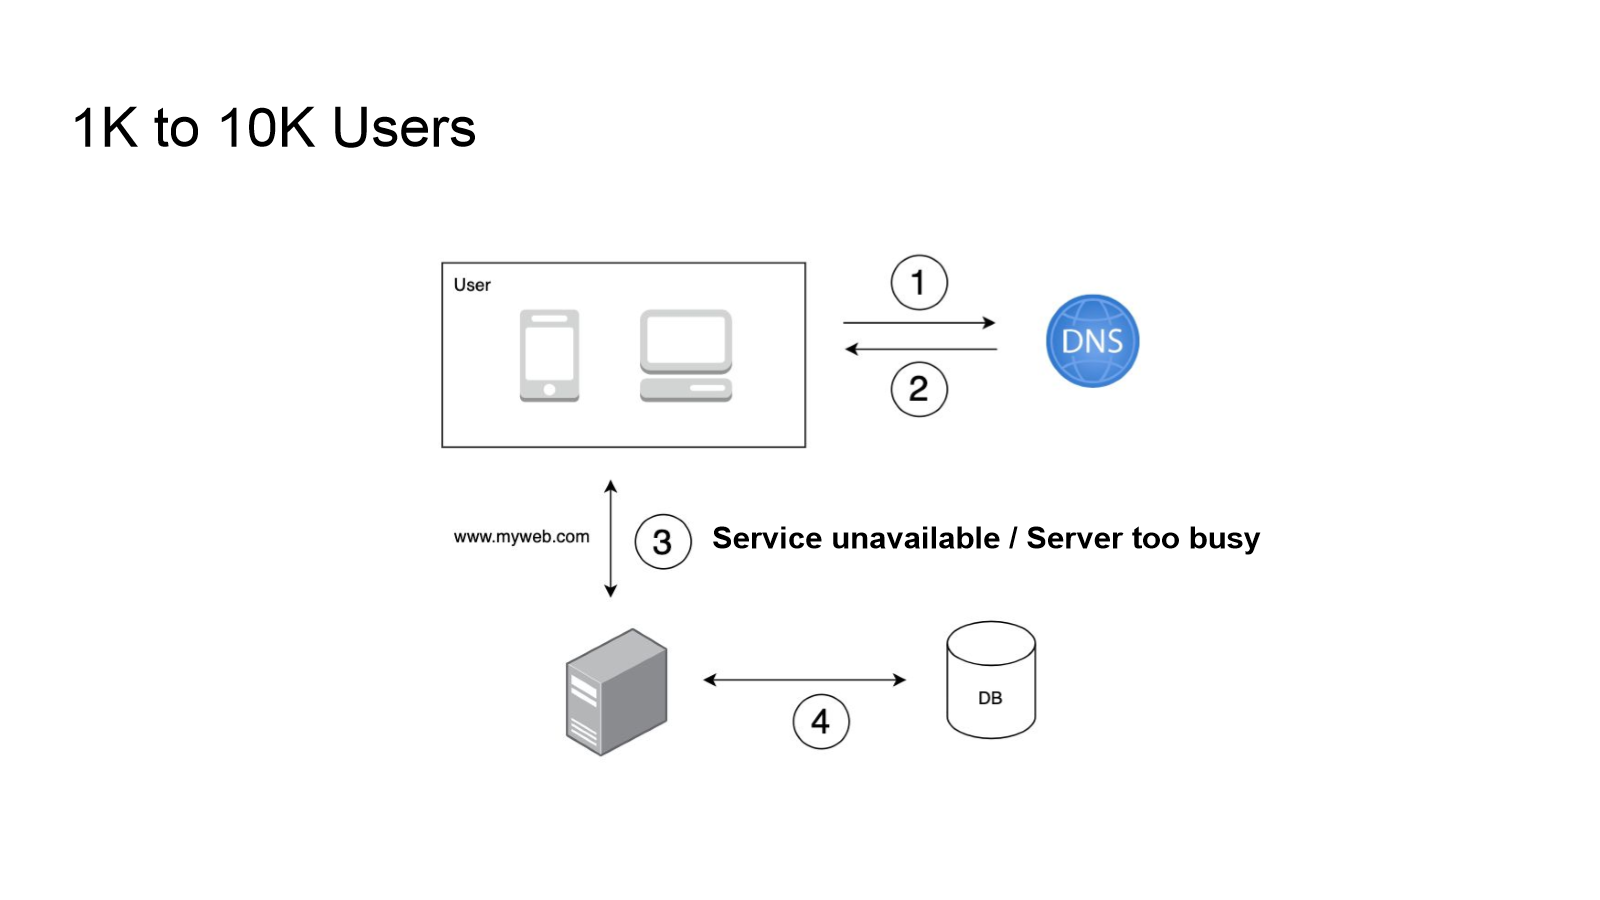
Tahap 2 — 1K to 10K Users: muncul masalah availability. Dengan arsitektur yang sama persis (satu server, satu DB), begitu jumlah user bertambah, server mulai kewalahan dan muncul error “Service unavailable / Server too busy”. Ini menunjukkan bahwa arsitektur single-server tidak scalable terhadap pertumbuhan trafik.
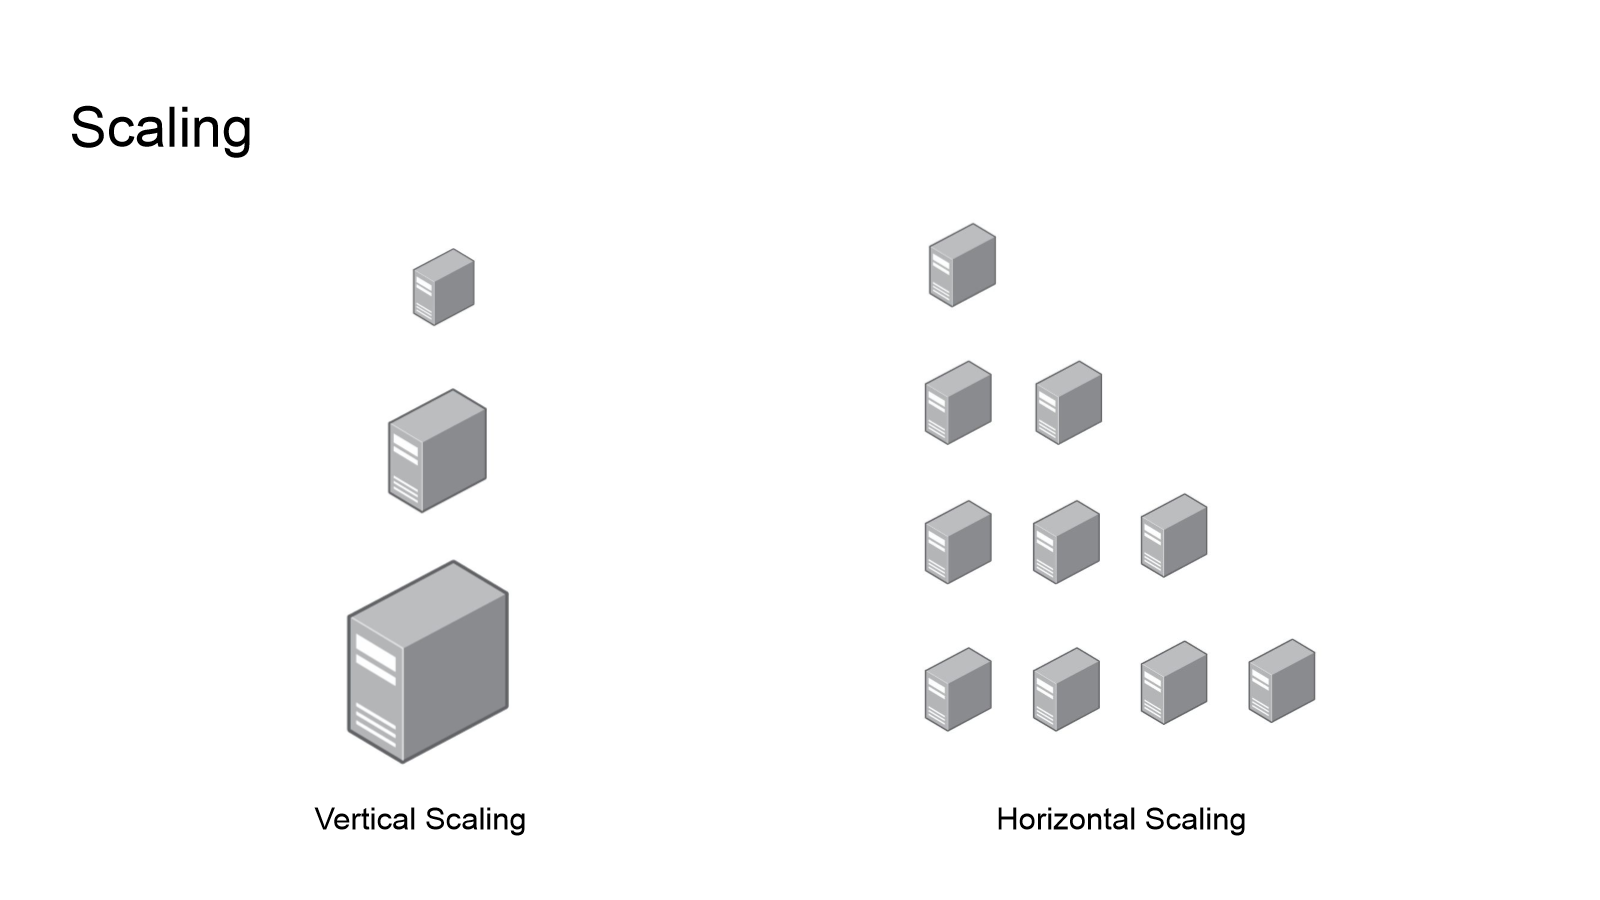
Tahap 3 — Menentukan strategi scaling. Ada dua pilihan dasar: vertical scaling (memperkuat satu mesin yang sama — CPU, RAM, storage lebih besar) atau horizontal scaling (menambah jumlah mesin/server).
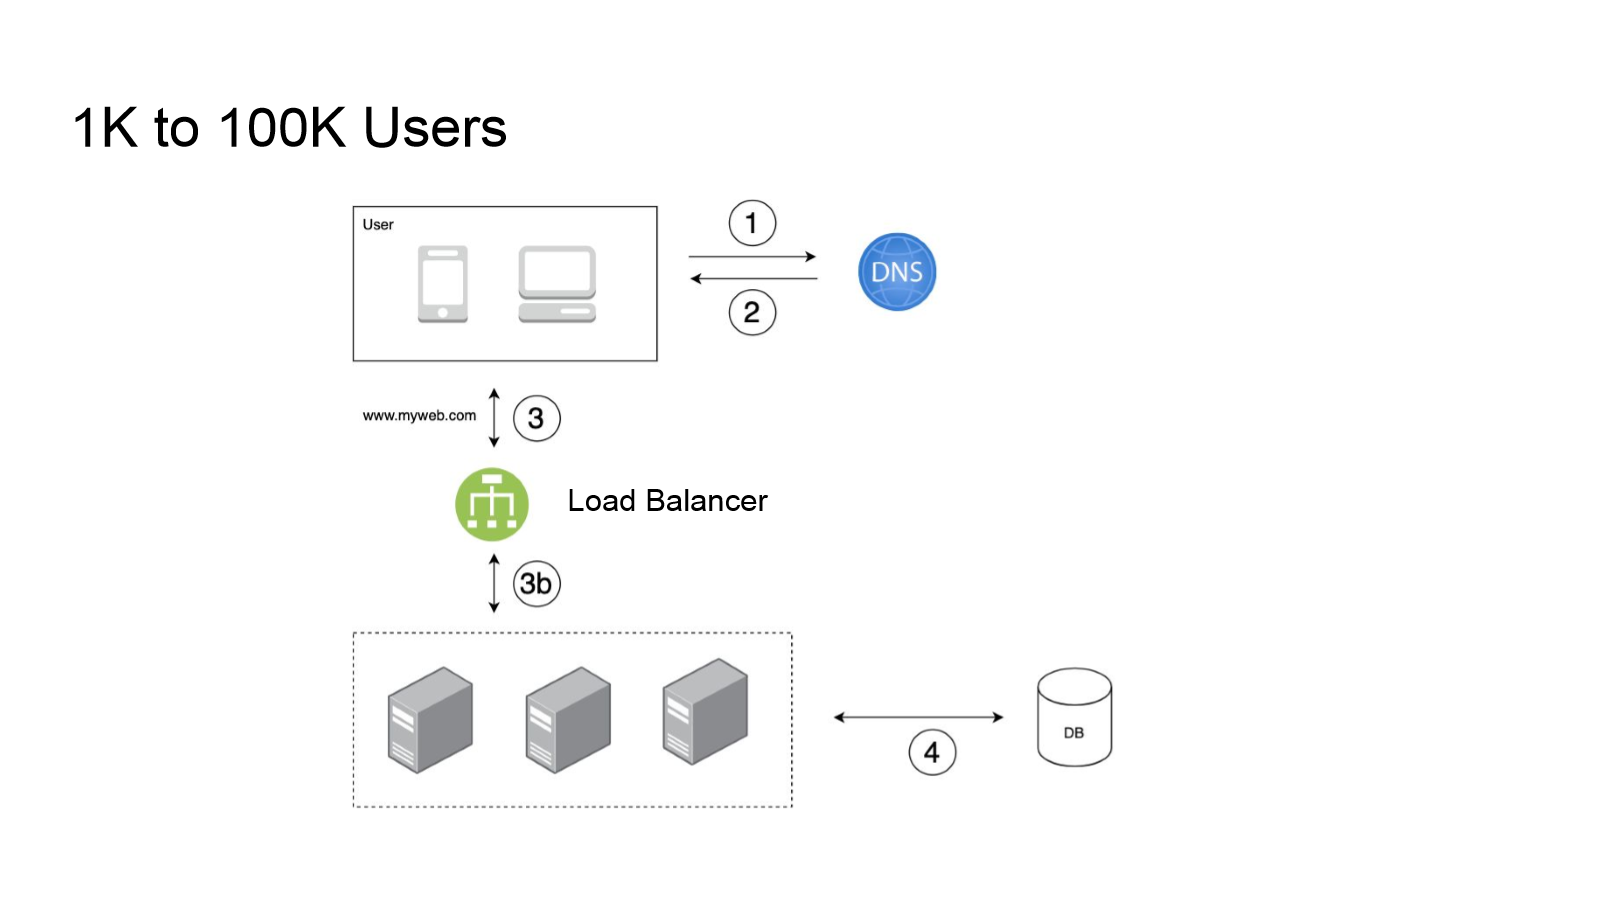
Tahap 4 — 1K to 100K Users: horizontal scaling + Load Balancer. Server aplikasi digandakan menjadi beberapa instance, dan sebuah Load Balancer ditambahkan di depan kumpulan server tersebut (langkah 3 → 3b) untuk mendistribusikan trafik secara merata ke server-server backend, sebelum diteruskan ke database (langkah 4).
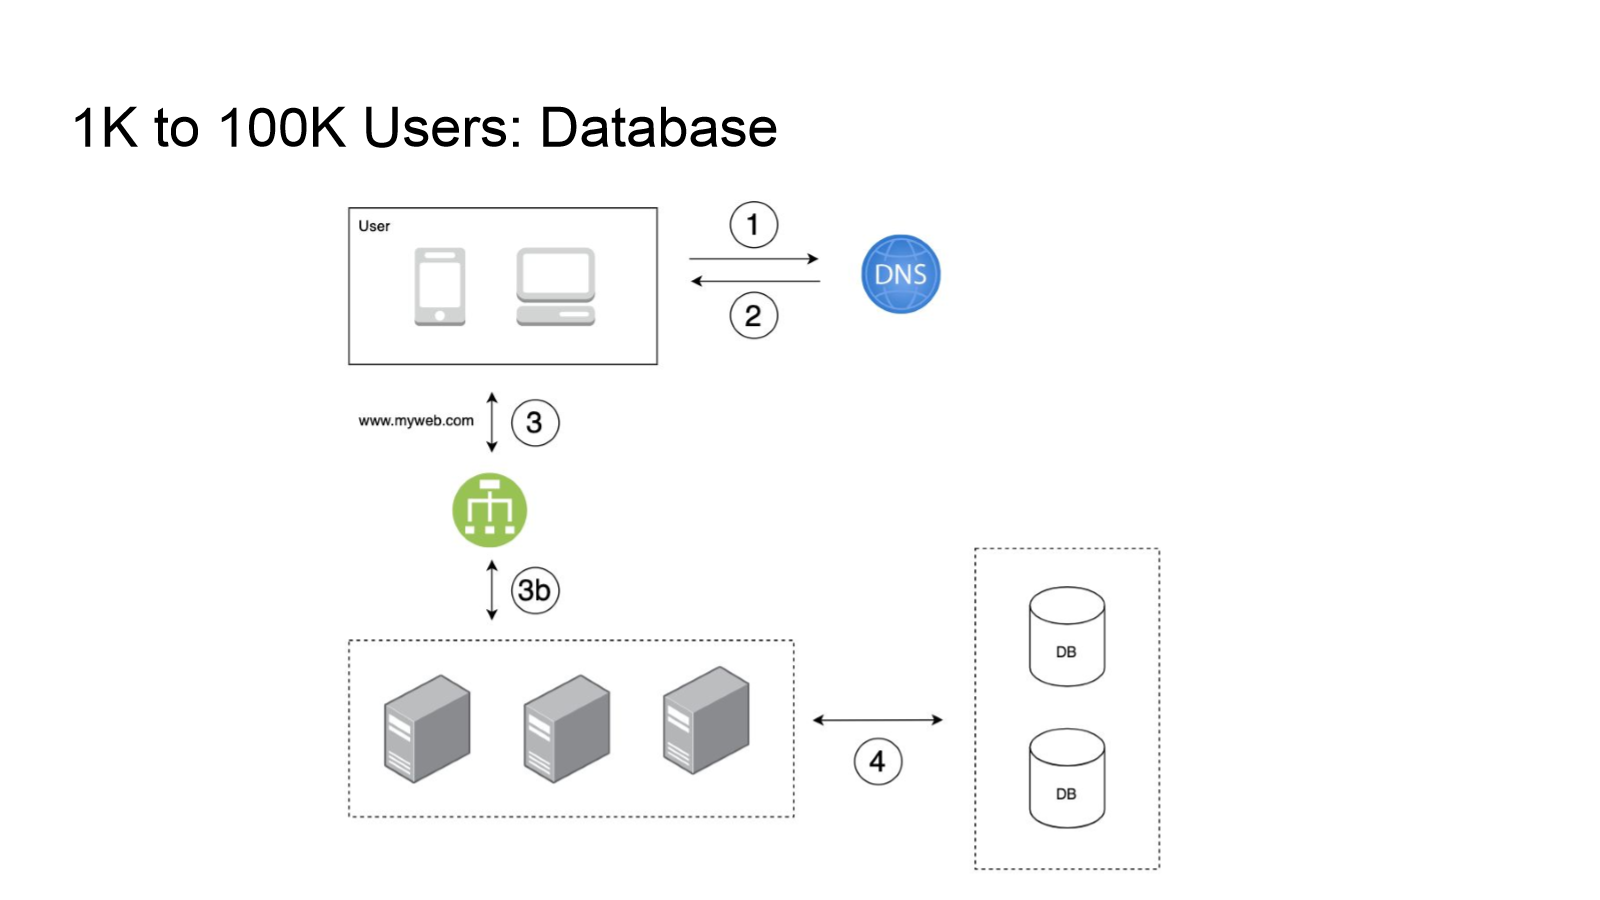
Tahap 5 — Scaling Database. Database tunggal juga menjadi bottleneck baru, sehingga perlu diperbanyak menjadi beberapa instance DB.
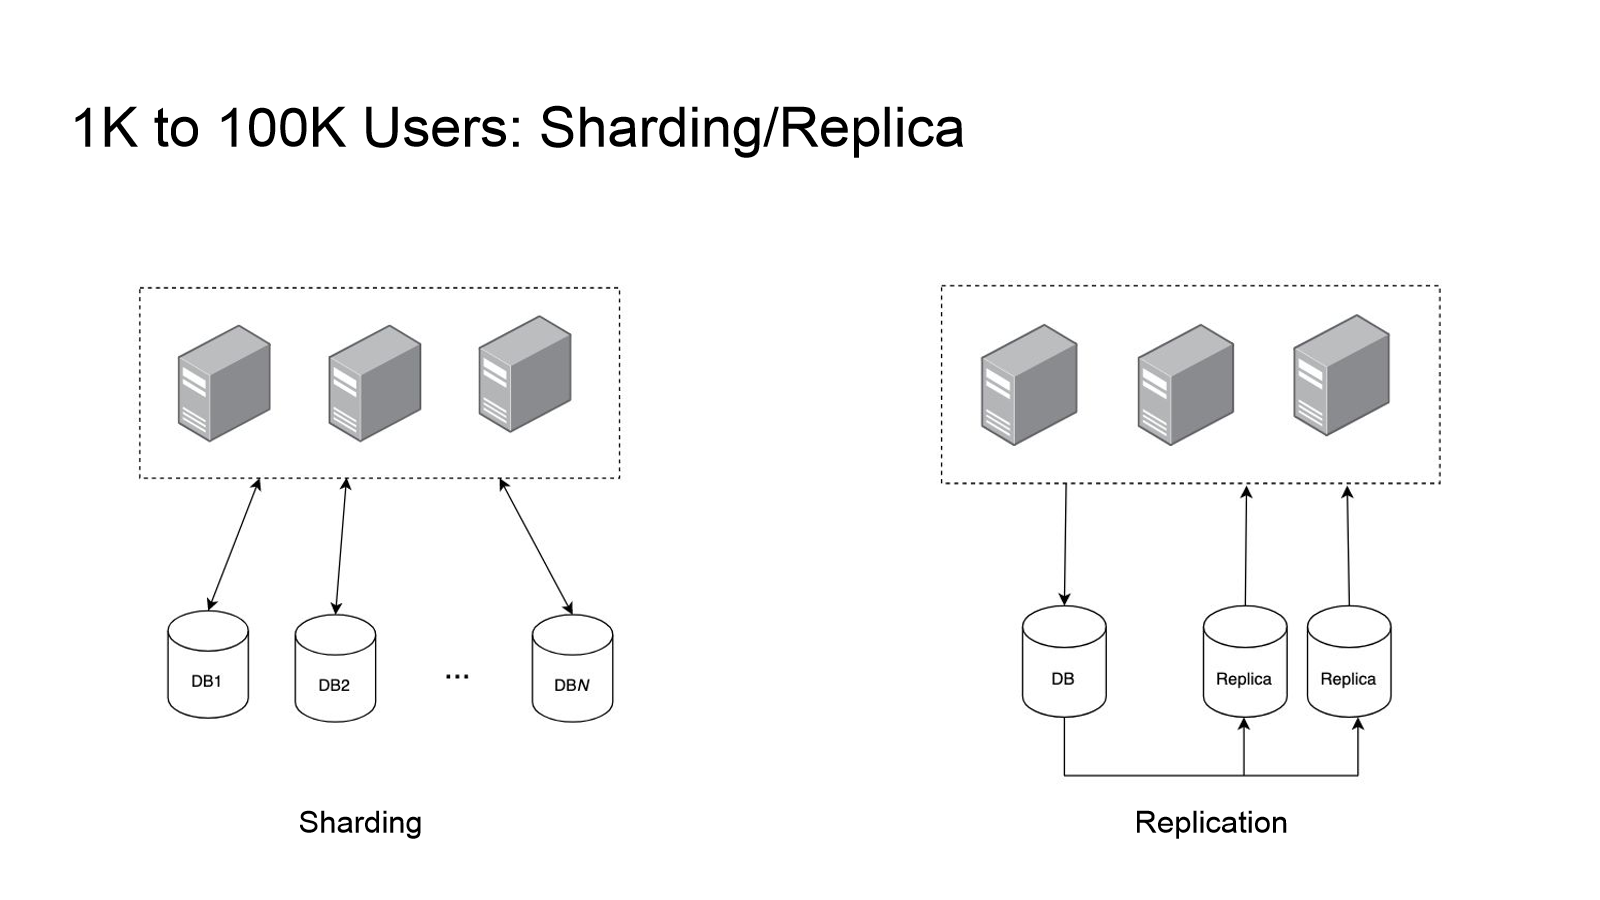
Tahap 6 — Memilih strategi database: Sharding vs Replication. Sharding membagi data ke beberapa DB berbeda (DB1, DB2, …, DBN) sehingga setiap shard menyimpan subset data yang berbeda; Replication menduplikasi seluruh data yang sama ke beberapa DB (satu DB utama dan beberapa replica).
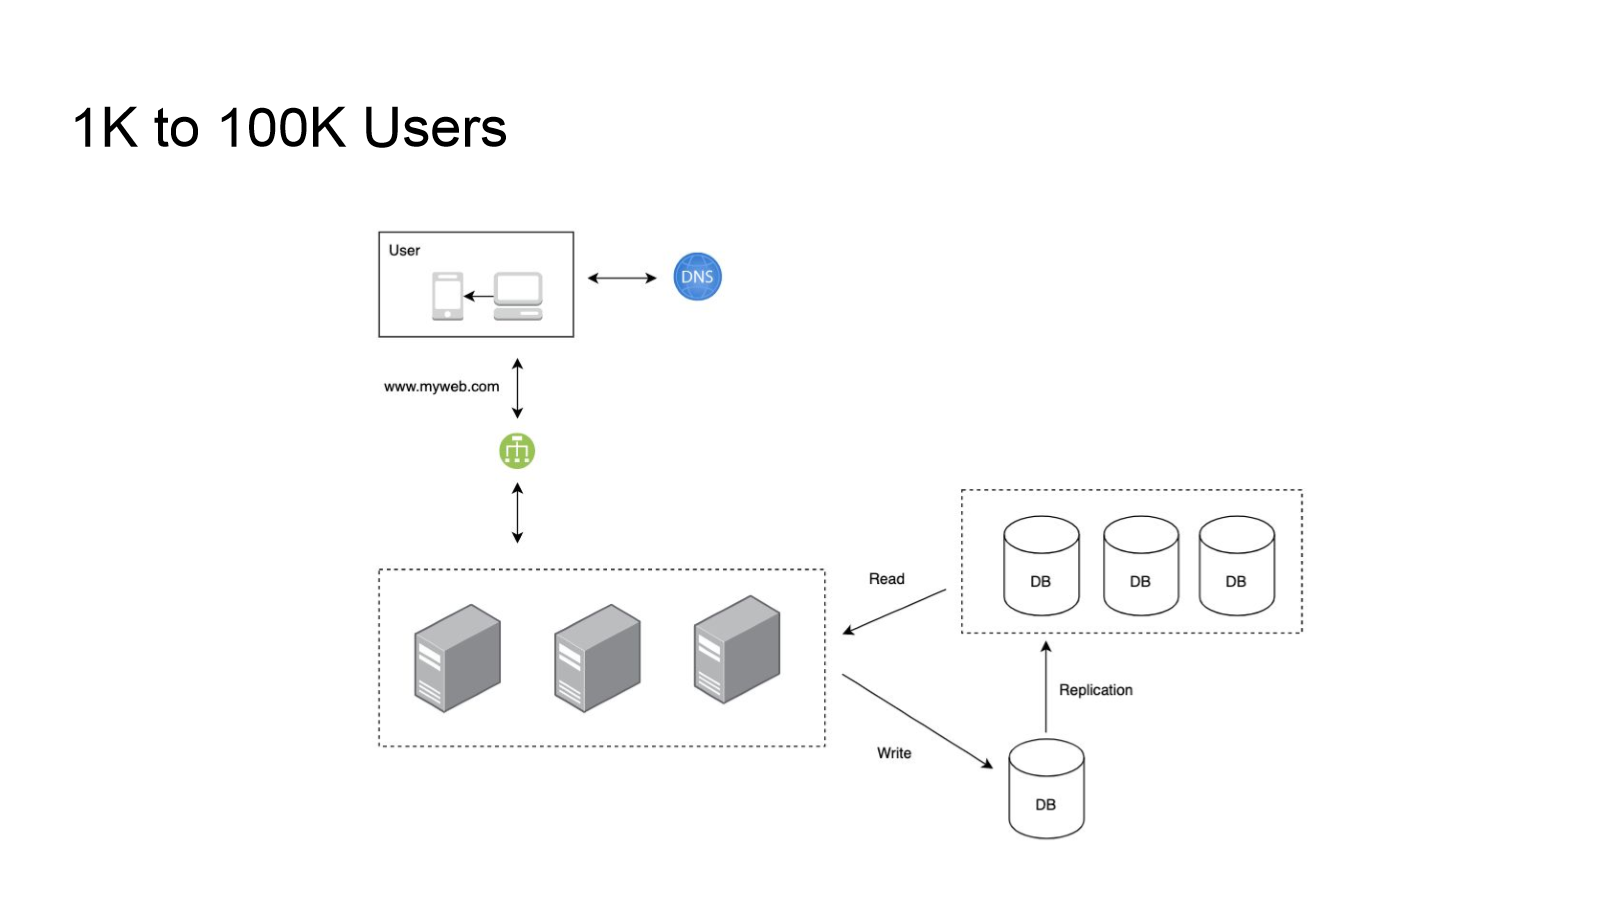
Tahap 7 — Menerapkan Read/Write Replication. Arsitektur final tahap ini menerapkan replication: server aplikasi melakukan write ke satu DB utama, yang kemudian direplikasi (replication) ke kumpulan DB read replica; server aplikasi melakukan read dari kumpulan replica tersebut. Pola ini memisahkan beban baca dan tulis agar database lebih scalable.
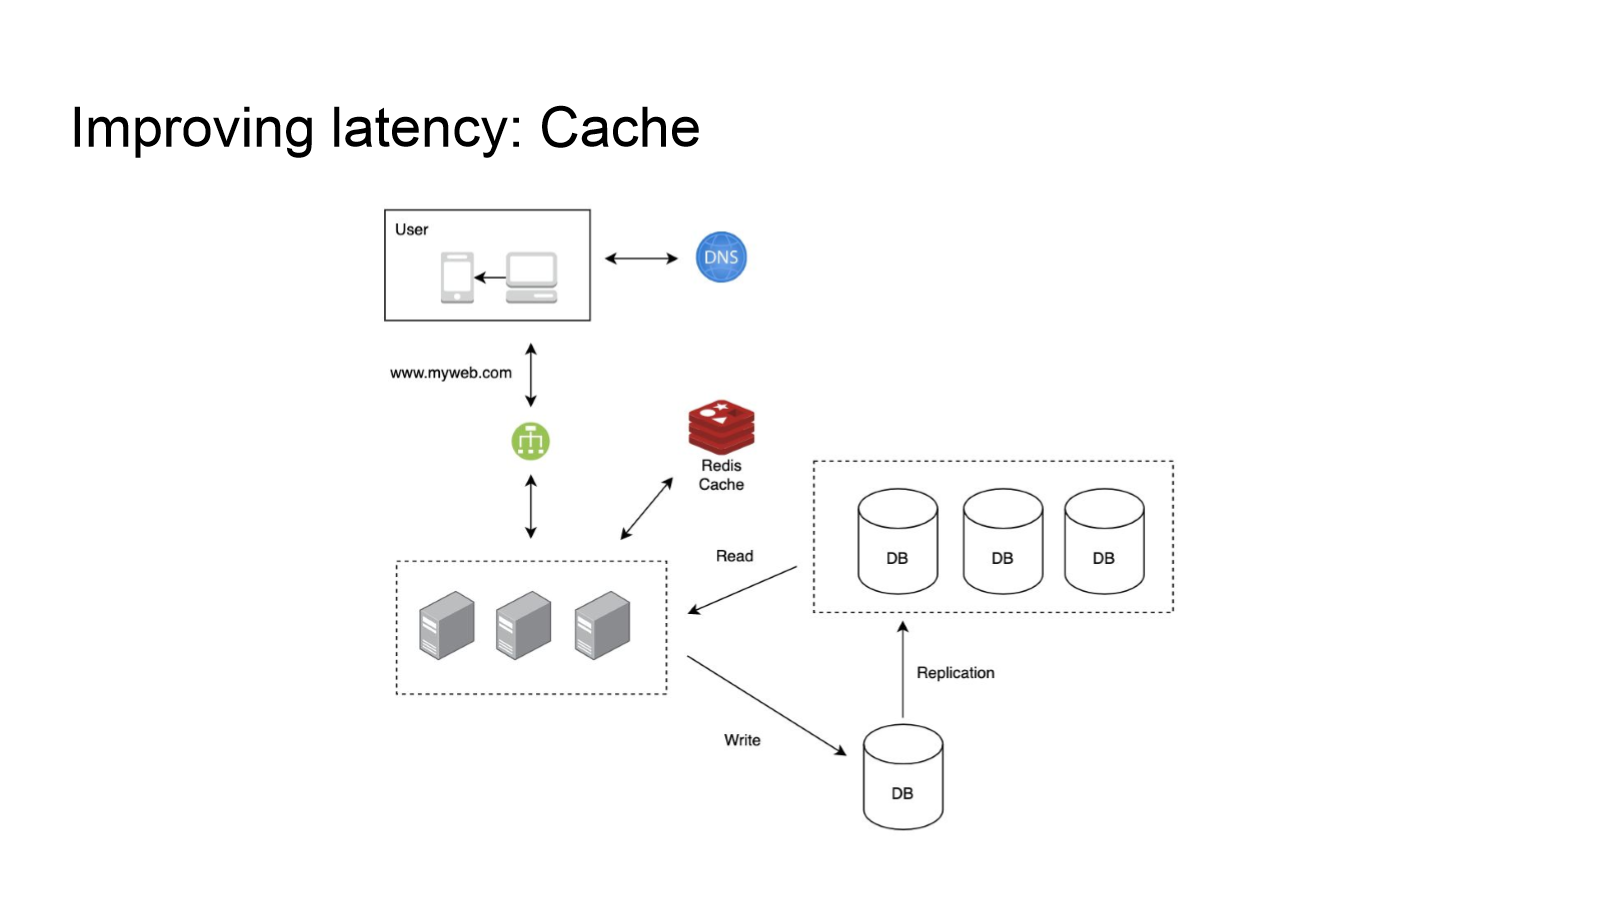
Tahap 8 — Improving Latency dengan Cache. Sebuah komponen cache (mis. Redis Cache) ditambahkan sejajar dengan load balancer/DB replica untuk mempercepat pembacaan data yang sering diakses, mengurangi beban langsung ke database.
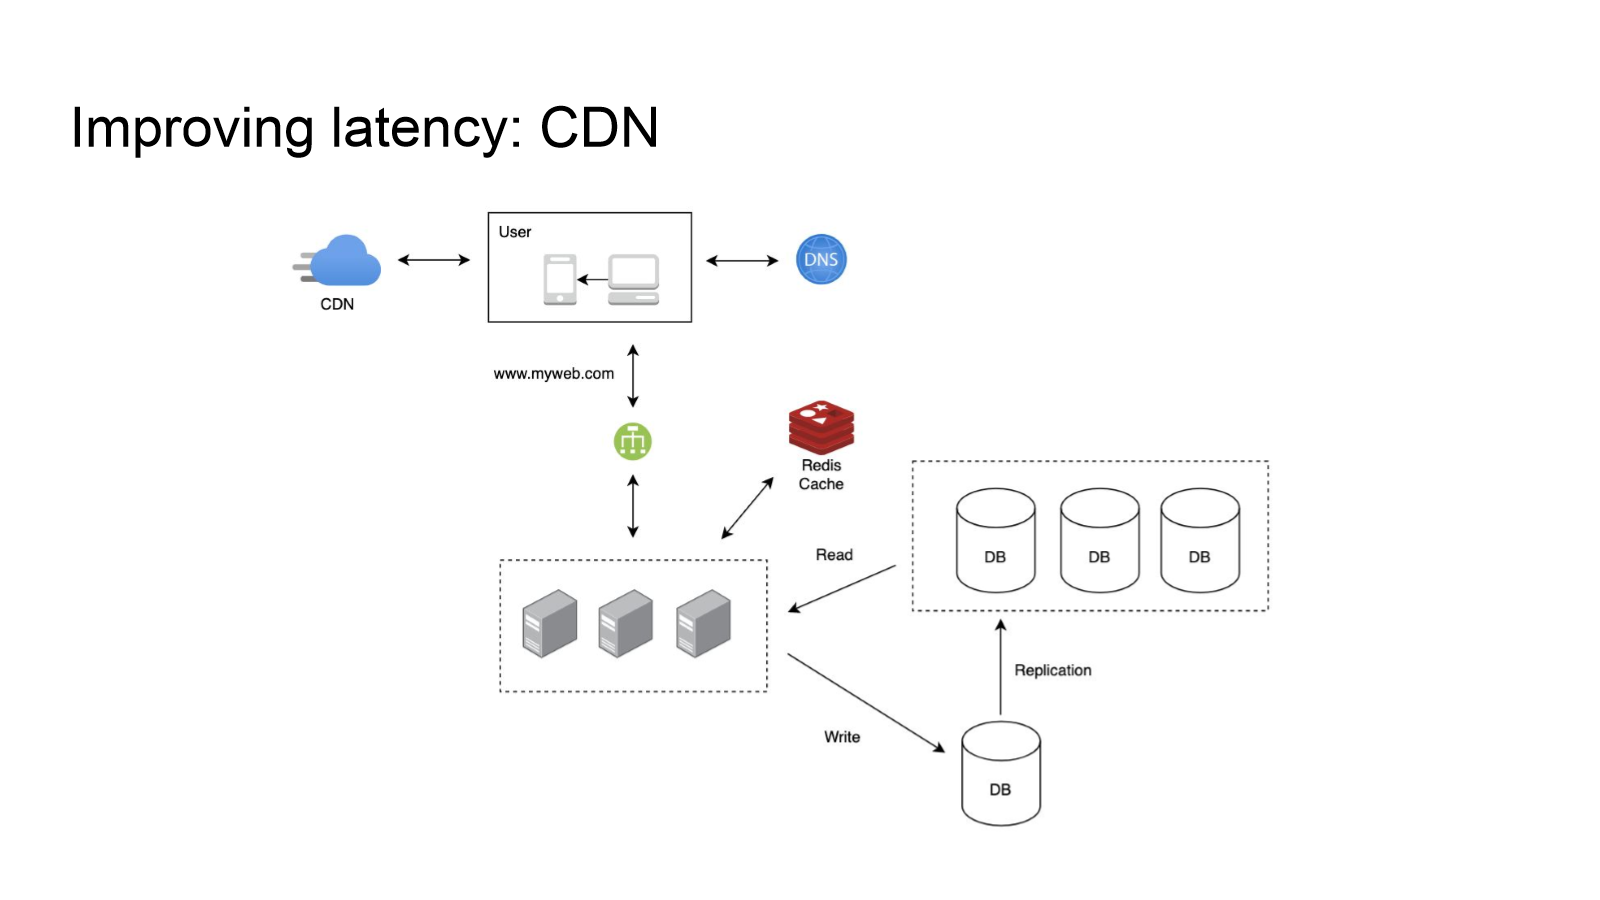
Tahap 9 — Improving Latency dengan CDN. Sebuah CDN ditambahkan di sisi user untuk melayani konten statis dari lokasi yang lebih dekat secara geografis, sehingga permintaan tidak perlu selalu mencapai server pusat.
Secara konseptual, CDN bekerja dengan menempatkan edge server/PoP (Point of Presence) di berbagai lokasi geografis dekat pengguna, dibandingkan hanya melayani semua user dari satu origin server yang jauh:
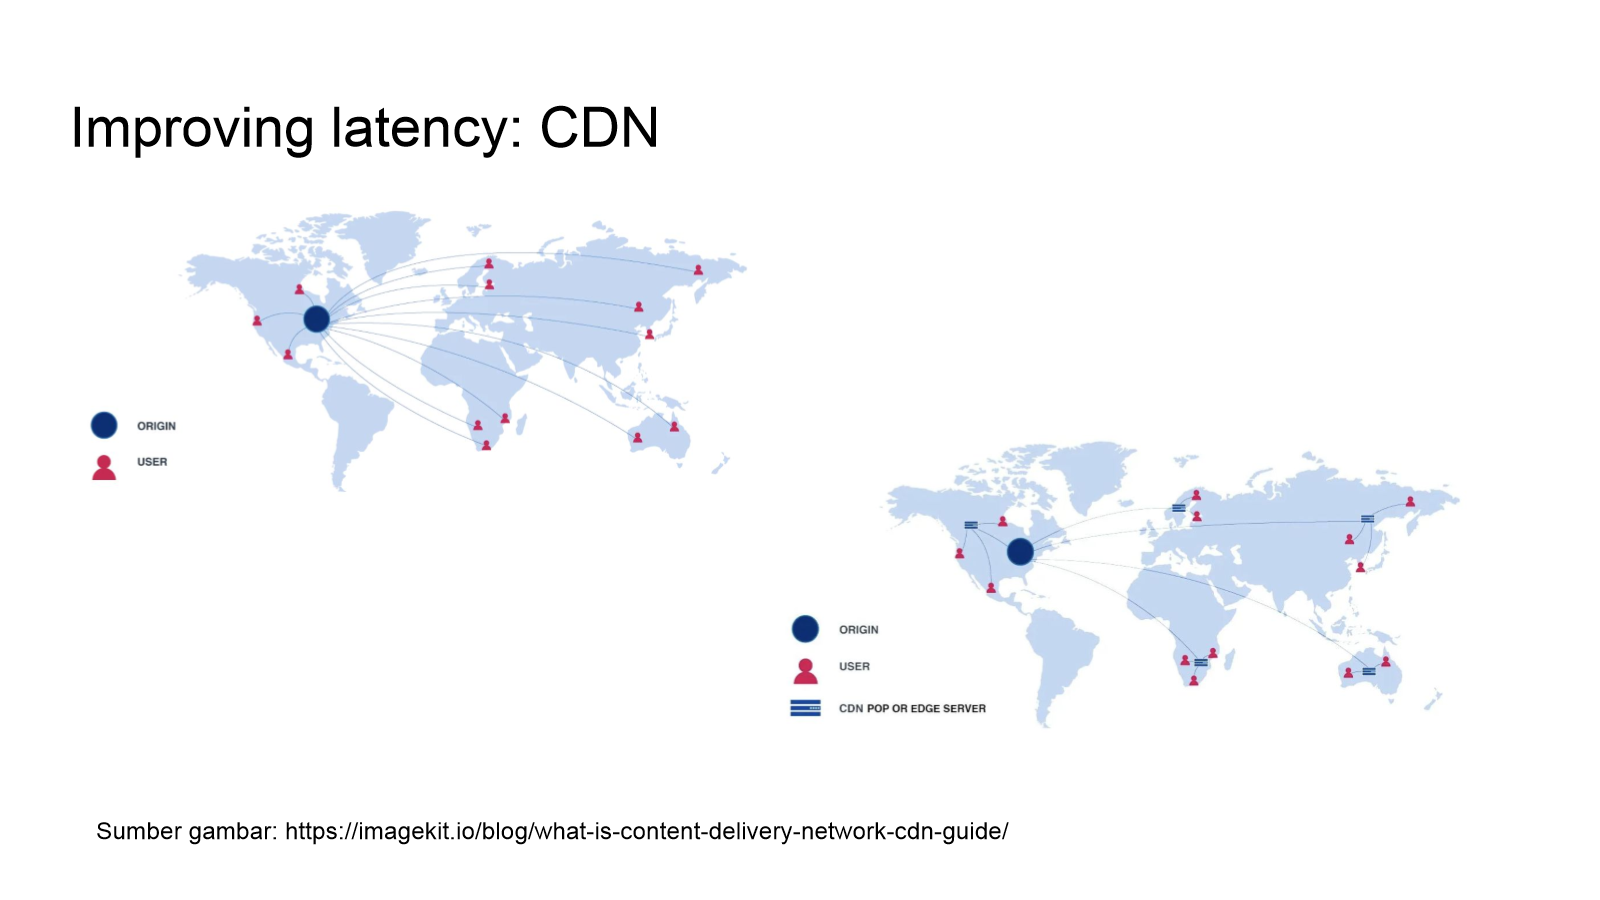
Poin diskusi dari slide: apa saja yang bisa disimpan di CDN (umumnya konten statis: HTML, CSS, JS, gambar, video), dan apakah response API bisa disimpan di CDN (dapat, untuk response yang jarang berubah/cacheable, namun perlu strategi invalidasi cache yang tepat).
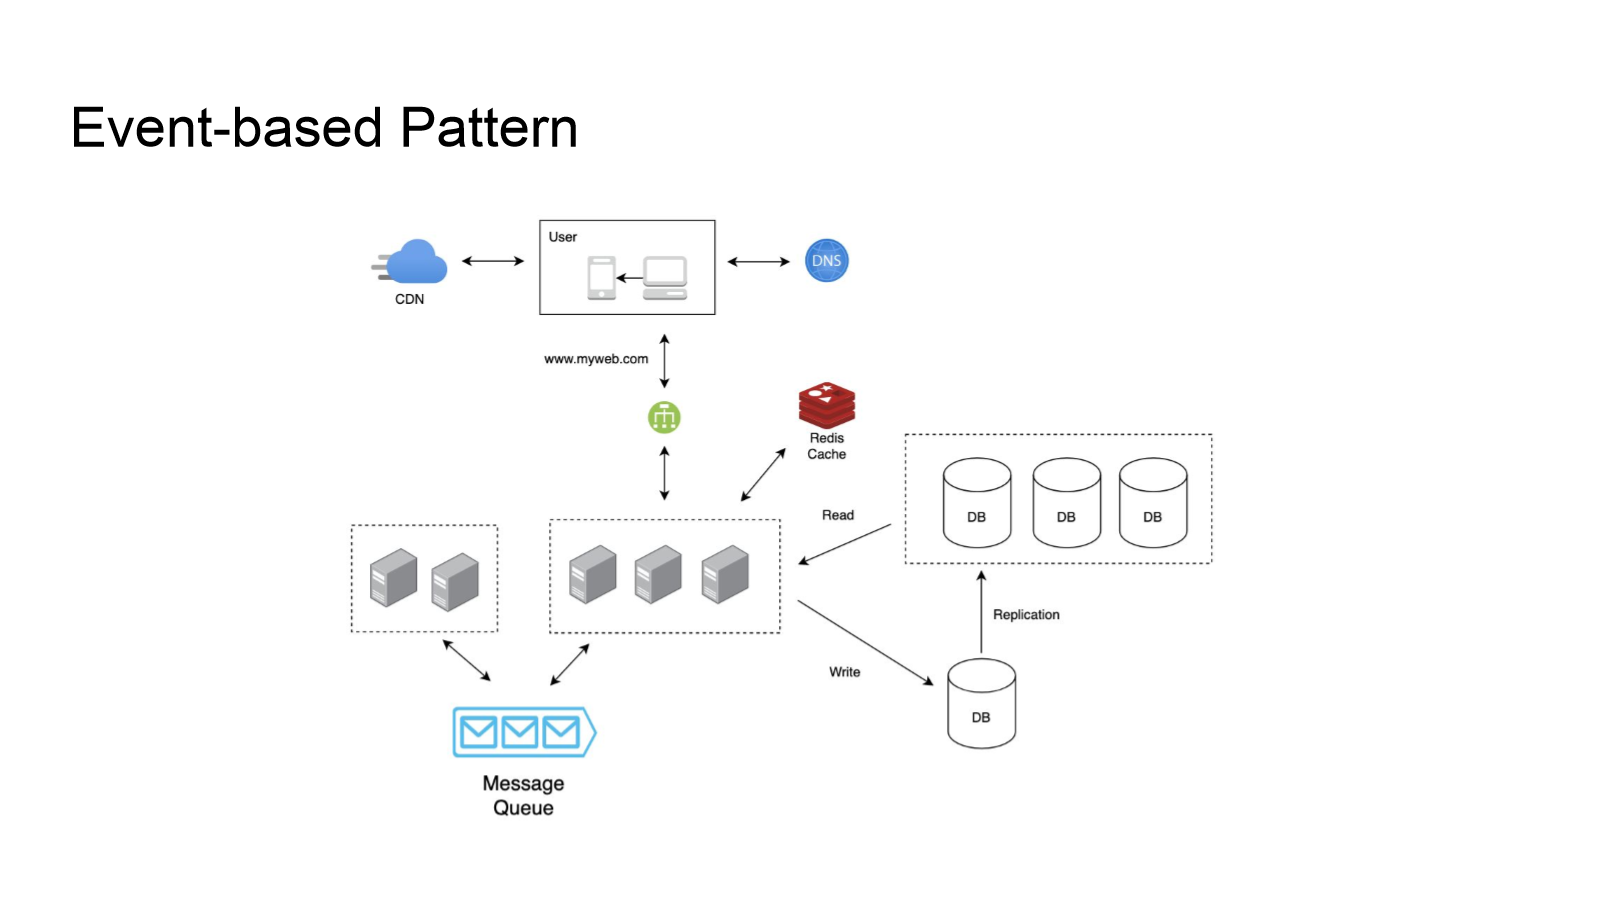
Tahap 10 — Event-based Pattern dengan Message Queue. Sekumpulan server pekerja (workers) baru ditambahkan, terhubung ke server aplikasi utama melalui Message Queue, memungkinkan pemrosesan tugas secara asynchronous (event-based) tanpa memblokir alur request-response utama.
Tahap 11 — Pertimbangan Monolith vs Microservices. Pada titik tertentu, arsitektur monolith (satu kumpulan server + satu DB di belakang satu load balancer) dapat dipecah menjadi microservices: beberapa kelompok server kecil, masing-masing dengan DB-nya sendiri, saling berkomunikasi satu sama lain, tetap di belakang satu load balancer/DNS yang sama dari sisi user.
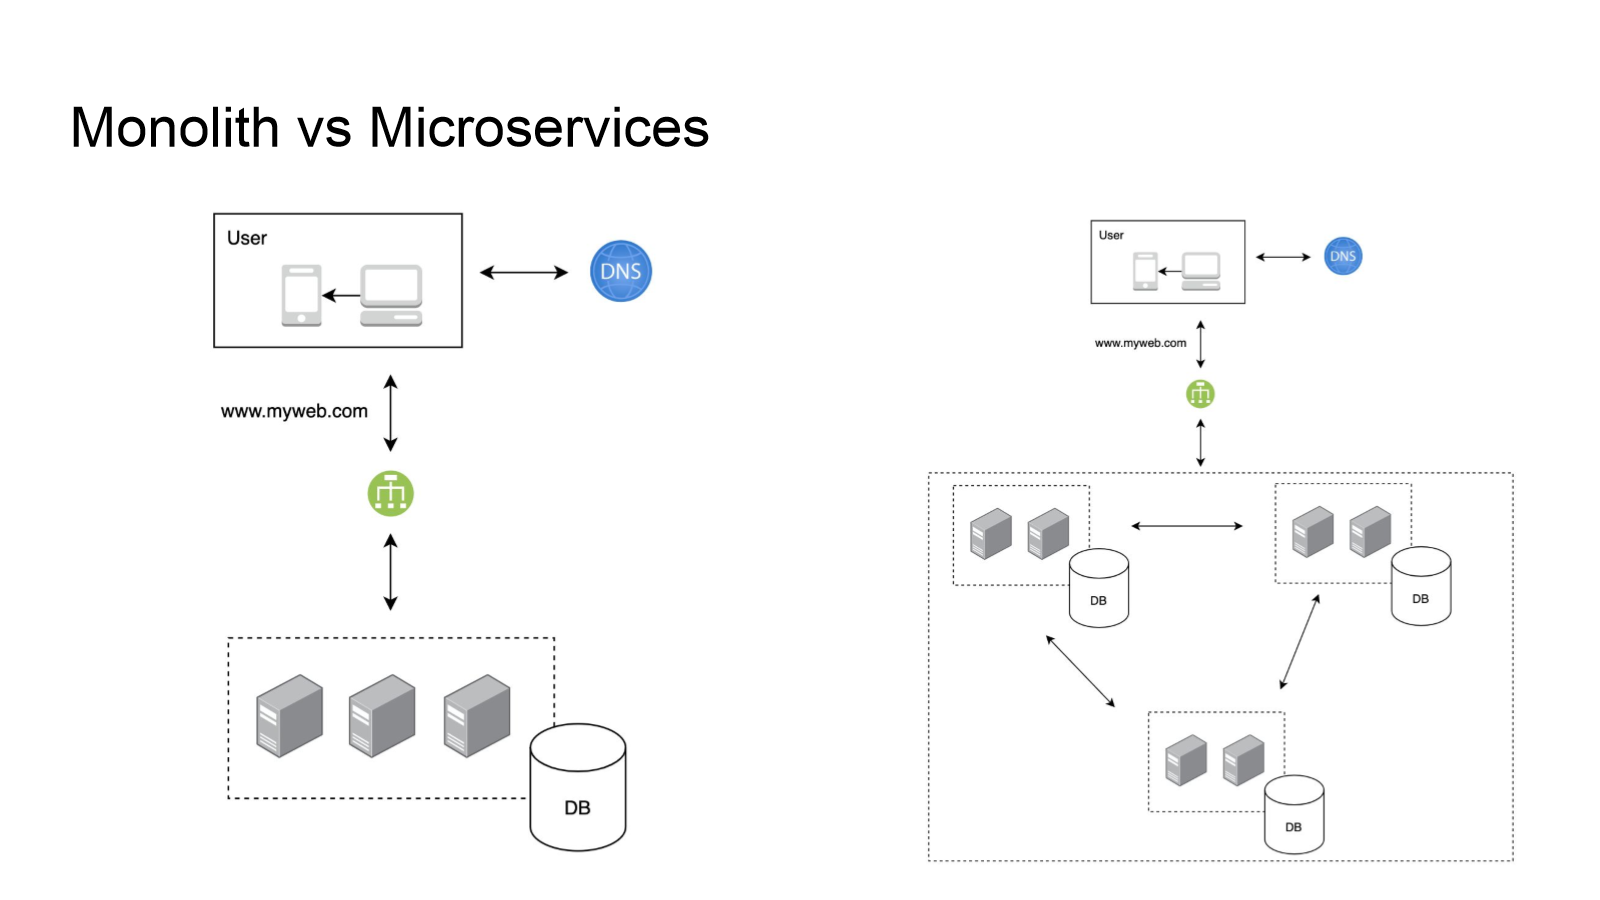
Poin diskusi dari slide — perbandingan kapan sebaiknya memilih monolith vs microservices, ditinjau dari lima aspek:
| Aspek | Monolith (cenderung) | Microservices (cenderung) |
|---|---|---|
| Development | Lebih sederhana di awal (satu codebase) | Lebih kompleks (banyak service, banyak repo) |
| Testing | Lebih mudah (dependency terpusat) | Perlu strategi test lintas service (integration test antar service) |
| Deployment | Deploy sekaligus (all-or-nothing), lebih berisiko | Deploy independen per service, risiko lebih terisolasi |
| Scalability | Scaling seluruh aplikasi sekaligus, kurang efisien | Scaling granular hanya pada service yang butuh |
| Fault-tolerance | Kegagalan satu bagian dapat menjatuhkan seluruh aplikasi | Kegagalan satu service dapat diisolasi (dengan pola seperti circuit breaker/bulkhead) |
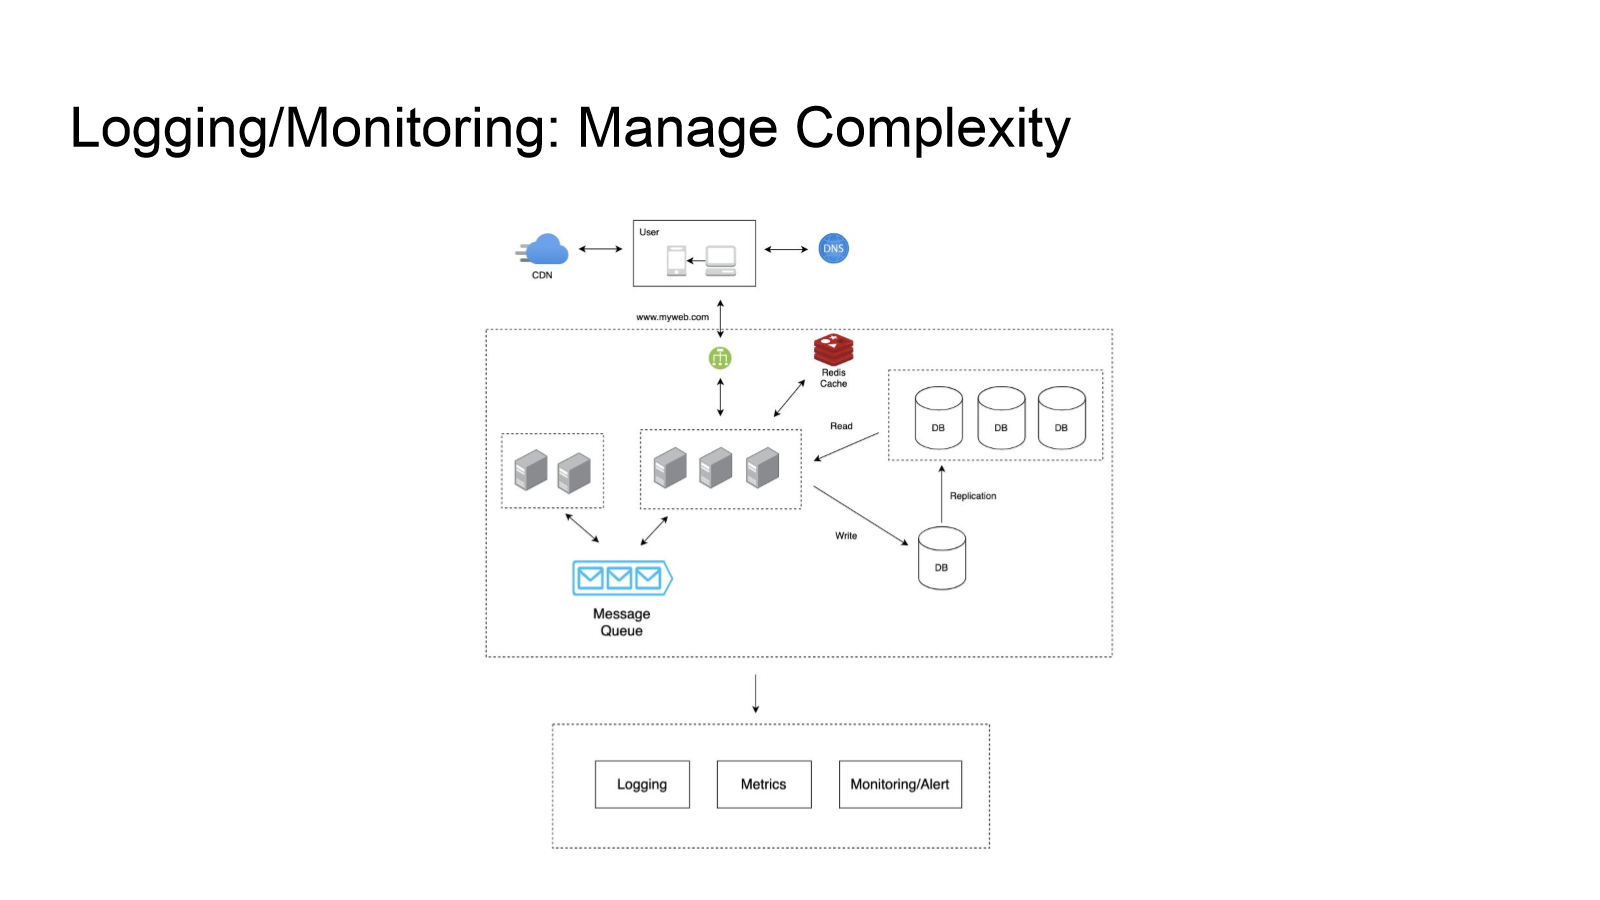
Tahap 12 — Logging/Monitoring untuk Mengelola Kompleksitas. Setelah arsitektur menjadi kompleks (load balancer, banyak server, cache, message queue, banyak DB), ditambahkan lapisan Logging, Metrics, dan Monitoring/Alert yang mengamati keseluruhan sistem — praktik ini selaras dengan prinsip “observe the system, not the components” pada bagian System Reliability.
Studi kasus ditutup dengan sesi diskusi mendalam bertajuk “Studi Kasus” (dilanjutkan secara interaktif/verbal dalam sesi kelas tanpa slide tambahan pada materi ini) untuk mempraktikkan penerapan seluruh konsep di atas pada kasus nyata.
Rangkuman Pola Evolusi yang Terlihat pada Studi Kasus
Dari seluruh tahapan di atas, terlihat sebuah pola pendekatan yang konsisten dalam mendesain sistem berskala besar: mulai dari arsitektur paling sederhana yang cukup untuk kebutuhan awal → identifikasi bottleneck konkret yang muncul seiring pertumbuhan beban (availability, kapasitas server, kapasitas database, latency, kompleksitas operasional) → terapkan teknik scalability yang paling sesuai untuk bottleneck tersebut (horizontal scaling, load balancer, sharding/replication, caching, CDN, message queue, microservices) → tambahkan observability (logging/monitoring) begitu sistem menjadi cukup kompleks untuk dipantau secara manual. Pendekatan bertahap ini mencerminkan penerapan langsung prinsip-prinsip reliability (redundancy, loosely coupled dependency, observability) dan scalability (vertical/horizontal scaling, stateless service, caching, database partitioning) yang telah dibahas sebelumnya.
Flashcard
flashcards Apa perbedaan definisi antara Reliability dan Resilience menurut materi ini? :: Reliability adalah kualitas untuk dapat dipercaya/bekerja konsisten dari waktu ke waktu, sedangkan Resilience adalah kapasitas untuk pulih dengan cepat dari kesulitan — kemampuan sistem untuk kembali ke kondisi normal setelah mengalami gangguan. Apa inti dari prinsip “blameless postmortem” dan mengapa itu penting? :: Blameless postmortem berfokus pada perbaikan sistem (memahami root cause, mis. lewat 5 Whys, dan menyusun action plan) tanpa mengindikasikan aktor penyebab kesalahan. Ini penting karena human error adalah masalah sistem, dan ketakutan akan hukuman membuat engineer menghindari pengambilan risiko terkontrol yang justru diperlukan. Sebutkan lima “Rules of Resilience” dari Astrid Atkinson. :: (1) Every node for itself — node pulih mandiri; (2) Everything runs on more than one machine — redundancy & statelessness; (3) Loosely coupled dependencies — batasi blast radius dengan circuit breaker/bulkhead; (4) Design for change — pakai tools, canary, rollback aman; (5) Observe the system, not the components — fokus pada metrik level sistem. Apa fungsi Circuit Breaker dan Bulkhead pattern dalam mencegah cascading failure? :: Circuit breaker membatasi dampak kegagalan sebuah service agar tidak merambat (cascading) ke service lain yang bergantung padanya. Bulkhead pattern mengisolasi resource (mis. connection pool) per workload/service, sehingga satu workload yang bermasalah tidak menghabiskan resource bersama yang dipakai workload lain. Apa perbedaan mendasar antara scaling vertikal dan scaling horizontal? :: Scaling vertikal meningkatkan kapasitas satu mesin (mis. tambah RAM, ganti SSD, upgrade processor), sedangkan scaling horizontal menambah jumlah mesin/server yang bekerja bersama-sama, biasanya membutuhkan load balancer dan desain service yang stateless. Mengapa stateless service lebih mudah di-scale secara horizontal dibanding stateful service? :: Karena stateless service tidak menyimpan state di antara request — semua session/file diambil dari shared storage, sehingga request dari user mana pun dapat dilayani oleh instance server mana pun tanpa bergantung pada server tertentu yang menyimpan state user tersebut. Apa perbedaan load balancer tipe NAT (Layer-4) dan Reverse Proxy? :: NAT bekerja di layer TCP/IP dengan meneruskan paket berdasarkan IP/port dan cocok untuk semua jenis service dengan skala sangat tinggi (~1-10 juta request/detik), sedangkan Reverse Proxy bekerja di layer HTTP, menyimpan full request/response, hanya untuk layanan HTTP, tapi punya fitur tambahan seperti SSL termination dan caching, dengan skala lebih rendah (~100rb-1 juta request/detik). Apa perbedaan sharding dan replication pada database sebagai strategi scaling? :: Sharding membagi data ke beberapa database berbeda sehingga tiap shard menyimpan subset data yang berbeda (membagi beban penyimpanan), sedangkan replication menduplikasi seluruh data yang sama ke beberapa database (satu utama + replica) untuk memisahkan beban baca (read) dari beban tulis (write) dan meningkatkan availability. Pada studi kasus evolusi arsitektur myweb.com, apa yang terjadi ketika trafik naik dari 1K ke 10K users tanpa perubahan arsitektur? :: Server single-instance yang sama menjadi kewalahan dan muncul error “Service unavailable / Server too busy”, menunjukkan bahwa arsitektur satu-server tidak scalable terhadap pertumbuhan trafik dan menjadi pemicu langkah scaling berikutnya. Sebutkan minimal empat tahapan berurutan dalam evolusi arsitektur studi kasus system design setelah load balancer ditambahkan. :: Setelah load balancer: (1) database digandakan/dipecah lewat sharding atau replication, (2) ditambahkan cache (mis. Redis) untuk improving latency, (3) ditambahkan CDN untuk konten statis, (4) ditambahkan message queue untuk event-based/asynchronous processing, dan selanjutnya dipertimbangkan migrasi ke microservices serta ditambahkan logging/monitoring untuk mengelola kompleksitas. Menurut diskusi pada studi kasus, apa trade-off utama antara desain monolith dan microservices dari sisi deployment dan fault-tolerance? :: Monolith di-deploy sekaligus (all-or-nothing) sehingga lebih berisiko, dan kegagalan satu bagian bisa menjatuhkan seluruh aplikasi; microservices dapat di-deploy independen per service dan kegagalan satu service dapat diisolasi (mis. dengan circuit breaker/bulkhead), sehingga fault-tolerance lebih baik meski development dan testing menjadi lebih kompleks. Mengapa lapisan Logging/Monitoring baru ditambahkan pada tahap akhir evolusi arsitektur studi kasus, dan apa kaitannya dengan prinsip resilience? :: Karena begitu arsitektur menjadi kompleks (load balancer, banyak server, cache, message queue, banyak DB), kompleksitas tersebut perlu dikelola dengan observability. Ini selaras dengan Rule #5 resilience (“observe the system, not the components”) yang menekankan pemantauan metrik level sistem secara keseluruhan, bukan hanya komponen individual.