Sesi tamu di kelas IF5153 ini dibawakan oleh Fajar J. Ekaputra (WU Vienna, alumnus ITB) dengan judul “An Introduction to Boxology Extended Annotation Model (BEAM)“. Materinya membahas boxology: notasi visual berjenjang kotak-dan-panah untuk membongkar arsitektur sistem AI hibrida (yang menggabungkan komponen learning/neural dengan komponen reasoning/simbolik) menjadi kombinasi dari sekumpulan kecil pola desain yang bisa dipakai ulang. Slide pembuka Ekaputra membingkai persoalan ini lewat tiga poin motivasi: (1) sistem AI makin kompleks — kombinasi berbagai komponen ML dan knowledge representation (KR) makin sulit dipahami sebagai satu kesatuan; (2) stakeholder-nya makin beragam secara disiplin ilmu, sebagian didorong oleh regulasi seperti EU AI Act dan tuntutan aspek etis/sosial AI, sehingga seorang etisis misalnya perlu memahami arsitektur sistem tanpa harus paham detail teknis tiap komponennya; (3) belum ada representasi yang dipahami bersama antar-stakeholder yang beragam ini, sehingga komunikasi dan transfer pengetahuan soal arsitektur AI jadi terhambat. Boxology — dan ekstensinya, BEAM — diajukan sebagai jawaban atas kesenjangan itu.
Catatan ini menelusuri bagaimana notasi boxology berkembang lewat rangkaian 5 paper (plus satu paper terkait dari kelompok riset yang sama), dari versi paling awal sampai versi yang dipakai di kelas ini.
Neuro-Symbolic AI: Konteks di Balik Boxology
Sebelum masuk ke notasinya, materi framing dari Ekaputra menjelaskan dulu kenapa kombinasi learning + reasoning ini penting, lewat analogi psikologi “Thinking, Fast and Slow” (Daniel Kahneman):
- System 1 (intuisi/instink): cepat tapi rawan salah, tidak sadar, asosiatif, “autopilot” — contoh: mendeteksi nada permusuhan dari suara seseorang. Dalam AI, ini dipetakan ke sub-symbolic AI / neural (mis. neural network) yang belajar pola dari data sebagai “parametric knowledge” di dalam model, lalu menyimpulkan pengetahuan baru berdasarkan pola yang sudah dipelajari.
- System 2 (rasional): lambat tapi bisa diandalkan, butuh usaha sadar, logis, “manual control” — contoh: menyebutkan nomor telepon seseorang. Dalam AI, ini dipetakan ke symbolic AI (mis. expert system berbasis rule) di mana aturan diberikan secara eksplisit, lalu sistem menyimpulkan/menalar pengetahuan baru berdasarkan sekumpulan rule eksplisit tersebut.
Slide memakai estimasi kasar bahwa ~95% pemikiran manusia sehari-hari adalah System 1 dan hanya ~5% System 2 — menunjukkan intuisi kenapa AI modern condong ke arah sub-symbolic (deep learning), tapi juga kenapa reasoning eksplisit tetap krusial untuk tugas yang butuh keandalan/interpretasi. Neuro-Symbolic AI (NeSy) adalah bidang yang mencoba menggabungkan keduanya. Dua definisi yang dikutip Ekaputra:
- NeSy Association: “integrasi neural dan symbolic AI, mengombinasikan sifat statistik dari machine learning dengan representasi dan penalaran pengetahuan (knowledge representation and reasoning).”
- Wang, Yang & Wu (2025, IEEE TPAMI): NeSy mencari integrasi dua kemampuan kognitif fundamental — learning (kemampuan belajar dari pengalaman) dan reasoning (kemampuan bernalar dari apa yang sudah dipelajari) — untuk mengeksploitasi kekuatan utama dan mengatasi kelemahan bawaan masing-masing paradigma.
Contoh klasik System 2/symbolic AI yang diberikan: expert system — menangkap pengetahuan tacit seorang ahli dalam domain sempit sebagai sekumpulan rule dalam rules engine yang bisa dipakai orang lain di organisasi (contoh permainan: Akinator, yang menebak karakter lewat serangkaian pertanyaan ya/tidak; contoh bisnis: sistem credit-granting dengan rule berjenjang A→B: jika income > 50.000, tanya cicilan mobil... dst.). Sementara System 1/sub-symbolic AI dicontohkan lewat neural network untuk deteksi fraud kartu kredit: network “belajar” pola dari data historis (usia, income, riwayat pembelian, dst.) lewat hidden layer, tanpa rule eksplisit — polanya (mis. “frekuensi beli sangat tinggi + nominal besar + riwayat pendek → cenderung fraud”) muncul implisit dari data, bukan didefinisikan manusia.
Masalah paper akademik pertama (van Harmelen & ten Teije) merumuskan hal serupa dari sisi teknis: deduksi vs induksi (pembedaan Peirce abad ke-19) — deduksi menurunkan kesimpulan spesifik φ dari sekumpulan pernyataan umum T (T ⊢ φ), sedangkan induksi menurunkan pernyataan umum T dari sekumpulan observasi spesifik φ₁,…,φₙ. Cara pandang lain: kompresi vs dekompresi — proses learning “mengompresi” observasi menjadi model yang lebih ringkas (pakai prinsip Minimum Description Length), sedangkan reasoning “mendekompresi” model itu menjadi prediksi baru. Ada juga pembedaan berdasarkan representasi: istilah Pearl “model-free” (dipakai learning system) vs “model-based” (dipakai reasoning system); Darwiche menyebutnya “function-based” vs “model-based”. Properti representasi model-based yang dianggap khas: compositional (makna model = fungsi dari makna komponennya), referential (simbol merujuk objek/relasi di dunia nyata), homologous (struktur model mencerminkan struktur dunia yang dimodelkan), interpretable, symbolic (bukan numerik), dan discrete (bukan kontinu/differentiable). Kedua limitasi masing-masing pendekatan saling melengkapi: sistem deep learning data hungry, limited transfer (model yang bagus di satu task sering gagal di task mirip), brittle terhadap adversarial input, opaque (sulit diekstrak rantai alasan yang bisa dipahami manusia), dan tidak memanfaatkan prior knowledge; sementara sistem symbolic brittle terhadap data noisy (representasi diskritnya sulit menangkap pengecualian), mahal untuk diperoleh (perlu knowledge-base eksplisit dari expert), dan rawan combinatorial explosion saat jumlah aksioma/individu/kedalaman reasoning membesar. Kombinasi keduanya — hybrid learning-and-reasoning system — adalah objek yang coba dipetakan oleh boxology.
Notasi Boxology: Ide Dasar
Ide inti boxology (istilah yang dipakai bercanda oleh van Harmelen & ten Teije, merujuk pada definisi umum “representasi struktur terorganisir sebagai graf dari node berlabel dan koneksi antar-node”): alih-alih mendeskripsikan tiap sistem hybrid secara ad hoc dalam prosa atau diagram bebas, gambarkan arsitekturnya sebagai komposisi dari sejumlah kecil pola desain (design pattern) yang dibangun dari elemen notasi yang sama. Filosofinya meniru design pattern di Software Engineering (Gang of Four) dan inference structure di CommonKADS (Knowledge Engineering): pola yang dapat dipakai ulang, mendorong reuse, menyediakan bahasa bersama antar-komunitas, dan berguna sebagai alat didaktik.
Elemen paling dasar dalam notasi aslinya (van Harmelen & ten Teije, 2019) hanya dua jenis bentuk:
- Oval = komponen algoritmik (yang melakukan komputasi), dibedakan jadi dua tipe: KR (melakukan inferensi deduktif, simbolik) dan ML (melakukan inferensi induktif, statistik).
- Kotak = struktur data input/output komponen, dibedakan jadi dua tipe: sym (struktur model-based, simbolik/relasional — mis. knowledge graph, taxonomy) dan data (struktur model-free — mis. teks, gambar, angka).
Dari dua bentuk dasar ini, komposisi paling sederhana adalah: sym → KR → sym (sistem KR klasik) dan data → ML → data (sistem ML klasik). Diagram panah menyatakan alur data: keluaran satu komponen menjadi masukan komponen berikutnya.
Fondasi: Van Harmelen & Ten Teije (2019) — Boxology Awal
Paper fondasi “A Boxology of Design Patterns for Hybrid Learning and Reasoning Systems” (Frank van Harmelen & Annette ten Teije, Journal of Web Engineering 18(1-3), 2019) adalah paper pertama yang memperkenalkan notasi boxology dan katalog pola desainnya. Klaim intinya bukan mengklaim mencakup seluruh literatur hybrid AI (dianggap sudah terlalu voluminous untuk itu), melainkan mengklaim bahwa pola-polanya mencakup semua variasi desain yang muncul di literatur — divalidasi terhadap lebih dari 50 paper dari dekade sebelumnya.
Paper ini mengidentifikasi 15 pola, dibangun dari komposisi 4 pola elementer (sym→KR→sym, data→ML→data, plus dua variasi campuran). Berikut katalognya, dengan nama yang dipakai paper aslinya:
| # | Nama pola | Notasi (ringkas) | Contoh/penjelasan |
|---|---|---|---|
| 3 | Learning with symbolic input and output | sym → ML → sym | ILP, Probabilistic Soft Logic, Markov Logic Networks — ML diterapkan ke struktur simbolik, bukan data mentah |
| 4 | From symbols to data and back again | sym → ML → data → ML → sym | Graph completion: knowledge graph di-embed ke vector space, lalu diprediksi edge baru, hasil diterjemahkan balik ke simbol |
| 5 | Learning from data with symbolic output | data → ML → sym | Ontology learning dari teks; juga mencakup decision tree learning, rule mining |
| 6 | Explainable learning systems | data → ML → sym → KR → sym | Output ML (simbolik) dipakai KR untuk menyusun penjelasan yang bisa dipahami manusia |
| 7 | Explainable learning systems with background knowledge | pola 6 + input sym tambahan ke KR | KR memakai background knowledge eksplisit saat merekonstruksi penjelasan |
| 8 | Explainable learning systems through inspection | data→ML→data, lalu KR menginspeksi state ML lewat sym | KR menjelaskan perilaku ML (mis. fitur mana yang berhasil dipakai) tanpa mengubah cara kerja ML itu sendiri |
| 9 | Learning an intermediate abstraction for learning | data → ML → sym → ML → data | Perceptual input dipelajari jadi representasi simbolik antara, lalu dipakai reinforcement learning berikutnya (mis. transfer learning spasial) |
| 10 | Learning an intermediate abstraction for reasoning | data → ML → sym → KR → sym | AlphaGo: ML mempelajari fungsi evaluasi papan, hasilnya dipakai Monte Carlo Tree Search (KR) untuk memilih langkah |
| 11 | Deriving an intermediate abstraction for reasoning | data → KR(pakai sym) → sym → ML → sym | Data stream mentah diabstraksi jadi simbol lewat ontology (KR), baru diklasifikasi ML — performa lebih baik di data simbolik |
| 12 | Learning with symbolic information as a prior | sym (prior) masuk ke data → ML → data | Logic Tensor Networks: prior knowledge simbolik meningkatkan hasil belajar dengan data lebih sedikit dan lebih tahan noise |
| 13 | Learning with derived symbolic information as a prior | sym → KR → sym sebagai sumber prior ke data → ML → data | Prior tidak diberikan langsung, tapi diturunkan dulu oleh reasoner |
| 14 | Meta-reasoning for control | KR menalar state (sym) dari data→ML→data untuk mengontrolnya | KR memutuskan apa yang harus dipelajari ML dan kapan (hyper-parameter, kapan berhenti belajar) — analogi: murid yang sadar merefleksikan proses belajarnya sendiri |
| 15 | Meta-reasoning for learning to reason | sym→KR→sym diamati oleh ML untuk meniru perilaku deduktif | ML dilatih meniru perilaku KR reasoner pada query baru — mencakup reasoning atas RDF knowledge base, Description Logic reasoning |
Selain 15 pola di atas, paper ini menegaskan sifat kompositional: pola kompleks selalu bisa dibangun dari pola-pola elementer yang lebih sederhana (mis. pola 4 = komposisi sekuensial pola 3 + pola 5). Paper ini juga secara eksplisit menyebut keterbatasannya sendiri sebagai arah kerja selanjutnya: (a) belum ada grammar formal yang menghasilkan seluruh ruang kombinasi pola secara sistematis, (b) notasinya belum mendukung aktor manusia (human-in-the-loop) sebagai tipe pemroses ketiga di samping ML dan KR, dan (c) pembedaan data vs symbol sendiri diakui belum punya definisi formal yang tegas — baru sebatas intuisi bersama. Ketiga celah inilah yang kemudian diisi oleh paper-paper berikutnya.
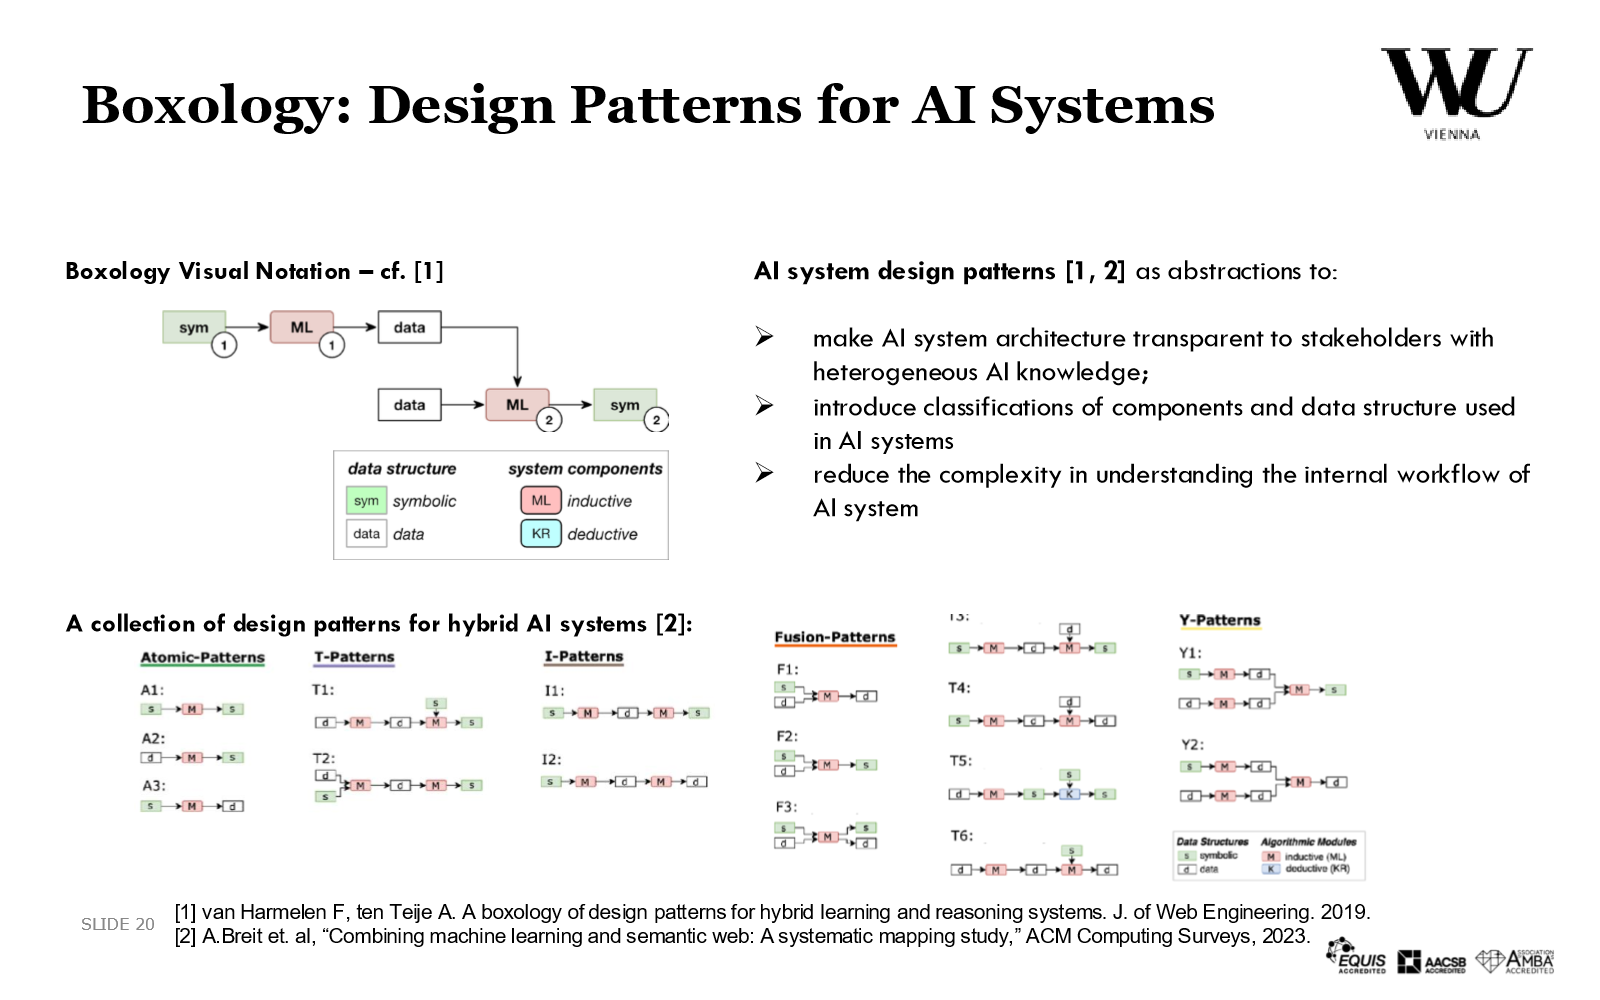
Belakangan, klasifikasi pola boxology juga di-organize ulang secara lebih sistematis oleh Breit et al. (2023, “Combining machine learning and semantic web: A systematic mapping study”, ACM Computing Surveys) menjadi kelompok bernama: Atomic-Patterns (A1-A3, pola tunggal s→M→s, d→M→s, s→M→d), T-Patterns dan I-Patterns (T1-T2, I1-I2, komposisi sekuensial dua model), Fusion-Patterns (F1-F3, T3-T6, gabungan data simbolik+non-simbolik jadi satu model), dan Y-Patterns (Y1-Y2, satu model bercabang jadi dua alur). Klasifikasi ini dipakai Ekaputra di slide pembuka kelas untuk merangkum “koleksi pola desain untuk sistem AI hybrid” secara visual (lihat gambar di bawah — kiri: legenda sym/data/ML(inductive)/KR(deductive); kanan: katalog Atomic/T/I/Fusion/Y-Patterns).
Ekstensi Pertama: Van Bekkum et al. (2021) — Modular Design Patterns
Paper kedua, “Modular design patterns for hybrid learning and reasoning systems: a taxonomy, patterns and use cases” (Michael van Bekkum, Maaike de Boer, Frank van Harmelen, André Meyer-Vitali, Annette ten Teije — Applied Intelligence 51(9), 2021) adalah perluasan langsung dari paper pertama (dua penulis, van Harmelen dan ten Teije, sama-sama jadi co-author di kedua paper). Kontribusi utamanya bukan mengganti notasi lama, tapi mempertajam taksonomi dan menambah dua elemen notasi baru: Process (bentuk oval, menggantikan pembedaan biner ML/KR dengan klasifikasi proses yang lebih halus) dan Actor (bentuk segitiga, entitas otonom seperti manusia/software agent/robot yang menginisiasi proses berdasarkan intensi dan tujuan — celah yang secara eksplisit disebut sebagai “future work” di paper pertama).
Taksonomi barunya membagi konsep jadi 4 kategori level-tertinggi:
- Instance — blok bangunan dasar. Terbagi jadi Data (numbers, texts, tensors, streams) dan Symbol (labels, relations, traces). Data didefinisikan sebagai token yang “hanya menjadi dirinya sendiri” (mis. kumpulan piksel gambar orang), sedangkan symbol harus memenuhi 3 syarat: (1) menunjuk objek/kelas/relasi di dunia nyata, (2) bisa atomik atau kompleks (tersusun dari simbol lain lewat aturan komposisi formal), (3) ada sistem operasi yang menghasilkan simbol baru dari simbol lama (mis. inferensi logika).
- Model — deskripsi entitas dan relasinya, berguna untuk menyimpulkan data/pengetahuan baru. Terbagi jadi Statistical Model (neural network, Bayesian network, Markov model — merepresentasikan dependensi antar-variabel statistik) dan Semantic Model/knowledge base (taxonomy, ontology, knowledge graph, rulebase, persamaan diferensial — merepresentasikan makna implisit simbol lewat konsep, atribut, relasi).
- Process — langkah dari input ke hasil, terbagi 3: Generation (pembuatan instance/model, lewat Training atau Engineering/rekayasa manual oleh expert), Transformation (mis. mengubah knowledge graph jadi vector space), dan Inference (lewat Induction, dari spesifik ke umum, atau Deduction, dari umum ke spesifik — pembedaan induksi/deduksi ini persis sama dengan pembedaan learning/reasoning). Klasifikasi dan prediksi keduanya dianggap proses deduktif, karena sama-sama memakai model generik (hasil induksi) untuk menyimpulkan info tentang instance spesifik.
- Actor — entitas otonom (manusia, software agent, robot) yang menginisiasi proses berdasarkan intensi/tujuan. Belum dipakai aktif di pola-pola paper ini, tapi diletakkan sebagai fondasi untuk kerja mendatang soal distributed AI dan human-agent interaction.
Dari taksonomi ini, paper menurunkan elementary pattern yang membentuk grammar bertipe untuk semua pola kompleks: generate:train (data/symbol → model), generate:engineer (actor → model), transform (symbol/data → data), dan tiga varian infer:deduce (kombinasi model+data/symbol → data/symbol/model, tergantung apakah modelnya statistical atau semantic). Dari sinilah paper memberi definisi presisi yang sebelumnya “dipakai secara nebulous” di literatur: Machine Learning system = kombinasi pola generate:train (data→model) dengan infer:deduce (data+model→data); Knowledge Representation system = pola infer:deduce murni simbolik (symbol+semantic model→symbol); Hybrid system = kombinasi lain apa pun dari pola-pola elementer ini.
Dari elementary pattern ini, paper menyusun 8 kategori pola kompositional (parafrase, bukan penomoran ulang literal seperti paper pertama, karena strukturnya sekarang diagram bernama, bukan nomor):
- Learning from data with symbolic output — ontology learning dari teks: teks diterjemahkan jadi relasi (subject,verb,object) via model statistik (mis. Stanford Parser), lalu semantic model (mis. rule Hearst pattern) menyimpulkan hierarki relasi jadi ontology penuh.
- Explainable learning systems through rational reconstruction — sistem ML dilatih dan menghasilkan prediksi, lalu reasoning system memakai background knowledge untuk menyusun “rekonstruksi rasional” alasan di balik pasangan input/output tersebut — dengan catatan penting: justifikasi yang dihasilkan tidak merefleksikan komputasi statistik internal ML, hanya justifikasi post-hoc. Ada varian instance-level explanation (penjelasan per hasil spesifik) vs model-level explanation (penjelasan struktur keseluruhan model).
- Learning an intermediate abstraction — dua varian: untuk learning (dua pola train+deduce dirangkai lewat representasi simbolik antara, dipakai di DeepProbLog untuk penjumlahan digit tulisan tangan — mengenali digit dulu baru menjumlahkan, lebih robust daripada end-to-end training langsung dari bitmap ke hasil) dan untuk reasoning (abstraksi yang diturunkan dipakai sebagai input tugas deduktif — contoh klasik: AlphaGo, di mana ML melatih fungsi evaluasi papan yang lalu ditelusuri Monte Carlo Tree Search/KR untuk memilih langkah simbolik berikutnya).
- Informed learning with prior knowledge — fase training ML dipandu informasi dari sistem inferensi simbolik (mis. domain knowledge dari knowledge graph dipakai membatasi ruang pencarian training, atau semantic loss function di mana bagian loss function dirumuskan berdasar derajat pelanggaran background knowledge simbolik). Paper ini mencatat pola ini mencakup lebih dari 100 sistem “informed machine learning” yang disurvei terpisah oleh Von Rueden et al. (2019).
- From symbols to data and back again — link prediction/graph completion pada knowledge graph: KG diterjemahkan ke vector space (embedding), lalu representasi ini dipakai memprediksi edge tambahan berdasarkan regularitas geometris.
- Learning logical representations for statistical inferencing — integrasi logika ke dalam model ML lewat tensorization (mis. Logic Tensor Networks, Graph Neural Networks) — model semantic ditransformasikan jadi representasi vector/tensor lalu dipakai melatih neural network.
- Learning to reason — bukan hanya belajar representasi logika, tapi benar-benar melatih neural network untuk meniru proses reasoning itu sendiri (mis. Relational Tensor Networks, reasoning atas RDF/Description Logic) — termotivasi oleh skalabilitas dan robustness neural network terhadap data noisy dibanding reasoner simbolik murni.
- Meta-reasoning for control — satu sistem menalar/belajar dari perilaku sistem lain, mis. AutoML (Alpine Meadow): knowledge base konfigurasi ML dipakai menyimpulkan hyper-parameter yang cocok, lalu performa model hasil training diinspeksi ulang oleh knowledge base yang sama untuk menyesuaikan hyper-parameter di iterasi berikutnya. Pola serupa juga menjelaskan curriculum-guided learning (urutan optimal materi belajar) dan arah sebaliknya: sistem sub-symbolic yang belajar strategi pencarian untuk memandu symbolic theorem prover.
Paper ini juga mendemonstrasikan pola-polanya lewat dua use case nyata: (1) skills matching — mencocokkan lowongan kerja dengan CV berdasarkan skill, memakai skill ontology yang direkayasa manusia (generate:engineer) di-embed jadi tensor, dikombinasikan dengan teks vacancy yang juga di-embed, untuk melatih model statistik yang memprediksi skill dari teks vacancy; dan (2) robot in action — robot dengan kamera melatih object detector dan tracker (dua neural network terpisah), dikombinasikan dengan ontology dunia yang direkayasa manusia, untuk menyimpulkan rule semantik tentang apa yang akan terjadi berikutnya dan memilih aksi terbaik.
Terakhir, paper ini secara eksplisit memposisikan dirinya relatif terhadap taksonomi Kautz (6 tipe neuro-symbolic system dari invited talk Kautz di AAAI 2020) dan taksonomi De Raedt et al. (2020, 8 dimensi survei “neural-symbolic”): boxology van Bekkum dkk. mengklaim memberi pembedaan lebih halus/granular — misalnya, satu tipe Kautz (“Neuro:Symbolic → Neuro”, Type 4) ternyata terurai jadi tiga pola boxology berbeda (elementary pattern symbolic, “symbols to data and back”, dan “learning to reason”) — sementara De Raedt dkk. justru membuat pembedaan lebih halus di dalam satu komponen boxology (mis. jenis-jenis logika yang semuanya tercakup dalam satu komponen KR boxology), tanpa membahas bagaimana komponen-komponen itu dirangkai jadi sistem yang lebih besar — sesuatu yang justru jadi fokus utama boxology.
Tool4Boxology: Dari Diagram ke Knowledge Graph yang Bisa Divalidasi
Paper ketiga, “Tool4Boxology: A Semantic Toolbox for Constructing and Analysing Neuro-Symbolic Architectures” (Johannes E. Bendler, Yashrajsinh Chudasama, Mahsa Forghani, Enrique Iglesias, Disha Purohit, Jacquiline Roney, Annette ten Teije, Frank van Harmelen, Maria-Esther Vidal — ESWC 2026, LNCS 16550), bukan menambah notasi baru, melainkan menjawab persoalan berbeda: bagaimana memastikan diagram boxology yang dibuat orang benar-benar valid secara sintaksis dan semantis, dan bagaimana mengubahnya jadi representasi yang bisa dianalisis secara otomatis (query, deteksi pola, perbandingan antar-sistem) — bukan cuma gambar statis di paper.
Tool4Boxology mengorganisasikan solusinya jadi 3 lapisan (istilah masing-masing lapisan penting karena dipakai berulang di paper ini dan BEAM):
flowchart LR
  A["Boxology Design Layer<br/>(editor grafis + validasi sintaksis)"] --> B["Knowledge Representation Layer<br/>(RML mapping → Knowledge Graph<br/>sesuai T4B Ontology)"]
  B --> C["Knowledge Graph Exploration Layer<br/>(SPARQL query, SHACL validation,<br/>deteksi pola)"]
- Boxology Design Layer: editor grafis (plugin draw.io atau versi standalone berbasis GoJS) tempat pengguna menyusun diagram boxology dengan validasi sintaksis real-time — mis. memastikan proses
trainmemang mengonsumsi data/symbol dan menghasilkan tepat satu model, atau prosesdeducememang butuh minimal satu model sebagai input. Aturan-aturan ini dituliskan sebagai grammar bertipe eksplisit (lihat kotak di bawah), sesuatu yang tidak ada di boxology versi paper 1 dan 2 (aturan komposisi hanya implisit lewat contoh diagram). - Knowledge Representation Layer: diagram yang sudah valid diekspor sebagai JSON, lalu ditransformasikan lewat RML (RDF Mapping Language) menjadi triple RDF yang sesuai T4B Ontology — ontology yang dibangun di atas EASY-AI Ontology (Ellis et al.), berisi kelas
t4b:Artefact(dengan sub-kelas Data, Symbol, Actor, Process, Model) dant4b:DesignPatternyang menangkap input/proses/output yang diizinkan tiap pola. - Knowledge Graph Exploration Layer: Knowledge Graph hasilnya divalidasi lebih lanjut lewat SHACL constraints (aturan semantik yang lebih ketat dari sekadar tipe, mis. proses
deduceharus mengonsumsi semantic model yang cocok seperti OWL ontology), lalu bisa di-query lewat SPARQL untuk analisis pola, perbandingan struktural antar-sistem, dan validasi korektnes.
Grammar aturan sintaksisnya (Appendix A paper ini), misalnya untuk generate:train:
{model[0..1], (data|symbol)[1..]} → generate:train → {model[1]}
— dibaca: nol atau satu model plus satu atau lebih data/symbol sebagai input, menghasilkan tepat satu model sebagai output.
Validitas nyata dari nilai tambah ini ditunjukkan lewat studi kasus: paper ini mengambil korpus 69 sistem neuro-symbolic clinical decision yang sebelumnya sudah dipetakan secara manual ke notasi boxology oleh Ng et al. (2025, AIME — dari 71 sistem yang disurvei Kierner et al. 2023 dalam 5 architectural archetype: rule embedded dalam ML, ML sebagai preprocessing sebelum rule-based inference, rule-based sebagai preprocessing sebelum ML, rule yang memandu training ML, dan ensemble paralel rule+ML). Ketika 69 diagram manual ini “dikonfrontasikan” dengan validator sintaksis dan semantik Tool4Boxology, hasilnya mengejutkan: hanya 12 dari 61 diagram yang tervalidasi sepenuhnya benar secara sintaksis, 49 diagram melanggar aturan tipe (kesalahan paling umum: koneksi yang salah antara artefact dan proses — dianggap wajar karena sebelumnya memang belum ada aturan validasi eksplisit), dan 8 sisanya melanggar batasan semantik yang butuh koreksi manual kembali ke paper aslinya. Temuan ini sekaligus jadi bukti kuat kenapa validasi formal seperti Tool4Boxology dibutuhkan — diagram boxology yang dibuat manusia, bahkan oleh peneliti berpengalaman, ternyata rawan salah secara konsisten tanpa alat bantu semacam ini.
Setelah divalidasi, 61 diagram ini diintegrasikan jadi satu Knowledge Graph dan bisa di-query (contoh: query SPARQL untuk menghitung frekuensi pemakaian tiap pola elementer di seluruh korpus). Tool4Boxology juga sudah diuji di domain lain di luar biomedis: energi, aplikasi militer, edukasi, dan sistem berbasis LLM. Tool ini tersedia daring di tool4boxology.service.tib.eu, open-source (Apache License 2.0), dengan dokumentasi lengkap dan video tutorial.
BEAM: Boxology Extended Annotation Model
Paper keempat sekaligus paper inti sesi kelas ini, “Towards Supporting AI System Engineering with an Extended Boxology Notation” (Fajar J. Ekaputra, Alexander Prock, Elmar Kiesling — 2nd KG-STAR Workshop @ ESWC 2025), memperkenalkan BEAM. Berbeda dari Tool4Boxology yang fokus pada validasi diagram yang sudah ada, BEAM mengisi celah berbeda: boxology (versi manapun sebelumnya) tidak punya elemen untuk menangkap informasi rekayasa (siapa/di konteks apa sistem ini dipakai) maupun risiko dan mitigasinya — dua hal yang krusial untuk trustworthy AI system engineering, tapi belum ada tempatnya di notasi lama. Motivasi lain yang disebut eksplisit: sejauh pengetahuan penulis, boxology sejauh ini baru dipakai untuk analisis post-hoc sistem AI yang sudah ada (mendeskripsikan sistem yang sudah jadi), bukan sebagai alat bantu selama proses desain dan pengembangan — celah kedua inilah yang coba diisi BEAM.
BEAM memperluas boxology dalam dua perspektif baru, di atas fondasi notasi boxology “legacy” (istilah yang dipakai BEAM sendiri untuk merujuk gabungan elemen dari van Harmelen/ten Teije + van Bekkum dkk.). Legenda lengkap notasi legacy versi BEAM (data, symbol, statistical model, semantic model, training, engineering, inference, transformation, actor, workflow connector) digambarkan di tabel berikut, diambil langsung dari slide kelas:
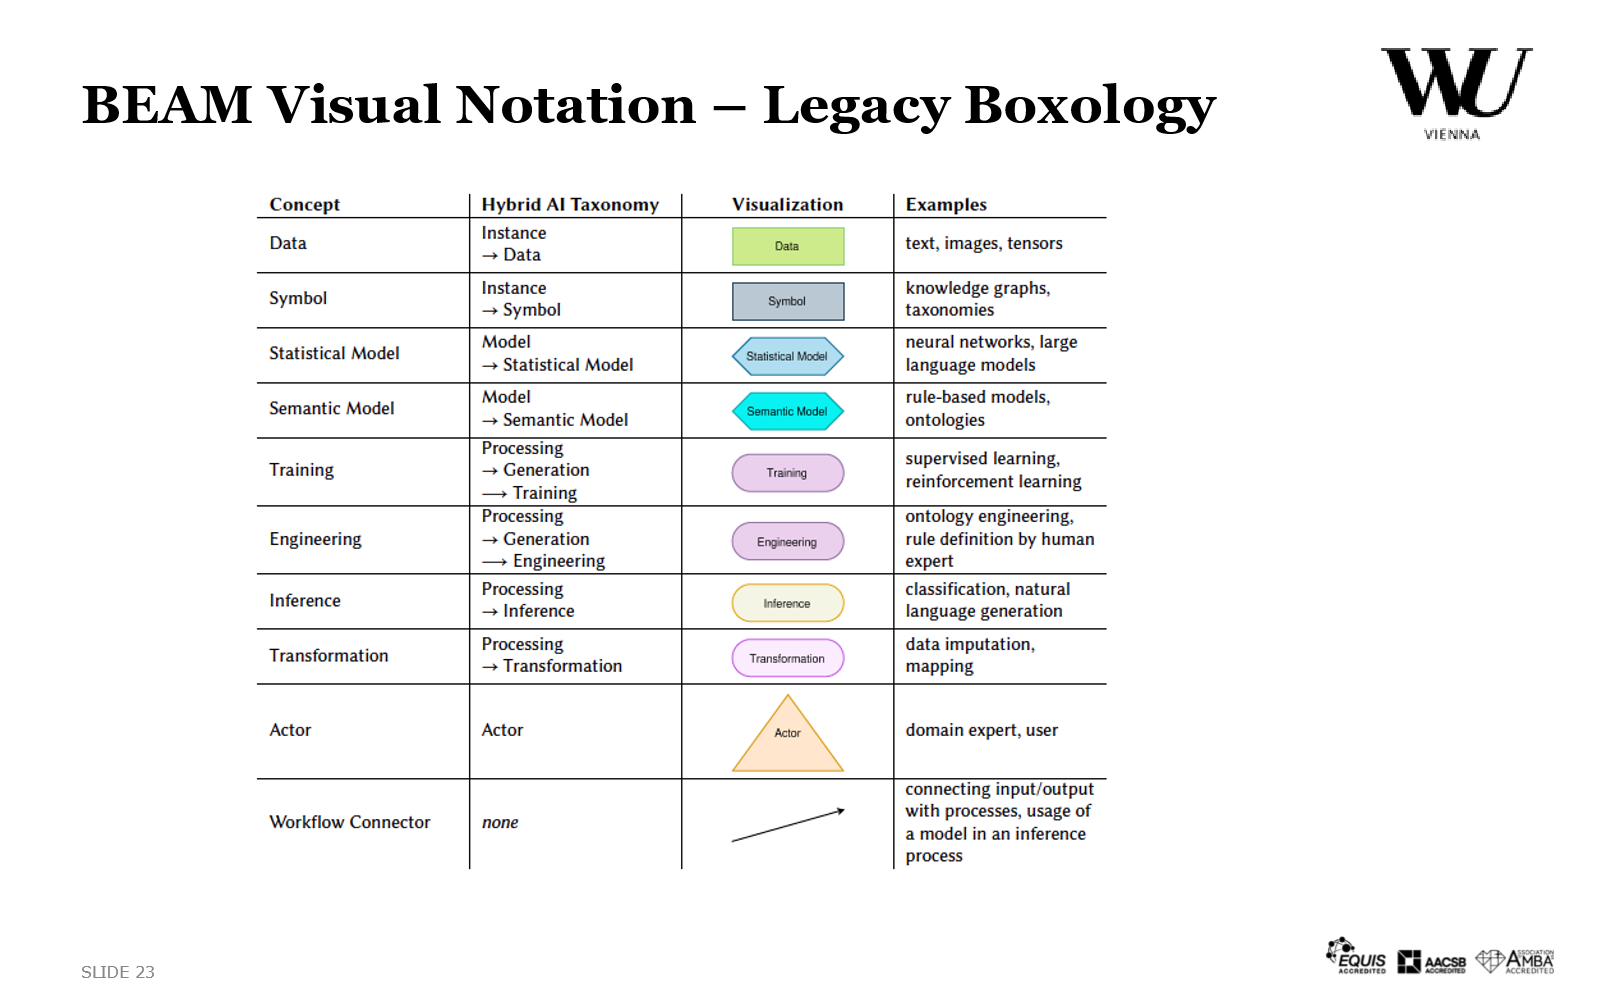
Beberapa detail penting dari legenda ini yang memperjelas taksonomi van Bekkum et al. sebelumnya:
- Data (kotak hijau) vs Symbol (kotak abu-abu): instance. Data = tanpa struktur makna eksplisit (teks, gambar, video, tensor). Symbol = punya skema bermakna yang bisa dipakai bernalar (database, knowledge graph, taxonomy). Hint praktis dari slide: kalau ragu suatu instance masuk kategori mana, masukkan saja sebagai Data dulu.
- Statistical Model (heksagon biru) vs Semantic Model (heksagon cyan): model. Statistical = inferensi berbasis pola yang dipelajari dari data (inductive) — mis. LLM, neural network, classical ML model. Semantic = inferensi lewat aturan yang sudah didefinisikan sebelumnya (deductive) — mis. ontology, logic programming.
- Actor (segitiga oranye): entitas otonom yang bertindak proaktif untuk menginisiasi proses berdasarkan intensi/tujuan tertentu — contoh: domain expert, user.
- Empat jenis Processing (oval/rounded-rectangle ungu-merah muda): Training (
data/symbol → statistical model, mis. supervised/reinforcement learning), Engineering (... → data/symbol/semantic model, generasi manual oleh actor, mis. ontology engineering atau definisi rule oleh human expert), Inference (data/symbol → data/symbol, proses penalaran berdasar input untuk menghasilkan output, mis. klasifikasi, generasi bahasa alami), Transformation (data/symbol → data/symbol, modifikasi instance lewat operasi/fungsi spesifik, mis. data imputation, mapping).
Perspektif Baru #1: System
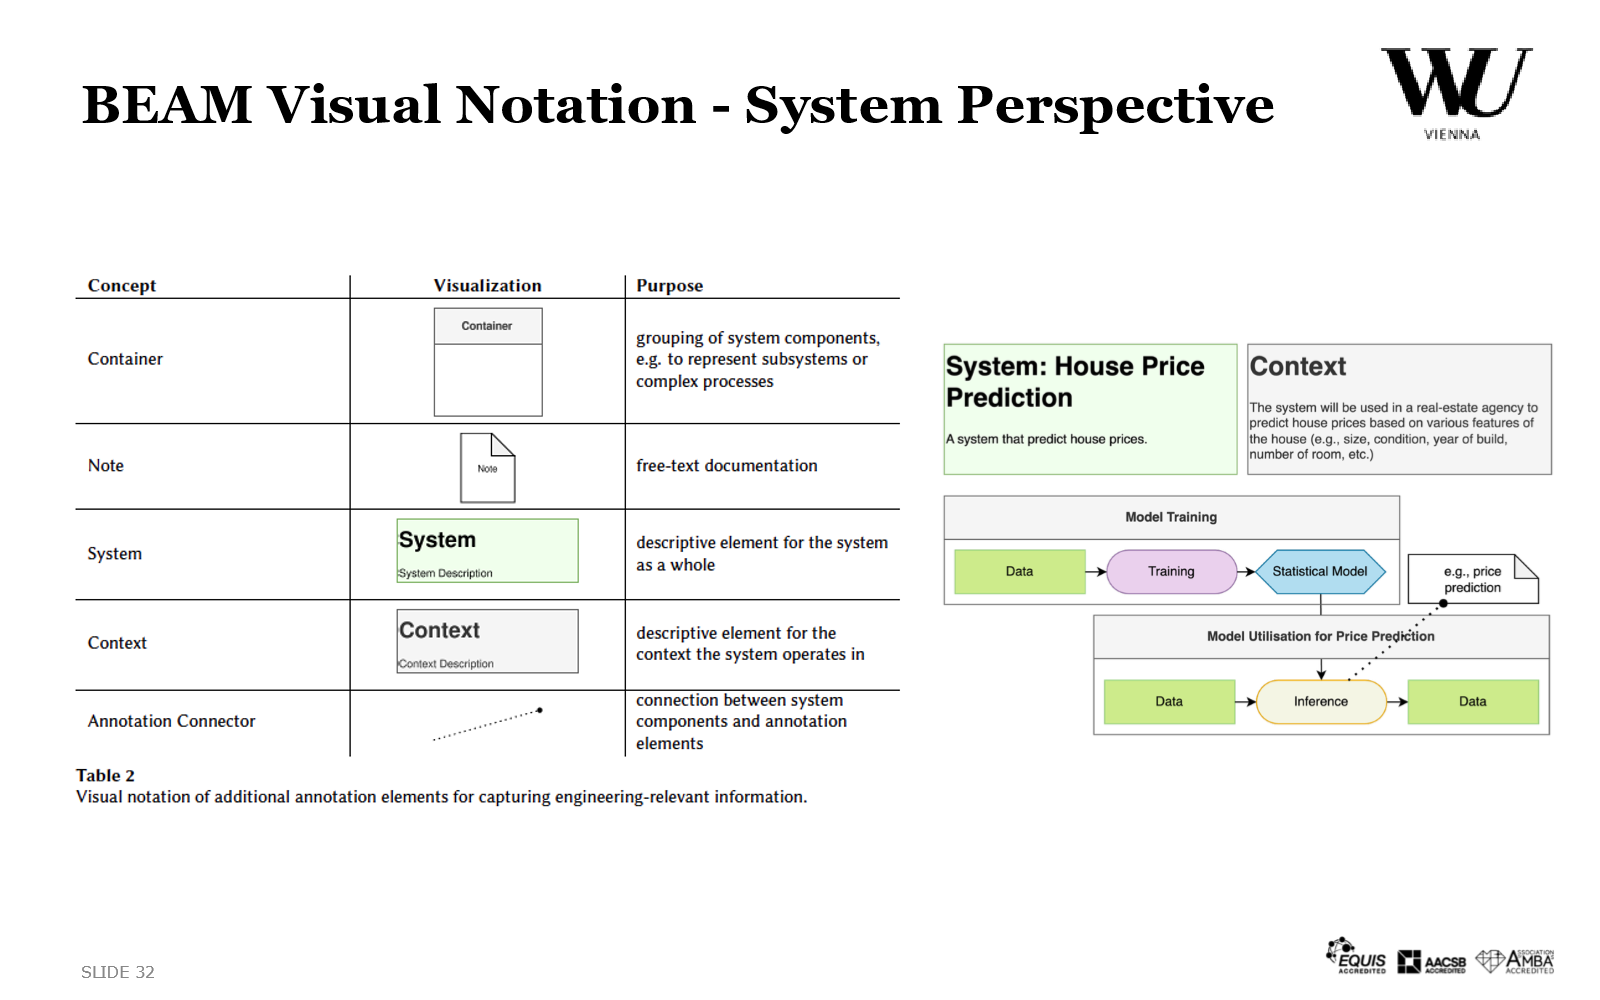
Perspektif System menambahkan elemen anotasi murni untuk mendokumentasikan konteks rekayasa — bukan bagian dari alur data sistem itu sendiri, tapi metadata di sekitarnya:
| Elemen | Tujuan |
|---|---|
| Container | mengelompokkan komponen sistem, mis. merepresentasikan subsistem atau proses kompleks |
| Note | dokumentasi bebas-teks (mirip UML) |
| System | elemen deskriptif untuk sistem secara keseluruhan |
| Context | elemen deskriptif untuk konteks tempat sistem beroperasi |
| Annotation Connector | koneksi titik-titik (beda dari panah alur kerja biasa) yang menghubungkan komponen sistem dengan elemen anotasi |
Contoh dari slide kelas: sistem “House Price Prediction” — kotak System berisi deskripsi singkat sistem, kotak Context menjelaskan sistem akan dipakai agen real-estate untuk memprediksi harga rumah berdasarkan fitur seperti ukuran, kondisi, tahun bangun, jumlah kamar — keduanya dihubungkan lewat annotation connector (garis titik-titik) ke Container yang membungkus alur boxology sebenarnya (Data → Training → Statistical Model untuk fase training, lalu Data → Inference → Data untuk fase pemakaian model memprediksi harga).
Perspektif Baru #2: Risk dan Mitigation
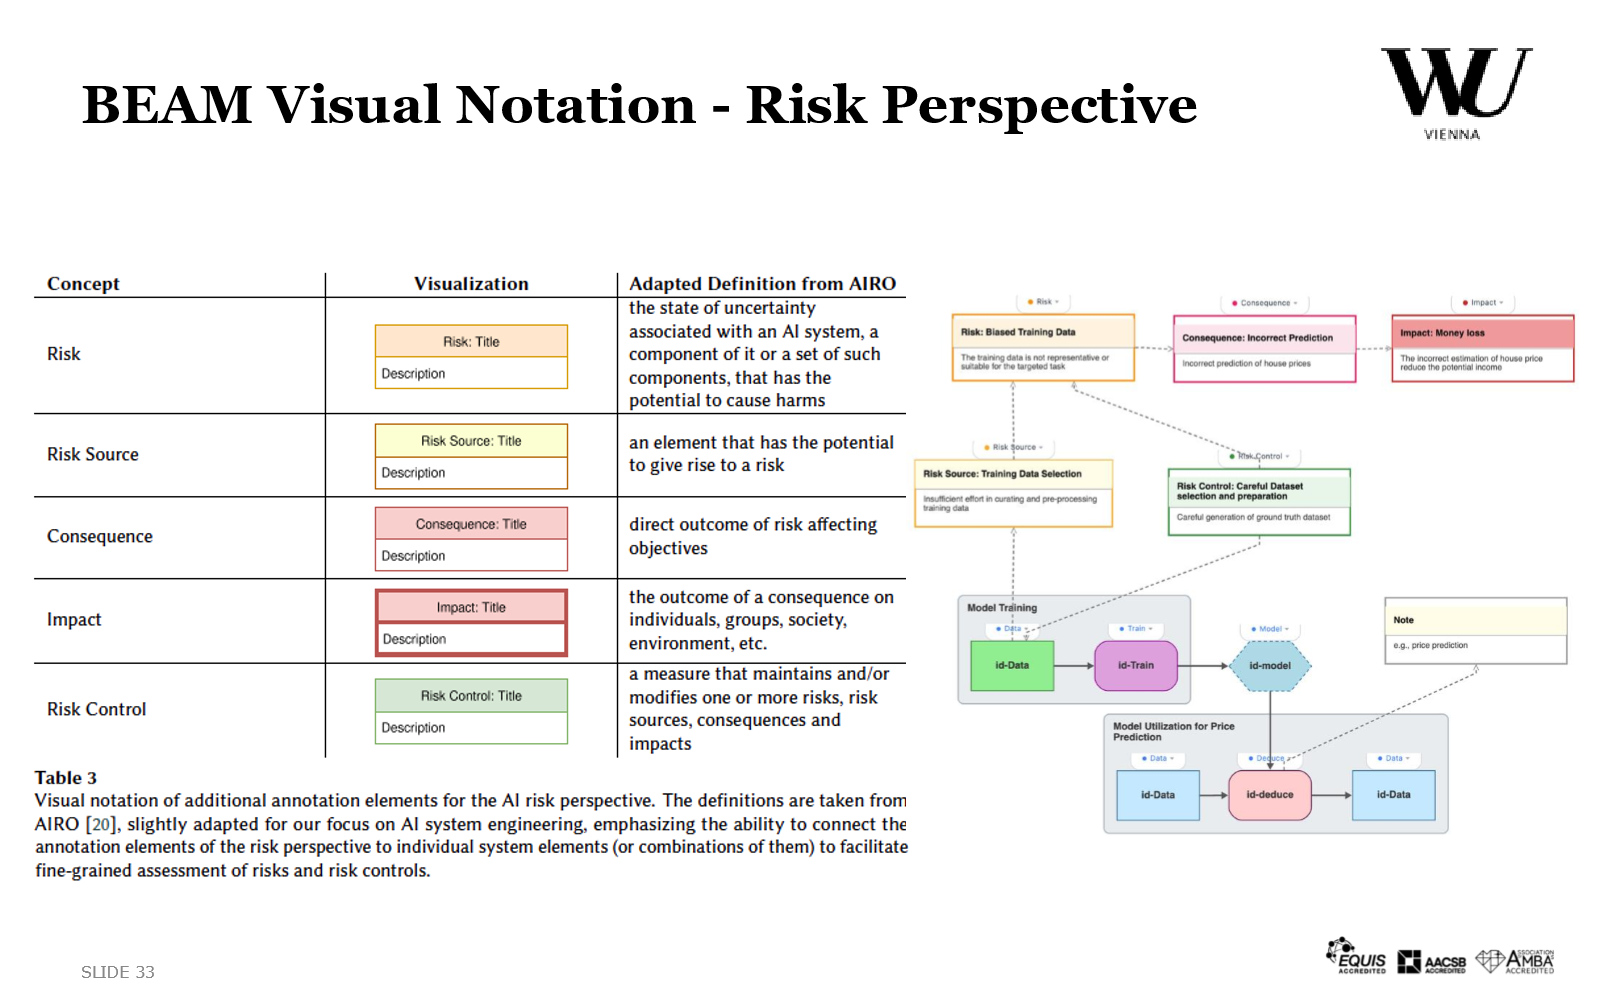
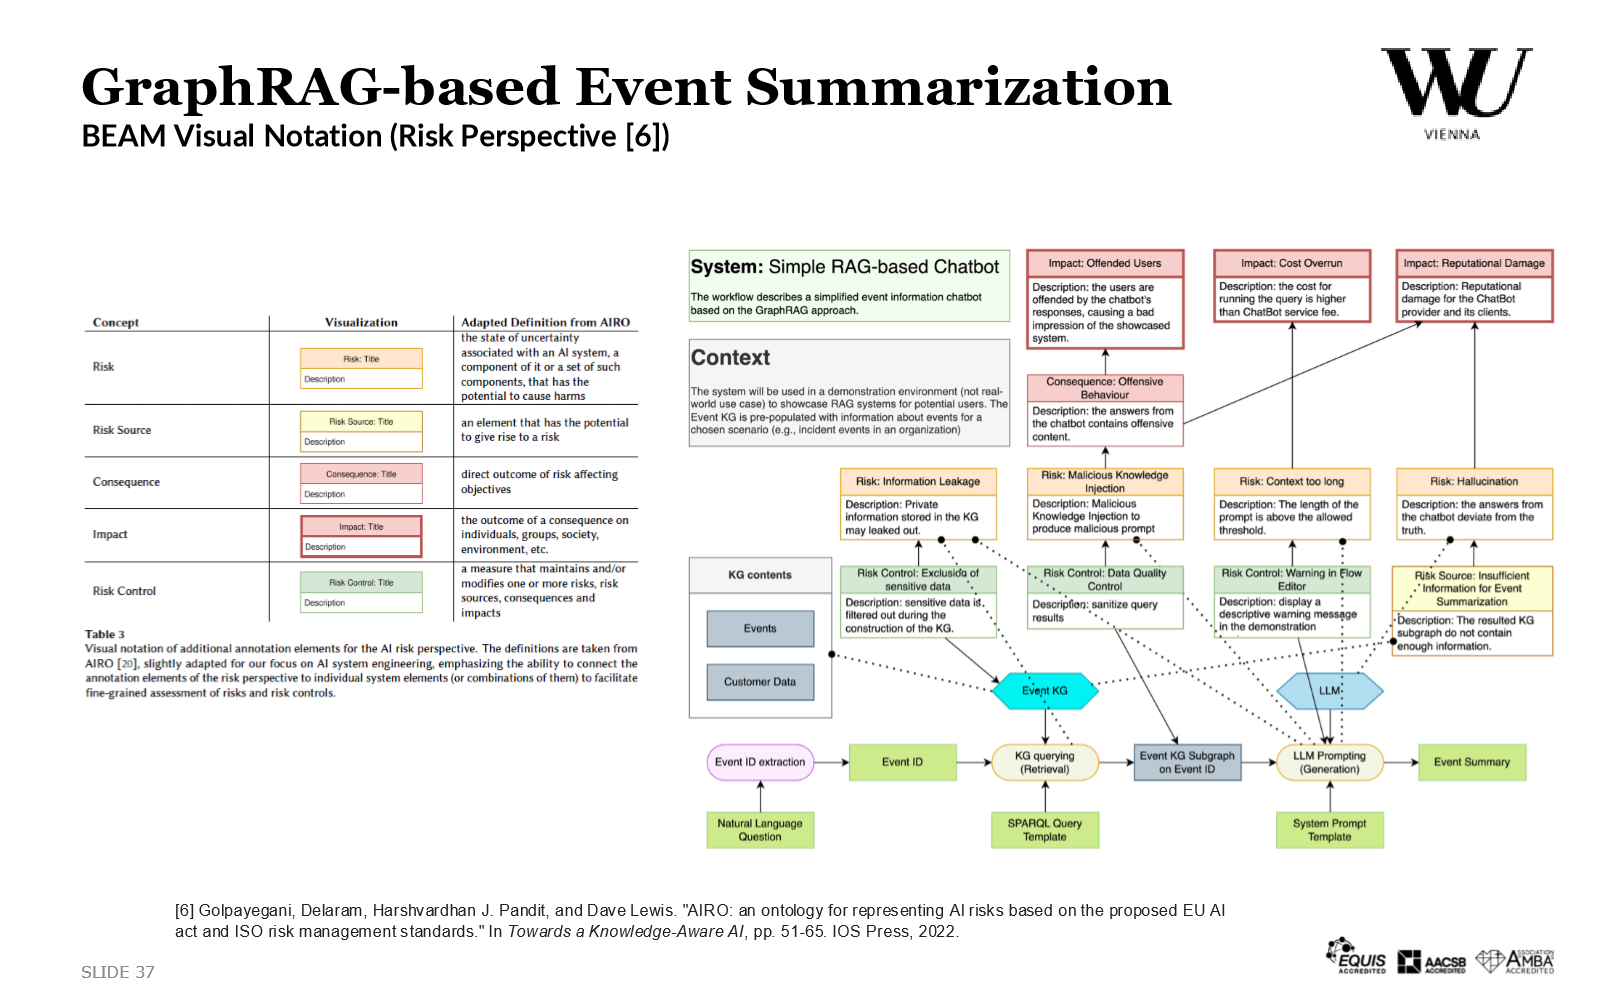
Perspektif Risk memasukkan konsep dari AIRO (AI Risk Ontology) milik Golpayegani, Pandit & Lewis (2022) — ontology yang dibangun berlandaskan standar manajemen risiko ISO dan didorong kebutuhan regulasi EU AI Act — ke dalam notasi boxology, dengan definisi yang sedikit diadaptasi untuk fokus rekayasa sistem AI:
| Elemen | Definisi (adaptasi dari AIRO) |
|---|---|
| Risk | keadaan ketidakpastian terkait suatu sistem AI (atau komponen/kombinasi komponennya) yang berpotensi menimbulkan bahaya |
| Risk Source | elemen yang berpotensi memunculkan suatu risiko |
| Consequence | akibat langsung dari risiko yang memengaruhi tujuan sistem |
| Impact | dampak dari suatu consequence terhadap individu, kelompok, masyarakat, lingkungan, dst. |
| Risk Control | ukuran yang menjaga dan/atau memodifikasi satu atau lebih risk, risk source, consequence, dan impact |
Kelima elemen ini divisualisasikan sebagai kotak dengan title bar berkonvensi Tipe: Judul (mis. “Risk Source: Poor Data Quality”), lalu deskripsi bebas-teks di bawahnya. Yang membuat pendekatan ini berbeda dari sekadar mengutip AIRO apa adanya: elemen risk perspective BEAM bisa ditempelkan langsung ke elemen sistem individual (satu atau kombinasi beberapa) lewat annotation connector yang sama — jadi risiko tidak cuma dideskripsikan di level sistem secara umum (seperti kebanyakan pendekatan risk management AI lain yang disurvei paper ini: ALTAI, MIT AI Risk Repository, NIST AI RMF, framework industri seperti IBM Risk Atlas/Google Model Cards/Microsoft Responsible AI Standard — semuanya bersifat normatif tapi tidak menautkan risiko ke komponen arsitektur secara granular), melainkan bisa dilokalisasi ke komponen/proses/actor tertentu di dalam arsitektur.
BEAM Ontology
Sejalan dengan notasi visualnya, BEAM juga punya representasi formal: BEAM Ontology, terdiri dari dua modul: BEAM core (dibangun di atas EASY-AI dan SWeMLS ontology, menambahkan kelas beam:Resource sebagai superclass beam:Instance+beam:Model, beam:Container, beam:Unit, beam:Note, serta relasi beam:usedBy, beam:participatedIn, beam:inform) dan BEAM risk (namespace beamr:, subclass dari kelas-kelas AIRO: beamr:Risk, beamr:RiskSource, beamr:Consequence, beamr:Impact, beamr:RiskControl, dengan dua relasi kunci baru — hasRisk yang menautkan risiko ke elemen sistem granular, dan originatesFrom yang menautkan risk source abstrak ke elemen konkret di arsitektur). Ontology ini tersedia daring di w3id.org/beam/.
Evaluasi BEAM
BEAM dievaluasi lewat dua jalur: (1) evaluasi kelayakan awal dengan mahasiswa Data Science di proyek capstone industri (~25 model dari kasus industri nyata selama dua semester, dengan skor rata-rata usefulness dan ease of use 3/7 pada skala Likert 7-poin di mana 1 = sangat setuju, dan skor 2/7 untuk manfaat diskusi lintas-stakeholder — makin rendah makin baik pada skala ini); dan (2) lokakarya mendalam dengan 7 mitra industri dalam proyek riset Austria FAIR-AI, di mana feedback kualitatif menunjukkan BEAM membantu (i) menjelaskan pendekatan teknis dan mengomunikasikan arsitektur solusi lintas-stakeholder, (ii) menautkan keputusan desain teknis ke risiko dan kepentingan bisnis, dan (iii) meningkatkan risk-awareness di sepanjang siklus hidup sistem.
Contoh use case nyata dari lokakarya ini — chatbot berbasis GraphRAG (Retrieval-Augmented Generation dengan Knowledge Graph) untuk merangkum event, dengan tiga komponen: Event Identification (ekstraksi entitas dari pertanyaan natural language), KG Querying/Retrieval (query SPARQL ke Event Knowledge Graph), dan Answer Generation (LLM menyusun jawaban dari subgraph hasil retrieval) — didokumentasikan lengkap dengan risk perspective-nya: risiko Information Leakage (informasi privat di KG bisa bocor, dimitigasi dengan Risk Control: Exclusion of Sensitive Data), Malicious Knowledge Injection (menghasilkan consequence Offensive Behaviour, dimitigasi lewat Data Quality Control), Context Too Long (consequence Cost Overrun, dimitigasi lewat Warning in Flow Editor), dan Hallucination (langsung berujung impact Reputational Damage tanpa risk control eksplisit di contoh ini — menunjukkan bagaimana representasi BEAM bisa dipakai men-query elemen sistem mana saja yang risikonya belum punya mitigasi, lewat query SPARQL semacam SELECT ?element ?risk WHERE {...FILTER NOT EXISTS {?mitigation beamr:modifiesRiskConcept ?risk}}).
Tool4Boxology(+): Menyatukan Boxology, BEAM, dan Tooling
Bagian praktik kelas ini memakai Tool4Boxology(+), versi Tool4Boxology yang sudah diintegrasikan dengan elemen anotasi BEAM (shape library tambahan “BEAM Annotation” dan “BEAM Risk” di sidebar editor), tersedia daring di t4b.komunitech.id. Fitur-fitur kunci yang ditekankan di slide kelas:
- Open/Save Diagram sebagai file XML
.boxology. - Export ke berbagai format: JSON, gambar (JPG/PNG/Graphviz DOT), dan Knowledge Graph dalam format Turtle (
.ttl) memakai vocabulary BEAM (beam:/beamr:) — jembatan langsung dari diagram visual ke representasi formal yang bisa di-query. - Loading Known Patterns: drag-and-drop pola siap-pakai dari daftar (mis. “Learning and Prediction Task from Data”, “Learn Ontology from Data” — pola-pola Bekkum) langsung ke canvas.
- Specific Element Types: tipe konkret untuk tiap kategori abstrak — mis. Data bisa dipersempit jadi Number/Audio/Video, Model:Statistical bisa dipersempit jadi CNN/GNN/LLM, Model:Semantic bisa dipersempit jadi OWL Model/RuleBasedModel.
- BEAM View: toggle skema warna khusus BEAM (berbeda tipis dari skema warna Tool4Boxology asli).
Latihan kelas: mereplikasi dua contoh (house price prediction, GraphRAG event summarization) di tool ini, melengkapi dengan anotasi System/Context, lalu mengekspor sebagai .boxology untuk dikumpulkan — praktik langsung yang menunjukkan bagaimana keempat paper boxology/BEAM di atas menyatu jadi satu alur kerja end-to-end: rancang diagram (Design Layer) → validasi + anotasi rekayasa & risiko (BEAM) → ekspor jadi Knowledge Graph (Representation Layer) → query/analisis (Exploration Layer).
Penerapan Pribadi: Fake Job Vacancy Detection (Tugas Besar NLP)
Latihan kelas (house price prediction, GraphRAG) di atas dipakai lagi untuk tugas besar NLP kelompok saya sendiri: Fake Job Vacancy Detection, sistem deteksi lowongan kerja palsu di dataset EMSCAD penuh (shivamb, “Real or Fake: Fake JobPosting Prediction”, ~17.880 baris, ~4,84% fraud — sebelumnya tim sempat pakai split 8.940-baris dengan kolom yang dipangkas, lalu pindah ke versi penuh ini untuk laporan). Dokumentasi alur sistemnya ada terpisah di _Materi/NLP/nlp-tugas-besar/cara-kerja-fake-job-detection.md; bagian ini fokus ke bagaimana dua fragmen .boxology yang sudah saya buat (branch boxology di github.com/FaqihMSY/Fake-Job-Vacancy-Detection) memetakan langsung ke notasi yang dijelaskan di atas.
Sistemnya punya tiga tugas NLP yang berantai lewat satu artifact bersama, bukan tiga sistem paralel independen:
Lowongan kerja (teks + metadata)
        │
        ▼
   [1] NER  ──────────────► Extracted Entities (Skills, Contact, Edu)
                                   │                    │
                                   ▼                    ▼
                    [2] Text Classification    [3] Red-Flag Extraction
                                   │                    │
                                   ▼                    ▼
                        Label: fraud/legit     Frasa red-flag + kategori
Node Extracted Entities dari NER dipakai ulang oleh dua task berikutnya tanpa digandakan — persis konsep shared artifact yang didukung tool-nya sendiri (field isShared/sharedGroups di JSON tiap node Data/Symbol).
Fragmen 1: NER Pipeline
flowchart LR
  subgraph Training
    D1["Data: Annotated EMSCAD Dataset"] --> T1["Train: Fine-tuning BERT"] --> M1["Model (Statistical): Fine-tuned BERT NER"]
  end
  subgraph Inference
    D2["Data: Job Description Text"] --> P1["Deduce: Entity Extraction NER"]
    M1 --> P1
    P1 --> S1["Symbol: Extracted Entities"]
  end
Ini instans konkret dari komposisi generate:train + infer:deduce yang didefinisikan van Bekkum et al. sebagai Machine Learning system (lihat bagian Ekstensi Pertama di atas) — bedanya, outputnya Symbol bukan Data, jadi secara struktur sama dengan pola #5 van Harmelen & ten Teije (“Learning from data with symbolic output”, data→ML→sym). Alasan kenapa outputnya harus Symbol: hasil NER bukan teks bebas lagi, sudah punya skema (jenis entitas + nilai) yang bisa dinalar lebih lanjut oleh dua task berikutnya.
Perspektif Risk-nya:
| Elemen | Judul | Ringkasan |
|---|---|---|
| Risk Source | Adversarial Text Formatting | Scammer sengaja mengacak format teks kontak/gaji (spasi tidak wajar, salah eja) untuk lolos deteksi |
| Risk | Entity Extraction Failure | Fine-tuned BERT gagal mendeteksi entitas “red-flag” karena format non-standar atau kata out-of-vocabulary |
| Consequence | Incomplete Feature Set | Model klasifikasi hilir kehilangan fitur prediktif krusial |
| Impact | Undetected Fake Vacancies | Lowongan palsu lolos dan tayang, calon korban tetap terpapar |
| Risk Control | Regex / Rule-based Fallback | Regex digabung dengan output NER BERT untuk menangkap pola terobfuskasi (nomor telepon, email, URL) secara andal |
Risk di sini ditautkan lewat annotation connector langsung ke node Deduce: Entity Extraction, bukan ke sistem secara umum — contoh nyata dari klaim BEAM soal risiko yang bisa dilokalisasi ke komponen granular.
Fragmen 2: Text Classification
Fragmen ketiga (dibuat belakangan lewat skill generator .boxology sendiri, disimpan di _Materi/NLP/beam/boxology-ai-skill-restored.md) mengisi tahap yang sebelumnya cuma jadi catatan draft “NOTE SEMENTARA” di fragmen Red-Flag — task inti yang memutuskan label akhir. File ini sekarang sudah menyertakan fragmen NER di dalamnya (bukan lagi mengasumsikan Extracted Entities sebagai input eksternal) — grup NER diberi label 0a/0b supaya urutan tahapnya kebaca jelas sebelum grup Text Classification sendiri (1a-2a):
flowchart LR
  subgraph "0a NER Training"
    D0["Data: Annotated EMSCAD Dataset"] --> T0["Train: Fine-tuning BERT"] --> M0["Model: Fine-tuned BERT (NER)"]
  end
  subgraph "0b NER Inference"
    D1["Data: Job Description Text"] --> P0["Deduce: Entity Extraction"]
    M0 --> P0
    P0 --> S0["Symbol: Extracted Entities"]
  end
  subgraph "1a Feature Combination"
    D4["Data: Job Text + Metadata"] --> P5["Transform: Combine Features"]
    S0 --> P5
    P5 --> D5["Data: Combined Feature Representation"]
  end
  subgraph "1b Baseline Training"
    D5 --> T2["Train: TF-IDF + LogReg/SVM"] --> M4["Model: Baseline Classifier"]
  end
  subgraph "1c Fine-tuned Training"
    D5 --> T3["Train: Fine-tuning BERT/DistilBERT"] --> M5["Model: Fine-tuned Classifier"]
  end
  subgraph "1d Model Selection"
    M4 --> P7["Deduce: Model Selection"]
    M5 --> P7
    P7 --> M6["Model: Selected Fraud Classifier"]
  end
  subgraph "2a Classification"
    M6 --> P6["Deduce: Fraud Classification"]
    D5 --> P6
    P6 --> S6["Symbol: Predicted Fraudulent Postings"]
  end
Extracted Entities sekarang jadi isShared:true (dipakai grup 0b NER Inference sekaligus 1a Feature Combination, tanpa group tunggal) — instans nyata dari aturan shared artifact di skill generator, bukan cuma diasumsikan sama by convention seperti sebelumnya. Menggabungkan ulang file ini juga jadi kesempatan membetulkan dua hal:
- Output
Deduce: Fraud Classificationsebelumnya digambar sebagaiData, padahal itu label kelas (fraud/legit) — menurut kosakata skill (“labels, traces, rules, classes… ” masukSymbol), harusnyaSymboldengantype: Label, jadi ikut dibetulkan. Baseline Classifierawalnya jadi dead-end — dilatih di grup1btapi tidak pernah dipakai node manapun setelahnya, padahal dokumen alur sistem eksplisit bilang “dua model dilatih dan dibandingkan”. Cluster1d Model Selectionditambahkan untuk menutup celah ini:Deducedengan duaModelsebagai input ({Model, Model} -> Deduce -> Model, pola “two cooperating models” yang eksplisit ada di elementary pattern library skill generator) memilih model mana yang dipakai, baru hasilnya (Selected Fraud Classifier) yang diteruskan ke2a Classification. Baseline sekarang benar-benar berperan di diagram, bukan cuma node yang menggantung.
Tiga hal yang menarik secara struktural di fragmen ini:
- Kenapa perlu
Transformdi depan, bukan langsung keTrain? KarenaData(teks+metadata) danSymbol(entitas NER) adalah dua jenis artifact berbeda — grammar boxology tidak mengizinkan satu proses menerima kombinasi tipe campuran begitu saja tanpa disatukan lebih dulu. Persis pola Transform{Symbol, Data} -> Datadi elementary pattern library. - Dua
Trainparalel (baseline vs fine-tuned) yang sama-sama mengonsumsiCombined Feature Representationtapi menghasilkanModelterpisah — ini cara boxology merepresentasikan perbandingan model (bukan cuma satu jalur linear), tanpa perlu notasi khusus tambahan. Extracted Entitiesdipakai sebagaiisShared:truetanpagroup— secara eksplisit menandai bahwa node ini bukan dihasilkan ulang di fragmen ini, melainkan artifact yang sama dari fragmen NER, sesuai aturan shared artifact di skill generator (“Do not duplicate the same artifact in multiple groups”).
Perspektif Risk-nya diambil langsung dari alasan penanganan imbalance di dokumen alur sistem (cara-kerja-fake-job-detection.md bagian 4):
| Elemen | Judul | Ringkasan |
|---|---|---|
| Risk Source | Extreme Class Imbalance | Dataset EMSCAD penuh (shivamb, ~17.880 baris) cuma sekitar 4,84% berlabel fraud |
| Risk | Majority-Class Bias | Tanpa class weighting/SMOTE, model bisa “malas” dan selalu menebak legitimate — accuracy tinggi tapi gunanya nol |
| Consequence | Missed Fraud Detection | Sebagian besar lowongan fraud lolos tanpa diberi label fraud |
| Impact | Undetected Fake Vacancies | Pencari kerja tetap terpapar lowongan palsu di tahap paling krusial pipeline |
| Risk Control | Class Weighting/SMOTE + PR-AUC Eval | Evaluasi sengaja pakai precision/recall/F1 kelas fraud + PR-AUC, bukan accuracy, supaya bias tidak tersembunyi di metrik |
Output Predicted Fraudulent Postings dari fragmen ini persis node yang jadi input pertama di fragmen Red-Flag di bawah (di file itu masih tergambar sebagai Data, belum ikut dibetulkan ke Symbol — lihat catatan penggabungan di akhir bagian ini) — dengan fragmen ini ada, ketiga tahap (NER → Text Classification → Red-Flag) sekarang tersambung penuh lewat tiga shared artifact (Extracted Entities, Fine-tuned Classifier/“Fraud Classifier”, dan Predicted Fraudulent Postings), menutup placeholder yang sebelumnya cuma ditandai lewat “NOTE SEMENTARA”.
Fragmen 3: Red-Flag Phrase Extraction & Categorization
Fragmen ini punya tiga sub-alur yang saling menyambung, dan tiap sub-alur cocok dengan pola berbeda dari katalog di atas:
flowchart LR
  subgraph "Attribution Extraction"
    D3["Data: Predicted Fraudulent Postings\n(dari Text Classification)"] --> P2["Deduce: SHAP/LIME Attribution"]
    M2["Model: Fraud Classifier\n(dari Text Classification)"] --> P2
    P2 --> S2["Symbol: High-Attribution Phrases"]
  end
  subgraph "Few-Shot Exemplar Labeling"
    S2 --> P3["Engineer: Manual Exemplar Labeling"]
    A1["Actor: Domain Expert/Analyst"] --> P3
    P3 --> S3["Symbol: Category Exemplars"]
  end
  subgraph "Automated Category Matching"
    S2 --> P4["Deduce: Nearest-Neighbor Matching"]
    S3 --> P4
    M3["Model: Pretrained Sentence Embedder"] --> P4
    P4 --> S4["Symbol: Red-Flag Category Labels"]
    P4 -.review loop.-> A1
  end
- Attribution Extraction (
Dataprediksi +Modelclassifier →Deduce→Symbolfrasa): ini persis pola #8 van Harmelen & ten Teije, “Explainable learning systems through inspection”, yang sudah dibahas di atas — SHAP/LIME menginspeksi state/perilaku classifier lewat representasi simbolik, tanpa mengubah cara kerja classifier itu sendiri. - Few-Shot Exemplar Labeling (
Actor+Engineer→Symbol): instans langsung dari elementary patterngenerate:engineervan Bekkum et al. — actor (domain expert/analyst) menghasilkan symbol lewat kerja manual, bukan training. - Automated Category Matching (dua
Symbol+ satuModel→Deduce→Symbol): tidak persis satu pola tunggal dari katalog manapun, tapi hybrid manual-labeling-diperluas-otomatis. NodeDeducedi sini juga terhubung balik keActor(panahmatch → actor) — jalur review, bukan alur data utama.
Diagram ini juga punya elemen Note (kategori beamCard, sama seperti System/Context) berisi teks “NOTE SEMENTARA: yg nyambung dari bagian text classification yang model fraud classifier sama data prediksi” — pemakaian nyata elemen Note System perspective untuk penanda kerja tim yang belum final, sebelum tiga fragmen (NER, Text Classification, Red-Flag) disatukan penuh oleh anggota kelompok masing-masing.
Perspektif Risk-nya:
| Elemen | Judul | Ringkasan |
|---|---|---|
| Risk Source | Novel Scam Phrasing | Scammer memakai frasa baru/tidak langsung yang tidak ada di few-shot exemplar set yang kecil |
| Risk | Category Misassignment | Frasa attribusi-tinggi tidak cocok jelas ke kategori manapun, atau nearest-neighbor salah kategori |
| Consequence | Incomplete Explanation | Output interpretability yang ditunjukkan ke user/analis kehilangan atau salah mewakili alasan sebenarnya |
| Impact | Reduced Trust in System | Analis/pencari kerja kehilangan kepercayaan ke penjelasan sistem |
| Risk Control | Iterative Lexicon Review | Analis meninjau berkala frasa berconfidence rendah/tidak cocok, memperluas few-shot exemplar set |
Risk Control di sini beranotasi ganda: ke Risk (memitigasi) sekaligus langsung ke Symbol: Category Exemplars (menunjukkan bagaimana mitigasinya konkret dilakukan — memperbesar exemplar set, bukan cuma pernyataan abstrak).
Menyatukan Ketiga Fragmen
Ketiga file di atas awalnya berdiri sendiri (satu file per anggota tim). Diagram Unified Pipeline.boxology (juga di folder boxology/ repo yang sama) menggabungkan ketiganya jadi satu canvas, dengan tiga artifact yang tadinya cuma “nyambung by convention” (nama/label sama tapi node berbeda) sekarang jadi node isShared:true yang literal sama:
Extracted Entities (Skills, Contact, Edu)— shared antaraInference(NER) dan1a Feature Combination(Text Classification).Fine-tuned Classifier (BERT/DistilBERT)— shared antara1c Fine-tuned Training(Text Classification) danAttribution Extraction(Red-Flag, di sana disebut “Fraud Classifier”).Predicted Fraudulent Postings— shared antara2a Classification(Text Classification) danAttribution Extraction(Red-Flag).
Node Note: "NOTE SEMENTARA" yang jadi penanda di fragmen Red-Flag sudah dihapus di versi gabungan ini — perannya sebagai placeholder sudah selesai begitu sambungannya jadi nyata lewat shared node di atas.
Evolusi Notasi: Siapa Menambahkan Apa
Karena melacak kontribusi paper-per-paper adalah inti catatan ini, berikut ringkasannya secara eksplisit:
| Paper | Tahun | Menambahkan apa | Alasan/celah yang diisi |
|---|---|---|---|
| van Harmelen & ten Teije — “A Boxology of Design Patterns…“ | 2019 | Notasi dasar: oval (ML/KR) dan kotak (data/sym); katalog 15 pola desain kompositional | Meletakkan fondasi: representasi abstrak yang menangkap bagaimana komponen dirangkai, bukan detail matematis di dalamnya |
| van Bekkum et al. — “Modular design patterns…“ | 2021 | Taksonomi lebih halus (Instance/Model/Process/Actor); elemen Process dan Actor baru; definisi presisi ML/KR/Hybrid system; 8 kategori pola kompositional; 2 use case nyata | Mengisi celah “future work” paper 2019: aktor manusia belum ada, notasi belum cukup granular untuk dipakai sebagai engineering tool, bukan cuma alat kategorisasi |
| Bendler et al. — “Tool4Boxology” | 2026 | Grammar formal (aturan tipe eksplisit); T4B Ontology; pipeline RML→Knowledge Graph; validasi SHACL; kemampuan query SPARQL | Diagram manual rawan salah tanpa validasi (terbukti: 49/69 diagram manual gagal validasi sintaksis) — mengangkat boxology dari “gambar di paper” jadi artefak machine-readable yang bisa diverifikasi & dianalisis skala besar |
| Ekaputra, Prock & Kiesling — “Towards Supporting AI System Engineering… (BEAM)“ | 2025 | Perspektif System (Container, Note, System, Context); perspektif Risk & Mitigation (5 elemen berbasis AIRO); BEAM Ontology (beam:/beamr:) | Boxology lama hanya dipakai untuk analisis post-hoc sistem yang sudah jadi, tidak menangkap info rekayasa (konteks, deskripsi sistem) maupun risiko/mitigasi yang krusial untuk trustworthy AI system engineering sejak fase desain |
| Tool4Boxology(+) (integrasi BEAM ke Tool4Boxology, dipakai di kelas ini) | 2026 | Menyatukan shape library BEAM Annotation + BEAM Risk ke editor Tool4Boxology; export .ttl dengan vocabulary BEAM | Menyediakan satu tool praktis end-to-end: desain → validasi → anotasi BEAM → Knowledge Graph, tanpa harus berpindah tool |
Catatan Terkait: SoCK — Pola Arsitektur yang Sama, Domain Berbeda
Paper keenam yang masuk folder materi (“Synthesising Causal Knowledge with Semantic Technologies” oleh Katrin Ehrenmüller, Lucas Kook, Fajar J. Ekaputra, Marta Sabou — dipublikasikan di “Bridging the Gap Between Curated and Induced Semantics”, IOS Press, doi:10.3233/SSW260004, nama file materinya SSW-63-SSW260004.pdf) bukan paper tentang boxology — tidak menyinggung notasi boxology sama sekali. Tapi paper ini ditulis oleh kelompok riset yang sama (Ekaputra jadi co-author di sini juga), dan yang membuatnya relevan untuk sesi ini adalah kemiripan pola arsitektur solusinya: paper ini memecahkan masalah lain — menyintesis pengetahuan kausal (causal graph) dari berbagai sumber yang saling bertentangan (kurasi ahli domain, algoritma causal discovery statistik seperti PC/FCI/NOTEARS/R2SORT, dan causal discovery berbasis LLM) — dengan arsitektur tiga-lapis yang sama persis filosofinya dengan Tool4Boxology: (1) SoCK Ontology — vocabulary formal untuk causal graph, tipe-tipenya (DAG, CPDAG, PAG, ADMG — tergantung asumsi algoritma yang dipakai: causal sufficiency, faithfulness, linearitas), metadata provenance, dan metode discovery-nya; (2) Causal Knowledge Graph (CKG) — integrasi multi-sumber jadi satu “source of truth” yang bisa dihitung metrik perbandingannya (mis. Hamming distance antar-graph); (3) Exploration Interface — antarmuka berbasis competency question yang menerjemahkan kebutuhan tiga tipe stakeholder (Knowledge Engineer, Causal Discovery Researcher, Domain Expert) jadi query SPARQL, tanpa mereka perlu menulis SPARQL sendiri.
Paralelnya eksplisit: sama seperti Tool4Boxology memvalidasi dan menyintesis diagram arsitektur AI yang berantakan/tidak konsisten jadi Knowledge Graph yang bisa di-query, SoCK memvalidasi dan menyintesis causal graph dari berbagai algoritma/sumber yang saling bertentangan (mis. FCI menghasilkan PAG dengan edge ambigu ◦→, sedangkan NOTEARS menghasilkan DAG tanpa ambiguitas) jadi satu basis pengetahuan yang bisa dibandingkan secara sistematis (mis. lewat visualisasi warna: hijau = complete match, kuning = partial match/beda relasi, merah = no match/unik ke satu graph). Evaluasi paper ini terhadap benchmark CausalAssembly (98 sensor lini produksi manufaktur) menunjukkan ontology-nya berhasil menjawab 14 dari 15 competency question yang dirumuskan — satu-satunya yang gagal (mencari semua jalur kausal antar-dua variabel) adalah keterbatasan bahasa query SPARQL standar (tidak ada operator path-finding bawaan), bukan keterbatasan ontology-nya. Bagi konteks kelas ini, SoCK menunjukkan bahwa pola “notasi/ontology terstruktur → Knowledge Graph → antarmuka eksplorasi ramah-stakeholder” yang dipelopori Tool4Boxology bukan cuma cocok untuk arsitektur neuro-symbolic, tapi bisa digeneralisasi ke persoalan sintesis pengetahuan heterogen lain di AI engineering.
Sumber
- Fajar J. Ekaputra, “An Introduction to Boxology Extended Annotation Model (BEAM)”, slide kuliah tamu IF5153 Advanced NLP, ITB, September 2026 (Semantic Systems Group, WU Vienna).
- Frank van Harmelen & Annette ten Teije, “A Boxology of Design Patterns for Hybrid Learning and Reasoning Systems”, Journal of Web Engineering 18(1-3), 97–124, 2019.
- Michael van Bekkum, Maaike de Boer, Frank van Harmelen, André Meyer-Vitali, Annette ten Teije, “Modular design patterns for hybrid learning and reasoning systems: a taxonomy, patterns and use cases”, Applied Intelligence 51(9), 6528–6546, 2021.
- Johannes E. Bendler, Yashrajsinh Chudasama, Mahsa Forghani, Enrique Iglesias, Disha Purohit, Jacquiline Roney, Annette ten Teije, Frank van Harmelen, Maria-Esther Vidal, “Tool4Boxology: A Semantic Toolbox for Constructing and Analysing Neuro-Symbolic Architectures”, ESWC 2026, LNCS 16550, 191–211.
- Fajar J. Ekaputra, Alexander Prock, Elmar Kiesling, “Towards Supporting AI System Engineering with an Extended Boxology Notation”, 2nd International Workshop on Knowledge Graphs for Responsible AI (KG-STAR) co-located with ESWC 2025.
- Katrin Ehrenmüller, Lucas Kook, Fajar J. Ekaputra, Marta Sabou, “Synthesising Causal Knowledge with Semantic Technologies”, in Bridging the Gap Between Curated and Induced Semantics, IOS Press, 2026, doi:10.3233/SSW260004.
Flashcard
flashcards
Dalam notasi boxology asli (van Harmelen & ten Teije), apa yang direpresentasikan oleh bentuk oval dan bentuk kotak? :: Oval = komponen algoritmik (ML untuk inferensi induktif/statistik, KR untuk inferensi deduktif/simbolik). Kotak = struktur data input/output (data = model-free, sym = model-based/simbolik).
Sebutkan 3 keterbatasan utama sistem deep learning dan 3 keterbatasan utama sistem symbolic reasoning menurut van Harmelen & ten Teije (2019) :: Deep learning: data hungry, limited transfer, brittle terhadap adversarial attack, opaque, tidak memakai prior knowledge. Symbolic: brittle terhadap noise, mahal (perlu knowledge-base dari expert), rawan combinatorial explosion.
Apa perbedaan antara pola boxology “Learning an intermediate abstraction for learning” dan “…for reasoning”? :: For learning: representasi simbolik antara dipakai sebagai input untuk proses ML lagi (data→ML→sym→ML→data), contoh DeepProbLog. For reasoning: representasi simbolik antara dipakai sebagai input proses KR/deduktif (data→ML→sym→KR→sym), contoh AlphaGo (ML evaluasi papan lalu Monte Carlo Tree Search memilih langkah).
Apa dua elemen baru yang ditambahkan van Bekkum et al. (2021) ke notasi boxology, dan kenapa? :: Process (menggantikan pembedaan biner ML/KR dengan klasifikasi Generation/Transformation/Inference yang lebih halus) dan Actor (segitiga, entitas otonom manusia/software agent/robot) — mengisi celah “future work” dari paper 2019 yang belum mendukung human-in-the-loop system.
Menurut van Bekkum et al., apa definisi presisi dari “Hybrid system”? :: Sistem yang membentuk kombinasi apa pun dari pola-pola elementer boxology selain kombinasi murni Machine Learning (generate:train + infer:deduce berbasis data) atau murni Knowledge Representation (infer:deduce simbolik murni).
Apa perbedaan Statistical Model dan Semantic Model dalam taksonomi boxology/BEAM? :: Statistical Model melakukan inferensi berbasis pola yang dipelajari dari data (inductive) — mis. neural network, LLM. Semantic Model melakukan inferensi lewat aturan yang sudah didefinisikan sebelumnya (deductive) — mis. ontology, logic programming.
Apa masalah utama yang ditemukan Tool4Boxology ketika memvalidasi 69 diagram boxology manual dari studi sistem neuro-symbolic clinical decision (Kierner et al./Ng et al.)? :: Hanya 12 dari 61 diagram yang tervalidasi benar secara sintaksis; 49 diagram melanggar aturan tipe (kesalahan paling umum: koneksi salah antara artefact dan proses); 8 sisanya melanggar batasan semantik dan butuh koreksi manual — menunjukkan diagram manual rawan salah tanpa alat validasi formal.
Apa tiga lapisan arsitektur Tool4Boxology? :: Boxology Design Layer (editor grafis + validasi sintaksis), Knowledge Representation Layer (RML mapping ke Knowledge Graph sesuai T4B Ontology), Knowledge Graph Exploration Layer (SPARQL query, validasi SHACL, deteksi pola).
Apa dua perspektif baru yang ditambahkan BEAM ke boxology, dan celah apa yang masing-masing isi? :: System perspective (Container, Note, System, Context — menangkap info rekayasa/konteks sistem) dan Risk & Mitigation perspective (Risk, Risk Source, Consequence, Impact, Risk Control berbasis AIRO — menangkap risiko AI dan mitigasinya secara granular per-elemen sistem), keduanya mengisi celah “trustworthy AI system engineering” yang tidak ada di boxology versi sebelumnya.
Dari mana ontology dasar untuk BEAM Risk perspective diambil, dan apa yang membuat pendekatan BEAM berbeda dari ontology risiko AI lain? :: Diambil dari AIRO (AI Risk Ontology, Golpayegani et al. 2022). Bedanya: elemen risk BEAM bisa ditautkan langsung ke elemen sistem individual (via annotation connector dan relasi hasRisk/originatesFrom), bukan cuma dideskripsikan di level sistem secara umum seperti kebanyakan framework risk management AI lain.
Sebutkan 4 jenis Processing dalam notasi BEAM dan contoh masing-masing :: Training (data/symbol→statistical model, mis. supervised/reinforcement learning), Engineering (…→data/symbol/semantic model, mis. ontology engineering manual), Inference (data/symbol→data/symbol, mis. klasifikasi), Transformation (data/symbol→data/symbol, mis. data imputation/mapping).
Apa itu Tool4Boxology(+) dan bagaimana kaitannya dengan BEAM? :: Versi Tool4Boxology yang sudah diintegrasikan dengan shape library anotasi BEAM (BEAM Annotation dan BEAM Risk), memungkinkan diagram divalidasi sekaligus diekspor sebagai Knowledge Graph (.ttl) dengan vocabulary BEAM (beam:/beamr:), dipakai untuk latihan hands-on di kelas.
Apa itu SoCK dan bagaimana kaitannya dengan rangkaian paper boxology/BEAM? :: SoCK (Synthesis of Causal Knowledge) adalah framework semantik untuk mengintegrasikan causal graph dari berbagai sumber (kurasi ahli, algoritma causal discovery, LLM). Bukan tentang boxology, tapi ditulis kelompok riset yang sama (Ekaputra) dan memakai arsitektur tiga-lapis yang mirip filosofinya dengan Tool4Boxology: ontology formal → Knowledge Graph terpadu → antarmuka eksplorasi ramah-stakeholder.
Apa perbedaan antara pola boxology “Explainable learning systems” biasa dan variannya “through inspection”? :: Versi biasa: output ML (simbolik) dipakai sebagai input KR untuk menyusun penjelasan post-hoc yang tidak merefleksikan komputasi internal ML. Versi “through inspection”: KR menginspeksi langsung state/perilaku sistem ML (lewat representasi simbolik dari state tersebut) untuk menjelaskan perilakunya, tanpa mengubah cara kerja ML itu sendiri.
Menurut framing System 1/System 2 di slide pembuka BEAM, apa yang dipetakan ke sub-symbolic AI dan apa yang dipetakan ke symbolic AI? :: System 1 (intuisi, cepat, tidak sadar, ~95% pemikiran manusia) dipetakan ke sub-symbolic AI/neural network yang belajar parametric knowledge dari data. System 2 (rasional, lambat, sadar, ~5%) dipetakan ke symbolic AI/expert system yang bernalar dari rule eksplisit.
Di fragmen NER tugas besar Fake Job Vacancy Detection, kenapa output-nya digambar sebagai node Symbol bukan Data? :: Karena hasil NER (skill, kontak, edukasi) bukan lagi teks bebas mentah — sudah punya skema (jenis entitas + nilai) yang bisa dinalar lebih lanjut oleh task Text Classification dan Red-Flag Extraction, beda dari raw text yang cuma kumpulan karakter tanpa struktur.
Tahap “Attribution Extraction” (SHAP/LIME) di fragmen Red-Flag Phrase Extraction cocok dengan pola boxology yang mana, dan kenapa? :: Pola #8 van Harmelen & ten Teije, “Explainable learning systems through inspection” — karena SHAP/LIME menginspeksi state/perilaku fraud classifier lewat representasi simbolik (frasa berkontribusi tinggi) untuk menjelaskannya, tanpa mengubah cara kerja classifier itu sendiri.
Kenapa fragmen Text Classification butuh node Transform sebelum data masuk ke Train, alih-alih langsung menghubungkan Data dan Symbol ke proses training? :: Karena Data (teks+metadata) dan Symbol (entitas hasil NER) adalah dua jenis artifact berbeda, dan grammar boxology tidak mengizinkan satu proses menerima kombinasi tipe campuran tanpa disatukan dulu — cocok dengan pola elementary {Symbol, Data} -> Transform -> Data.