Lanjutan materi NoSQL dari kurikulum semester ini: Introduction to NoSQL (riwayat SQL, keterbatasan relational DB, column store & graph database lebih dalam), Key-Value Database, dan Document Database.
Motivasi Munculnya NoSQL
Basis data relasional dirancang dengan asumsi ACID (Atomicity, Consistency, Isolation, Durability) sebagai prioritas utama, cocok untuk transaksi keuangan/bisnis kritikal. Namun aplikasi Web skala besar (media sosial, e-commerce, big data) menghadapi tantangan berbeda: volume data sangat besar, kebutuhan skalabilitas horizontal (menambah banyak mesin murah, bukan satu mesin besar), ketersediaan tinggi (high availability), dan latensi rendah — sementara strict consistency & rigid schema relasional justru menjadi hambatan (skema harus didefinisikan di depan, join mahal saat data terdistribusi, scaling vertikal mahal). Hal ini melahirkan gerakan NoSQL (“Not Only SQL”) — basis data non-relasional yang mengutamakan skalabilitas, fleksibilitas skema, dan ketersediaan, dengan mengorbankan sebagian konsistensi/relasi formal.
ACID vs BASE
| ACID | BASE | |
|---|---|---|
| Kepanjangan | Atomicity, Consistency, Isolation, Durability | Basically Available, Soft state, Eventually consistent |
| Filosofi | Konsistensi kuat harus dijamin setiap saat | Ketersediaan diutamakan; konsistensi dicapai belakangan |
| Cocok untuk | Transaksi kritikal (perbankan) | Aplikasi Web skala besar, terdistribusi |
| Trade-off | Skalabilitas terbatas | Konsistensi sementara dapat longgar |
- Basically Available: sistem menjamin ketersediaan (dalam pengertian CAP) — selalu merespons meski beberapa node gagal.
- Soft state: state sistem dapat berubah seiring waktu, bahkan tanpa input, karena proses eventual consistency.
- Eventually consistent: sistem akan menjadi konsisten pada akhirnya jika tidak ada input baru, namun untuk sementara dapat menunjukkan data yang tidak konsisten antar-replika.
Teorema CAP (Brewer’s Theorem)
Dalam sistem terdistribusi, hanya dua dari tiga properti berikut yang dapat dijamin secara simultan:
- Consistency (C): setiap pembacaan menerima data terbaru (write) atau error — semua node melihat data yang sama pada saat yang sama.
- Availability (A): setiap permintaan menerima respons (tanpa jaminan berisi data terbaru), meski beberapa node gagal.
- Partition tolerance (P): sistem tetap berjalan meski terjadi kegagalan komunikasi (partisi jaringan) antar-node.
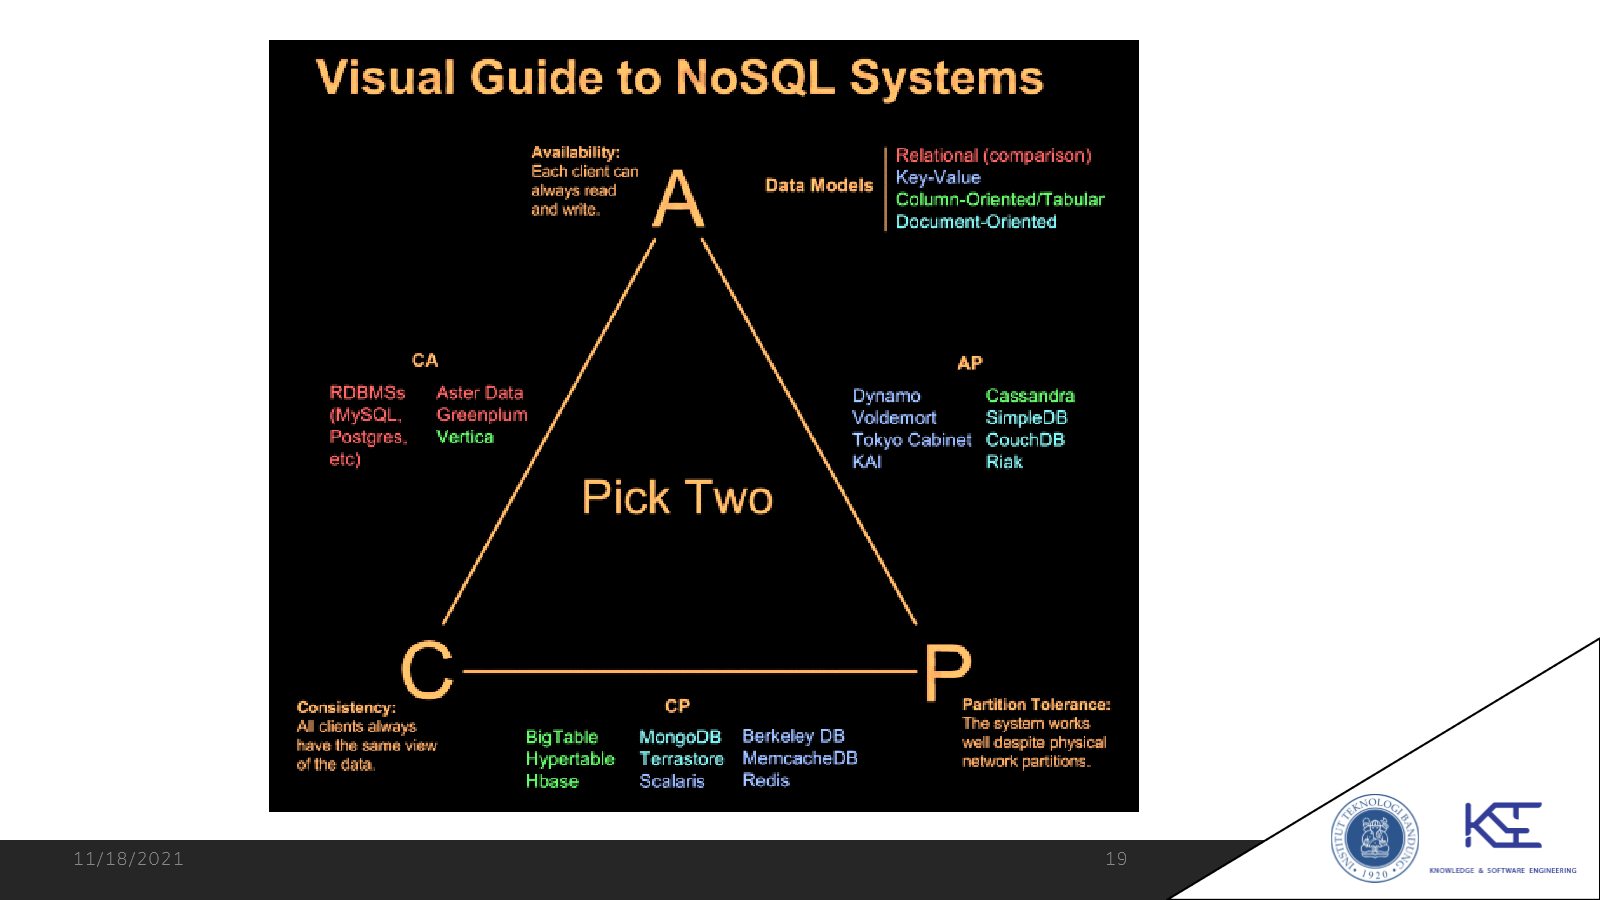
Karena partisi jaringan tidak dapat dihindari pada sistem terdistribusi skala besar, pilihan sebenarnya adalah trade-off antara C dan A ketika P terjadi:
- CP (Consistency + Partition tolerance): mengorbankan availability saat partisi terjadi — sistem menolak/menunda respons demi menjaga konsistensi (mis. HBase, MongoDB dalam mode tertentu).
- AP (Availability + Partition tolerance): mengorbankan consistency saat partisi terjadi — sistem tetap merespons meski data mungkin stale (mis. Cassandra, DynamoDB).
- CA: hanya realistis pada sistem tanpa partisi (single-node atau cluster dengan jaringan sangat andal) — pada praktiknya jarang murni dicapai pada sistem terdistribusi luas.
Klasifikasi Basis Data NoSQL
NoSQL bukan satu teknologi tunggal melainkan payung istilah untuk beberapa model data berbeda, masing-masing dioptimalkan untuk pola akses tertentu:
1. Key-Value Store
Model paling sederhana: data disimpan sebagai pasangan (key, value), di mana value adalah blob opaque (string, JSON, biner) yang tidak diinterpretasikan oleh sistem. Operasi dasar hanya get(key), put(key, value), delete(key). Sangat cepat dan mudah di-shard (partisi berdasar key) untuk skalabilitas horizontal, tetapi tidak mendukung query berdasarkan isi value maupun relasi antar-item.
- Contoh sistem: Amazon DynamoDB, Redis, Riak.
- Use case: session store, caching, shopping cart.
2. Column-Family (Wide-Column) Store
Data disimpan per baris, tetapi kolom dikelompokkan menjadi column family, dan setiap baris dapat memiliki himpunan kolom yang berbeda-beda (skema fleksibel per baris) — tidak seperti tabel relasional yang skemanya kaku untuk semua baris. Cocok untuk data sparse (banyak kolom potensial, tapi tiap baris hanya mengisi sedikit) dan skala sangat besar (miliaran baris/kolom).
- Contoh sistem: Google Bigtable, Apache HBase, Apache Cassandra.
- Use case: log analitik, time-series, data sensor skala besar.
3. Document Store
Data disimpan sebagai dokumen semi-terstruktur (biasanya JSON/BSON/XML), di mana tiap dokumen dapat memiliki struktur field yang berbeda dan mendukung nesting (dokumen di dalam dokumen, array). Mendukung query berdasarkan isi field di dalam dokumen (tidak sekadar key), berbeda dari key-value store.
- Contoh sistem: MongoDB, CouchDB.
- Use case: content management, katalog produk, profil pengguna dengan struktur bervariasi.
4. Graph Database
Data dimodelkan sebagai graf: node (entitas) dan edge (relasi berarah/tak-berarah, dapat memiliki properti). Dioptimalkan untuk query traversal (menelusuri relasi berantai, mis. “teman dari teman”) yang sangat mahal jika dilakukan lewat join berulang pada basis data relasional.
- Contoh sistem: Neo4j, Amazon Neptune.
- Use case: jejaring sosial, sistem rekomendasi, deteksi fraud, knowledge graph.
Tabel Ringkasan
| Tipe | Unit Data | Kelebihan Utama | Contoh Sistem |
|---|---|---|---|
| Key-Value | pasangan (key, value) | Sangat cepat, sangat mudah di-shard | Redis, DynamoDB |
| Column-Family | baris dengan kolom dinamis per column family | Skalabel untuk data sparse & sangat besar | Bigtable, HBase, Cassandra |
| Document | dokumen semi-terstruktur (JSON/BSON) | Skema fleksibel, mendukung struktur nested | MongoDB, CouchDB |
| Graph | node & edge | Traversal relasi kompleks efisien | Neo4j, Neptune |
MapReduce
MapReduce adalah model pemrograman untuk memproses dataset besar secara paralel dan terdistribusi di banyak mesin, populer sebagai paradigma pengolahan data pada ekosistem NoSQL/Big Data (dipopulerkan Google, diimplementasikan open-source pada Hadoop). Terdiri dari dua fase:
- Map: fungsi yang diterapkan pada tiap unit data input secara independen, menghasilkan sekumpulan pasangan (key intermediate, value intermediate).
- Reduce: seluruh value intermediate dengan key yang sama dikelompokkan lalu diproses oleh fungsi reduce untuk menghasilkan output akhir (biasanya berupa agregasi).
Prinsip kerja ini memungkinkan pemrosesan didistribusikan ke banyak node yang masing-masing hanya memproses sebagian data (data locality — memproses data pada/mendekati node tempat data tersimpan), sehingga skalabel secara horizontal. Contoh kasus klasik: word count — fase map memecah dokumen menjadi pasangan (kata, 1) untuk tiap kemunculan kata; fase reduce menjumlahkan seluruh nilai 1 untuk key (kata) yang sama guna mendapatkan frekuensi total tiap kata.
MapReduce sering digabungkan dengan basis data NoSQL (terutama column-family dan document store) sebagai mekanisme query/agregasi built-in, karena keduanya sama-sama dirancang untuk beroperasi di lingkungan terdistribusi skala besar.
Perbandingan Umum: Relasional vs NoSQL
| Aspek | Basis Data Relasional | NoSQL |
|---|---|---|
| Skema | Kaku, didefinisikan di depan | Fleksibel/dinamis, dapat bervariasi antar-record |
| Model konsistensi | ACID (strong consistency) | Umumnya BASE (eventual consistency) |
| Skalabilitas | Vertikal (mesin lebih besar) — horizontal sulit karena join | Horizontal (menambah node) — dirancang untuk sharding |
| Query | SQL deklaratif, mendukung join kompleks | Bervariasi per jenis (get/put, query dokumen, traversal graf); join umumnya terbatas/dihindari |
| Use case ideal | Transaksi kritikal, integritas data ketat | Big data, aplikasi Web skala besar, ketersediaan tinggi |
Sumber
- Materi kuliah IF4040 Pemodelan Data Lanjut, topik NoSQL.
Flashcard
flashcards Kenapa basis data relasional dianggap kurang cocok untuk aplikasi Web skala besar? :: Karena mengutamakan ACID/strict consistency dan skema kaku, sementara aplikasi Web besar butuh skalabilitas horizontal, ketersediaan tinggi, dan fleksibilitas skema — join di lingkungan terdistribusi juga mahal. Apa kepanjangan BASE dan apa maknanya? :: Basically Available, Soft state, Eventually consistent — filosofi yang mengutamakan ketersediaan sistem dan menerima konsistensi yang tercapai belakangan, bukan konsistensi kuat setiap saat. Sebutkan tiga properti dalam Teorema CAP :: Consistency (semua node melihat data sama), Availability (setiap request selalu direspons), Partition tolerance (sistem tetap jalan meski ada partisi jaringan). Kenapa dalam praktik pilihan CAP biasanya antara CP dan AP, bukan CA? :: Karena partisi jaringan (P) tidak dapat dihindari pada sistem terdistribusi skala besar, sehingga trade-off nyata terjadi antara Consistency dan Availability ketika partisi terjadi. Sebutkan empat kategori utama basis data NoSQL beserta satu contoh sistem masing-masing :: Key-value (Redis/DynamoDB), Column-family (HBase/Cassandra/Bigtable), Document (MongoDB/CouchDB), Graph (Neo4j/Neptune). Apa perbedaan utama column-family store dengan tabel relasional? :: Pada column-family store, tiap baris dapat memiliki himpunan kolom (dalam column family) yang berbeda-beda/fleksibel, cocok untuk data sparse, sedangkan tabel relasional memiliki skema kolom yang sama dan kaku untuk semua baris. Kapan graph database lebih unggul dibanding basis data relasional? :: Saat query melibatkan traversal relasi berantai (mis. teman-dari-teman, rekomendasi, deteksi fraud) yang pada model relasional memerlukan banyak join mahal, sementara pada graph database dapat ditelusuri langsung lewat edge. Jelaskan dua fase utama pada model pemrograman MapReduce :: Map: memproses tiap unit data input secara independen menjadi pasangan (key, value) intermediate; Reduce: mengelompokkan value dengan key sama lalu mengagregasinya menjadi output akhir. Apa manfaat data locality dalam MapReduce untuk skalabilitas? :: Memungkinkan pemrosesan dilakukan pada/mendekati node tempat data tersimpan, sehingga beban dapat didistribusikan ke banyak mesin secara paralel tanpa memindahkan seluruh data ke satu tempat.