In the Beginning There Was Google BigTable
Tahun 2006, Google mempublikasikan paper “BigTable: A Distributed Storage System for Structured Data” (Fay Chang, dkk., OSDI’06). Paper ini mendeskripsikan tipe basis data baru: column family database. Google mendesain basis data ini untuk beberapa layanan skala besarnya, termasuk web indexing, Google Earth, dan Google Finance. BigTable menjadi model untuk mengimplementasikan basis data NoSQL skala sangat besar — column family database lain yang mengikuti model ini antara lain Cassandra, HBase, dan Accumulo.
Core Features Google BigTable
- Developer punya kontrol dinamis atas kolom — kolom bisa ditambahkan kapan saja tanpa perlu update definisi skema.
- Data value diindeks oleh row identifier, column name, dan time stamp.
- Data modeler & developer punya kontrol atas lokasi data (data yang sering dipakai bersama bisa disimpan berdekatan).
- Read dan write suatu row bersifat atomic.
- Row dipertahankan dalam urutan terurut (sorted order).
Row sebagai Set Column Family
Row pada column family database diorganisasikan sebagai sekumpulan column family. Column family terdiri dari kolom-kolom terkait, dan data value diindeks oleh row, column name, dan time stamp. Contoh: column family Address bisa berisi kolom Street, City, State/Province, Postal Code, Country.
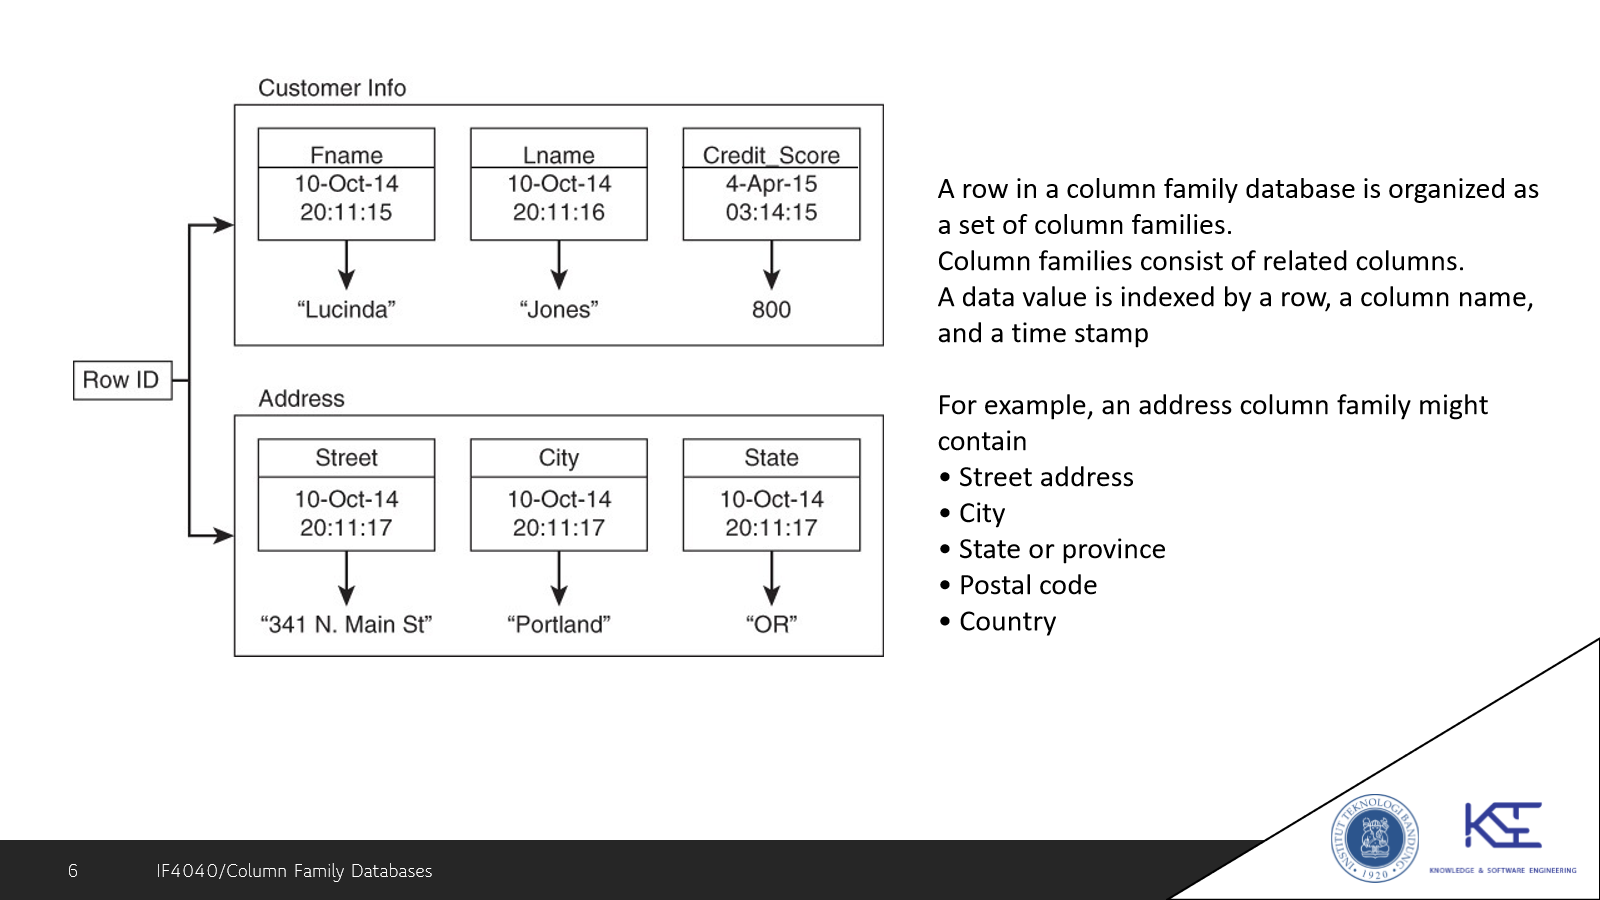
Column family diorganisasikan menjadi grup data item yang sering dipakai bersama. Column family untuk satu row boleh tidak berdekatan di disk, tapi kolom-kolom di dalam satu column family selalu disimpan berdekatan.
BigTable mengambil jalan tengah dalam mendefinisikan struktur data:
- Data modeler mendefinisikan column family sebelum implementasi basis data.
- Developer bisa menambahkan kolom secara dinamis ke column family tersebut.
- Tidak perlu update definisi skema setiap kali kolom baru ditambahkan.
Dari sudut pandang developer, column family analog dengan tabel relasional, dan kolom di dalamnya berfungsi layaknya pasangan key-value.
Contoh pemanfaatan kontrol dinamis atas kolom: sebuah perusahaan membangun column family database untuk data customer di Amerika Serikat. Data modeler mendefinisikan column family Address tanpa nama kolom spesifik. Developer menambahkan kolom “State” untuk seluruh customer AS. Ketika perusahaan ekspansi ke Kanada (yang memakai istilah “province”), developer cukup menambahkan kolom baru “Province” ke column family Address yang sama — tanpa migrasi skema.
Indexing by Row, Column Name, and Time Stamp
Data value diindeks oleh tiga hal:
- Row identifier — analog primary key pada relational database, mengidentifikasi row secara unik. Satu row bisa punya banyak column family.
- Column name — mengidentifikasi kolom secara unik.
- Time stamp — mengurutkan versi-versi nilai suatu kolom. Saat nilai baru ditulis ke BigTable, nilai lama tidak ditimpa — nilai baru ditambahkan beserta time stamp-nya, sehingga aplikasi bisa menentukan versi terbaru dari suatu kolom value.
Controlling Location of Data
Salah satu cara menghindari kebutuhan membaca banyak blok data yang tersebar di berbagai lokasi disk adalah menyimpan data yang sering dipakai bersama secara berdekatan. Contoh: jarang ada kasus di mana kita ingin street address customer tapi tidak ingin city/state-nya — masuk akal menyimpan ketiganya berdekatan.
Namun tidak selalu logis menyimpan street, city, state selalu berdekatan di semua kondisi. Contoh: seorang sales manager ingin query jumlah tablet terjual bulan lalu di negara bagian Colorado — tidak perlu mereferensikan city atau street address toko yang menjual tablet tersebut.
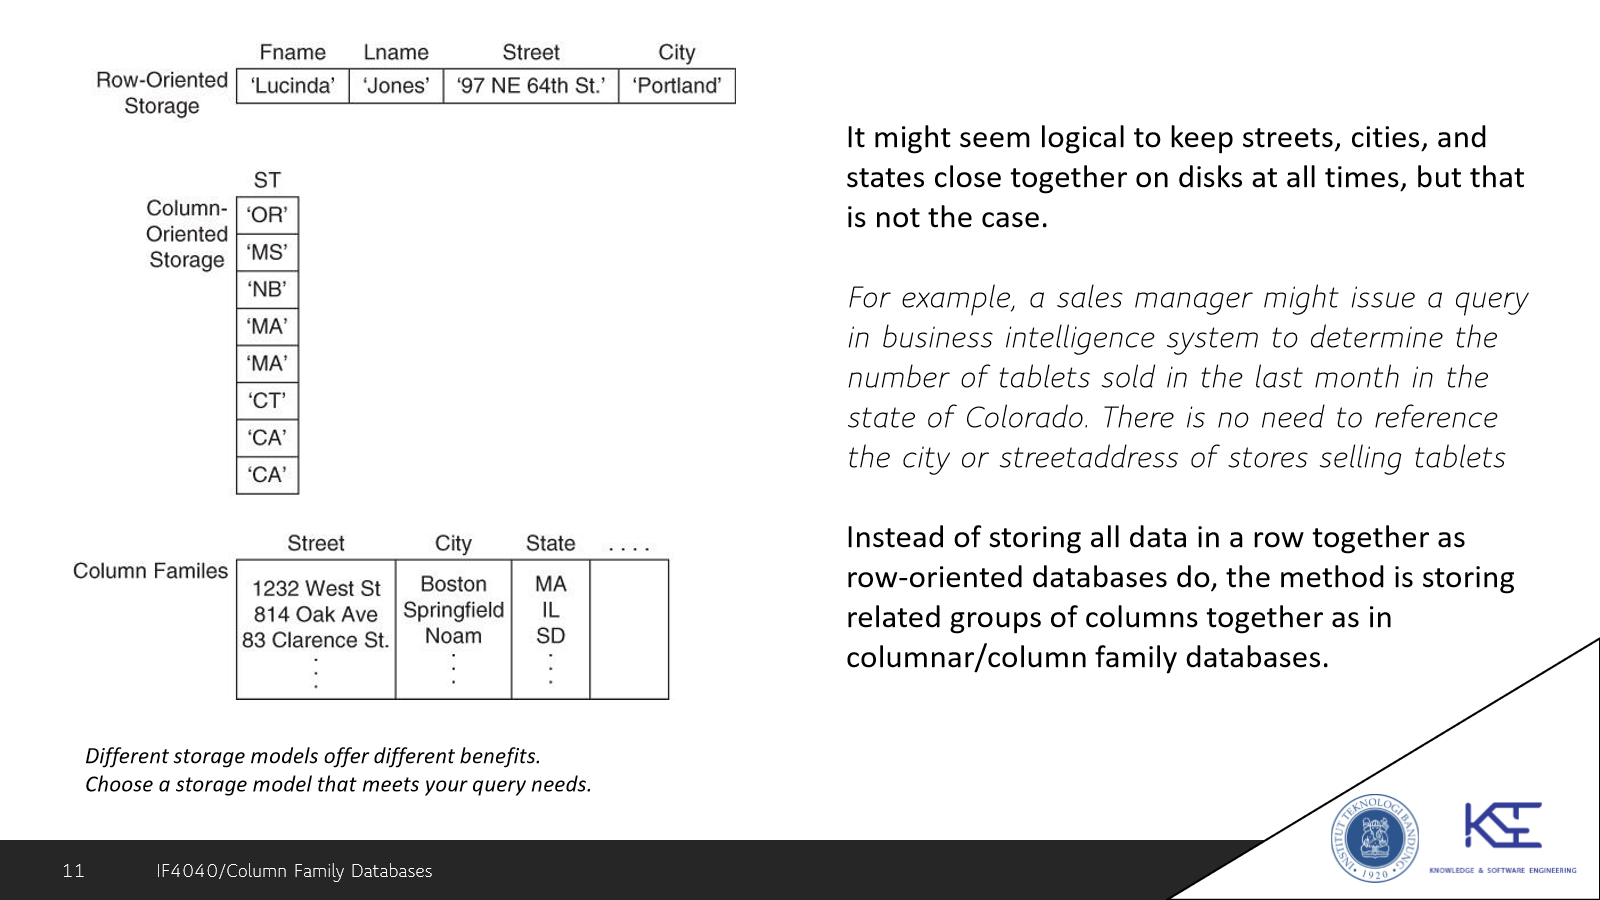
Alih-alih menyimpan seluruh data satu row bersama-sama (seperti row-oriented database), pendekatan column family database adalah menyimpan grup kolom terkait bersama-sama (columnar storage). Model storage berbeda menawarkan manfaat berbeda — pilih model storage yang sesuai kebutuhan query.
Reading and Writing Atomic Rows
Saat membaca sekumpulan kolom, kita akan mendapatkan seluruh kolom yang dibutuhkan atau tidak sama sekali — tidak ada hasil parsial pada operasi atomic.
Maintaining Rows in Sorted Order
BigTable mempertahankan row dalam urutan terurut → memudahkan range query. Contoh: sales transaction diurutkan berdasarkan tanggal — saat user perlu mengambil daftar transaksi minggu lalu, data bisa diambil tanpa perlu mengurutkan tabel transaksi besar atau memakai secondary index yang menjaga urutan tanggal. Catatan penting: tabel hanya bisa diurutkan dalam satu cara, jadi pemilihan sort order harus dilakukan dengan hati-hati.
Differences and Similarities with Key-Value, Document, and Relational Databases
Column Family Db vs Key-Value Db
Column family analog dengan namespace pada key-value database — developer bebas menambahkan kolom & value ke column family sama seperti bebas menambahkan key & value di key-value database.
Berbeda dari key-value database, value pada kolom diindeks oleh row identifier selain oleh column name (dan time stamp) — key-value database murni hanya mengindeks lewat key.
Column Family Db vs Document Db
Document database memungkinkan query & filter berdasarkan elemen dalam dokumen (mis. db.customers.find({"customer_id":187693}, {"address": 1}) pada MongoDB). Column family database mendukung jenis query serupa untuk memilih subset data dalam satu row — mis. Cassandra memakai bahasa mirip SQL bernama Cassandra Query Language (CQL) dengan statement SELECT yang familiar.
Seperti document database, column family database tidak mewajibkan seluruh kolom terisi di seluruh row — sebagian row bisa punya value untuk semua kolom, sebagian lain hanya untuk sebagian kolom di sebagian column family.
Column Family Db vs Relational Db
Kesamaan: kedua tipe basis data memakai unique identifier untuk row data — row key pada column family database dan primary key pada relational database, keduanya diindeks untuk pengambilan cepat. Kedua tipe basis data juga bisa dipandang menyimpan data tabular pada level abstraksi tertentu — column family database memakai konsep map/dictionary/associative array: column key memetakan dari nama kolom ke nilai kolom, dan column family sendiri adalah map yang menunjuk ke map kolom-kolom.
Perbedaan — Typed Column: column family database tidak mendukung konsep typed column. Nilai kolom dipandang sebagai rangkaian byte yang diinterpretasikan oleh aplikasi, bukan oleh basis data — memberi fleksibilitas lebih (developer bebas menginterpretasikan rangkaian byte dengan berbagai cara), tapi tanggung jawab validasi data sepenuhnya berpindah ke developer.
Perbedaan — Multirow Transaction: meski read/write pada satu row bersifat atomic, column family database seperti Cassandra tidak mendukung transaksi multirow. Jika butuh dua atau lebih operasi dijalankan sebagai satu transaksi, sebaiknya cari cara mengimplementasikan operasi tersebut dalam satu row data — ini mungkin memerlukan perubahan model data dan menjadi salah satu pertimbangan penting saat mendesain column family.
Perbedaan — Joins and Subqueries: seharusnya minim kebutuhan join dan subquery pada column family database. Column family mempromosikan denormalisasi, yang menghilangkan atau setidaknya mengurangi kebutuhan join — relasi antar column family cukup ditangkap lewat row identifier yang sama.
Basic Components of Column Family Database
Komponen dasar yang paling sering dihadapi developer: keyspace, row key, column, column family.
Keyspace
Keyspace adalah struktur data top-level pada column family database — seluruh struktur data lain yang dibuat berada di dalam suatu keyspace. Keyspace analog dengan schema pada relational database: container top-level yang secara logis menampung column family, row key, dan struktur data terkait. Umumnya, ada satu keyspace per aplikasi.
Row Key
Row key mengidentifikasi satu row secara unik dalam suatu column family — berfungsi mirip primary key pada relational database. Cara lain mengidentifikasi value secara unik dalam basis data: nama column family, nama kolom, dan mekanisme pengurutan versi (mis. timestamp).
Row key juga dipakai untuk partisi dan pengurutan data:
- Pada HBase, row disimpan dalam urutan lexicographic dari row key-nya.
- Pada Cassandra, row disimpan dalam urutan yang ditentukan oleh objek bernama partitioner (default: random partitioner, tapi bisa juga order-preserving partitioner).
Column
Column adalah struktur data untuk menyimpan satu nilai dalam basis data. Berbeda implementasi, berbeda perlakuan tipe kolom:
- HBase: value direpresentasikan sebagai rangkaian byte → meminimalkan overhead validasi tipe data.
- Cassandra: mendukung spesifikasi tipe data mulai dari integer, string, hingga list dan map.
Value bisa bervariasi, dari integer tunggal hingga dokumen XML yang kompleks & terstruktur. Column, beserta row key dan version stamp, secara bersama mengidentifikasi value secara unik.
Column adalah anggota dari suatu column family — database designer mendefinisikan column family saat membuat basis data, tapi developer bisa menambahkan kolom kapan saja setelahnya. Column punya tiga bagian:
- Column name — berfungsi sama seperti key pada pasangan key-value: merujuk ke suatu value.
- Time stamp (atau version stamp lain) — cara mengurutkan versi-versi value suatu kolom. Saat value diupdate, value baru disisipkan ke basis data beserta timestamp (atau version) baru, bersama nama kolom dan value-nya.
- Value.
Column Families
Column family adalah kumpulan kolom-kolom terkait — kolom yang sering dipakai bersama sebaiknya dikelompokkan dalam column family yang sama (mis. informasi alamat customer: street, city, state, zip dikelompokkan dalam satu column family).
Column family disimpan dalam suatu keyspace. Setiap row dalam column family diidentifikasi unik oleh row key — analog dengan tabel pada relational database. Meski analog, ada perbedaan signifikan:
- Data pada tabel relasional tidak wajib dipertahankan dalam urutan tertentu, sedangkan data pada column family selalu terurut.
- Row pada tabel relasional tidak diversi seperti pada column family database.
- Kolom pada tabel relasional tidak sedinamis kolom pada column family database (kolom bisa berbeda antar-row).
Komponen Lain (Internal)
Selain empat komponen dasar di atas, ada struktur internal & parameter konfigurasi penting lain yang perlu dipahami designer/developer: Cluster, Partition, Commit Log, Bloom Filter, Replication count, Consistency Level (tidak dibahas mendalam pada materi ini).
Guidelines for Designing Tables (Column Families)
Seperti basis data NoSQL lainnya, desain dimulai dari query. Query memberi informasi yang dibutuhkan untuk mendesain column family database secara efektif, mencakup: entities, atribut entitas, query criteria, derived values. Designer memulai dari informasi ini, lalu memakai fitur-fitur column family database untuk memilih implementasi paling sesuai.
Column family database diimplementasikan berbeda dari relational database — menganggap keduanya sama bisa berujung pada keputusan desain yang buruk. Penting dipahami:
- Column family database diimplementasikan sebagai sparse, multidimensional map.
- Kolom bisa berbeda antar-row.
- Kolom bisa ditambahkan secara dinamis.
- Join tidak dipakai; data didenormalisasi sebagai gantinya.
Tujuh guideline mendesain tabel (column family):
1. Denormalize Instead of Join
Column family database butuh lebih sedikit tabel dibanding relational database untuk menghindari kebutuhan join. Pada relational database, relasi many-to-many dimodelkan lewat tabel junction yang menyimpan primary key kedua entitas. Pada column family database, relasi many-to-many ditangkap lewat denormalisasi data — mis. tabel Cust_Prod menyimpan produk yang dibeli langsung sebagai bagian dari row customer (produk sebagai valueless column, lihat poin berikut), tanpa perlu tabel junction terpisah.
2. Make Use of Valueless Columns
Daripada punya kolom bernama ProductPurchased1 dengan value PR_B1839, tabel cukup menyimpan product ID sebagai nama kolom itu sendiri (kolom tanpa value bermakna, atau value-nya dipakai untuk keperluan lain). Ini memanfaatkan fakta bahwa nama kolom pada column family database bersifat dinamis dan bisa membawa informasi.
3. Use Both Column Names and Column Values to Store Data
Baik nama kolom maupun value kolom bisa dipakai menyimpan data. Contoh: pada basis data customer & produk, fitur produk (deskripsi, ukuran, warna, berat) disimpan di tabel produk. Jika user ingin laporan produk yang dibeli customer beserta nama produknya (bukan hanya ID-nya), nama produk bisa disimpan sebagai value dari kolom yang nama-nya adalah product ID pada tabel Cust_Prod. Menyimpan salinan nama produk di tabel customer menambah storage, tapi ini adalah trade-off: storage tambahan ditukar dengan performa baca yang lebih baik (tidak perlu lookup terpisah ke tabel produk).
4. Model an Entity with a Single Row
Satu entitas (mis. customer atau produk tertentu) sebaiknya punya seluruh atributnya dalam satu row — meski sebagian row menyimpan lebih banyak column value dibanding row lain, itu tidak masalah. Entitas bisa punya atribut tersebar di banyak tabel, tapi tidak direkomendasikan untuk column family database — karena write ke satu row bersifat atomic: jika beberapa kolom dalam satu tabel diupdate, semuanya akan terupdate atau tidak sama sekali (jaminan atomicity ini hilang jika atribut tersebar ke banyak tabel).
5. Avoid Hotspotting in Row Keys
Hotspotting terjadi ketika banyak operasi dijalankan pada sejumlah kecil server saja (row key sekuensial cenderung diarahkan ke server yang sama, menyebabkan beban tidak merata). Cara mencegah hotspotting:
- Hashing nilai sekuensial yang dihasilkan sistem lain.
- Menambahkan string acak sebagai prefix pada nilai sekuensial tersebut.
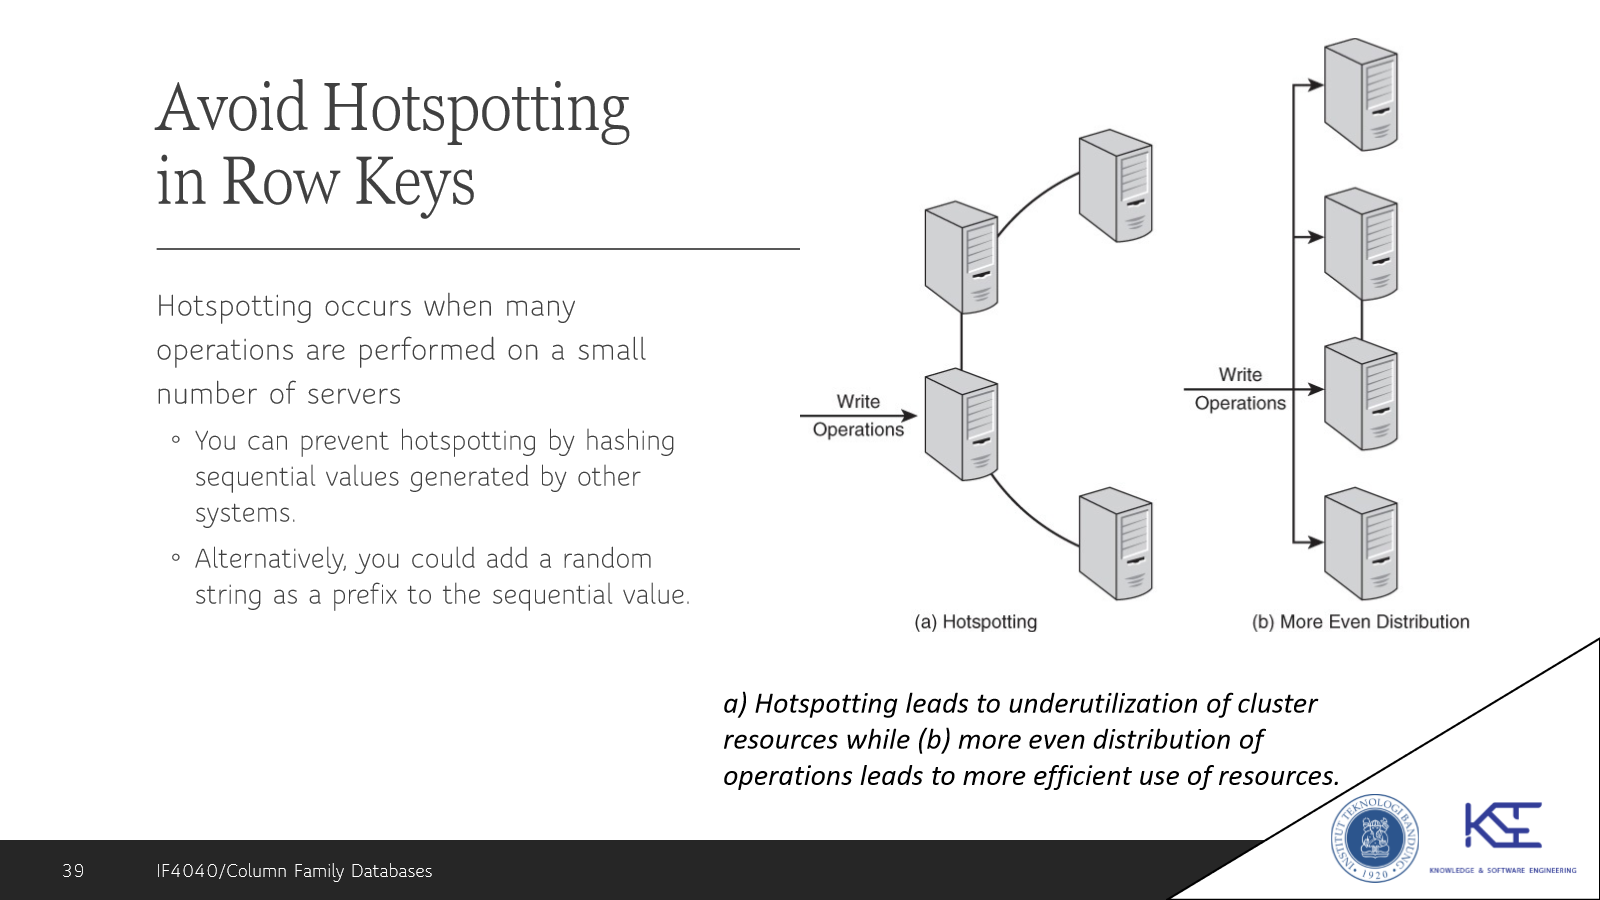
Hotspotting menyebabkan underutilization resource cluster, sedangkan distribusi operasi yang lebih merata memakai resource cluster secara lebih efisien.
6. Keep an Appropriate Number of Column Value Versions
Column value diberi timestamp sehingga versi terbaru maupun terlama bisa ditentukan — berguna untuk roll back perubahan pada column value. Simpan versi sebanyak yang dibutuhkan aplikasi, tidak lebih:
- HBase memungkinkan pengaturan jumlah versi minimum & maksimum. HBase tidak akan menghapus versi jika akan menyisakan column value dengan jumlah versi di bawah minimum.
- Saat jumlah versi melebihi maksimum, versi terlama dihapus selama operasi data compaction.
7. Avoid Complex Data Structures in Column Values
Pada document database, embedded object umum dipakai di dalam dokumen. Struktur data semacam ini bisa disimpan sebagai column value pada column family database, tapi tidak direkomendasikan kecuali ada alasan spesifik untuk mempertahankan struktur tersebut. Memakai kolom terpisah untuk tiap atribut lebih memudahkan penerapan fitur basis data terhadap atribut tersebut (mis. indexing per atribut), dan memisahkan atribut ke kolom individual memungkinkan penggunaan column family berbeda jika diperlukan — alih-alih menyimpan objek address sebagai satu blob JSON bersarang di dalam satu column value.
Guidelines for Indexing
Index memungkinkan pencarian data dalam tabel secara cepat. Pada column family database, kita bisa mencari suatu column value untuk menemukan row-row yang mereferensikan value tersebut — dalam banyak kasus, index membuat database engine mengambil data lebih cepat dibanding tanpa index.
Dua jenis index: primary dan secondary.
- Primary index: index pada row key suatu tabel → otomatis dikelola oleh sistem column family database.
- Secondary index: index yang dibuat pada satu atau lebih column value.
Kapan Memakai Secondary Index yang Dikelola Sistem
Jika butuh secondary index pada column value dan sistem column family database menyediakan secondary index yang dikelola otomatis, sebaiknya manfaatkan fitur tersebut. Keuntungan utama: lebih sedikit kode yang perlu dipelihara developer, dan tidak perlu mengubah kode untuk memakai index tersebut. Contoh CQL pada Cassandra:
CREATE INDEX state ON customers(state);Cassandra kemudian membuat & mengelola seluruh struktur data yang dibutuhkan untuk memelihara index tersebut, serta menentukan penggunaan index yang optimal.
Hindari secondary index otomatis pada kondisi berikut:
- Jumlah nilai distinct kecil pada suatu kolom (mis. kolom boolean “Opt In?” dengan hanya dua nilai distinct) — index semacam ini kurang selektif dan kurang bermanfaat.
- Terlalu banyak nilai unik pada suatu kolom (mis. kolom email di mana hampir semua value unik).
- Column value bersifat sparse (banyak row tidak punya value untuk kolom tersebut, mis. kolom “Province” yang hanya terisi untuk customer Kanada).
Kapan Membuat & Mengelola Sendiri Secondary Index Lewat Tabel
Jika sistem column family database tidak mendukung secondary index otomatis, atau kolom yang ingin diindeks punya banyak nilai distinct, kita bisa mendapat manfaat dari membuat & mengelola index sendiri. Index yang dibuat & dikelola aplikasi memakai struktur data tabel, column family, dan column yang sama seperti data biasa — kita secara eksplisit membuat tabel untuk menyimpan data yang ingin diakses lewat index tersebut.
Contoh: untuk cepat menemukan semua customer yang membeli suatu produk, buat tabel Cust_by_Prod yang memakai product identifier sebagai row key dan customer identifier sebagai nama kolom (column value bisa dipakai menyimpan info tambahan seperti nama customer). Sebaliknya, tabel Prod_by_Cust memakai customer identifier sebagai row key dan product identifier sebagai nama kolom untuk arah pencarian yang berlawanan.
Row key (Cust_by_Prod) | 123 | 287 | 1987 | 2405 | 3902 |
|---|---|---|---|---|---|
| 38383 | Smith | Badal | |||
| 48282 | Smith | Jones | O’Malley | ||
| 59595 | Washington |
Memakai tabel sebagai secondary index tentu membutuhkan storage tambahan (sama halnya saat sistem column family database mengelola index secara otomatis). Saat memakai tabel sebagai index, kita bertanggung jawab memelihara index tersebut — dua opsi terkait waktu update:
- Update index setiap kali ada perubahan pada tabel dasar (base table) — menjaga data tetap sinkron, tapi menambah waktu penyelesaian operasi tulis.
- Jalankan batch job secara berkala untuk mengupdate tabel index — memperkenalkan periode di mana data tidak sinkron, tapi ini bisa diterima pada sebagian kasus.
When to Use Column Family Database
Column family database adalah pilihan tepat untuk deployment basis data skala besar yang membutuhkan performa tulis tinggi, jumlah server yang besar, atau ketersediaan multi–data center:
- Operasi write-intensive, seperti yang ditemukan pada aplikasi social networking.
- Arsitektur peer-to-peer Cassandra dengan dukungan hinted handoff berarti basis data akan selalu bisa menerima operasi tulis selama minimal satu node berfungsi & terjangkau.
- Catatan: jika aplikasi write-intensive juga membutuhkan transaksi, column family database mungkin bukan pilihan terbaik — pertimbangkan pendekatan hybrid yang memakai basis data pendukung transaksi ACID (mis. relational database, atau key-value database seperti FoundationDB).
Column family database juga tepat dipakai saat jumlah server besar dibutuhkan untuk memenuhi beban kerja. Jika satu atau beberapa server saja sudah cukup memenuhi kebutuhan performa, key-value, document, atau bahkan relational database bisa jadi pilihan yang lebih baik. Cassandra mendukung deployment multi–data center, termasuk replikasi lintas data center — jika butuh ketersediaan berkelanjutan bahkan saat satu data center down, pertimbangkan Cassandra.
Jika mempertimbangkan column family database semata-mata karena fleksibilitas model data, pastikan turut mengevaluasi key-value dan document database — keduanya mungkin sudah cukup memenuhi kebutuhan dan berjalan baik pada lingkungan dengan satu atau sedikit server.
Case Study: Customer Data Analysis
Konteks: analis di TGTS (TransGlobal Transport and Shipping) ingin memahami bagaimana pola shipping customer berubah dari waktu ke waktu — mereka punya beberapa hipotesis mengapa sebagian customer melakukan lebih banyak/lebih sedikit shipping. Mereka menginginkan data store besar dengan cakupan data luas:
- Seluruh shipping order untuk seluruh customer sejak perusahaan berdiri.
- Seluruh detail pada customer record.
- Artikel berita, newsletter industri, dan teks lain tentang industri & pasar customer mereka.
- Data historis tentang industri shipping, terutama basis data finansial.
Kebutuhan query fase pertama: analis ingin menerapkan teknik statistik & machine learning untuk memahami data (mis. apakah ada klaster customer/shipping order yang mirip, bagaimana rata-rata nilai order bervariasi per customer & musim). Mereka juga ingin menjalankan laporan spesifik dengan query berikut:
- Untuk customer tertentu, order apa saja yang sudah ditempatkan?
- Untuk order tertentu, item apa saja yang dikirim?
- Untuk rute tertentu, berapa banyak kapal memakai rute tersebut dalam periode waktu tertentu?
- Untuk customer di industri tertentu, berapa banyak shipment dilakukan dalam periode waktu tertentu?
Keputusan desain: variasi & volume data ini masuk kategori Big Data, sehingga tim pengembang memilih column family database. Basis data column store membutuhkan tabel untuk:
- Customers: satu column family berisi nama perusahaan, alamat, kontak, industri, kategori pasar.
- Orders: detail item yang dikirim (nama, deskripsi, berat).
- Ships: detail kapasitas, usia, riwayat perawatan, dan fitur kapal lainnya.
- Routes: informasi deskriptif rute serta detail geografis rute.
Strategi indexing: designer mengimplementasikan tabel sebagai index untuk kebutuhan berikut:
- Orders by customer
- Shipped items by order
- Ships by route
Selain itu, karena sebagian query mereferensikan periode waktu, designer juga mengimplementasikan index yang dikelola sistem basis data (database-managed index) pada kolom data terkait tanggal.
Architectures Used in Column Family Databases
Secara umum, ada dua tipe arsitektur yang umum dipakai pada basis data terdistribusi: multiple node type dan peer-to-peer type.
HBase Architecture: Variety of Nodes
HBase dibangun di atas Hadoop File System (HDFS), yang memakai arsitektur master-slave terdiri dari name node dan data node.
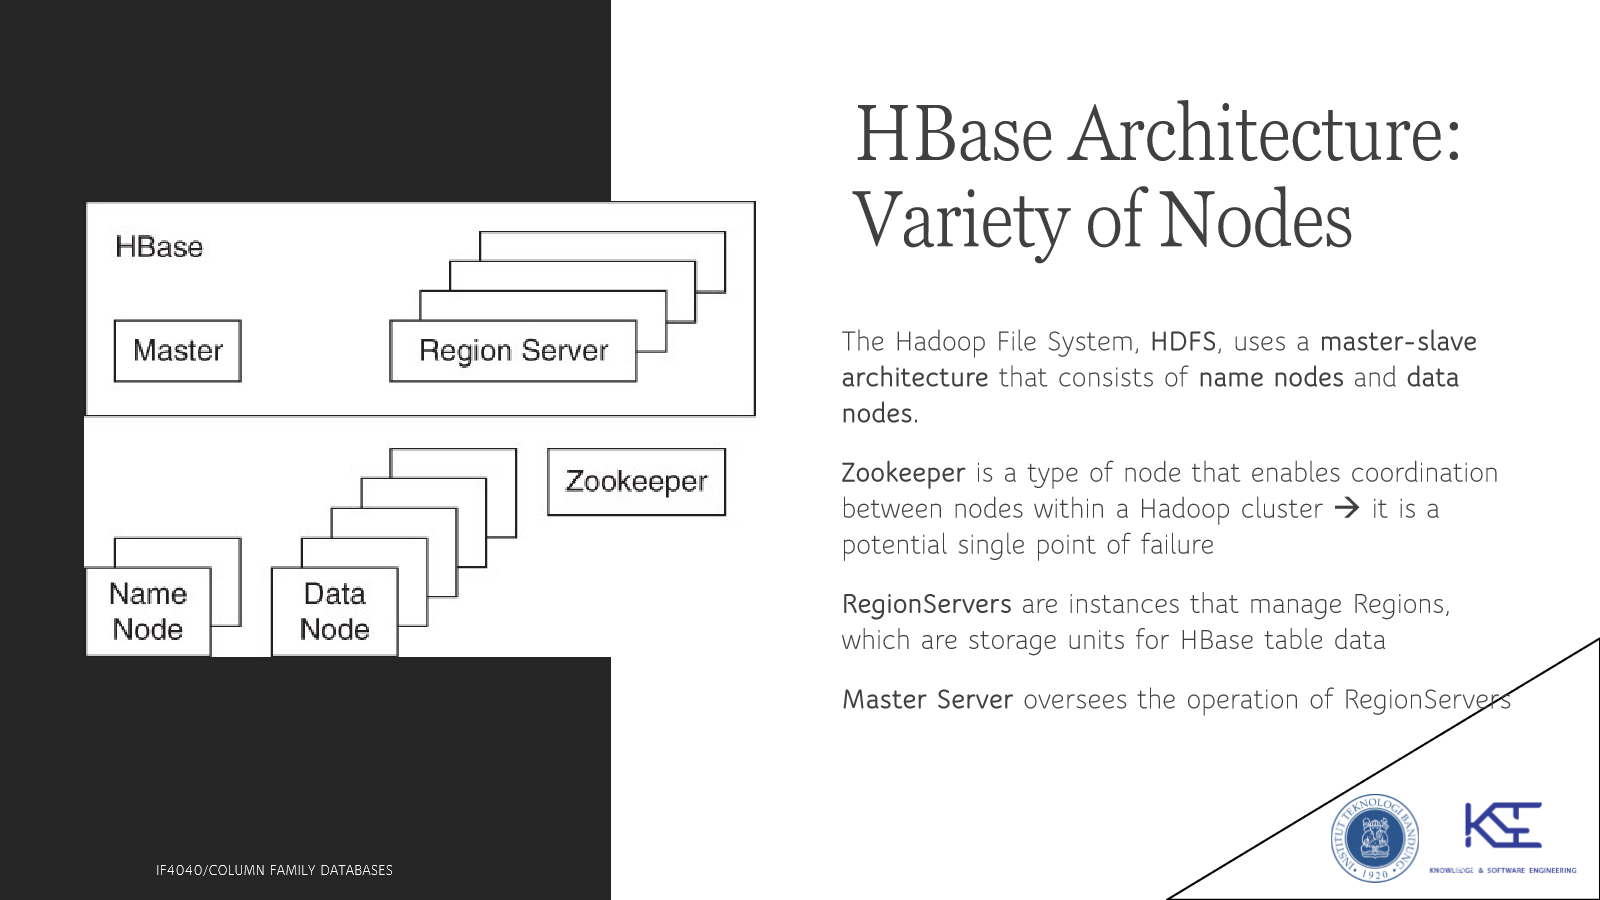
- Zookeeper — tipe node yang mengaktifkan koordinasi antar-node dalam cluster Hadoop. Zookeeper berpotensi menjadi single point of failure.
- RegionServer — instance yang mengelola Region, yaitu unit penyimpanan untuk data tabel HBase.
- Master Server — mengawasi operasi seluruh RegionServer.
Cassandra Architecture: Peer-to-Peer
Cassandra memakai model peer-to-peer. Seluruh node Cassandra menjalankan software yang sama, meski bisa melayani fungsi berbeda untuk cluster — tidak ada satu node pun yang menjadi single point of failure, berbeda dengan arsitektur HBase yang punya Zookeeper & Master Server sebagai potensi titik gagal tunggal.
graph LR
  N1((Cassandra Node 1)) --> N2((Cassandra Node 2)) --> N3((Cassandra Node 3)) --> N4((Cassandra Node 4))
  N4 -.-> Nn((Cassandra Node n)) --> N1
Seluruh server dalam cluster bertanggung jawab untuk:
- Membagikan informasi tentang status server-server lain dalam cluster.
- Memastikan node memiliki versi data terbaru.
- Memastikan data tulis tetap tersimpan (lewat mekanisme seperti hinted handoff) saat server yang seharusnya menerima tulisan sedang tidak tersedia.
Sumber
- D. Sullivan: NoSQL for Mere Mortals, Addison-Wesley, 2015, Chapter 9–10 (Column Family Databases).
Flashcard
flashcards Apa itu Google BigTable dan mengapa penting bagi perkembangan NoSQL? :: Basis data terdistribusi yang dideskripsikan Google dalam paper OSDI’06 (2006); mempopulerkan tipe basis data column family dan menjadi model untuk column family database lain seperti Cassandra, HBase, dan Accumulo. Sebutkan lima core feature Google BigTable :: (1) Kontrol dinamis developer atas kolom, (2) data value diindeks oleh row identifier + column name + time stamp, (3) kontrol lokasi data oleh data modeler/developer, (4) read/write satu row bersifat atomic, (5) row dipertahankan dalam urutan terurut. Bagaimana BigTable mengambil “jalan tengah” dalam mendefinisikan struktur data? :: Data modeler mendefinisikan column family sebelum implementasi (skema kasar/coarse-grained), tapi developer bisa menambah kolom secara dinamis ke column family tersebut kapan saja tanpa perlu update definisi skema. Kenapa row-oriented storage tidak selalu ideal dibanding column-oriented storage? :: Karena query tertentu (mis. total tablet terjual di satu state) hanya butuh sebagian kolom saja; column-oriented storage menyimpan grup kolom terkait bersama sehingga hanya kolom relevan yang dibaca, alih-alih membaca seluruh row termasuk kolom yang tidak dibutuhkan. Apa perbedaan utama column family database dengan key-value database dalam hal indexing? :: Key-value database hanya mengindeks lewat key; column family database mengindeks value lewat row identifier DAN column name (plus time stamp) — column family sendiri analog dengan namespace pada key-value database. Kenapa column family database tidak mendukung “typed column”, dan apa konsekuensinya? :: Column value dipandang sebagai rangkaian byte yang diinterpretasikan aplikasi (bukan database) — memberi fleksibilitas interpretasi, tapi tanggung jawab validasi tipe data sepenuhnya berpindah ke kode aplikasi. Kenapa Cassandra tidak mendukung transaksi multirow, dan apa implikasinya bagi desain? :: Read/write atomic hanya dijamin untuk satu row; jika butuh beberapa operasi sebagai satu transaksi, operasi tersebut harus diimplementasikan dalam satu row data — mungkin memerlukan perubahan model data. Jelaskan tiga komponen dasar column family database: keyspace, row key, dan column family :: Keyspace = container top-level (analog schema relasional, biasanya satu per aplikasi); row key = pengidentifikasi unik row (analog primary key, juga berperan dalam partisi & urutan data); column family = kumpulan kolom terkait yang sering dipakai bersama (analog tabel relasional, tapi row terurut, terversi, dan kolom dinamis). Sebutkan tiga hal penting yang membedakan column family dari tabel relasional :: Data pada column family selalu terurut (relasional tidak wajib), row pada column family diversi lewat timestamp (relasional tidak), dan kolom pada column family bisa berbeda antar-row & ditambah dinamis (relasional tidak sedinamis itu). Apa strategi “denormalize instead of join” pada column family database untuk relasi many-to-many? :: Alih-alih membuat tabel junction terpisah seperti pada relational database, relasi many-to-many ditangkap dengan mendenormalisasi data langsung ke dalam row (mis. memakai valueless column berisi ID entitas terkait sebagai nama kolom). Apa manfaat pola “use both column names and column values to store data”? :: Menyimpan data baik di nama kolom maupun value-nya sekaligus (mis. product ID sebagai nama kolom, product name sebagai value) — trade-off menambah storage untuk mendapat performa baca lebih baik (satu lookup, tanpa perlu query terpisah ke tabel lain). Kenapa “model an entity with a single row” penting pada column family database? :: Karena write ke satu row bersifat atomic — jika atribut suatu entitas tersebar ke banyak row/tabel, jaminan bahwa semua atribut terupdate bersama (atau tidak sama sekali) akan hilang. Apa itu hotspotting dan bagaimana mencegahnya pada row key? :: Hotspotting adalah kondisi banyak operasi terkonsentrasi pada sejumlah kecil server karena row key sekuensial; dicegah dengan hashing nilai sekuensial atau menambahkan prefix string acak pada nilai tersebut. Kapan sebaiknya menghindari secondary index otomatis yang dikelola sistem column family database? :: Saat kolom punya jumlah nilai distinct kecil (kurang selektif), saat kolom punya terlalu banyak nilai unik, atau saat column value bersifat sparse (banyak row tanpa value pada kolom tersebut). Apa perbedaan arsitektur HBase dan Cassandra dari sisi single point of failure? :: HBase memakai arsitektur master-slave (HDFS name/data node) plus Zookeeper untuk koordinasi dan Master Server untuk mengawasi RegionServer — keduanya berpotensi jadi single point of failure; Cassandra memakai model peer-to-peer di mana seluruh node menjalankan software yang sama, sehingga tidak ada satu node pun yang menjadi titik gagal tunggal. Kapan column family database (mis. Cassandra) menjadi pilihan tepat, dan kapan sebaiknya dihindari? :: Tepat untuk deployment skala besar dengan performa tulis tinggi, banyak server, atau kebutuhan ketersediaan multi-data center (mis. aplikasi write-intensive seperti social networking); kurang tepat jika aplikasi write-intensive tersebut juga butuh transaksi ACID (pertimbangkan pendekatan hybrid dengan relational/key-value database yang mendukung ACID).