What is a Graph?
Graph adalah objek matematis yang terdiri dari dua bagian: vertices (simpul) dan edges (sisi). Vertex merepresentasikan suatu entitas (kota, karyawan, protein, sirkuit listrik, junction pipa air, organisme dalam ekosistem, stasiun kereta, dsb) — semua entitas ini memiliki kesamaan: punya relasi dengan entitas lain. Relasi/koneksi antar entitas inilah yang direpresentasikan oleh edge.
Graph and Network Modeling
Beberapa contoh domain yang dimodelkan dengan graph:
- Geographic Locations — lokasi geografis (kota, kota kecil, persimpangan jalan) dimodelkan sebagai vertex (dengan properti nama, latitude, longitude, populasi, dsb); jalan raya/rel kereta dimodelkan sebagai edge (dengan properti panjang, tahun dibangun, kecepatan maksimum) — bisa satu edge untuk dua arah, atau dua edge terpisah untuk masing-masing arah.
- Infectious Diseases — penyebaran penyakit menular mudah dimodelkan dengan graph: vertex merepresentasikan orang (properti: usia, berat, status infeksi), edge merepresentasikan interaksi antar orang (properti: probabilitas infeksi).
- Abstract and Concrete Entities — graph cocok memodelkan relasi abstrak seperti relasi part-of (mis. Automobile → Body/Electrical System/Power Train → Doors/Windows, dst). Relasi hierarkis dimodelkan dalam tipe graph khusus bernama tree, yang punya vertex khusus disebut root (mis. United States → Washington/Oregon/California, dengan Oregon → Portland).
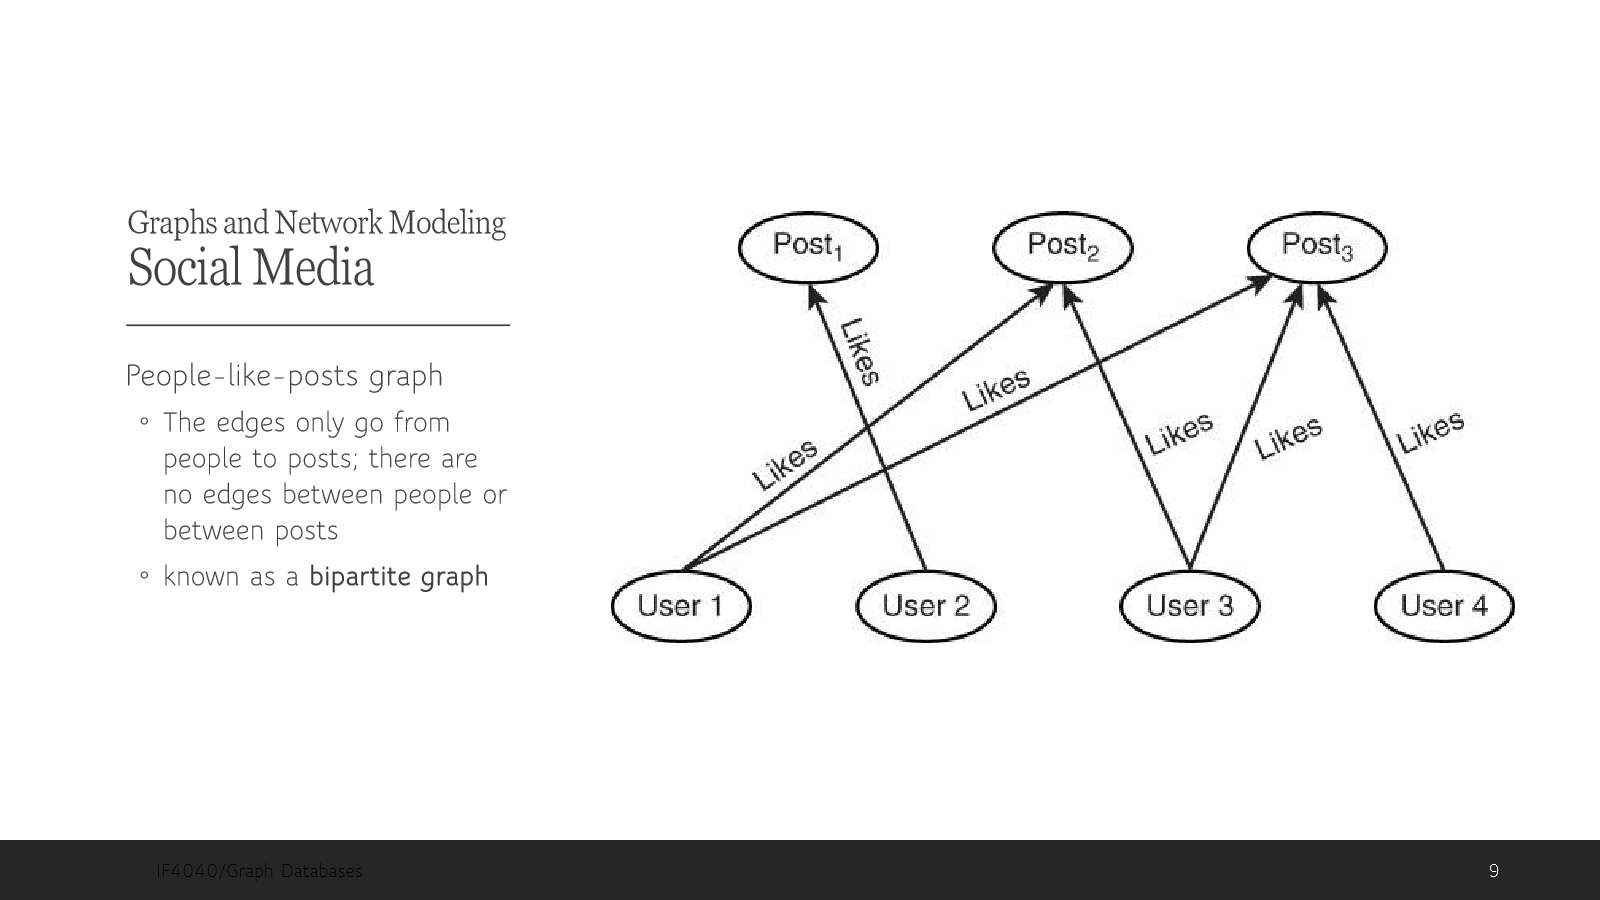
- Social Media — graph people-like-posts: edge hanya mengalir dari orang ke post, tidak ada edge antar-orang atau antar-post. Ini dikenal sebagai bipartite graph.
Advantages of Graph Databases
Faster Query by Avoiding Joins
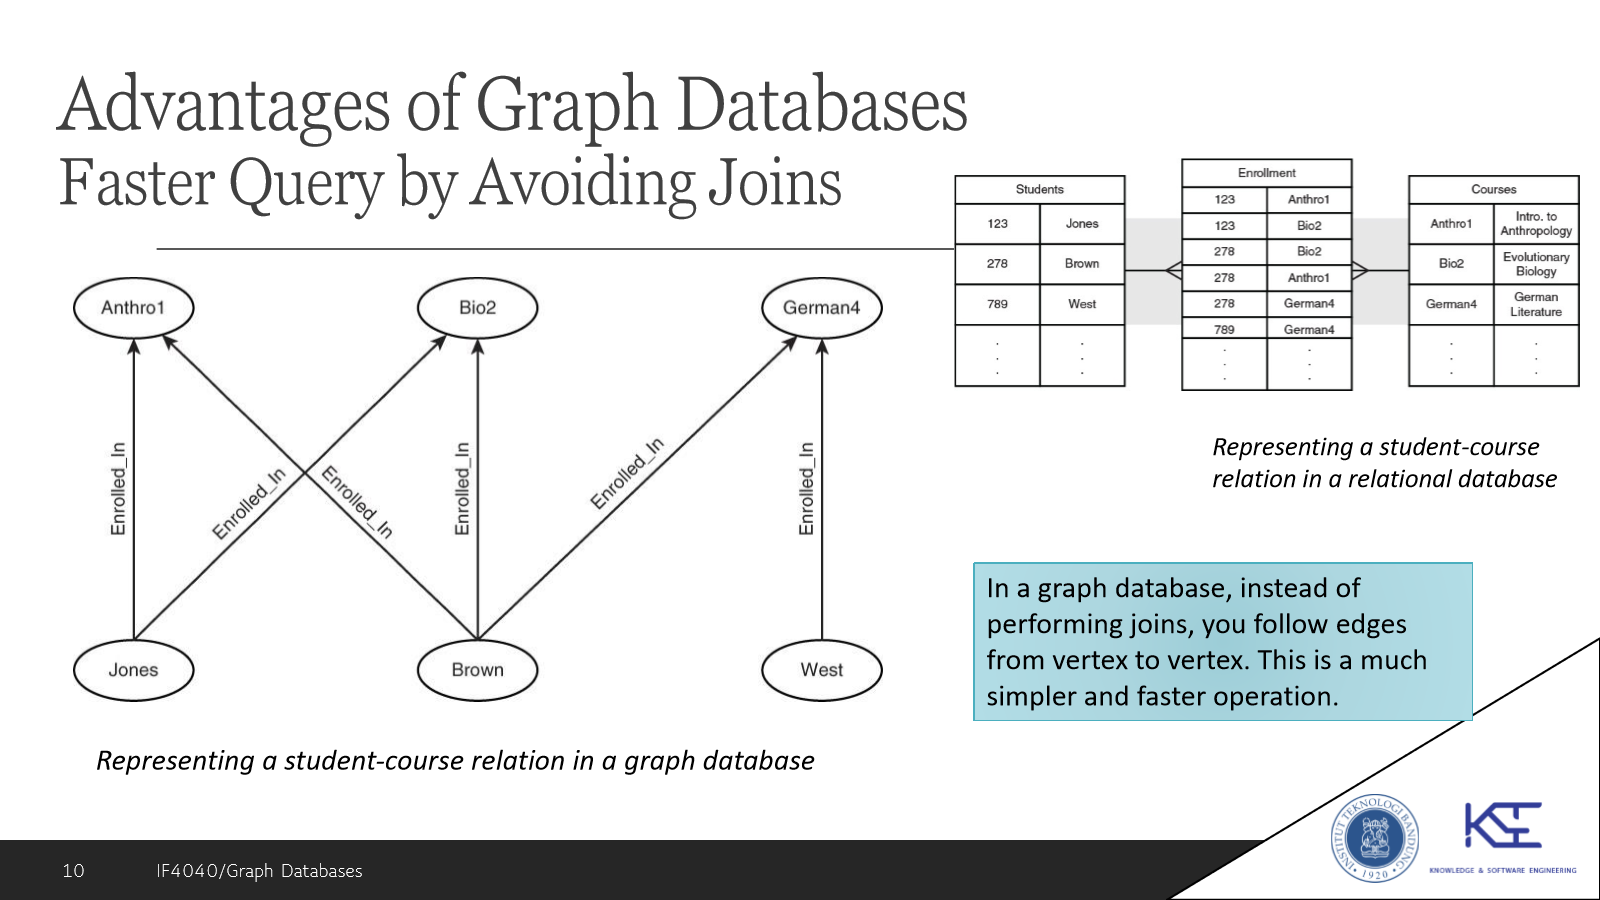
Pada relational database, relasi student-course butuh tiga tabel (Students, Enrollment, Courses) yang di-join. Pada graph database, alih-alih melakukan join, kita cukup mengikuti edge dari vertex ke vertex — operasi yang jauh lebih sederhana dan cepat.
Contoh lain: menemukan “Patient Zero” (sumber infeksi pertama) dari data relasional Course_of_Infection (kolom Patient, Infected By) memerlukan penelusuran berulang antar baris tabel — pada graph database, ini tinggal mengikuti edge infeksi mundur dari satu vertex ke vertex berikutnya.
Simplified Modeling
Memodelkan relasi many-to-many (mis. user-likes-post) pada relational database butuh tiga tabel terpisah (People, Likes, Posts) dengan foreign key silang. Pada graph database, relasi ini cukup direpresentasikan langsung sebagai edge “Likes” antara vertex User dan vertex Post — jauh lebih sederhana.
Multiple Relations Between Entities
Graph database dapat memodelkan beberapa jenis relasi sekaligus antara dua entitas yang sama — mis. antara Chicago dan New York bisa ada tiga edge berbeda (rail, air, road) yang masing-masing punya properti sendiri (speed, regulation).
Graph Database Terminologies
Elements of Graphs
- Vertex — merepresentasikan entitas dengan identifier unik (analog row key pada column family database atau primary key pada relational database). Bisa punya properti (mis. Person: nama, alamat, tanggal lahir; Cities: populasi, longitude/latitude, nama).
- Edge (juga disebut link atau arc) — mendefinisikan relasi antar vertex, dan juga bisa punya properti (mis. pada highway database: jarak, batas kecepatan, jumlah lajur; pada family tree: menandai apakah dua orang berelasi lewat pernikahan, adopsi, atau biologis).
- Weight — merepresentasikan nilai tertentu tentang relasi (biaya, jarak, atau ukuran relasi lain).
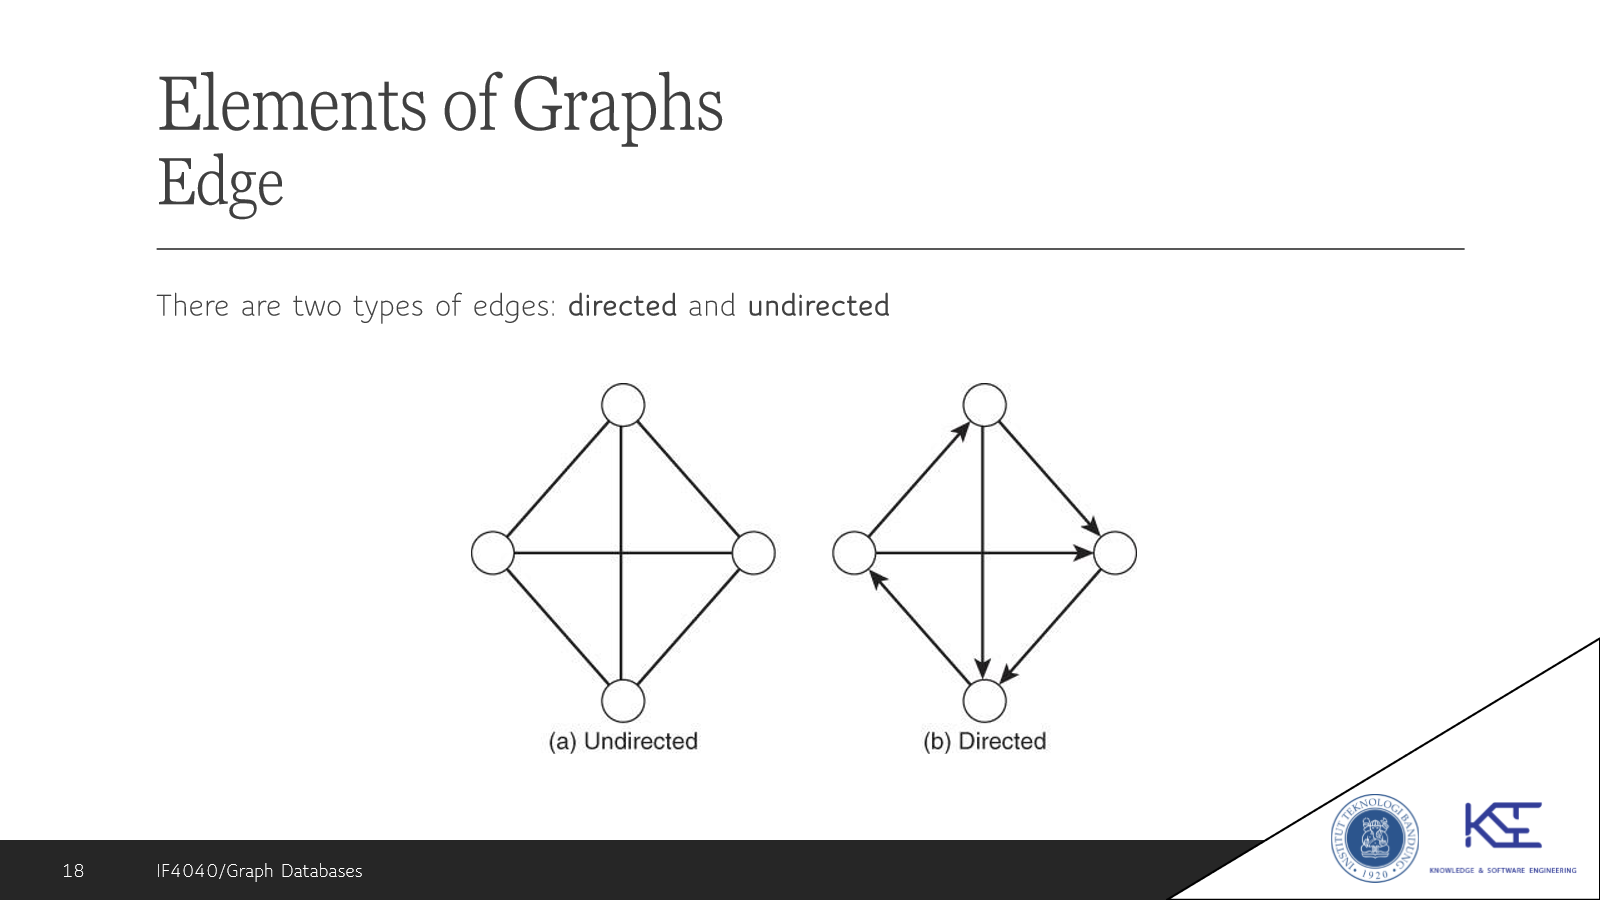
- Edge terbagi menjadi dua tipe: directed dan undirected.
- Path — sekumpulan vertex beserta edge di antaranya yang dilalui dari satu vertex ke vertex lain; penting karena menangkap informasi tentang bagaimana vertex-vertex dalam graph saling berelasi.
- Loop — edge yang menghubungkan sebuah vertex ke dirinya sendiri.
Operations on Graphs
Selain operasi basis data umum (insert, read, update, delete), ada tiga operasi penting yang khas graph:
- Union of graphs — gabungan (union) dari himpunan vertex dan edge dua graph.
- Intersection of graphs — himpunan vertex dan edge yang sama-sama dimiliki kedua graph.
- Graph traversal — proses mengunjungi seluruh vertex dalam graph dengan cara tertentu.
Properties of Graphs
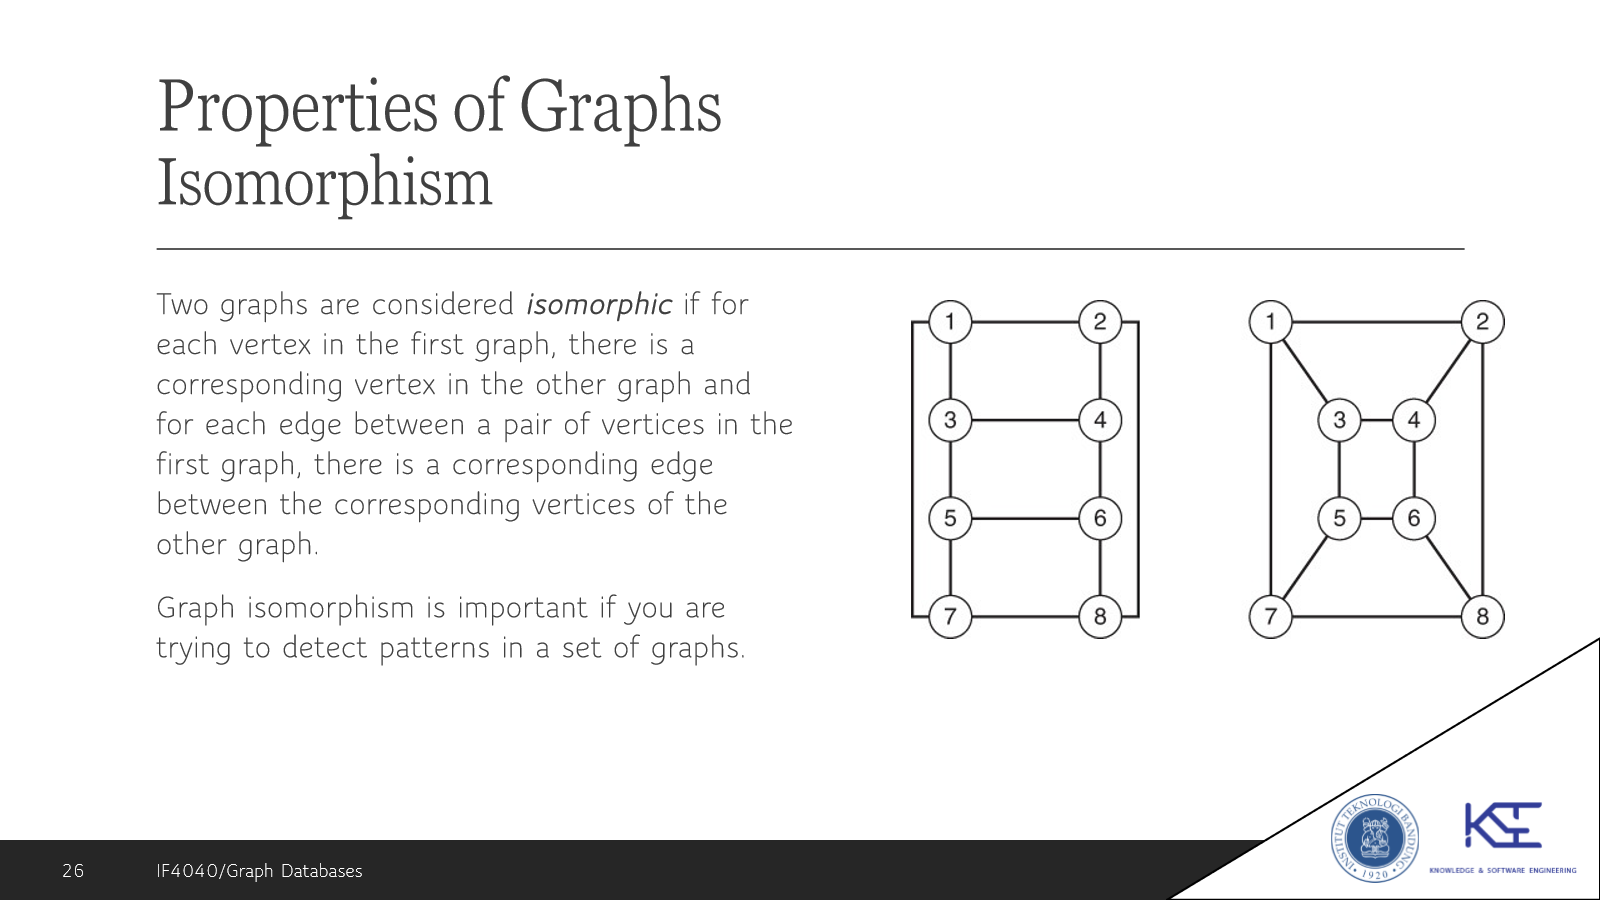
- Isomorphism — dua graph dianggap isomorphic jika setiap vertex di graph pertama punya vertex yang berkorespondensi di graph kedua, dan setiap edge antar sepasang vertex di graph pertama punya edge yang berkorespondensi di graph kedua. Penting untuk mendeteksi pola dalam sekumpulan graph.
- Order and Size — order adalah jumlah vertex, size adalah jumlah edge dalam suatu graph. Keduanya memengaruhi waktu dan ruang yang dibutuhkan untuk melakukan operasi pada graph tersebut.
- Degree — jumlah edge yang terhubung ke suatu vertex; salah satu cara mengukur pentingnya suatu vertex dalam graph, penting saat menangani masalah penyebaran informasi/properti lewat jaringan.
- Closeness — properti vertex yang menunjukkan seberapa jauh vertex tersebut dari semua vertex lain dalam graph; penting untuk memahami penyebaran informasi di jejaring sosial, penyakit menular di suatu komunitas, atau pergerakan material di jaringan distribusi. Vertex dengan closeness tinggi bisa menjangkau vertex lain lebih cepat.
- Betweenness — ukuran seberapa besar suatu vertex menjadi bottleneck (titik penyempitan); membantu mengidentifikasi bagian jaringan yang rentan.
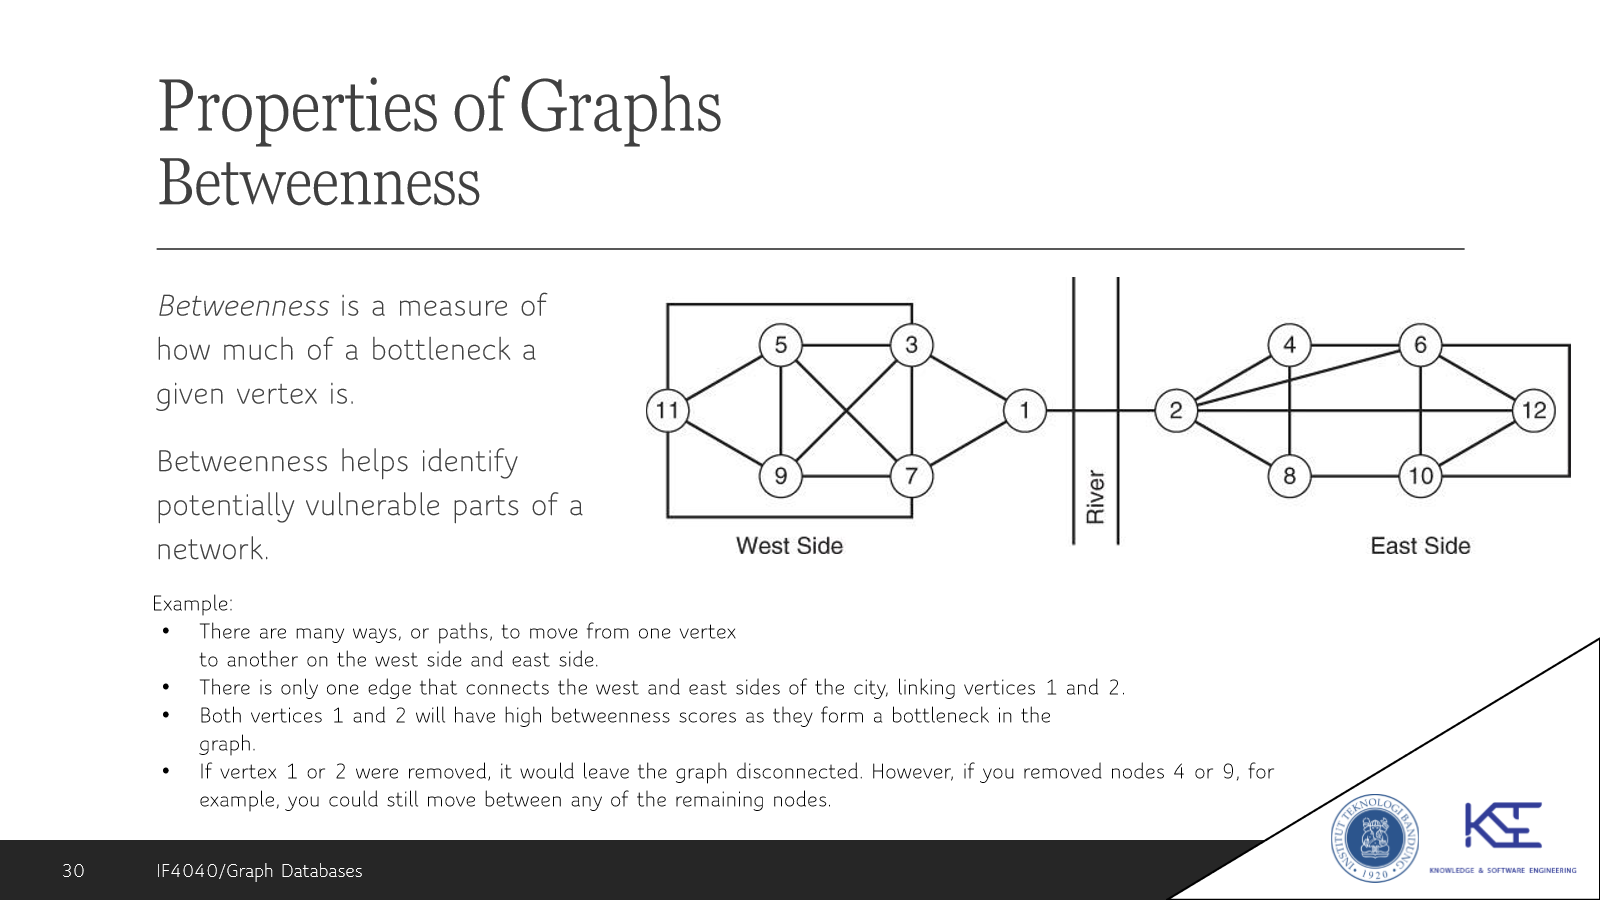
Pada contoh di atas: banyak jalur di sisi barat (west side) dan sisi timur (east side) kota, tapi hanya ada satu edge yang menghubungkan kedua sisi (menyambungkan vertex 1 dan 2). Vertex 1 dan 2 punya skor betweenness tinggi karena membentuk bottleneck — jika salah satu dihapus, graph akan terputus. Sebaliknya, menghapus vertex 4 atau 9 tidak memutus koneksi antar vertex yang tersisa.
Centrality adalah istilah payung untuk properti-properti di atas (degree, closeness, betweenness, dst) — semuanya adalah cara berbeda untuk mengukur seberapa “penting”/sentral suatu vertex dalam graph, dengan definisi “penting” yang berbeda-beda: degree centrality (seberapa banyak koneksi langsung), closeness centrality (seberapa dekat ke semua vertex lain), betweenness centrality (seberapa besar peran vertex sebagai penghubung/bottleneck). Materi tidak mendefinisikan “centrality” sebagai satu rumus tunggal — istilah ini dipakai sebagai kategori umum saat merujuk ke properti-properti tersebut (lihat juga penyebutannya di bagian “Queries Drive Design” di bawah).
Types of Graphs
- Undirected & Directed Graphs — undirected graph dipakai untuk memodelkan relasi/aliran yang tidak memerlukan arah; directed graph (edge berarah) cocok untuk relasi seperti parent-child.
- Flow Networks (disebut juga transportation networks) — directed graph di mana tiap edge punya kapasitas dan tiap vertex punya sekumpulan edge masuk & keluar. Jumlah kapasitas edge masuk tidak boleh lebih besar dari jumlah kapasitas edge keluar — kecuali pada vertex source (titik awal aliran, hanya punya edge keluar, tanpa edge masuk) dan sink (titik akhir aliran, hanya punya edge masuk, tanpa edge keluar).
- Bipartite Graphs (bigraph) — graph dengan dua himpunan vertex yang berbeda, di mana tiap vertex di satu himpunan hanya terhubung ke vertex di himpunan lainnya. Berguna untuk memodelkan relasi antara dua jenis objek berbeda (mis. people-likes-posts).
- Multigraphs — graph dengan beberapa edge di antara sepasang vertex yang sama (mis. beberapa opsi pengiriman: truk, kereta, pesawat antara dua kota).
- Weighted Graphs — graph di mana tiap edge diberi angka (merepresentasikan biaya, kapasitas, atau ukuran lain); umum dipakai pada masalah optimasi seperti mencari jalur terpendek. Dijkstra’s algorithm dipakai mencari jalur terpendek dalam suatu network, dengan growth rate sebanding jumlah vertex kuadrat:
| Number of Vertices | Time Units to Complete |
|---|---|
| 1 | 1 |
| 5 | 25 |
| 10 | 100 |
| 20 | 400 |
| 50 | 2.500 |
| 100 | 10.000 |
| 1.000 | 1.000.000 |
Designing for Graph Database
Getting Started
Graph database cocok untuk domain masalah yang mudah dideskripsikan dalam bentuk entitas dan relasi antar entitas tersebut (entitas bisa berupa apa saja, dari protein sampai planet). Aplikasi graph database umumnya melibatkan query/analisis:
- Mengidentifikasi relasi antara dua entitas
- Mengidentifikasi properti umum dari edge-edge suatu node
- Menghitung nilai agregat properti edge dari suatu node
- Menghitung nilai agregat properti dari node-node
Contoh kasus: situs jejaring sosial untuk developer NoSQL, yang memungkinkan developer join/leave situs, follow posting developer lain, post pertanyaan, mendapat saran koneksi baru berdasarkan minat yang sama, dan pemeringkatan anggota berdasarkan jumlah koneksi/post/jawaban. Model dimulai sederhana dengan dua entitas: Developer (properti: nama, lokasi, NoSQL database yang dipakai, tahun pengalaman, area minat) dan Post (properti: tanggal dibuat, keyword topik, tipe post, judul, isi).
Ada empat kombinasi entity-relation-entity yang mungkin: developer-relation-developer, developer-relation-post, post-relation-developer, post-relation-post.
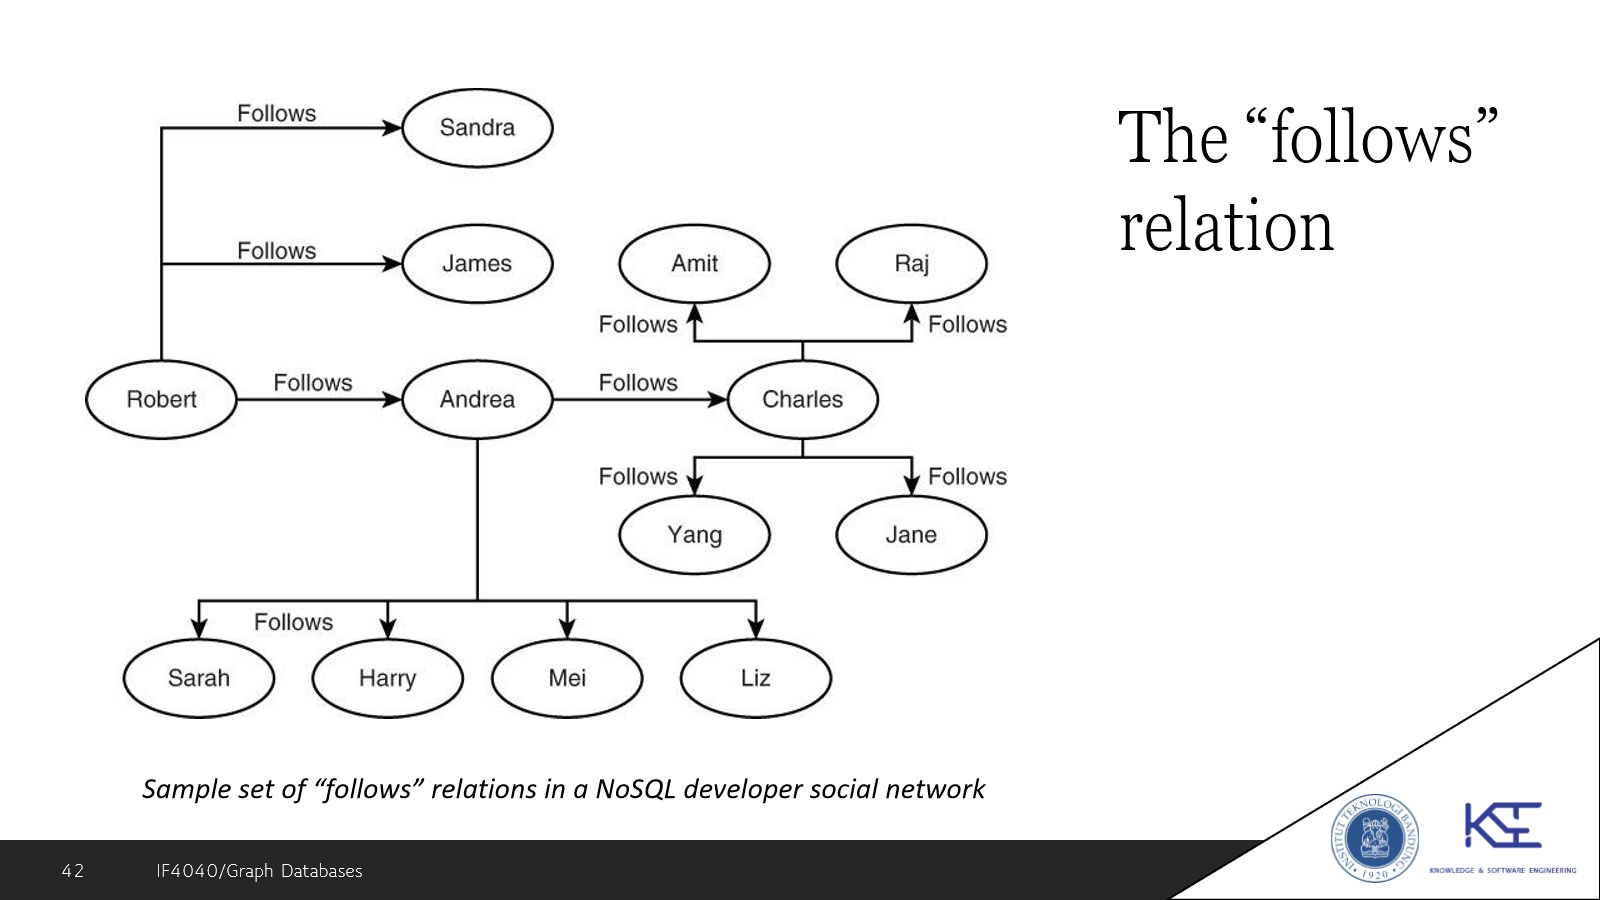
Untuk relasi seperti “created” dan “created by” (antara Developer dan Post) yang saling berimplikasi satu sama lain, kita bisa menghindari dua directed edge terpisah dan cukup memakai satu edge (bisa undirected).
Queries Drive Design (Again): tidak ada satu cara yang benar untuk memodelkan graph database untuk semua kemungkinan masalah. Saat mendesain, kita mulai dari domain-specific query, lalu memetakannya ke graph-specific query yang mereferensikan vertex, edge, dan graph measure (seperti centrality dan betweenness). Contoh pemetaan: “berapa banyak developer yang follow Andrea Wilson?” (domain-specific) ↔ “berapa banyak incoming edge yang menuju vertex A?” (graph-centric).
Langkah dasar mendesain graph database:
- Identifikasi query yang ingin dilakukan.
- Identifikasi entitas dalam graph.
- Identifikasi relasi antar entitas.
- Petakan domain-specific query ke query yang lebih abstrak, sehingga bisa diimplementasikan sebagai graph query dan memakai algoritma graph untuk menghitung properti tambahan pada node.
Querying a Graph
Cypher (dipakai pada Neo4j) — bahasa query deklaratif mirip SQL:
CREATE (robert:Developer { name: 'Robert Smith' })
CREATE (andrea:Developer { name: 'Andrea Wilson' })
CREATE (charles:Developer { name: 'Charles Vita' })

CREATE (robert)-[FOLLOWS]->(andrea)
CREATE (andrea)-[FOLLOWS]->(charles)

MATCH (developer:DEVELOPER)
RETURN (developer)

MATCH (robert:Developer {name:'Robert Smith'})--(developer:DEVELOPER)
RETURN developers
Cypher juga mendukung klausa yang sama dengan SQL: WHERE, ORDER BY, LIMIT, UNION, COUNT, DISTINCT, SUM, AVG — karena Cypher bersifat deklaratif, kita cukup menyebutkan kriteria seleksi vertex dan edge, bukan langkah proseduralnya.
Gremlin (https://tinkerpop.apache.org/) — bahasa traversal dari Apache TinkerPop, sebuah framework open-source untuk graph computing yang dipakai berbagai graph database. Gremlin memakai pendekatan traversal: menelusuri seluruh graph, dan setiap vertex yang dikunjungi diuji apakah memenuhi kriteria pencarian. Beberapa istilah penting:
outE/inE/bothE— edge berarah keluar / masuk / keduanya dari suatu vertexoutV/inV/bothV— vertex keluar / masuk / keduanya dari suatu edge
Contoh: v = G.v(1) lalu v.outE menghasilkan daftar edge keluar dari vertex 1. Gremlin mendukung traversal depth-first search maupun breadth-first search.
Tips and Traps of Graph Database Design
- Use indexes to improve retrieval time — mis. Neo4j menyediakan perintah
CREATE INDEX; query processor Cypher otomatis memakai index (bila tersedia) untuk mempercepat operasiWHEREdanIN. - Use appropriate types of edges — undirected edge untuk relasi simetris, directed edge untuk relasi tidak simetris. Edge sederhana tanpa properti butuh sedikit storage; edge dengan banyak properti atau value besar (mis. BLOB/Binary Large Object, seperti file gambar atau dokumen biner) bisa butuh storage signifikan.
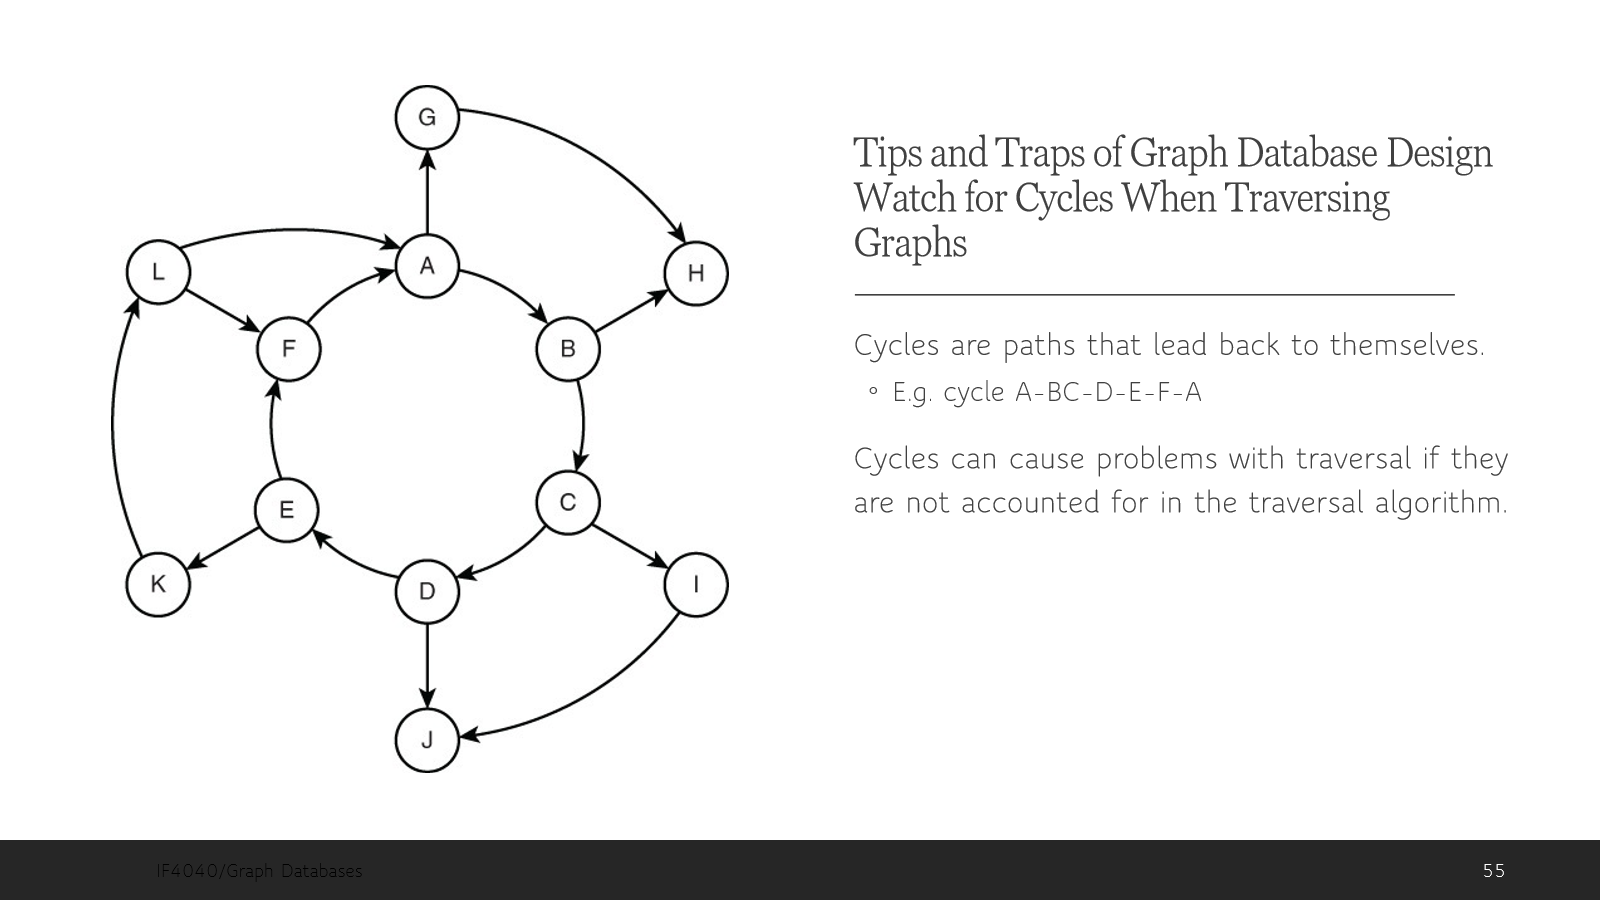
- Watch for cycles when traversing graphs — cycle adalah path yang kembali ke titik awalnya sendiri (mis. A-B-C-D-E-F-A). Cycle bisa menyebabkan masalah pada traversal jika tidak diantisipasi oleh algoritma traversal-nya.
- Consider the scalability of your graph database — sistem graph database masa kini bisa menangani jutaan vertex & edge dengan satu server. Perlu dipertimbangkan bagaimana aplikasi & tools analisis akan scale seiring bertambahnya jumlah node/edge, jumlah user, serta jumlah & ukuran properti. Jika satu server sudah tidak cukup (perlu scale vertically, yaitu mengganti dengan server yang lebih besar/kuat), pertimbangkan basis data yang bisa scale horizontally (menambah jumlah server, bukan memperbesar satu server) — mis. Titan, graph database yang didesain untuk didistribusikan ke banyak server. Pertimbangkan juga algoritma yang dipakai untuk menganalisis data dalam graph.
Case Study: Optimizing Transportation Routes
Konteks: klien TGTS (TransGlobal Transport and Shipping, fiktif) mengirim parsel dari manufacturing site → distribution center → customer site, dan mencurigai metode pengirimannya belum optimal. Klien memakai dua metode:
- Non-rush: manufacturing site → hub airport terdekat (drive) → distribution center terdekat dari tujuan (fly) → customer (drive). Lebih murah.
- Rush: manufacturing site → regional airport terdekat (drive) → regional airport terdekat customer (fly). Lebih mahal, dipakai hanya untuk memenuhi batasan waktu.
Desain solusi analisis graph: analis menyadari klien hanya memakai sebagian kecil dari semua rute yang mungkin. Mereka memakai Dijkstra’s algorithm pada data graph database untuk mencari jalur berbiaya-terendah (least-cost path) antar semua lokasi — namun ini belum mengakomodasi batasan waktu pengiriman.
Solusinya: edge diberi dua properti — cost (biaya pengiriman) dan time (rata-rata waktu pengiriman, sebagian dari data historis, sebagian diestimasi dari fasilitas serupa). Analis lalu mengembangkan algoritma sendiri untuk mencari least-cost path yang tetap memenuhi batasan waktu:
- Algoritma menerima input: fasilitas awal, fasilitas akhir, dan waktu yang tersedia untuk pengiriman.
- Saat menelusuri tiap fasilitas (vertex), algoritma mencatat akumulasi cost & time. Jika akumulasi waktu melebihi batas yang tersedia, jalur tersebut dibuang.
- Sisa jalur disimpan dalam daftar terurut berdasarkan cost — jalur pertama adalah least-cost path sejauh ini. Algoritma melanjutkan dari jalur tersebut, mencari fasilitas-fasilitas yang terhubung ke fasilitas terakhir dalam jalur itu.
- Jika salah satu fasilitas tersebut adalah tujuan akhir, algoritma berhenti dan mengeluarkan least-cost path dengan waktu pengiriman yang masih dalam batas. Jika belum, algoritma melanjutkan pencarian dari fasilitas terakhir di least-cost path saat ini.
Pelajaran: algoritma yang sudah mapan (seperti Dijkstra) bisa jadi fondasi untuk masalah analisis graph, tapi kadang perlu sedikit variasi pada algoritma tersebut untuk mengakomodasi kebutuhan spesifik masalah yang sedang dihadapi.
Sumber
- D. Sullivan: NoSQL for Mere Mortals, Addison-Wesley, 2015, Chapter 12–14 (Graph Databases).
Flashcard
flashcards Apa dua komponen dasar penyusun sebuah graph, dan apa yang direpresentasikan masing-masing? :: Vertex (merepresentasikan entitas, mis. kota, orang, protein) dan edge (merepresentasikan relasi/koneksi antar entitas, mis. jalan raya, interaksi, hubungan kerja). Mengapa relasi hierarkis dimodelkan sebagai “tree”, dan apa ciri khas vertex pada tree? :: Karena tree adalah tipe graph khusus yang menangkap relasi berjenjang (part-of/parent-child); tree punya vertex khusus bernama root sebagai titik awal hierarki. Apa yang dimaksud bipartite graph, dan berikan contohnya :: Graph dengan dua himpunan vertex berbeda, di mana vertex di satu himpunan hanya terhubung ke vertex di himpunan lainnya (tidak ada edge dalam himpunan yang sama) — contoh: graph people-likes-posts pada media sosial. Apa keunggulan utama graph database dibanding relational database untuk query relasi? :: Alih-alih melakukan join antar beberapa tabel, graph database cukup mengikuti edge dari vertex ke vertex — operasi yang jauh lebih sederhana dan cepat (mis. mencari Patient Zero pada rantai infeksi). Sebutkan tiga operasi yang khas pada graph (di luar insert/read/update/delete standar basis data) :: Union of graphs (gabungan vertex & edge dua graph), intersection of graphs (vertex & edge yang sama-sama dimiliki dua graph), dan graph traversal (proses mengunjungi seluruh vertex dengan cara tertentu). Apa itu graph isomorphism, dan mengapa penting? :: Dua graph dianggap isomorphic jika tiap vertex dan edge di satu graph punya korespondensi persis di graph lainnya; penting untuk mendeteksi pola dalam sekumpulan graph meski secara visual kedua graph terlihat berbeda. Apa perbedaan antara degree, closeness, dan betweenness sebagai properti graph? :: Degree = jumlah edge yang terhubung ke suatu vertex (ukuran kepentingan vertex); closeness = seberapa dekat suatu vertex ke semua vertex lain (relevan untuk penyebaran informasi/penyakit); betweenness = seberapa besar suatu vertex menjadi bottleneck/titik penyempitan jaringan. Apa itu “centrality” dalam konteks graph, dan apa hubungannya dengan degree/closeness/betweenness? :: Centrality adalah istilah payung untuk mengukur seberapa penting/sentral suatu vertex dalam graph; degree, closeness, dan betweenness masing-masing adalah JENIS centrality yang berbeda (degree centrality, closeness centrality, betweenness centrality) — bukan konsep terpisah dari ketiganya. Bagaimana betweenness membantu mengidentifikasi kerentanan jaringan? Berikan contoh dari materi :: Vertex dengan betweenness tinggi adalah bottleneck — jika dihapus, graph terputus. Contoh: dua vertex yang menjadi satu-satunya penghubung sisi barat dan timur kota (dipisahkan sungai) akan punya betweenness tinggi, sedangkan menghapus vertex lain di masing-masing sisi tidak memutus koneksi. Apa itu flow network, dan aturan apa yang berlaku pada kapasitas edge-nya? :: Directed graph di mana tiap edge punya kapasitas dan tiap vertex punya edge masuk & keluar; jumlah kapasitas edge masuk tidak boleh melebihi jumlah kapasitas edge keluar, kecuali pada vertex source (hanya punya edge keluar) dan sink (hanya punya edge masuk). Disebut juga transportation network. Sebutkan empat langkah dasar mendesain graph database :: (1) Identifikasi query yang ingin dilakukan, (2) identifikasi entitas dalam graph, (3) identifikasi relasi antar entitas, (4) petakan domain-specific query ke query graph yang lebih abstrak (vertex/edge/graph measure). Apa perbedaan pendekatan Cypher dan Gremlin dalam melakukan query pada graph database? :: Cypher bersifat deklaratif (mirip SQL, cukup sebutkan kriteria seleksi vertex/edge, dipakai pada Neo4j) sedangkan Gremlin berbasis traversal (menelusuri graph dan menguji tiap vertex yang dikunjungi terhadap kriteria pencarian, mendukung depth-first maupun breadth-first search). Kenapa satu relasi “created”/“created by” antara Developer dan Post cukup dimodelkan dengan satu edge, bukan dua edge berarah? :: Karena kedua relasi tersebut saling berimplikasi satu sama lain (jika Developer created Post, otomatis Post created-by Developer itu) — memakai satu edge (bisa undirected) menghindari redundansi. Sebutkan tiga tips/trap penting dalam mendesain graph database menurut materi :: Gunakan index untuk mempercepat retrieval (mis. CREATE INDEX di Neo4j), gunakan tipe edge yang sesuai (directed untuk relasi tidak simetris, undirected untuk yang simetris), dan waspadai cycle saat traversal karena bisa menyebabkan masalah jika tidak diantisipasi algoritma. Pada studi kasus TGTS, mengapa least-cost path dari Dijkstra saja tidak cukup, dan bagaimana solusinya? :: Karena least-cost path murni belum tentu memenuhi batasan waktu pengiriman; solusinya, edge diberi properti cost DAN time, lalu dipakai algoritma custom yang membuang jalur yang akumulasi waktunya melebihi batas, dan memilih jalur berbiaya terendah dari sisa jalur yang masih valid.