Dari DevOps ke MLOps: Recap Singkat
- Prinsip DevOps: CI/CD, automation, IaC, observability.
- Pertanyaan kunci: apa yang berubah ketika artifact yang dikelola adalah model, bukan code?
- Software konvensional: code-driven, perilakunya deterministic.
- ML: data + code + model + environment, perilakunya probabilistic.
- Karena perbedaan sifat ini, dibutuhkan praktik khusus: MLOps.
Overview End-to-End ML Lifecycle
Alur lengkap: Business Problem → Data Collection → Data Processing → Feature Engineering → Training → Evaluation → Model Selection → Deployment → Monitoring → Feedback & Retraining (siklus berlanjut).
- Ini berbeda dari alur kerja “one-shot” ala kompetisi Kaggle (yang berhenti setelah model terbaik ditemukan, tanpa perlu dioperasikan di dunia nyata).
- MLOps = orkestrasi + otomasi + governance di sepanjang lifecycle ini.
CRISP: Data Mining vs Machine Learning Lifecycle
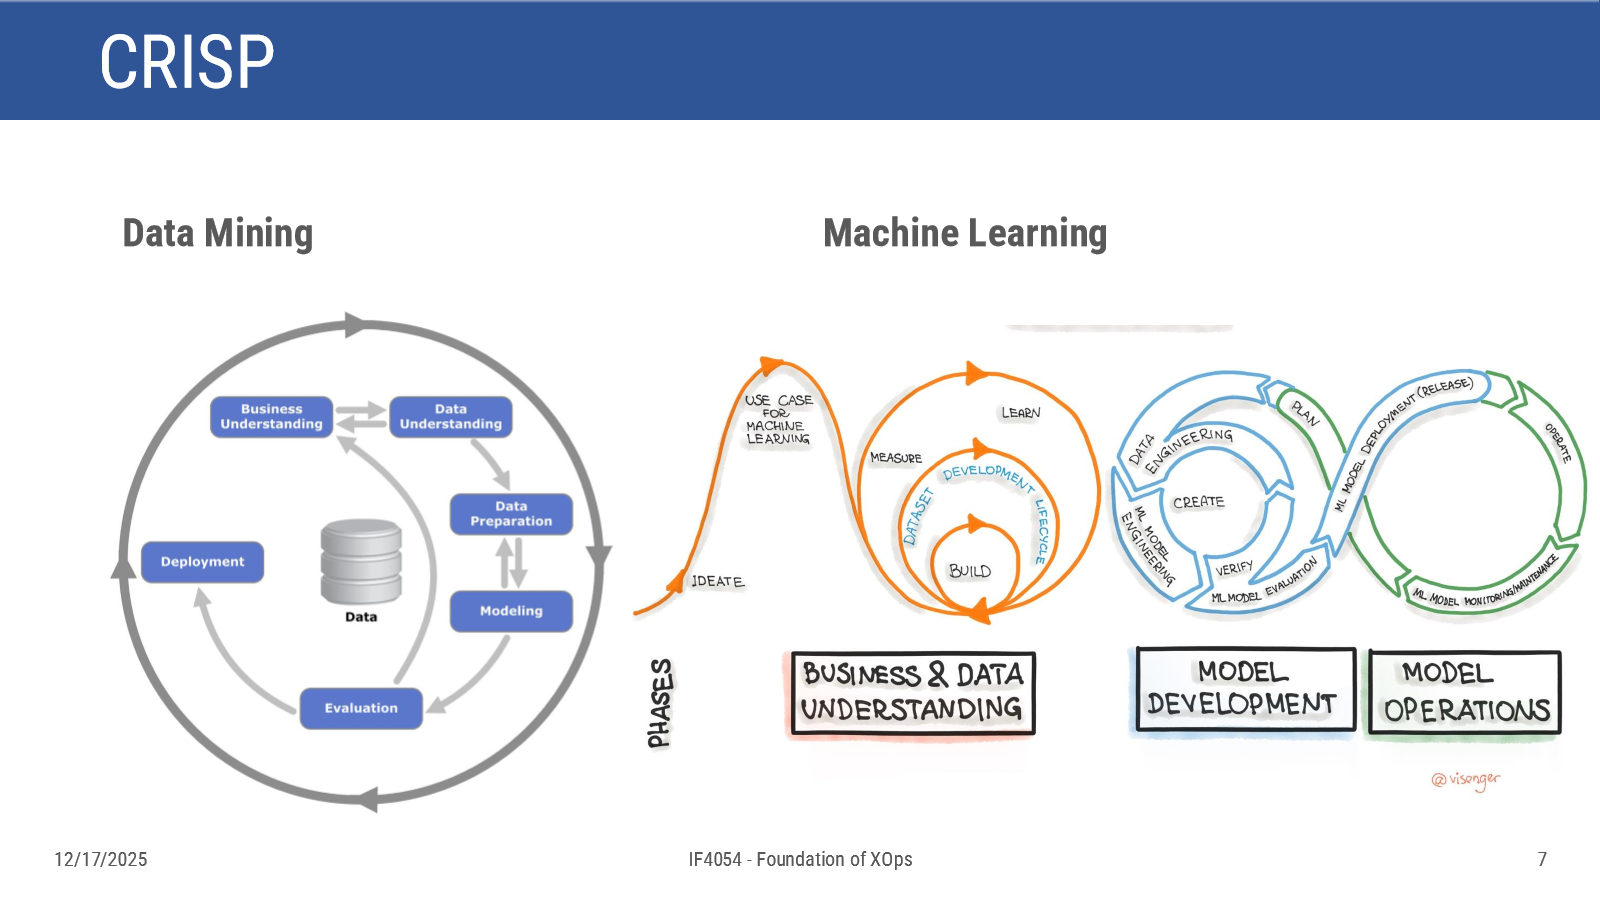
Perbandingan siklus CRISP-DM (Data Mining) klasik dengan siklus ML modern:
- Data Mining (CRISP-DM): Business Understanding ↔ Data Understanding → Data Preparation ↔ Modeling → Evaluation → Deployment (kembali ke Business Understanding), mengelilingi Data di tengah.
- Machine Learning: dimulai dari Ideate → Use Case for Machine Learning (fase Business & Data Understanding), lalu masuk loop Dataset ↔ Development Lifecycle ↔ Build (fase Model Development: Data Engineering, ML Engineering, Create, Verify, ML Model Evaluation, Plan), lalu ke loop ML Model Deployment (Release) ↔ ML Model Monitoring/Maintenance ↔ Operate (fase Model Operations).
Problem Framing & Data Understanding
- Problem framing yang benar: classification vs. ranking vs. forecasting — jenis masalah menentukan pendekatan teknis yang sesuai.
- Data understanding: sumber data, strategi sampling, strategi labeling.
- Problem framing yang buruk merusak seluruh pipeline, meskipun tooling-nya sempurna.
- Contoh: memprediksi churn (klasifikasi biner) itu berbeda dari memprediksi next-best-action (ranking/rekomendasi) — pendekatan model dan metrik evaluasinya pun berbeda.
Data Pipelines dalam ML Lifecycle
- Pipeline ETL/ELT dipakai baik untuk training maupun inference.
- Batch vs. streaming pipeline untuk ML.
- Requirement: training data snapshot yang reproducible.
- Dataset yang versioned dan diselaraskan dengan versi model.
- Training-serving skew: perbedaan antara feature generation secara offline (saat training) vs. real-time (saat serving) — jika logikanya tidak konsisten, model bisa berperforma buruk di produksi meski bagus saat training.
Data Collection
Data Collection: mengumpulkan, memperoleh, dan menyiapkan dataset untuk training, validasi, dan testing. Key steps:
- Identify Data Sources
- Data Relevance and Quality
- Data Access and Permissions
- Data Collection Methods
- Data Volume and Diversity
- Data Storage and Organization
Data Preparation
Data Preparation: membersihkan, memproses, dan mentransformasi data mentah menjadi format yang sesuai untuk training model ML. Key steps:
- Data Analysis and Cleaning
- Data Transformation
- Feature Scaling and Normalization
- Handling Imbalanced Data
- Feature Engineering
- Data Splitting and Formatting
- Handling Text and Unstructured Data
- Data Quality Checks and Validation
Feature Engineering & Feature Store
- Feature vs. raw data: feature adalah nilai yang sudah ditransformasi, diagregasi, atau diturunkan (derived) dari data mentah.
- Masalah umum: logika feature harus diimplementasikan ulang di notebook, kode training, dan microservice serving — rawan inkonsistensi.
- Feature store: registry sentral untuk feature.
- Menyediakan offline view (batch) dan online view (low-latency).
- Mendukung versioning dan reuse feature lintas model.
- Contoh: feature
user_7_day_txn_countdipakai oleh banyak model sekaligus, cukup dihitung dan disimpan sekali di feature store.
Modeling: Experimentation & Reproducibility
- Yang perlu dilacak (track): versi kode (Git commit), versi data (dataset ID), hyperparameter, metrik, dan artifact.
- Tools experiment tracking: MLflow, Weights & Biases.
- Pertanyaan reproducibility: model mana yang sedang di produksi dan bagaimana cara melatihnya? Bisakah kita melatih ulang model terbaik tahun lalu secara persis sama?
Model Building
Model Building: menggunakan algoritma untuk membuat model prediktif atau deskriptif dari dataset yang sudah disiapkan. Key steps:
- Algorithm Selection
- Model Training
- Hyperparameter Tuning
- Cross-Validation
- Ensemble Methods
- Model Interpretability and Explainability
Training Pipelines & Automation
- Perjalanan dari notebook manual menuju training yang scripted, terjadwal (scheduled), dan containerized.
- Komponen: data loading → feature computation → training → evaluation → model packaging → registration.
- Orchestrators: Airflow, Kubeflow, Argo.
- Scheduled retraining (terjadwal berkala) vs. event-driven retraining (dipicu oleh event tertentu, misalnya penurunan performa).
Model Evaluation & Validation
- Metrik standar: accuracy, precision/recall, ROC-AUC, RMSE.
- Validasi khusus ML: data leakage, temporal split, cross-validation.
- Business dan fairness constraint: metrik model bisa saja bagus secara statistik, tapi gagal memenuhi constraint bisnis (contoh: fairness dalam credit scoring).
- Guardrails/acceptance test perlu dilakukan sebelum deployment.
Detail Model Evaluation (Key Steps Tambahan)
- Performance Metrics Selection:
- Classification: Confusion Matrix, ROC, Precision-Recall Curves.
- Regression: MAE, MSE, RMSE, dll.
- Clustering: Silhouette Score, Davies-Bouldin index.
- Cross-Validation
- Overfitting and Underfitting Analysis
- Benchmark and Comparison
- Interpreting Result and Adjustment
- Handling Imbalanced Data or Specific Challenges
Model Deployment
Model dimasukkan ke produksi untuk membuat prediksi/menyediakan insight terhadap data baru yang belum pernah dilihat. Key steps:
- Environment Setup (server/cloud infra/containerization)
- Integration with Application or System (API/microservices)
- Scalability and Optimization
- Security and Authentication
- Testing in Production
- Rollout Strategy
Model Monitoring and Maintenance
Model yang sudah di-deploy akan berada di bawah pengawasan, evaluasi, dan pemeliharaan berkelanjutan:
- Real-time Monitoring and Alerting
- Data Drift and Model Drift Detection
- Performance Metrics Tracking
- Retraining and Updates
- Re-evaluation and Validation
- Version Control and Rollback
- Feedback Loop Integration
Tantangan MLOps di Produksi
- Data drift vs. concept drift — keduanya bisa menyebabkan penurunan performa namun dengan penyebab berbeda: data drift adalah perubahan distribusi input, concept drift adalah perubahan relasi antara input dan output yang ingin diprediksi.
- Feedback loop — model bisa mempengaruhi data yang nantinya dipakai untuk melatihnya kembali (misalnya rekomendasi model membentuk perilaku user, yang kemudian jadi data training berikutnya).
- Dependency complexity — feature pipeline, layanan eksternal, registry, semuanya saling bergantung dan menambah kompleksitas.
- Governance — auditability, compliance (GDPR, explainability).
- Masalah-masalah inilah yang memotivasi lahirnya praktik dan tools MLOps.
MLOps Tools: dari Teori ke Praktik
Core Principles
- Automation & Operationalization — otomasi bertahap (progressive automation).
- Version Control & Reproducibility — untuk kode, data, dan model.
- CI/CD for ML — update dan redeployment yang sering.
- Monitoring & Observability — memantau drift dan kualitas data.
- Collaboration & Governance — kolaborasi lintas fungsi, responsible AI.
- Infrastructure Automation — scalable, minim intervensi manual.
Core Practices
- Model Registry — penyimpanan terpusat untuk model terlatih, memungkinkan versioning dan deployment terkontrol.
- Feature Store — repositori feature yang bisa dipakai ulang, menjamin konsistensi antara training dan serving.
- Metadata Store — melacak konfigurasi, dataset, dan metrik untuk reproducibility dan lineage.
- Pipeline Orchestrator — mengotomasi workflow ML, mengelola dependency, scheduling, dan eksekusi.
MLOps Tooling Landscape (Kategori)
- Data & feature management: DVC, Feature Stores.
- Experiment tracking: MLflow, Weights & Biases.
- Orchestration & pipelines: Airflow, Kubeflow, Argo.
- Model registry: versioning, staging, production.
- Serving/Deployment: containerization, API.
- Monitoring & alerting: kualitas data, performa model.
Data & Experiment Management Tools
- Data versioning: DVC, Lakehouse (Delta, Apache Iceberg).
- Experiment tracking: mencatat metrik, artifact, plot, konfigurasi.
- Alur tipikal: run → log → compare → choose best.
- Perbandingan eksperimen: biasanya ditampilkan dalam format tabel berisi ID, parameter, dan metrik.
Orchestration & Pipelines
- Contoh batch workflow: ingest data harian → feature computation → training → evaluation → conditional register (register model hanya jika lolos syarat tertentu).
- DAG (Directed Acyclic Graph) dipakai untuk merepresentasikan workflow.
- Airflow: orkestrasi general-purpose.
- Kubeflow/Argo: Kubernetes-native, container-first, fokus ML.
- Pipeline memberikan repeatability dan visibility.
Model Registry Concepts
- Tempat sentral menyimpan versi model beserta metadatanya.
- Stages: Staging, Production, Archived.
- Metadata yang disimpan: referensi data training, git hash, metrik, pemilik (owner).
- Manfaat: rollback, approval, audit trail.
- Prinsip penting: deployment harus selalu menarik model dari registry, bukan dari artifact ad-hoc.
Deployment Patterns
| Pattern | Karakteristik | Use Case | Kelebihan | Keterbatasan |
|---|---|---|---|---|
| Batch Inference | Job dijalankan secara periodik untuk menghasilkan prediksi secara massal; arsitektur: read dari warehouse → run model → write predictions | Credit risk score, churn prediction, demand forecasting | Lebih sederhana, lebih mudah dimonitor, tidak ada batasan latency | Tidak cocok untuk personalisasi real-time |
| Online/Real-Time Inference | Microservice sinkron (REST/gRPC endpoint yang membungkus model); stack: containerized service di Kubernetes dengan autoscaling; bisa juga asinkron via message queue (Kafka/RabbitMQ) | Aplikasi yang butuh respons langsung | Real-time, responsif | Perlu perhatian pada latency, throughput, autoscaling; integrasi lebih kompleks (API gateway, auth, logging) |
CI/CD/CT untuk ML
- CI for ML: unit test untuk logika feature, pengecekan skema data.
- CD for ML: otomasi deployment layanan model.
- CT (Continuous Training): retraining otomatis saat ada data baru atau penurunan performa.
- Contoh alur: Git push → CI tests → training → register → tests → canary deploy.
Release Strategies untuk Model
- Blue-Green: mengalihkan traffic sepenuhnya ke versi baru setelah validasi.
- Canary: mengirim persentase kecil traffic ke model baru, membandingkan metriknya dengan model lama.
- A/B Testing: dua model berjalan paralel, dievaluasi berdasarkan KPI bisnis.
- Kriteria sukses: kombinasi metrik bisnis dan batasan risiko — bukan hanya metrik ML offline semata.
Flashcard
flashcards Apa perbedaan mendasar antara software konvensional dan sistem ML yang membuat MLOps diperlukan? :: Software konvensional bersifat code-driven dengan perilaku deterministic; sistem ML terdiri dari data + code + model + environment dengan perilaku probabilistic, sehingga butuh praktik khusus (MLOps) di luar DevOps biasa. Sebutkan urutan tahap dalam End-to-End ML Lifecycle. :: Business Problem → Data Collection → Data Processing → Feature Engineering → Training → Evaluation → Model Selection → Deployment → Monitoring → Feedback & Retraining (siklus berulang). Apa itu training-serving skew dan mengapa berbahaya? :: Perbedaan antara logika feature generation offline (saat training) vs real-time (saat serving); jika tidak konsisten, model bisa berperforma buruk di produksi meskipun bagus saat training karena feature yang dihitung berbeda. Apa fungsi Feature Store dalam MLOps? :: Registry sentral untuk feature yang menyediakan offline view (batch) dan online view (low-latency), mendukung versioning dan reuse feature lintas model, mengatasi masalah re-implementasi logika feature yang berulang di notebook/training/microservice. Jelaskan perbedaan antara Data Drift dan Concept Drift sebagai tantangan MLOps. :: Data drift adalah perubahan distribusi data input dari waktu ke waktu; concept drift adalah perubahan relasi/hubungan antara input dan output yang ingin diprediksi model — keduanya menurunkan performa model namun dengan penyebab berbeda. Sebutkan 4 Core Practices MLOps (Model Registry dst). :: Model Registry (penyimpanan terpusat model dengan versioning), Feature Store (repositori feature reusable), Metadata Store (melacak konfigurasi/dataset/metrik), Pipeline Orchestrator (mengotomasi workflow ML). Jelaskan perbedaan pola deployment Batch Inference dan Online/Real-Time Inference. :: Batch Inference menjalankan job periodik untuk prediksi massal (read warehouse → run model → write predictions), lebih sederhana tapi tidak cocok real-time; Online/Real-Time Inference berupa microservice sinkron (REST/gRPC) atau asinkron (message queue) yang perlu diperhatikan latency, throughput, dan autoscaling. Apa itu CI/CD/CT untuk ML dan apa yang membedakan CT dari CI/CD biasa? :: CI untuk ML mencakup unit test logika feature dan pengecekan skema data; CD mengotomasi deployment layanan model; CT (Continuous Training) adalah elemen khusus ML yaitu retraining otomatis saat ada data baru atau performa menurun, sesuatu yang tidak ada di CI/CD software biasa. Sebutkan 3 strategi rilis (release strategies) untuk model ML. :: Blue-Green (switch traffic penuh setelah validasi), Canary (kirim persentase kecil traffic ke model baru untuk dibandingkan), A/B Testing (dua model berjalan paralel dievaluasi berdasarkan KPI bisnis) — dengan kriteria sukses berupa kombinasi metrik bisnis dan batasan risiko, bukan hanya metrik ML offline.