Jenis-jenis Event yang Dipantau
Monitoring menangkap berbagai jenis event, misalnya:
- Menerima HTTP request / mengirim HTTP response.
- Masuk ke sebuah fungsi, atau menjangkau statement tertentu pada kode.
- User log in.
- Penulisan data ke disk, membaca data dari jaringan, meminta memory ke kernel, dsb.
Setiap event punya context — misalnya untuk HTTP request, konteksnya adalah IP address, URL, cookies.
Lokasi Monitoring
Monitoring bisa dilakukan di berbagai lokasi/lapisan sistem:
- Database
- Application
- Middleware
- System (CPU, Memory, Paging, dll.)
- Network
Empat Pendekatan Monitoring
1. Profiling
- Tujuan: karakterisasi target dengan mengumpulkan sampel/snapshot.
- Tidak menyimpan/menangkap semua konteks dan semua event di setiap saat — hanya memilih konteks tertentu, event tertentu, pada waktu tertentu.
- Termasuk kategori debugging tools, misal:
tcpdump,gprof/prof,NVTX/nprov. - Di Linux kernel: eBPF (extended Berkeley Packet Filter).
- Alat-alat observability Linux tersebar dari level Application, System Call Interface, hingga Hardware (mis.
strace,perf,iostat,vmstat,netstat,top, dll — lihat buku Systems Performance karya Brendan Gregg).
2. Tracing
- Tidak menyimpan semua event — hanya menangkap sebagian event (misalnya 1% dari request yang masuk, melalui sampling).
- Menelusuri trace/fungsi lain yang dipanggil hingga ke database.
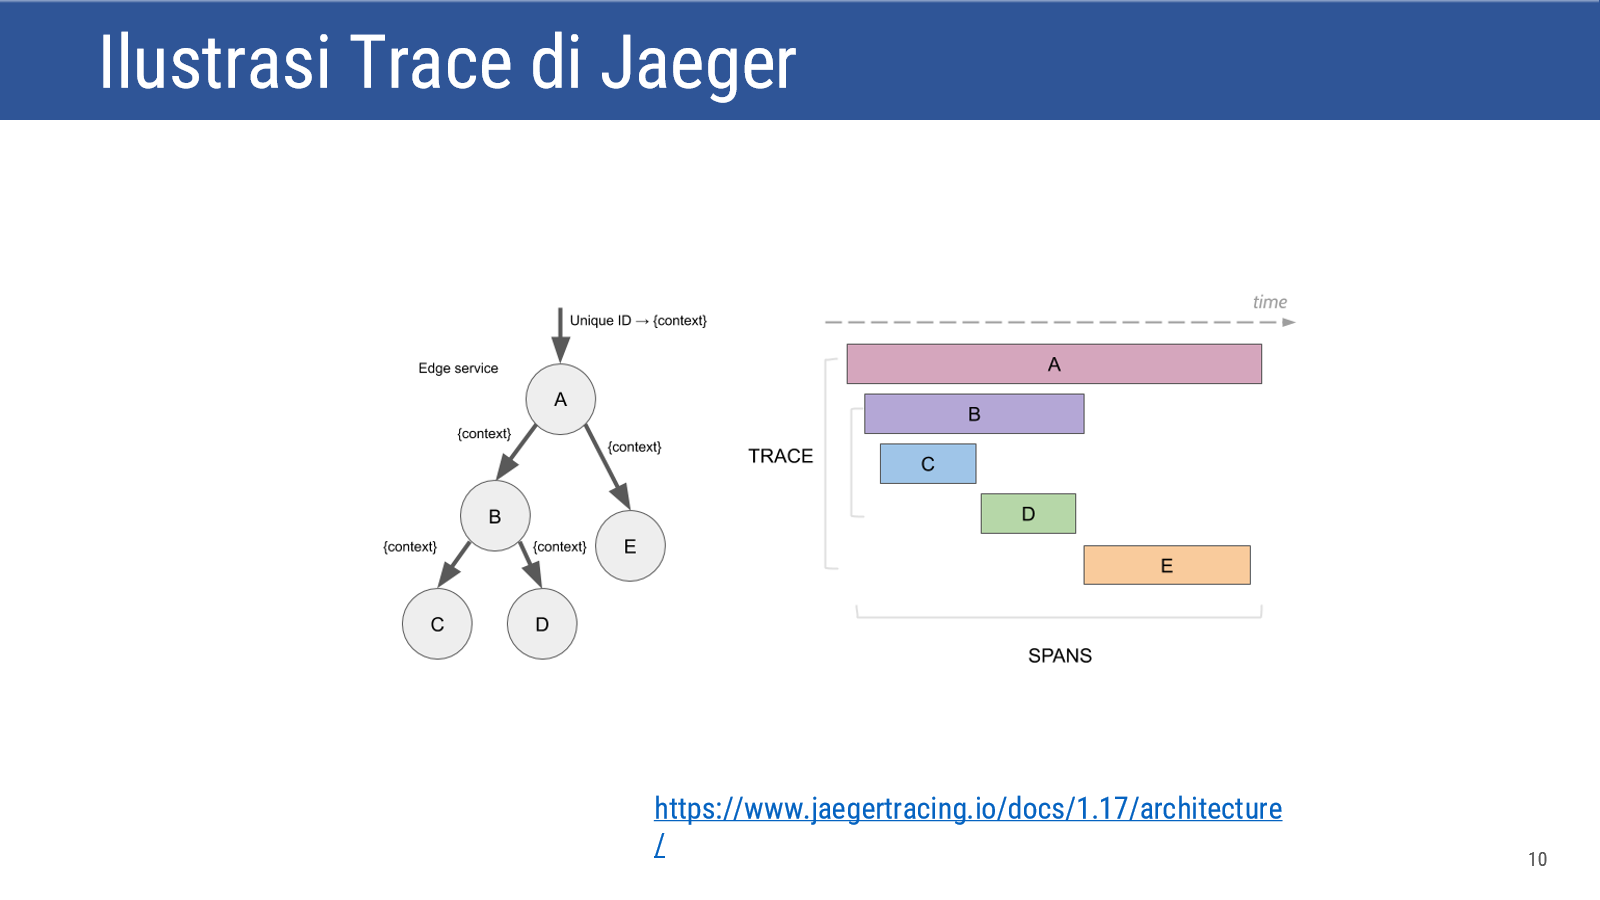
- Distributed tracing: menandai request dengan unique ID sehingga bisa di-trace lintas layanan.
- Contoh tools: OpenZipkin, Jaeger, AWS X-Ray, GCP Cloud Trace.
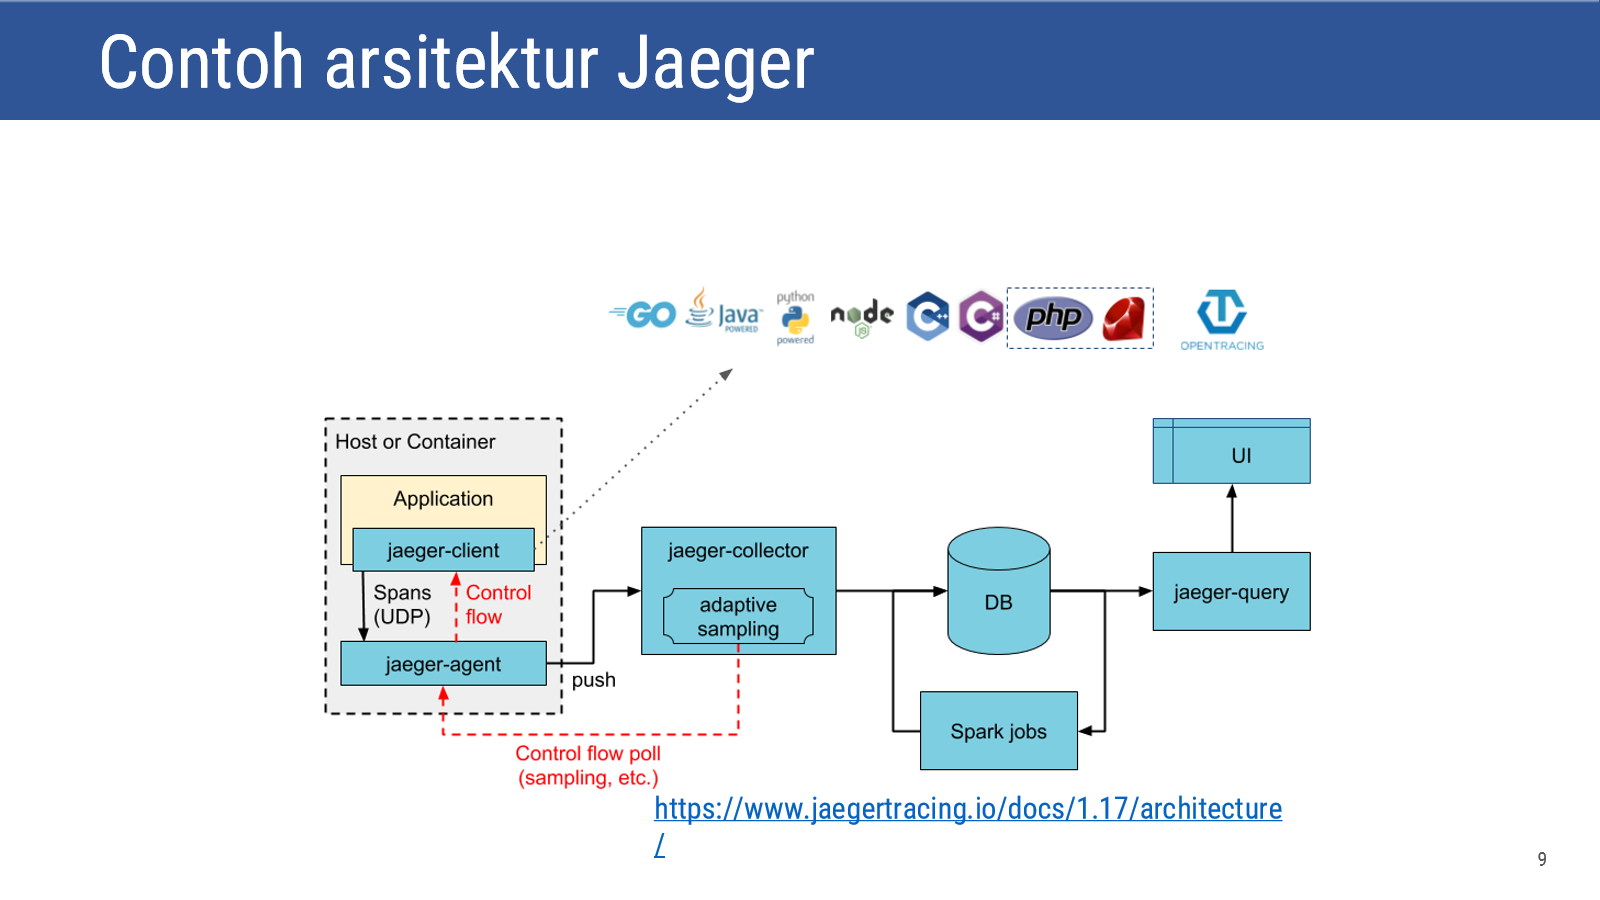
Contoh arsitektur Jaeger: aplikasi mengirim spans lewat jaeger-client ke jaeger-agent (via UDP), diteruskan (push) ke jaeger-collector (melakukan adaptive sampling), disimpan ke DB, lalu diolah Spark jobs, dan ditampilkan lewat jaeger-query ke UI.
Sebuah trace terdiri dari beberapa spans yang bersarang: request diberi Unique ID → {context}, lalu ditelusuri lewat rantai pemanggilan layanan (misal Edge service A memanggil B dan E, B memanggil C dan D). Tiap span punya durasi waktunya sendiri yang bisa divisualisasikan sebagai garis waktu (timeline).
3. Logging
- Mencatat event-event tertentu beserta sebagian konteksnya. Misal: mencatat semua HTTP request beserta IP asal dan URL, atau mencatat query SQL.
- Log dapat membangkitkan data yang sangat besar, sehingga perlu pembatasan event apa saja yang perlu dicatat.
- Contoh perhitungan: server dengan 1000 request/detik, tiap entry log memiliki 100 field @10 bytes → menghasilkan 1 MB/detik → 84 GB/hari.
- Kategori log: transaction logs, request logs, application logs, debug logs.
- Tools: ELK stack, Graylog.
4. Metrics
- Metrics tidak mencatat konteks — mencatat agregat selama periode tertentu untuk berbagai jenis event.
- Contoh: jumlah request per detik, rata-rata waktu eksekusi request, jumlah pending transaction.
- Konteks tertentu masih bisa disimpan sebagai metric terpisah (misal, setiap URL/kelompok URL menjadi metric tersendiri untuk HTTP request).
- Perbedaan Metric vs Log: metric menyimpan semua event dari semua proses namun dengan konteks yang sangat terbatas; log menyimpan event jenis tertentu lengkap dengan konteksnya.
- Tools: Munin, Prometheus/Grafana, ELK.
Arsitektur Umum Tools Performance Monitoring
Pola arsitektur umum: setiap Server menjalankan Application dan Agent monitoring → agent mengirim data ke Monitoring Database Server (berisi Metric Storage) → Monitoring Web Server memuat UI → Client menampilkan Metrics Dashboard dengan cara fetch metrics dari database server.
Umumnya server monitoring memakai database spesifik seperti RRDTool (Round Robin Database) — RRDTool hanya menyimpan data detail untuk periode yang baru saja, lalu mengagregasi data lama setelah waktu tertentu (round-robin) agar ukuran database tidak terus membesar.
Daftar Tools untuk Performance Monitoring
- Nagios (nagios.org)
- Graphite (graphiteapp.org)
- Munin (munin-monitoring.org)
- Cacti (cacti.net)
- Ganglia (ganglia.info)
- Prometheus – Grafana (prometheus.io)
- ElasticSearch – Logstash – Kibana / ELK (elastic.co)
Munin
Munin adalah networked resource monitoring tool, terdiri dari 3 komponen:
- munin master — komponen server.
- munin node — komponen client/agent.
- munin plugin — program yang mengambil data.
Relasinya: Master 1..* → Node 1..* → Plugin. Master mengumpulkan data dari setiap node secara periodik dan menyimpannya di RRDTool untuk ditampilkan ke user. Node akan mengecek semua plugin yang telah dikonfigurasi dan mengirimkan hasilnya ke master.
Instalasi tersedia di distro Linux besar (Ubuntu: apt-get install munin / munin-node; Fedora/CentOS/RedHat: yum install munin / munin-node). Konfigurasi master di /etc/munin/munin.conf (mendaftarkan node yang dimonitor beserta address-nya), konfigurasi node di /etc/munin/munin-node.conf (mengatur allow IP master), serta /etc/munin/plugins berisi symbolic link ke plugin yang dipanggil.
Prometheus
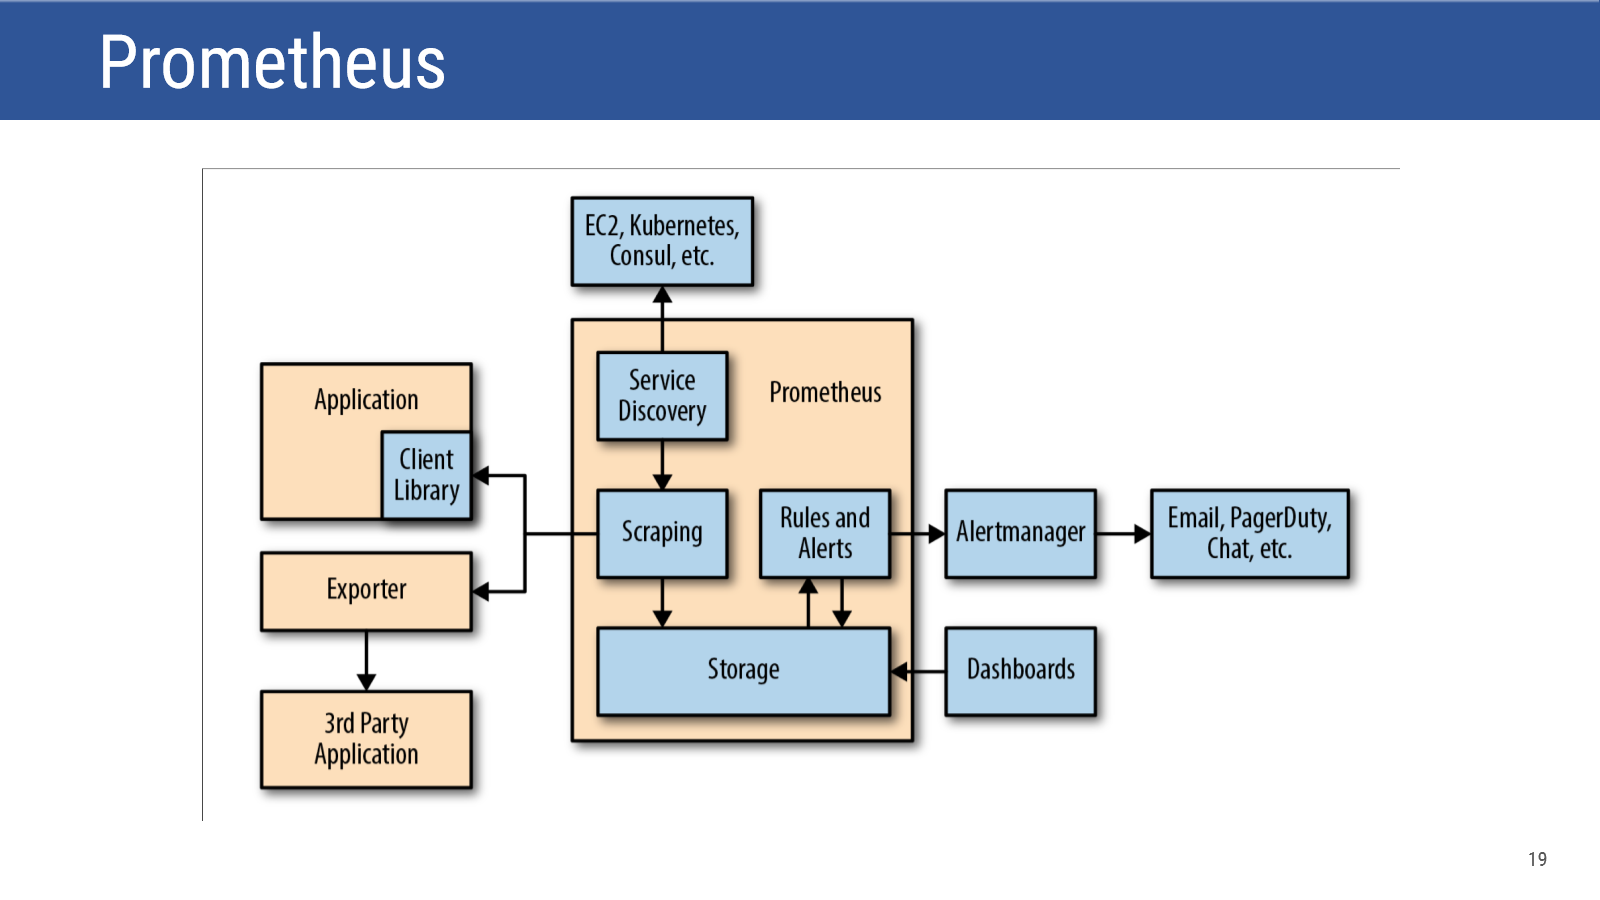
Prometheus adalah tool metrics monitoring berbasis pull (scraping), dengan komponen:
- Service Discovery — target metric bisa ditentukan secara dinamis (terintegrasi dengan EC2, Kubernetes, Consul, dll).
- Scraping — proses mengambil metrics dari target secara periodik lewat HTTP request (berbasis pull).
- Storage — penyimpanan data menggunakan database custom milik Prometheus.
- Rules and Alerts — mekanisme evaluasi query secara periodik yang membangkitkan alert.
- Alertmanager — menerima alert dari Prometheus dan meneruskannya ke Email, PagerDuty, Chat, dll.
- Dashboards — dashboard sederhana bawaan Prometheus memakai expression browser (mengevaluasi query PromQL); untuk kebutuhan dashboard yang lebih kaya biasanya dipasangkan dengan Grafana.
Sumber data metric Prometheus:
- Client libraries — aplikasi yang dimonitor memakai library klien untuk menyediakan metrics yang bisa dibaca Prometheus scraper.
- Exporter — aplikasi lain (pihak ketiga) memakai exporter untuk menyediakan metrics ke Prometheus scraper.
Contoh konfigurasi scrape (prometheus.yml) mendefinisikan scrape_configs dengan job_name, scrape_interval, dan static_configs.targets. Contoh konfigurasi rule alert (rules.yml) mendefinisikan groups berisi rules seperti alert: InstanceDown, expr: up == 0, for: 1m (alert terpicu jika target down selama minimal 1 menit).
ELK Stack (Elasticsearch, Logstash, Kibana)
Masalah yang diselesaikan: memonitor banyak komputer sekaligus, di mana ada banyak aplikasi yang dimonitor pada tiap node dan banyak log yang harus diproses/diolah. Log perlu dikumpulkan di satu tempat. Pendekatan Munin mengelola data series lewat RRDTool; alternatifnya, data dikumpulkan pada repositori yang memudahkan retrieval, yaitu lewat indexing/search engine.
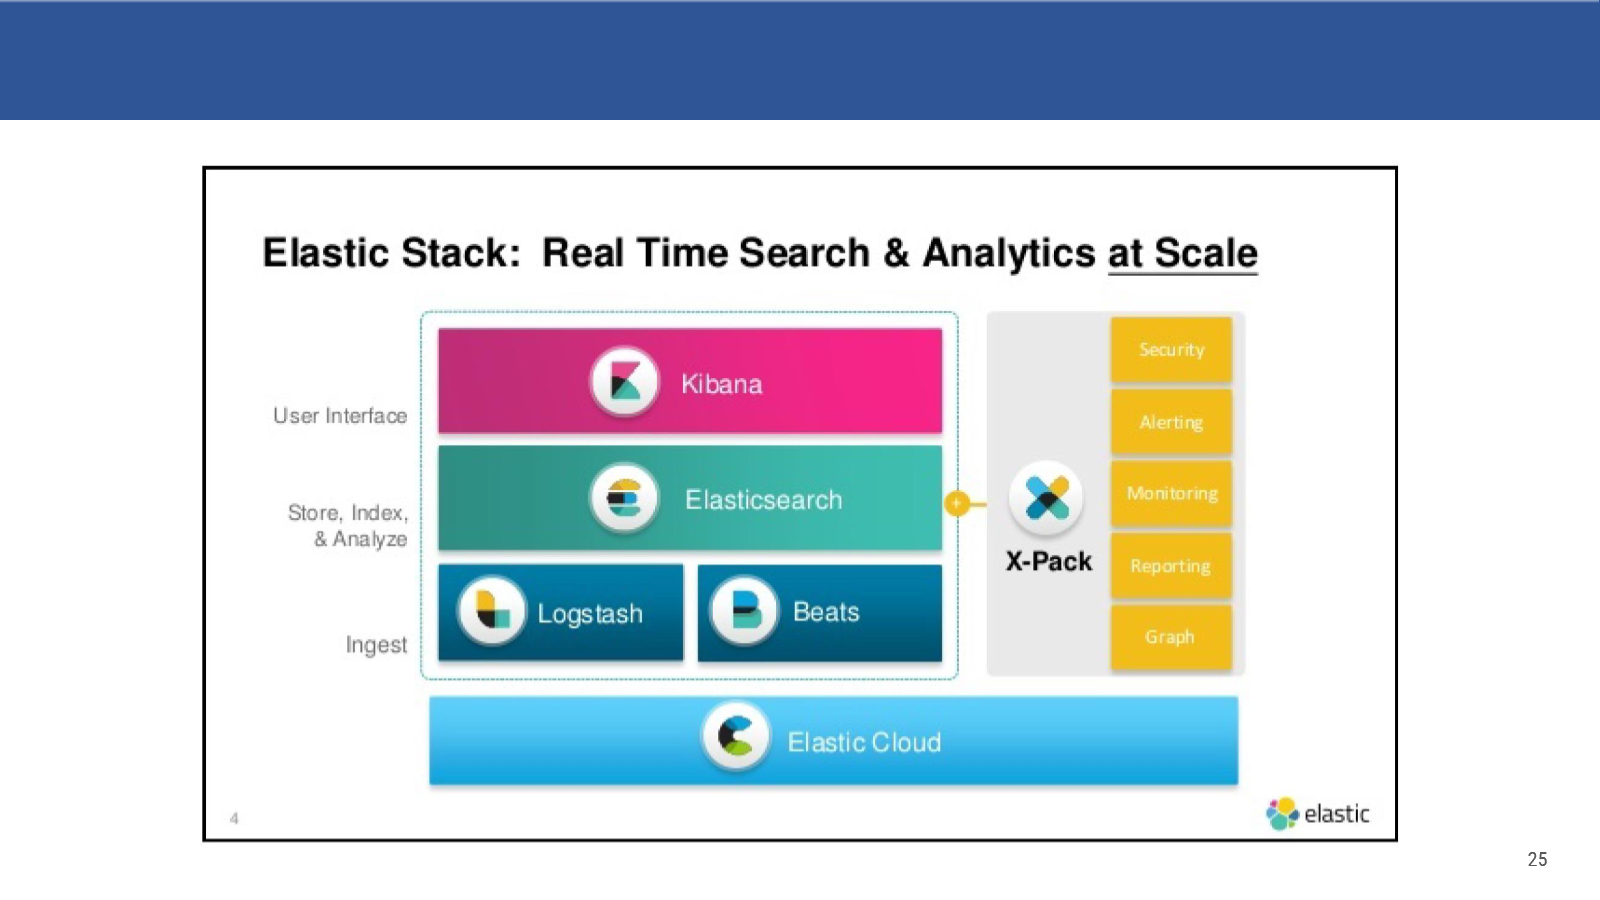
Elastic Stack: Beats dan Logstash (ingest) → Elasticsearch (store, index, & analyze) → Kibana (user interface), dengan tambahan X-Pack (Security, Alerting, Monitoring, Reporting, Graph), semuanya bisa dijalankan di atas Elastic Cloud.
Elasticsearch
- Dikembangkan berbasis Java, berbasis Apache Lucene.
- Menyediakan searching dan indexing.
- Terdistribusi — data otomatis di-shard dan di-copy (replica) ke cluster Elasticsearch yang ada.
- Menyediakan API via JSON/REST.
Logstash
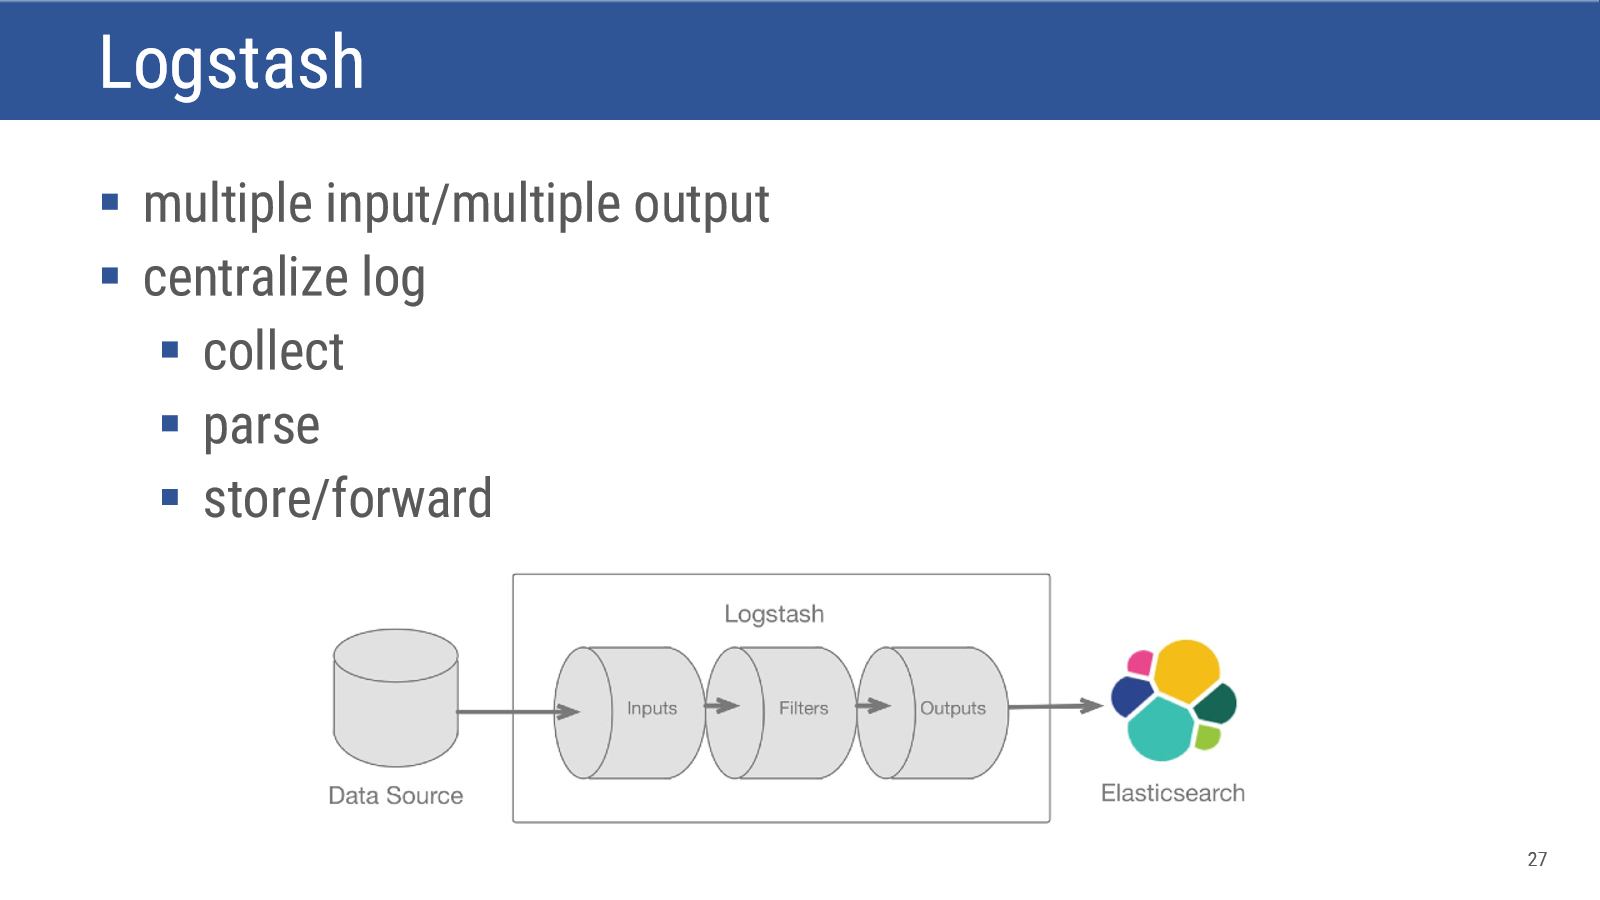
- Bersifat multiple input/multiple output, untuk centralize log: collect → parse → store/forward.
- Sebuah data (event) melalui 3 tahap: input (file, syslog, logstash-forwarder/beats) → filter (data bisa diubah format/diseleksi, misal via plugin
grok) → output (data dikirim ke target tertentu, misal file atau Elasticsearch), ditambah opsi codec. - Contoh konfigurasi:
input { beats { port => 5044 } },filter { grok { pattern => "%{COMBINEDAPACHELOG}" } },output { elasticsearch { } }.
Beats
Mekanisme pengumpulan data ringan yang disediakan ELK, mengirim data ke Logstash/Elasticsearch:
- Filebeat — mengumpulkan data dari file.
- Packetbeat — mengumpulkan data paket jaringan.
- Winlogbeat — mengumpulkan Windows event log.
Contoh konfigurasi filebeat: filebeat.prospectors: - input_type: log, paths: - /path/to/file/logstash-tutorial.log, output.logstash: hosts: ["localhost:5043"].
Kibana
Alat visualisasi data yang dapat membaca dan menampilkan data langsung dari Elasticsearch (dashboard, chart waktu, tabel log, dsb).
Hal-hal yang Perlu Diwaspadai (Things to Watch Out)
- Collect just enough measurement or events (beserta trace info-nya) — terlalu banyak event akan membebani sistem dan menyulitkan analisis (validasi & pemeriksaan).
- The clock at multiple hosts — perbedaan jam antar host bisa mengacaukan urutan/korelasi event terdistribusi.
- Validate dan scrutinize measurement values — misalnya memastikan nilai lebih besar dari 0, atau berada di antara nilai X dan Y (masuk akal secara domain).
- Be aware with operational context — misalnya kondisi khusus seperti virtualized environment atau adanya reverse proxy yang bisa mempengaruhi interpretasi data yang diukur.
Flashcard
flashcards Sebutkan 4 pendekatan/jenis monitoring yang dibahas. :: Profiling, Tracing, Logging, dan Metrics. Apa perbedaan mendasar antara Metrics dan Logging? :: Metrics mencatat data agregat dari semua event/proses selama periode tertentu tanpa/dengan konteks sangat terbatas; Logging mencatat event jenis tertentu secara detail lengkap dengan konteksnya, sehingga volume datanya jauh lebih besar. Apa itu distributed tracing dan bagaimana cara kerjanya? :: Teknik tracing yang menandai setiap request dengan unique ID agar bisa ditelusuri (di-trace) lintas layanan/service dalam sistem terdistribusi; contoh tools: Jaeger, OpenZipkin, AWS X-Ray, GCP Cloud Trace. Sebutkan 3 komponen utama Munin dan relasinya. :: Munin master (server, mengumpulkan data dan menyimpan ke RRDTool), munin node (client/agent di tiap mesin yang dimonitor), dan munin plugin (program pengambil data); relasi: Master 1..* Node 1..* Plugin. Bagaimana cara kerja scraping pada Prometheus? :: Prometheus mengambil (scrape) metrics dari target secara periodik melalui HTTP request, bersifat pull-based (bukan push), dengan target ditentukan lewat static config atau service discovery (mis. Kubernetes, EC2). Sebutkan 3 komponen inti ELK Stack beserta fungsinya masing-masing. :: Elasticsearch (menyimpan, mengindeks, dan mencari data, berbasis Apache Lucene, terdistribusi via shard/replica), Logstash (mengumpulkan, memparsing/filter, dan meneruskan log dari berbagai input), Kibana (visualisasi data dari Elasticsearch). Apa fungsi Beats dalam ekosistem ELK dan sebutkan 3 jenisnya. :: Beats adalah agen ringan untuk mengumpulkan data dan mengirimkannya ke Logstash/Elasticsearch; jenisnya antara lain Filebeat (data file), Packetbeat (data paket jaringan), dan Winlogbeat (Windows event log). Mengapa perlu berhati-hati terhadap “the clock at multiple hosts” saat melakukan monitoring terdistribusi? :: Karena jika jam antar host tidak tersinkronisasi, urutan waktu (timestamp) event dari host berbeda bisa salah, sehingga mengacaukan korelasi/urutan event saat analisis trace atau log terdistribusi.