Asal-usul SRE
- Site-Reliability Engineering (SRE) lahir di Google pada 2003 di bawah Ben Treynor Sloss.
- Kutipan terkenal Treynor Sloss: “What happens when you ask a software engineer to design an operations team” — SRE pada dasarnya adalah eksperimen memperlakukan tim operasional sebagaimana tim software engineering.
- Prinsip inti: memperlakukan operasi (operations) sebagai masalah software engineering.
- Fokus: mencapai reliability lewat rekayasa (engineering), bukan intervensi manual.
SRE vs DevOps
- DevOps = budaya dan kolaborasi antara Dev + Ops (filosofi luas): meruntuhkan silo, meningkatkan kolaborasi, mempersingkat feedback loop.
- SRE = implementasi konkret dari prinsip-prinsip DevOps, dengan metodologi spesifik ala Google yang mengedepankan engineering-first mindset.
- Keduanya berbagi tujuan yang sama: Speed, Reliability, Automation.
DevOps = “What” | SRE = “How” — DevOps menyatakan prinsip (“kita butuh rilis yang cepat dan reliable”), sedangkan SRE menegakkan prinsip itu lewat praktik/tools konkret: SLO, error budget, otomasi, monitoring, blameless postmortem.
Fokus Inti SRE
- Menyeimbangkan risk dan reliability.
- Menggunakan error budget untuk memandu keputusan.
- Mendorong service management berbasis data.
Tujuh Prinsip SRE
- Embracing risk
- Service Level Objectives
- Eliminating Toil
- Monitoring Distributed Systems
- The Evolution of Automation at Google
- Release Engineering
- Simplicity
Mengapa 100% Reliability Itu Keliru
- Realita: reliability 100% itu mustahil dan tidak diinginkan.
- Reliability ekstrem justru memperlambat inovasi.
- Dari sudut pandang pengguna: mereka tidak bisa membedakan availability 99.99% dengan 100%.
- Biaya reliability:
- Butuh redundant resources (mesin, storage, maintenance).
- Cost curve: setiap tambahan “nine” (misal dari 99.9% ke 99.99%) biayanya 100x lebih mahal dari sebelumnya.
- Opportunity cost: resource engineering yang dipakai untuk reliability ekstrem tidak dipakai untuk membangun fitur baru.
Mengelola Risiko (Managing Risk)
SRE menyeimbangkan risiko downtime dengan:
- Rapid innovation
- Efficient operations
- User happiness
Mengukur risiko: fokus pada unplanned downtime. Availability secara tradisional dinyatakan dalam “nines” (99.9%, 99.99%, dst.), namun di Google diukur lewat request success rate, bukan sekadar uptime.
Error Budget
Error budget adalah jumlah maksimum ketidak-andalan (error, downtime, failed request) yang boleh dimiliki sebuah layanan dalam periode tertentu, sambil tetap memenuhi Service Level Objective (SLO)-nya.
- Merupakan metrik bersama antara tim SRE dan tim produk.
- Memungkinkan pengambilan risiko yang terkendali dan kecepatan rilis yang seimbang.
- Rumus: Error budget = 100% − target availability.
- Contoh: target 99.9% → error budget 0.1% → setara 43.2 menit/bulan.
- Penggunaan: budget dibelanjakan untuk inovasi dan kecepatan fitur. Jika budget habis → perlambat rilis.
Risk Tolerance
Faktor yang perlu dipertimbangkan:
- Menyelaraskan reliability layanan dengan tujuan bisnis.
- Target availability berfungsi sebagai batas minimum sekaligus maksimum (jangan under- maupun over-invest).
- Memungkinkan pengambilan risiko yang eksplisit dan disengaja.
- Keseimbangan antara: target Availability, jenis Failure, dan Cost.
Contoh Penerapan Risk Tolerance
| Kategori | Contoh | Karakteristik |
|---|---|---|
| Consumer Services | YouTube (tahun-tahun awal) | Availability lebih rendah, pertumbuhan fitur lebih cepat |
| Enterprise Services | Google Apps for Work | Availability lebih tinggi (kritikal bagi enterprise) |
| Infrastructure Services | Bigtable | Klien berbeda punya kebutuhan berbeda: cluster low-latency (reliability tinggi, biaya lebih mahal) vs. cluster throughput (reliability lebih rendah, lebih murah) |
Mengapa metrik-metrik ini penting: memastikan aplikasi tersedia dan reliable, mengikat metrik reliability ke tujuan bisnis. Tanpa metrik ini, kita tidak bisa menilai apakah sistem membantu atau justru merugikan pengguna.
Service Level Objectives (SLO)
Motivasi
- Memberikan target numerik untuk availability/reliability sistem.
- Mustahil mengelola layanan dengan baik tanpa metrik yang jelas.
- SLO mendefinisikan apa yang penting bagi pengguna dan cara mengukurnya.
- Memberi keyakinan bahwa layanan sehat dan reliable.
- Mendefinisikan reliability minimum yang bisa diterima pengguna — reliability yang berlebihan berarti biaya lebih tinggi dan development lebih lambat.
Tiga Istilah Kunci: SLI, SLO, SLA
| Istilah | Definisi | Contoh |
|---|---|---|
| SLI (Service Level Indicator) | Apa yang diukur — pengukuran langsung dari perilaku layanan | latency, availability, throughput, error rate |
| SLO (Service Level Objective) | Target nilai untuk SLI | 99.9% availability |
| SLA (Service Level Agreement) | Konsekuensi bisnis jika SLO tidak terpenuhi — kontrak formal dengan pelanggan | Idealnya SLA ≤ SLO, dengan buffer untuk margin operasional |
- SLA adalah janji ke pengguna bahwa SLO (dengan margin tertentu) akan dipenuhi pada level tertentu selama periode tertentu, beserta konsekuensinya.
- External SLA harus lebih longgar (loose) dibanding internal SLO — sistem harus berperforma lebih baik dari SLO agar tidak melanggar SLA.
- Kepatuhan (compliance) dipantau lewat logs & dashboards.
- SLA mencakup penalti jika tidak terpenuhi (refund, credit, dll.) dan membantu memprioritaskan traffic/obligasi ke pengguna berbayar.
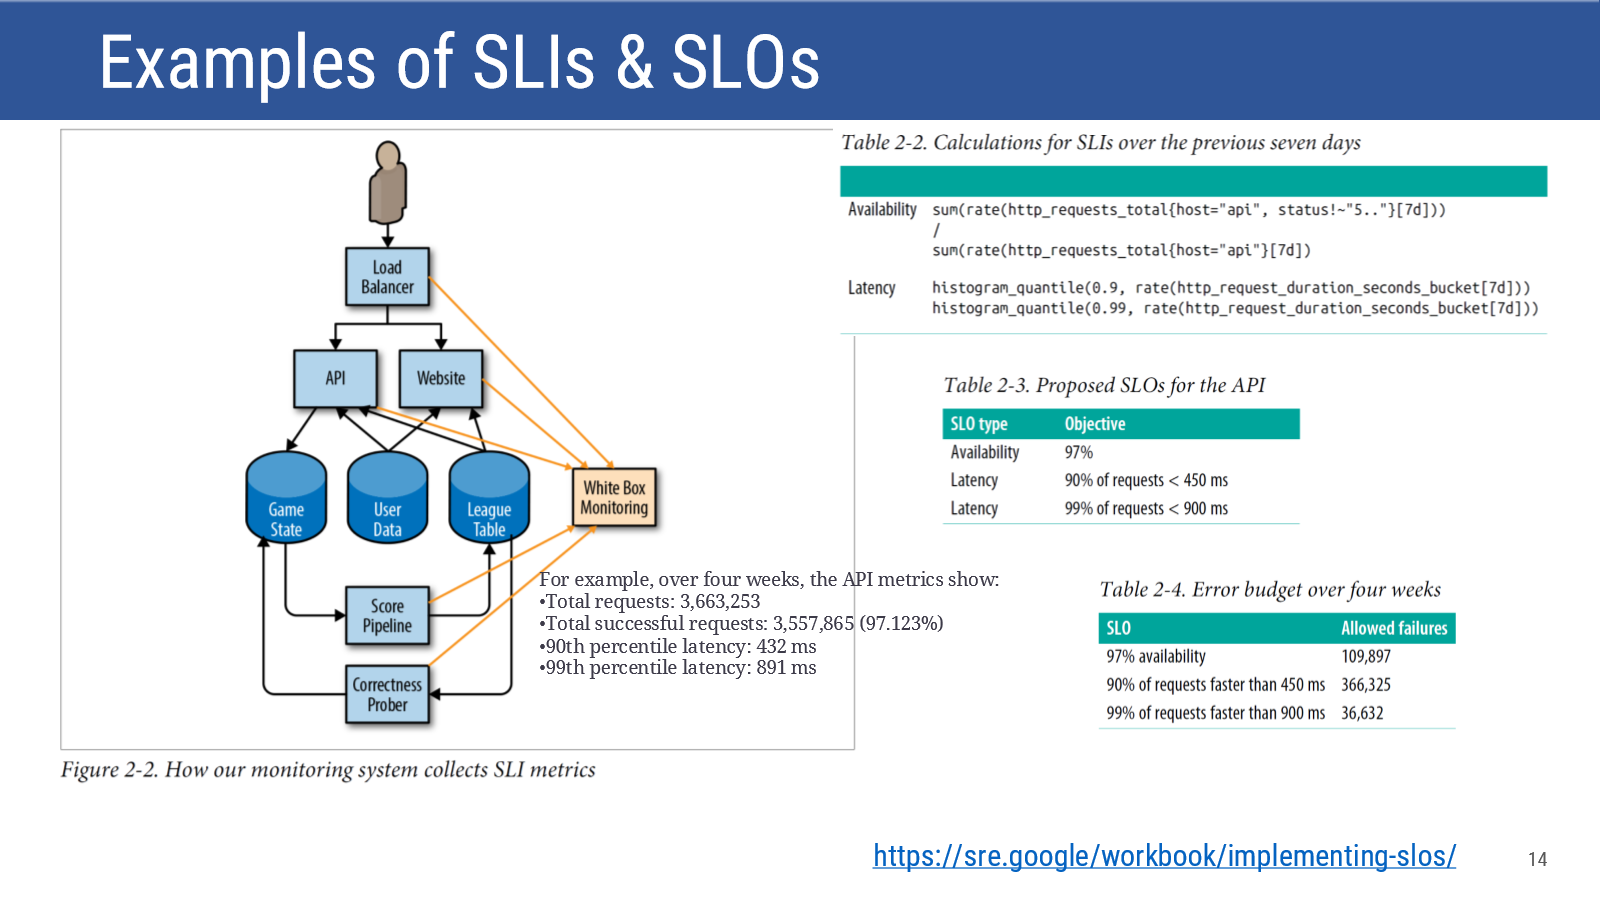
Contoh Perhitungan SLI/SLO (Google Workbook)
Arsitektur contoh: Load Balancer → API dan Website → mengakses Game State, User Data, League Table (data stores) → Score Pipeline → Correctness Prober, semuanya dipantau lewat White Box Monitoring.
Selama 4 minggu, metrik API menunjukkan:
- Total request: 3.663.253
- Total request sukses: 3.557.865 (97,123%)
- Latency persentil ke-90: 432 ms
- Latency persentil ke-99: 891 ms
Contoh SLO yang diusulkan untuk API tersebut:
| Tipe SLO | Objective |
|---|---|
| Availability | 97% |
| Latency | 90% request < 450 ms |
| Latency | 99% request < 900 ms |
Dari SLO tersebut dapat dihitung error budget selama 4 minggu, misalnya “97% availability” mengizinkan 109.897 kegagalan (allowed failures).
Praktik Terbaik (Best Practices) untuk SLO
- Contoh SLO: “99% request selesai dalam < 100ms”.
- Mungkin perlu beberapa SLO untuk beban kerja berbeda (misal bulk vs. interactive).
- SLO adalah lever utama untuk prioritisasi dan inovasi.
- Best practices:
- Mulai dari apa yang penting bagi pengguna, bukan sekadar apa yang mudah diukur.
- Hindari nilai absolut (100% uptime tidak realistis).
- Sederhanakan dan fokus pada dampak bisnis → sedikit tapi SLO yang bermakna.
- Jangan overachieve — reliability yang jauh melebihi SLO justru menciptakan rasa aman yang keliru (false sense of reliability) dan bisa membuat pengguna bergantung pada level layanan yang sebenarnya tidak dijamin.
- Pertimbangkan alternatif: apa yang terjadi jika pengguna tidak puas?
- Refine target dari waktu ke waktu.
Jenis-jenis SLI
SLI dinyatakan sebagai SLI ≤ target atau lower ≤ SLI ≤ upper. Jenis SLI berdasarkan tipe sistem:
- User-centric metrics — apa yang benar-benar dialami pengguna.
- Request/Response systems — availability, latency, throughput.
- Data processing — freshness, correctness, coverage.
- Storage systems — durability, availability, consistency.
Contoh SLI: Latency (waktu mengembalikan response), Error Rate (fraksi request gagal), Throughput (request per detik), Availability (persentase request sukses), Durability (retensi data seiring waktu).
Flashcard
flashcards Siapa yang mendirikan SRE dan di mana, serta apa kutipan terkenalnya? :: Ben Treynor Sloss mendirikan SRE di Google pada 2003; kutipan terkenalnya “What happens when you ask a software engineer to design an operations team.” Apa hubungan antara DevOps dan SRE menurut kerangka “What vs How”? :: DevOps adalah filosofi luas (the “what”) yang menyatakan prinsip seperti butuh rilis cepat dan reliable; SRE adalah metodologi konkret Google (the “how”) untuk mencapai tujuan DevOps tersebut lewat SLO, error budget, otomasi, monitoring, dan blameless postmortem. Mengapa reliability 100% dianggap keliru dalam SRE? :: Karena mustahil dicapai, memperlambat inovasi, pengguna tidak bisa membedakan 99.99% dari 100%, dan setiap tambahan “nine” reliability biayanya sekitar 100x lebih mahal dari sebelumnya (opportunity cost engineering). Apa itu error budget dan bagaimana rumus menghitungnya? :: Jumlah maksimum ketidak-andalan yang boleh dimiliki layanan dalam periode tertentu sambil tetap memenuhi SLO; rumus: Error budget = 100% - target availability (contoh: target 99.9% → error budget 0.1% → 43.2 menit/bulan). Jelaskan perbedaan SLI, SLO, dan SLA. :: SLI adalah metrik yang diukur langsung dari perilaku layanan (mis. latency, availability); SLO adalah target nilai untuk SLI (mis. 99.9% availability); SLA adalah kontrak formal dengan konsekuensi bisnis jika SLO tidak terpenuhi, biasanya lebih longgar dari SLO internal. Mengapa external SLA harus dibuat lebih longgar (loose) dibanding internal SLO? :: Agar sistem selalu berperforma lebih baik dari SLO yang dijanjikan ke pengguna (SLA), sehingga ada buffer/margin operasional dan tidak mudah melanggar kontrak SLA meski ada fluktuasi performa. Sebutkan 3 kategori risk tolerance beserta contohnya di Google. :: Consumer Services (YouTube awal - availability rendah demi fitur cepat), Enterprise Services (Google Apps for Work - availability tinggi karena kritikal), Infrastructure Services (Bigtable - cluster low-latency vs throughput dengan trade-off reliability dan biaya berbeda). Sebutkan 7 prinsip inti SRE. :: Embracing risk, Service Level Objectives, Eliminating Toil, Monitoring Distributed Systems, The Evolution of Automation at Google, Release Engineering, dan Simplicity.