Eliminating Toil
Apa itu Toil
Toil adalah task operasional yang memiliki karakteristik berikut (Google SRE Book):
- Manual — membutuhkan eksekusi manusia.
- Repetitive — dilakukan berulang kali, bukan hal baru (novel).
- Automatable — bisa digantikan oleh mesin.
- Reactive — dipicu oleh sesuatu (bukan proaktif).
- Tactical — bersifat interrupt-driven, bukan strategis.
- No enduring value — tidak memperbaiki sistem secara jangka panjang.
- O(n) with service growth — bebannya bertambah seiring pertumbuhan ukuran layanan.
Contoh toil: setiap alert mengharuskan engineer login ke server, menjalankan diagnostic script secara manual, restart layanan jika kondisi tertentu terpenuhi, dan mendokumentasikan insiden di ticketing system.
Motivasi Menghilangkan Toil
- Membebaskan waktu untuk engineering dan inovasi.
- Mencegah burnout dan stagnasi karier.
- Memungkinkan sublinear scaling tim (tim tidak perlu tumbuh proporsional dengan pertumbuhan layanan).
- Mengurangi jumlah error/inkonsistensi.
- Mengurangi response time.
- Menjaga SRE tetap berbeda dari Ops tradisional.
Aturan 50% (The 50% Rule)
- Tujuan: SRE menghabiskan ≤50% waktunya untuk toil.
- Sisa waktu dipakai untuk proyek engineering.
- Tugas on-call menjadi batas bawah (floor) toil, yaitu sekitar 25–33%.
- Survei menunjukkan rata-rata toil aktual ≈33%.
Sumber Toil
- Interrupts — pesan/alert non-urgent.
- On-call — respons insiden yang urgent.
- Releases & Pushes — meski sudah diotomasi, tetap menyisakan toil.
Pengukuran Toil
- Gunakan tool task/ticket management (misal Redmine, JIRA).
- Identifikasi hot spot — engineer tertentu yang paling sering mengerjakan toil.
- Identifikasi peluang untuk high impact toil reduction.
Pola untuk Mengurangi Toil
- Gunakan third-party/open-source sebisa mungkin.
- Buat standar untuk task ber-risiko tinggi, seperti rollout software (misalnya pakai Kubernetes, Terraform).
- Buat standar untuk otomasi (CLI tool, gitlab-ci, chef cookbook, ansible, dll), dan expose API/RPC endpoint agar otomasi bisa dipakai tim lain.
- Jika memungkinkan, hindari toil sejak awal (desain sistem agar tidak menimbulkan toil).
Apakah Toil Selalu Buruk?
Toil bukan berarti tidak menyenangkan — mengerjakan task sederhana dengan tingkat keberhasilan tinggi bisa memberi kepuasan. Namun, jika dilakukan terus-menerus dalam jumlah besar, toil akan mengakibatkan kejenuhan: career stagnation, low morale, slow progress.
Nilai Otomasi
Otomasi memberi nilai berupa: consistency, platform (bisa dipakai lintas kasus), faster repairs, faster action, time saving.
Peringatan realistis (komik XKCD #1319 & #1205): niat mengotomasi task agar hemat waktu sering kali dalam praktiknya justru menghabiskan waktu untuk debugging, rethinking, dan ongoing development — sehingga perlu estimasi dulu apakah usaha otomasi sepadan dengan manfaatnya, dipertimbangkan terhadap seberapa sering task tersebut dilakukan dan berapa lama rentang manfaatnya (bisa dihitung: makin sering dan makin lama task akan dilakukan ke depan, makin besar waktu yang layak diinvestasikan untuk otomasi).
Contoh area otomasi: user account creation, rollout versi software baru, runtime configuration change, VM deployment. Tools otomasi: Puppet, Chef, Ansible, cfengine, Terraform, serta scripting (Bash, Perl, Python).
Catatan penutup: Toil tidak bisa dihilangkan sepenuhnya (inevitable) tapi harus diminimalkan. SRE adalah organisasi engineering, bukan Ops biasa. Mengurangi toil berarti menskalakan reliability dengan resource yang lebih sedikit — “Let’s invent more, and toil less.”
Monitoring dalam SRE
White-box vs Black-box Monitoring
- Monitoring: mengumpulkan, memproses, mengagregasi, dan menampilkan data kuantitatif real-time tentang sebuah sistem (misal: jumlah query dan jenisnya, jumlah error dan jenisnya, waktu pemrosesan, umur server).
- White-box monitoring — monitoring berdasarkan metrik yang diekspos oleh bagian internal sistem (log, instrumentasi, interface seperti Java Virtual Machine Profiling Interface, atau HTTP handler yang mengeluarkan statistik internal).
- Black-box monitoring — menguji perilaku yang terlihat dari luar (external) sebagaimana yang dilihat pengguna.
Motivasi Monitoring
- Mendeteksi dan memberi alert atas masalah aktif agar manusia bisa menyelidiki dan memitigasi.
- Mendorong analisis jangka panjang: capacity planning, trend analysis, perbandingan eksperimen.
- Monitoring memungkinkan: Dashboards, Alerting, Postmortem debugging.
Dashboard vs Alert
- Dashboard: aplikasi (biasanya web-based) yang memberikan ringkasan metrik inti sebuah layanan, dengan filter/selector untuk menampilkan metrik terpenting bagi penggunanya (misal panjang antrean tiket, daftar bug prioritas tinggi, engineer on-call saat ini, atau push terbaru).
- Alert: notifikasi yang ditujukan untuk dibaca manusia, dikirim ke sistem seperti bug/ticket queue, email alias, atau pager.
- Page → butuh respons manusia segera.
- Ticket → butuh respons manusia tapi tidak segera.
Prinsip Alerting
- Page hanya ketika kondisinya urgent, actionable, dan user-visible.
- Hanya libatkan manusia ketika SLO terancam.
- Buat aturan paging sederhana, predictable, dan robust untuk menghindari alert fatigue.
- Lebih utamakan symptom-oriented paging (black-box), dan gunakan white-box untuk sinyal root-cause atau kondisi yang akan segera terjadi (imminent).
- Pertanyaan yang perlu diajukan sebelum membuat alert: Bisakah alert ini diabaikan dengan aman? Bisakah diotomasi, atau memang butuh human intelligence? Apakah rule mendeteksi kondisi yang urgent, actionable, dan user-visible? Bisakah alert diabaikan dengan aman pada kasus yang memang jinak (traffic yang di-drain, deployment test)? Bisakah aksinya diotomasi atau ditunda ke jam yang tidak mendesak? Apakah beberapa tim di-page untuk isu yang sama secara tidak perlu?
Root Cause dan Four Golden Signals
- Root cause: cacat pada software atau sistem manusia yang, jika diperbaiki, memberi keyakinan bahwa event yang sama tidak akan terulang dengan cara yang sama. Satu insiden bisa punya banyak root cause (misal kombinasi otomasi proses yang kurang, software yang crash karena input tidak valid, dan testing script konfigurasi yang kurang memadai).
- Four Golden Signals — empat sinyal emas untuk monitoring sistem yang menghadap pengguna:
- Latency
- Traffic
- Errors
- Saturation
Symptoms vs Causes
Sistem monitoring harus menjawab dua pertanyaan: apa yang rusak (symptom) dan mengapa (cause).
| Symptom | Cause |
|---|---|
| Serving HTTP 500 atau 404 | Database server menolak koneksi |
| Response lambat | CPU overload akibat bogosort, atau kabel Ethernet terjepit rak (packet loss parsial) |
| User di Antartika tidak menerima animated cat GIF | Content Distribution Network memblokir sejumlah client IP |
| Konten privat bisa dibaca semua orang | Push software baru menyebabkan ACL terlupa dan mengizinkan semua request |
Efficiency and Performance
- Penyediaan kapasitas membutuhkan biaya → perlu optimasi penggunaan resource.
- Penyediaan resource adalah fungsi dari demand/load, capacity, dan software efficiency.
- SRE memonitor penggunaan resource dan kinerja untuk mendeteksi regresi dan mengambil tindakan.
- Tim yang belum matang (immature): menyesuaikan ketersediaan resource dan memperbaiki software efficiency.
- Tim matang (mature): melakukan rollback.
Praktik Terbaik Monitoring
- Seimbangkan performa (reliability/availability) dengan resource.
- Ukur persentil dan histogram, bukan hanya rata-rata (mean), agar bisa menangkap tail latency dan pengalaman pengguna riil.
- Gunakan bucket latency secara eksponensial untuk memvisualisasikan distribusi dan mendeteksi lonjakan tail lebih awal.
- Pilih resolusi pengukuran secara bijak, menyeimbangkan kebutuhan deteksi, sifat sinyal, dan biaya penyimpanan.
- Jaga sistem monitoring tetap sederhana dan decoupled — hindari mencampur monitoring dengan tool profiling/debugging berat.
- Hapus koleksi data/alert/sinyal yang jarang dipakai dan tidak muncul di dashboard, agar kompleksitas dan maintenance berkurang.
- Kadang perlu melonggarkan alert sementara agar tim bisa fokus memperbaiki isu yang lebih mendalam, bukan terus firefighting.
- Fokuskan page pada symptom, dashboard pada cause.
- Lacak frekuensi page (insiden per shift) dalam laporan untuk menjaga beban on-call yang berkelanjutan dan kesehatan tim.
- Anggap tingkat paging yang tinggi sebagai sinyal untuk mengurangi noise, mengotomasi respons, atau menyesuaikan target SLO demi stabilitas jangka panjang.
Time-Series Monitoring: Borgmon (dan Prometheus sebagai Padanan Open Source)
Borgmon adalah pendekatan monitoring time-series milik Google (padanan open source-nya adalah Prometheus). Fitur kunci:
- Mengumpulkan metrik dalam format standar dari semua layanan.
- Menyimpan data sebagai time-series di memori (“arena”).
- Menggunakan bahasa rule untuk agregasi dan alerting.
- Memisahkan pengumpulan data dari visualisasi dan alerting.
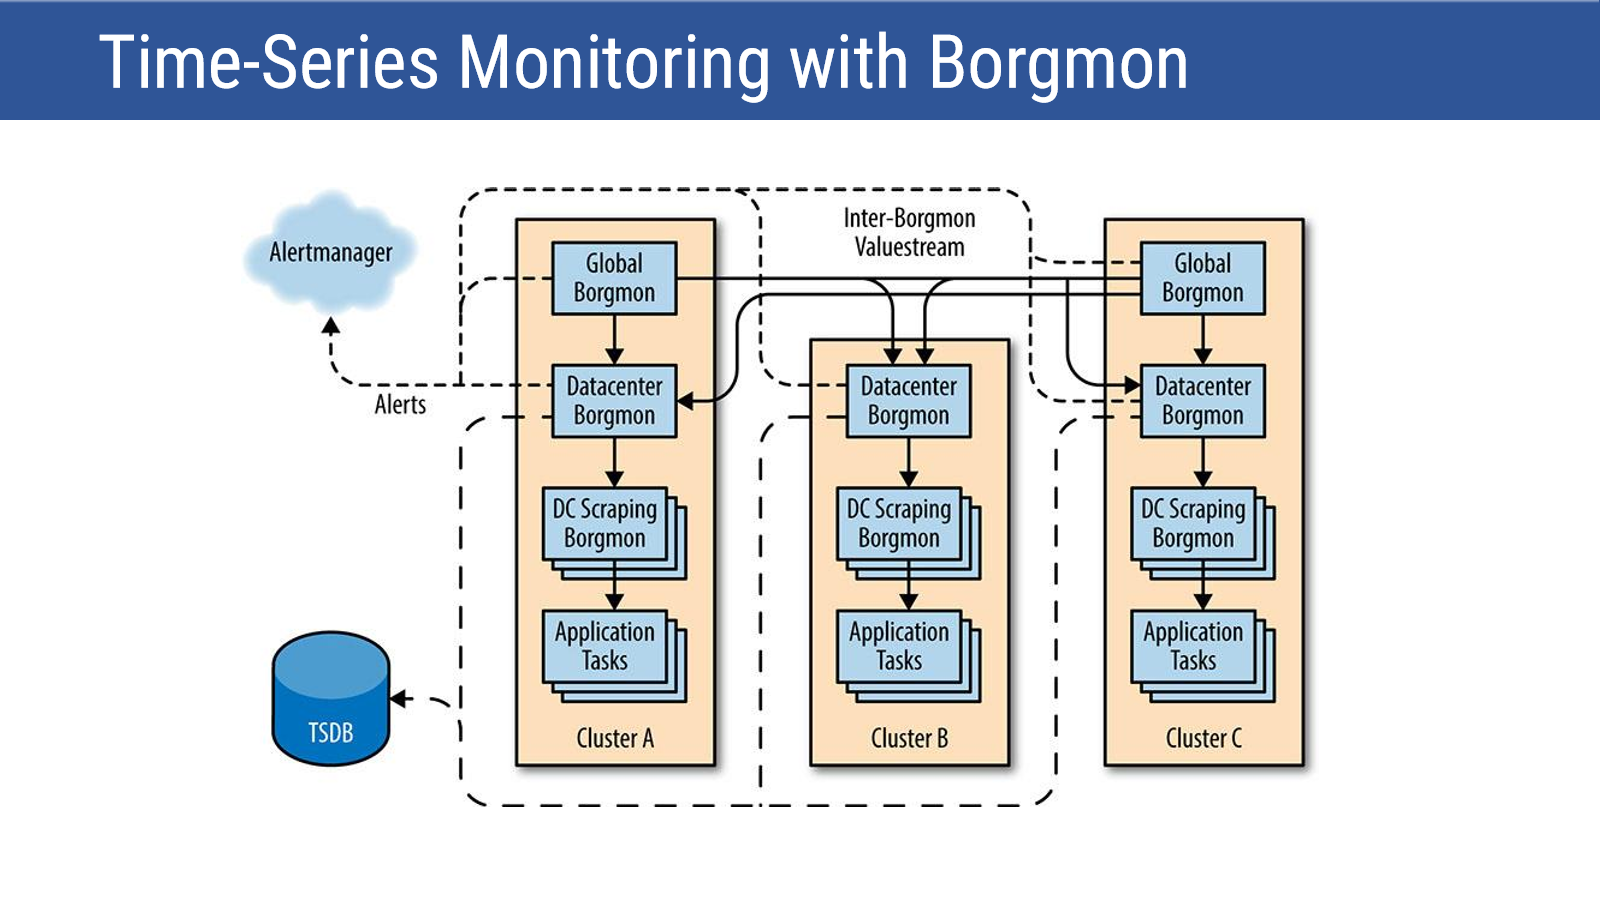
Arsitektur Borgmon berlapis:
- Scraping layer — mengumpulkan metrik dari application tasks.
- Aggregation layer — menghitung metrik tingkat datacenter dan global.
- Alerting layer — mengevaluasi rule dan mengirim alert ke Alertmanager.
- Storage layer — mengarsipkan time-series ke TSDB untuk analisis historis.
Antar cluster (A, B, C) terdapat DC Scraping Borgmon → Datacenter Borgmon → Global Borgmon, saling bertukar data lewat Inter-Borgmon Valuestream, dengan alert dikirim ke Alertmanager dan data historis diarsipkan ke TSDB.
Contoh rule alerting praktis: alert ErrorRatioTooHigh terpicu jika rasio error melebihi 1% selama 10 menit DAN jumlah error absolut melebihi 1/detik, dengan kondisi ini harus benar selama 2 menit (mencegah flapping/alert yang naik-turun berulang), serta alert menyertakan informasi kontekstual (details "webserver error ratio at [[trigger_value]]", labels {severity=page}).
On-Call Engineering
Menyeimbangkan reliability dan kesejahteraan manusia. Karakteristik on-call yang sehat:
- Balanced load — sekitar 50% waktu untuk proyek engineering, bukan hanya operasional.
- Predictable rotation — ada peran on-call primer dan sekunder.
- Adequate staffing — rotasi 6–8 orang (25–33% waktu on-call).
- Psychological safety — blameless postmortem, budaya belajar.
- Playbooks — prosedur terdokumentasi memberi peningkatan 3x pada MTTR (Mean Time To Repair).
Menghindari operational overload: batasi toil maksimal 50% waktu SRE, otomasi task berulang, tolak (push back) pekerjaan manual berlebihan, eskalasi ketika toil melampaui target. Hasil akhirnya: on-call yang berkelanjutan (sustainable) dan tidak menyebabkan burnout.
Release Engineering, CI/CD, dan Safe Change Velocity
Release Engineering
Release engineering berfokus pada membangun dan mengirimkan software. Skillset seorang Release Engineer mencakup: source code management, compiler & konfigurasi build, automated build tools, package manager & installer, configuration management, test integration, dan system administration.
Tanggung jawab inti: memastikan binary dan konfigurasi dibangun dengan cara yang reproducible dan otomatis, sehingga rilis bersifat repeatable, bukan “unique snowflakes” (rilis yang unik dan tidak bisa diulang identik). SRE bergantung pada kepercayaan terhadap proses rilis dari source code hingga deployment.
Empat Prinsip Release Engineering (Filosofi Google)
- Self-Service Model — tim mengontrol proses rilisnya sendiri, keterlibatan engineer minimal (otomatis secara default), dan mampu berskala ke ribuan engineer dan produk.
- High Velocity — rilis yang sering menghasilkan perubahan yang lebih sedikit per versi, sehingga testing dan troubleshooting lebih mudah. Beberapa tim melakukan build per jam, dengan pola “Push on Green” (langsung push begitu test hijau/lulus).
- Hermetic Builds — build tidak sensitif terhadap environment mesin build; bergantung pada versi tools dan library yang diketahui. Revisi yang sama + tools yang sama = binary yang identik.
- Enforcement of Policies — operasi yang di-gate (code review, persetujuan rilis, deployment), audit trail untuk semua perubahan, serta kontrol keamanan dan akses di tiap tahap.
Continuous Build and Deployment (Contoh: Sistem Rapid milik Google)
- Build Process (memakai Blaze/Bazel): mendefinisikan build target dan dependency, dependency dibangun otomatis, ada flag khusus proyek (build ID, revision number), semua binary mendukung flag yang menampilkan metadata build.
- Branching Strategy: branch dibuat dari mainline pada revisi tertentu; branch tidak pernah di-merge kembali ke mainline; bugfix disubmit ke mainline lalu di-cherry-pick ke branch; dengan begitu isi tiap rilis diketahui persis.
- Testing: continuous test system berjalan pada setiap perubahan mainline; test dijalankan ulang pada release branch (termasuk cherry-pick); ada system testing independen atas artifact yang sudah dipaketkan; serta audit trail yang membuktikan semua test lulus.
Alur Kerja Rilis Tipikal (dari Kode ke Produksi)
- Branch Creation — Rapid membuat release branch pada revisi integrasi, biasanya dari continuous test build terakhir yang sukses.
- Build and Test — kompilasi binary (diparalelkan di banyak build server), eksekusi unit test (diparalelkan), keduanya berjalan di environment khusus.
- Packaging — Midas Package Manager (MPM) merakit paket; paket diberi nama, versi dengan hash unik, dan ditandatangani (signed); label diterapkan (dev, canary, production).
- Deployment — kasus sederhana: Rapid memperbarui Borg jobs secara langsung; kasus kompleks: otomasi rollout Sisyphus; rollout dilakukan bertahap (gradual): mulai satu cluster → ekspansi eksponensial.
- Monitoring — laporan semua perubahan sejak rilis terakhir, diarsipkan bersama build artifact, sehingga memungkinkan troubleshooting cepat.
Configuration Management: Empat Model Distribusi Konfigurasi
- Mainline Configuration — mengubah file konfigurasi di head mainline branch; memisahkan rilis binary dari perubahan konfigurasi; risikonya adalah skew (ketidaksesuaian) antara konfigurasi yang tercatat dan yang benar-benar berjalan.
- Config dalam Package yang Sama dengan Binary — binding yang ketat, deployment lebih sederhana, namun fleksibilitasnya terbatas.
- Separate Config Packages — prinsip hermetic diterapkan ke konfigurasi; konfigurasi diversikan bersama binary; bisa diupdate independen dari binary; label dipakai untuk menandai versi yang kompatibel.
- External Config Store — untuk konfigurasi yang sering berubah/dinamis; disimpan di Chubby, Bigtable, atau filesystem berbasis source; dibaca saat runtime.
Best practice: pilih model berdasarkan frekuensi perubahan dan tingkat coupling yang dibutuhkan.
Safe Change Velocity
Realita manajemen perubahan: sekitar 70% outage disebabkan oleh perubahan pada sistem live. Manusia menambah latensi dan error pada respons darurat — engineer “hero” (pahlawan yang bertindak sendiri secara ad hoc) bisa berhasil, tapi engineer yang terlatih dengan playbook bekerja 3x lebih baik.
Otomasi untuk perubahan yang aman:
- Progressive rollouts — canary → ekspansi bertahap.
- Automated detection — monitoring menangkap masalah dengan cepat.
- Safe rollbacks — otomatis kembali ke state yang diketahui baik (known-good state).
Error Budget Governance: kaitkan kecepatan deployment dengan laju pembakaran (burn rate) error budget. Jika error budget habis → perlambat rilis. Jika error budget sehat → tingkatkan kecepatan. Hasilnya: baik kecepatan rilis maupun keamanan sama-sama meningkat.
Canarying dan Phased Rollout (Meminimalkan Blast Radius)
- Canary Deployment: deploy versi baru ke subset kecil server (1–5%), pantau metrik kunci (latency, error, saturation), bandingkan canary dengan baseline; jika sehat lanjutkan, jika tidak rollback.
- Phased Rollout Strategy: mulai dari satu cluster (risiko terendah), ekspansi eksponensial 1% → 5% → 25% → 100%, diselang-seling (interleave) lintas region geografis, dengan jeda (pause) antar fase untuk observasi.
- Automated Rollback Triggers: laju pembakaran SLO melebihi threshold, lonjakan error rate terdeteksi, degradasi latency melebihi toleransi; manual override tetap selalu tersedia.
Feature Flags dan Decoupling
Prinsip kunci: Deploy ≠ Release.
Manfaat feature flag:
- Men-deploy kode tanpa mengaktifkan fitur.
- Menguji di production dengan eksposur terbatas.
- Rollout bertahap ke segmen pengguna tertentu.
- Rollback instan tanpa perlu redeploy.
Implementasi: aktivasi fitur dikendalikan konfigurasi; rollout per-user, per-region, atau berbasis persentase; terikat ke error budget (fitur dimatikan otomatis jika SLO terancam).
Kehati-hatian: hapus flag setelah rollout penuh (hindari technical debt), uji kedua kondisi (enabled dan disabled), dokumentasikan tujuan dan pemilik (owner) flag.
Prinsip DevOps: memisahkan (decouple) risiko deployment dari risiko fitur.
Flashcard
flashcards Apa itu Toil dan sebutkan minimal 5 karakteristiknya. :: Toil adalah task operasional manual, repetitif, automatable, reaktif (dipicu sesuatu), taktis (interrupt-driven), tidak memberi nilai jangka panjang bagi sistem, dan bebannya bertambah seiring pertumbuhan layanan (O(n) with service growth). Apa isi “Aturan 50%” dalam SRE? :: SRE idealnya menghabiskan maksimal 50% waktu untuk toil, sisanya untuk proyek engineering; tugas on-call menjadi batas bawah toil sekitar 25-33%, dengan rata-rata toil aktual di lapangan sekitar 33%. Jelaskan perbedaan white-box monitoring dan black-box monitoring. :: White-box monitoring berdasarkan metrik yang diekspos dari internal sistem (log, instrumentasi, JVM profiling interface); black-box monitoring menguji perilaku yang terlihat dari luar sebagaimana dialami pengguna. Sebutkan Four Golden Signals dalam monitoring SRE. :: Latency, Traffic, Errors, dan Saturation. Apa perbedaan antara “Page” dan “Ticket” sebagai bentuk alert? :: Page membutuhkan respons manusia segera (urgent), sedangkan Ticket membutuhkan respons manusia tetapi tidak segera. Apa itu Hermetic Build dalam Release Engineering ala Google? :: Prinsip build yang tidak sensitif terhadap environment mesin build karena bergantung pada versi tools dan library yang sudah diketahui pasti, sehingga revisi yang sama plus tools yang sama akan selalu menghasilkan binary yang identik. Mengapa sekitar 70% outage disebabkan oleh perubahan pada sistem live, dan bagaimana SRE memitigasinya? :: Karena perubahan (deployment, konfigurasi) adalah sumber risiko utama kegagalan; SRE memitigasinya lewat progressive rollout/canary, automated detection via monitoring, automated rollback ke known-good state, dan menghubungkan kecepatan rilis dengan burn rate error budget. Apa perbedaan konsep antara “Deploy” dan “Release” dalam konteks Feature Flags? :: Deploy adalah menempatkan kode baru ke production tanpa harus mengaktifkan fiturnya; Release adalah mengaktifkan fitur tersebut ke pengguna (via feature flag), sehingga risiko deployment kode bisa dipisahkan dari risiko mengaktifkan fitur baru. Jelaskan strategi Canary Deployment dan Phased Rollout untuk meminimalkan blast radius. :: Canary deployment men-deploy versi baru ke subset kecil server (1-5%) dan membandingkan metriknya dengan baseline sebelum melanjutkan; phased rollout memperluas rilis secara eksponensial (1% → 5% → 25% → 100%) mulai dari satu cluster berisiko rendah, dengan jeda observasi antar fase dan automated rollback jika SLO/error rate/latency memburuk.