Catatan gabungan dua pertemuan berurutan tentang Text Classification (materi 02a-Klasifikasi-Teks.pdf dan 02b-Klasifikasi-Teks-word-representation.pdf) — digabung jadi satu topik karena keduanya memang satu alur utuh: 02b eksplisit berjudul “Text Classification #2: Word Representation” dan membuka dengan mengulang slide penutup 02a (fitur bag-of-words untuk spam filtering), lalu melanjutkan ke soal representasi kata sebagai pengembangan lanjutan dari fitur bag of words yang sudah dibahas di 02a. Mencakup: definisi & karakteristik text classification, studi kasus spam filtering, tahapan preprocessing, feature extraction (bag of words, TF-IDF, mutual information), teknik klasifikasi (Naive Bayes, CNN, RNN), hingga pengantar word representation (one-hot, count-based/SVD, predictive/Word2Vec). Pendalaman lebih lanjut soal HAL/LDA/GloVe dibahas terpisah di Word Representation: HAL, LDA, GloVe untuk menghindari duplikasi.
Apa itu Text Classification?
Text classification adalah task NLP yang memberi label/kategori ke keseluruhan teks/dokumen secara otomatis. Beberapa dimensi yang membedakan variasi task-nya:
- Output: single label vs multi label.
- Text input: short message vs document (teks panjang); user generated content vs formal sentence; teks lengkap vs tidak lengkap (misalnya respons chat yang masih berjalan).
Contoh kontras: SMS promo (“Valued customer, you’ve unlocked an exclusive offer: 20% OFF…”) vs email phishing (“CONGRATULATIONS!! You Have Won $50,000…, Click here to claim…“) — keduanya sama-sama butuh diklasifikasi, tapi karakteristik teksnya (panjang, struktur, formalitas) berbeda.
Studi Kasus: Spam Filtering
Spam filtering mengklasifikasikan teks (SMS, email, chat, media sosial) menjadi dua kelas: Spam vs Not Spam (Ham). Contoh data:
- “Hope you are having a good week. Just checking in” → NOT SPAM
- “K..give back my thanks.” → NOT SPAM
- “complimentary 4 STAR Ibiza Holiday or £10,000 cash needs your URGENT collection. 09066364349 NOW from Landline not to lose out!” → SPAM
Alur Proses Umum
Alur dasarnya: Preprocessing → Feature Extraction → Classification (Rule/Model).
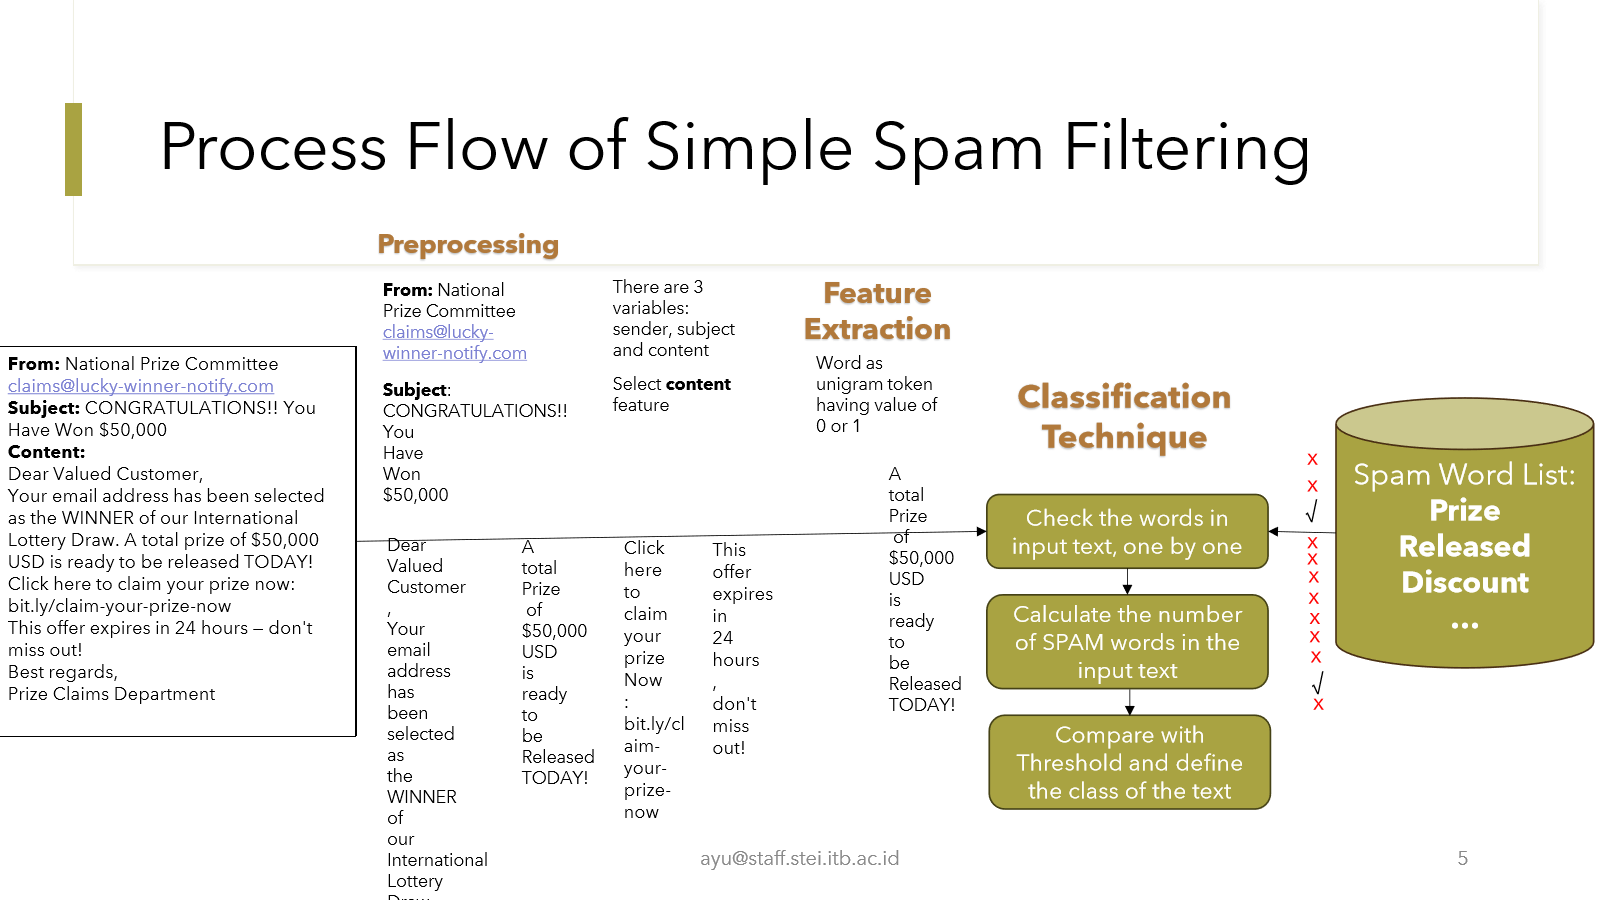
Diagram di atas mengilustrasikan proses spam filtering sederhana secara end-to-end pada sebuah email: teks mentah (from/subject/content) di-preprocessing jadi daftar token per bagian, lalu feature extraction memilih fitur dari bagian content (kata sebagai unigram token, bernilai 1 jika ada/0 jika tidak), kemudian classification technique mengecek kata-kata dalam teks satu per satu terhadap sebuah spam word list (mis. “Prize”, “Released”, “Discount”), menghitung jumlah kata SPAM yang ditemukan, dan membandingkannya dengan sebuah threshold untuk menentukan kelas akhir.
Kelemahan Pendekatan Spam Word List
Pendekatan berbasis daftar kata spam manual punya beberapa kelemahan:
- Kata yang muncul di teks spam bisa jadi kata umum (“this”, “that”, “and”, “or”) → perlu stop word elimination.
- Kata yang muncul di teks spam bisa juga muncul di teks bukan-spam (mis. “hotel”, “price”) → perlu feature selection dengan word weight.
- Urutan kata berbeda bisa menghasilkan label spam yang berbeda meski memakai kata serupa. Contoh:
- “Click here now to claim your free $500 gift card before it expires today!” → SPAM
- “Thanks for shopping with us, here’s a $500 gift card as a thank-you, no action needed” → NOT SPAM
- Daftar kata spam bisa ditulis manual oleh manusia, atau diambil/dipelajari dari corpus.
Preprocessing
Preprocessing mengubah teks input mentah menjadi daftar token yang siap diekstrak fiturnya. Tahapan yang umum dipakai (tidak semua wajib dipakai bersamaan, tergantung task):
- Tokenization — teks dipecah jadi token (biasanya kata).
- Lemmatization — kata diubah ke bentuk lema/akar katanya (mis. writing → write).
- Morphological analyzer — kata dianalisis jadi kata dasar + afiksnya (mis. writing → writ + ing).
- Stemming — kata dipotong ke bentuk stem-nya (mis. writing → writ, memakai algoritma seperti Porter stemmer).
- Lowercase — semua kata diseragamkan huruf kecil.
- Entity masking — kata yang memenuhi pola tertentu (nomor telepon, URL, dsb) di-mask.
- Spelling correction — kata salah eja (termasuk bentuk informal) dikoreksi.
- Word normalization — mis. akronim dinormalisasi ke bentuk penuhnya.
- Stop word elimination — kata-kata umum yang tidak informatif dihapus (daftar stop word bisa ditulis manual, pakai daftar default seperti dari NLTK, atau ditentukan lewat word weight/POS tag — mis. hanya menyisakan Noun/Verb/Adjective untuk keperluan information retrieval). Contoh: “The place is nice but the food is not recommended” → “place nice food recommended”.
Morfologi: Tiga Konsep yang Sering Tertukar
| Konsep | Definisi | Contoh (writing) |
|---|---|---|
| Morphological analyzer | Memecah kata jadi afiks (suffix, prefix, infix) | writ + ing |
| Lemmatization | Mengubah kata ke lema/akar kata (kata dasar yang valid secara gramatikal) | write |
| Stemming | Memotong kata ke bentuk stem (bisa jadi bukan kata valid) | writ |
Morfologi sendiri didefinisikan sebagai studi tentang pembentukan dan struktur internal kata — unit gramatikal paling elementer [Fromkin et al., 2018]. Morfologi juga berkaitan erat dengan POS tag.
Sentence Splitter & Tokenizer
Sentence splitter mengecek apakah token khusus (”.”, ”?”, ”!”) benar-benar menandai akhir kalimat (End of Sentence/EOS) — perlu logika tambahan karena tanda baca ini ambigu (mis. titik pada singkatan “etc.” bukan EOS, tapi titik di akhir kalimat setelahnya adalah EOS).
Tokenizer memecah kalimat jadi token. Untuk Inggris/Indonesia, delimiter yang umum dipakai adalah spasi (bisa dengan tool sederhana seperti tr di command line). Namun untuk bahasa yang tidak memisah kata dengan spasi (mis. Mandarin) atau bahasa dengan noun compound panjang (mis. Jerman: Lebensversicherungsgesellschaftsangestellter = “pegawai perusahaan asuransi jiwa”), dibutuhkan teknik khusus bernama word segmentation.
Maximum Matching adalah algoritma baseline standar (disebut greedy) untuk word segmentation:
- Pointer dimulai dari awal string/kalimat.
- Cari kata terpanjang dalam kamus yang cocok dengan input string dimulai dari posisi pointer.
- Pindahkan pointer ke karakter terakhir dari kata kamus yang ditemukan.
- Ulangi ke langkah 2.
Contoh: Thecatinthehat → the cat in the hat. Algoritma yang sama dipakai untuk memecah teks Mandarin tanpa spasi menjadi token per kata.
Feature Extraction
Vectorization adalah proses mengubah fitur token menjadi angka, supaya bisa diproses algoritma machine learning.
Bag of Words
Contoh pada unigram word sebagai fitur token untuk spam filtering: teks “complimentary Ibiza Holiday needs your URGENT collection” → daftar token complimentary, ibiza, holiday, needs, your, urgent, collection → direpresentasikan sebagai baris tabel fitur (1 jika kata itu ada di teks, 0 jika tidak), dengan kolom Class sebagai label target. Selain unigram, fitur lain yang mungkin dipakai: bigram (mis. “complimentary Ibiza”, “Ibiza Holiday”) dan trigram.
Representasi bag of words ini juga bisa dilihat sebagai matrix Term × Document (baris = term, kolom = dokumen), yang membentuk Vector Space Model — tiap dokumen menjadi satu titik/vektor dalam ruang berdimensi sejumlah term. Nilai selnya bisa berupa Boolean (1/0, ada/tidak), TF (term frequency), atau TF×IDF.
Mengurangi Jumlah Fitur
Dengan vocabulary yang besar, jumlah fitur bisa meledak. Cara mengurangi:
- Lemmatization, Stemming.
- Stop Word Elimination.
- Hanya pilih term dengan skor tinggi dari:
- TF × IDF: , di mana = frekuensi term pada dokumen , = jumlah dokumen yang mengandung term , = total dokumen. Variasi idf: atau .
- Mutual Information (MI): , di mana = jumlah dokumen berlabel, = jumlah kata dengan label , = jumlah kata tanpa label , = jumlah dokumen berlabel tanpa term .
Classification: dari Naive Bayes hingga Neural Network
Setelah data ditransformasi jadi fitur (bag of words) dan label, tahap NLP Model Training memakai algoritma machine learning untuk membangun model klasifikasi — contoh: SVM, Neural Network, XGBoost, Decision Tree, Naive Bayes.
Contoh Implementasi: Text Classification dengan Naive Bayes (scikit-learn)
from sklearn.feature_extraction.text import CountVectorizer
from nltk.tokenize import RegexpTokenizer
token = RegexpTokenizer(r'[a-zA-Z0-9]+')
cv = CountVectorizer(lowercase=True, stop_words='english', ngram_range=(1,1), tokenizer=token.tokenize)
text_counts = cv.fit_transform(data['text'])

from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(text_counts, data['label'], test_size=0.1, random_state=1)

from sklearn.naive_bayes import MultinomialNB
from sklearn import metrics
clf = MultinomialNB().fit(x_train, y_train)
predicted = clf.predict(x_test)
print("MultinomialNB Accuracy:", metrics.accuracy_score(y_test, predicted))
# MultinomialNB Accuracy: 0.982078853046595
Alurnya: Tokenizer (RegexpTokenizer) → Vectorization (CountVectorizer, menghasilkan bag-of-words dengan stop word removal bawaan) → NLP Model Training (MultinomialNB).
CNN untuk Text Classification
Yoon Kim (2014), “Convolutional neural network for sentence classification” (EMNLP 2014), memperkenalkan arsitektur CNN untuk klasifikasi kalimat:
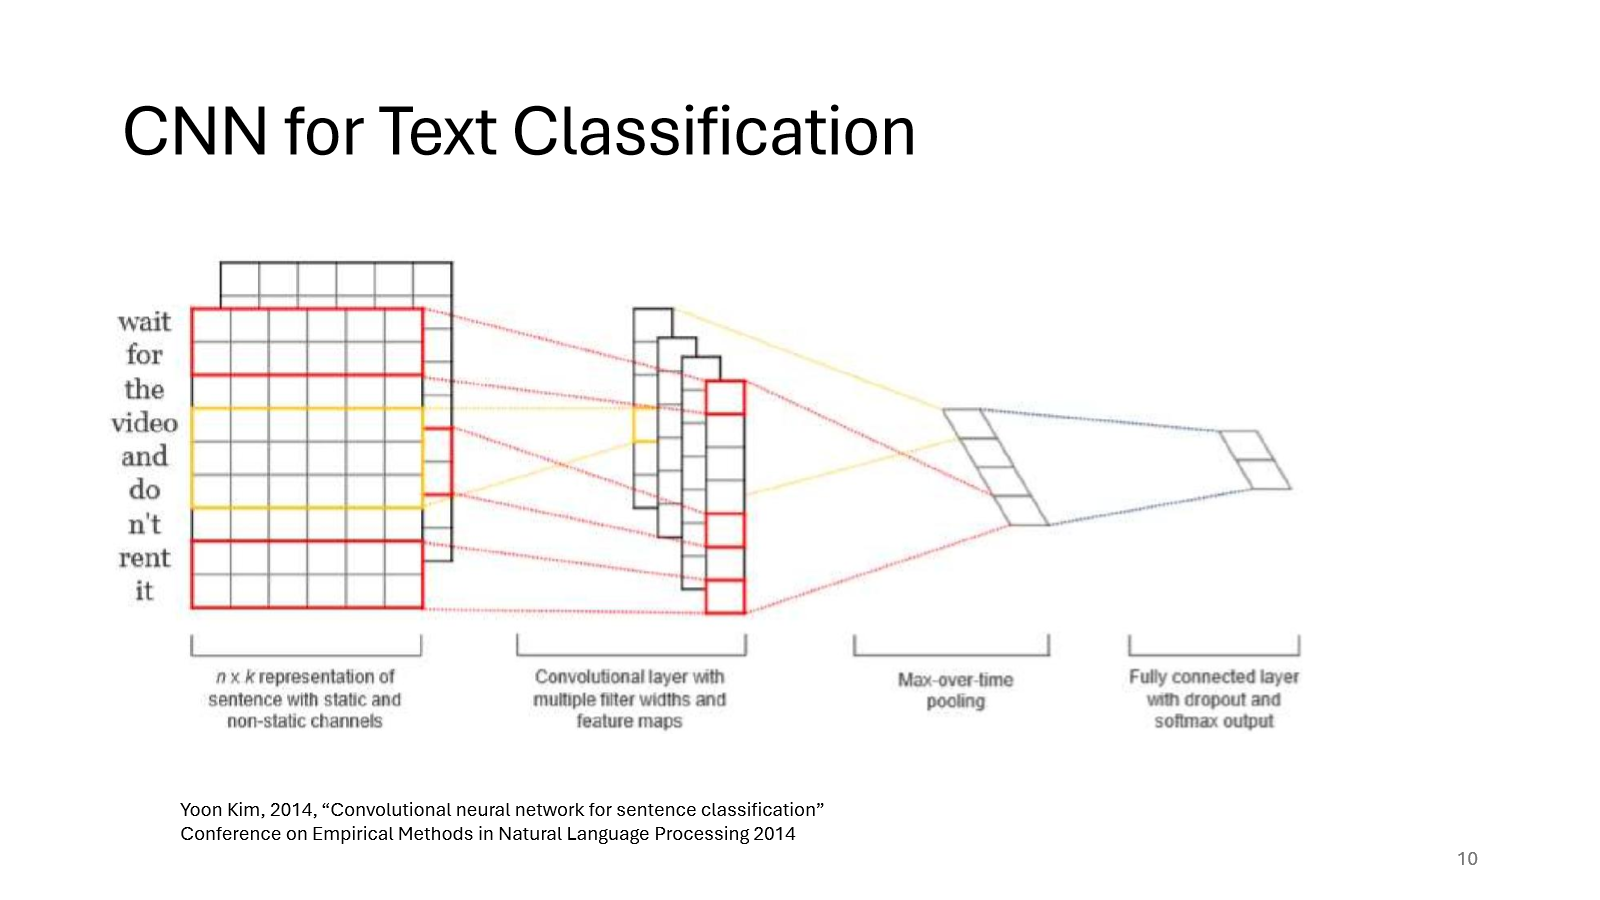
Arsitekturnya: kalimat direpresentasikan sebagai matriks (tiap baris = vektor representasi satu kata, dengan static dan non-static channel) → convolutional layer dengan berbagai lebar filter menghasilkan feature map → max-over-time pooling meringkas tiap feature map jadi satu nilai → fully connected layer dengan dropout dan softmax menghasilkan output klasifikasi.
RNN untuk Text Classification
Pendekatan lain memakai RNN/LSTM yang memproses kalimat kata-per-kata secara sekuensial (pola many-to-one: banyak input token, satu output di akhir sequence) — representasi tiap kata (mis. one-hot [0,1,..,0]) dialirkan lewat rangkaian sel LSTM, dan output akhir dipakai sebagai representasi untuk klasifikasi (Nowak et al., “LSTM Recurrent Neural Network for Short Text and Sentiment Classification”, ICAISC 2017).
Dari Bag of Words ke Word Representation
Bag of words punya keterbatasan mendasar: setiap token hanya direpresentasikan sebagai satu skor (1 dokumen = 1 vektor skor kata), sehingga tidak ada cara membedakan kata yang mirip makna/sinonim satu sama lain — dua kata berbeda selalu dianggap independen. Solusinya adalah representasi di mana satu token direpresentasikan sebagai satu vektor angka (bukan satu skor tunggal), sehingga kata-kata yang mirip makna akan punya jarak vektor yang lebih kecil.
Taksonomi Word Representation Model
- One-hot representation — tiap kata direpresentasikan sebagai vektor berisi satu angka 1 (pada posisi/index kata tersebut) dan 0 di posisi lainnya. Tidak menangkap kemiripan makna antar kata sama sekali.
- Distributed Representation:
- Count-based model — dibangun dari matriks co-occurrence term × term (dalam jendela/window kata) atau term × context, lalu dilakukan dimensional reduction (mis. Singular Value Decomposition/SVD).
- Predict-based model (Word Embedding) — vektor kata dipelajari lewat proses prediksi:
- Tanpa konteks (representasi tetap per kata, tidak berubah sesuai kalimat): word2vec, GloVe, fastText.
- Dengan konteks (representasi kata berubah tergantung kalimat tempatnya muncul): BERT, XLNet, ELMo.
Detail lengkap tentang metode count-based (HAL) dan pendekatan hybrid (LDA, GloVe) — termasuk contoh perhitungan numerik lengkap — dibahas di catatan terpisah Word Representation: HAL, LDA, GloVe, supaya tidak duplikasi. Bagian di bawah ini fokus pada SVD/Latent Semantic Indexing dan pengantar Word2Vec, yang memang dibahas langsung dalam konteks text classification pada materi ini.
Singular Value Decomposition (SVD) / Latent Semantic Indexing
Latent Semantic Indexing/Analysis (LSI/LSA) merepresentasikan term dan dokumen sebagai vektor dalam sebuah ruang “makna laten” (latent semantic space) berdimensi lebih rendah, hasil dekomposisi matriks term-dokumen memakai SVD.
Rumus dekomposisi:
- U: kolomnya adalah eigenvector dari — dipakai untuk memetakan term.
- V: kolomnya adalah eigenvector dari — dipakai untuk memetakan dokumen.
- S: matriks diagonal berisi singular value (akar dari eigenvalue atau ), diurutkan dari terbesar ke terkecil.
Setelah dekomposisi, input baru (query atau dokumen ) dipetakan ke latent space yang sama lewat: dan .
Contoh Perhitungan Numerik
Diberikan matriks term-dokumen , maka .
- Eigenvalue & singular value dari : , sehingga , . Singular value , .
- Eigenvector dari (untuk V): dari diperoleh ; setelah dinormalisasi, .
- Eigenvector dari (untuk U) dihitung dengan cara serupa.
Hasil akhir: , , . Setiap instance data (dokumen sebagai vektor kata) selanjutnya ditransformasi ke vektor baru lewat rumus di atas.
Word2Vec: Pengantar
Word2Vec (Mikolov et al., 2013 — “Efficient Estimation of Word Representations in Vector Space” dan “Distributed Representations of Words and Phrases and their Compositionality”) dibangun di atas gagasan distributional hypothesis: kata-kata yang mirip cenderung muncul dalam konteks yang mirip.
Contoh window konteks: pada kalimat “The fluffy dog barked as it chased a cat”, kata “dog” (input) punya context window {fluffy, barked, it}. Prinsip ini memungkinkan relasi aljabar antar vektor kata, contoh klasik: .
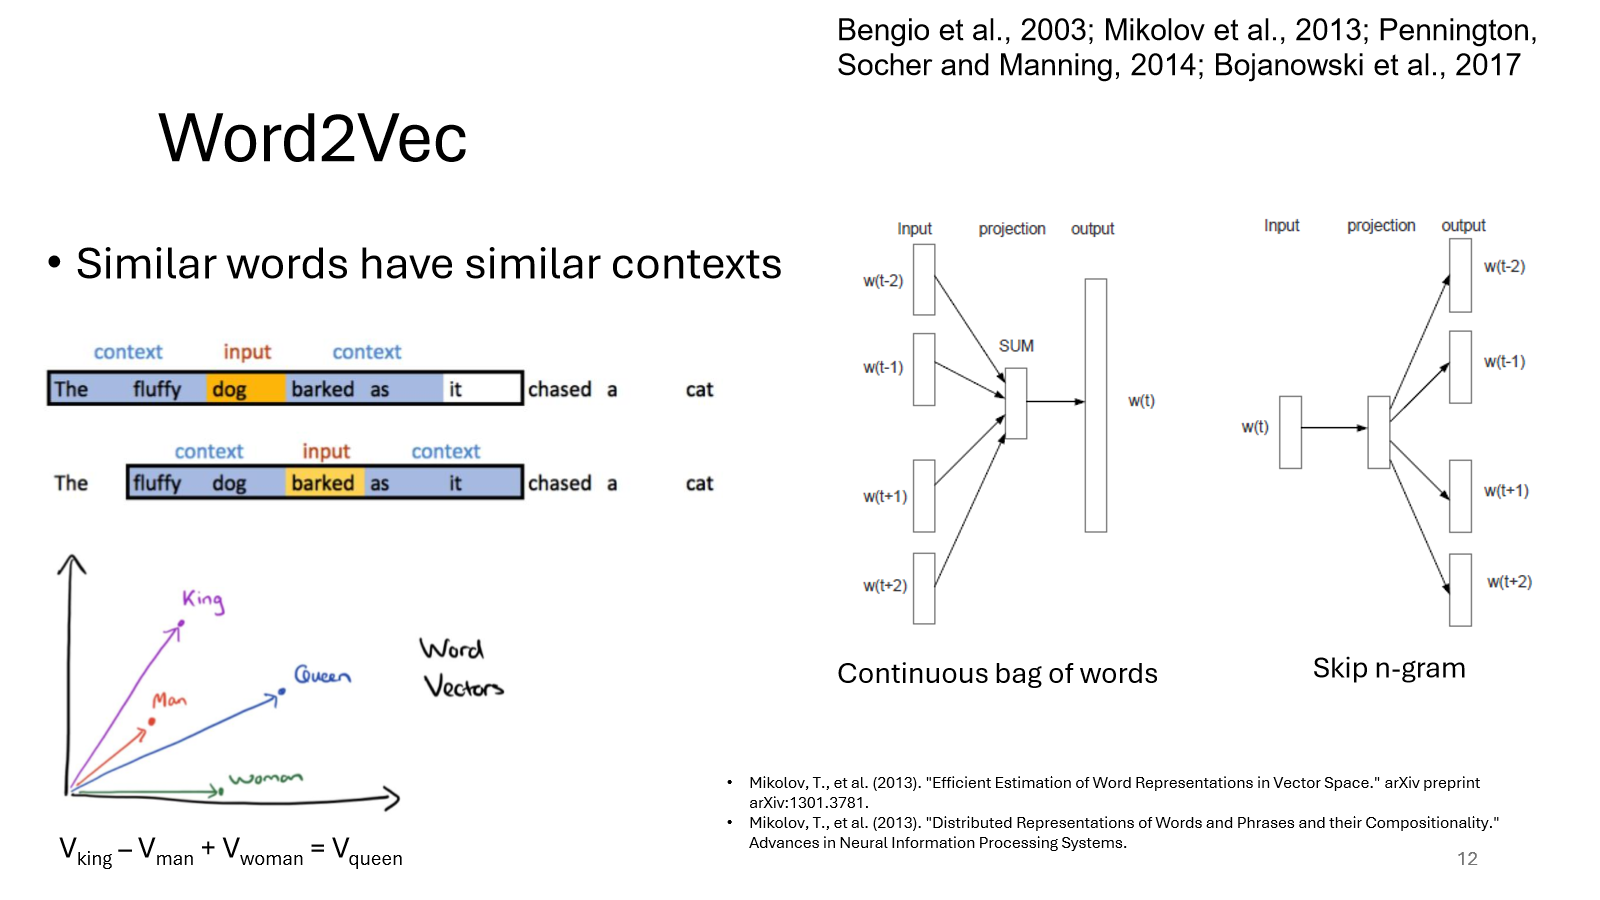
Dua arsitektur utama Word2Vec:
- Continuous Bag of Words (CBOW) — memprediksi kata target dari kata-kata konteks di sekitarnya (), dijumlahkan (SUM) pada layer proyeksi.
- Skip-gram — kebalikannya: dari satu kata target , memprediksi kata-kata konteks di sekitarnya.
Pada Skip-gram, secara konkret: input berupa one-hot vector kata target (mis. dimensi 10.000 kata) dikalikan hidden layer weight matrix (mis. 300 neuron) — matriks bobot inilah yang setelah training menjadi word vector lookup table. Output layer menghasilkan probabilitas tiap kata dalam corpus untuk muncul di posisi berdekatan (kontekstual) dengan kata input — dengan cara memprediksi hubungan kedekatan antar kata secara tidak langsung, model justru “belajar” relasi semantik antar kata.
Sumber
- Materi kuliah IF5153 Advanced Natural Language Processing, topik Text Classification #1 & #2 (Ayu Purwarianti).
- Yoon Kim (2014), “Convolutional Neural Network for Sentence Classification”, EMNLP 2014.
- Nowak J., et al. (2017), “LSTM Recurrent Neural Network for Short Text and Sentiment Classification”, ICAISC 2017.
- Mikolov, T., et al. (2013), “Efficient Estimation of Word Representations in Vector Space”, arXiv:1301.3781.
- Mikolov, T., et al. (2013), “Distributed Representations of Words and Phrases and their Compositionality”, NeurIPS.
Flashcard
flashcards Sebutkan tiga dimensi yang membedakan variasi task text classification :: Output (single label vs multi label), jenis text input (short message vs document panjang; user generated content vs formal sentence), dan kelengkapan teks (lengkap atau tidak, misal respons chat yang masih berjalan). Sebutkan tiga kelemahan pendekatan spam filtering berbasis daftar kata spam manual :: Kata di teks spam bisa berupa kata umum (this/that/and/or) sehingga butuh stop word elimination; kata di teks spam bisa juga muncul di teks bukan-spam sehingga butuh feature selection dengan word weight; dan urutan kata berbeda bisa menghasilkan label berbeda meski memakai kata yang mirip. Jelaskan perbedaan antara morphological analyzer, lemmatization, dan stemming, dengan contoh kata “writing” :: Morphological analyzer memecah kata jadi afiks (writ+ing), lemmatization mengubah ke lema/kata dasar valid gramatikal (write), stemming memotong ke bentuk stem yang bisa jadi bukan kata valid (writ). Apa itu Maximum Matching dan untuk apa algoritma ini dipakai? :: Maximum Matching adalah algoritma greedy baseline untuk word segmentation: dari posisi pointer, cari kata terpanjang di kamus yang cocok dengan input, lalu pindahkan pointer ke akhir kata tersebut, ulangi. Dipakai untuk memecah teks yang tidak memakai spasi sebagai pemisah kata, misalnya bahasa Mandarin. Tuliskan rumus TF x IDF beserta dua variasi rumus idf yang disebutkan di materi :: w(x,y) = tf(x,y) x log(N/df_x), dengan dua variasi idf: idf = 1/df, atau idf = log(N/df). N = total dokumen, df_x = jumlah dokumen yang mengandung term x. Apa keterbatasan mendasar representasi bag of words yang mendorong munculnya word representation (word embedding)? :: Bag of words merepresentasikan tiap token hanya sebagai satu skor tunggal, sehingga tidak bisa membedakan atau menangkap kemiripan makna/sinonim antar kata — dua kata berbeda selalu dianggap independen, padahal idealnya kata yang mirip makna punya jarak vektor yang lebih kecil. Sebutkan taksonomi word representation model: one-hot vs distributed (count-based vs predict-based) :: One-hot: tiap kata = vektor berisi satu angka 1 pada posisi index-nya. Distributed - count-based: dari matriks co-occurrence term x term/context, direduksi dimensinya (misal via SVD). Distributed - predict-based (word embedding): dipelajari lewat prediksi, tanpa konteks (word2vec, GloVe, fastText) atau dengan konteks (BERT, XLNet, ELMo). Pada SVD/LSI, apa peran matriks U, V, dan S dalam dekomposisi A = U S V^T? :: U berisi eigenvector dari AA^T dan dipakai memetakan term; V berisi eigenvector dari A^TA dan dipakai memetakan dokumen; S adalah matriks diagonal berisi singular value (akar eigenvalue A^TA atau AA^T) yang diurutkan dari terbesar ke terkecil. Apa perbedaan arsitektur CBOW dan Skip-gram pada Word2Vec? :: CBOW memprediksi kata target dari kata-kata konteks di sekitarnya (beberapa input dijumlahkan di layer proyeksi untuk memprediksi satu output). Skip-gram melakukan kebalikannya: dari satu kata target, memprediksi kata-kata konteks di sekitarnya. Apa makna relasi vektor V_king - V_man + V_woman = V_queen pada Word2Vec? :: Relasi ini menunjukkan bahwa word2vec menangkap hubungan semantik/analogis antar kata dalam bentuk operasi aljabar vektor - arah dan jarak antar vektor kata mencerminkan relasi makna (di sini relasi gender-royalti), bukan sekadar kemiripan. Pada arsitektur CNN Yoon Kim (2014) untuk text classification, apa fungsi max-over-time pooling? :: Max-over-time pooling meringkas setiap feature map hasil convolutional layer (dengan berbagai lebar filter) menjadi satu nilai, sebelum diteruskan ke fully connected layer dengan dropout dan softmax untuk menghasilkan output klasifikasi akhir.