0Catatan dari materi 1728450360169_03-contextual_DL.pdf dan 1790573162739_5-Transformer-Encoder.pdf, membahas Transformer dan BERT — melanjutkan alur representasi kata dari Word Representation: HAL, LDA, GloVe dan taksonomi word embedding “dengan konteks” yang disinggung di Klasifikasi Teks (BERT, XLNet, ELMo). Sesuai silabus poin (3) — Transfer Learning (Transformer based Encoder/Decoder).
Motivasi
Model sequence-to-sequence sebelumnya (RNN/LSTM, lihat 2_Klasifikasi_Teks) memproses kata satu per satu secara sekuensial — kata ke- baru bisa diproses setelah kata ke- selesai. Transformer dirancang untuk menghilangkan komputasi sekuensial ini, sehingga proses training bisa diparalelkan dan jadi jauh lebih cepat.
Arsitektur Umum: Encoder-Decoder
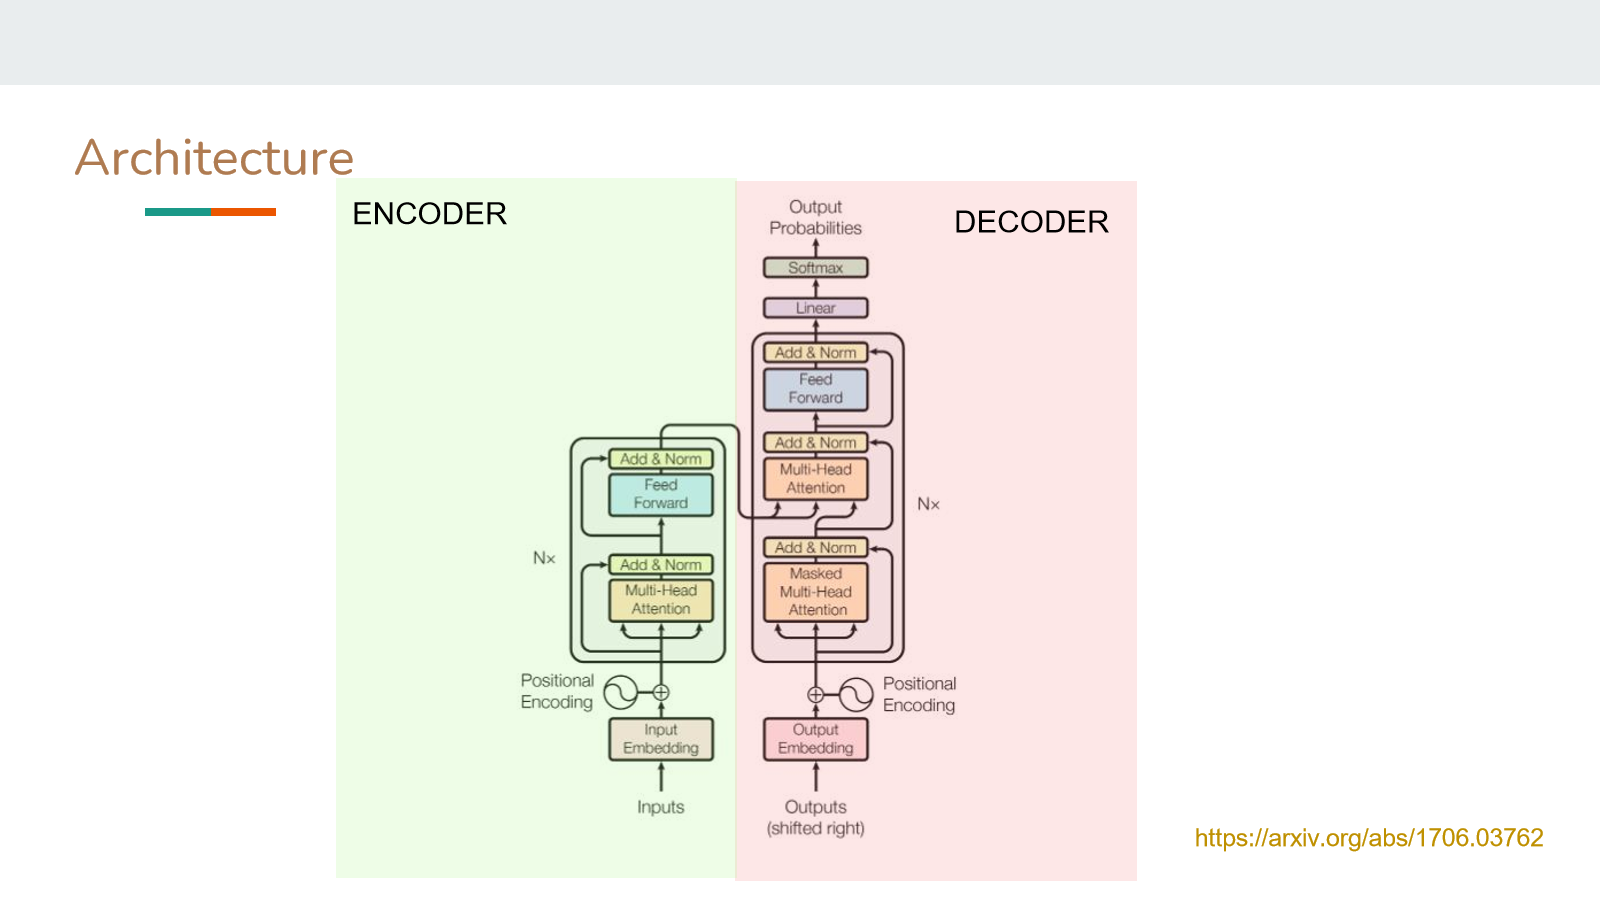
Transformer terdiri dari dua blok besar:
- Encoder (kiri, hijau) — membaca seluruh kalimat input sekaligus (bukan satu per satu), diulang (ditumpuk beberapa layer).
- Decoder (kanan, merah) — menghasilkan kalimat output token demi token, juga ditumpuk .
Setiap blok encoder berisi Multi-Head Attention → Add & Norm → Feed Forward → Add & Norm (koneksi residual di tiap sub-layer). Setiap blok decoder punya struktur serupa tapi dengan tambahan Masked Multi-Head Attention di awal dan satu Multi-Head Attention tambahan yang menghubungkan ke output encoder.
Ilustrasi lain dari sudut pandang “kotak hitam”: satu kalimat input (“Je suis étudiant”) mengalir lewat tumpukan encoder, lalu representasi akhirnya dipakai oleh setiap blok decoder untuk membangkitkan output (“I am a student”) kata demi kata.
Tokenizer
Sebelum masuk ke embedding, teks mentah harus dipecah jadi token dulu lewat tokenizer. Beberapa skema tokenizer yang umum dipakai model berbeda:
- BERT — memakai WordPiece (dari paper “Japanese and Korean Voice Search”): kata dipecah jadi sub-word, mis. kata di luar vocabulary dipecah jadi potongan yang diawali
##(capitalization→capital+##ization). - GPT-2 — memakai BPE (Byte Pair Encoding) (dari paper “Neural machine translation of rare words with subword units”): subword digabung berdasarkan pasangan karakter/byte yang paling sering muncul bersama.
- Flan-T5 — memakai SentencePiece: tokenizer yang language-independent, tidak bergantung pada spasi sebagai pemisah kata (cocok untuk bahasa tanpa spasi eksplisit seperti Jepang).
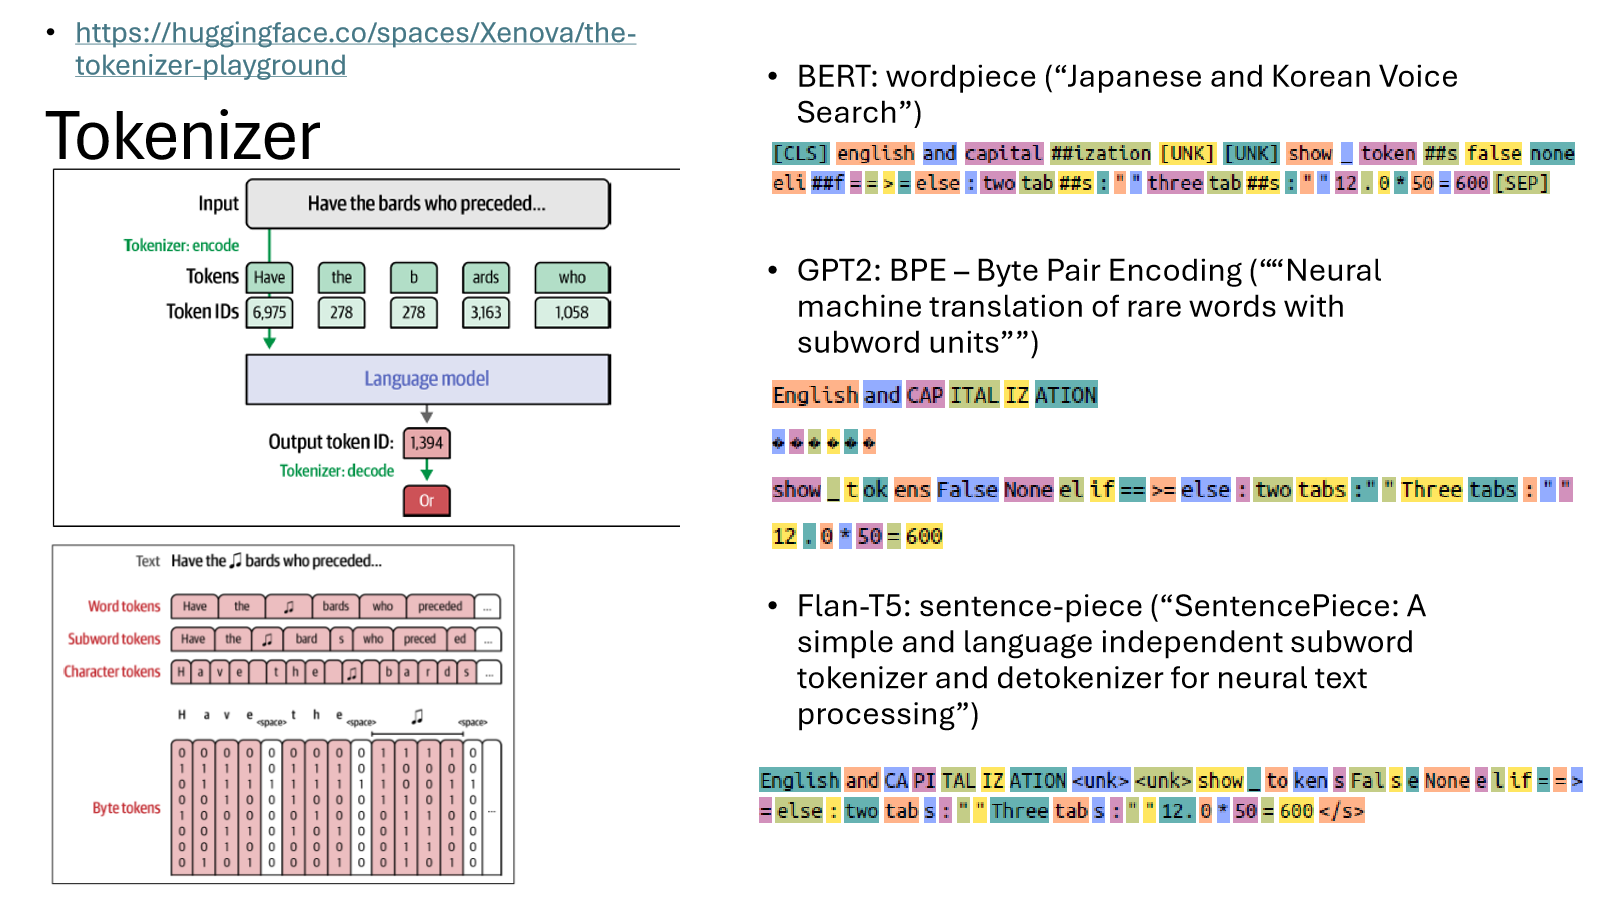
Granularitas tokenisasi sendiri berjenjang: word token (utuh per kata) → subword token (dipecah jadi potongan lebih kecil, mis. WordPiece/BPE) → character token (per huruf) → byte token (representasi biner tiap karakter). Subword adalah titik tengah yang populer: cukup granular untuk menangani kata di luar vocabulary (out-of-vocabulary), tapi tidak se-mahal representasi karakter/byte.
Dari Token ke Index
Setelah teks dipecah jadi token, tiap token dipetakan ke ID numerik lewat lookup ke vocabulary (tabel token → ID). Contoh vocabulary kecil:
| Token | ID |
|---|---|
[PAD] | 0 |
[UNK] | 1 |
| I | 2 |
| love | 3 |
| NLP | 4 |
| AI | 5 |
Maka ["I", "love", "NLP"] → [2, 3, 4]. ID hanyalah index baris token dalam vocabulary — tidak ada makna semantik apa pun pada angka itu sendiri (ID 4 tidak “lebih besar maknanya” dari ID 2).
Dari Index ke Vector
ID token lalu dipakai untuk lookup ke embedding matrix (berukuran jumlah vocabulary × dimensi embedding) — setiap baris matriks ini adalah vektor embedding untuk satu token. Contoh embedding matrix (6 token vocabulary, 4 dimensi):
| ID | dim-1 | dim-2 | dim-3 | dim-4 |
|---|---|---|---|---|
0 ([PAD]) | 0.1 | 0.2 | 0.3 | 0.4 |
1 ([UNK]) | 0.2 | 0.1 | 0.4 | 0.3 |
| 2 (I) | 1 | 0 | 1 | 0 |
| 3 (love) | 0 | 1 | 0 | 1 |
| 4 (NLP) | 1 | 1 | 0 | 0 |
| 5 (AI) | 0.5 | 0.5 | 0.5 | 0.5 |
Hasil lookup untuk ["I", "love", "NLP"] adalah matriks berisi , , — berukuran 3 token × 4 dimensi. Nilai embedding matrix ini dipelajari saat training, sama seperti bobot-bobot lain di jaringan (bukan nilai tetap yang ditentukan manual).
Input Embedding & Positional Encoding
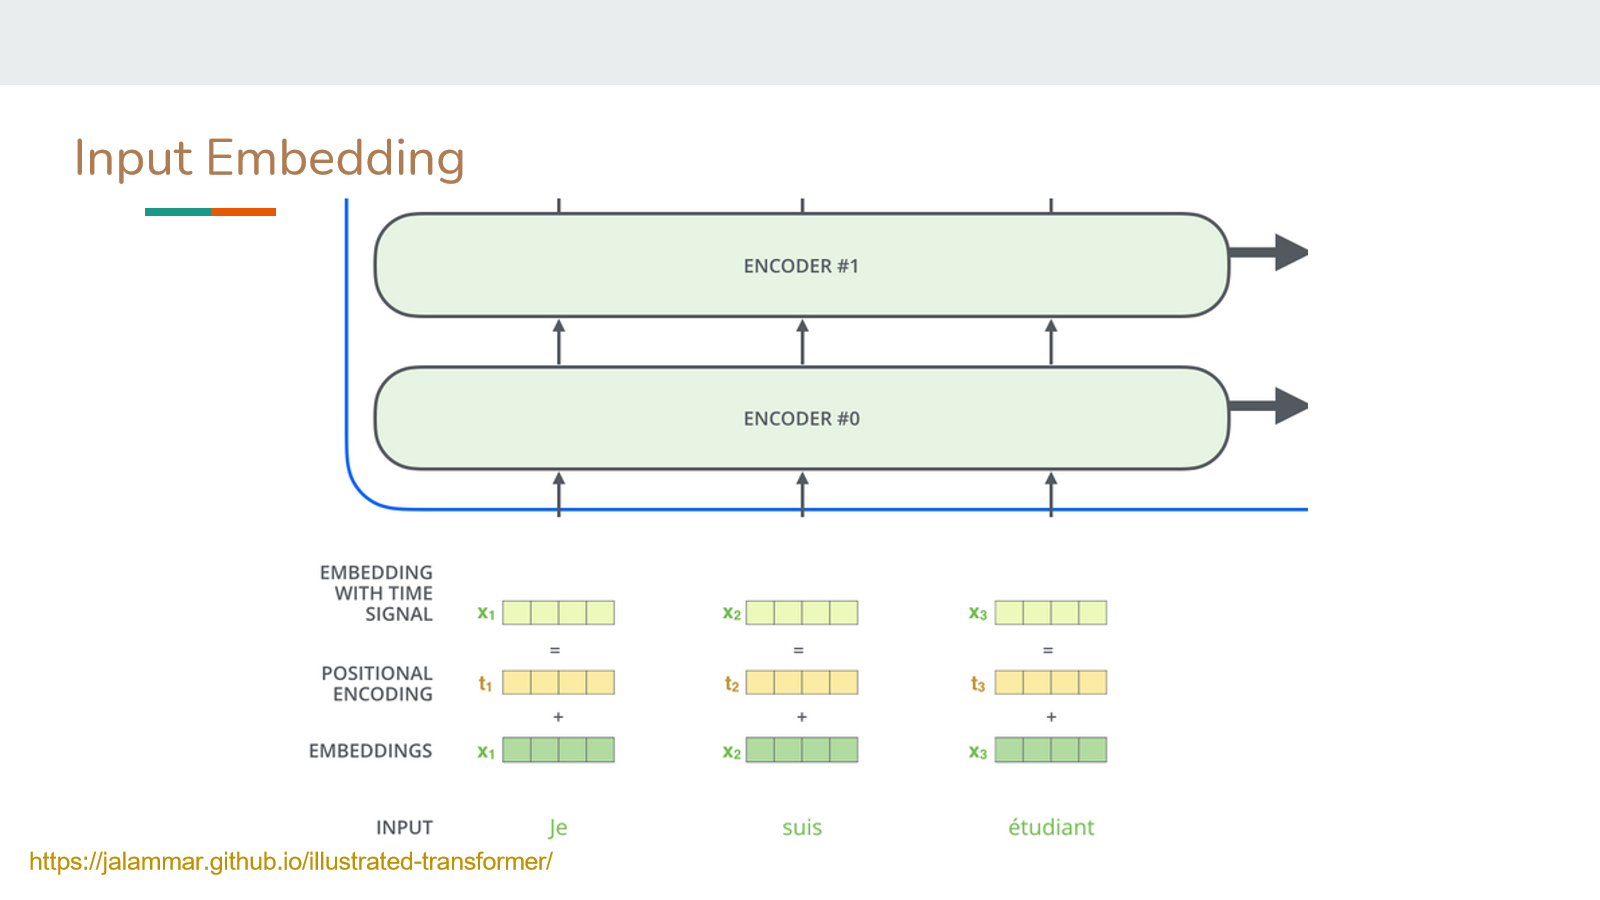
Karena Transformer tidak memproses kata secara sekuensial, ia tidak tahu urutan kata secara bawaan (tidak seperti RNN yang urutan prosesnya otomatis merepresentasikan posisi). Untuk itu, ke setiap embedding kata ditambahkan positional encoding — vektor yang mengkodekan posisi kata dalam kalimat — lewat penjumlahan elemen-wise (bukan konkatenasi).
Rumus positional encoding (Vaswani et al., 2017): untuk posisi dan dimensi encoding ,
Jadi tiap posisi dikodekan sebagai gabungan sinus dan cosinus pada frekuensi yang berbeda-beda (indeks genap pakai sin, ganjil pakai cos) — hanya berlaku untuk input encoder di layer paling bawah; layer-layer di atasnya menerima output layer sebelumnya secara langsung (tidak perlu embedding/positional encoding lagi).
Encoder: Self-Attention
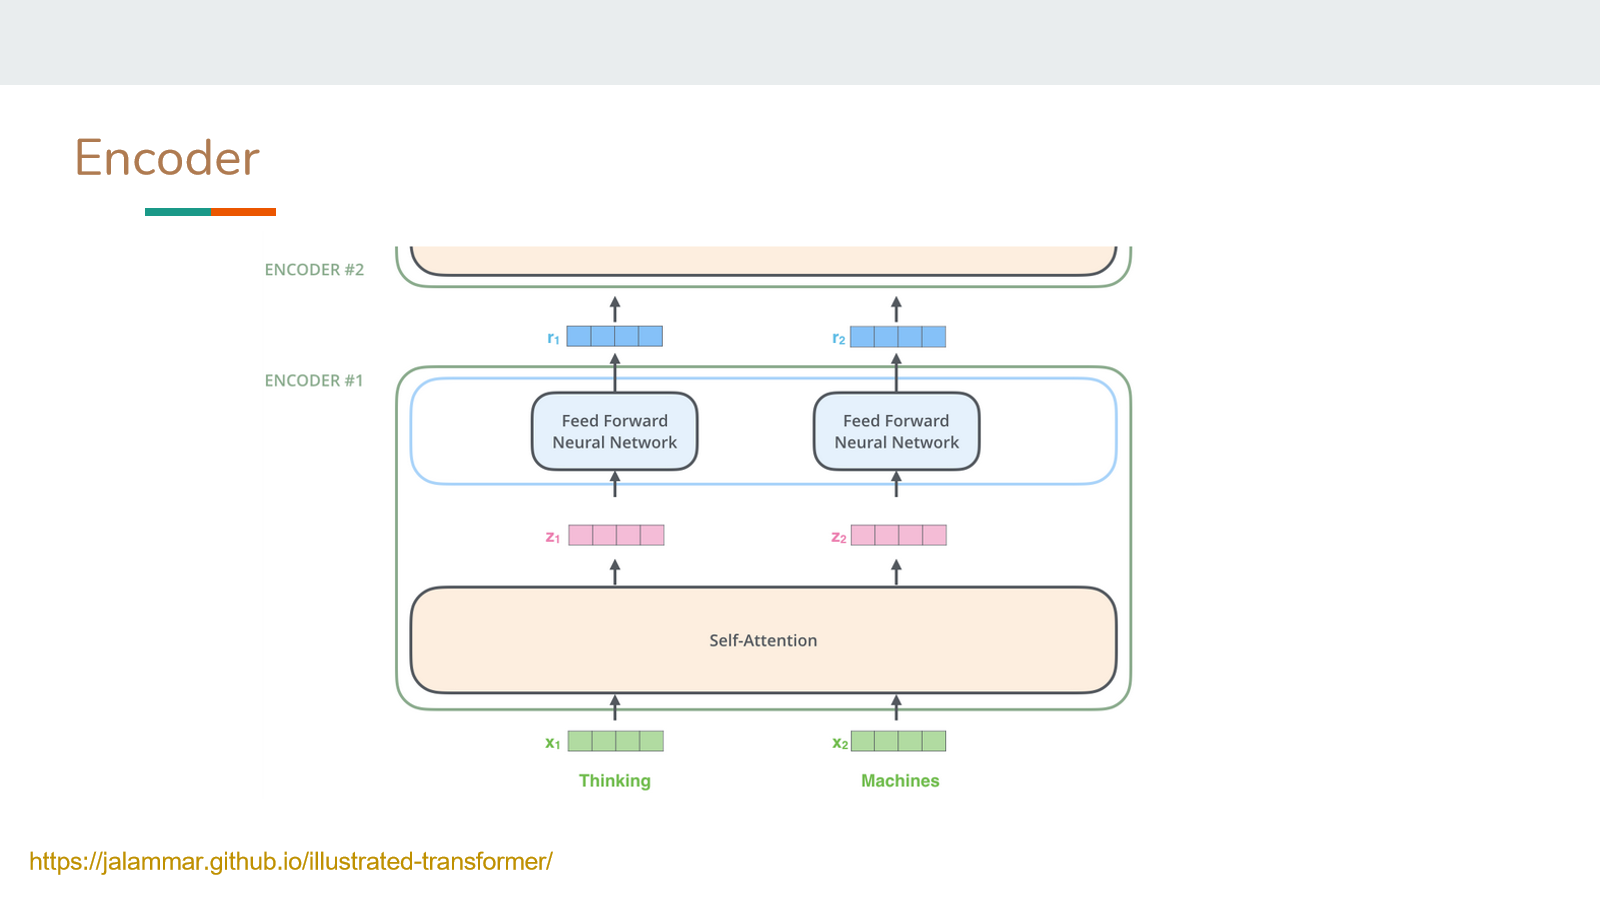
Di dalam satu blok encoder, setiap kata (mis. “Thinking”, “Machines”) diproses lewat self-attention dulu (menghasilkan vektor ), baru diteruskan ke feed forward neural network yang sama untuk tiap posisi (menghasilkan ).
Intuisi Self-Attention
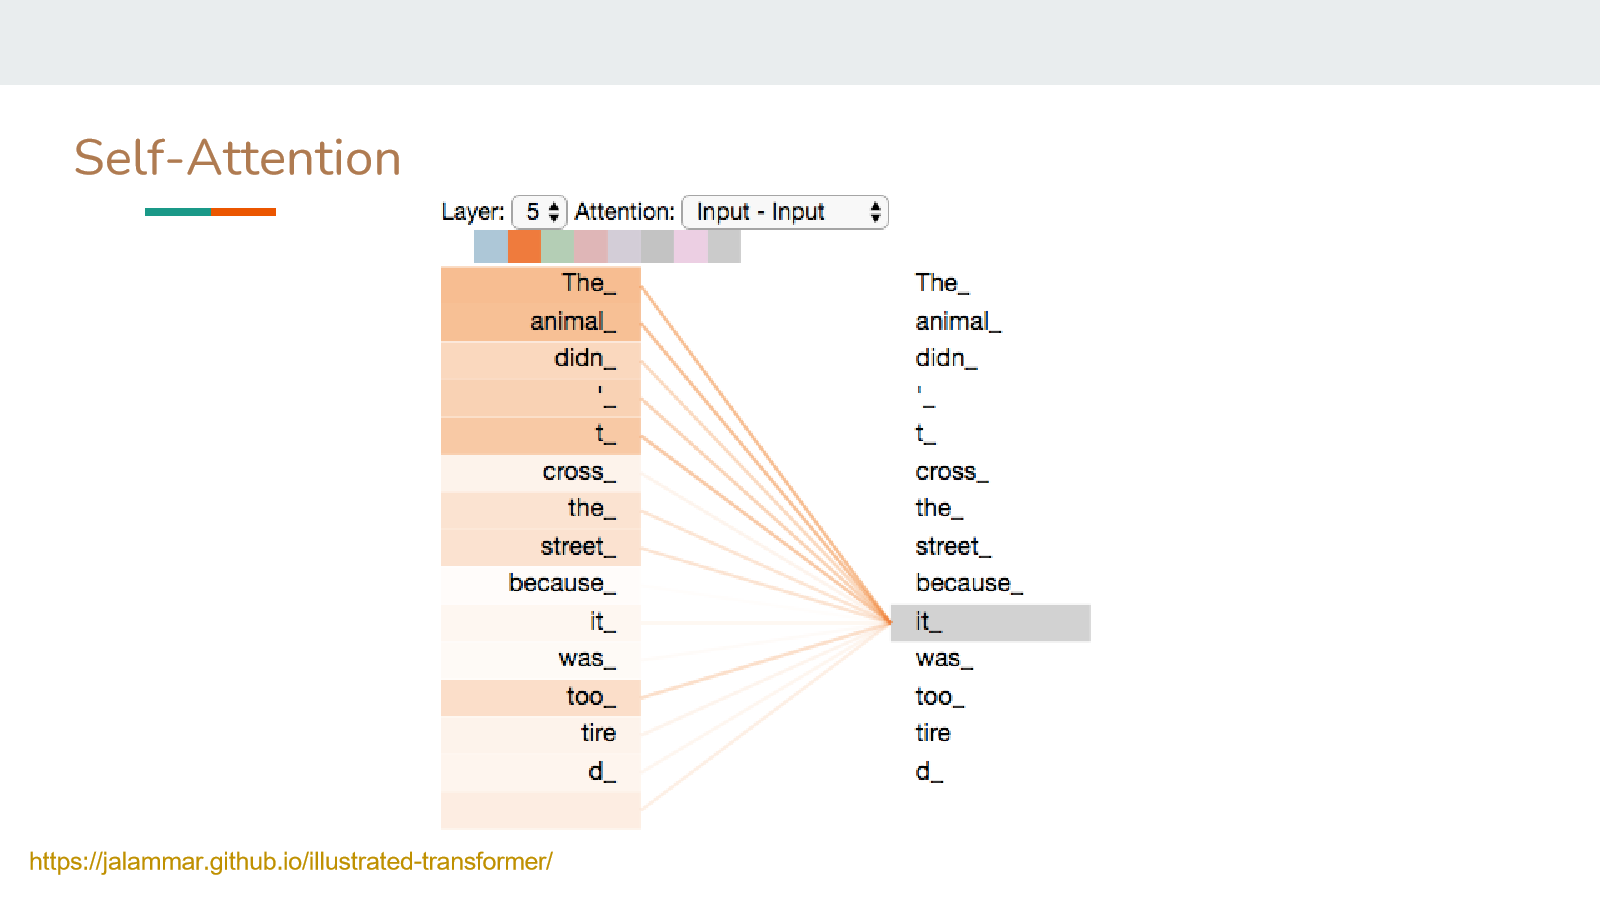
Self-attention membiarkan model “melihat” kata lain dalam kalimat yang sama untuk membantu mengkodekan makna suatu kata. Contoh: pada kalimat “The animal didn’t cross the street because it was too tired”, kata “it” secara linguistik ambigu — bisa merujuk “animal” atau “street”. Visualisasi attention weight di atas menunjukkan model justru memberi bobot besar dari “it” ke “The animal”, artinya model “belajar” bahwa “it” merujuk pada “animal”.
Abstraksi Query, Key, Value
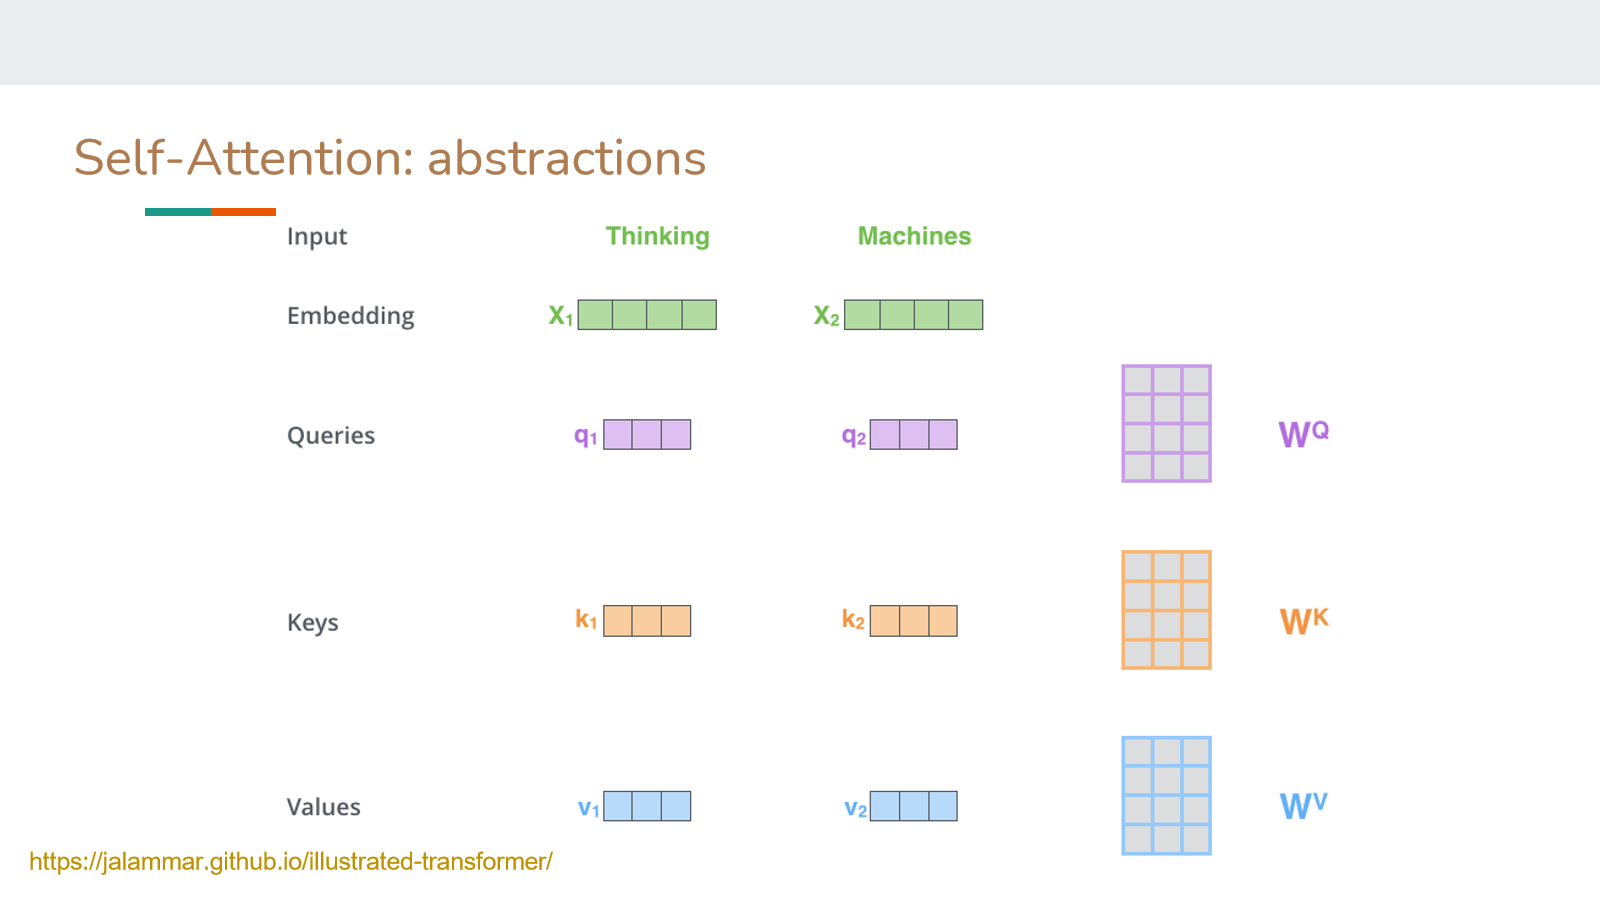
Tiap vektor embedding kata () dikalikan tiga matriks bobot berbeda yang dipelajari saat training () untuk menghasilkan tiga vektor: Query (), Key (), Value ().
Rumus self-attention:
di mana adalah dimensi vektor key (dipakai sebagai faktor penskalaan supaya nilai dot product tidak terlalu besar sebelum softmax).
Contoh Perhitungan Numerik
Untuk kata “Thinking” () terhadap dirinya sendiri dan “Machines” ():
- Score: , .
- Dibagi (di sini ): jadi dan .
- Softmax: dan .
- Kalikan dengan value () lalu jumlahkan: .
Jadi output untuk kata “Thinking” adalah rata-rata berbobot dari semua value dalam kalimat, dengan bobot ditentukan seberapa relevan tiap kata lain (lewat dot product query-key) terhadap “Thinking”.
Contoh Lain: Attention Weight atas Tiga Token
Prinsip yang sama berlaku untuk kalimat dengan lebih dari dua token. Untuk kalimat ["I", "love", "NLP"], tiap query menghasilkan distribusi attention weight (hasil softmax) atas seluruh token dalam kalimat:
| Query | terhadap “I” | terhadap “love” | terhadap “NLP” |
|---|---|---|---|
| I | 22.9% | 32.1% | 45.1% |
| love | 21.3% | 31.7% | 47.0% |
| NLP | 19.8% | 31.2% | 49.0% |
Output untuk query “I” dihitung sebagai kombinasi linear dari value seluruh token, dibobot oleh attention weight di atas: . Pola ini konsisten untuk tiap query — makin tinggi attention weight suatu token, makin besar kontribusi value token tersebut ke output.
Multi-Head Attention
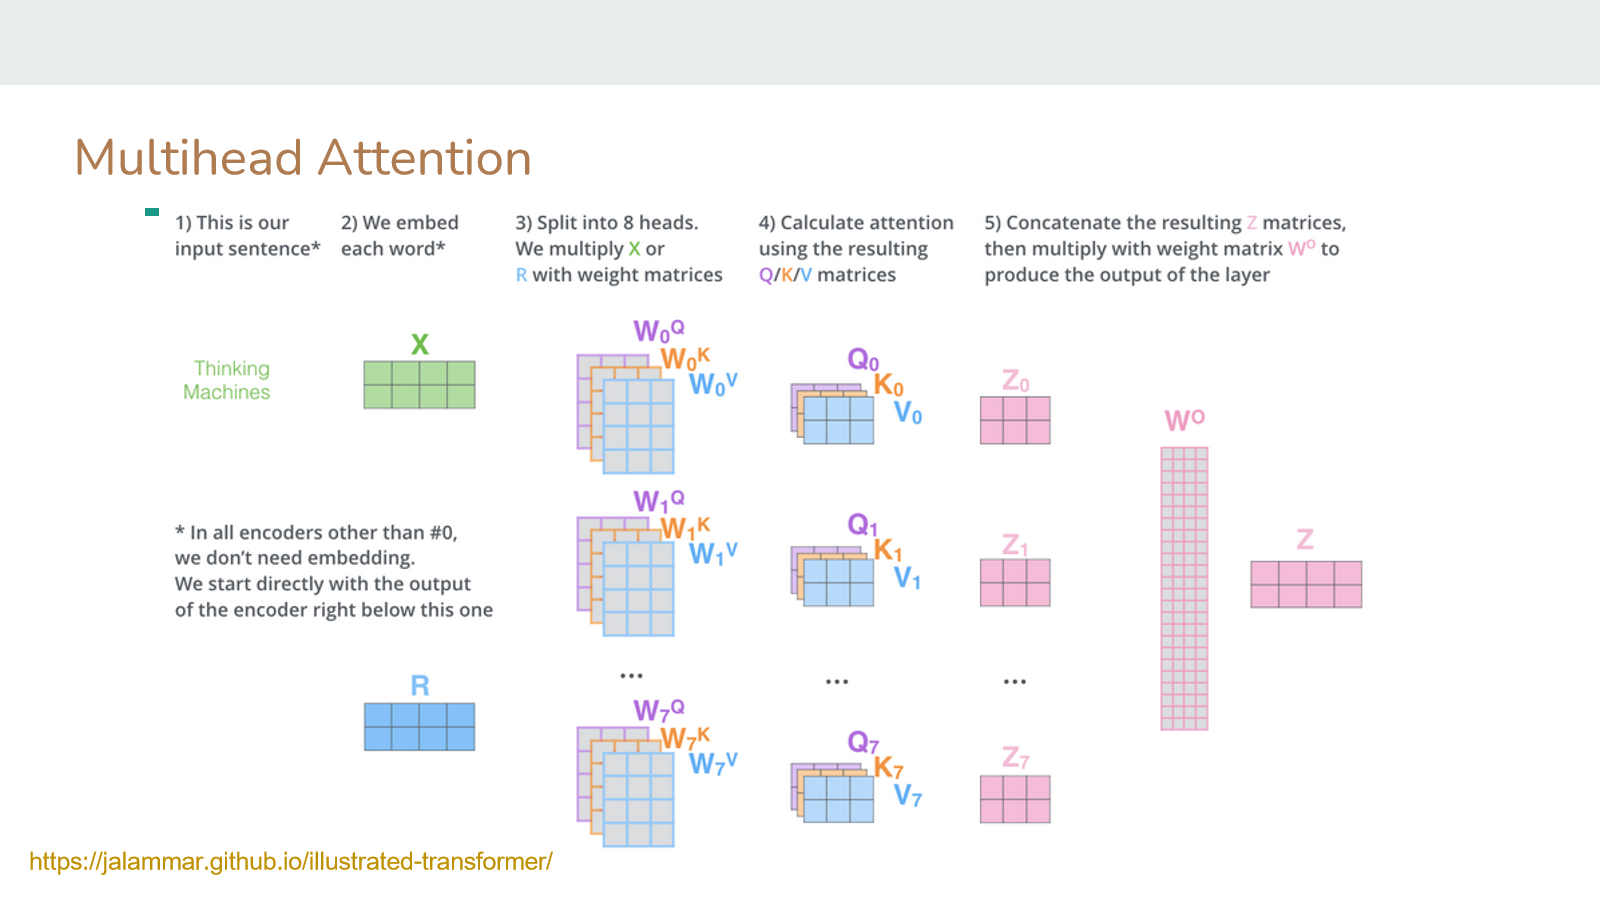
Alih-alih menghitung self-attention sekali, Transformer menghitungnya beberapa kali secara paralel (mis. 8 “head”), masing-masing dengan matriks sendiri:
- Kalimat input di-embed.
- Di-split jadi 8 head (kalikan atau dengan matriks bobot tiap head).
- Hitung attention pakai hasil tiap head → menghasilkan 8 matriks .
- Konkatenasi semua , lalu kalikan matriks bobot → menghasilkan output layer.
Kenapa perlu banyak head? Karena tiap head bisa “belajar” fokus pada relasi yang berbeda-beda:
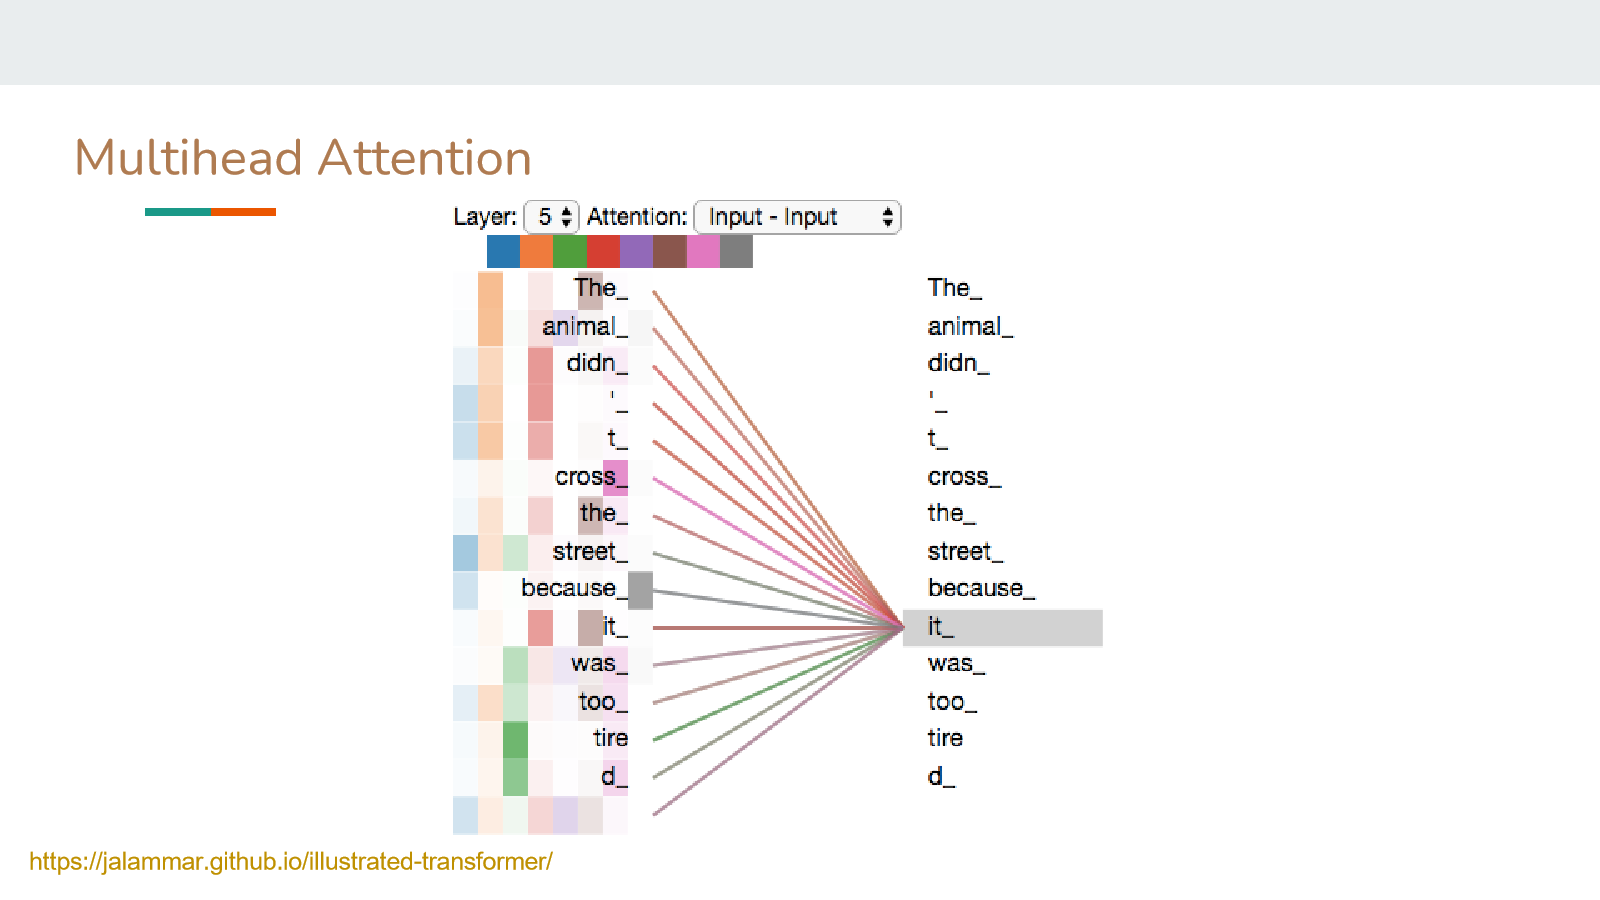
Visualisasi di atas menunjukkan kata “it” (sama seperti contoh single-head sebelumnya) — tapi kali ini beberapa head warna berbeda menunjuk ke kata-kata berbeda (“The”, “animal”, “tire”, “d”) secara bersamaan, menangkap beberapa aspek relasi sekaligus yang tidak bisa ditangkap satu head saja.
Decoder
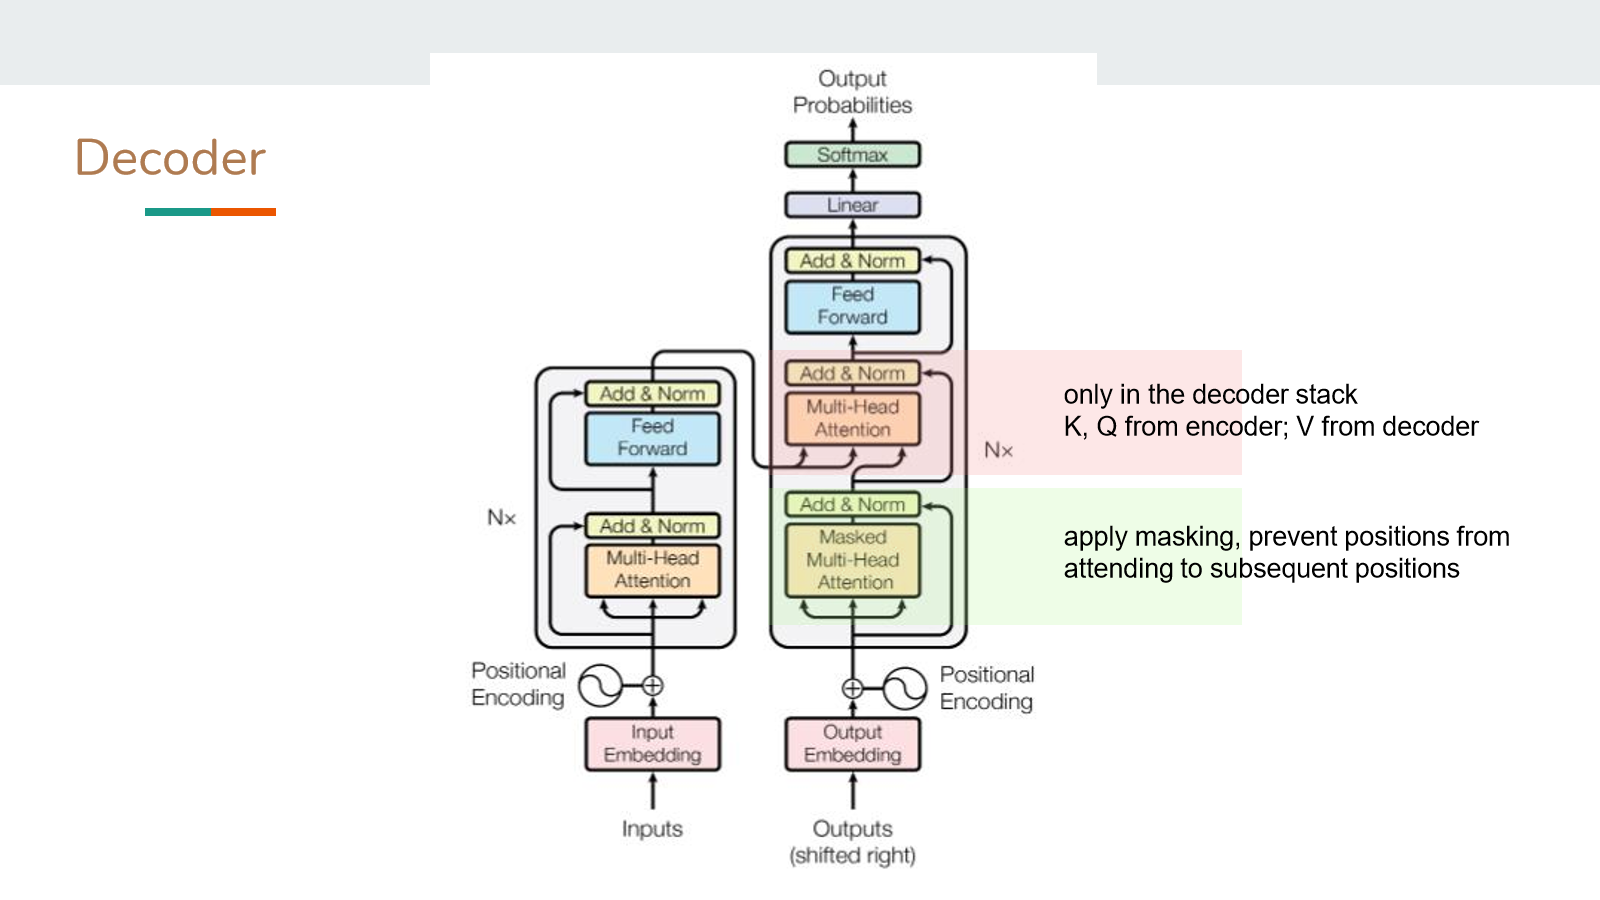
Decoder punya dua jenis attention:
- Masked Multi-Head Attention — self-attention di dalam decoder sendiri, tapi dengan masking: posisi ke- tidak boleh “mengintip” (attend ke) posisi setelahnya (), supaya prediksi kata berikutnya tidak curang melihat jawaban.
- Multi-Head Attention (encoder-decoder attention) — Key dan Value berasal dari output encoder, sedangkan Query berasal dari decoder. Ini yang menghubungkan informasi dari kalimat input ke proses pembangkitan output.
Masking untuk Paralelisasi
Supaya training tetap bisa diparalelkan (bukan diproses token-per-token), attention score ke posisi masa depan langsung di-set sebelum softmax:
Setelah softmax, skor menjadi , sehingga posisi tersebut otomatis tidak berkontribusi ke output — efeknya sama seperti memproses sekuensial, tapi perhitungannya tetap bisa dilakukan sekaligus dalam satu operasi matriks.
Proses Decoding
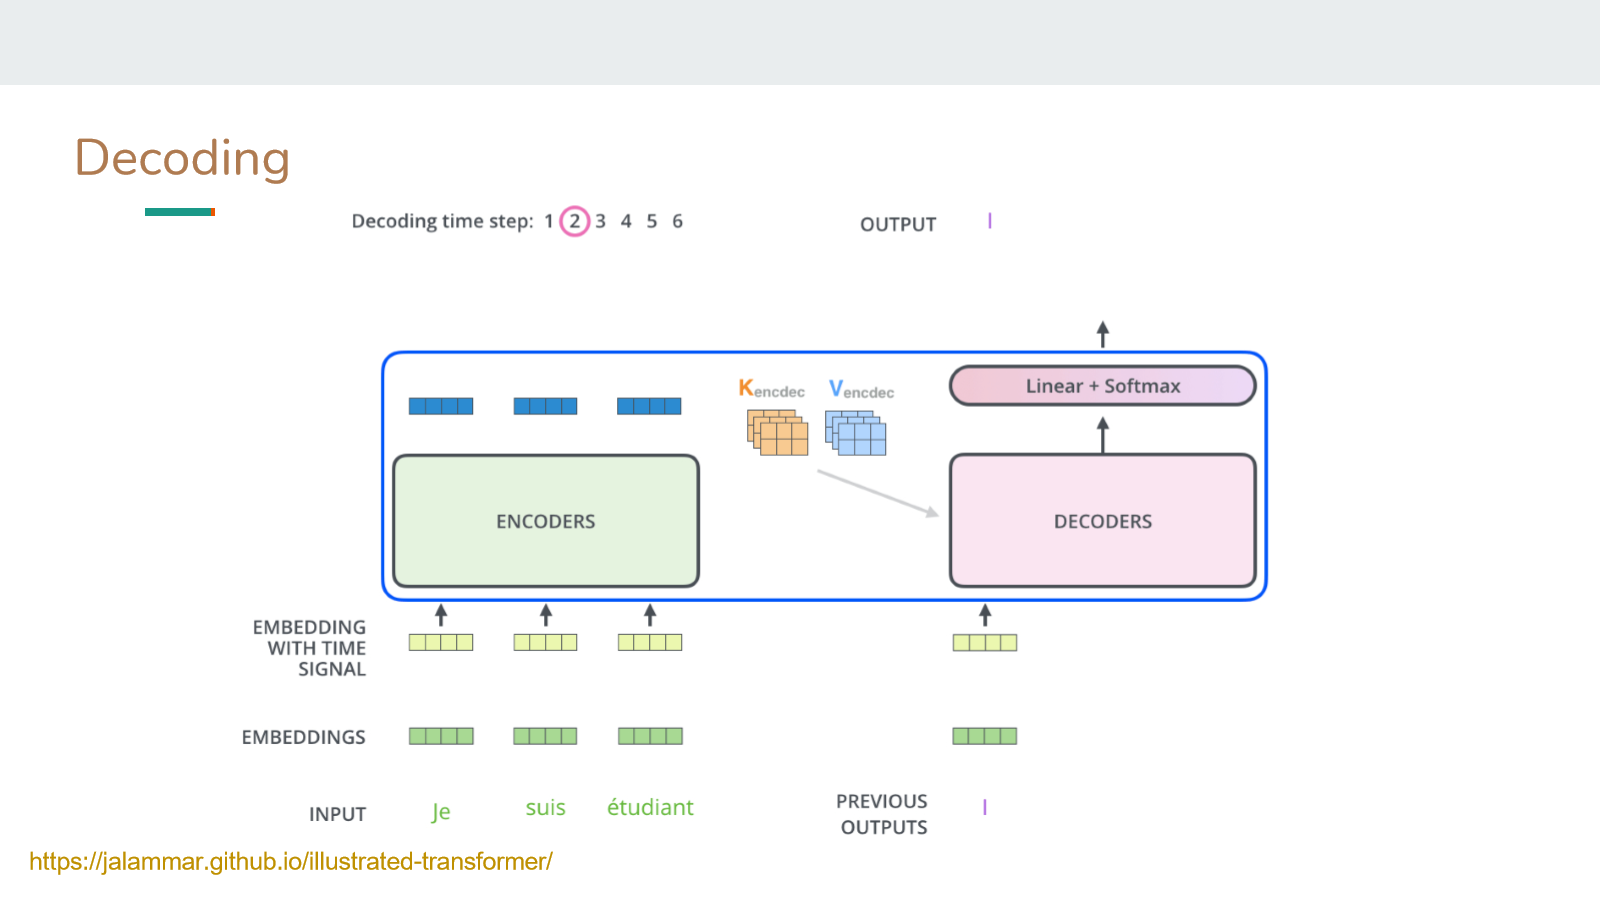
Decoding berjalan token demi token (autoregresif): pada setiap decoding time step, decoder menerima output langkah sebelumnya sebagai bagian dari input barunya, ditambah dan dari encoder (dihitung sekali di awal, dipakai berulang di tiap step). Encoder sendiri hanya dijalankan sekali di awal (karena inputnya tetap, tidak berubah tiap step), sedangkan decoder dijalankan berulang sampai token akhir (mis. token akhir kalimat) dihasilkan.
Output akhir tiap step melalui Linear layer (memproyeksikan ke ukuran vocabulary) lalu Softmax (mengubah jadi distribusi probabilitas), dan kata dengan probabilitas tertinggi (argmax) dipilih sebagai token output.
Kenapa Transformer? Efisiensi & Performa
Self-Attention vs RNN/CNN: Kompleksitas Komputasi
Paper “Attention Is All You Need” membandingkan kompleksitas komputasi self-attention dengan recurrent dan convolutional layer (untuk sequence length , dimensi representasi , ukuran kernel konvolusi , dan ukuran neighborhood pada restricted self-attention):
| Layer Type | Complexity per Layer | Sequential Operations | Maximum Path Length |
|---|---|---|---|
| Self-Attention | |||
| Recurrent | |||
| Convolutional | |||
| Self-Attention (restricted) |
Poin kunci dari tabel ini:
- Sequential operations self-attention adalah — tidak bergantung pada panjang sequence , sehingga bisa diparalelkan penuh. Recurrent layer butuh operasi sekuensial (harus menunggu step sebelumnya selesai).
- Maximum path length self-attention adalah — setiap pasangan token bisa saling “berhubungan langsung” dalam satu operasi, sehingga dependensi jarak jauh (long-range dependency) lebih mudah dipelajari. Pada RNN, path length antara dua token yang berjauhan adalah (informasi harus mengalir lewat setiap step di antaranya).
- Trade-off: self-attention punya complexity per layer — kuadratik terhadap panjang sequence — sehingga menjadi mahal untuk sequence yang sangat panjang (motivasi di balik varian seperti restricted self-attention yang membatasi attention ke neighborhood berukuran ).
Performa pada Machine Translation
Pada task machine translation (English-to-German dan English-to-French, dataset newstest2014), Transformer mencapai skor BLEU lebih tinggi dibanding model state-of-the-art sebelumnya (mis. GNMT+RL, ConvS2S), dengan biaya training (FLOPs) jauh lebih rendah — Transformer (base model) hanya butuh FLOPs dibanding model lain yang butuh – FLOPs, sambil tetap mencapai BLEU tertinggi (Transformer big: 28.4 EN-DE, 41.8 EN-FR).
BERT: Encoder-Based Transformer untuk Text Classification
BERT (Bidirectional Encoder Representations from Transformers) hanya memakai bagian encoder dari Transformer (tanpa decoder), dipakai untuk tugas Natural Language Understanding (NLU) — model mencoba memahami makna teks, dievaluasi lewat task seperti sequence classification, question answering, natural language inference.
Contoh use case — Sentiment Analysis: kalimat “I had to wait for 30 minutes for my meal. But the food was good. I wasn’t that disappointed” → diberi skor positive: 0.87, negative: 0.13, lewat alur: teks masuk ke BERT model (encoder Transformer) → hidden state output-nya masuk ke classifier (fully-connected layer + softmax) → skor per kelas.
Pre-training BERT
BERT di-pre-train dengan dua task sekaligus pada corpus teks besar tanpa label manual:
1. Masked Language Model (MLM)
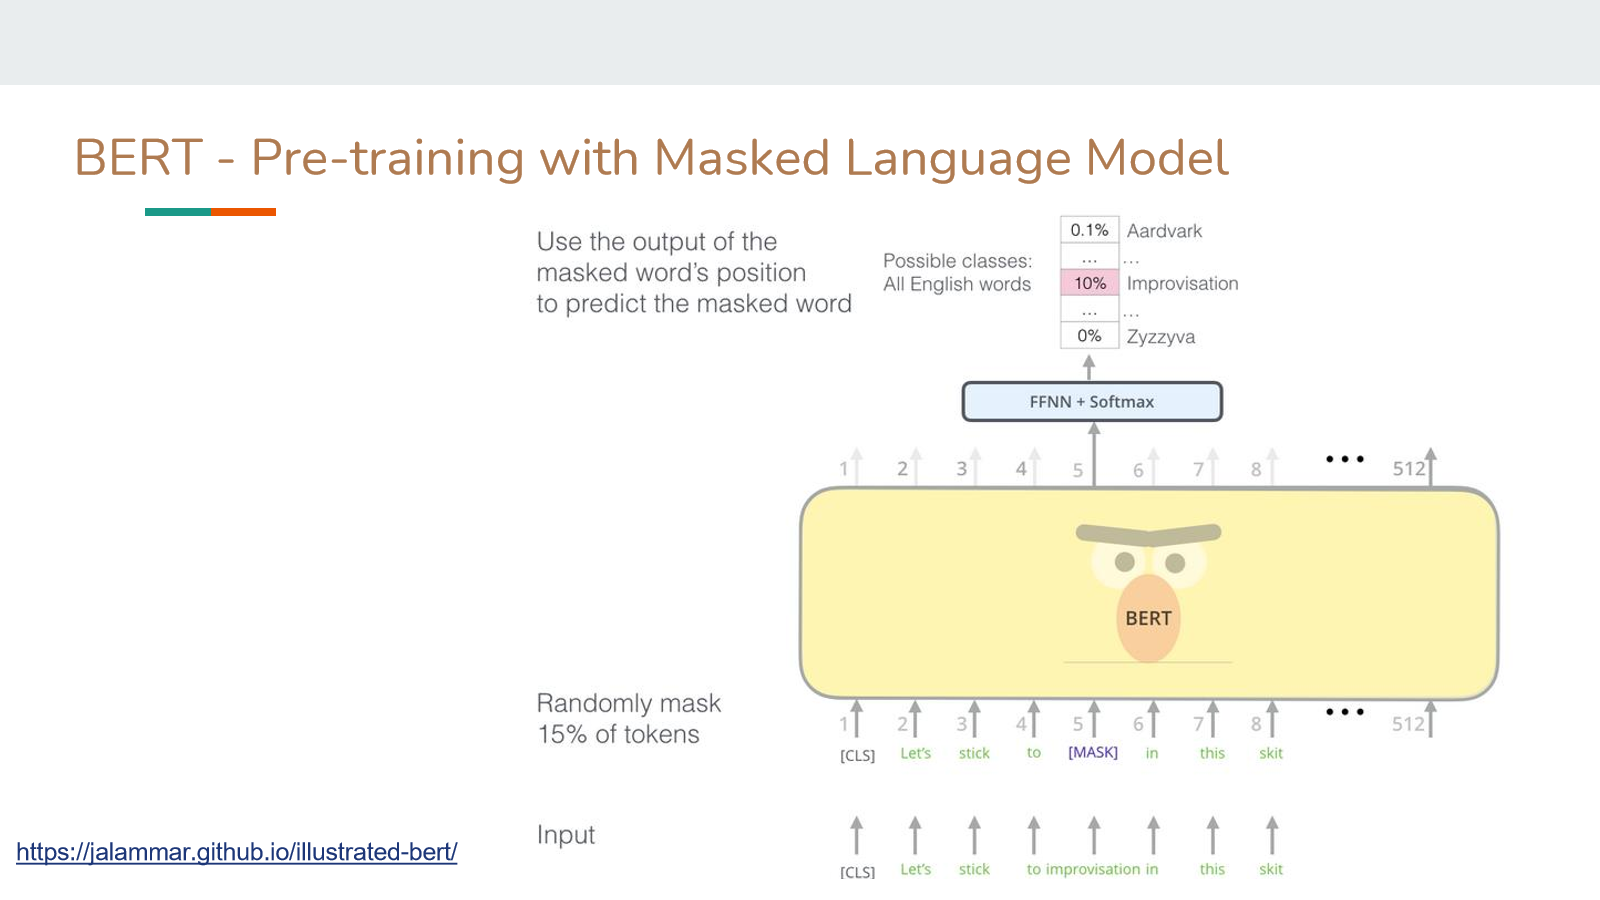
Secara acak, 15% token di-mask (diganti token [MASK]), lalu model diminta memprediksi kata asli di posisi yang di-mask tersebut, menggunakan output BERT di posisi itu → FFNN + Softmax → distribusi probabilitas atas seluruh kosakata (kelas = semua kata bahasa Inggris). Karena BERT bisa melihat konteks kiri dan kanan token yang di-mask sekaligus, representasi yang dihasilkan bersifat bidirectional (berbeda dari model sebelumnya yang hanya melihat satu arah).
2. Next Sentence Prediction (NSP)
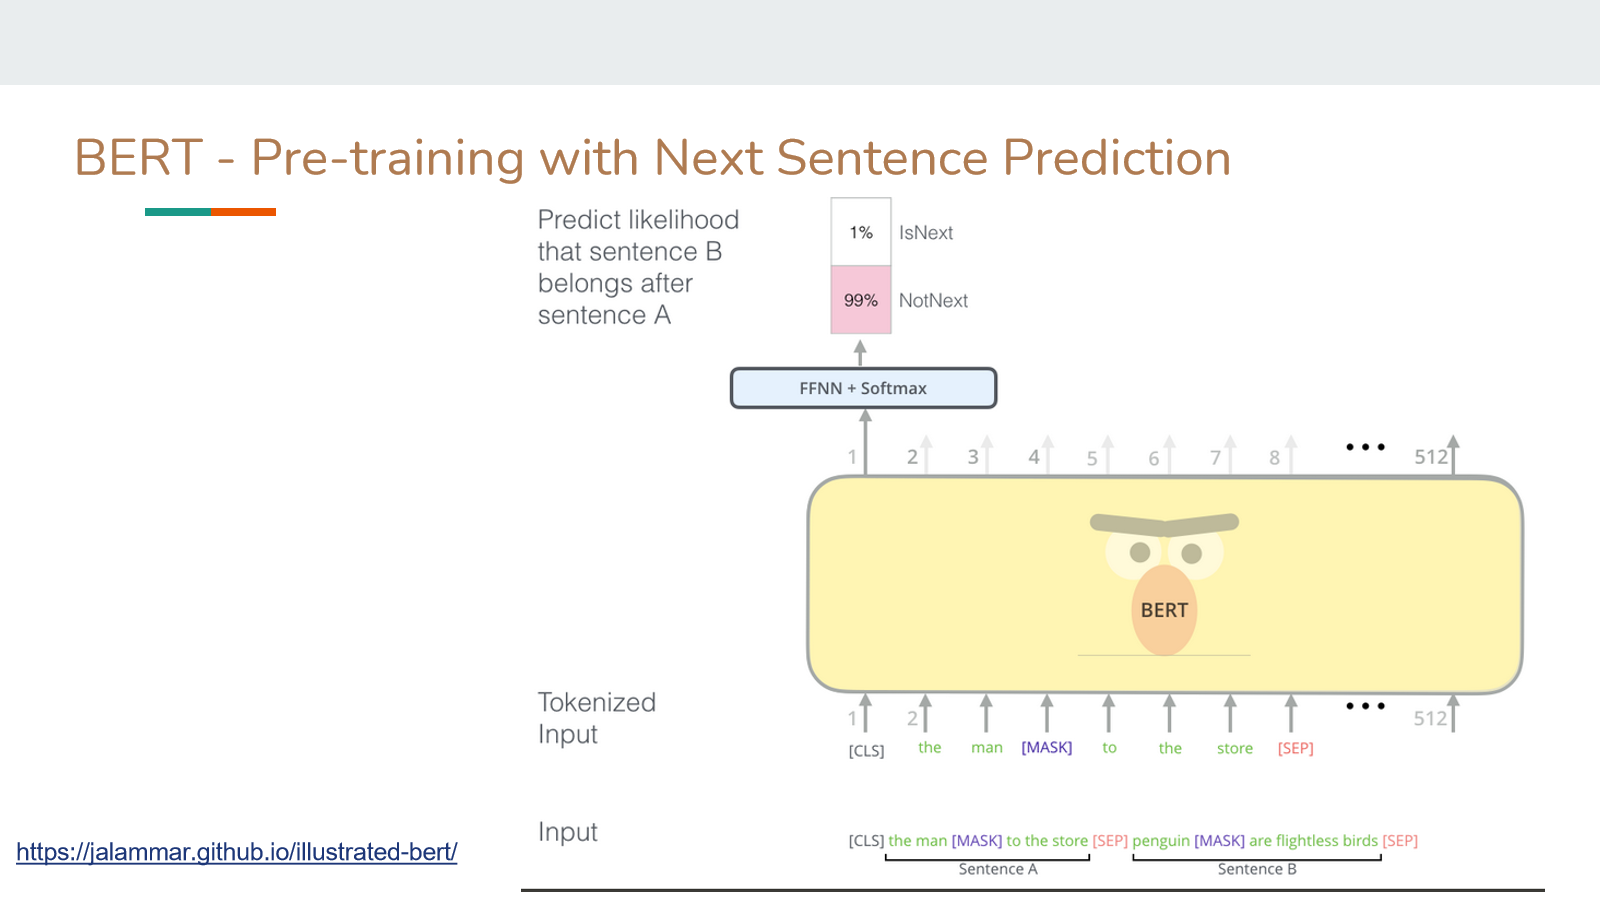
Model diberi sepasang kalimat (A dan B, dipisah token [SEP], diawali [CLS]), lalu diminta memprediksi apakah kalimat B benar-benar kalimat berikutnya setelah A (IsNext) atau bukan (NotNext), lewat output di posisi [CLS] → FFNN + Softmax → probabilitas dua kelas.
Representasi Input BERT
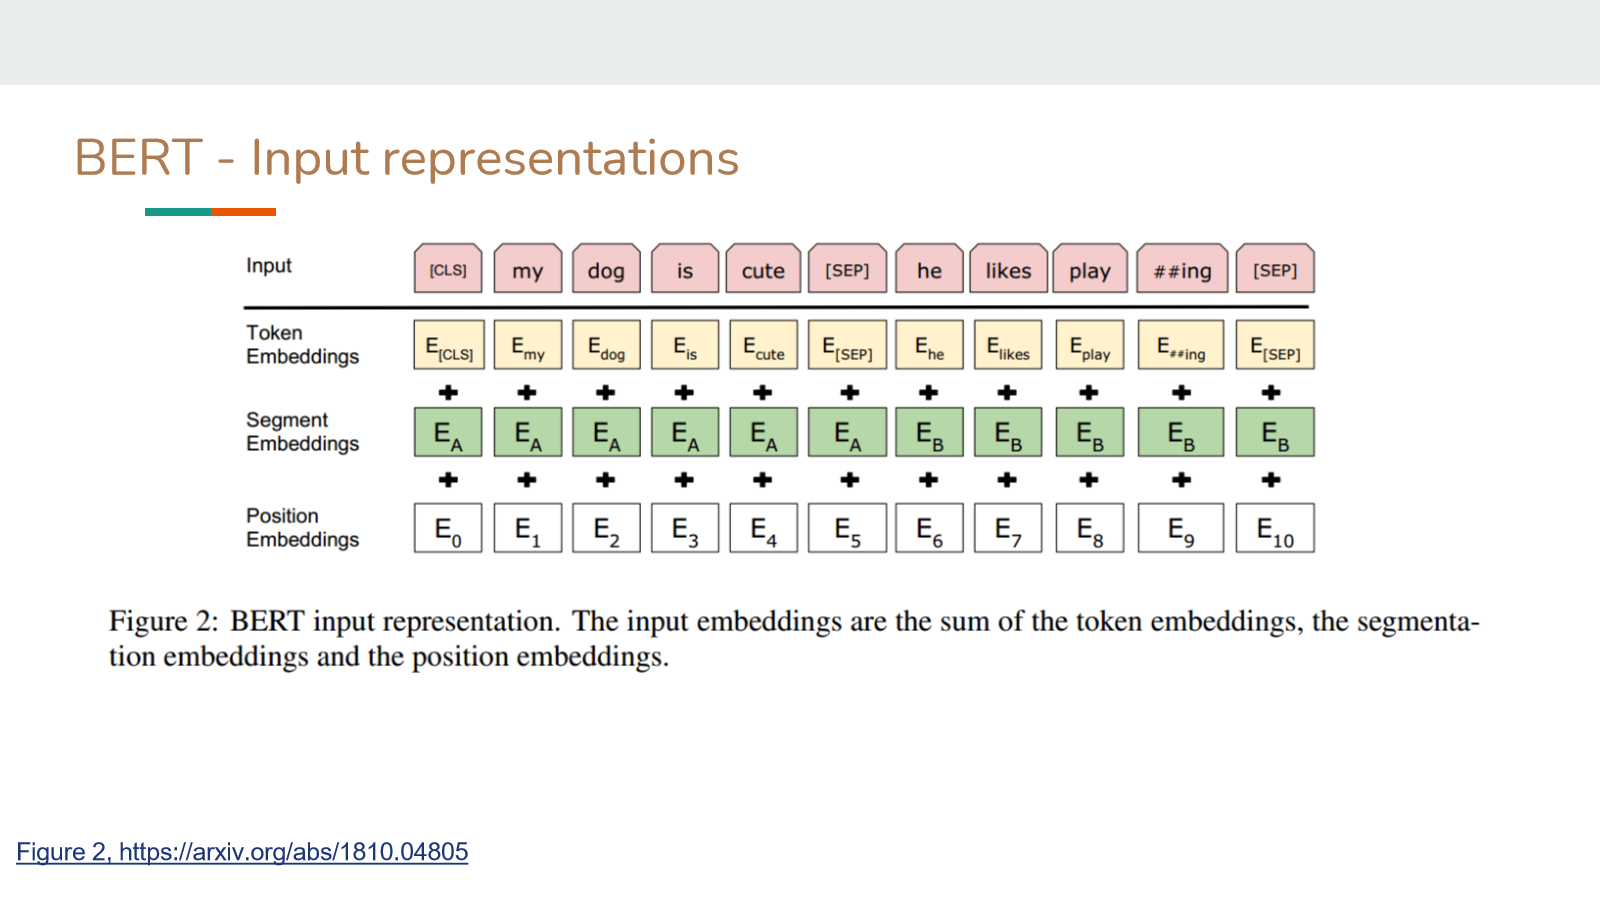
Embedding input BERT adalah penjumlahan tiga jenis embedding:
- Token Embedding () — representasi tiap sub-word token (BERT pakai WordPiece tokenizer, contoh: “playing” → “play” + “##ing”).
- Segment Embedding (/) — menandai token itu milik kalimat A atau B (dipakai untuk task NSP/sentence-pair).
- Position Embedding () — posisi token dalam sequence (mirip fungsi positional encoding di Transformer asli, tapi di BERT ini adalah embedding yang dipelajari, bukan fungsi sinus-cosinus tetap).
Fine-tuning ke Downstream Task
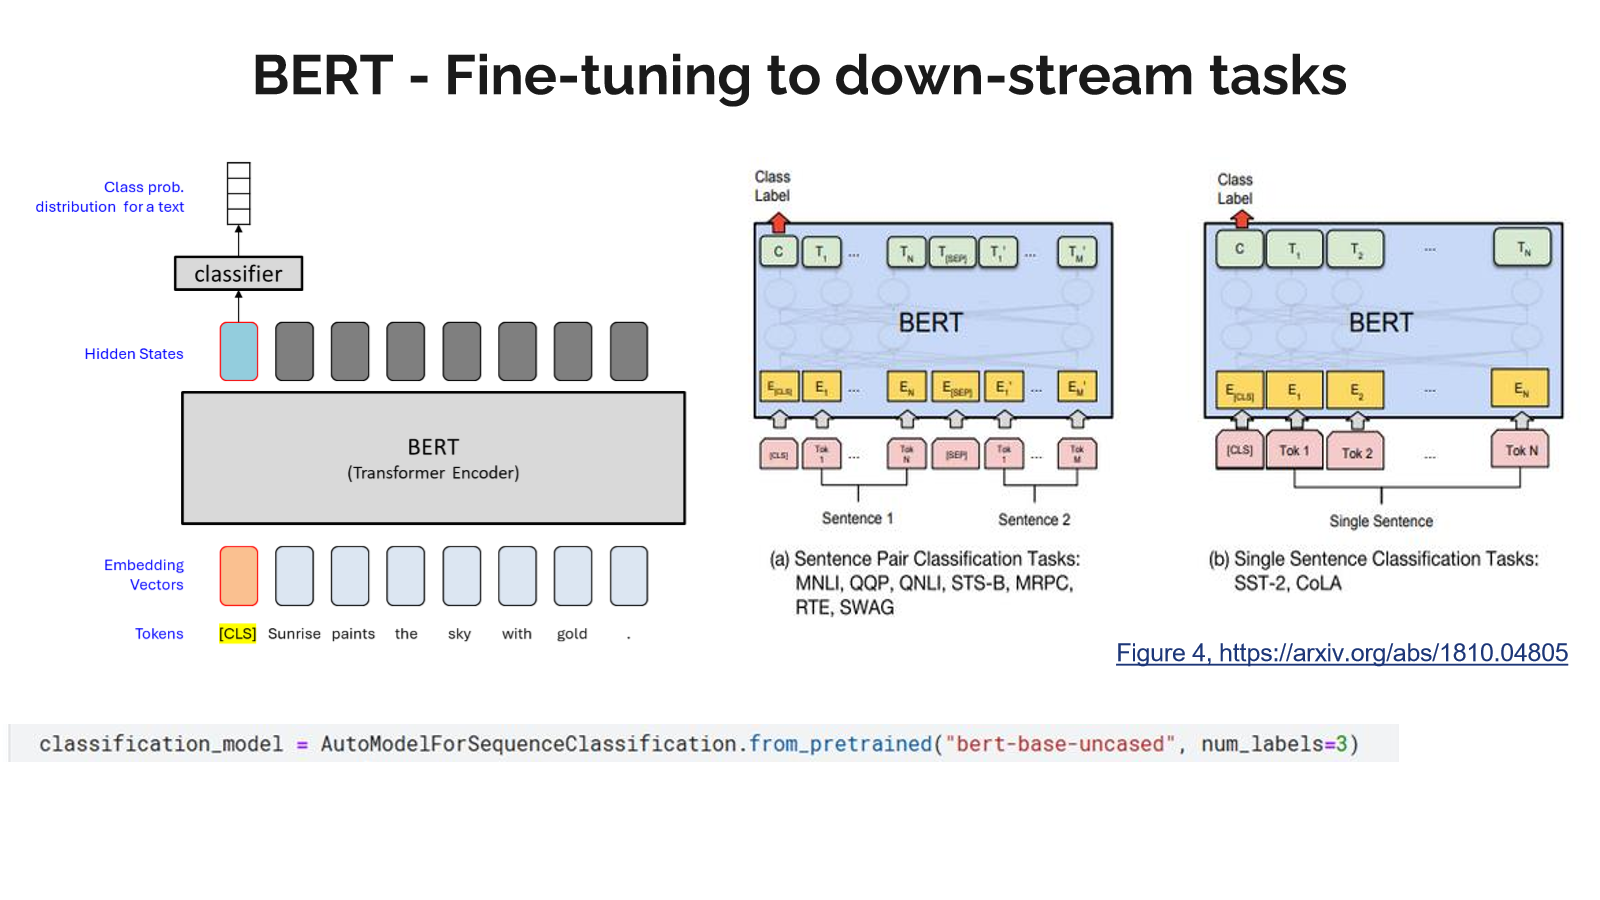
Setelah pre-training, BERT bisa di-fine-tune langsung untuk task spesifik dengan menambahkan satu classifier di atasnya, lalu seluruh model (BERT + classifier) dilatih ulang bersama-sama pada data task tersebut:
- Sentence Pair Classification (mis. MNLI, QQP, STS-B, MRPC) — dua kalimat digabung dengan
[SEP], prediksi diambil dari output posisi[CLS]. - Single Sentence Classification (mis. SST-2, CoLA) — satu kalimat saja, prediksi tetap dari posisi
[CLS].
Implementasi praktis (Hugging Face):
classification_model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased", num_labels=3)Alternatif: Feature Extraction (Tanpa Fine-tuning)
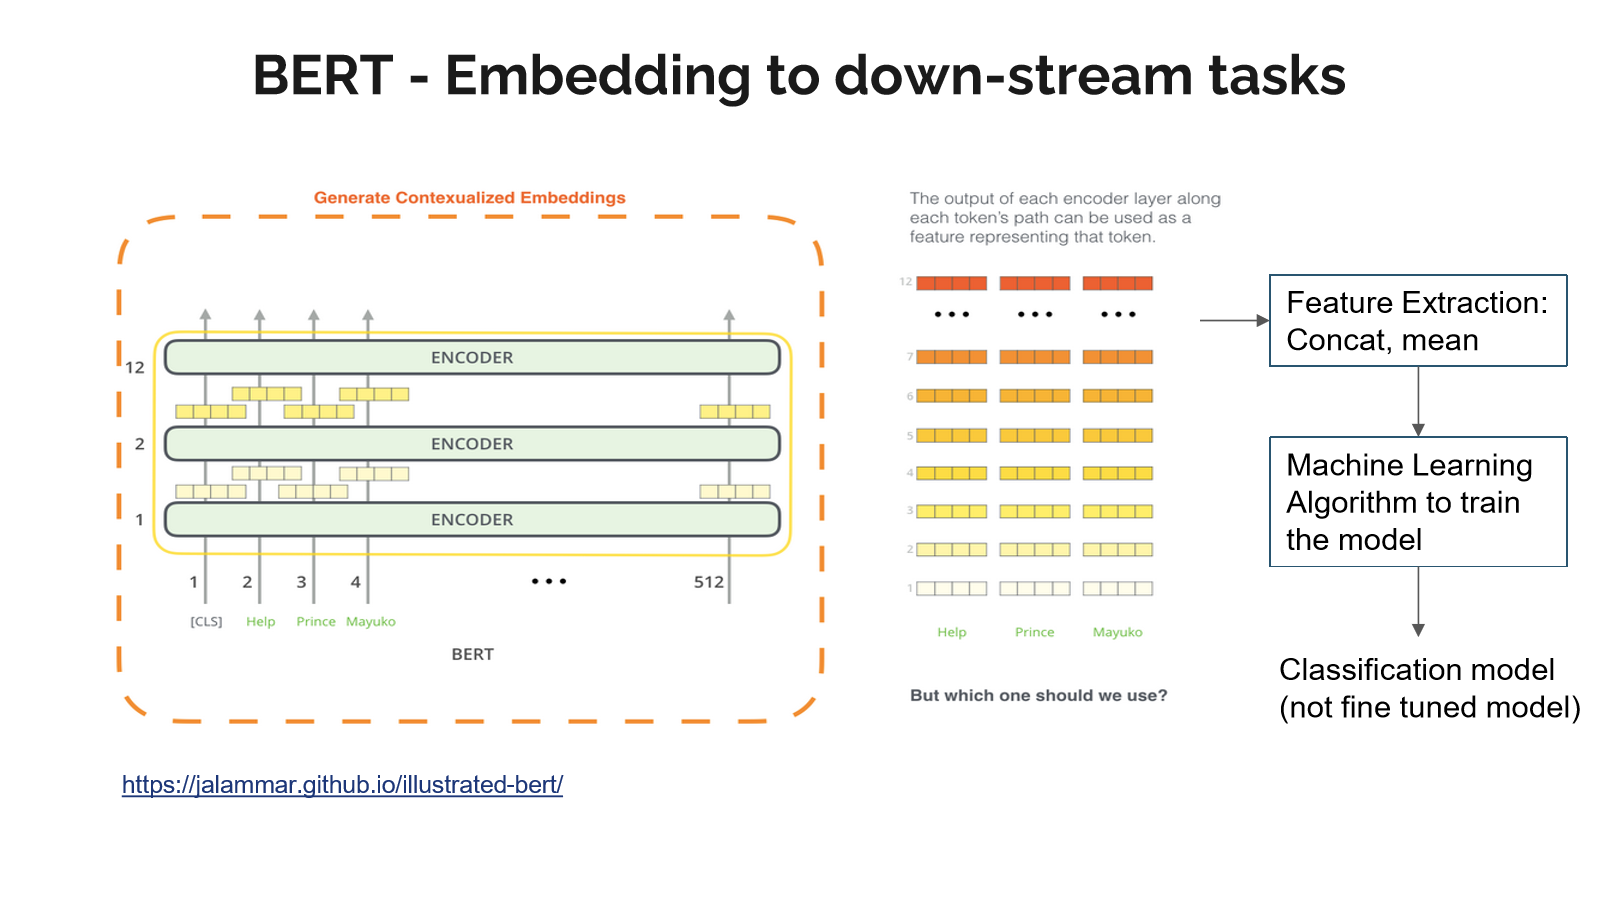
Selain fine-tuning penuh, BERT juga bisa dipakai sebagai ekstraktor fitur saja (BERT dibekukan, tidak ikut dilatih ulang):
- Setiap token melewati 12 layer encoder, menghasilkan contextualized embedding di tiap layer.
- Karena tiap layer punya representasi berbeda untuk token yang sama, perlu dipilih cara feature extraction: konkatenasi atau rata-rata (mean) beberapa layer.
- Fitur hasil ekstraksi itu lalu dipakai sebagai input untuk algoritma machine learning terpisah (bukan neural network fine-tuned), menghasilkan model klasifikasi yang berbeda dari model BERT yang di-fine-tune langsung.
Dua pendekatan ini (fine-tuning vs feature extraction) adalah pilihan desain yang sama seperti dikontraskan pada model klasik di 2_Klasifikasi_Teks: feature extraction dari BERT bisa dipasangkan dengan classifier klasik (Naive Bayes, SVM, dsb.) mirip pola bag-of-words/TF-IDF, sedangkan fine-tuning melatih ulang seluruh jaringan BERT sekaligus.
Performa BERT: GLUE & Question Answering
Pada benchmark GLUE (General Language Understanding Evaluation — kumpulan task klasifikasi/inferensi bahasa seperti MNLI, QQP, QNLI, SST-2, CoLA, STS-B, MRPC, RTE), BERT mengungguli model sebelumnya:
| System | Rata-rata skor GLUE |
|---|---|
| BiLSTM+ELMo+Attn | 71.0 |
| OpenAI GPT | 75.1 |
| Pre-OpenAI SOTA | 74.0 |
| BERT-Base | 79.6 |
| BERT-Large | 82.1 |
Pada task Question Answering (SQuAD 2.0), BERT-Large (single model) mencapai skor F1 83.1 pada test set — mendekati performa manusia (F1 89.5) dan mengungguli sistem top leaderboard sebelumnya (mis. MIR-MRC F-Net di 78.0, nlnet di 77.1).
Detail Training BERT
- Data training: Wikipedia (2.5 miliar kata) + BookCorpus (800 juta kata).
- Batch size: 131.072 kata (1024 sequence × panjang 128, atau 256 sequence × panjang 512).
- Waktu training: 1 juta step (~40 epoch).
- Optimizer: AdamW, learning rate 1e-4, dengan linear decay.
- Ukuran model:
- BERT-Base: 12 layer, hidden size 768, 12 attention head, ~110 juta parameter.
- BERT-Large: 24 layer, hidden size 1024, 16 attention head, ~340 juta parameter.
- Pretraining mahal & tidak praktis di satu GPU — BERT dipretrain memakai 64 chip TPU selama 4 hari. Sebaliknya, fine-tuning praktis dan umum dilakukan di satu GPU — filosofi “pretrain once, finetune many times”: satu model hasil pretraining dipakai ulang untuk banyak downstream task lewat fine-tuning yang jauh lebih murah.
Varian BERT
Beberapa varian BERT yang muncul untuk memperbaiki kekurangan tertentu:
- RoBERTa — melatih BERT lebih lama dan dengan data lebih besar, serta menghapus task Next Sentence Prediction (ditemukan tidak terlalu membantu).
- ALBERT — mengurangi ukuran model lewat dua cara: berbagi parameter (parameter sharing) antar hidden layer, dan memfaktorkan embedding layer.
- SpanBERT — mem-mask span kontiguus (rangkaian kata berurutan), bukan token acak satu-satu, menghasilkan task pre-training yang lebih sulit sekaligus lebih berguna.
- DistilBERT — mengurangi jumlah parameter model lewat teknik distillation (model kecil “murid” belajar meniru output model besar “guru”).
Studi Kasus: Teknik Fine-Tuning di Lab Work 4
Penerapan praktis dari materi di atas — lihat catatan tugas Lab Work 4 untuk konteks lengkapnya. Tiga encoder (BERT, RoBERTa, XLM-R) di-fine-tune untuk klasifikasi sentimen 3-kelas (negative/neutral/positive) atas tweet politik.
Tokenizer — persis tiga skema yang dibahas di atas, satu per model: bert-base-uncased (WordPiece), roberta-base (Byte-level BPE), xlm-roberta-base (SentencePiece/Unigram). Secara empiris, WordPiece milik BERT menghasilkan token per baris paling sedikit (17.6) meski vocabulary-nya paling kecil (30.522, dibanding 250.002 milik XLM-R) — dan BERT juga model dengan skor fine-tuning tertinggi, sejalan dengan vocabulary yang lebih ringkas untuk teks tweet informal ini.
Fine-tuning, bukan feature extraction — sesuai kontras yang dibahas di bagian “Alternatif: Feature Extraction” di atas: dipakai AutoModelForSequenceClassification, seluruh bobot encoder ikut dilatih ulang bersama classification head (bukan membekukan BERT dan memakainya cuma sebagai ekstraktor fitur untuk classifier klasik). Prediksi kelas diambil dari representasi token [CLS], persis seperti dijelaskan di bagian “Fine-tuning ke Downstream Task”.
Class-weighted loss — karena kelas timpang (23% negative/34% neutral/43% positive), cross-entropy loss dibobot invers-frekuensi (compute_class_weight) lewat custom Trainer yang override compute_loss(), supaya kelas minoritas (“negative”) tidak diabaikan model saat training.
Dynamic padding — beda dari batch size tetap 131.072 kata di pretraining BERT (lihat “Detail Training BERT” di atas), fine-tuning di sini pakai DataCollatorWithPadding per-batch (bukan padding ke panjang maksimum tetap), karena tweet-nya pendek dan padding tetap akan membuang komputasi ke token [PAD] yang percuma.
Di luar cakupan materi kuliah — ensembling (stacking, weighted average, grid search bobot) dan bagian evaluasi fair (split holdout terpisah dari data yang dipakai memilih strategi) adalah tambahan di luar arsitektur Transformer itu sendiri, murni di layer pasca-prediksi. Insight utamanya: skor validasi yang lebih tinggi bukan jaminan performa lebih baik kalau prosedur pemilihan strategi ikut “melihat” data yang sama yang dipakai untuk menilai — masalah metodologi umum, bukan spesifik ke Transformer.
Sumber
- Materi kuliah IF5153 Advanced Natural Language Processing, topik “Transformer” (contextual deep learning) dan “Transformer Encoder”.
- Vaswani et al. (2017), “Attention Is All You Need”, arXiv:1706.03762.
- Devlin et al. (2018), “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”, arXiv:1810.04805.
- Jay Alammar, “The Illustrated Transformer” — https://jalammar.github.io/illustrated-transformer/
- Jay Alammar, “The Illustrated BERT” — https://jalammar.github.io/illustrated-bert/
- Kazemnejad, “Transformer Architecture: The Positional Encoding” — https://kazemnejad.com/blog/transformer_architecture_positional_encoding/
- Transformer Explainer (visualisasi interaktif) — https://poloclub.github.io/transformer-explainer/
- Tokenizer Playground (Hugging Face) — https://huggingface.co/spaces/Xenova/the-tokenizer-playground
Flashcard
flashcards Apa motivasi utama di balik desain arsitektur Transformer dibanding RNN/LSTM? :: Menghilangkan komputasi sekuensial (RNN memproses kata satu per satu secara berurutan) supaya proses training bisa diparalelkan, sehingga jauh lebih cepat. Kenapa Transformer butuh positional encoding, padahal RNN tidak? :: Karena Transformer memproses semua kata dalam kalimat sekaligus (paralel), tidak ada urutan pemrosesan yang otomatis merepresentasikan posisi kata seperti pada RNN, jadi informasi posisi harus ditambahkan eksplisit lewat positional encoding (dijumlahkan ke embedding kata). Tuliskan rumus self-attention (Attention(Q,K,V)) beserta arti tiap komponennya :: Attention(Q,K,V) = softmax(QK^T / sqrt(d_k)) x V. Q=query, K=key, V=value (semua diturunkan dari embedding kata lewat matriks bobot terpisah W^Q/W^K/W^V), d_k = dimensi vektor key (untuk penskalaan sebelum softmax). Kenapa Transformer memakai multi-head attention, bukan satu head attention saja? :: Karena tiap head bisa belajar fokus pada relasi/aspek yang berbeda-beda dalam kalimat secara paralel (misal satu head fokus relasi subjek-objek, head lain fokus relasi kata sifat-kata benda), sehingga menangkap lebih banyak jenis relasi dibanding satu head saja. Apa perbedaan masked multi-head attention dan multi-head attention biasa (encoder-decoder attention) di decoder? :: Masked multi-head attention adalah self-attention di dalam decoder sendiri dengan masking supaya posisi i tidak bisa melihat posisi j>=i (mencegah “mengintip” jawaban). Encoder-decoder attention memakai Key dan Value dari output encoder, sedangkan Query dari decoder, menghubungkan informasi dari kalimat input ke proses pembangkitan output. Bagaimana cara masking diimplementasikan secara matematis di decoder, dan kenapa itu tetap memungkinkan paralelisasi? :: Attention score ke posisi j>=i di-set menjadi -infinity sebelum softmax (e_ij = q_i.k_j jika j<i, -infinity jika j>=i). Setelah softmax, skor -infinity menjadi 0 sehingga posisi itu tidak berkontribusi ke output - efeknya sama seperti pemrosesan sekuensial, tapi tetap dihitung sekaligus dalam satu operasi matriks (paralel). Apa dua task pre-training BERT, dan apa tujuan masing-masing? :: (1) Masked Language Model (MLM): 15% token diacak/di-mask, model memprediksi kata aslinya, memungkinkan representasi bidirectional karena BERT melihat konteks kiri dan kanan sekaligus. (2) Next Sentence Prediction (NSP): model memprediksi apakah kalimat B benar-benar kalimat berikutnya setelah kalimat A atau bukan, melatih pemahaman relasi antar kalimat. Representasi input BERT adalah penjumlahan tiga jenis embedding, sebutkan :: Token Embedding (representasi tiap sub-word/WordPiece token), Segment Embedding (menandai token milik kalimat A atau B), dan Position Embedding (posisi token dalam sequence, dipelajari saat training, bukan fungsi sinus-cosinus tetap seperti Transformer asli). Apa perbedaan fine-tuning dan feature extraction saat memakai BERT untuk downstream task seperti klasifikasi teks? :: Fine-tuning melatih ulang seluruh BERT bersama classifier tambahan di atasnya untuk task spesifik. Feature extraction membekukan BERT (tidak dilatih ulang), mengambil contextualized embedding dari satu atau beberapa layer (dikonkatenasi/dirata-rata), lalu memasukkannya sebagai fitur ke algoritma machine learning terpisah (mis. SVM, Naive Bayes). Pada fine-tuning BERT, dari posisi token mana prediksi kelas biasanya diambil, baik untuk sentence pair classification maupun single sentence classification? :: Dari posisi token [CLS] (token khusus di awal setiap input), yang hidden state akhirnya dipakai sebagai representasi ringkasan seluruh input untuk classifier. Sebutkan tiga skema tokenizer berbeda beserta model yang memakainya :: WordPiece dipakai BERT (memecah kata jadi sub-word, potongan tambahan diawali ), BPE (Byte Pair Encoding) dipakai GPT-2 (menggabung pasangan karakter/byte yang paling sering muncul bersama), dan SentencePiece dipakai Flan-T5 (language-independent, tidak bergantung spasi sebagai pemisah kata). Apa perbedaan makna antara “token ID” dan “embedding vector” suatu token? :: Token ID hanyalah index baris token dalam tabel vocabulary (tidak ada makna semantik apa pun pada angkanya); embedding vector adalah hasil lookup index tersebut ke embedding matrix yang nilainya dipelajari saat training dan merepresentasikan makna/konteks token tersebut. Bandingkan kompleksitas self-attention, recurrent, dan convolutional layer dari sisi sequential operations dan maximum path length :: Self-attention: O(1) sequential operations dan O(1) maximum path length (semua token bisa saling terhubung langsung, sangat paralel). Recurrent: O(n) sequential operations dan O(n) maximum path length (harus diproses berurutan, informasi mengalir step demi step). Convolutional: O(1) sequential operations tapi O(log_k(n)) maximum path length. Kenapa Transformer disebut lebih efisien dibanding model sebelumnya pada task machine translation, meski mencapai BLEU score lebih tinggi? :: Karena biaya training (FLOPs)-nya jauh lebih rendah dibanding model state-of-the-art sebelumnya (mis. Transformer base ~3.3x10^18 FLOPs vs GNMT+RL/ConvS2S yang butuh 10^19-10^21 FLOPs), sambil tetap mencapai BLEU score tertinggi. Sebutkan detail penting training BERT: data, ukuran model, dan biaya pretraining :: Data: Wikipedia (2.5B kata) + BookCorpus (800M kata). Ukuran: BERT-Base (12 layer, ~110M parameter) dan BERT-Large (24 layer, ~340M parameter). Pretraining mahal (64 TPU chip selama 4 hari, tidak praktis di satu GPU), tapi fine-tuning praktis di satu GPU — filosofi “pretrain once, finetune many times”. Sebutkan empat varian BERT beserta perbedaan utamanya dari BERT asli :: RoBERTa (training lebih lama & data lebih besar, tanpa Next Sentence Prediction), ALBERT (mengurangi ukuran lewat parameter sharing antar layer + factorized embedding), SpanBERT (mask span kontiguus, bukan token acak satu-satu), DistilBERT (mengurangi parameter lewat distillation dari model guru yang lebih besar).