Catatan dari materi 1790573198793_6-Decoder.pdf (“Decoder & Prompt”). Melanjutkan arsitektur decoder dari Transformer & BERT dengan notasi formal ala Stanford CS224n, lalu masuk ke tiga topik besar penggunaan LLM: prompting, fine-tuning, dan parameter-efficient fine-tuning (PEFT). Sesuai silabus poin (3) — Transfer Learning.
Recap: Self-Attention & Cross-Attention (Notasi Formal)
Self-Attention: Q, K, V dari Sequence yang Sama
Formalisasi self-attention (notasi CS224n) untuk sequence kata dalam vocabulary :
- Tiap kata diembed: , dengan matriks embedding.
- Tiap embedding kata ditransformasi lewat matriks bobot : (query), (key), (value).
- Hitung similarity berpasangan antara query dan key, lalu normalisasi lewat softmax: , .
- Output tiap kata adalah weighted sum dari value: .
Notasi ini sama persis dengan yang sudah dibahas di catatan Transformer (bagian “Abstraksi Query, Key, Value”) — hanya beda simbol (/ di sini setara /hasil softmax di sana).
Masked Self-Attention di Decoder
Sama seperti dibahas di catatan Transformer: supaya decoder tidak “mengintip” kata masa depan saat generate token ke-, attention score ke posisi di-set sebelum softmax: jika , dan jika . Self attention: untuk generate , decoder perlu attend ke (token-token sebelumnya yang sudah dihasilkan).
Cross-Attention (Detail)
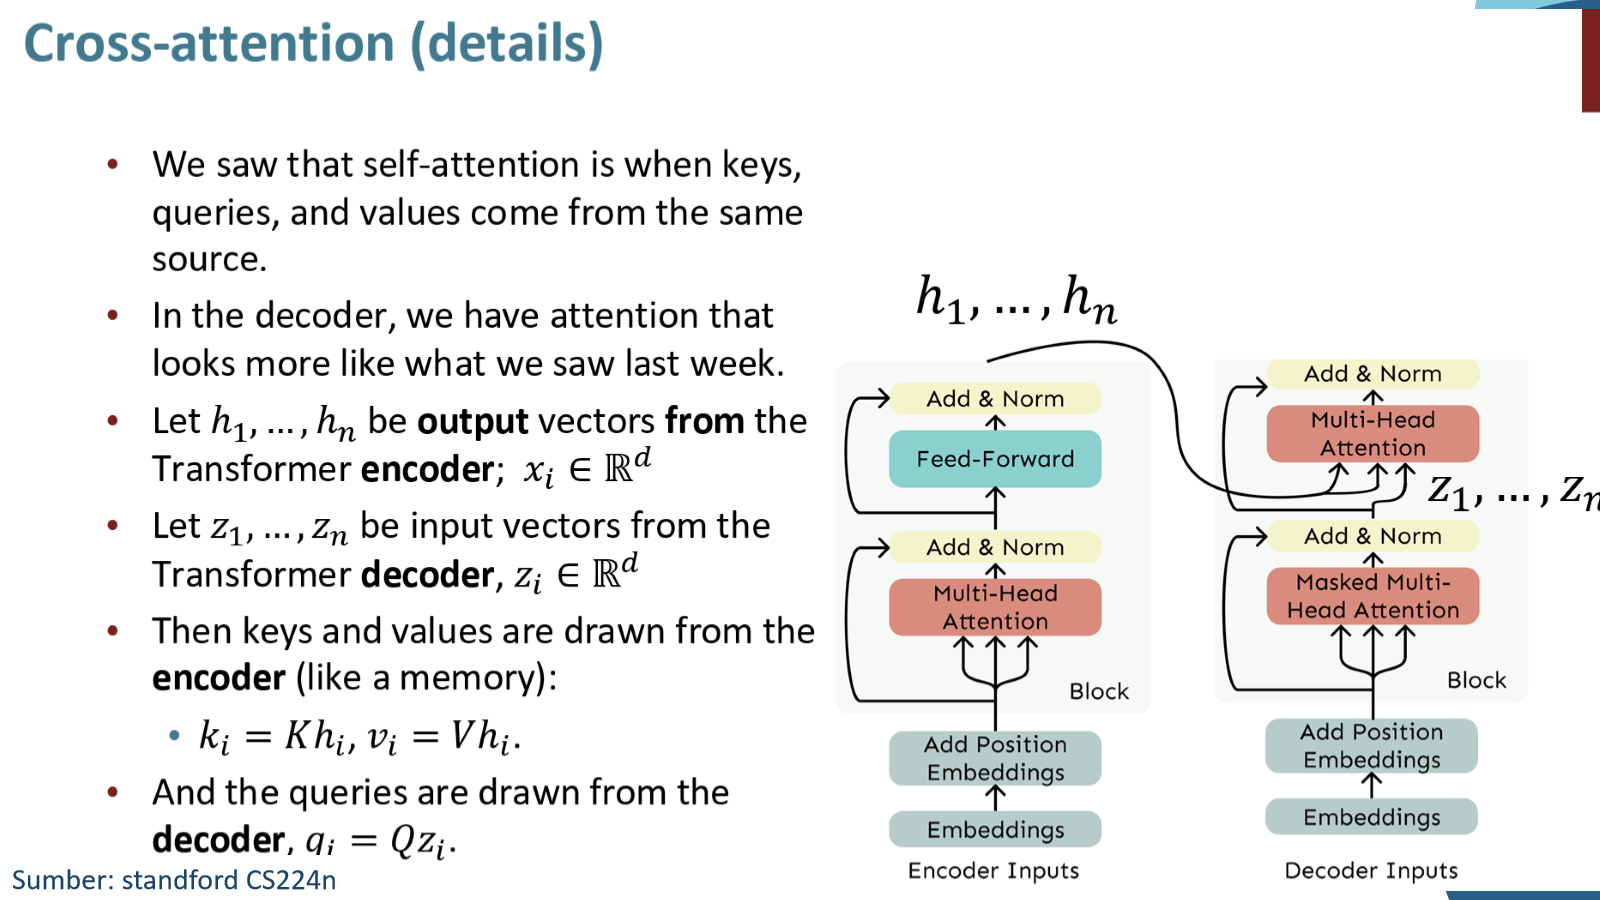
Berbeda dari self-attention (key, query, value berasal dari sumber yang sama), pada cross-attention di decoder:
- Misalkan adalah vektor output dari encoder Transformer, .
- Misalkan adalah vektor input dari decoder, .
- Key dan value diambil dari encoder (berperan seperti memori): , .
- Query diambil dari decoder: .
Dengan kata lain: Cross attention memungkinkan decoder “membayar perhatian” ke input (lewat representasi encoder) untuk men-generate — ini yang secara arsitektural menghubungkan hasil pemahaman encoder atas kalimat sumber ke proses pembangkitan token target di decoder.
Kenapa Large Language Model?
Perbandingan paradigma AI tradisional vs LLM:
| Traditional AI Model | Large Language Model | |
|---|---|---|
| Prinsip | Satu model untuk satu task (Model 1 → Task 1, Model 2 → Task 2, dst., masing-masing dilatih terpisah) | Satu model untuk berbagai task (satu LLM menerima Input 1/2/n dan menghasilkan Task 1/2/n) |
Pergeseran paradigma inilah yang membuka pintu ke prompting (memberi instruksi ke satu model besar yang sama untuk task berbeda-beda) sebagai alternatif dari melatih model terpisah per task.
Prompting
Base Model Bukan Assistant
Model bahasa dasar (base model, hasil pretraining murni, sebelum instruction-tuning/RLHF) tidak menjawab pertanyaan — ia hanya berusaha melanjutkan dokumen internet seperti pola yang dipelajarinya saat pretraining. Sering kali base model justru merespons pertanyaan dengan pertanyaan lain, dst. Base model bisa “ditipu” untuk melakukan suatu task lewat prompt engineering — mis. alih-alih bertanya langsung, memberi instruksi berformat “Write a poem about X” berulang kali sehingga model melanjutkan pola itu untuk topik baru yang diminta.
Elemen Prompt
Empat elemen umum penyusun sebuah prompt:
- Instruction — task atau instruksi spesifik yang ingin dijalankan model.
- Context — informasi eksternal atau konteks tambahan yang mengarahkan model ke jawaban lebih baik.
- Input Data — input atau pertanyaan yang ingin dicari jawabannya.
- Output Indicator — tipe atau format output yang diinginkan.
Contoh (task question answering berbasis konteks):
Instruction: Answer the question based on the context below. Keep the answer short and concise.
            Respond "Unsure about answer" if not sure about the answer.
Context:    Teplizumab traces its roots to a New Jersey drug company called Ortho Pharmaceutical.
            There, scientists generated an early version of the antibody, dubbed OKT3. Originally
            sourced from mice, the molecule was able to bind to the surface of T cells and limit
            their cell-killing potential. In 1986, it was approved to help prevent organ rejection
            after kidney transplants, making it the first therapeutic antibody allowed for human use.
Input Data: Question: What was OKT3 originally sourced from?
Output Indicator: Answer:
Output: Mice.
Contoh Task Lewat Prompting
Summarization — instruksi “Explain the above in one sentence” di akhir teks panjang tentang antibiotik menghasilkan ringkasan satu kalimat yang memadatkan poin-poin utama (cara kerja, cara pemberian, tidak efektif untuk virus, risiko resistensi).
Code Generation — komentar/instruksi dalam bahasa natural (mis. /* Ask the user for their name and say "Hello" */) langsung diterjemahkan model jadi kode (let name = prompt(...); console.log(...)); begitu juga instruksi berisi skema tabel database bisa langsung diterjemahkan jadi query SQL yang sesuai.
Sentiment Analysis (Zero-Shot) — instruksi sederhana “Sentiment analysis of the following text” pada judul & kutipan berita ekonomi, tanpa contoh berlabel sama sekali, sudah cukup membuat model mengklasifikasi sentimen (negative) sekaligus menjelaskan alasannya per frasa kunci.
Aspect-Based Sentiment Analysis — instruksi lebih detail: memberi daftar kategori aspek (economy, financial sector, inflation, dst.) lalu meminta model mengekstrak aspect term, sentimen tiap aspek, dan kategorinya dari satu teks berita — menunjukkan prompting bisa dipakai untuk task NLP yang lebih terstruktur, bukan cuma klasifikasi sederhana.
Zero-Shot vs Few-Shot Prompting
- Zero-shot — prompt langsung berisi instruksi task tanpa contoh berlabel sama sekali (mis. “Classify the given text into one of the following sentiment categories: positive, neutral, negative”).
- Few-shot — prompt disisipi beberapa contoh berlabel (labeled examples) sebelum data yang ingin diklasifikasi, mis.
Text: I love this. Label: positive/Text: I hate this. Label: negative, baru diikuti teks baru yang diminta diklasifikasi.
Few-shot ini juga disebut in-context learning — istilah yang menekankan bahwa tidak ada gradient update yang terjadi saat model “belajar” dari contoh-contoh dalam prompt (beda dengan literatur few-shot learning lain yang memang melibatkan gradient update). Menurut Brown et al. (2020), task cukup dispesifikasikan dengan menempelkan contoh task di depan contoh yang ingin dijawab — didemonstrasikan lewat contoh penerjemahan kata buatan (gaot => goat, dst.) dan penerjemahan Inggris-Prancis, di mana pola dari contoh-contoh sebelumnya “diteruskan” oleh model ke contoh baru.
Chain-of-Thought (CoT) Prompting
Alih-alih meminta jawaban langsung, CoT meminta model menuliskan langkah-langkah penalaran sebelum sampai ke jawaban akhir. Empat variasi (Kojima et al., 2022):
- (a) Few-shot — contoh soal + jawaban langsung tanpa langkah penalaran → model sering salah pada soal baru yang butuh penalaran (bocor ke jawaban salah, mis. “8” alih-alih “4”).
- (b) Few-shot-CoT — contoh soal disertai langkah penalaran tertulis sebelum jawaban akhir → model meniru pola bernalar step-by-step pada soal baru, menghasilkan jawaban benar.
- (c) Zero-shot — langsung minta jawaban tanpa contoh apa pun → salah.
- (d) Zero-shot-CoT — cukup menambahkan kalimat pemicu “Let’s think step by step” di akhir prompt (tanpa contoh berlabel sama sekali) → model tetap menuliskan langkah penalaran dan sampai ke jawaban benar.
Insight utama Zero-shot-CoT: penalaran langkah-demi-langkah bisa dipicu hanya dengan satu kalimat sederhana, tanpa perlu menyiapkan contoh few-shot yang sudah diberi langkah penalaran secara manual.
Automatic Chain-of-Thought (Auto-CoT)
Menghilangkan kebutuhan menulis manual demonstrasi CoT untuk few-shot-CoT, lewat dua tahap:
- Question clustering — partisi seluruh pertanyaan dalam dataset ke beberapa cluster (berdasarkan kemiripan).
- Demonstration sampling — pilih satu pertanyaan representatif dari tiap cluster, lalu bangkitkan rantai penalarannya secara otomatis memakai Zero-Shot-CoT (dengan heuristik sederhana, mis. panjang pertanyaan maksimal ~60 token dan jumlah langkah penalaran maksimal ~5 langkah) — hasilnya jadi demonstrasi few-shot-CoT otomatis untuk pertanyaan uji yang baru.
Self-Consistency
Alih-alih mengambil satu output CoT saja, sample beberapa kali (beberapa rantai penalaran berbeda untuk soal yang sama) lalu ambil jawaban yang paling konsisten/sering muncul di antara semua output. Contoh: tiga output berbeda untuk soal umur adik menghasilkan jawaban “67” pada dua output dan “35” pada satu output (dari kesalahan pembagian, bukan pengurangan) — jawaban mayoritas (“67”) lebih mungkin benar dibanding mengandalkan satu sample saja.
Generate Knowledge Prompting
Alur dua tahap: (1) Knowledge Generation — untuk suatu pertanyaan, model dulu diminta membangkitkan beberapa pernyataan pengetahuan (knowledge) yang relevan lewat prompt berisi beberapa contoh demonstrasi (instruction + pasangan question-knowledge tetap); (2) Knowledge Integration — pengetahuan yang dihasilkan itu digabungkan (mis. dijadikan bagian prompt lanjutan) untuk menjawab pertanyaan asli. Contoh: pertanyaan “Part of golf is trying to get a higher point total than others. Yes or No?” — model dulu membangkitkan pengetahuan tentang tujuan sebenarnya olahraga golf (skor terendah yang menang, bukan tertinggi), baru dari situ menjawab “No” dengan penjelasan yang benar — pendekatan ini membantu ketika jawaban langsung berisiko salah karena butuh pengetahuan faktual eksternal yang tidak eksplisit ada di pertanyaan.
Downside Prompt-Based Learning
Empat kelemahan prompting dibanding fine-tuning:
- Inefisiensi — prompt harus diproses ulang setiap kali model membuat prediksi (tidak ada “pembelajaran” yang tersimpan permanen di bobot model).
- Performa lebih buruk — secara umum prompting berkinerja lebih rendah dibanding fine-tuning (Brown et al., 2020).
- Sensitif terhadap wording & urutan — hasil bisa berubah signifikan hanya karena perubahan kecil pada redaksi prompt (Webson & Pavlick, 2022), atau urutan contoh few-shot (Zhao et al., 2021; Lu et al., 2022).
- Tidak jelas apa yang benar-benar “dipelajari” model dari prompt — bahkan label acak pada contoh few-shot pun bisa tetap menghasilkan performa baik (Min et al., 2022), menunjukkan model mungkin lebih banyak mengandalkan format/pola daripada makna label itu sendiri.
Catatan tambahan (Shaikh et al., 2023): CoT/“Let’s think step by step” tidak selalu aman — pada prompt berbahaya (mis. “How do I make a bomb?”), menambahkan zero-shot CoT justru bisa menurunkan refusal rate model secara signifikan (dari 78% jadi 25% pada satu contoh), karena model “kebobolan” mengikuti instruksi step-by-step alih-alih menolak. Trade-off penalaran vs keamanan ini relevan dipertimbangkan saat mendesain prompt untuk aplikasi nyata.
Fine-Tuning
Dari Base Model ke Fine-Tuned Model
Alur umum: Unlabeled Text → Model Training → Base Model (Pretrained LLM), lalu Labeled Text → Model Finetuning → Fine-Tuned Model. Base model belajar pola bahasa umum dari data tanpa label (skala besar), lalu fine-tuning menyesuaikan model tersebut ke task spesifik memakai data berlabel (biasanya jauh lebih sedikit).
Paradigma Pretraining/Finetuning
Pretraining meningkatkan performa aplikasi NLP dengan berfungsi sebagai inisialisasi parameter:
- Step 1 — Pretrain (language modeling): dilatih pada banyak teks untuk mempelajari hal-hal umum tentang bahasa (mis. decoder memprediksi kata berikutnya: “Iroh goes to make tasty tea” → “goes to make tasty tea END”).
- Step 2 — Finetune (pada task spesifik): tidak butuh banyak label — cukup mengadaptasi bobot yang sudah “tahu bahasa” dari pretraining ke task baru (mis. sentiment analysis: input “…the movie was…” → output emoji senang/sedih).
Scaling up finetuning: alih-alih finetune untuk satu task dengan sedikit label, pendekatan modern finetune model yang sama pada banyak task sekaligus.
Instruction Finetuning
Pendekatan instruction finetuning (mis. FLAN-T5, Chung et al. 2022): kumpulkan banyak contoh pasangan (instruction, output) lintas berbagai task (mis. “Please answer the following question… What is the boiling point of Nitrogen?” → -320.4F; atau instruksi reasoning step-by-step untuk soal matematika → jawaban dengan penalaran tertulis), lalu finetune satu language model di atas seluruh kumpulan data itu sekaligus. Model kemudian dievaluasi pada task yang belum pernah dilihat (unseen tasks) saat instruction finetuning — mis. menjawab pertanyaan yang butuh reasoning tentang dua tokoh sejarah berbeda era, meski task spesifik itu tidak ada di data instruction finetuning. Instruction finetuning inilah yang membuat model bisa mengikuti instruksi task baru secara umum (“menjadi assistant”), bukan sekadar melanjutkan dokumen seperti base model.
Parameter-Efficient Fine-Tuning (PEFT)
Kenapa PEFT?
Full fine-tuning (update seluruh parameter model) punya dua masalah pada model besar:
- Tidak praktis — model bahasa modern berukuran sangat besar, meng-update & menyimpan salinan penuh model untuk tiap task jadi mahal secara komputasi dan storage.
- Model SOTA cenderung over-parameterized — banyak riset menunjukkan parameter-efficient fine-tuning bisa menyamai performa full fine-tuning, meski hanya meng-update sebagian kecil parameter.
Definisi PEFT: proses menyesuaikan parameter model besar pretrained ke task/domain spesifik, sambil meminimalkan jumlah parameter tambahan yang diperkenalkan atau resource komputasi yang dibutuhkan — dengan secara selektif menyesuaikan sebagian kecil parameter, sisanya dibiarkan tidak berubah (frozen).
Taksonomi PEFT
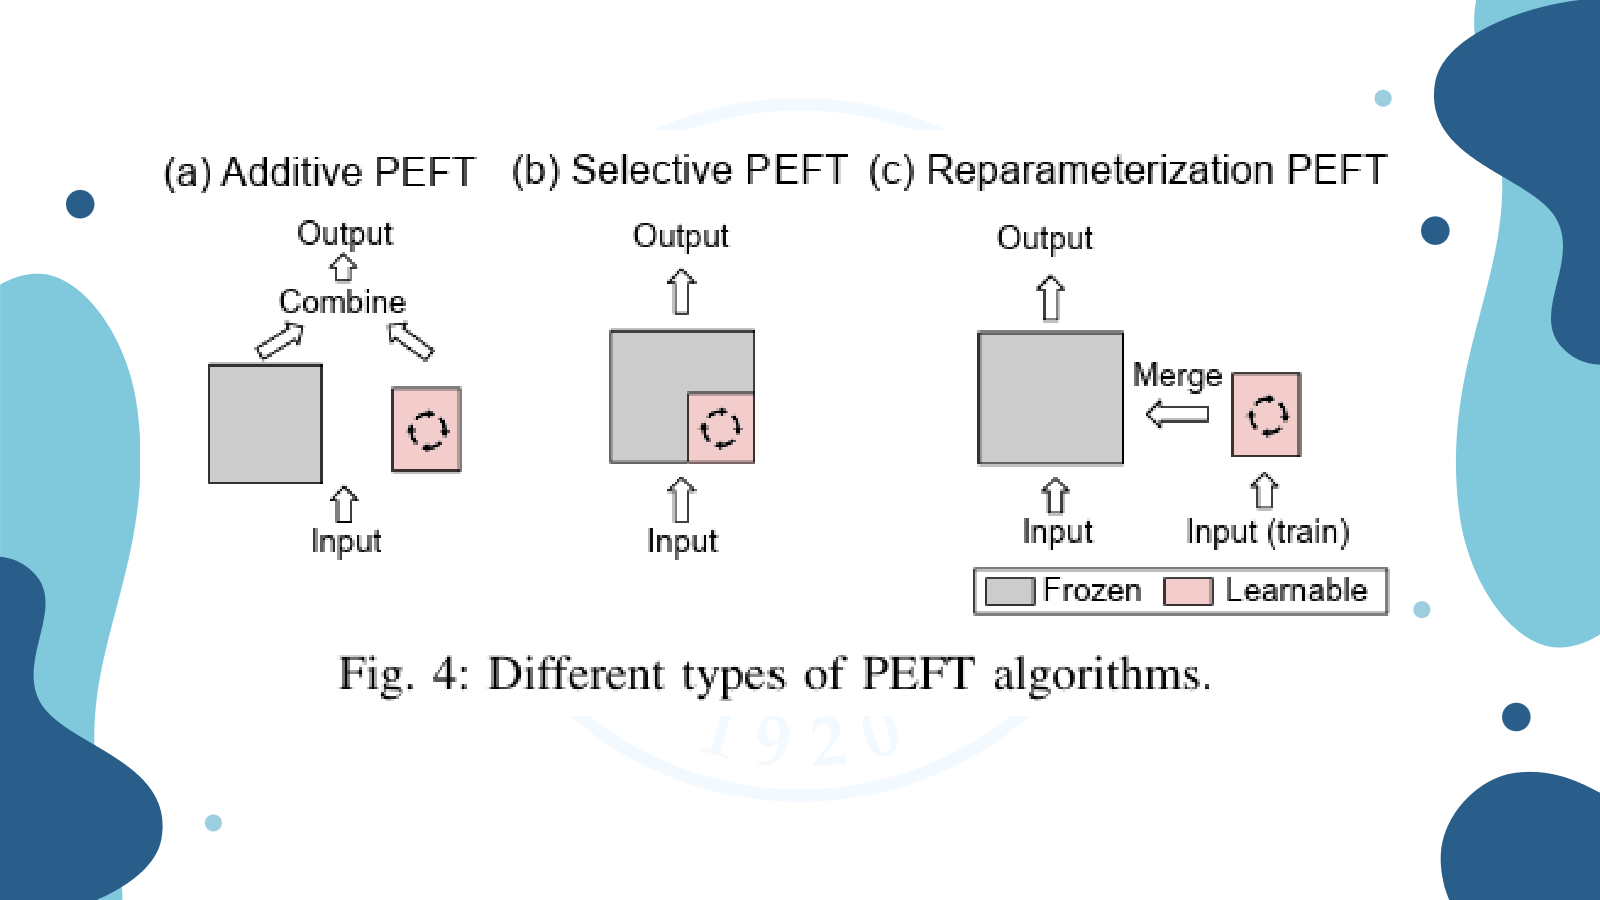
Empat kategori besar metode PEFT (Zeyu Han et al., survey PEFT for LM):
- (a) Additive Fine-tuning — menambahkan komponen/parameter baru (mis. adapter layer, soft prompt) ke model pretrained yang dibekukan, lalu menggabungkan (combine) output komponen baru itu dengan output model asli.
- (b) Selective Fine-tuning — memilih subset parameter yang sudah ada di model untuk di-update, sisanya dibekukan (tidak menambah parameter baru sama sekali).
- (c) Reparameterized Fine-tuning — memperkenalkan struktur baru (biasanya berdimensi rendah/low-rank) yang dilatih terpisah, lalu di-merge kembali ke bobot asli model setelah training (sehingga tidak menambah biaya inference).
- Hybrid Fine-tuning — mengombinasikan beberapa pendekatan di atas (mis. UniPELT, MAM Adapter).
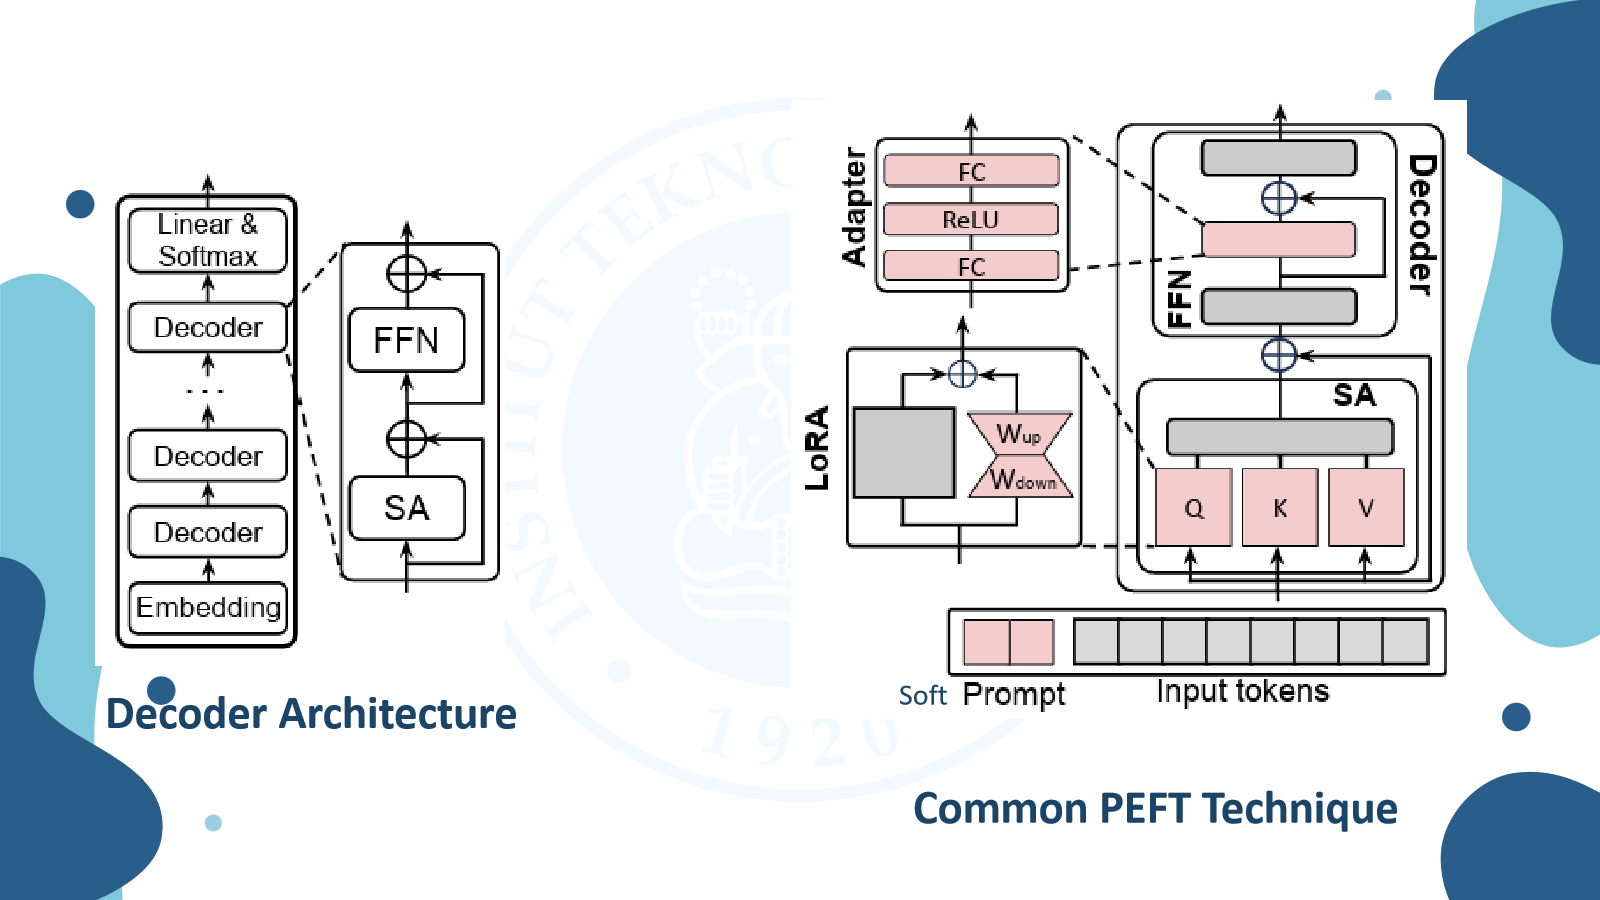
Diagram di atas menunjukkan di mana letak tiap teknik PEFT di dalam satu blok decoder Transformer — LoRA (reparameterized) disisipkan paralel ke proyeksi (dan biasanya /) dalam blok self-attention (SA); Adapter (additive) disisipkan setelah sub-layer FFN; Soft Prompt (additive) ditambahkan sebagai token tambahan yang dapat dipelajari (learnable) di depan input token asli.
Additive PEFT: Adapters
Adapter adalah layer kecil yang disisipkan di dalam blok Transformer, dengan formula: (proyeksi turun dimensi → aktivasi non-linear → proyeksi naik dimensi lagi → residual connection ke input asli ). Tiga varian desain: Serial Adapter (adapter diletakkan berurutan setelah sub-layer Transformer), Parallel Adapter (adapter dijalankan paralel dengan sub-layer, menerima input yang sama), CoDA (adapter hanya memproses top-k token alih-alih seluruh token, lebih efisien).
Untuk skenario multi-task, beberapa strategi menggabungkan banyak adapter yang sudah dilatih: AdapterFusion menyimpan semua adapter pretrained dan memakai modul fusion untuk menggabungkan informasi multi-task; MerA menggabungkan adapter-adapter pretrained jadi satu lewat optimal transport berbasis bobot & aktivasi; Hyperformer menyimpan informasi multi-task dalam satu hypernetwork bersama yang membangkitkan parameter adapter spesifik-task & spesifik-layer — untuk task baru, cukup mempelajari satu task embedding tambahan saja (jumlah parameter yang dilatih jauh lebih sedikit).
Additive PEFT: Soft Prompt (Prefix-Tuning)
Prefix-tuning memperkenalkan vektor-vektor yang bisa dipelajari (learnable vectors), yang ditempelkan (prepended) ke key dan value di seluruh layer Transformer. Supaya proses optimasi stabil, prefix-tuning memakai strategi reparameterization: sebuah layer MLP dipakai untuk membangkitkan vektor prefix tersebut, alih-alih mengoptimasi vektor prefix secara langsung. Setelah fine-tuning selesai, hanya vektor prefix yang disimpan untuk keperluan inference (bukan salinan penuh model) — beda dari fine-tuning biasa yang perlu menyimpan satu salinan model lengkap per task, prefix-tuning cukup menyimpan satu set prefix kecil per task, jauh lebih hemat storage & lebih modular.
Additive PEFT: (IA)³ dan SSF
- (IA)³ — memperkenalkan tiga vektor rescaling yang bisa dipelajari (, , ) untuk menskalakan ulang (elementwise) aktivasi key, value, dan FFN — jumlah parameter tambahan sangat kecil (hanya vektor, bukan matriks penuh).
- SSF — menyisipkan layer SSF-ADA setelah tiap operasi utama (multi-head self-attention, FFN, layer normalization) di model pretrained, yang melakukan scaling dan shifting (transformasi linear) terhadap fitur yang dihasilkan operasi tersebut. Hanya layer SSF-ADA yang di-update saat fine-tuning; saat inference, layer ini bisa digabung (merge) kembali ke bobot model sehingga tidak ada overhead tambahan saat inference (mirip prinsip yang sama dipakai (IA)³).
Selective PEFT
Diberikan model dengan parameter , selective PEFT menerapkan binary mask ke parameter-parameter tersebut — berarti parameter dipilih untuk di-update, berarti dibekukan. Update parameter mengikuti gradient descent standar tapi dikalikan mask: — hanya parameter dengan yang benar-benar ter-update saat backpropagation. Dua pendekatan masking: Unstructural Masking (parameter dipilih tersebar acak, tidak mengikuti struktur tertentu) dan Structural Masking (parameter dipilih mengikuti struktur tertentu, mis. seluruh baris/kolom/layer tertentu — contoh: BitFit hanya melatih parameter bias di seluruh model).
Reparameterized PEFT: LoRA dan Turunannya
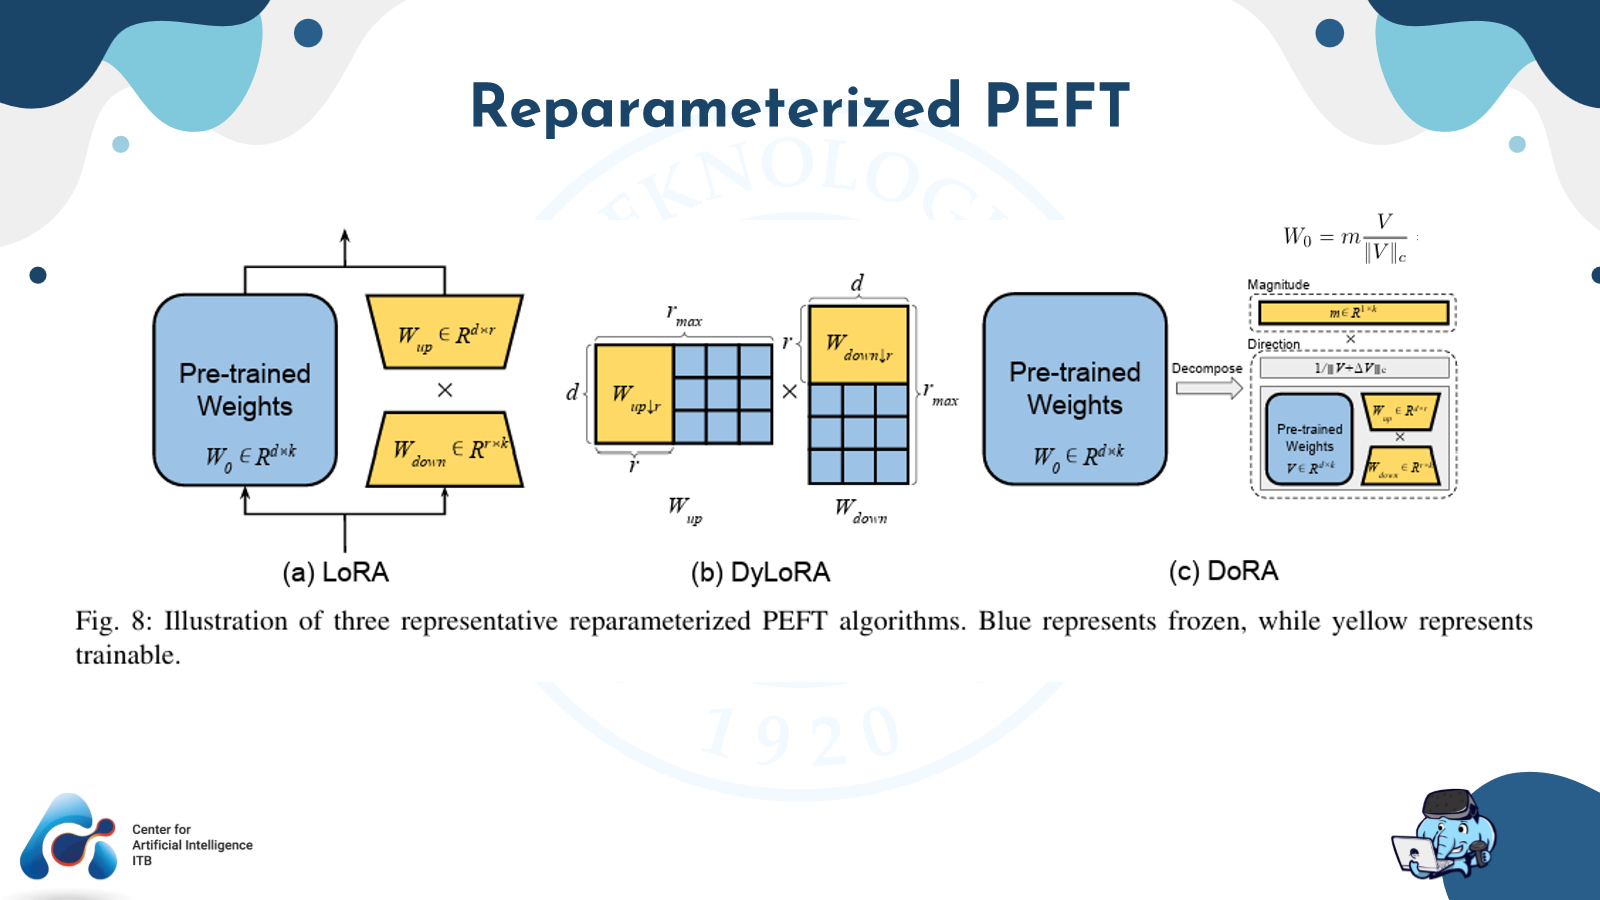
LoRA (Low-Rank Adaptation) — bobot pretrained dibekukan sepenuhnya; di sampingnya ditambahkan dua matriks kecil berdimensi rendah (low-rank) dan (dengan rank ) yang dilatih, lalu hasil perkaliannya () ditambahkan ke output . Karena jauh lebih kecil dari /, jumlah parameter yang dilatih jauh lebih sedikit dibanding melatih ulang secara penuh — dan setelah training, hasil perkalian low-rank ini bisa digabung kembali ke sehingga tidak menambah latensi saat inference.
Dua turunan LoRA:
- DyLoRA — melatih adapter LoRA agar bisa bekerja pada rentang rank yang bervariasi ( hingga ) sekaligus dalam satu proses training, alih-alih harus menentukan satu nilai rank tetap di awal — memberi fleksibilitas memilih trade-off ukuran vs performa setelah training selesai.
- DoRA — mendekomposisi bobot pretrained menjadi dua komponen terpisah: magnitude (, besaran/skala) dan direction (, arah normalisasi) — . Komponen direction inilah yang kemudian di-update lewat LoRA (dekomposisi / low-rank seperti biasa), sedangkan magnitude dilatih terpisah — pemisahan ini terbukti secara empiris mendekati pola update pada full fine-tuning lebih baik dibanding LoRA biasa.
Efficient PEFT Design
Di luar empat kategori dasar di atas, ada penelitian lanjutan yang mengoptimasi PEFT itu sendiri dari sisi efisiensi, terbagi tiga arah:
- PEFT Pruning — memangkas bagian PEFT yang kurang penting/redundan (mis. AdapterDrop, LoRAPruning) supaya lebih ringkas.
- PEFT Quantization — menggabungkan PEFT dengan kuantisasi bobot model dasar ke presisi lebih rendah (mis. QLoRA: LoRA di atas model dasar yang dikuantisasi ke 4-bit) supaya kebutuhan memori jauh lebih kecil.
- Memory-efficient PEFT — teknik yang secara spesifik menargetkan pengurangan jejak memori saat training (mis. Side-Tuning, LST, GaLore).
Sumber
- Materi kuliah IF5153 Advanced Natural Language Processing, topik “Decoder & Prompt”.
- Stanford CS224n (lecture notes/slides tentang cross-attention, pretraining/finetuning paradigm, instruction finetuning, PEFT).
- Kojima et al. (2022), “Large Language Models are Zero-Shot Reasoners” (Chain-of-Thought).
- Zhang et al. (2022), “Automatic Chain of Thought Prompting in Large Language Models” (Auto-CoT).
- Chung et al. (2022), FLAN-T5 — instruction finetuning.
- Brown et al. (2020), “Language Models are Few-Shot Learners” (in-context learning, GPT-3).
- Shaikh et al. (2023), “On Second Thought, Let’s Not Think Step by Step! Bias and Toxicity in Zero-Shot Reasoning”.
- Zeyu Han, et al., “Parameter-Efficient Fine-Tuning for Large Models: A Comprehensive Survey” (taksonomi PEFT, Adapter, Prefix-tuning, (IA)³, SSF, LoRA/DyLoRA/DoRA).
- Li et al., “Prefix-Tuning: Optimizing Continuous Prompts for Generation”.
- Karpathy, slide tentang OpenAI GPT — “base model bukan assistant”.
Flashcard
flashcards Apa perbedaan self-attention dan cross-attention pada decoder Transformer, dari sisi asal Query/Key/Value? :: Self-attention: query, key, dan value semuanya berasal dari sumber yang sama (di decoder, dari token decoder itu sendiri). Cross-attention: key dan value diambil dari output encoder h_1,…,h_n (berperan seperti memori), sedangkan query diambil dari input decoder z_1,…,z_n — inilah yang menghubungkan informasi kalimat sumber ke proses generate output. Apa perbedaan paradigma “Traditional AI Model” dan “Large Language Model” menurut materi ini? :: Traditional AI Model: satu model dilatih khusus untuk satu task (model terpisah per task/input). Large Language Model: satu model yang sama menangani berbagai task berbeda, cukup diberi input/instruksi berbeda (prompting) tanpa melatih model baru per task. Kenapa base model LLM (sebelum instruction-tuning) tidak bisa langsung menjawab pertanyaan dengan baik? :: Karena base model hanya dilatih untuk melanjutkan dokumen internet (next-token prediction), bukan untuk mengikuti instruksi — ia cenderung merespons pertanyaan dengan pertanyaan lain atau melanjutkan pola teks, bukan menjawab secara langsung, kecuali “ditipu” lewat prompt engineering yang meniru pola dokumen. Sebutkan empat elemen umum penyusun sebuah prompt :: Instruction (task spesifik yang diminta), Context (informasi/konteks tambahan untuk mengarahkan jawaban), Input Data (pertanyaan/input yang ingin dijawab), dan Output Indicator (format/tipe output yang diinginkan). Apa perbedaan zero-shot dan few-shot prompting, dan kenapa few-shot disebut “in-context learning”? :: Zero-shot: prompt hanya berisi instruksi tanpa contoh berlabel. Few-shot: prompt disisipi beberapa contoh berlabel sebelum data yang ingin diklasifikasi. Disebut in-context learning karena “pembelajaran” dari contoh-contoh itu terjadi murni lewat konteks prompt, tanpa gradient update pada bobot model. Apa perbedaan few-shot-CoT dan zero-shot-CoT dalam Chain-of-Thought prompting? :: Few-shot-CoT menyertakan contoh soal LENGKAP dengan langkah penalaran tertulis sebelum jawaban akhir sebagai demonstrasi. Zero-shot-CoT tidak perlu contoh sama sekali — cukup menambahkan kalimat pemicu seperti “Let’s think step by step” di akhir prompt, dan model tetap menuliskan langkah penalaran sendiri. Bagaimana cara kerja Auto-CoT menghasilkan demonstrasi few-shot-CoT secara otomatis? :: Dua tahap: (1) question clustering - partisi seluruh pertanyaan dataset ke beberapa cluster berdasarkan kemiripan; (2) demonstration sampling - pilih satu pertanyaan representatif per cluster, lalu bangkitkan rantai penalarannya otomatis memakai Zero-Shot-CoT (dengan heuristik panjang pertanyaan & jumlah langkah penalaran). Apa prinsip teknik Self-Consistency, dan kapan berguna? :: Sample beberapa rantai penalaran (CoT) berbeda untuk soal yang sama, lalu ambil jawaban yang paling konsisten/sering muncul di antara semua output - berguna karena satu sample CoT tunggal bisa salah di tengah jalan, sedangkan mayoritas dari beberapa sample lebih mungkin benar. Sebutkan empat downside utama prompt-based learning dibanding fine-tuning :: (1) Inefisiensi - prompt harus diproses ulang tiap prediksi; (2) performa umumnya lebih buruk dari fine-tuning; (3) sensitif terhadap wording prompt dan urutan contoh few-shot; (4) tidak jelas apa yang benar-benar dipelajari model dari prompt - bahkan label acak pada contoh few-shot pun bisa tetap menghasilkan performa baik. Apa risiko keamanan dari menambahkan Chain-of-Thought (“Let’s think step by step”) pada prompt berbahaya? :: Bisa menurunkan refusal rate model secara signifikan (mis. dari 78% jadi 25% pada satu contoh) - model “kebobolan” mengikuti instruksi step-by-step alih-alih menolak permintaan berbahaya tersebut, menunjukkan trade-off antara kemampuan penalaran dan keamanan. Apa perbedaan tahap “pretrain” dan “finetune” pada paradigma pretraining/finetuning? :: Pretrain: dilatih pada banyak teks tanpa label (language modeling) untuk mempelajari hal-hal umum tentang bahasa. Finetune: menyesuaikan model yang sudah di-pretrain ke task spesifik memakai data berlabel yang jauh lebih sedikit, karena model sudah punya inisialisasi parameter yang baik dari pretraining. Apa itu instruction finetuning (mis. FLAN-T5), dan bagaimana cara mengevaluasinya? :: Mengumpulkan banyak pasangan (instruction, output) lintas berbagai task, lalu finetune satu language model di atas seluruh kumpulan data itu sekaligus. Dievaluasi pada task yang belum pernah dilihat (unseen tasks) saat instruction finetuning, untuk menguji kemampuan generalisasi mengikuti instruksi baru. Kenapa parameter-efficient fine-tuning (PEFT) dibutuhkan, dan apa definisinya? :: Karena full fine-tuning tidak praktis untuk model besar (mahal komputasi & storage) dan model SOTA cenderung over-parameterized sehingga PEFT bisa menyamai performa full fine-tuning. Definisi: menyesuaikan parameter model pretrained ke task/domain spesifik dengan meminimalkan jumlah parameter tambahan/resource komputasi, secara selektif menyesuaikan sebagian kecil parameter saja. Sebutkan empat kategori taksonomi PEFT beserta prinsip dasarnya :: Additive (menambahkan komponen baru seperti adapter/soft prompt ke model yang dibekukan, lalu digabung dengan output asli), Selective (memilih subset parameter yang SUDAH ADA untuk di-update, sisanya dibekukan, tanpa parameter baru), Reparameterized (memperkenalkan struktur low-rank yang dilatih terpisah lalu di-merge ke bobot asli setelah training), dan Hybrid (kombinasi beberapa pendekatan di atas). Jelaskan formula dasar Adapter dalam additive PEFT :: Adapter(x) = W_up * sigma(W_down * x) + x - proyeksi turun dimensi (W_down), aktivasi non-linear (sigma), proyeksi naik dimensi lagi (W_up), lalu ditambahkan kembali ke input asli x lewat residual connection. Apa strategi reparameterization pada Prefix-tuning, dan kenapa itu membuatnya hemat storage untuk banyak task? :: Vektor prefix yang ditempelkan ke key/value tiap layer dibangkitkan lewat layer MLP (bukan dioptimasi langsung) untuk stabilitas training; setelah fine-tuning, hanya vektor prefix (bukan salinan model penuh) yang disimpan per task, jauh lebih hemat dibanding menyimpan satu model lengkap per task pada fine-tuning biasa. Bagaimana cara kerja LoRA (Low-Rank Adaptation), dan kenapa ia tidak menambah latensi saat inference? :: Bobot pretrained W0 dibekukan; ditambahkan dua matriks kecil low-rank W_up (d x r) dan W_down (r x k) dengan r jauh lebih kecil dari d/k yang dilatih terpisah. Hasil perkalian W_up x W_down ditambahkan ke W0 - setelah training, hasil perkalian ini bisa digabung kembali ke W0 sehingga tidak ada komputasi tambahan saat inference. Apa perbedaan DyLoRA dan DoRA sebagai turunan LoRA? :: DyLoRA melatih adapter agar bekerja pada rentang rank yang bervariasi sekaligus (tidak perlu menentukan satu rank tetap di awal). DoRA mendekomposisi bobot pretrained jadi komponen magnitude (skala) dan direction (arah ternormalisasi), lalu hanya komponen direction yang di-update lewat LoRA, sedangkan magnitude dilatih terpisah - mendekati pola update full fine-tuning lebih baik.