Catatan dari materi 1791180311765_9-Sentence-Comparison.pdf, membahas Sentence Comparison — membandingkan dua kalimat/teks, baik lewat kemiripan (similarity) maupun klasifikasi pasangan kalimat. Termasuk kategori Text Comparison/Similarity di silabus (lihat Pengantar Kelas). Melanjutkan konsep CLS token dan arsitektur encoder BERT dari Transformer & BERT — bagian itu dianggap sudah dikuasai dan tidak diulang detailnya di sini.
Lexical-Based Sentence Comparison
Dua kalimat direpresentasikan sebagai vektor sparse (mis. bag-of-words — tiap elemen vektor menandai ada/tidaknya suatu kata, mayoritas elemen bernilai 0, makanya disebut “sparse”), lalu dibandingkan dengan Cosine Similarity.
Contoh: “Institut Teknologi Bandung” → , “Bandung Institute of Technology” → (overlap hanya di kata “Bandung”/representasinya).
- Menunjukkan jarak leksikal (berdasarkan kata yang sama persis) antara dua teks.
- Cocok untuk information retrieval (bandingkan query vs semua dokumen di korpus) atau clustering (tiap dokumen dibandingkan dengan dokumen lain di korpus).
- Jarak diurutkan (rank) dari skor cosine — skor cosine lebih tinggi berarti jarak lebih kecil (dua teks lebih mirip).
Sentence Embedding (Semantic) Based Sentence Comparison
Sama seperti di atas, tapi representasi kalimatnya dense (vektor berisi angka pecahan di hampir semua elemen, mis. — bukan 0/1 sparse) dari hasil sentence embedding, bukan sekadar kemunculan kata. Cosine similarity dihitung dengan cara yang sama, tapi sekarang mengukur jarak makna (semantik), bukan sekadar kesamaan kata persis — pada contoh kalimat yang sama di atas, skornya naik jadi (lebih mirip secara makna meski kata-katanya beda bahasa).
Sentence Embedding dari Encoder-Based PLM
Mengacu ke arsitektur BERT (lihat 5_Transformer_BERT untuk detail CLS token, attention, dsb.), ada beberapa cara mengambil satu vektor yang mewakili keseluruhan kalimat dari output encoder:
- Hidden state token
[CLS]— diambil sebelum dikalikan dengan bobot klasifikasi (). Contoh: dipakai langsung sebagai sentence embedding, berbeda dari saat dipakai untuk klasifikasi di mana dikalikan menghasilkan logits, lalu softmax menghasilkanprobs. - Rata-rata semua hidden state token, termasuk token
[CLS]dan[SEP]. - Rata-rata hidden state token hasil tokenisasi saja (tanpa
[CLS]dan[SEP]).
Ketiga cara ini jadi fondasi untuk model-model sentence embedding khusus di bawah.
BERT yang Di-fine-tune Khusus untuk Task Perbandingan Kalimat
BERT dasar hanya dilatih dengan Masked Language Model dan Next Sentence Prediction (lihat 5_Transformer_BERT). Untuk tugas perbandingan kalimat, BERT di-fine-tune lebih lanjut dengan data yang spesifik:
- Natural Language Inference (NLI) — data training: (kalimat 1, kalimat 2, kelas NLI). Tiga kelas: entail (kalimat 2 adalah konsekuensi logis dari kalimat 1, mis. “pertandingan sepak bola dengan banyak pria bermain” → “beberapa pria bermain olahraga”), contradict (kalimat 2 bertentangan dengan kalimat 1), neutral (tidak berhubungan secara logis).
- Semantic Text Similarity (STS) — data training (STS-Benchmark): (kalimat 1, kalimat 2, skor kemiripan 0-5). Contoh: “A man is playing a large flute” vs “A man is playing a flute” → skor 5.0 (sangat mirip); vs “A man is spreading shredded cheese on a pizza” → skor 0.0 (tidak berhubungan).
- SBERT (Sentence-BERT) — di-fine-tune dua kali berturut-turut: dulu dengan NLI, lalu dilanjutkan dengan STS.
Variasi SBERT
SimCSE
- Unsupervised: untuk tiap kalimat, lakukan dua kali forward pass saat training. Karena dropout bersifat random, kedua forward pass menghasilkan vektor embedding yang sedikit berbeda meski dari kalimat yang sama — kedua vektor ini disebut “anchor” dan “positive”. Untuk kalimat, didapat vektor embedding. Hitung matriks kemiripan tiap “anchor” dengan semua “positive” yang tersedia (pasangan yang benar harus bernilai tinggi), bagi dengan konstanta temperatur (mengatur seberapa tajam distribusi probabilitas setelah softmax), hitung softmax tiap pasangan, hitung loss, lalu update bobot model.
- Supervised: memakai dataset NLI — mirip versi unsupervised, tapi ditambah kalimat “contradiction” sebagai vektor negatif (contoh yang seharusnya tidak mirip, membantu model belajar membedakan).
E5
Dua tahap training:
- Contrastive pre-training — tambahkan pasangan positif dari data weakly supervised (berlabel longgar/tidak sempurna, tapi tersedia melimpah tanpa anotasi manual), mis. judul artikel Wikipedia + paragraf pertamanya, judul post Reddit + komentar teratas, query pencarian + dokumen pertama yang diklik user. Tiap kalimat diberi prefix
"query:"atau"passage:"untuk membedakan perannya. Dihitung contrastive loss: (memaksimalkan kemiripan pasangan positif relatif terhadap semua kandidat lain). - Supervised fine-tuning — pakai dataset NLI, retrieval, dan QA, dengan tambahan hard negative (kalimat yang mirip secara permukaan tapi salah secara makna, mis. query “Apa ibu kota Prancis?” dengan positive “Paris adalah ibu kota Prancis” dan hard negative “Lyon adalah kota terbesar kedua di Prancis” — sengaja dipilih yang menyesatkan supaya model belajar lebih presisi).
BGE-M3
Model multilingual (dilatih dari >100 bahasa), dengan tiga karakteristik utama:
- Multi-Linguality — bisa memasangkan kalimat dalam bahasa yang sama (Indonesia-Indonesia, Inggris-Inggris) maupun cross-lingual (query bahasa Indonesia dicocokkan dengan dokumen bahasa Inggris, dan sebaliknya).
- Multi-Functionality — mendukung tiga jenis retrieval sekaligus: dense retrieval (lewat cosine similarity atas sentence embedding, ), sparse retrieval (skor dari pencocokan kata/term seperti pada pendekatan lexical di atas, ), dan multi-vector retrieval (tiap token query dicocokkan dengan token dokumen paling mirip lalu dijumlahkan, ).
- Multi-Granularity — bisa menangani teks level kalimat, paragraf (passage), hingga dokumen penuh (sampai 8192 token).
Kontribusi utama BGE-M3: data curation (gabungan data unsupervised, supervised, dan sintetis), hybrid retrieval (skor akhir = kombinasi berbobot ketiga jenis retrieval di atas: ), self-knowledge distillation (model belajar dari prediksi gabungan ketiga metode retrieval-nya sendiri), dan efficient batching.
Klasifikasi untuk Dua Kalimat Input
Selain mengukur similarity, pasangan kalimat juga bisa langsung diklasifikasikan ke suatu label:
- Paraphrase Identification — (kalimat 1, kalimat 2, kelas: duplicate/not duplicate). Contoh: “How do I lose weight fast?” vs “What is the quickest way to lose weight?” → duplicate.
- NLI → entail/contradict/neutral (lihat definisi di atas).
- QNLI (Question Answering NLI) dan RTE (Recognizing Textual Entailment) → disederhanakan jadi 2 kelas: entailment vs not entailment.
- Fact Verification → supports/refutes/not enough info.
- Stance Detection → agree/disagree/discuss/unrelated — mis. headline “Vaccines cause autism, new study claims” vs isi artikel yang justru menyangkalnya → label disagree.
Tiga Arsitektur untuk Mengklasifikasi/Membandingkan Dua Kalimat
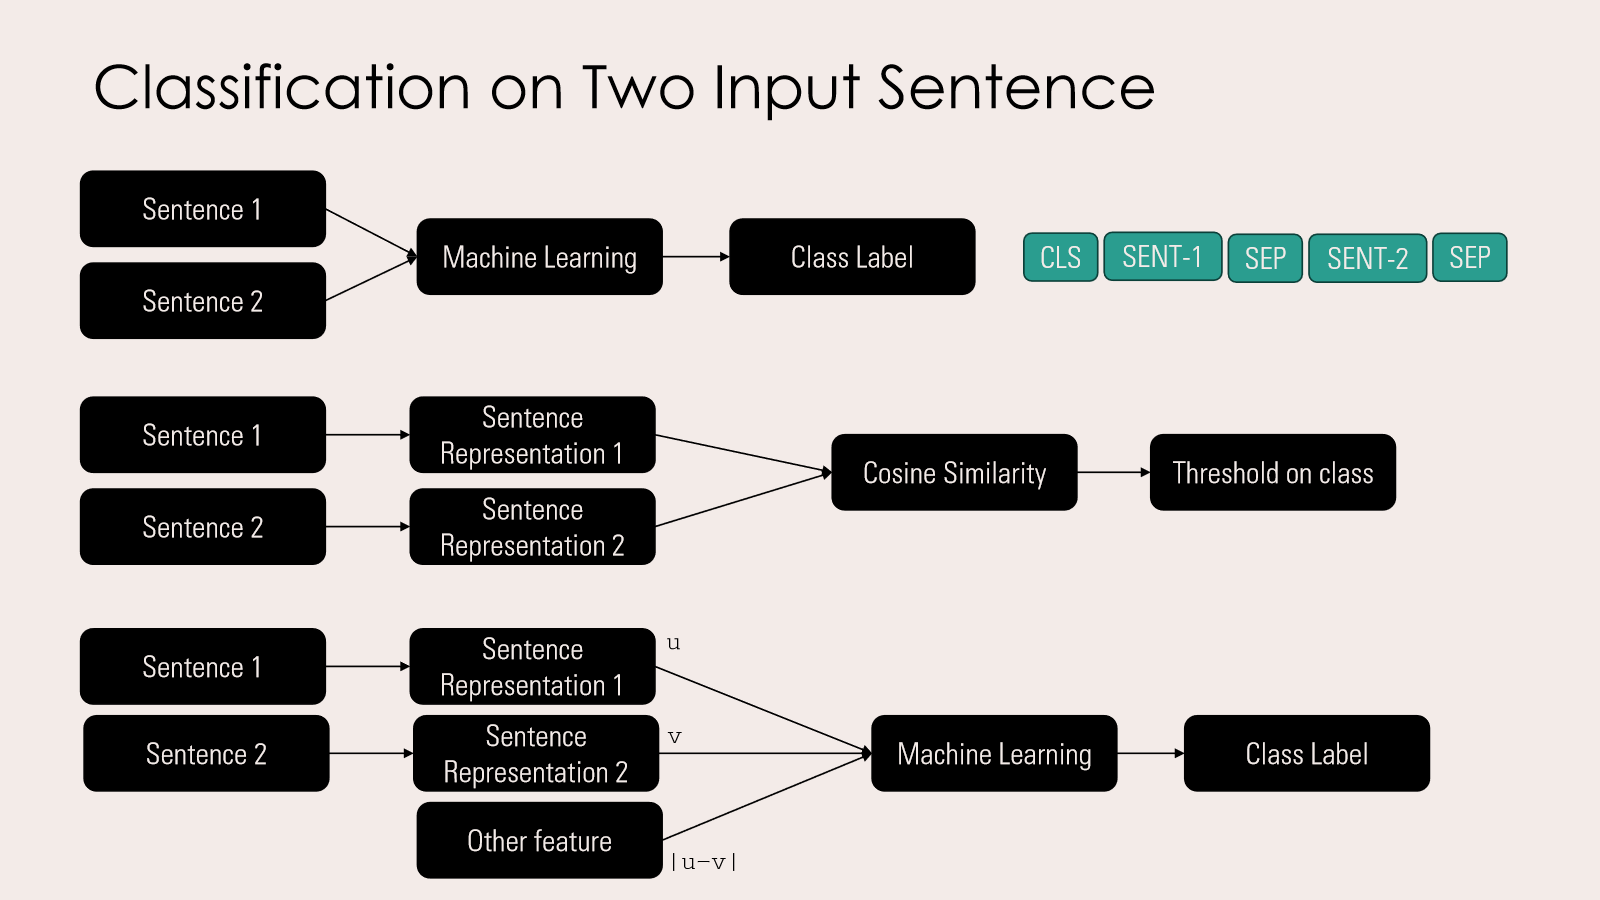
- Cross-Encoder — kedua kalimat digabung jadi satu input sekaligus (format:
[CLS] SENT-1 [SEP] SENT-2 [SEP]), diproses bersama lewat satu model, lalu diklasifikasi langsung jadi class label. Paling akurat (model bisa saling “melihat” kedua kalimat lewat attention sejak awal), tapi mahal: untuk membandingkan 1 kalimat terhadap kalimat lain, perlu kali forward pass penuh. - Bi-Encoder + Cosine Similarity — tiap kalimat diproses terpisah jadi representasinya masing-masing (encoding bisa dihitung sekali dan disimpan/cache), baru dibandingkan lewat cosine similarity, lalu diberi threshold untuk menentukan kelasnya. Jauh lebih efisien untuk skala besar (gaya kerja SBERT).
- Bi-Encoder + Classifier Tambahan — representasi dan dari tiap kalimat (dihasilkan terpisah seperti opsi 2), digabung dengan fitur tambahan seperti (selisih absolut elemen-wise, menangkap seberapa beda kedua vektor), lalu fitur gabungan ini dimasukkan ke model machine learning (bukan cuma cosine similarity) untuk menghasilkan class label.
Penting soal “Machine Learning” pada tiap arsitektur — kotak “Machine Learning” di skema 1 dan 3 tidak berarti hal yang sama:
- Pada Cross-Encoder (1), input-nya adalah token mentah (urutan kata, panjang berubah-ubah per kalimat) — bukan vektor fitur siap pakai. Yang bisa mengolah input seperti ini hanya model neural sequence (transformer/BERT, atau dulu RNN) yang punya embedding layer + attention/recurrence bawaan. Algoritma classical ML seperti SVM, decision tree, random forest, atau logistic regression tidak bisa dipakai di sini — semuanya cuma bisa menerima vektor fitur berukuran tetap, bukan sequence token mentah. Jadi “Machine Learning” pada Cross-Encoder = transformer yang di-fine-tune end-to-end (ekstraksi fitur dan klasifikasi jadi satu proses, dilatih bersamaan).
- Pada Bi-Encoder + Classifier (3), input ke “Machine Learning”-nya sudah berupa vektor fitur berukuran tetap (, , ) — hasil encoding yang sudah selesai duluan. Di titik ini, algoritma classical ML apa saja bisa dipakai: SVM, decision tree, random forest, logistic regression, Naive Bayes, dst. Decision tree butuh vektor fitur sama seperti SVM — bukan cuma SVM yang punya syarat itu, hampir semua classical ML (kecuali model neural sequence) memang bekerja di atas data tabular/vektor, bukan teks mentah.
Trade-off utama: cross-encoder lebih akurat tapi tidak bisa di-precompute/di-cache (harus menjalankan ulang model tiap kali ada pasangan baru); bi-encoder bisa menghitung & menyimpan embedding tiap kalimat sekali saja, lalu dipakai berulang untuk dibandingkan ke banyak kalimat lain secara cepat — ini sebabnya SBERT dirancang sebagai bi-encoder: agar skala ke jutaan dokumen tetap praktis.
Zero-Shot Text Classification dengan NLI
XLM-RoBERTa-Large-XNLI — model encoder multilingual (>100 bahasa), di-fine-tune khusus pada XNLI (versi NLI multilingual, 15 bahasa: Inggris, Prancis, Spanyol, Jerman, dst). Bisa dipakai untuk klasifikasi teks tanpa data training (zero-shot) dengan trik memanfaatkan kemampuan NLI-nya:
- Kalimat input dijadikan “premise”, tiap kandidat label dijadikan “hypothesis” berbentuk
"this text is {_class_}". - Jalankan model NLI untuk tiap pasangan (premise, hypothesis kandidat).
- Ambil probabilitas kelas entailment dari tiap pasangan — kandidat label dengan tertinggi dianggap sebagai kelas prediksi.
Contoh: kalimat “I just adopted a puppy and I’m so excited!” diuji terhadap 4 hipotesis (“this text is sports/pets/politics/technology”) — hipotesis “this text is pets” mendapat (tertinggi), sehingga diprediksi sebagai kelas pets. Trik ini memanfaatkan model NLI yang sudah dilatih tanpa perlu data training khusus untuk task klasifikasi barunya.
Sumber
- Materi kuliah IF5153 Advanced Natural Language Processing, topik “Sentence Comparison”.
- Reimers & Gurevych (2019), “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks” (sumber arsitektur cross-encoder vs bi-encoder, SBERT NLI→STS fine-tuning).
- Gao et al. (2021), “SimCSE: Simple Contrastive Learning of Sentence Embeddings”.
- Wang et al., “E5: Text Embeddings by Weakly-Supervised Contrastive Pre-training”.
- Chen et al., “BGE M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings”.
Flashcard
flashcards Apa perbedaan representasi sparse dan dense dalam konteks lexical-based vs embedding-based sentence comparison? :: Sparse (lexical-based) = vektor yang mayoritas elemennya 0, hanya menandai ada/tidaknya kata tertentu (mis. bag-of-words); dense (embedding-based) = vektor berisi angka pecahan di hampir semua elemen hasil sentence embedding, menangkap makna/semantik bukan sekadar kata yang sama persis. Sebutkan tiga cara mengambil sentence embedding dari encoder-based PLM (BERT) :: (1) Hidden state token [CLS] sebelum dikalikan bobot klasifikasi, (2) rata-rata semua hidden state termasuk [CLS] dan [SEP], (3) rata-rata hidden state hasil tokenisasi saja tanpa [CLS]/[SEP]. Apa perbedaan data training untuk fine-tuning NLI vs STS pada BERT? :: NLI: (kalimat1, kalimat2, kelas kategorikal entail/contradict/neutral). STS: (kalimat1, kalimat2, skor kemiripan numerik 0-5 dari STS-Benchmark). SBERT di-fine-tune dua kali berturut-turut: NLI dulu, baru STS. Bagaimana SimCSE versi unsupervised menghasilkan pasangan “anchor” dan “positive” tanpa data berlabel? :: Dengan melakukan dua forward pass berbeda untuk kalimat yang sama; karena dropout bersifat random, kedua forward pass menghasilkan vektor embedding yang sedikit berbeda meski dari kalimat identik — kedua vektor ini dipakai sebagai pasangan anchor dan positive. Apa itu “hard negative” pada fine-tuning E5, dan kenapa penting? :: Kalimat yang mirip secara permukaan/topik tapi salah secara makna (mis. “Lyon adalah kota terbesar kedua di Prancis” sebagai hard negative untuk query “Apa ibu kota Prancis?”). Penting karena memaksa model belajar membedakan kemiripan permukaan dari kebenaran faktual/semantik, bukan cuma menghindari negatif yang jelas-jelas tidak berhubungan. Sebutkan tiga karakteristik utama BGE-M3 dan apa arti masing-masing :: Multi-Linguality (mendukung >100 bahasa termasuk pencocokan cross-lingual), Multi-Functionality (mendukung dense, sparse, dan multi-vector retrieval sekaligus), Multi-Granularity (bisa menangani teks level kalimat sampai dokumen hingga 8192 token). Apa perbedaan arsitektur cross-encoder dan bi-encoder untuk membandingkan/mengklasifikasi dua kalimat? :: Cross-encoder menggabung dua kalimat jadi satu input ([CLS] SENT-1 [SEP] SENT-2 [SEP]) dan diproses bersama sekaligus — akurat tapi mahal untuk skala besar. Bi-encoder memproses tiap kalimat terpisah jadi representasi masing-masing (bisa di-cache), baru dibandingkan lewat cosine similarity atau classifier tambahan — jauh lebih efisien untuk dibandingkan ke banyak kalimat. Mengapa bi-encoder lebih cocok untuk sistem skala besar (mis. retrieval atas jutaan dokumen) dibanding cross-encoder, meski cross-encoder lebih akurat? :: Karena representasi tiap kalimat pada bi-encoder bisa dihitung sekali dan disimpan/di-cache, lalu dipakai berulang untuk dibandingkan ke banyak kalimat lain secara cepat (tinggal cosine similarity). Cross-encoder harus menjalankan ulang model penuh untuk setiap pasangan baru, sehingga butuh N forward pass penuh untuk membandingkan 1 kalimat ke N kalimat lain. Bagaimana trik zero-shot text classification memakai XLM-RoBERTa-Large-XNLI bekerja? :: Kalimat input dijadikan premise, tiap kandidat label diubah jadi hypothesis berformat “this text is {label}”, lalu dijalankan sebagai task NLI untuk tiap pasangan — kandidat label dengan probabilitas entailment tertinggi dipilih sebagai kelas prediksi, tanpa perlu data training khusus untuk task tersebut. Pada fitur tambahan |u-v| di arsitektur bi-encoder+classifier, apa yang direpresentasikan oleh fitur ini? :: Selisih absolut elemen-wise antara vektor representasi dua kalimat (u dan v) — menangkap seberapa besar/arah perbedaan antara kedua representasi, sebagai fitur tambahan di luar vektor u dan v itu sendiri untuk classifier machine learning. Kenapa SVM atau decision tree TIDAK bisa dipakai sebagai “Machine Learning” pada arsitektur Cross-Encoder, tapi BISA dipakai pada Bi-Encoder + Classifier? :: Karena input Cross-Encoder adalah token mentah (sequence, panjang berubah-ubah) yang hanya bisa diproses model neural sequence (transformer/BERT) lewat embedding+attention bawaannya. Classical ML (SVM, decision tree, dst) hanya menerima vektor fitur berukuran tetap — pada Bi-Encoder+Classifier, input ke classifier sudah berupa vektor (u, v, |u-v|) hasil encoding yang selesai duluan, jadi classical ML apa saja bisa dipakai di situ.
Glossary
Istilah yang muncul di catatan ini, dikelompokkan sesuai urutan kemunculannya.
Representasi & Kemiripan Teks
| Istilah | Penjelasan |
|---|---|
| Cosine Similarity | Ukuran kemiripan dua vektor berdasarkan sudut di antara keduanya (bukan jaraknya) — nilainya 0 (sangat beda arah) sampai 1 (persis searah/sama). Dipakai di sini untuk mengukur semirip apa dua kalimat. |
| Sparse vector | Vektor yang mayoritas elemennya bernilai 0 — mis. bag-of-words, tiap posisi cuma menandai “kata ini ada/tidak”, bukan makna kata itu. |
| Dense vector | Vektor yang hampir semua elemennya berisi angka pecahan bermakna (bukan 0/1) — hasil dari model embedding, menangkap makna bukan sekadar kata persis sama. |
| Bag-of-words | Cara representasi teks paling sederhana: tiap kalimat jadi vektor yang isinya cuma “kata apa saja yang muncul”, tanpa peduli urutan kata. |
| Sentence embedding | Satu vektor (dense) yang jadi “ringkasan makna” dari sebuah kalimat utuh, dihasilkan oleh model seperti BERT. |
| Information retrieval | Proses mencari dokumen paling relevan dari sekumpulan dokumen besar berdasarkan sebuah query (mis. mesin pencari). |
| Clustering | Mengelompokkan data (di sini: dokumen/kalimat) yang mirip satu sama lain ke dalam grup yang sama, tanpa label yang ditentukan di awal. |
| Pooling | Cara meringkas banyak vektor (mis. hidden state tiap token) jadi satu vektor — contoh pooling yang dipakai di catatan ini: ambil token [CLS], atau rata-rata semua token. |
Konsep Training / Fine-Tuning
| Istilah | Penjelasan |
|---|---|
| Hidden state | Vektor output dari suatu layer di dalam model (mis. output encoder BERT untuk satu token) — lihat 5_Transformer_BERT untuk konteks arsitekturnya. |
| Logits | Angka mentah hasil perhitungan model sebelum diubah jadi probabilitas — belum dinormalisasi, bisa negatif/lebih dari 1. |
| Softmax | Fungsi yang mengubah sekumpulan logits jadi distribusi probabilitas (semua nilai antara 0-1, totalnya 1). |
| Dropout | Teknik regularisasi saat training: sebagian neuron “dimatikan” secara acak di tiap forward pass, supaya model tidak terlalu bergantung pada neuron tertentu. Dipakai SimCSE untuk membuat dua versi embedding yang sedikit beda dari kalimat yang sama. |
| Anchor / Positive / Negative | Istilah dari contrastive learning: anchor = contoh acuan, positive = contoh yang seharusnya mirip dengan anchor, negative = contoh yang seharusnya tidak mirip. Model dilatih mendekatkan anchor-positive dan menjauhkan anchor-negative. |
| Hard negative | Contoh negative yang sengaja dipilih mirip secara permukaan/topik tapi sebenarnya salah/tidak relevan — melatih model membedakan lebih presisi dibanding negative yang asal beda. |
| Temperature constant (τ) | Angka pembagi pada skor kemiripan sebelum softmax — makin kecil nilainya, makin “tajam”/ekstrem perbedaan antar probabilitas hasil softmax. |
| Contrastive loss | Fungsi loss yang melatih model supaya skor kemiripan anchor-positive setinggi mungkin relatif terhadap anchor-kandidat lain — dasar training SimCSE dan E5. |
| Weakly supervised | Data yang berlabel “longgar”/tidak sempurna tapi tersedia melimpah tanpa anotasi manual (mis. judul artikel + paragraf pertamanya dianggap “pasangan yang berhubungan”, meski tidak ada orang yang mengecek satu-satu). |
| Self-knowledge distillation | Model belajar dari hasil prediksinya sendiri (gabungan dari beberapa cara/metode internal) sebagai “guru”, bukan dari label eksternal. |
| Zero-shot (classification) | Mengklasifikasikan data ke kategori yang belum pernah dilihat modelnya saat training — tidak perlu data contoh untuk kelas-kelas baru tersebut. |
Task & Dataset
| Istilah | Penjelasan |
|---|---|
| NLI (Natural Language Inference) | Task menentukan hubungan logis dua kalimat: apakah kalimat kedua merupakan konsekuensi (entail), bertentangan (contradict), atau tidak berhubungan (neutral) dengan kalimat pertama. |
| STS (Semantic Text Similarity) | Task memberi skor numerik (0-5) seberapa mirip makna dua kalimat. |
| Paraphrase Identification | Task menentukan apakah dua kalimat punya makna yang sama meski kata-katanya beda (duplicate/not duplicate). |
| QNLI | Versi NLI yang disederhanakan jadi 2 kelas untuk task question-answering: entailment vs not entailment. |
| RTE (Recognizing Textual Entailment) | Mirip QNLI — task biner entailment vs not entailment, versi lebih umum/lama dari NLI. |
| Fact Verification | Task menentukan apakah suatu klaim didukung, dibantah, atau tidak cukup informasi dari suatu sumber (supports/refutes/not enough info). |
| Stance Detection | Task menentukan sikap suatu teks terhadap teks lain: setuju, tidak setuju, sekadar membahas, atau tidak berhubungan (agree/disagree/discuss/unrelated). |
| Premise / Hypothesis | Istilah dalam NLI: premise = kalimat/pernyataan acuan, hypothesis = kalimat yang diuji benar/salah/berhubungan terhadap premise tersebut. |
Arsitektur & Model
| Istilah | Penjelasan |
|---|---|
| Cross-Encoder | Arsitektur yang memproses dua kalimat sekaligus dalam satu input ke model — akurat tapi mahal karena harus diproses ulang tiap pasangan baru. |
| Bi-Encoder | Arsitektur yang memproses tiap kalimat terpisah jadi vektornya masing-masing (bisa disimpan/dipakai ulang) — lebih efisien untuk skala besar. |
| Threshold | Nilai batas yang dipakai untuk mengubah skor kemiripan (angka kontinu) jadi keputusan kelas (mis. “mirip” jika skor cosine > 0.7). |
| SBERT (Sentence-BERT) | Model BERT yang di-fine-tune khusus (NLI lalu STS) supaya cocok dipakai sebagai bi-encoder penghasil sentence embedding berkualitas. |
| SimCSE / E5 / BGE-M3 | Model-model turunan/varian SBERT, beda di cara dan data trainingnya (lihat masing-masing bagian di atas) — tujuan akhirnya sama: menghasilkan sentence embedding yang bagus untuk dibandingkan lewat cosine similarity. |
| XLM-RoBERTa / XNLI | XLM-RoBERTa = model encoder transformer multilingual; XNLI = versi dataset NLI yang diterjemahkan ke banyak bahasa, dipakai untuk fine-tuning XLM-RoBERTa supaya bisa dipakai NLI/zero-shot classification lintas bahasa. |