Versi materi semester 1 2026/2027 (60 slide). Isinya sebagian besar sama dengan 10_XML_Databases (sumber: Silberschatz, Database System Concepts 6th ed. bab 23), tetapi ada tambahan di akhir: definisi XML database, XML-enabled vs native XML database, dan alasan memakai XML di database.
Introduction
XML (Extensible Markup Language) didefinisikan oleh W3C (WWW Consortium) dan diturunkan dari SGML (Standard Generalized Markup Language), tetapi lebih sederhana. Dokumen XML punya tag yang memberi informasi tambahan tentang bagian dokumen, contoh <title> XML </title> <slide> Introduction ... </slide>.
XML bersifat extensible, tidak seperti HTML: pengguna bisa menambah tag baru dan menentukan sendiri cara tag itu ditampilkan.
Kemampuan membuat tag baru dan struktur tag bersarang (nested) membuat XML cocok untuk menukar data, bukan hanya dokumen. Tag membuat data relatif self-documenting, artinya arti tiap nilai terbaca dari tag-nya.
<university>
  <department>
    <dept_name> Comp. Sci. </dept_name>
    <building> Taylor </building>
    <budget> 100000 </budget>
  </department>
  <course>
    <course_id> CS-101 </course_id>
    <title> Intro. to Computer Science </title>
    <dept_name> Comp. Sci </dept_name>
    <credits> 4 </credits>
  </course>
</university>
Motivasi
- Data interchange (pertukaran data) sangat penting di dunia yang terhubung jaringan. Contoh: transfer dana perbankan, pemrosesan order antar-perusahaan, data ilmiah (kimia: ChemML, genetika: BSML atau Bio-Sequence Markup Language).
- Alur kertas antar-organisasi digantikan alur informasi elektronik. Tiap bidang punya standar sendiri untuk merepresentasikan informasi, dan XML menjadi dasar bagi semua format pertukaran data generasi baru.
- Format generasi sebelumnya berbasis teks biasa dengan header baris yang menandai arti tiap field (mirip header email). Kelemahannya: tidak mendukung struktur bersarang, tidak punya bahasa “tipe” standar, dan terlalu terikat pada struktur dokumen tingkat rendah (baris, spasi, dsb).
- Tiap standar berbasis XML mendefinisikan elemen yang valid dengan bahasa spesifikasi tipe XML (DTD atau XML Schema) ditambah deskripsi teks untuk semantiknya. Tag baru boleh dibuat sesuai kebutuhan, tetapi bisa dibatasi oleh DTD. Tersedia banyak tools untuk parsing (membaca dan menguraikan struktur), browsing, dan query dokumen XML.
Perbandingan dengan Data Relasional
- Tidak efisien: tag, yang pada dasarnya adalah informasi skema, diulang-ulang di setiap elemen.
- Lebih baik dari tuple relasional sebagai format pertukaran data:
- self-documenting karena ada tag
- format tidak kaku (tag bisa ditambah)
- mendukung struktur bersarang
- diterima luas, tidak hanya di sistem database tetapi juga di browser, tools, dan aplikasi
Structure of XML Data
- Tag: label untuk suatu bagian data.
- Element: bagian data yang diawali
<tagname>dan diakhiri</tagname>yang cocok. - Elemen harus bersarang dengan benar (properly nested):
- benar:
<course> <title> ... </title> </course> - salah:
<course> <title> ... </course> </title> - formalnya: setiap start tag harus punya end tag unik yang cocok dalam konteks elemen induk yang sama.
- benar:
- Setiap dokumen harus punya satu elemen tingkat-atas (single top-level element).
Nested Elements
Contoh purchase order, dengan elemen item bersarang di dalam itemlist:
<purchase_order>
  <identifier> P-101 </identifier>
  <purchaser> ... </purchaser>
  <itemlist>
    <item>
      <identifier> RS1 </identifier>
      <description> Atom powered rocket sled </description>
      <quantity> 2 </quantity>
      <price> 199.95 </price>
    </item>
    <item>
      <identifier> SG2 </identifier>
      <description> Superb glue </description>
      <quantity> 1 </quantity>
      <unit-of-measure> liter </unit-of-measure>
      <price> 29.95 </price>
    </item>
  </itemlist>
</purchase_order>
Motivasi nesting:
- Nesting berguna untuk transfer data (contoh:
itemdi dalamitemlist). - Nesting tidak didukung atau tidak dianjurkan di database relasional. Dengan banyak order, nama dan alamat customer tersimpan berulang (redundan). Normalisasi (proses memecah tabel agar data tidak berulang) mengganti struktur bersarang dengan foreign key ke tabel customer terpisah. Nesting baru didukung di database object-relational.
- Namun nesting cocok untuk transfer data, karena aplikasi eksternal tidak punya akses langsung ke data yang dirujuk foreign key.
Mixed content (campuran teks dan sub-elemen) sah secara sintaks di XML, berguna untuk document markup tetapi tidak dianjurkan untuk representasi data:
<course>
  This course is being offered for the first time in 2009.
  <course_id> BIO-399 </course_id>
  <title> Computational Biology </title>
  <dept_name> Biology </dept_name>
  <credits> 3 </credits>
</course>
Attributes
Elemen bisa punya attribute, ditulis sebagai pasangan name=value di dalam tag pembuka. Satu elemen boleh punya beberapa atribut, tetapi tiap nama atribut hanya boleh muncul sekali.
<course course_id="CS-101" credits="4">Attributes vs subelements:
- Dalam konteks dokumen, atribut adalah bagian markup, sedangkan isi subelemen adalah bagian isi dokumen.
- Dalam konteks representasi data, bedanya tidak jelas dan bisa membingungkan, karena informasi yang sama bisa ditulis dua cara:
<course course_id="CS-101"> ... </course>

<course>
  <course_id>CS-101</course_id> ...
</course>- Saran: pakai atribut untuk identifier elemen, dan subelemen untuk isi.
Namespaces
Data XML dipertukarkan antar-organisasi, sehingga tag yang sama bisa berarti beda di organisasi berbeda. Solusi: pakai nama unik dengan format unique-name:element-name, dan supaya tidak menulis nama panjang di mana-mana, pakai XML Namespace (prefix yang terikat ke sebuah URI lewat xmlns:prefix).
<university xmlns:yale="http://www.yale.edu">
  ...
  <yale:course>
    <yale:course_id> CS-101 </yale:course_id>
    <yale:title> Intro. to Computer Science </yale:title>
    <yale:dept_name> Comp. Sci. </yale:dept_name>
    <yale:credits> 4 </yale:credits>
  </yale:course>
  ...
</university>
Sintaks Tambahan
- Elemen tanpa subelemen atau isi teks bisa disingkat dengan mengakhiri start tag dengan
/>dan membuang end tag:
<course course_id="CS-101" Title="Intro. To Computer Science"
dept_name="Comp. Sci." credits="4" />- CDATA (character data) dipakai untuk menyimpan string yang mungkin mengandung tag tanpa tag itu dianggap subelemen. Di contoh ini
<course>dan</course>hanya dianggap string:
<![CDATA[<course> ... </course>]]>XML Document Schema
- Skema database membatasi informasi apa yang boleh disimpan dan tipe nilainya.
- Dokumen XML tidak wajib punya skema, tetapi skema sangat penting untuk pertukaran data. Tanpa skema, sebuah situs tidak bisa menafsirkan data dari situs lain secara otomatis.
- Dua mekanisme: DTD (Document Type Definition, banyak dipakai) dan XML Schema (lebih baru, makin banyak dipakai).
Document Type Definition (DTD)
DTD membatasi struktur data XML:
- elemen apa yang boleh muncul
- atribut apa yang boleh atau wajib dimiliki sebuah elemen
- subelemen apa yang boleh atau wajib muncul di dalam elemen, dan berapa kali
DTD tidak membatasi tipe data, semua nilai di XML adalah string.
Sintaks: <!ELEMENT element (subelements-specification)> dan <!ATTLIST element (attributes)>.
Spesifikasi elemen. Subelemen bisa berupa nama elemen, #PCDATA (parsed character data, string biasa), EMPTY (tanpa subelemen), atau ANY (apa pun boleh):
<!ELEMENT department (dept_name, building, budget)>
<!ELEMENT dept_name (#PCDATA)>
<!ELEMENT budget (#PCDATA)>
Spesifikasi subelemen boleh memakai ekspresi reguler: | (alternatif), + (1 kali atau lebih), * (0 kali atau lebih).
<!ELEMENT university ((department | course | instructor | teaches)+)>University DTD lengkap:
<!DOCTYPE university [
  <!ELEMENT university ((department|course|instructor|teaches)+)>
  <!ELEMENT department (dept_name, building, budget)>
  <!ELEMENT course (course_id, title, dept_name, credits)>
  <!ELEMENT instructor (IID, name, dept_name, salary)>
  <!ELEMENT teaches (IID, course_id)>
  <!ELEMENT dept_name (#PCDATA)>
  <!ELEMENT building (#PCDATA)>
  <!ELEMENT budget (#PCDATA)>
  <!ELEMENT course_id (#PCDATA)>
  <!ELEMENT title (#PCDATA)>
  <!ELEMENT credits (#PCDATA)>
  <!ELEMENT IID (#PCDATA)>
  <!ELEMENT name (#PCDATA)>
  <!ELEMENT salary (#PCDATA)>
]>
Spesifikasi atribut. Untuk tiap atribut ditentukan nama, tipe (CDATA, atau ID / IDREF / IDREFS), dan statusnya: wajib (#REQUIRED), punya nilai default, atau tidak keduanya (#IMPLIED, artinya opsional).
<!ATTLIST course course_id CDATA #REQUIRED>

<!ATTLIST course
  course_id   ID      #REQUIRED
  dept_name   IDREF   #REQUIRED
  instructors IDREFS  #IMPLIED >
IDs and IDREFs
- Satu elemen paling banyak punya satu atribut bertipe
ID. - Nilai atribut
IDtiap elemen di dalam satu dokumen harus berbeda, jadiIDberfungsi sebagai object identifier. - Atribut
IDREFharus berisi nilaiIDdari sebuah elemen di dokumen yang sama. - Atribut
IDREFSberisi himpunan (0 atau lebih) nilaiID, dan tiap nilainya harus nilaiIDelemen di dokumen yang sama.
University DTD dengan atribut:
<!DOCTYPE university-3 [
  <!ELEMENT university ((department|course|instructor)+)>
  <!ELEMENT department (building, budget)>
  <!ATTLIST department
    dept_name ID #REQUIRED >
  <!ELEMENT course (title, credits)>
  <!ATTLIST course
    course_id ID #REQUIRED
    dept_name IDREF #REQUIRED
    instructors IDREFS #IMPLIED >
  <!ELEMENT instructor (name, salary)>
  <!ATTLIST instructor
    IID ID #REQUIRED
    dept_name IDREF #REQUIRED >
  ... deklarasi title, credits, building, budget, name, salary ...
]>
Data XML dengan ID dan IDREF (course merujuk department lewat dept_name dan instructor lewat instructors="10101 83821"):
<university-3>
  <department dept_name="Comp. Sci.">
    <building> Taylor </building>
    <budget> 100000 </budget>
  </department>
  <department dept_name="Biology">
    <building> Watson </building>
    <budget> 90000 </budget>
  </department>
  <course course_id="CS-101" dept_name="Comp. Sci"
          instructors="10101 83821">
    <title> Intro. to Computer Science </title>
    <credits> 4 </credits>
  </course>
  ...
  <instructor IID="10101" dept_name="Comp. Sci.">
    <name> Srinivasan </name>
    <salary> 65000 </salary>
  </instructor>
  ...
</university-3>
Limitations of DTDs
- Tidak ada tipe untuk elemen teks dan atribut: semua string, tidak ada integer, real, dsb.
- Sulit menspesifikasikan himpunan subelemen tak berurutan. Urutan biasanya tidak penting di database (beda dengan lingkungan dokumen tata letak tempat XML berasal).
(A | B)*bisa mewakili himpunan tak berurutan, tetapi tidak bisa memastikan A dan B masing-masing muncul hanya sekali. IDdanIDREFtidak bertipe. Atributinstructorspadacoursebisa saja berisi rujukan kecourselain, yang tidak bermakna, padahal idealnya dibatasi hanya merujuk elemeninstructor.
XML Schema
Bahasa skema yang lebih canggih dan mengatasi kelemahan DTD. Mendukung:
- tipe nilai (integer, string, dsb), termasuk batas nilai min/max
- tipe kompleks buatan pengguna (user-defined complex types)
- banyak fitur lain, termasuk uniqueness dan foreign key constraint, serta inheritance
XML Schema sendiri ditulis dengan sintaks XML (beda dengan DTD): representasinya lebih standar, tetapi lebih panjang (verbose). Terintegrasi dengan namespace. Kelemahannya: jauh lebih rumit daripada DTD.
Versi XML Schema dari University DTD:
<xs:schema xmlns:xs="http://www.w3.org/2001/XMLSchema">
  <xs:element name="university" type="universityType" />
  <xs:element name="department">
    <xs:complexType>
      <xs:sequence>
        <xs:element name="dept_name" type="xs:string"/>
        <xs:element name="building" type="xs:string"/>
        <xs:element name="budget" type="xs:decimal"/>
      </xs:sequence>
    </xs:complexType>
  </xs:element>
  ...
  <xs:element name="instructor">
    <xs:complexType>
      <xs:sequence>
        <xs:element name="IID" type="xs:string"/>
        <xs:element name="name" type="xs:string"/>
        <xs:element name="dept_name" type="xs:string"/>
        <xs:element name="salary" type="xs:decimal"/>
      </xs:sequence>
    </xs:complexType>
  </xs:element>
  ...
  <xs:complexType name="UniversityType">
    <xs:sequence>
      <xs:element ref="department" minOccurs="0" maxOccurs="unbounded"/>
      <xs:element ref="course" minOccurs="0" maxOccurs="unbounded"/>
      <xs:element ref="instructor" minOccurs="0" maxOccurs="unbounded"/>
      <xs:element ref="teaches" minOccurs="0" maxOccurs="unbounded"/>
    </xs:sequence>
  </xs:complexType>
</xs:schema>- Pemilihan prefix
xs:itu bebas, prefix namespace lain boleh dipakai. - Elemen
universitybertipeuniversityTypeyang didefinisikan terpisah denganxs:complexType.
Fitur lain:
- Atribut dideklarasikan dengan
xs:attribute, contoh<xs:attribute name="dept_name"/>. Menambahuse="required"berarti nilainya wajib diisi. - Key constraint: nama department menjadi key untuk elemen department di bawah root
university. - Foreign key constraint dari
coursekedepartmentmemakaixs:keyref.
<xs:key name="deptKey">
  <xs:selector xpath="/university/department"/>
  <xs:field xpath="dept_name"/>
</xs:key>

<xs:keyref name="courseDeptFKey" refer="deptKey">
  <xs:selector xpath="/university/course"/>
  <xs:field xpath="dept_name"/>
</xs:keyref>
Querying and Transforming XML Data
- Ada dua kebutuhan: menerjemahkan informasi dari satu skema XML ke skema lain, dan melakukan query pada data XML. Keduanya berkaitan erat dan ditangani oleh tools yang sama.
- Bahasa standar:
- XPath: bahasa sederhana yang terdiri dari path expression.
- XSLT: bahasa sederhana untuk menerjemahkan XML ke XML dan XML ke HTML.
- XQuery: bahasa query XML dengan fitur yang kaya.
Tree Model of XML Data
Bahasa query dan transformasi didasarkan pada tree model (model pohon):
- Dokumen XML dimodelkan sebagai pohon, dengan node untuk elemen dan atribut.
- Node elemen punya child node yang bisa berupa atribut atau subelemen.
- Teks di dalam elemen dimodelkan sebagai text node anak dari elemen itu.
- Anak sebuah node diurutkan sesuai urutan di dokumen XML.
- Node elemen dan atribut (kecuali root) punya tepat satu parent, yaitu node elemen.
- Root node punya satu anak, yaitu elemen root dokumen.
XPath
XPath dipakai untuk menunjuk (memilih) bagian dokumen dengan path expression: rangkaian step yang dipisah /, mirip nama file di hierarki direktori. Hasilnya adalah himpunan nilai beserta elemen atau atribut pembungkus yang cocok dengan path.
/university-3/instructor/namemengembalikan<name>Srinivasan</name>dan<name>Brandt</name>./university-3/instructor/name/text()mengembalikan nama yang sama tanpa tag pembungkus./di awal menunjuk root dokumen (di atas tag tingkat-atas).- Path dievaluasi dari kiri ke kanan, dan tiap step beroperasi pada himpunan hasil step sebelumnya.
- Selection predicate boleh mengikuti step mana pun, ditulis di dalam
[ ]:/university-3/course[credits >= 4]mengembalikan elemencoursedengan nilaicredits>= 4/university-3/course[credits]mengembalikan elemencourseyang punya subelemencredits
- Atribut diakses dengan
@:/university-3/course[credits >= 4]/@course_idmengembalikancourse_iddari course yang memenuhi. - Atribut
IDREFtidak otomatis di-dereference (diikuti ke elemen tujuannya).
Catatan: di slide, penjelasan contoh
[credits >= 4]masih memakai kata “account elements … balance greater than 400”. Itu sisa contoh lama buku (skema bank). Maksudnya sama dengan penjelasan di atas.
Fungsi di XPath:
count()di akhir path menghitung jumlah elemen hasil path. Contoh/university-2/instructor[count(./teaches/course) > 2]mengembalikan instructor yang mengajar lebih dari 2 course (skema university-2).- Ada fungsi untuk menguji posisi node (1, 2, …) terhadap saudaranya (sibling).
- Konektif boolean
and,or, dan fungsinot()bisa dipakai di predicate. id()untuk merujuk IDREF. Bisa dipakai pada himpunan rujukan seperti IDREFS, bahkan pada string berisi beberapa rujukan yang dipisah spasi. Contoh/university-3/course/id(@dept_name)mengembalikan semua elemendepartmentyang dirujuk atributdept_namedari elemencourse.
Fitur lain:
- Operator
|untuk union. Contoh gabungan course Comp. Sci. dan Biology:
/university-3/course[@dept_name="Comp. Sci"] |
    /university-3/course[@dept_name="Biology"]
Namun | tidak boleh disarangkan di dalam operator lain.
//melompati banyak level node. Contoh/university-3//namemenemukan elemennamedi mana pun di bawah/university-3, apa pun elemen induknya.- Sebuah step bisa menuju parent, sibling, ancestor, dan descendant dari node hasil step sebelumnya, tidak hanya anak.
//adalah bentuk singkat “semua descendant”, dan..menunjuk parent. doc(name)mengembalikan root dokumen bernama tertentu.
XQuery
- XQuery adalah bahasa query tujuan umum untuk data XML, distandarkan oleh W3C. Buku teks menjelaskannya berdasarkan draft standar Januari 2005, versi finalnya bisa sedikit beda tetapi fitur utamanya diperkirakan tetap.
- Diturunkan dari bahasa Quilt, yang meminjam dari SQL, XQL, dan XML-QL.
- Sintaks FLWOR (dibaca “flower”):
for ... let ... where ... order by ... return ...
| XQuery | Padanan SQL |
|---|---|
for | from |
where | where |
order by | order by |
return | select |
let | tidak ada (variabel sementara) |
(Slide menulis result untuk klausa terakhir, tetapi kata kunci aslinya return, dan contoh-contoh slide memakai return.)
Contoh FLWOR: cari semua course dengan credits > 3, hasil tiap course dibungkus <course_id> ... </course_id>:
for $x in /university-3/course
let $courseId := $x/@course_id
where $x/credits > 3
return <course_id> { $courseId } </course_id>- Klausa
formemakai ekspresi XPath, dan variabelnya menjangkau nilai di himpunan hasil XPath. - Item di klausa
returndianggap teks XML kecuali diapit{ }, yang berarti dievaluasi. - Klausa
letsebenarnya tidak diperlukan di query ini, dan seleksi bisa dilakukan di XPath:
for $x in /university-3/course[credits > 3]
return <course_id> { $x/@course_id } </course_id>- Ada notasi alternatif untuk membuat elemen:
return element course_id { element $x/@course_id }.
Joins. Dinyatakan mirip SQL:
for $c in /university/course,
    $i in /university/instructor,
    $t in /university/teaches
where $c/course_id = $t/course_id and $t/IID = $i/IID
return <course_instructor> { $c $i } </course_instructor>
Query yang sama dengan seleksi ditulis sebagai XPath selection:
for $c in /university/course,
    $i in /university/instructor,
    $t in /university/teaches[ $c/course_id = $t/course_id
                               and $t/IID = $i/IID ]
return <course_instructor> { $c $i } </course_instructor>
Nested queries. Query berikut mengubah struktur flat data university menjadi struktur bersarang university-1:
<university-1>
{ for $d in /university/department
  return <department>
           { $d/* }
           { for $c in /university/course[dept_name = $d/dept_name]
             return $c }
         </department>
}
{ for $i in /university/instructor
  return <instructor>
           { $i/* }
           { for $c in /university/teaches[IID = $i/IID]
             return $c/course_id }
         </instructor>
}
</university-1>
$c/* berarti semua anak dari node yang terikat ke $c, tanpa tag pembungkus tingkat-atasnya.
Grouping and aggregation. Nested query dipakai untuk grouping, dengan fungsi agregat seperti fn:sum:
for $d in /university/department
return
  <department-total-salary>
    <dept_name> { $d/dept_name } </dept_name>
    <total_salary> { fn:sum(
        for $i in /university/instructor[dept_name = $d/dept_name]
        return $i/salary
    ) }
    </total_salary>
</department-total-salary>Sorting. Klausa order by bisa dipakai di akhir ekspresi mana pun. Tambah descending untuk urutan menurun.
for $i in /university/instructor
order by $i/name
return <instructor> { $i/* } </instructor>
Bisa mengurutkan di beberapa level nesting sekaligus (department diurutkan berdasarkan dept_name, dan di dalamnya course diurutkan berdasarkan course_id):
<university-1> {
  for $d in /university/department
  order by $d/dept_name
  return
    <department>
      { $d/* }
      { for $c in /university/course[dept_name = $d/dept_name]
        order by $c/course_id
        return <course> { $c/* } </course> }
    </department>
} </university-1>
Functions dan fitur lain:
- User defined function dengan sistem tipe XML Schema:
declare function local:dept_courses($iid as xs:string)
        as element(course)*
{
  for $i in /university/instructor[IID = $iid],
      $c in /university/courses[dept_name = $i/dept_name]
  return $c
}- Tipe bersifat opsional untuk parameter dan nilai kembalian.
- Tanda
*(seperti padadecimal*) berarti urutan (sequence) nilai bertipe itu. - Kuantifikasi universal dan eksistensial di predicate
where:some $e in path satisfies Pdanevery $e in path satisfies P. Tambahkanand fn:exists($e)supaya$ekosong tidak otomatis memenuhi klausaevery. - XQuery juga mendukung klausa if-then-else.
XSLT
- Stylesheet menyimpan opsi format sebuah dokumen, biasanya terpisah dari dokumennya (contoh: stylesheet HTML menentukan warna dan ukuran font heading).
- XSL (XML Stylesheet Language) awalnya dirancang untuk menghasilkan HTML dari XML.
- XSLT adalah bahasa transformasi tujuan umum: bisa XML ke XML dan XML ke HTML.
- Transformasi dinyatakan sebagai aturan bernama template, yang menggabungkan seleksi dengan XPath dan pembuatan hasil.
Contoh dari slide: stylesheet yang mengubah katalog CD (XML) menjadi tabel HTML “My CD Collection” dengan kolom Title dan Artist.
<?xml version="1.0" encoding="UTF-8"?>
<xsl:stylesheet version="1.0"
  xmlns:xsl="http://www.w3.org/1999/XSL/Transform">
  <xsl:template match="/">
    <html>
    <body>
      <h2>My CD Collection</h2>
      <table border="1">
        <tr bgcolor="#9acd32">
          <th>Title</th>
          <th>Artist</th>
        </tr>
        <xsl:for-each select="catalog/cd">
        <tr>
          <td><xsl:value-of select="title"/></td>
          <td><xsl:value-of select="artist"/></td>
        </tr>
        </xsl:for-each>
      </table>
    </body>
    </html>
  </xsl:template>
</xsl:stylesheet>
Sumber XML-nya berisi elemen <catalog> dengan banyak <cd> (title, artist, country, company, price, year), dan menautkan stylesheet lewat <?xml-stylesheet type="text/xsl" href="cdcatalog.xsl"?>.
Application Program Interface (API)
Dua API standar untuk mengakses data XML dari program:
- SAX (Simple API for XML): berbasis model parser, pengguna menyediakan event handler untuk peristiwa parsing, misalnya awal elemen dan akhir elemen.
- DOM (Document Object Model): data XML di-parse menjadi representasi pohon, dengan berbagai fungsi untuk menelusuri pohon DOM. Contoh pada Java DOM API, kelas
Nodepunya methodgetParentNode(),getFirstChild(),getNextSibling(),getAttribute(),getData()(untuk text node),getElementsByTagName(), dst. DOM juga menyediakan fungsi untuk mengubah pohon.
Storage of XML Data
XML bisa disimpan di:
- Non-relational data store:
- Flat file: natural untuk menyimpan XML, tetapi punya semua masalah file biasa (tanpa concurrency, tanpa recovery, dst).
- XML database: database yang dibangun khusus untuk menyimpan data XML, mendukung model DOM dan query deklaratif. Menurut slide, saat ini belum ada sistem commercial-grade.
- Relational database: data harus diterjemahkan ke bentuk relasional. Kelebihan: sistem database sudah matang. Kekurangan: overhead menerjemahkan data dan query.
Storage of XML in Relational Databases
Tiga alternatif: String Representation, Tree Representation, dan Map to Relations.
String Representation
Simpan tiap elemen tingkat-atas sebagai field string pada sebuah tuple. Boleh dengan satu relasi untuk semua elemen, atau satu relasi terpisah per tipe elemen tingkat-atas (contoh: relasi account, customer, depositor, masing-masing dengan atribut bernilai string untuk menyimpan elemennya).
Indexing:
- Simpan nilai subelemen atau atribut yang perlu diindeks sebagai kolom tambahan relasi, lalu buat indeks di kolom itu (contoh
customer_nameatauaccount_number). - Sebagian sistem database mendukung function index, yaitu indeks yang memakai hasil sebuah fungsi sebagai nilai kunci. Fungsinya harus mengembalikan nilai subelemen atau atribut yang dibutuhkan.
Kelebihan:
- Bisa menyimpan data XML apa pun, bahkan tanpa DTD.
- Selama dokumen punya banyak elemen tingkat-atas, string kecil dibanding dokumen penuh, sehingga akses ke elemen individual cepat.
Kekurangan: perlu parsing string untuk mengakses nilai di dalam elemen, dan parsing itu lambat.
Tree Representation
Modelkan data XML sebagai pohon dan simpan memakai relasi:
nodes(id, parent_id, type, label, value)
- Tiap elemen atau atribut diberi identifier unik (
id). typemenandai elemen atau atribut.labelmenyimpan nama tag elemen atau nama atribut.valuemenyimpan nilai teks elemen atau atribut.- Boleh ditambah atribut
positionuntuk mencatat urutan anak.
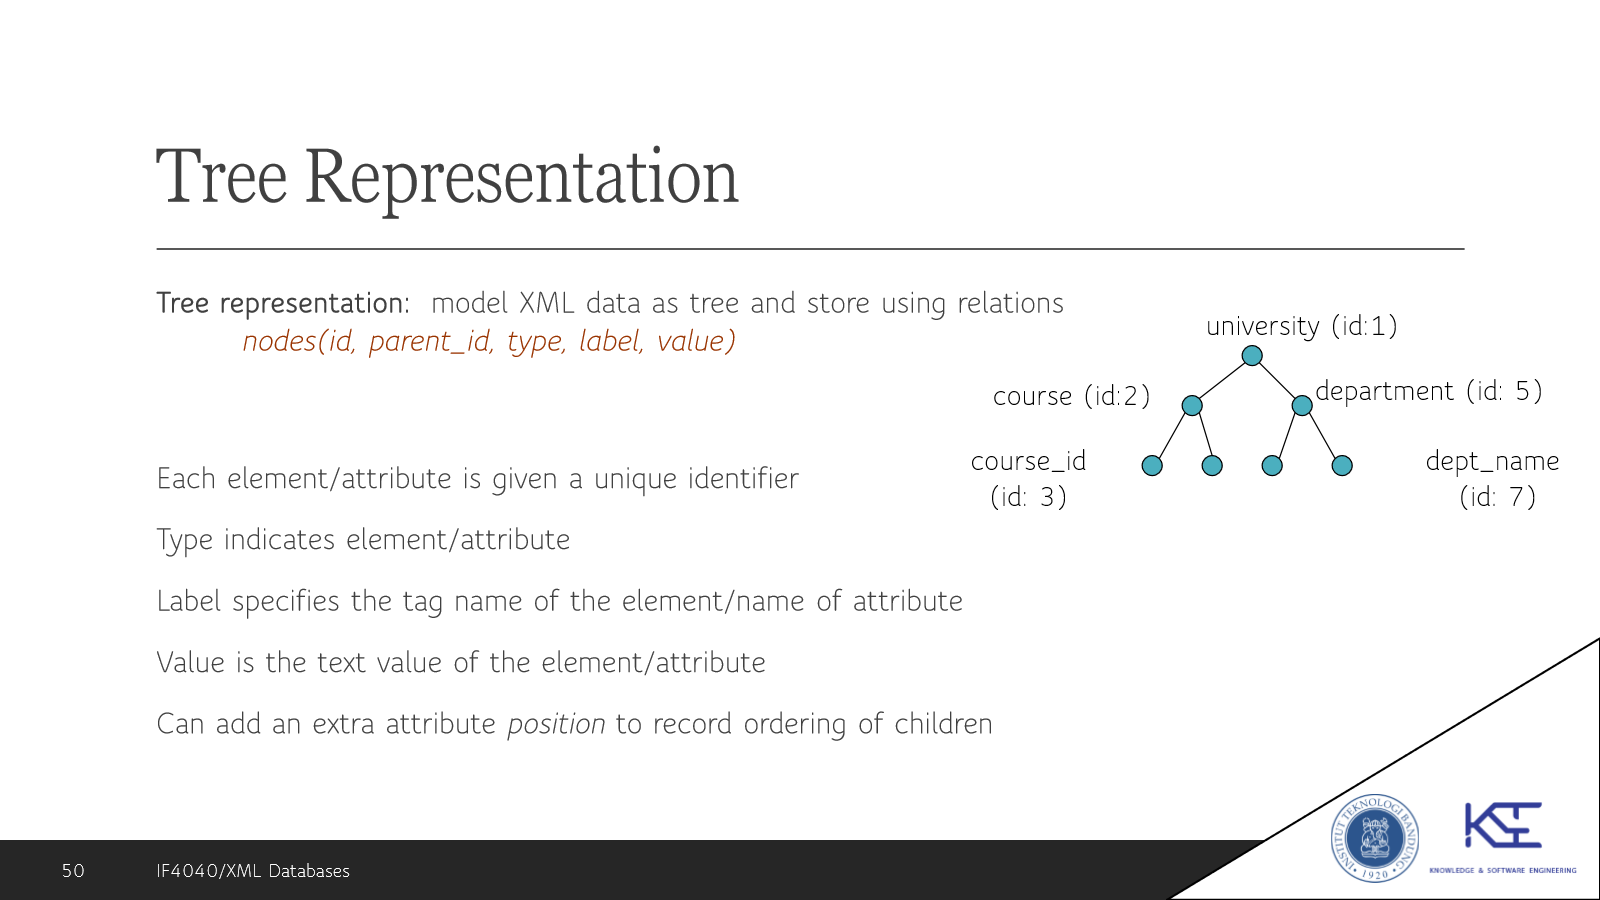
(Diagram di slide: pohon kecil dengan root university (id:1) dan dua anak, course (id:2) dan department (id:5), masing-masing punya dua daun, misalnya course_id (id:3) dan dept_name (id:7).)
Kelebihan: bisa menyimpan data XML apa pun, bahkan tanpa DTD.
Kekurangan:
- Data terpecah menjadi terlalu banyak bagian, sehingga overhead ruang naik.
- Bahkan query sederhana butuh banyak join, yang bisa lambat.
Mapping XML Data to Relations
Dibuat satu relasi untuk tiap tipe elemen yang skemanya diketahui, dengan:
- atribut
iduntuk menyimpan identifier unik tiap elemen - satu atribut relasi untuk tiap atribut elemen
- atribut
parent_iduntuk melacak elemen induk (seperti di tree representation); informasi posisi (anak ke-i) juga bisa disimpan
Aturan subelemen:
- Subelemen yang muncul hanya sekali bisa menjadi atribut relasi. Untuk subelemen bernilai teks, simpan teksnya sebagai nilai atribut. Untuk subelemen kompleks, simpan
idsubelemen itu. - Subelemen yang bisa muncul berkali-kali dipindah ke tabel terpisah, mirip penanganan multivalued attribute saat mengubah diagram ER menjadi tabel.
Menerapkan ide ini pada elemen department di skema university-1 (dengan elemen course bersarang) menghasilkan:
department(id, dept_name, building, budget)
course(parent_id, course_id, dept_name, title, credits)
Publishing dan Shredding
- Publishing: proses mengubah data relasional menjadi format XML.
- Shredding: proses mengubah dokumen XML menjadi sekumpulan tuple yang dimasukkan ke satu atau lebih relasi.
- XML-enabled database system mendukung publishing dan shredding secara otomatis.
- Banyak sistem menawarkan penyimpanan native memakai tipe data
xml, dengan struktur data internal dan indeks khusus untuk efisiensi.
SQL/XML
Ekstensi standar SQL yang memungkinkan pembuatan output XML bersarang. Tiap tuple output dipetakan ke elemen XML row:
<university>
  <department>
    <row>
      <dept_name> Comp. Sci. </dept_name>
      <building> Taylor </building>
      <budget> 100000 </budget>
    </row>
    ... baris lain bila ada tuple output lain ...
  </department>
  ... relasi lain ...
</university>
Fungsi utama:
xmlelementmembuat elemen XML.xmlattributesmembuat atribut.xmlaggmembuat forest (kumpulan elemen XML) dari hasil agregasi.
select xmlelement(name "course",
         xmlattributes(course_id as course_id, dept_name as dept_name),
         xmlelement(name "title", title),
         xmlelement(name "credits", credits))
from course
select xmlelement(name "department",
dept_name,
xmlagg(xmlforest(course_id)
order by course_id))
from course
group by dept_nameXML Applications
- Menyimpan dan menukar data berstruktur kompleks: contoh ODF (Open Document Format, standar untuk OpenOffice) dan OOXML (Office Open XML, standar untuk dokumen Microsoft Office). Ada banyak standar lain, misalnya ChemML dan MathML.
- Standar pertukaran data untuk Web services: pemanggilan method jarak jauh (remote method invocation) lewat protokol HTTP.
- Data mediation: format representasi data bersama untuk menjembatani sistem yang berbeda.
Web Services
- SOAP (Simple Object Access Protocol): pemanggilan prosedur lintas aplikasi dengan database yang berbeda, memakai XML untuk merepresentasikan input dan output prosedur.
- Web service adalah situs yang menyediakan kumpulan prosedur SOAP. Dideskripsikan dengan WSDL (Web Services Description Language). Direktori Web service dideskripsikan dengan standar UDDI (Universal Description, Discovery, and Integration).
XML Database
Bagian ini mengutip Wikipedia (XML database), bukan dari buku Silberschatz.
XML database adalah sistem perangkat lunak data persistence yang memungkinkan data dispesifikasikan, dan kadang disimpan, dalam format XML. XML database adalah salah satu jenis document-oriented database, yang sendiri termasuk kategori NoSQL.
Alasan memakai XML di database:
- Perusahaan mungkin sudah punya banyak XML dalam format standar yang ada.
- Data mungkin perlu diekspos atau dimasukkan sebagai XML, sehingga memakai format lain seperti relasional memaksa double-modeling (data dimodelkan dua kali).
- XML sangat cocok untuk data jarang (sparse), data bersarang dalam (deeply nested), dan mixed content (teks dengan tag markup di dalamnya).
- XML bisa dibaca manusia, sedangkan tabel relasional butuh keahlian untuk mengaksesnya.
- Metadata sering tersedia dalam XML.
- Data semantic web tersedia sebagai RDF/XML.
- Memberi solusi untuk object-relational impedance mismatch (ketidakcocokan antara model objek di program dan model tabel di database relasional).
XML-enabled Databases
Database relasional yang mendukung XML biasanya menawarkan satu atau lebih pendekatan untuk menyimpan XML di struktur relasional tradisional:
- XML disimpan ke CLOB (Character Large Object).
- XML di-shred menjadi serangkaian tabel berdasarkan sebuah skema.
- XML disimpan ke native XML type sesuai standar ISO 9075-14.
RDBMS yang mendukung XML type ISO: IBM DB2 (pureXML), Microsoft SQL Server, Oracle Database, PostgreSQL.
Native XML Databases
Database yang dibuat khusus untuk bekerja dengan data XML. Mengelola XML sebagai string besar tidak efisien, dan karena sifat hierarkis XML, dipakai struktur data khusus yang dioptimalkan untuk penyimpanan dan query.
Contoh: BaseX, eXist, MarkLogic Server, Oracle Berkeley DB XML, Sedna, Qizx.
Perbandingan Singkat: DTD vs XML Schema
| DTD | XML Schema | |
|---|---|---|
| Sintaks | Sintaks sendiri (<!ELEMENT>, <!ATTLIST>) | Ditulis dalam XML |
| Tipe data | Tidak ada (semua string) | Ada (integer, string, decimal, dsb, plus batas min/max) |
| Tipe kompleks buatan sendiri | Tidak | Ya |
| Key dan foreign key | ID/IDREF yang tidak bertipe | xs:key dan xs:keyref yang bertipe |
| Inheritance | Tidak | Ada |
| Namespace | Tidak terintegrasi | Terintegrasi |
| Kerumitan | Sederhana | Jauh lebih rumit dan panjang |
Perbandingan Singkat: Tiga Cara Menyimpan XML di Database Relasional
| String Representation | Tree Representation | Map to Relations | |
|---|---|---|---|
| Cara | Elemen tingkat-atas disimpan sebagai string | Relasi nodes(id, parent_id, type, label, value) | Satu relasi per tipe elemen, atribut jadi kolom |
| Perlu DTD/skema? | Tidak | Tidak | Ya, skema harus diketahui |
| Kelebihan | Akses cepat per elemen, bisa simpan XML apa pun | Bisa simpan XML apa pun | Tidak disebut di slide |
| Kekurangan | Parsing string lambat | Terlalu banyak baris, query butuh banyak join | Tidak disebut di slide; skemanya harus diketahui, subelemen yang berulang jadi tabel terpisah |
Sumber
- Silberschatz, Korth, Sudarshan: Database System Concepts, 6th edition, chapter 23
- Wikipedia: XML database (untuk bagian XML Database, XML-enabled, Native XML)
Flashcard
flashcards Apa itu XML dan apa bedanya dengan HTML? :: XML (Extensible Markup Language, standar W3C, turunan SGML yang lebih sederhana) bersifat extensible: pengguna bisa menambah tag baru dan menentukan sendiri cara penanganannya, sedangkan HTML tagnya tetap. Kenapa XML lebih baik dari tuple relasional sebagai format pertukaran data? :: Self-documenting (tag melekat pada data), format tidak kaku (tag bisa ditambah), mendukung struktur bersarang, dan diterima luas di browser, tools, dan aplikasi. Apa kekurangan XML dibanding data relasional? :: Tidak efisien, karena tag (yang sama dengan informasi skema) diulang di setiap elemen. Apa syarat elemen XML “properly nested” dan apa syarat dokumen XML? :: Setiap start tag harus punya end tag unik yang cocok dalam konteks elemen induk yang sama; dan setiap dokumen harus punya satu elemen tingkat-atas. Kenapa nesting cocok untuk transfer data tetapi tidak dianjurkan di database relasional? :: Di relasional nesting membuat data redundan (nama dan alamat customer tersimpan berulang per order), jadi dinormalisasi dengan foreign key. Tetapi saat transfer data, aplikasi eksternal tidak punya akses ke data yang dirujuk foreign key, jadi nesting lebih cocok. Kapan memakai atribut dan kapan subelemen di XML? :: Atribut untuk identifier elemen, subelemen untuk isi; dalam representasi data batasnya kabur karena informasi yang sama bisa ditulis dua cara. Apa fungsi XML Namespace? :: Menghindari kebingungan saat tag yang sama bermakna beda antar-organisasi, dengan prefix unik yang terikat ke URI lewat xmlns:prefix. Apa fungsi CDATA di XML? :: Menyimpan string yang mengandung tag tanpa tag itu ditafsirkan sebagai subelemen (tag dianggap string biasa). Apa yang dibatasi DTD dan apa yang tidak? :: DTD membatasi struktur (elemen, atribut, subelemen, jumlah kemunculan) tetapi tidak membatasi tipe data (semua nilai berupa string). Apa arti REQUIRED, IMPLIED, dan PCDATA di DTD? :: REQUIRED = atribut wajib diisi, IMPLIED = atribut opsional, PCDATA = isi elemen berupa parsed character data (string). Apa fungsi ID, IDREF, dan IDREFS di DTD? :: ID = identifier unik se-dokumen (paling banyak satu per elemen); IDREF = merujuk nilai ID elemen lain di dokumen yang sama; IDREFS = himpunan rujukan ID. Sebutkan tiga keterbatasan DTD dibanding XML Schema :: (1) Tidak ada tipe data (semua string); (2) sulit menspesifikasikan himpunan subelemen tak berurutan, karena (A|B)* tidak memastikan tiap elemen muncul sekali; (3) ID/IDREF tidak bertipe, jadi tidak bisa dibatasi merujuk ke tipe elemen tertentu. Apa kelebihan dan kekurangan XML Schema dibanding DTD? :: Kelebihan: tipe nilai, tipe kompleks buatan sendiri, key dan foreign key (xs:key, xs:keyref), inheritance, terintegrasi namespace, ditulis dalam sintaks XML. Kekurangan: jauh lebih rumit dan verbose. Bagaimana XML dimodelkan di tree model? :: Pohon dengan node elemen dan atribut; teks jadi text node anak elemen; anak diurutkan sesuai dokumen; setiap node selain root punya tepat satu parent. Apa fungsi XPath dan apa arti /, //, .., @, dan [ ]? :: XPath memilih bagian dokumen lewat path expression. ”/” memisah step (awal = root), ”//” melompati banyak level (semua descendant), ”..” parent, ”@” mengakses atribut, ”[ ]” selection predicate. Apa fungsi count() dan id() di XPath? :: count() menghitung jumlah elemen hasil path; id() men-dereference IDREF/IDREFS menjadi elemen yang dirujuk. Apa arti FLWOR di XQuery dan padanannya di SQL? :: for≈from, where≈where, order by≈order by, return≈select; let adalah variabel sementara yang tidak punya padanan SQL. Kapan isi klausa return XQuery dievaluasi? :: Item di return dianggap teks XML kecuali diapit { }, yang berarti dievaluasi sebagai ekspresi. Apa gunanya some dan every di XQuery, dan kenapa perlu fn:exists? :: some = kuantor eksistensial, every = kuantor universal di predicate where. fn:exists(e kosong tidak otomatis memenuhi every. Apa itu XSLT dan template? :: XSLT adalah bahasa transformasi tujuan umum (XML ke XML atau HTML); transformasi ditulis sebagai template yang menggabungkan seleksi XPath dengan konstruksi hasil. Apa perbedaan SAX dan DOM? :: SAX berbasis event parsing (event handler untuk awal dan akhir elemen); DOM mem-parse dokumen menjadi pohon yang bisa ditelusuri dan diubah. Sebutkan tiga cara menyimpan XML di database relasional :: String representation (elemen tingkat-atas sebagai field string), tree representation (relasi nodes(id,parent_id,type,label,value)), dan map to relations (satu relasi per tipe elemen yang skemanya diketahui). Apa kelebihan dan kekurangan string representation? :: Kelebihan: bisa simpan XML apa pun tanpa DTD dan akses elemen cepat; kekurangan: harus parsing string untuk mengakses nilai di dalam elemen, dan parsing lambat. Apa kekurangan tree representation? :: Data terpecah jadi terlalu banyak bagian (overhead ruang besar) dan query sederhana pun butuh banyak join. Bagaimana subelemen diperlakukan saat XML dipetakan ke relasi? :: Subelemen yang muncul sekali jadi atribut relasi (atau id subelemen bila kompleks); subelemen yang bisa muncul berkali-kali dipindah ke tabel terpisah, seperti multivalued attribute di ER-to-tabel. Apa beda publishing dan shredding? :: Publishing = mengubah data relasional menjadi XML; shredding = mengubah dokumen XML menjadi tuple yang dimasukkan ke relasi. Apa fungsi xmlelement, xmlattributes, dan xmlagg di SQL/XML? :: xmlelement membuat elemen XML, xmlattributes membuat atribut, xmlagg membuat forest (kumpulan elemen) dari hasil agregasi, sering dengan GROUP BY. Apa itu SOAP, WSDL, dan UDDI? :: SOAP = protokol pemanggilan prosedur lintas aplikasi dengan XML sebagai input/output; WSDL = bahasa mendeskripsikan Web service; UDDI = standar direktori Web service. Apa beda XML-enabled database dan native XML database? :: XML-enabled = database relasional yang menyimpan XML lewat CLOB, shredding ke tabel, atau native XML type; native XML database = dibuat khusus untuk XML dengan struktur data dioptimalkan untuk penyimpanan dan query (contoh BaseX, eXist, MarkLogic). Sebutkan alasan memakai XML di database :: Sudah banyak XML berstandar di perusahaan, menghindari double-modeling, cocok untuk data sparse/bersarang dalam/mixed content, bisa dibaca manusia, metadata dan RDF/XML umumnya XML, dan mengatasi object-relational impedance mismatch.