UTS PDL (IF4040 Advanced Data Modeling)
Bahan belajar UTS yang disusun dari catatan 12 sampai 20. Ini studi sheet, bukan pengganti catatan asli: tiap bagian me-link ke note sumber untuk detail, kode lengkap, dan flashcard aslinya. Istilah singkat ada di Glosarium_PDL. Soal contoh dari dosen ada di UTS_Sample_PDL.
Cara pakai: baca Prasyarat dulu, lalu Materi inti dari atas ke bawah. Urutannya disusun menurut ketergantungan konsep. Konsep yang sudah dijelaskan tidak diulang, hanya dirujuk (“lihat 2.x”).
0. Cakupan dan Peta CPMK
Cakupan UTS menurut slide dosen: materi minggu 01 sampai 07. Daftarnya:
- Review pemodelan data: ER model, relational model
- Introduction to NoSQL Databases
- Pemodelan data key-value
- Pemodelan data berbasis dokumen
- Pemodelan data berbasis kolom
- Pemodelan data graf
- XML Database
- “Pelajari case study tugas masing-masing.”
Peta ke catatan: 13-14 (ER dan relasional), 15 (intro NoSQL), 16 (key-value), 17 (dokumen), 18 (kolom), 19 (graf), 20 (XML). Note 12 hanya info mata kuliah. Topik spatial/temporal (note 1-9) tidak ada di daftar UTS ini, dan note 21 (Choosing a Database) di luar rentang yang diminta, jadi tidak dibahas di sini.
| CPMK (semester 1 2026/2027) | Bagian di file ini | Status |
|---|---|---|
| 1. Menjelaskan kasus penggunaan basis data nonrelasional/semi-terstruktur yang lebih disukai dibanding relasional | 2.4 (keterbatasan relasional dan karakteristik NoSQL), 2.5 sampai 2.9 (kapan tiap model dipakai) | Tercakup |
| 2. Mendeskripsikan karakteristik dasar model data nonrelasional/semi-terstruktur | 2.5 key-value, 2.6 dokumen, 2.7 kolom, 2.8 graf, 2.9 XML | Tercakup |
| 3. Mengeksplorasi implementasi model data nonrelasional/semi-terstruktur, termasuk temporal, spasial, spatio-temporal | 2.5 sampai 2.9 (desain dan studi kasus). Bagian temporal/spasial ada di note 1-9, di luar rentang | Tercakup sebagian |
Studi kasus tugas: slide dosen meminta mempelajari studi kasus tugas masing-masing. Catatan tugas ada di 1_Project1_Basis_Data_Dokumen_dan_KeyValue (Project-1: basis data dokumen dan key-value). Studi kasus TGTS yang ada di materi (key-value, dokumen, kolom, graf) dirangkum di bagian 2.5 sampai 2.8, dan kasus tugas kelompok (Nimonspedia) di 2.10.
1. Prasyarat: Istilah yang Harus Dipahami Dulu
Istilah di bagian ini tidak dijelaskan di note PDL 12-20 maupun di Glosarium-Teknis (dicek dengan pencarian teks; slide PDF mentah di _Materi/PDL/ tidak diperiksa karena teksnya tidak bisa dicari langsung). Penjelasannya adalah tambahan di luar materi kuliah. Istilah yang sudah dijelaskan di mana pun di catatan (misalnya ACID, hash function, sharding, JSON) tidak ada di sini, cukup lihat Glosarium_PDL. Konsep ACID/BASE/CAP/MapReduce dijelaskan di 11_NoSQL (materi lama, di luar rentang ini) dan ACID juga ada di 2.4.
| Istilah | Penjelasan (tambahan) |
|---|---|
| DFS dan BFS | Dua cara menelusuri graf. Depth-first search (DFS) menelusuri satu cabang sedalam mungkin dulu baru mundur. Breadth-first search (BFS) menelusuri semua tetangga di level yang sama dulu sebelum turun ke level berikutnya. Dipakai di 2.8 (Gremlin). |
| Laju pertumbuhan (O(n), O(n²)) | Cara menyatakan seberapa cepat waktu proses bertambah ketika ukuran data bertambah. O(n²) berarti ukuran data 10 kali lebih besar membuat waktu sekitar 100 kali lebih lama. Dipakai di 2.8 (Dijkstra) dan 2.6 (nested loop join). |
| Tree dan node | Tree adalah struktur berjenjang dengan satu titik awal (root), tiap titik (node) punya paling banyak satu parent. Dipakai di 2.2, 2.8, dan 2.9. |
| Parsing | Membaca teks mentah lalu menguraikannya menjadi struktur yang bisa diproses program. Dipakai di 2.9 (string representation, SAX/DOM). |
| Block disk, seek, dan cache | Disk membaca data dalam potongan tetap yang disebut block. Seek adalah waktu menggerakkan kepala disk ke lokasi block (relatif lambat). Cache menyimpan data yang baru dipakai di memori supaya akses berikutnya cepat. Dipakai di 2.5 sampai 2.7. |
| Urutan leksikografis | Urutan seperti kamus: dibandingkan karakter demi karakter dari kiri. Dipakai pada HBase di 2.7. |
| Big Data | Data yang volume, kecepatan masuk, dan ragamnya terlalu besar untuk ditangani satu server dengan cara konvensional. Dipakai di 2.7. |
| OLTP | Online Transaction Processing: beban kerja berisi banyak transaksi kecil yang cepat (misalnya pesanan, pembayaran). |
| Hadoop dan HDFS | Hadoop adalah platform pemrosesan data besar terdistribusi. HDFS adalah sistem file terdistribusinya. HBase berjalan di atasnya (2.7). |
| Compaction, commit log, bloom filter | Compaction: menggabung data lama dan membuang yang usang di penyimpanan. Commit log: catatan tulis berurutan untuk pemulihan setelah crash. Bloom filter: struktur kecil untuk memeriksa cepat apakah suatu key mungkin ada. Materi hanya menyebut namanya (2.7). |
| Trigger dan stored procedure | Trigger: kode yang otomatis jalan saat ada perubahan data. Stored procedure: rutin yang disimpan di dalam database. Disebut di 2.3 dan 2.4 tanpa penjelasan. |
| URI | Pengenal sumber daya berbentuk teks (misalnya alamat web). Dipakai pada XML namespace (2.9). |
| RDF | Format untuk menyatakan relasi antar data (subjek, predikat, objek). Disebut sebagai salah satu alasan memakai XML database (2.9). |
| Pemrosesan batch dan ETL | Batch: pekerjaan dijalankan terjadwal untuk banyak data sekaligus. ETL dijelaskan di 2.6. |
2. Materi Inti (Urut Menurut Ketergantungan Konsep)
2.1 Informasi Mata Kuliah
Sumber: 12_Course_Introduction
IF4040 Advanced Data Modeling (nama kurikulum baru dari Pemodelan Data Lanjut), semester I 2026/2027, 3 SKS (135 jam per semester). Prasyarat: IF2240 Database dan IF3140 Database Management (2019) / Database System (2024). Jadwal Selasa 10.00-12.00 dan Kamis 15.00-16.00. Tim pengajar: Fazat Nur Azizah dan Tricya E. Widagdo. Media: Edunex, MS Teams, presensi lewat SIX.
Tiga blok materi: (1) review ER dan relational modeling, (2) NoSQL data model (key-value, document, column, graph, dll), (3) spatial, temporal, dan spatio-temporal (moving objects). Penilaian: projects dan assignments, UTS, UAS, kuis/latihan. Kebijakan Gen-AI: dilarang total pada tes individu (ujian dan kuis); boleh dengan batasan pada project dan exercise sesuai kebijakan masing-masing; bebas untuk belajar mandiri. Referensi: Silberschatz dkk. (Database System Concepts), Sullivan (NoSQL for Mere Mortals, 2015), Rigaux dkk. (Spatial Databases), Güting dan Schneider (Moving Object Databases).
2.2 Model Entity-Relationship (ER)
Sumber: 13_ER_Modeling
Proses desain database: (1) fase awal: karakterisasi kebutuhan data; (2) fase kedua: pilih data model dan buat skema konseptual; (3) fase akhir: logical design (menentukan skema, melibatkan keputusan bisnis dan keputusan ilmu komputer) dan physical design (tata letak fisik). Dua kesalahan yang dihindari: redundancy (informasi berulang, bisa menyebabkan inkonsistensi) dan incompleteness (aspek enterprise sulit atau tidak mungkin dimodelkan). Dua pendekatan: ER model dan normalization theory.
Konsep dasar ER: entity set, relationship set, attribute, dan ER diagram.
- Entity adalah objek yang eksis dan dapat dibedakan; entity set himpunan entity bertipe sama. Subset atribut membentuk primary key. Diagram: rectangle, primary key digarisbawahi.
- Relationship adalah asosiasi antar entity; relationship set adalah relasi matematis di antara n ≥ 2 entity set:
{(e1, ..., en) | e1 ∈ E1, ..., en ∈ En}. Diagram: diamond. Relationship set boleh punya atribut sendiri (misalnyadatepadaadvisor). - Role: entity set yang sama bisa muncul lebih dari sekali dalam relationship (misalnya
prereqmemakai rolecourse_iddanprereq_id). - Degree: binary (mayoritas), non-binary (misalnya ternary
proj_guideantara instructor, student, project).
Atribut: simple vs composite (composite terdiri dari sub-bagian, misalnya name, address), single-valued vs multivalued ({ phone_number }), derived (dihitung dari atribut lain, misalnya age() dari date_of_birth), dan domain (himpunan nilai yang diizinkan).
Mapping cardinality (untuk binary relationship set):
| Tipe | Deskripsi |
|---|---|
| One to one | Satu entity di A berpasangan dengan paling banyak satu di B, dan sebaliknya |
| One to many | Satu entity di A bisa berpasangan dengan banyak di B; satu entity di B paling banyak satu di A |
| Many to one | Kebalikan one-to-many |
| Many to many | Satu di A bisa dengan banyak di B, dan sebaliknya |
Di diagram: garis berarah (→) berarti “one”, garis tak berarah (—) berarti “many”. Pada relationship ternary atau lebih, hanya boleh paling banyak satu panah keluar, karena lebih dari satu panah ambigu (dua interpretasi berbeda dipakai pada formalisme berbeda).
Participation: total (garis ganda; setiap entity berpartisipasi minimal satu relationship, contoh student pada advisor) vs partial (sebagian entity boleh tidak berpartisipasi, contoh instructor).
Primary key: untuk entity set, key adalah atribut yang cukup membedakan entity. Untuk relationship set R, primary key adalah union primary key entity set yang terlibat (plus atribut R sendiri bila ada). Pilihan menurut cardinality:
| Mapping cardinality | Primary key relationship |
|---|---|
| Many-to-many | Union seluruh primary key entity yang terlibat |
| One-to-many / many-to-one | Primary key sisi “many” saja sudah minimal superkey |
| One-to-one | Primary key salah satu entity set (mana saja) |
Weak entity set: entity set yang eksistensinya bergantung pada identifying entity. Tidak punya primary key sendiri; memakai identifying entity plus discriminator. Lawannya strong entity set. Weak entity bersifat existence dependent; relationship yang menghubungkannya disebut identifying relationship. Contoh: section (kunci (course_id, sec_id, semester, year)) bergantung pada course (relationship sec_course). Notasi: weak entity set = double rectangle, discriminator = garis bawah putus-putus, identifying relationship = double diamond.
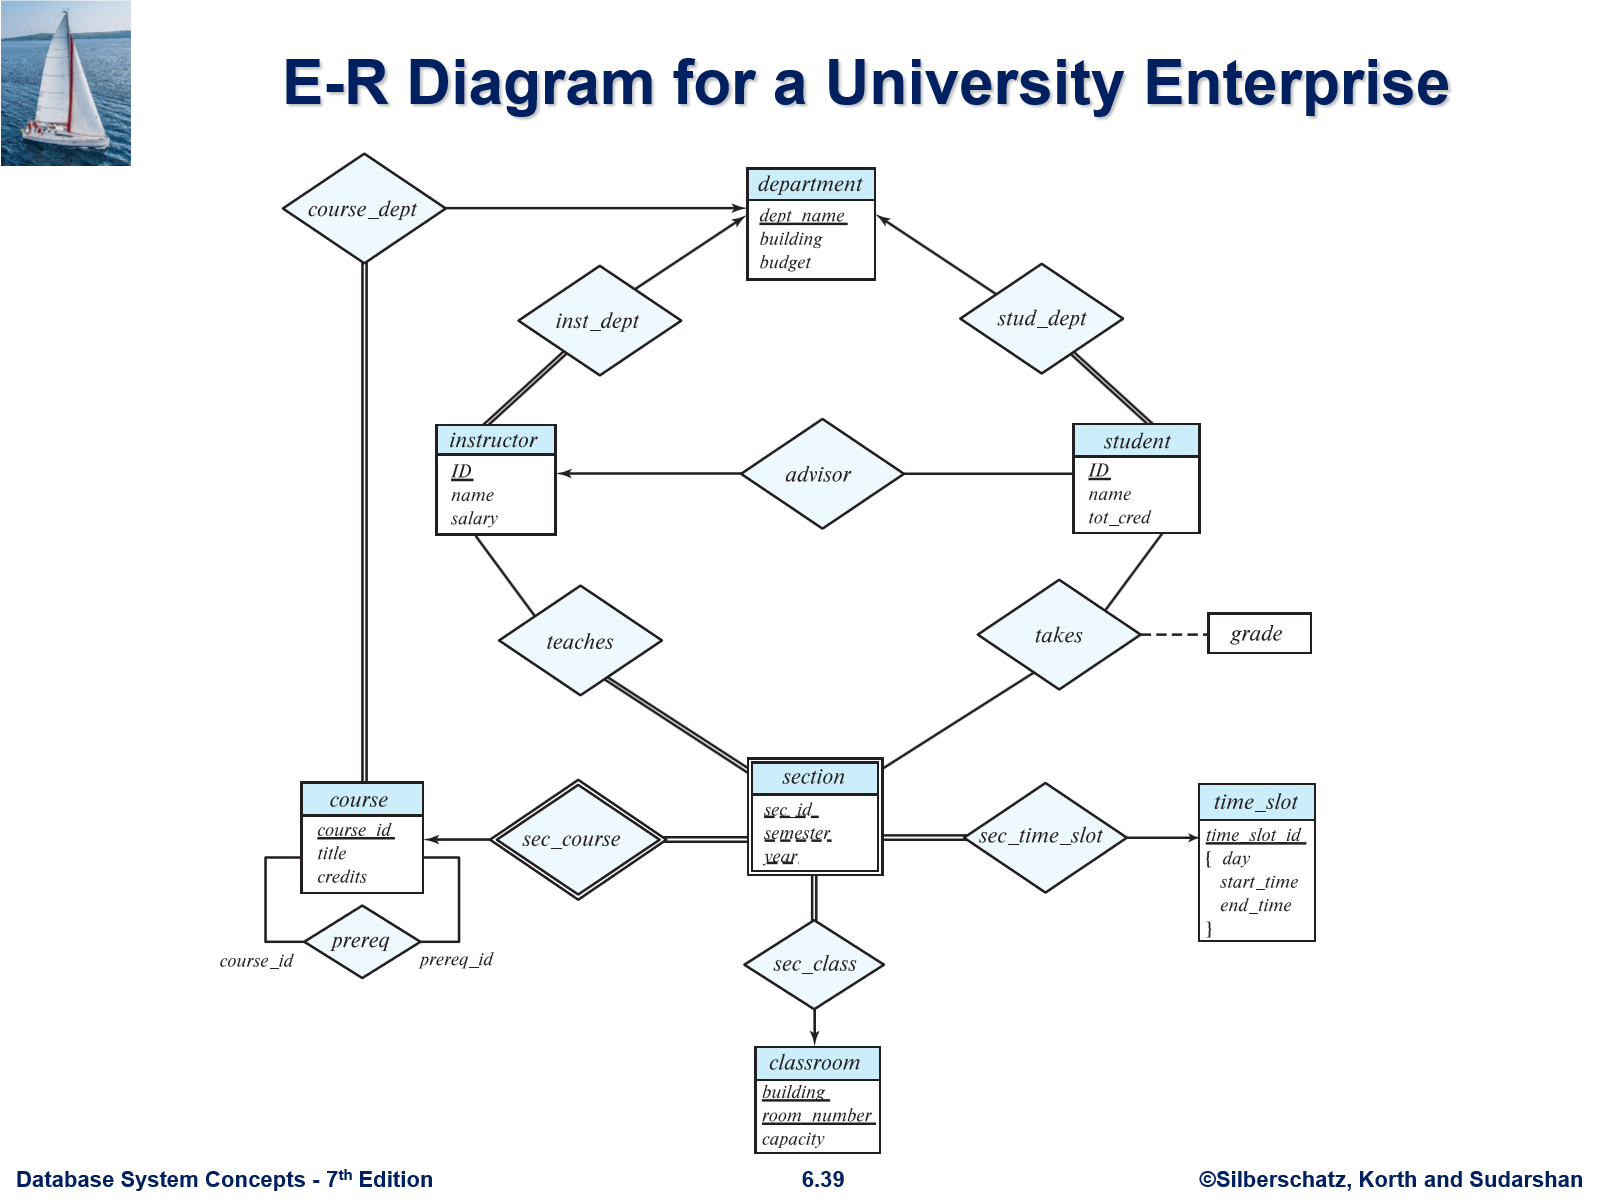
(Diagram universitas lengkap: department, instructor, student, course, section sebagai weak entity, time_slot, classroom, dengan relationship inst_dept, stud_dept, course_dept, advisor, teaches, takes beratribut grade, sec_course, sec_time_slot, sec_class, prereq.)
Extended ER:
- Specialization: proses top-down, membuat subgrouping lower-level dalam suatu entity set; digambar dengan triangle berlabel ISA (contoh
customeris aperson). Attribute inheritance: lower-level mewarisi atribut dan partisipasi relationship higher-level. - Generalization: proses bottom-up, menggabungkan entity set yang berbagi fitur. Digambar sama dengan specialization, hubungan ISA disebut superclass-subclass. Satu entity set boleh punya beberapa specialization sekaligus (contoh
employee: permanent/temporary dan officer/teller/secretary). - Constraint keanggotaan: condition-defined (kondisi eksplisit pada atribut) vs user-defined (manual).
- Constraint tumpang tindih: disjoint (satu entity hanya di satu lower-level; tulisan “disjoint” di triangle) vs overlapping.
- Completeness: total (entity wajib jadi anggota satu lower-level; garis ganda) vs partial (garis tunggal).
- Aggregation: memperlakukan relationship sebagai entity abstrak, supaya bisa direlasikan lagi. Dipakai ketika
eval_fordanproj_guidemerepresentasikan informasi yang tumpang tindih danproj_guidetidak bisa dibuang; tanpa menambah redundansi, diagram menyatakan (1) student dibimbing instructor pada project, (2) kombinasi itu mungkin punya evaluasi.
Isu desain ER:
- Atribut redundan:
dept_namepadastudentmeniru informasi yang sudah ada di relationshipstud_dept, sebaiknya dihapus. - Atribut relationship yang keliru: menaruh
assignmentdanmarkspadastud_sectionkeliru karena assignment adalah entity sendiri. Alternatif: jadikanassignmententity set dengan relationshipsec_assigndanmarks_in(beratributmarks), atau jadikan atribut multivalued composite{assignment_marks: {assignment, marks}}. - Entity vs atribut:
phone_numberbisa atribut atau entityphonesendiri (untuk info tambahan sepertilocationatau banyak nomor). - Entity vs relationship set: gunakan relationship set untuk aksi antar entity (contoh entity
registration). - Binary vs non-binary: ternary kadang lebih jelas, tetapi ada yang lebih baik dua binary (contoh
parentsjadifatherdanmotheragar informasi parsial bisa dicatat);proj_guidememang secara alami non-binary. - Konversi non-binary ke binary: buat entity set artifisial E, tiga relationship set
R_A,R_B,R_C; beri atribut pengidentifikasi untuk E (atau jadikan E weak entity set); tiap relationship(ai, bi, ci)menjadi entityeidengan(ei, ai),(ei, bi),(ei, ci). Tidak semua constraint bisa diterjemahkan sepenuhnya. - Ringkasan keputusan: atribut vs entity, entity vs relationship, ternary vs binary, strong vs weak, specialization/generalization (modularitas), aggregation (agregat diperlakukan satu unit).
2.3 Model Relasional dan SQL
Sumber: 14_Relational_Data_Model (memakai ER di 2.2)
Dasar. DBMS adalah kumpulan data berelasi plus program untuk mengaksesnya. Relational database terdiri dari tabel (relasi) bernama unik. Alasan tetap dipakai: model sederhana, fondasi matematis kuat, implementasi efisien dan dikenal, ada standar (SQL), prosedur desain lugas, dan untuk data predictable (struktur, ukuran, frekuensi akses) tetap pilihan terbaik (menurut MongoDB sendiri).
- Kolom = atribut, baris = tuple; urutan tuple tidak relevan (unordered). Relation schema
R = (A1, ..., An), instancer(R). Contohinstructor = (ID, name, dept_name, salary). - Domain, nilai atribut normalnya atomic, dan null (nilai tidak diketahui, anggota setiap domain, menimbulkan komplikasi).
- Key: superkey (cukup mengidentifikasi tuple unik), candidate key (superkey minimal), primary key (satu candidate key terpilih), alternate key (candidate key tidak terpilih). Foreign key constraint: nilai di relasi referencing harus muncul di relasi referenced (contoh
FK: instructor(dept_name) → department(dept_name)). Schema diagram menggambar relasi sebagai kotak (primary key digarisbawahi) dan panah foreign key.
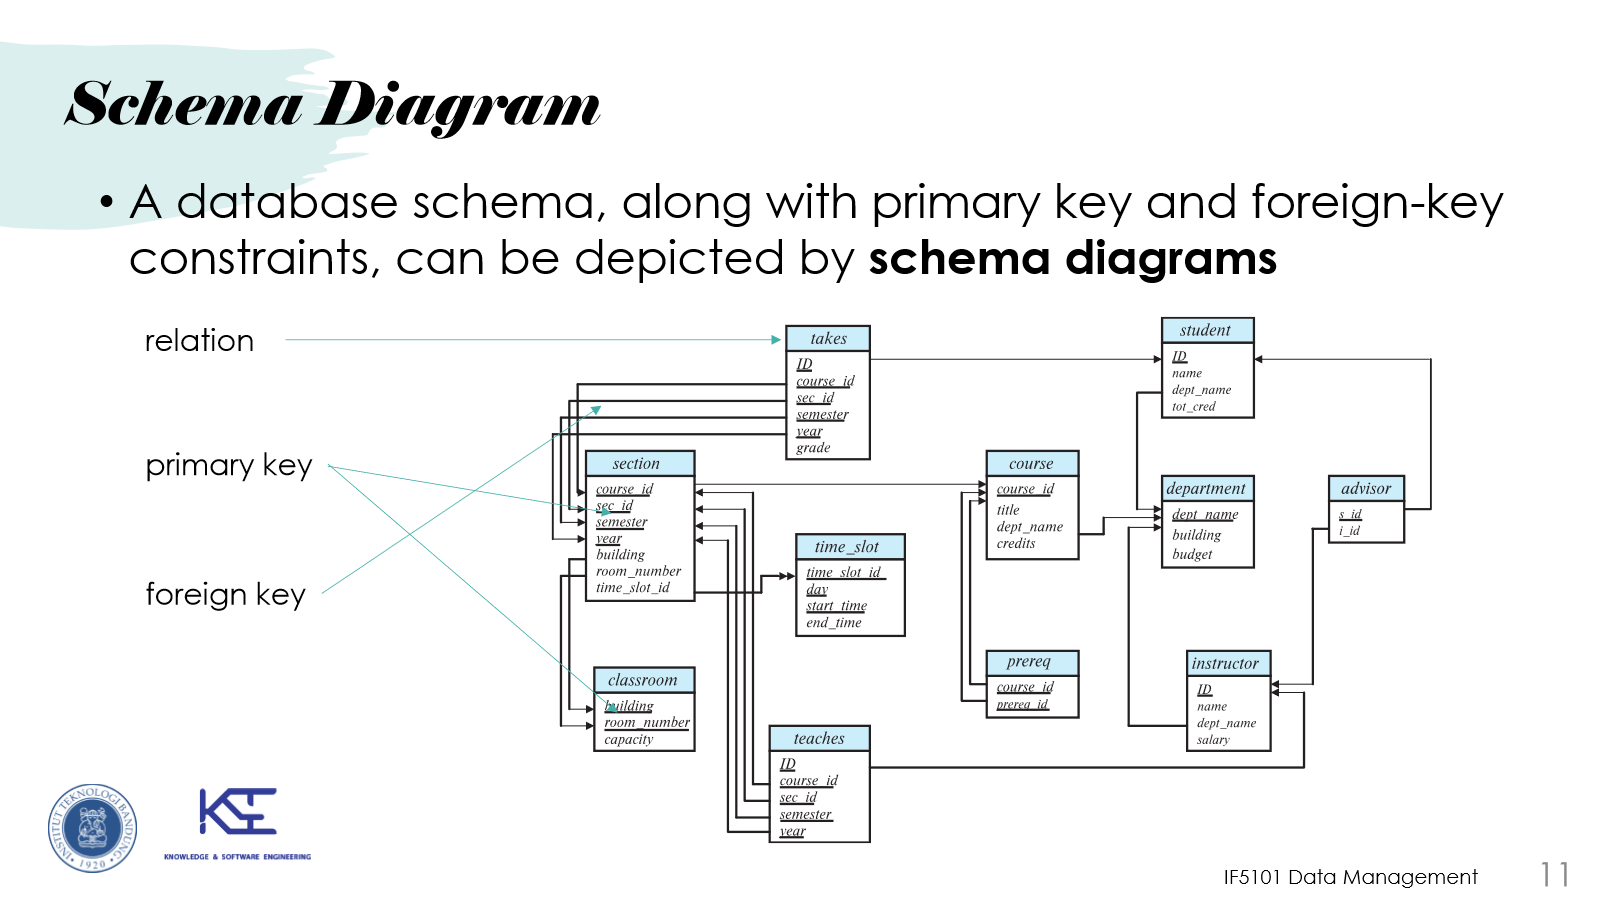
Reduksi ER ke relasional:
| Konsep ER | Hasil relasional |
|---|---|
| Strong entity set | Skema dengan atribut yang sama, contoh course = (course_id, title, credits) |
| Weak entity set | Tabel yang menyertakan primary key identifying entity (sebagai foreign key), contoh section = (course_id, sec_id, sem, year) |
| Composite attribute | Diratakan (flattened) jadi atribut terpisah per komponen |
| Multivalued attribute M pada entity E | Skema terpisah EM, contoh instructor_phone = (ID, phone_number) dengan FK ke instructor |
| Derived attribute | Tidak direpresentasikan eksplisit (bisa stored procedure, function, atau method di model lain) |
| Relationship many-to-many | Skema berisi primary key kedua entity plus atribut deskriptif, contoh advisor = (s_id, i_id, date) |
| Relationship many-to-one / one-to-many | Tambahkan foreign key di sisi “many” (terutama bila total participation), contoh student = (ID, name, tot_cred, dept_name, i_id) |
| Relationship one-to-one | Sisi mana pun bisa jadi “many”; pilih yang total participation karena partial berisiko menghasilkan null |
| Specialization | Skema higher-level, plus skema per lower-level berisi primary key higher-level dan atribut lokal, contoh Person = (ssn, address, type), Employee = (ssn, salary) dengan FK: Employee(ssn) → Person(ssn) |
| Aggregation | Skema berisi primary key relationship teragregasi, primary key entity terkait, dan atribut deskriptif, contoh eval_for = (i_id, p_id, s_id, e_id) dengan FK ke proj_guide dan evaluation |
SQL. Awalnya Sequel (IBM System R, San Jose Research Lab). Standar ANSI/ISO: SQL-86, SQL-89, SQL-92, SQL:1999, SQL:2003. Bagian: DML (query, insert, delete, update), DDL (relasi, integrity constraint, view), dan transaction control, embedded/dynamic SQL, authorization. Kategori bahasa query: imperative (instruksi langkah spesifik), functional (evaluasi fungsi, contoh relational algebra), declarative (deskripsikan informasi yang diinginkan, contoh relational calculus). SQL memuat ketiganya.
DDL. Tipe domain bawaan: char(n), varchar(n), int, smallint, numeric(p,d) (contoh numeric(3,1) menyimpan 44.5 tetapi tidak 444.5 atau 0.32), real, double precision, float(n), date, time, interval. Bentuk create table r (A1 D1, ..., An Dn, <integrity-constraint>). Constraint: primary key, not null, unique (A1..Am) (candidate key yang boleh null, beda dari primary key), check (P), foreign key (...) references .... Bila tidak dideklarasikan, semua atribut boleh null kecuali primary key. Mengubah struktur: drop table r, alter table r add A D, alter table r drop A (tidak didukung banyak DBMS).
DML. Query dasar select A1..An from r1..rm where P; hasil selalu sebuah relasi.
select distinctmenghapus duplikat;select all(default) tidak;select *semua atribut; ekspresi aritmetika dan alias denganas(salary/12 as monthly_salary).frommenghasilkan cartesian product, berguna dengan kondisiwhereatau join.
| Join type | Join condition |
|---|---|
| inner join | natural |
| full outer join | on <predicates> |
| left outer join | using (A1, ..., An) |
| right outer join |
natural join mencocokkan atribut bernama sama. Outer join mempertahankan tuple tanpa pasangan dengan null: left (semua tuple kiri), right (semua kanan), full (kedua sisi).
where:and/or/not, perbandingan< <= > >= = <>,like(wildcard%dan_),between, tuple comparison.- Null:
5 + null→null;is null/is not null; perbandingan dengan null bernilai unknown. order by(ascdefault,desc), set operationunion,intersect,except(hapus duplikat, tambahalluntuk mempertahankan), aggregateavg,min,max,sum,count,group by,having(diterapkan pada grup setelah terbentuk,wherediterapkan sebelum grup).- Nested subquery di
from,where(B <operation> (subquery)), danselect(scalar subquery, error runtime bila lebih dari satu tuple).in/not in;exists r⇔ r ≠ ∅,not exists r; correlation name dan correlated subquery;withclause (relasi sementara). - Subquery di
insert,update,delete(contohupdate instructor set salary = salary * 1.05 where salary < (select avg(salary) from instructor)),insert ... select. - View:
create view v as <query expression>, relasi virtual (contohfacultymenyembunyikansalary). Materialized view disimpan fisik, perlu di-refresh (refresh materialized view v) karena bisa usang.
2.4 Pengantar NoSQL
Sumber: 15_Intro_to_NoSQL (memakai 2.2 dan 2.3)
Catatan 15 tidak mengulang motivasi NoSQL, ACID vs BASE, CAP, klasifikasi dasar, dan MapReduce karena sudah ada di 11_NoSQL (materi lama).
Riwayat standar SQL (ISO/IEC 9075):
| Tahun | Perkembangan |
|---|---|
| 1987 | Standar ISO/IEC awal |
| 1989 | Referential integrity |
| 1992 | SQL2 |
| 1995 | SQL/CLI (ODBC) |
| 1996 | SQL/PSM (ekstensi prosedural) |
| 1999 | User-defined types |
| 2003 | SQL/XML |
| 2008 | Ekspansi dan koreksi |
| 2011/2012 | System-versioned dan application time period tables (data temporal) |
Recap relasional: data dalam tabel dengan foreign key; DML dan DDL (termasuk trigger, stored module, security); transaksi dengan ACID: Atomic (selesai semua atau tidak sama sekali), Consistent (dari satu state konsisten ke state konsisten lain), Isolated (perubahan tidak terlihat sebelum commit), Durable (hasil commit bertahan meski failure); abstraksi dari lapisan fisik (aplikasi menyatakan what bukan how, ada query optimization engine, lapisan fisik bisa berubah tanpa mengubah aplikasi). Contoh komersial: IBM DB2, Oracle, SQL Server, Sybase SQL Anywhere; open source: MySQL, PostgreSQL.
Keterbatasan relasional untuk skala Web: aplikasi Web butuh volume baca/tulis besar, low latency, dan high availability. Kendala: teknik lama tidak bekerja pada skala sekarang; upgrade CPU/memori/storage hanya sampai titik tertentu (scaling vertikal terbatas); redesain skema/denormalisasi berisiko konsistensi; multiple server relasional operasionalnya kompleks. Dari sini lahir NoSQL (“Not Only SQL”, definisi IBM): bisa menyimpan data yang sama seperti RDBMS, hanya berbeda cara menyimpannya; relational vs non-relational bergantung use case.
Karakteristik NoSQL: volume data besar, replikasi dan distribusi skalabel (ribuan mesin, global), query cepat (mayoritas query, sedikit update, insert/update asynchronous), schema-less, memakai BASE (bukan selalu ACID), dan open source.
Contoh produk: key-value (Redis, DynamoDB, Project Voldemort, Riak); document (MongoDB, CouchDB, Cloud Firestore); column-family (Google Bigtable, Apache HBase di atas Hadoop, Apache Cassandra); graph (Neo4j, ArangoDB).
Column store. Setiap blok penyimpanan hanya berisi data satu kolom (bukan seluruh kolom satu baris seperti row-oriented). Contoh: kolom id [1,2,3] dan username ['John','Mary','Yoda'] disimpan terpisah. Strukturnya sparse, distributed, multi-dimensional sorted map. Lebih efisien dibanding row/document store saat banyak baris di-insert bersamaan (update blok kolom bisa diagregasi) dan saat query hanya mengakses sebagian kolom. Contoh: Hadoop/HBase (mengikuti Google Bigtable, dipakai Yahoo dan Facebook), Apache Cassandra, Actian Vector (VectorWise, terintegrasi dengan SQL).
Graph database (ringkas). Memodelkan data sebagai node (properti termasuk ID) dan edge (berlabel, umumnya berarah). Berskala vertikal (bukan horizontal seperti kebanyakan NoSQL), mendukung algoritma graf (shortest path, traversal), berguna bila relasi adalah inti aplikasi. Contoh: Neo4j (graph native sampai level storage), ArangoDB (multi-model native: graph, dokumen JSON, key-value). Detail di 2.8.
Tipe non-SQL lain: XML database (2.9), Codasyl (berbasis network data model, didefinisikan CODASYL Database Task Group), object-oriented database, time-series database.
Memilih model: tidak ada satu model untuk semua use case; tergantung karakteristik data (terstruktur vs semi-terstruktur), pola akses (join kompleks vs lookup by key), kebutuhan konsistensi (ACID vs BASE), dan skala (vertikal vs horizontal).
2.5 Key-Value Database
Sumber: 16_Key_Value_Database
Istilah pemodelan: key (referensi ke value, analog alamat; minimal string, mis. "Cust9876"; Redis mendukung struktur kompleks sebagai key: strings, lists, sets, sorted sets, hashes, bit arrays; key juga mengorganisasi data lintas server), value (objek, umumnya sekumpulan byte: integer, string, BLOB, JSON, gambar, audio; batas Redis string 512 MB, FoundationDB 100.000 byte), namespace (kumpulan pasangan key-value tanpa key duplikat dalam satu namespace; value boleh duplikat; berguna saat banyak aplikasi berbagi satu database karena secara implisit menambah prefix, mis. CMGMT[Prod:12986:name] vs OMGMT[Prod:12986:name]), schemaless (tidak wajib mendefinisikan key dan tipe value di muka; ubah representasi tanpa migrasi skema, mis. dari fullName ke firstName dan lastName).
Key-naming convention: gabungkan nama tabel, nilai primary key, dan nama atribut, mis. customer:1982737:firstName. Jangan terlalu panjang (boros memori) maupun terlalu pendek (rawan konflik). Panduan: komponen bermakna dan tidak ambigu (cust, inv), komponen berbasis rentang untuk mengambil rentang (tanggal, counter), delimiter konsisten (:), sesingkat mungkin. Pola umum <entity>:<unique_id>:<attribute_name> dengan fungsi getCustAttr dan setCustAttr. Sebaiknya ada naming convention juga untuk namespace. Rentang nilai: pakai counter dalam key (cust061514:1:custId sampai cust061514:10:custId), iterasi sampai key tidak ditemukan. Batasan implementasi: ukuran key (FoundationDB 10.000 byte) dan tipe key (Riak biner/string, Redis lebih liberal).
Arsitektur:
- Partition / partitioned cluster: server yang masing-masing mengelola subset database (contoh A-L ke Server 1, M-Z ke Server 2). Distribusi key tidak merata menyebabkan ketidakseimbangan beban; saat menambah server, instance dialokasikan ulang.
- Partition key: key penentu partisi; yang baik mendistribusikan beban merata. Bila tidak ada key yang alami, pakai hash function (memetakan input ke string berukuran tetap, umumnya unik).
- Cluster: komputer saling terhubung yang mengoordinasikan operasi; loosely coupled (cluster key-value) atau tightly coupled. Node berbagi info rentang data dan mengirim heartbeat. Dua model: master node (mis. Redis: master menerima baca/tulis dan mereplikasi ke slave; bila master gagal, node lain memilih master baru) dan masterless (mis. Riak: semua node baca/tulis, node lain mengambil alih bila ada yang gagal).
- Ring: pola sirkular tiap server tertaut ke dua instance bersebelahan. Contoh: hash memetakan partition key ke 0-95, dipetakan ke 8 server (Server 1 menangani 0-11, Server 2 12-23, dst). Tiap tulis juga ditulis ke dua tetangga (replikasi, high availability). Bila Server 4 gagal, Server 3 dan 5 melayani baca dan menerima tulis, lalu mengirim ulang tulisan setelah Server 4 pulih.
- Replication: menyimpan banyak salinan; parameter jumlah replika. Makin banyak replika, makin kecil risiko kehilangan data tetapi performa berpotensi turun. Data mudah diregenerasi: replika sedikit cukup; toleransi kehilangan rendah: replika lebih banyak.
- Partitioning: mengelompokkan pasangan key-value ke node berbeda. Hashing (merata) vs range partitioning (nilai berdekatan ke node sama, mis.
cust:00001-cust:00999ke Server 1).
Mendesain value terstruktur: struktur data terstruktur mengurangi latensi (ambil nama dan alamat sekaligus bila 80% waktu keduanya dibutuhkan, karena mengambil value relatif lama, analog waktu seek disk). Cara mempercepat: simpan value sering dipakai di memory cache, dan simpan atribut yang sering dipakai bersama dalam satu value (mis. cstMgtNS[cust:198277:nameAddr] = {...}). Duplikasi data (denormalisasi) umum untuk performa. Value besar tidak efisien: melebihi ukuran block berarti banyak block dibaca, tulis harus menulis ulang seluruh value, dan block berisi banyak value kecil lebih menguntungkan cache. Bila sering mendesain value besar, pertimbangkan document database (2.6).
Keterbatasan: hanya lookup berdasarkan key (ekstensi: text search seperti Riak, secondary index); tidak ada range query kecuali pakai naming convention + lookup table, ordered key-value database, atau secondary index; tidak ada bahasa query standar setara SQL (sebagian memahami XML/JSON, library seperti Solr dan Lucene).
Enam design pattern:
| Pola | Isi |
|---|---|
| TTL keys | Objek transient: cache di server memori terbatas, atau menahan resource sementara (mis. kursi tiket ditahan dengan TTL 5 menit saat pembayaran diproses) |
| Emulating tables | Meniru tabel relasional lewat naming convention; tidak praktis secara utuh karena hanya get/set tanpa query bergaya SQL; cocok untuk sedikit tabel emulasi |
| Aggregates | Atribut berbeda untuk subtipe berbeda: satu entity type (mis. 'concert') dengan value list pasangan atribut-nilai per subtipe plus indikator tipe |
| Atomic aggregates | Semua nilai yang harus di-update bersamaan disimpan dengan satu statement assignment (mis. date, location, assigned seat), mirip Atomicity pada ACID |
| Enumerable keys | Key memakai counter/sequence, mis. ticketLog:20140617:10, untuk mengambil grup key berurutan |
| [Inverted] index | Pasangan key-value untuk mencari lewat atribut lain, mis. addLocAssgnSeat(p_locDescr, p_seat) untuk “semua kursi terjual di lokasi X” |
Studi kasus (TGTS Tracker, aplikasi mobile): konfigurasi tiap customer disimpan terpusat; harus mendukung 10.000 user simultan dengan read 90% dari I/O. Satu namespace TrackerNS, key <entity type>:<account number>, empat entity type: cust (informasi customer), dshb (opsi dashboard), alrt (alert dan notifikasi), ui (konfigurasi UI). Contoh: TrackerNS['cust:4719364'] = {'name': 'Prime Machine, Inc.', 'currency': 'USD'}; dashboard berisi list hingga enam atribut shipment (shpComp, shpState, shpDate, dst); alert berupa list of lists ({email, 'pickup'}, {telepon, 'delay'}); UI list pasangan atribut-nilai (font, ukuran, skema warna). Menunjukkan key design, namespace, dan aggregate pattern untuk aplikasi read-heavy.
2.6 Document Database
Sumber: 17_Document_Database (memakai key-value di 2.5, ER di 2.2, relasional di 2.3)
Apa itu dokumen: struktur yang memisahkan content dari formatting, biasanya JSON atau XML. Aturan JSON: pasangan key-value dipisah koma dalam { }; nama berupa string; nilai bisa angka, string, boolean, array [ ], objek { } (bersarang), atau null. Beda dengan key-value murni: atribut terkait dikelola dalam satu objek (seperti tabel relasional), jadi mengembalikan semua atribut entitas berdasarkan filter satu atribut lebih mudah. Dokumen dikelompokkan dalam collection; dokumen dalam satu collection tidak wajib berstruktur identik tetapi sebaiknya berbagi sebagian struktur.
Lima istilah: document (kumpulan pasangan key-value terurut; value bisa dokumen lain yang di-embed), collection (kumpulan dokumen satu entitas subjek; didukung index, analog indeks buku), embedded document (dokumen di dalam dokumen, menghindari join), schemaless (tidak ada schema formal: fleksibel, tetapi aturan seperti field wajib, rentang valid, dan referensi harus ditegakkan kode aplikasi; pengecualian unique identifier), polymorphic schema (banyak struktur implisit dalam satu collection, contoh {a,b,c}, {a,b,d}, {a,e,f,g}).
Operasi dasar (sintaks MongoDB): insert (db.books.insert({...}), bisa array), delete (db.books.remove({"book_id": 639397})), update (db.books.update({"book_id": 1298747}, {$set: {"quantity": 10}}), $inc), retrieve (db.books.find({"author": "..."}, {"title": 1}), {"quantity": {"$gte": 10, "$lt": 50}}). Operator: $lt, $lte, $gt, $gte, $in, $or, $not. Tidak ada bahasa manipulasi standar lintas document database.
Fase desain NoSQL document (Rossel dan Manna, 2020): (1) high level: conceptual model (mis. ER) plus query pattern; (2) logical level: tipe dokumen dan interelasinya lewat Document Interaction Diagram (DID), tiap tipe dengan JSON Schema; (3) physical level: index, sharding, distribusi data, penyesuaian tipe data.
Normalisasi, denormalisasi, join. Normalization mengurangi anomali data, tetapi performa relasional kadang buruk karena banyak join (tabel di-join lewat foreign key). Contoh nested loop join (hitung theta join): untuk tiap tuple tr di r, untuk tiap tuple ts di s, uji pasangan; mahal karena memeriksa setiap pasangan. Alternatif: indexed nested loop join, merge-join, hash-join. Denormalization sengaja memperkenalkan redundansi demi performa query (tanpa membaca banyak tabel). Contoh: order item dan product sebagai dua collection (dua lookup) vs di-embed dalam order item (satu lookup, product_ID tak diperlukan lagi).
Embedding vs referencing:
| Embedded document | Referenced document | |
|---|---|---|
| Struktur | Di dalam dokumen lain (nested/hierarkis) | Relasi lewat referensi (biasanya ObjectId) ke collection lain |
| Ideal untuk | One-to-one (profil dan pengaturan user); one-to-many dengan child kecil (komentar di post) | Many-to-many (mahasiswa-kelas); subdokumen besar diakses independen (review produk) |
One-to-many: entity “one” jadi dokumen utama, entity “many” sebagai array embedded document (contoh customer dengan array address). Many-to-many: dua collection, masing-masing menyimpan list identifier entitas terkait (mis. enrolledStudents di Courses dan courses di Students), meminimalkan duplikasi.
Empat faktor memilih embedding vs referencing: (1) access pattern (sering diakses bersama: embed; independen: reference); (2) ukuran dan pertumbuhan data (kecil/tetap: embed; besar/tumbuh: reference); (3) frekuensi update (butuh update atomik: embed; sering dan independen: reference); (4) kompleksitas skema (sederhana hierarkis: embed; kompleks berevolusi: reference).
Hindari denormalisasi berlebihan: dokumen besar membuat lebih sedikit dokumen terambil per pembacaan block dari storage sehingga total pembacaan block naik; strategi seimbang: duplikasi product_name saja di Order_Items. Jangan hindari join mutlak: bila perlu dua collection terpisah, join dilakukan di kode aplikasi (loop bersarang). Kesimpulan: normalisasi mengurangi anomali, denormalisasi meningkatkan performa; gunakan query sebagai panduan (terlalu normal: banyak join; terlalu denormal: dokumen besar).
Mutable documents. Pertimbangkan seberapa sering dan bagaimana ukuran dokumen berubah. Contoh fleet management: truk kirim data tiap 3 menit. Opsi 1: dokumen baru per set data (20 set/jam × 10 jam = 200 dokumen/hari per truk, truck_id, date, driver_name terduplikasi). Opsi 2: satu dokumen truk-per-hari dengan array operational_data yang tumbuh. Opsi 2 baik secara logis, tetapi secara fisik bila dokumen tumbuh melebihi ruang yang dialokasikan ia bisa dipindahkan (moved), membebani storage. Solusi: alokasikan ruang cukup sejak dokumen dibuat (array 200 embedded document dengan nilai default).
Index: read-heavy (BI, analitik): index pada hampir semua field filter. Write-heavy: index menambah beban CPU, storage, memori, dan waktu insert/update. Bila keduanya harus didukung: dua basis data (satu dituning untuk write/transaction, satu untuk read/analytics) dihubungkan proses ETL (Extraction, Transformation, Load).
Hierarki:
- Parent or child references: referensi ke parent (
parentID, berguna untuk dari instance ke kategori umum) atau ke children (childrenIDs, berguna untuk mengambil anak/subpart). - Listing all ancestors: simpan seluruh rantai leluhur dalam array (
"ancestors": ["PC72", "PC37", "P01"]). Untung: jalur penuh ke root dalam satu operasi baca. Rugi: perubahan hierarki membutuhkan banyak operasi tulis.
Hindari entity type terlalu abstrak: bila sering memfilter field doc_type dan kode level tertinggi penuh cabang if pada doc_type, indikasi mencampur beberapa entity type berbeda (mis. click_stream dan server_log) dalam satu collection; sebaiknya pisahkan karena memfilter lebih lambat dan mencampur tipe dalam satu disk block menimbulkan pembacaan tidak terpakai. Namun gunakan subtipe dokumen bila entitas sering diagregasi bersama atau berbagi banyak kode pemrosesan (contoh Products dengan subtipe Books, CD, Small kitchen appliances). Query yang memandu organisasi collection, bukan taksonomi di atas kertas.
Studi kasus (Customer Manifest, TGTS): field inti per kontainer: nama customer, fasilitas asal/tujuan, ringkasan isi, jumlah item, indikator bahan berbahaya, tanggal kedaluwarsa barang mudah rusak, kontak pengiriman; kontainer khusus butuh MSDS (hazardous) atau detail inspeksi makanan (perishable). Analisis query: 70-80% mengembalikan satu record manifest (lewat manifest identifier, atau nama customer + tanggal pengiriman + fasilitas asal). Keputusan: field perishable rutin dilaporkan bersama, jadi di-embed; MSDS hanya dibutuhkan facility manager saat darurat, jadi collection terpisah dengan field msdsID sebagai referensi. Index: manifest identifier, plus satu index gabungan (nama customer, tanggal pengiriman, fasilitas asal) alih-alih tiga index. Tipe manifest dibiarkan dalam satu collection (pengecualian karena tipe belum diketahui semua dan mengelola banyak collection merepotkan).
Partitioning:
- Vertical partitioning: memisahkan kolom tabel menjadi beberapa tabel (contoh
ImagesjadiImageAttributesdanImageObjects); lebih umum di relasional. - Horizontal partitioning (sharding): membagi database berdasarkan dokumen/baris menjadi shard di server terpisah; fundamental agar document database berskala. Shard key: key/field di seluruh dokumen collection (kandidat: unique document ID, nama, tanggal, kategori/tipe, region geografis), menjadi input partitioning algorithm.
- Algoritma: range (shard key terurut, mis.
creation dateper bulan), hash (hash function merata, mis. 8 server nilai 1-8), list (himpunan nilai diskret, mis. tipe produk ke lima server).
2.7 Column Family Database
Sumber: 18_Column_Family_Database (memakai 2.5, 2.6, dan column store di 2.4)
Google BigTable (2006, OSDI’06): paper “BigTable: A Distributed Storage System for Structured Data” (Fay Chang dkk.), untuk web indexing, Google Earth, dan Google Finance; menjadi model untuk Cassandra, HBase, Accumulo. Core features: (1) developer punya kontrol dinamis atas kolom (tanpa update skema), (2) value diindeks oleh row identifier, column name, dan time stamp, (3) kontrol atas lokasi data, (4) read/write satu row atomic, (5) row dipertahankan dalam urutan terurut.
- Row sebagai set column family: column family berisi kolom terkait (contoh
Address: Street, City, State/Province, Postal Code, Country). Column family untuk satu row boleh tidak berdekatan di disk, tetapi kolom dalam satu column family selalu berdekatan.
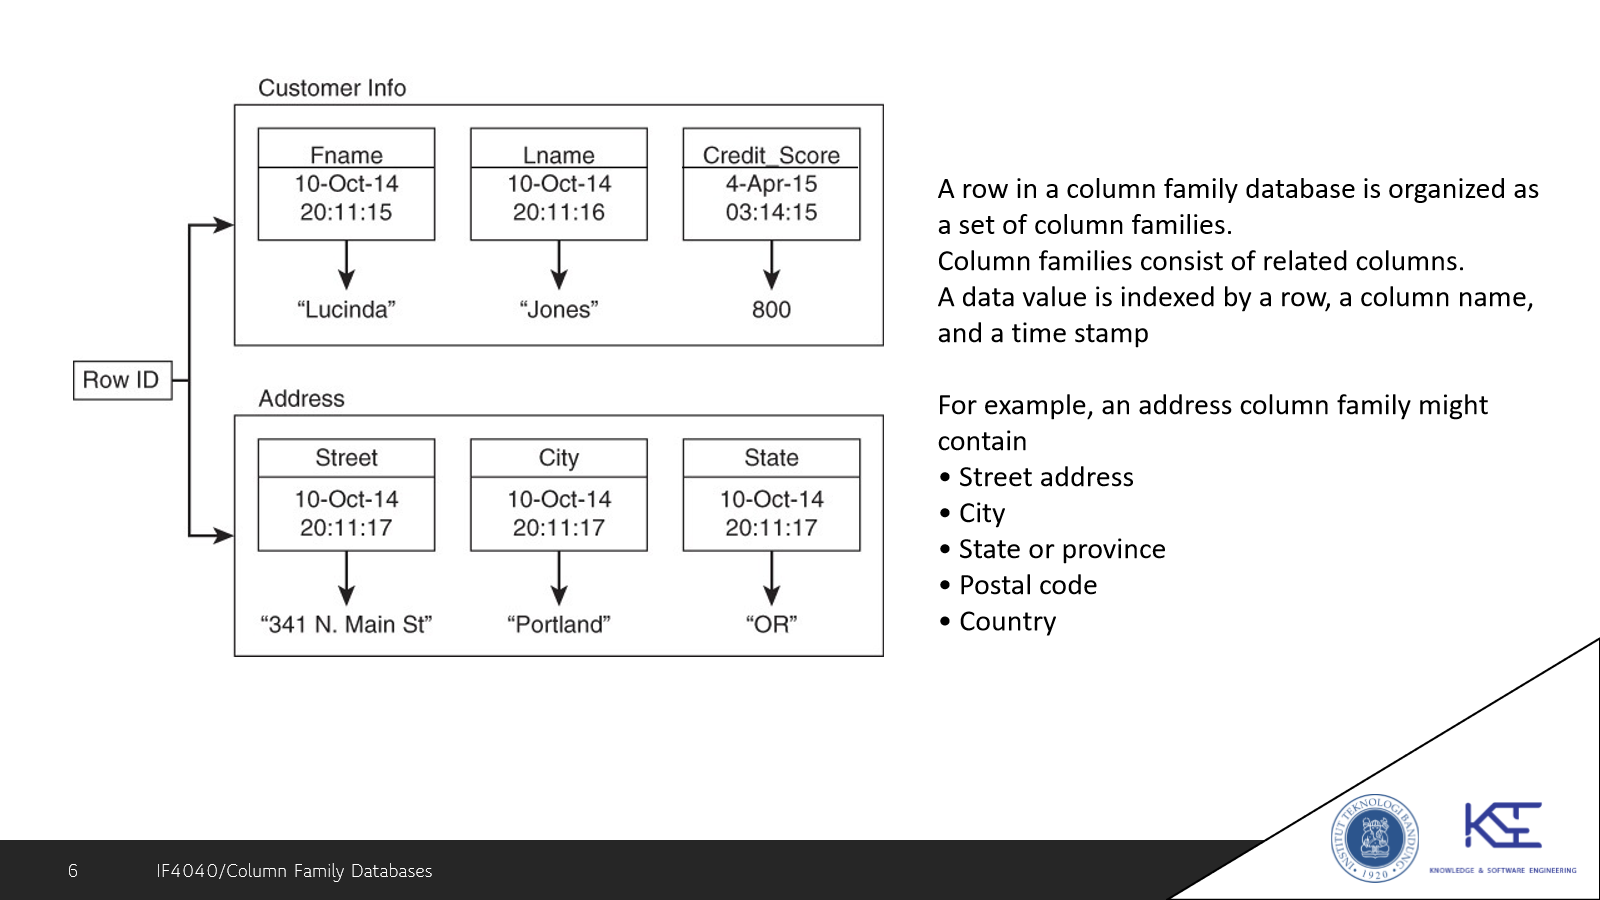
- Jalan tengah BigTable: modeler mendefinisikan column family sebelum implementasi; developer menambah kolom dinamis; tidak perlu update skema (contoh: kolom “State” untuk AS, lalu menambah “Province” untuk Kanada tanpa migrasi). Dari sudut developer column family analog tabel relasional dan kolom analog pasangan key-value.
- Indexing tiga arah: row identifier (analog primary key), column name, dan time stamp (nilai baru ditambahkan, tidak menimpa, sehingga ada versi).
- Lokasi data: data yang sering dipakai bersama disimpan berdekatan; tidak selalu logis street-city-state berdekatan (contoh query total tablet terjual di Colorado hanya butuh state), jadi pendekatannya menyimpan grup kolom terkait bersama (columnar storage).
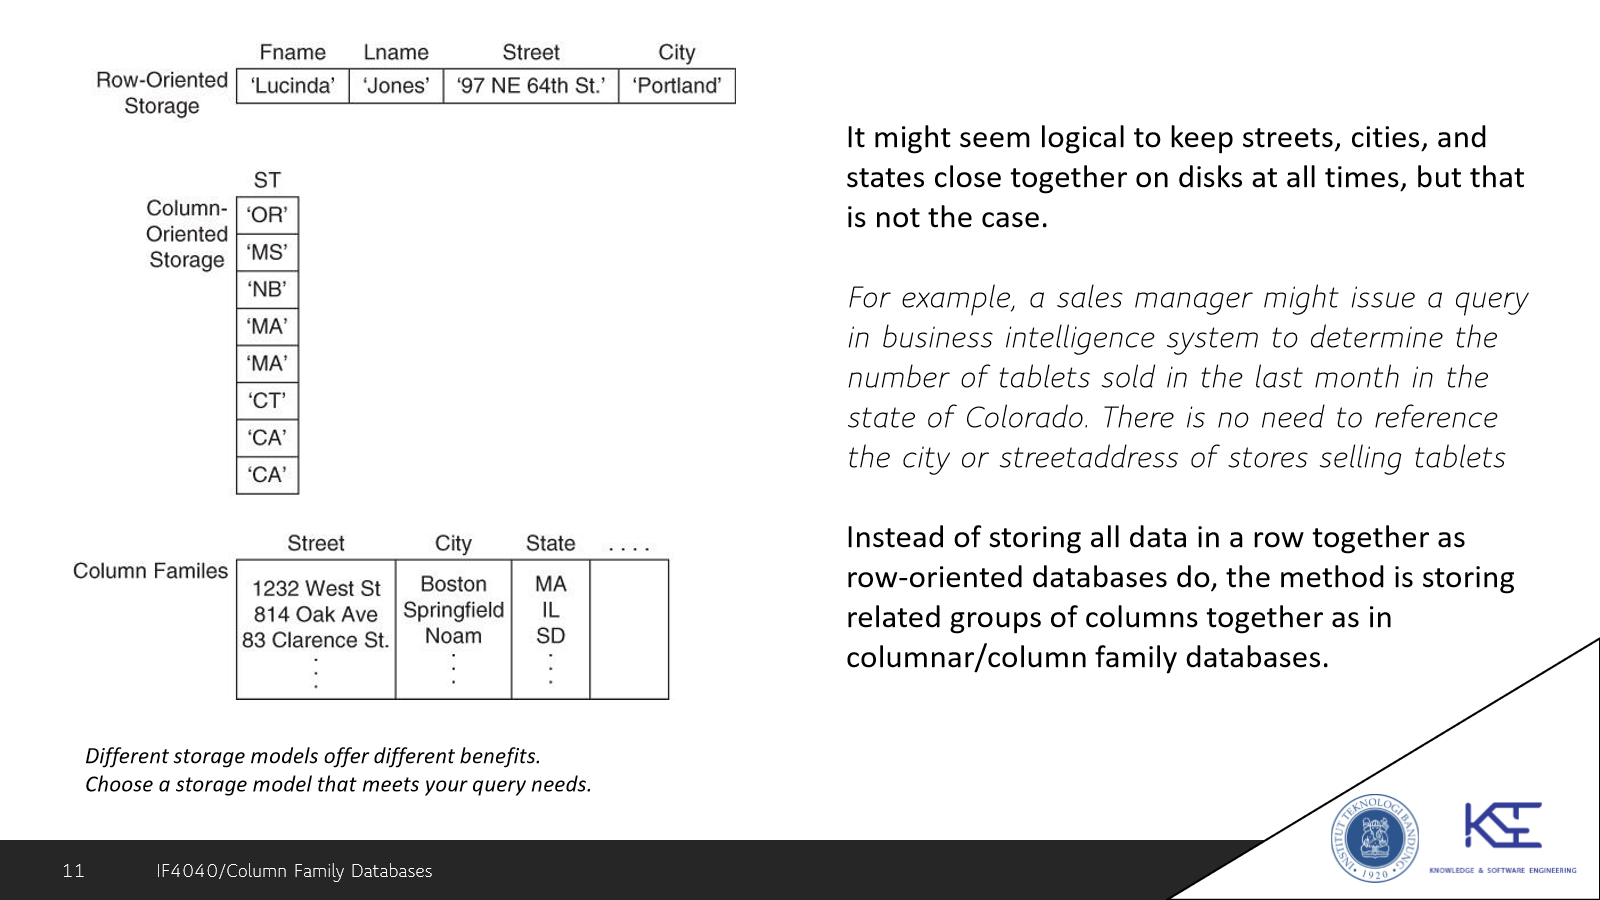
- Atomic rows: baca mendapat seluruh kolom yang dibutuhkan atau tidak sama sekali. Sorted order memudahkan range query (mis. transaksi minggu lalu diurutkan tanggal tanpa secondary index), tetapi tabel hanya bisa diurutkan satu cara.
Perbandingan:
| Dibanding | Perbedaan/kesamaan |
|---|---|
| Key-value | Column family analog namespace; bedanya value diindeks juga oleh row identifier (bukan hanya key) |
| Document | Bisa query subset dalam satu row (Cassandra: CQL, mirip SQL); seperti document, tidak semua kolom harus terisi di semua row |
| Relasional | Sama-sama punya unique row identifier (row key vs primary key) dan bisa dipandang tabular (map/dictionary/associative array). Beda: tidak ada typed column (nilai berupa byte, diinterpretasikan aplikasi, validasi tanggung jawab developer), tidak ada transaksi multirow (atomik hanya per row, Cassandra; bila butuh transaksi, implementasikan dalam satu row), minim join dan subquery (denormalisasi, relasi lewat row identifier yang sama) |
Komponen dasar:
- Keyspace: struktur top-level, analog schema relasional, umumnya satu per aplikasi.
- Row key: identifier unik (mirip primary key); juga untuk partisi dan pengurutan: HBase urutan lexicographic, Cassandra urutan oleh partitioner (default random, bisa order-preserving).
- Column: tiga bagian: column name, time stamp (atau version stamp), value. HBase: value rangkaian byte; Cassandra: mendukung tipe (integer, string, list, map). Column family dibuat designer, kolom ditambah developer kapan saja.
- Column family: kumpulan kolom terkait, disimpan di keyspace, analog tabel, tetapi data selalu terurut, row diversi, dan kolom lebih dinamis (berbeda antar row).
- Komponen internal lain (tidak dibahas mendalam): cluster, partition, commit log, bloom filter, replication count, consistency level.
Tujuh guideline desain tabel: desain mulai dari query (entities, atribut, query criteria, derived values); column family adalah sparse, multidimensional map, kolom bisa berbeda antar row dan ditambah dinamis, join tidak dipakai.
- Denormalize instead of join: many-to-many ditangkap lewat denormalisasi (mis.
Cust_Prodmenyimpan produk dibeli di row customer), tanpa tabel junction. - Use valueless columns: product ID jadi nama kolom (alih-alih
ProductPurchased1). - Use both column names and column values to store data: mis. product ID sebagai nama kolom dan nama produk sebagai value; tukar storage tambahan dengan performa baca.
- Model an entity with a single row: write satu row atomic; atribut tersebar di banyak tabel kehilangan jaminan atomicity.
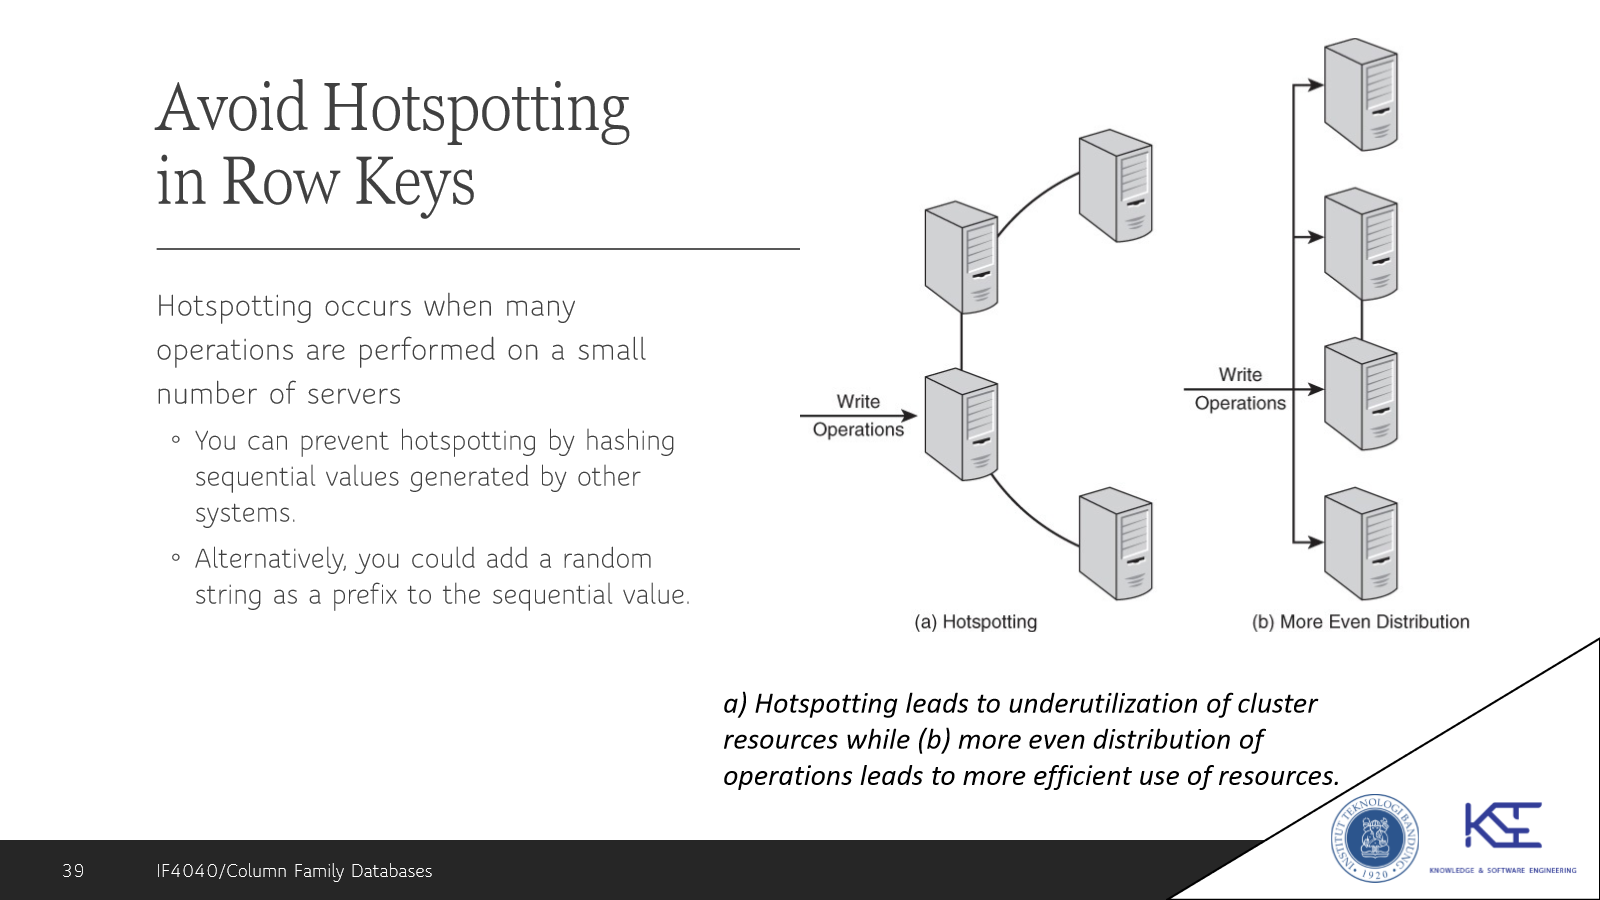
- Avoid hotspotting in row keys: row key sekuensial menumpuk operasi di sedikit server; cegah dengan hashing nilai sekuensial atau prefix string acak.
- Keep appropriate number of column value versions: timestamp memungkinkan roll back; simpan secukupnya. HBase punya versi min dan max, versi terlama dihapus saat data compaction.
- Avoid complex data structures in column values: objek bersarang bisa disimpan tetapi tidak disarankan; kolom terpisah memudahkan indexing per atribut dan pemakaian column family berbeda.
Indexing: primary index (pada row key, otomatis) dan secondary index (pada column value). Bila sistem menyediakan secondary index terkelola (Cassandra CREATE INDEX state ON customers(state);), manfaatkan (kode lebih sedikit). Hindari bila: nilai distinct sedikit (mis. boolean “Opt In?”), terlalu banyak nilai unik (mis. email), atau value sparse (mis. “Province”). Index buatan sendiri lewat tabel bila tidak ada dukungan atau nilai distinct banyak: contoh Cust_by_Prod (row key = product identifier, nama kolom = customer identifier) dan Prod_by_Cust untuk arah sebaliknya; butuh storage tambahan, dan update-nya: setiap ada perubahan (sinkron, tulis lebih lambat) atau batch job berkala (ada jeda tidak sinkron).
Row key (Cust_by_Prod) | 123 | 287 | 1987 | 2405 | 3902 |
|---|---|---|---|---|---|
| 38383 | Smith | Badal | |||
| 48282 | Smith | Jones | O’Malley | ||
| 59595 | Washington |
Kapan dipakai: deployment skala besar dengan performa tulis tinggi, banyak server, atau ketersediaan multi-data center. Operasi write-intensive (mis. social networking); arsitektur peer-to-peer Cassandra dengan hinted handoff selalu bisa menerima tulis selama minimal satu node hidup. Bila write-intensive juga butuh transaksi, kurang cocok; pertimbangkan hybrid dengan relasional atau key-value yang mendukung ACID (mis. FoundationDB). Bila satu atau beberapa server cukup, key-value, document, atau relasional bisa lebih baik; bila hanya karena fleksibilitas model, evaluasi key-value dan document dulu.
Studi kasus (Customer Data Analysis, TGTS): analis ingin memahami pola shipping customer dari waktu ke waktu (semua shipping order sejak berdiri, detail customer, artikel berita, data historis industri). Query: order per customer, item per order, jumlah kapal per rute per periode, jumlah shipment per industri per periode. Karena variasi dan volume (Big Data), dipilih column family database. Tabel: Customers, Orders, Ships, Routes. Index: tabel sebagai index untuk Orders by customer, Shipped items by order, Ships by route, plus index terkelola database pada kolom tanggal.
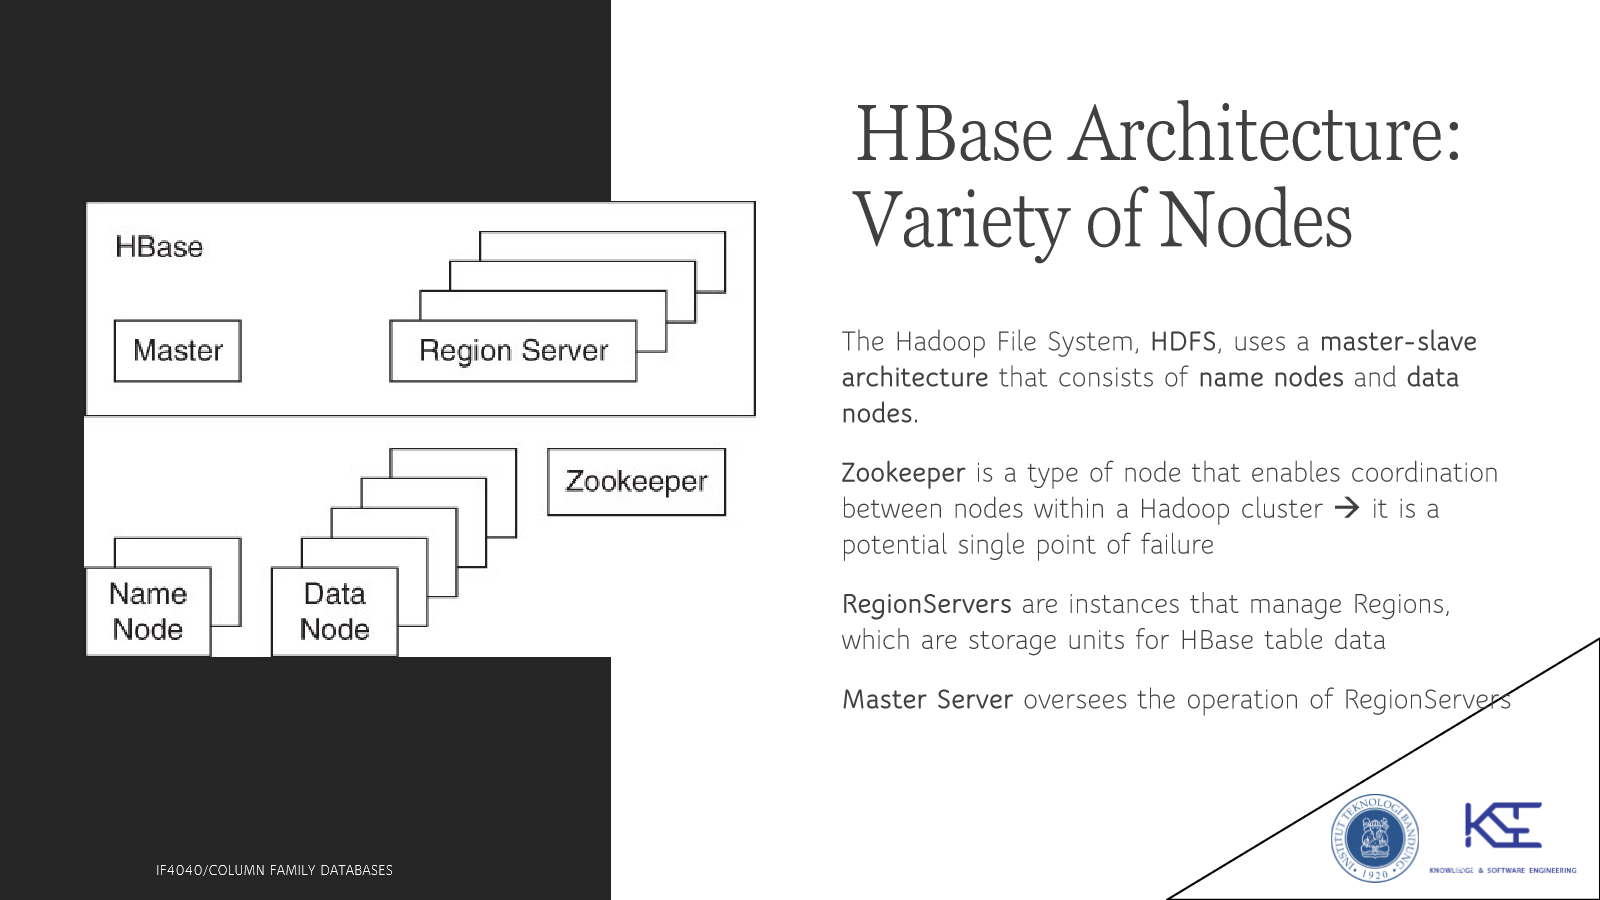
Arsitektur: dua tipe: multiple node type dan peer-to-peer.
- HBase: di atas HDFS (master-slave: name node dan data node). Zookeeper (koordinasi, berpotensi single point of failure), RegionServer (mengelola Region, unit penyimpanan tabel), Master Server (mengawasi RegionServer).
- Cassandra: peer-to-peer, semua node menjalankan software sama, tidak ada single point of failure. Tiap server berbagi status server lain, memastikan data terbaru, dan memastikan tulis tetap tersimpan (mis. hinted handoff) saat server tujuan tidak tersedia.
2.8 Graph Database
Sumber: 19_Graph_Database (memakai 2.5 sampai 2.7)
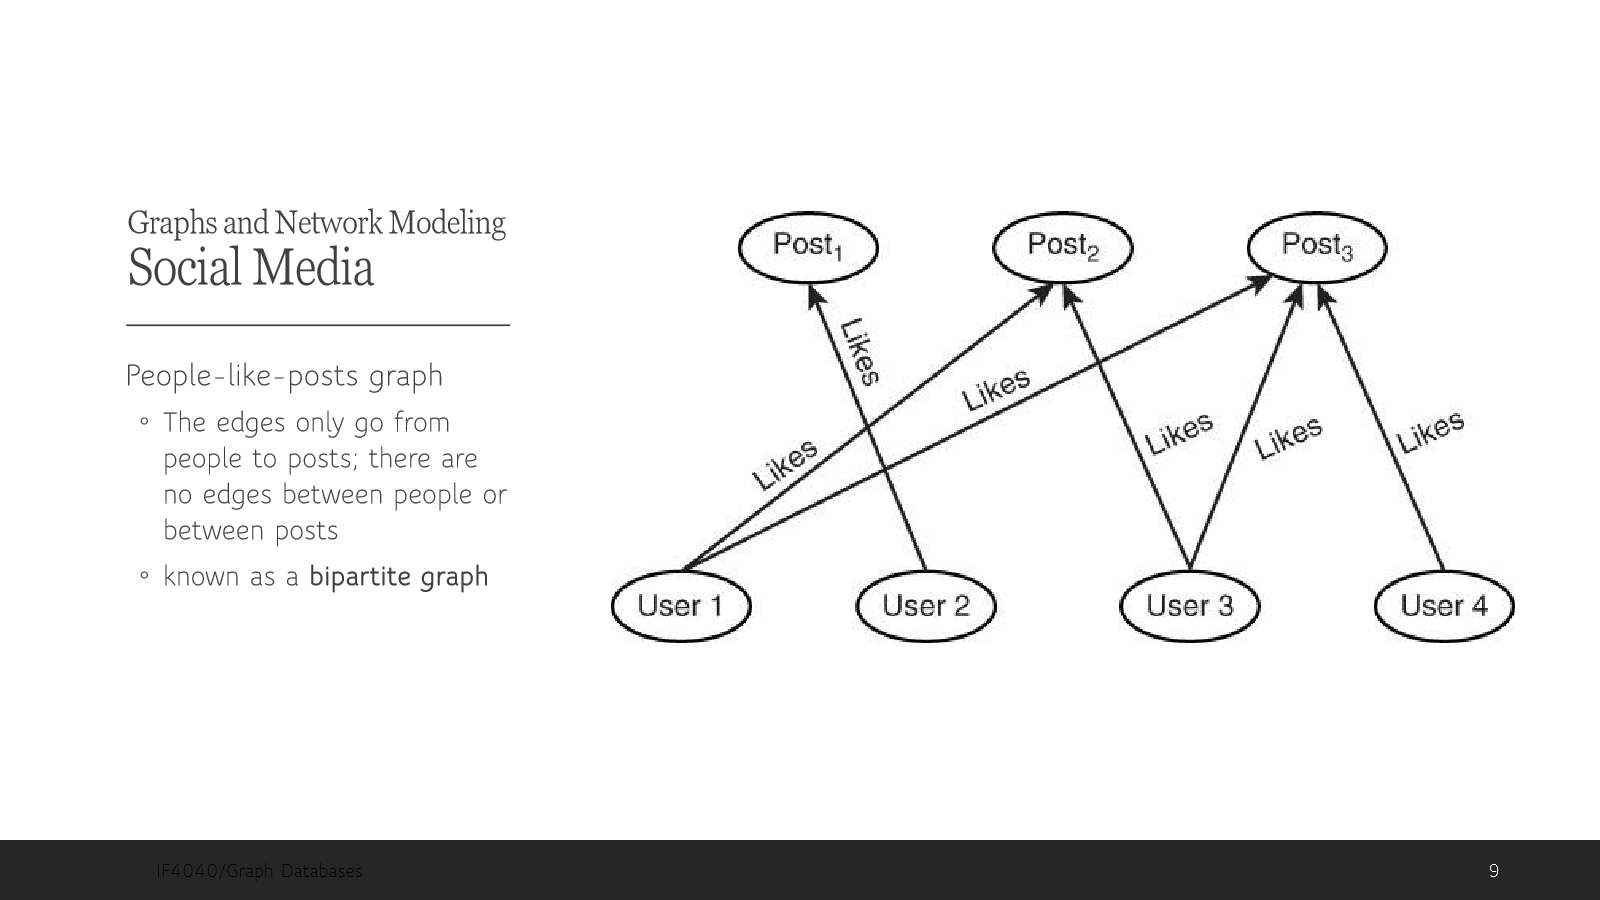
Graph terdiri dari vertices (entitas) dan edges (relasi). Contoh domain: lokasi geografis (vertex kota, edge jalan dengan properti panjang dan kecepatan maks; satu edge dua arah atau dua edge), penyakit menular (vertex orang, edge interaksi dengan probabilitas infeksi), entitas abstrak/konkret (part-of, tree dengan root), media sosial (people-like-posts, edge hanya dari orang ke post: bipartite graph).
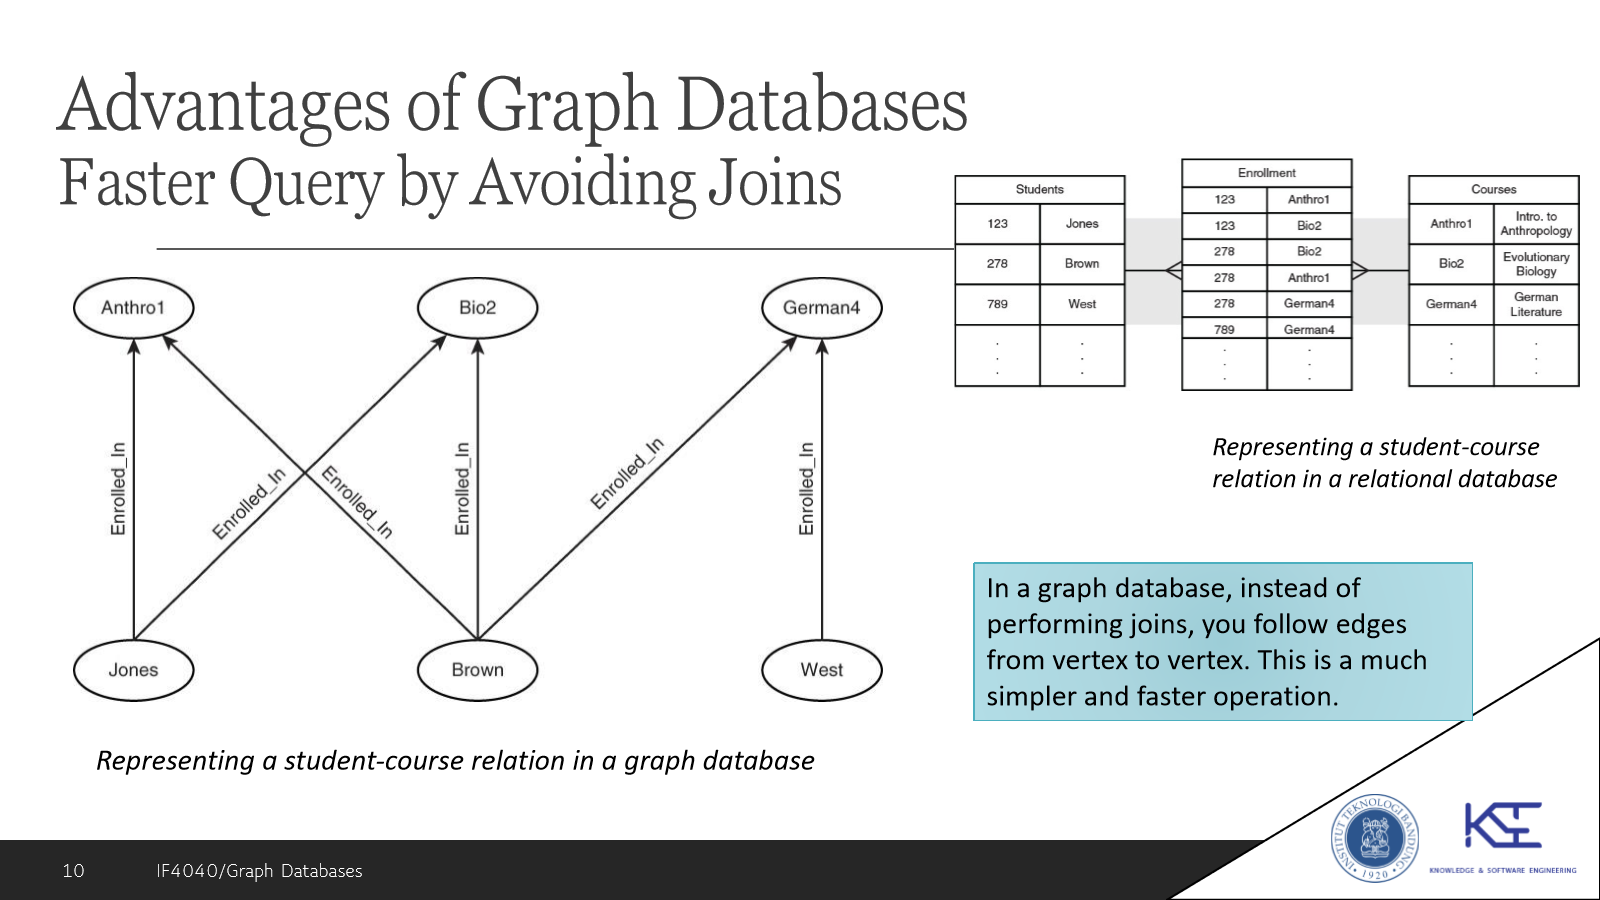
Keunggulan: (1) menghindari join: relasi student-course di relasional butuh tiga tabel (Students, Enrollment, Courses); di graph cukup mengikuti edge (contoh mencari “Patient Zero”). (2) Pemodelan lebih sederhana (many-to-many user-likes-post jadi satu edge “Likes”, bukan tiga tabel). (3) Multiple relations antar entitas yang sama (Chicago-New York: rail, air, road masing-masing berproperti sendiri).
Terminologi:
- Vertex: entitas dengan identifier unik (analog row key / primary key), bisa punya properti. Edge (juga link atau arc): relasi antar vertex, bisa punya properti; weight = nilai relasi (biaya, jarak); edge directed atau undirected.
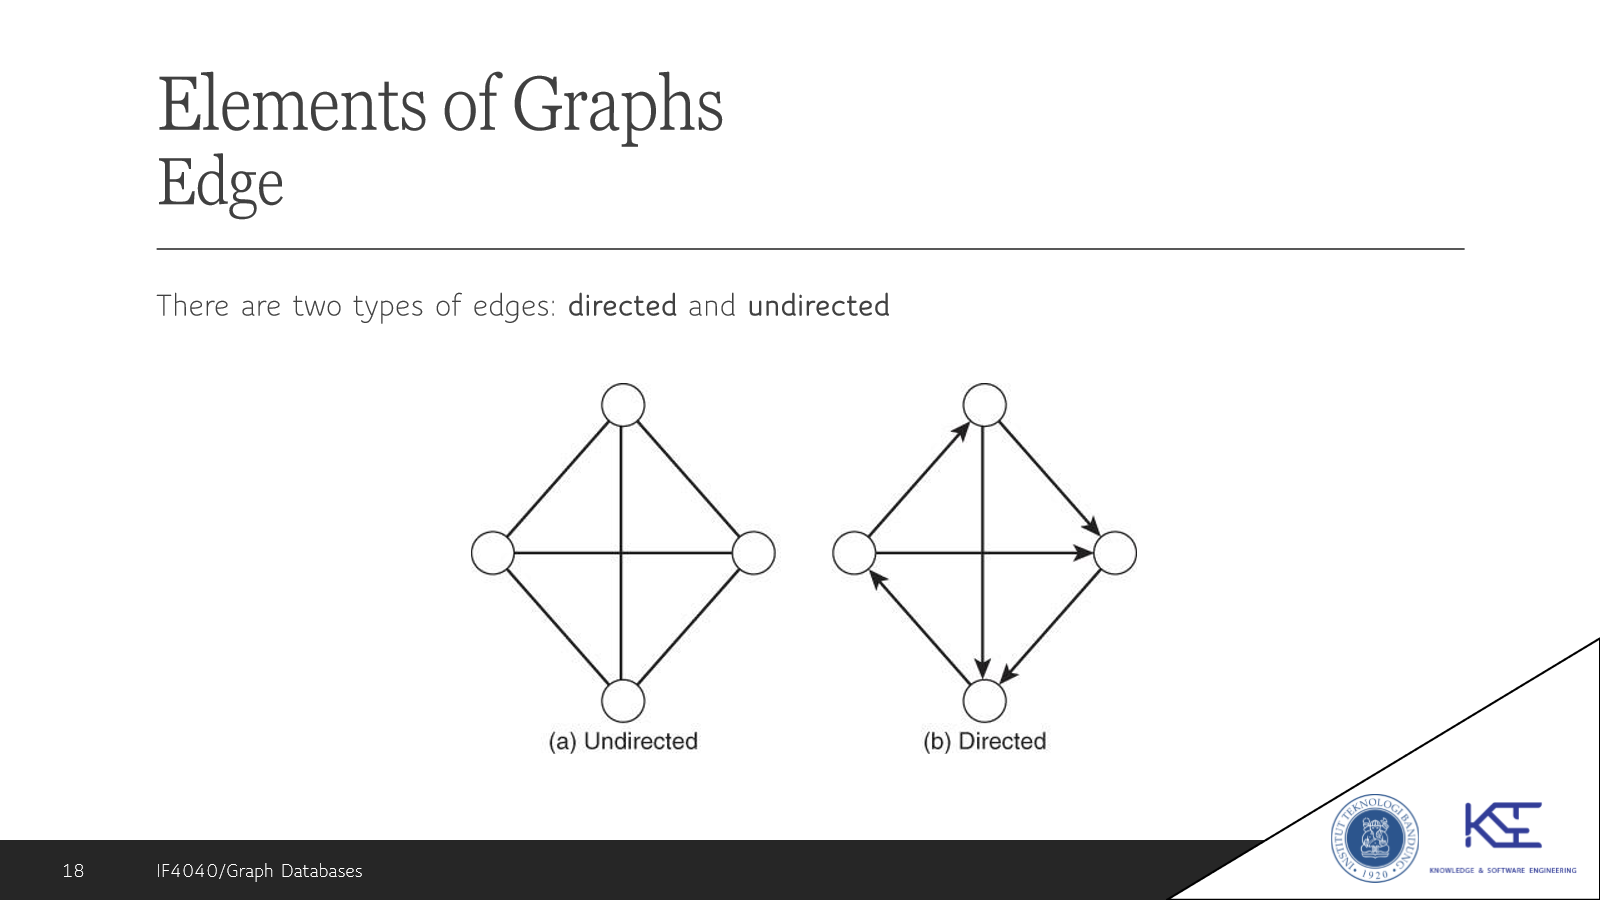
- Path: rangkaian vertex dan edge di antaranya. Loop: edge dari sebuah vertex ke dirinya sendiri.
- Operasi graf: union (gabungan vertex dan edge), intersection (vertex dan edge yang sama-sama dimiliki), graph traversal (mengunjungi seluruh vertex dengan cara tertentu).
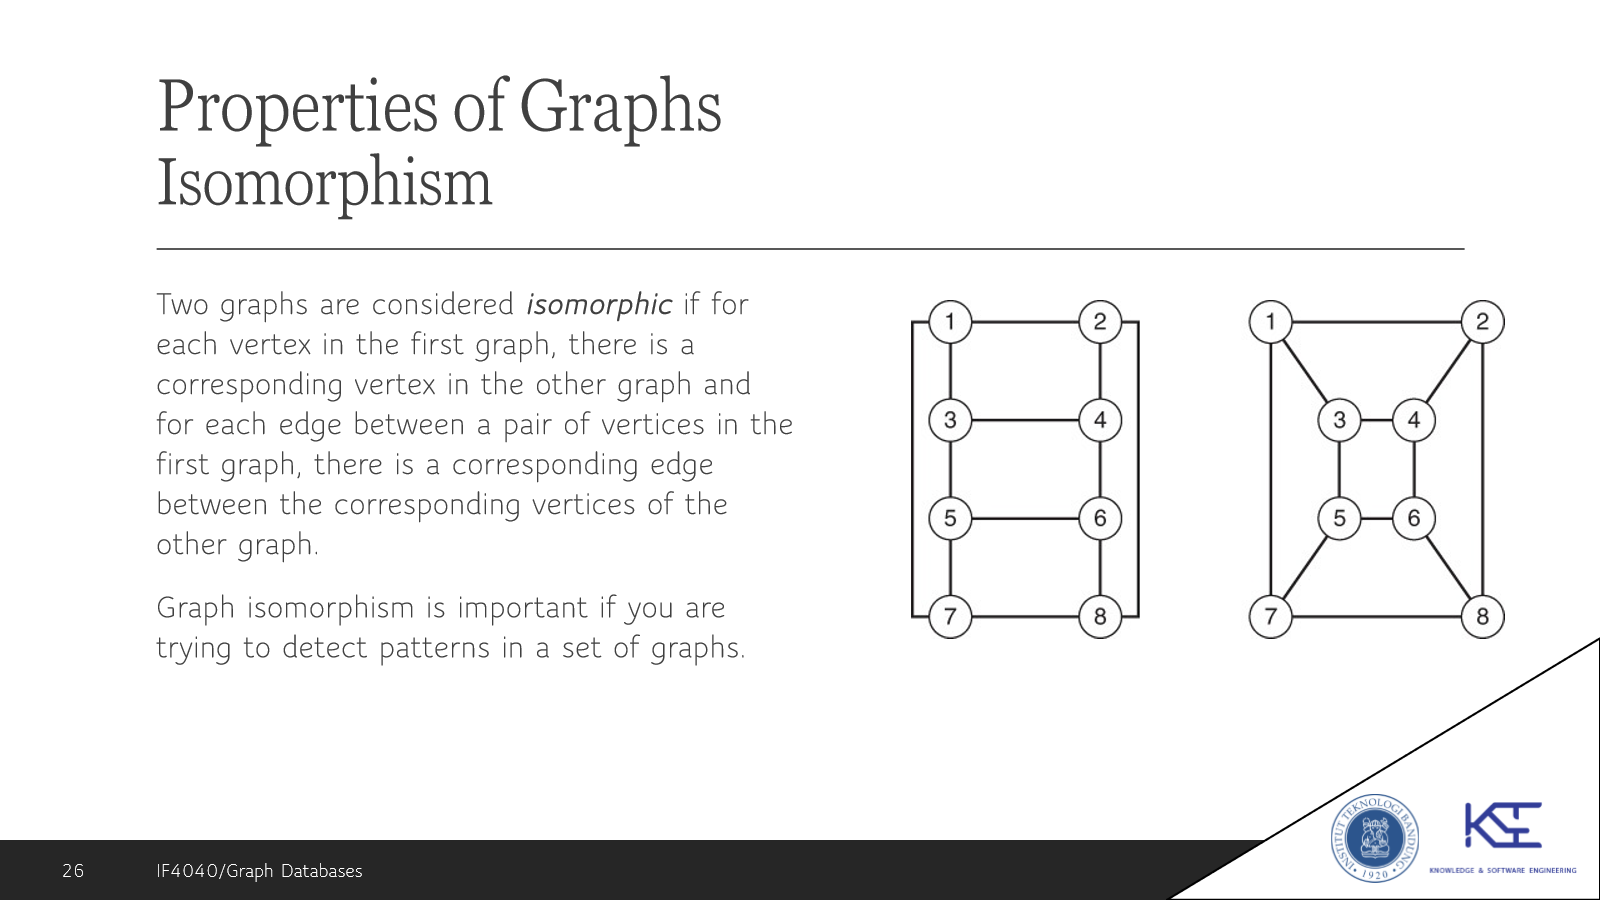
- Properti: Isomorphism (dua graph isomorphic bila tiap vertex dan edge punya korespondensi di graph lain; berguna mendeteksi pola), order (jumlah vertex) dan size (jumlah edge), degree (jumlah edge terhubung ke vertex), closeness (seberapa jauh vertex dari semua vertex lain; vertex dengan closeness tinggi menjangkau vertex lain lebih cepat), betweenness (seberapa besar vertex menjadi bottleneck).
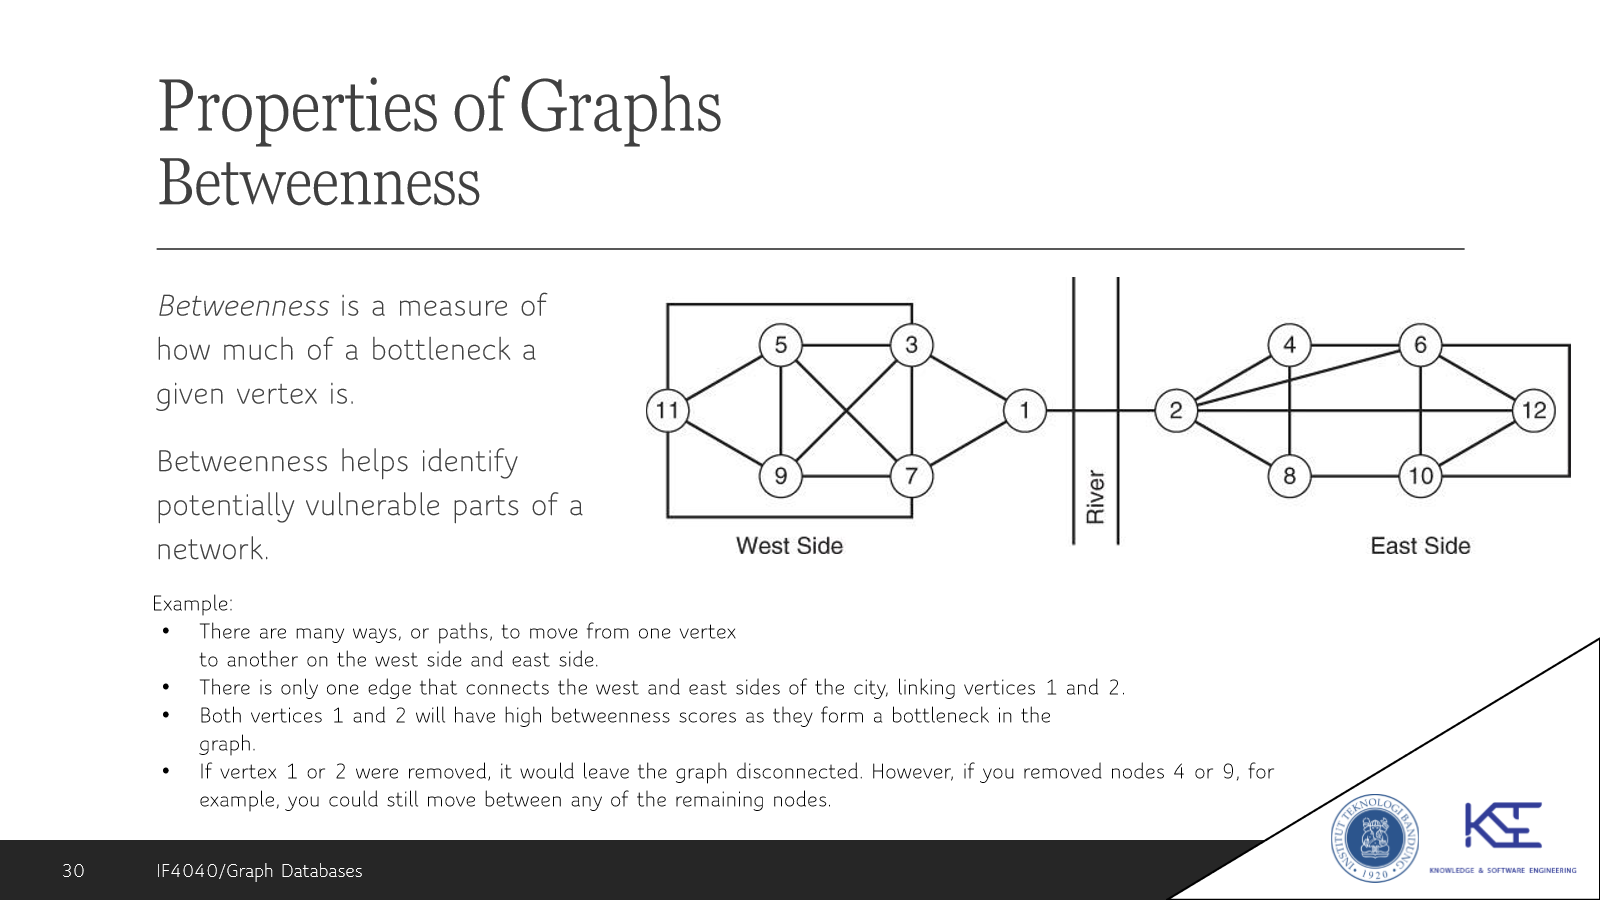
Contoh betweenness: banyak jalur di sisi barat dan timur kota, tetapi hanya satu edge menghubungkan keduanya (vertex 1 dan 2); keduanya punya betweenness tinggi karena bila salah satu dihapus graph terputus, sedangkan menghapus vertex 4 atau 9 tidak memutus koneksi. Centrality adalah istilah payung untuk degree, closeness, betweenness, dst (bukan rumus tunggal): degree centrality (koneksi langsung), closeness centrality (kedekatan ke semua vertex), betweenness centrality (peran penghubung/bottleneck).
- Tipe graf: undirected vs directed; flow network (transportation network): directed, tiap edge punya kapasitas, jumlah kapasitas edge masuk tidak boleh melebihi kapasitas edge keluar kecuali di source (hanya edge keluar) dan sink (hanya edge masuk); bipartite (dua himpunan vertex, tiap vertex hanya terhubung ke himpunan lain); multigraph (beberapa edge antar sepasang vertex yang sama); weighted graph (angka pada edge, umum untuk jalur terpendek). Dijkstra’s algorithm mencari jalur terpendek dengan growth rate sebanding jumlah vertex kuadrat:
| Number of Vertices | Time Units to Complete |
|---|---|
| 1 | 1 |
| 5 | 25 |
| 10 | 100 |
| 20 | 400 |
| 50 | 2.500 |
| 100 | 10.000 |
| 1.000 | 1.000.000 |
Mendesain graph database. Cocok untuk domain yang mudah dideskripsikan sebagai entitas dan relasi. Analisis umum: relasi antar dua entitas, properti umum edge suatu node, agregat properti edge suatu node, agregat properti node. Contoh jejaring sosial developer NoSQL: entitas Developer (nama, lokasi, NoSQL DB dipakai, tahun pengalaman, area minat) dan Post (tanggal, keyword topik, tipe, judul, isi); empat kombinasi entity-relation-entity (developer-developer, developer-post, post-developer, post-post).
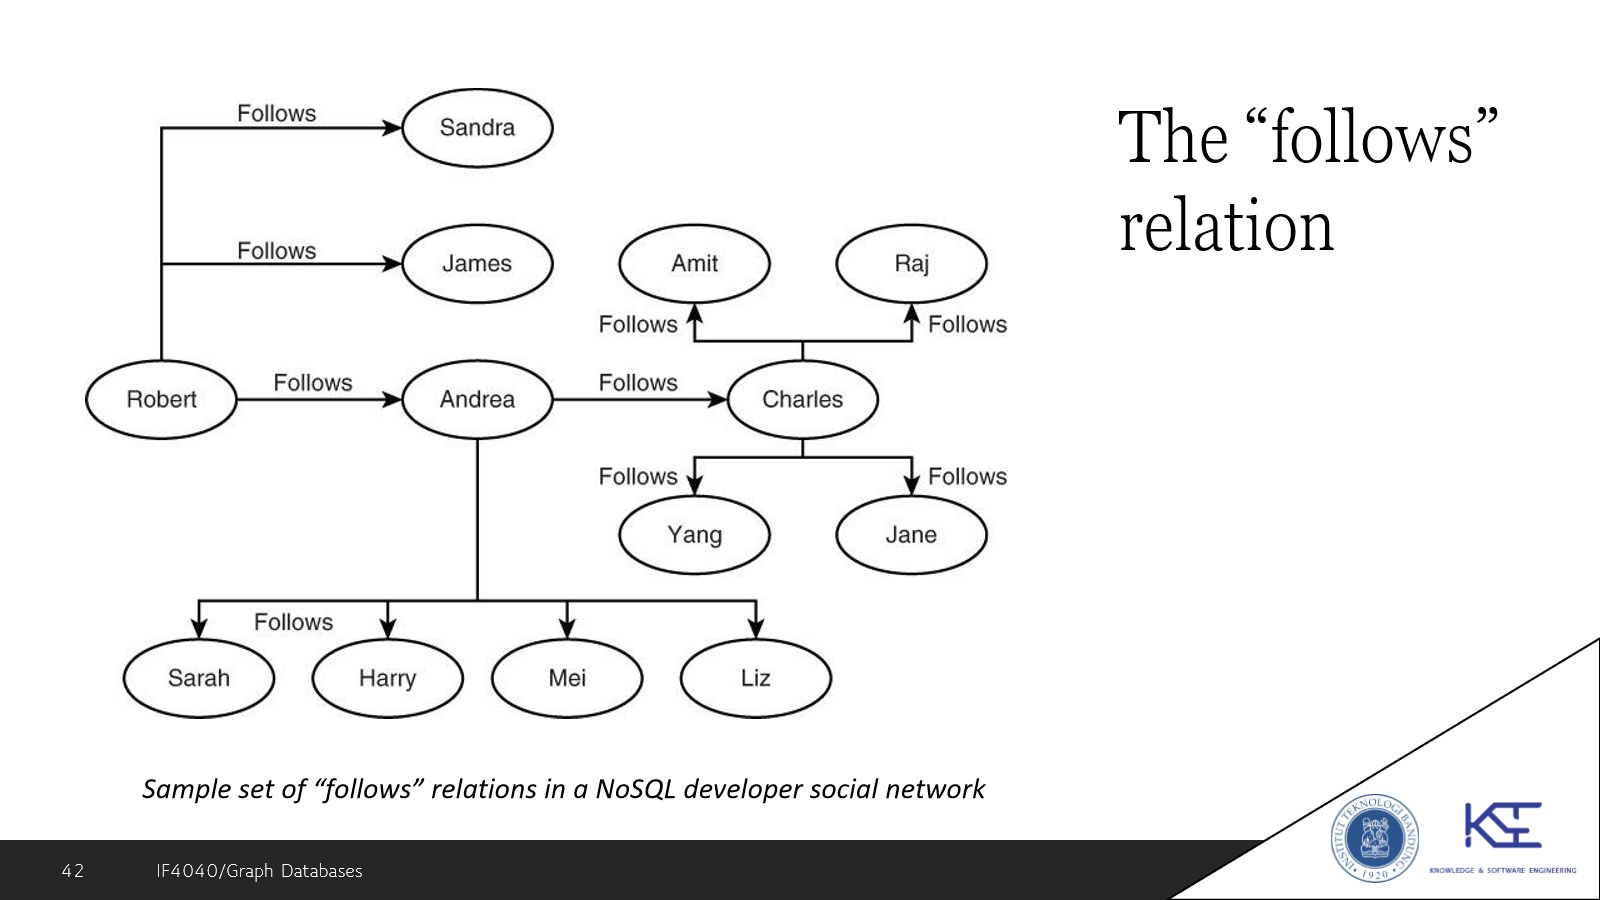
Relasi “created” dan “created by” yang saling berimplikasi cukup satu edge (bisa undirected). Queries drive design: mulai dari domain-specific query, petakan ke graph-specific query (vertex, edge, graph measure), contoh “berapa developer yang follow Andrea Wilson?” ↔ “berapa incoming edge menuju vertex A?“. Empat langkah: (1) identifikasi query, (2) entitas, (3) relasi antar entitas, (4) petakan query domain ke query graf abstrak.
Bahasa query:
- Cypher (Neo4j): deklaratif mirip SQL.
CREATE (robert:Developer { name: 'Robert Smith' }),CREATE (robert)-[FOLLOWS]->(andrea),MATCH (developer:DEVELOPER) RETURN (developer). MendukungWHERE,ORDER BY,LIMIT,UNION,COUNT,DISTINCT,SUM,AVG. - Gremlin (Apache TinkerPop): traversal, menelusuri graf dan menguji tiap vertex yang dikunjungi.
outE/inE/bothE(edge keluar/masuk/keduanya dari vertex),outV/inV/bothV(vertex dari edge); contohv = G.v(1)laluv.outE. Mendukung DFS dan BFS.
Tips dan jebakan: gunakan index (Neo4j CREATE INDEX, Cypher otomatis memakainya untuk WHERE dan IN); gunakan tipe edge yang tepat (undirected untuk simetris, directed untuk tidak simetris; edge dengan properti besar seperti BLOB butuh storage signifikan); waspadai cycle saat traversal (path yang kembali ke titik awal, mis. A-B-C-D-E-F-A); pertimbangkan skalabilitas: graph database masa kini menangani jutaan vertex dan edge dengan satu server; bila satu server tidak cukup (scale vertically), pertimbangkan database yang scale horizontally (mis. Titan) dan algoritma analisis yang dipakai.
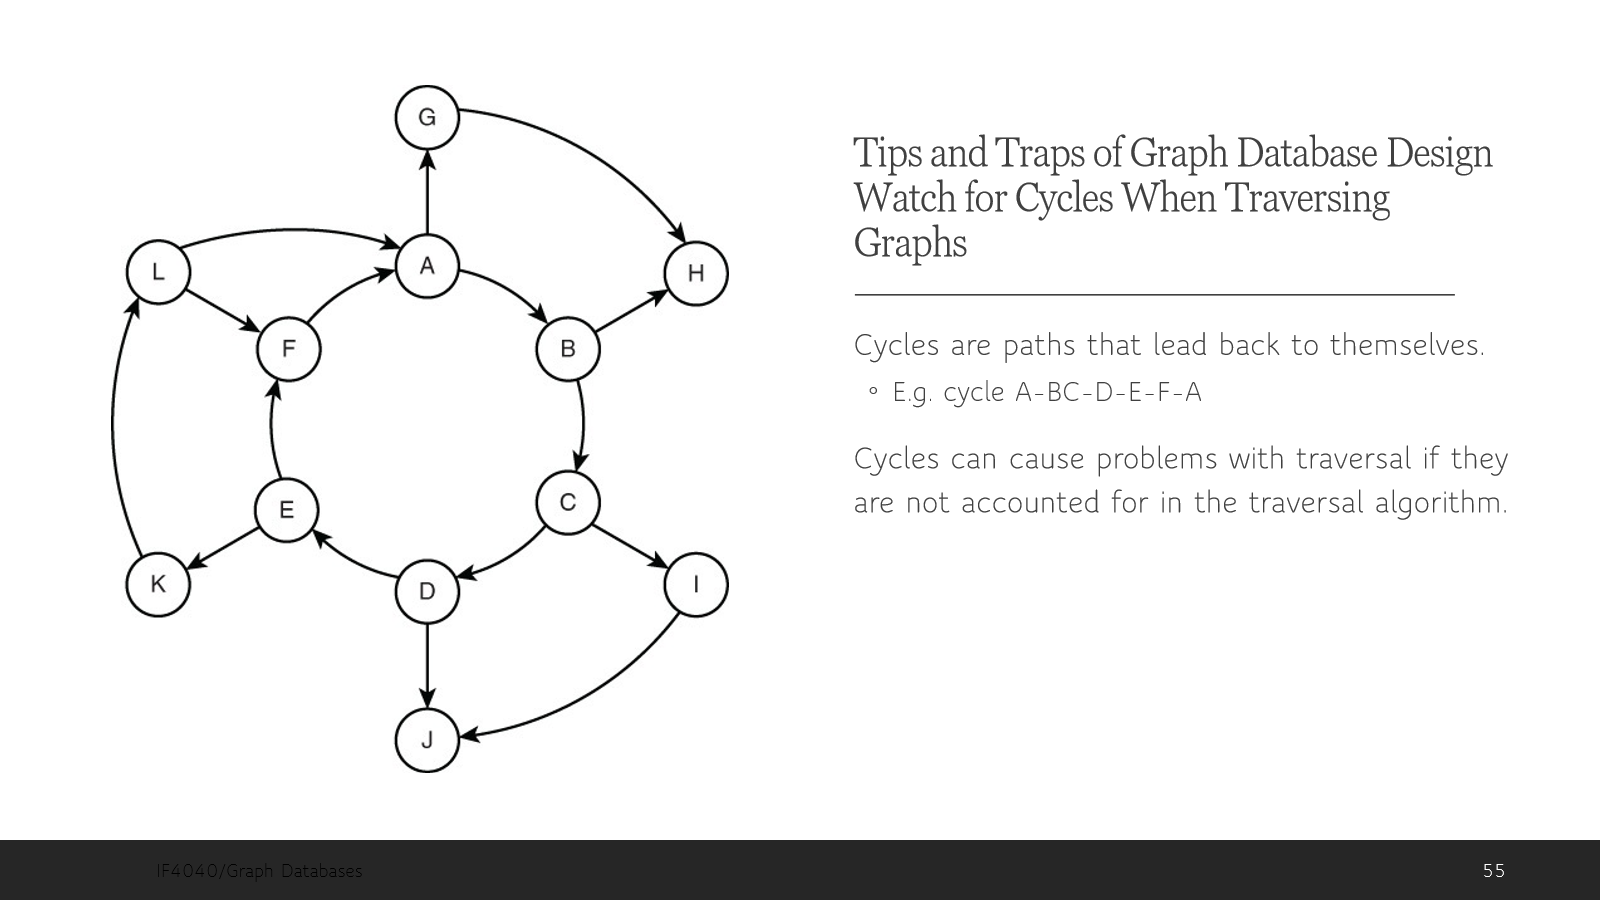
Studi kasus (Optimizing Transportation Routes, TGTS): klien mengirim parsel dari manufacturing site → distribution center → customer dengan dua metode: non-rush (manufacturing site → hub airport terdekat (drive) → distribution center terdekat tujuan (fly) → customer (drive); lebih murah) dan rush (regional airport terdekat → regional airport terdekat customer (fly); lebih mahal). Analis memakai Dijkstra untuk least-cost path, tetapi belum mengakomodasi batasan waktu. Solusi: edge diberi properti cost dan time, lalu algoritma kustom: (1) input fasilitas awal, akhir, dan waktu tersedia; (2) saat menelusuri vertex catat akumulasi cost dan time, buang jalur yang waktunya melebihi batas; (3) simpan sisa jalur dalam daftar terurut menurut cost, lanjutkan dari jalur termurah; (4) bila fasilitas terhubung adalah tujuan akhir, berhenti dan keluarkan least-cost path yang memenuhi waktu, bila tidak lanjut dari fasilitas terakhir. Pelajaran: algoritma mapan (Dijkstra) jadi fondasi, kadang perlu variasi untuk kebutuhan spesifik.
2.9 XML Database
Sumber: 20_XML_Database (memakai JSON dan dokumen di 2.6, tree di 2.2, relasional di 2.3)
XML (Extensible Markup Language): standar W3C, turunan SGML yang lebih sederhana; extensible (tidak seperti HTML, pengguna bisa menambah tag). Tag membuat data self-documenting. Motivasi: data interchange (banking, order antar-perusahaan, ChemML, BSML); format lama berbasis teks dengan header baris (tanpa nested, tanpa tipe standar). Dibanding relasional: tidak efisien (tag diulang, informasi skema berulang), tetapi lebih baik sebagai format pertukaran: self-documenting, tidak kaku, mendukung nested, diterima luas.
Struktur: tag (label), element (<tag>...</tag>), harus properly nested (setiap start tag punya end tag unik dalam konteks parent yang sama), dan setiap dokumen punya satu elemen top-level. Nesting berguna untuk transfer data (mis. item dalam itemlist pada purchase order), tidak dianjurkan di relasional (redundansi, diganti normalisasi/foreign key; nesting didukung object-relational). Mixed content sah tetapi tidak dianjurkan untuk data. Atribut: pasangan name=value di tag pembuka (nama atribut unik per elemen). Atribut vs subelemen: untuk dokumen, atribut adalah markup dan subelemen isi; untuk data, kabur; saran: atribut untuk identifier, subelemen untuk isi. Namespace: xmlns:prefix="URI" agar tag sama dari organisasi berbeda tidak bentrok (<yale:course>). Sintaks lain: elemen kosong <course ... />, CDATA <![CDATA[<course>...</course>]]> (tag diperlakukan string).
Skema. Dokumen XML tidak wajib punya skema, tetapi penting untuk pertukaran data. Dua mekanisme: DTD dan XML Schema.
DTD: membatasi struktur (elemen yang boleh, atribut, subelemen dan jumlah kemunculan), tidak membatasi tipe data (semua string). Sintaks <!ELEMENT element (subelements)> dan <!ATTLIST element (attributes)>. Subelemen: nama elemen, #PCDATA, EMPTY, ANY; ekspresi reguler | (alternatif), + (1 atau lebih), * (0 atau lebih). Contoh:
<!ELEMENT university ((department|course|instructor|teaches)+)>
<!ELEMENT department (dept_name, building, budget)>
<!ELEMENT dept_name (#PCDATA)>
<!ATTLIST course
  course_id   ID      #REQUIRED
  dept_name   IDREF   #REQUIRED
  instructors IDREFS  #IMPLIED >
Atribut: tipe CDATA, ID, IDREF, IDREFS; status #REQUIRED, default, atau #IMPLIED (opsional). ID/IDREF: satu elemen paling banyak satu atribut ID, nilainya unik se-dokumen (object identifier); IDREF berisi ID elemen lain; IDREFS himpunan ID. Keterbatasan DTD: tidak ada tipe untuk teks dan atribut; sulit menspesifikasikan himpunan subelemen tak berurutan ((A|B)* tidak memastikan masing-masing sekali); ID/IDREF tidak bertipe (atribut instructors pada course bisa merujuk course lain).
XML Schema: bahasa skema lebih canggih: tipe nilai (integer, string, min/max), tipe kompleks buatan pengguna, uniqueness dan foreign key constraint, inheritance; ditulis dalam sintaks XML (lebih standar tetapi verbose dan jauh lebih rumit), terintegrasi namespace. Contoh:
<xs:element name="department">
  <xs:complexType>
    <xs:sequence>
      <xs:element name="dept_name" type="xs:string"/>
      <xs:element name="budget" type="xs:decimal"/>
    </xs:sequence>
  </xs:complexType>
</xs:element>
<xs:key name="deptKey">
  <xs:selector xpath="/university/department"/>
  <xs:field xpath="dept_name"/>
</xs:key>
<xs:keyref name="courseDeptFKey" refer="deptKey">
  <xs:selector xpath="/university/course"/>
  <xs:field xpath="dept_name"/>
</xs:keyref>
Atribut dideklarasikan xs:attribute (use="required" untuk wajib); elemen berulang dengan minOccurs/maxOccurs; prefix xs: bebas dipilih.
| DTD | XML Schema | |
|---|---|---|
| Sintaks | Sendiri | Dalam XML |
| Tipe data | Tidak ada | Ada, plus batas min/max |
| Tipe kompleks buatan sendiri | Tidak | Ya |
| Key/foreign key | ID/IDREF tidak bertipe | xs:key/xs:keyref bertipe |
| Inheritance | Tidak | Ada |
| Namespace | Tidak terintegrasi | Terintegrasi |
| Kerumitan | Sederhana | Jauh lebih rumit dan panjang |
Query dan transformasi. Tree model: dokumen dimodelkan sebagai pohon, node untuk elemen dan atribut; teks jadi text node; anak berurutan sesuai dokumen; tiap node (kecuali root) punya satu parent. Bahasa: XPath, XSLT, XQuery.
XPath: path expression (step dipisah /, dievaluasi kiri ke kanan; / di awal = root). Contoh: /university-3/instructor/name; .../name/text() (tanpa tag); /university-3/course[credits >= 4]; /university-3/course[credits]; .../course[credits>=4]/@course_id (@ untuk atribut). IDREF tidak otomatis di-dereference. Fungsi: count() (mis. /university-2/instructor[count(./teaches/course) > 2]), posisi node, and/or/not(), id() (dereference IDREF/IDREFS, mis. /university-3/course/id(@dept_name)). | untuk union (tidak boleh bersarang di operator lain), // melompati banyak level (/university-3//name), .. parent, doc(name) root dokumen. (Catatan: penjelasan slide untuk [credits >= 4] masih memakai kata “account/balance 400” dari contoh lama; maksudnya sama.)
XSLT: XSL awalnya untuk menghasilkan HTML dari XML; XSLT adalah bahasa transformasi tujuan umum (XML ke XML atau HTML), dinyatakan sebagai template yang menggabungkan seleksi XPath dengan konstruksi hasil (xsl:template match, xsl:for-each select, xsl:value-of).
XQuery: bahasa query tujuan umum, turunan Quilt (meminjam SQL, XQL, XML-QL). Sintaks FLWOR: for ... let ... where ... order by ... return ....
| XQuery | Padanan SQL |
|---|---|
for | from |
where | where |
order by | order by |
return | select |
let | tidak ada (variabel sementara) |
for $x in /university-3/course
let $courseId := $x/@course_id
where $x/credits > 3
return <course_id> { $courseId } </course_id>
Item di return adalah teks XML kecuali diapit { }. Join: for $c in .../course, $i in .../instructor, $t in .../teaches where $c/course_id = $t/course_id and $t/IID = $i/IID return <course_instructor> { $c $i } </course_instructor>. Nested query mengubah struktur flat jadi nested ($d/* = semua anak). Grouping dan aggregation lewat nested query + fn:sum(...). Sorting order by (tambah descending), bisa di beberapa level nesting. Fungsi buatan declare function ... as element(course)* (tanda * = urutan nilai, tipe opsional). Kuantifikasi some $e in path satisfies P dan every $e in path satisfies P (tambah and fn:exists($e) agar kosong tidak otomatis memenuhi every). Mendukung if-then-else.
API: SAX (event handler untuk peristiwa parsing, misalnya awal/akhir elemen) dan DOM (di-parse jadi pohon, method seperti getParentNode(), getFirstChild(), getNextSibling(), getAttribute(), getElementsByTagName(), bisa memperbarui pohon).
Penyimpanan XML: di non-relational store (flat file: natural tetapi tanpa concurrency dan recovery; XML database khusus: mendukung DOM dan query deklaratif) atau relasional (translasi data, tetapi memakai DBMS yang matang dan overhead translasi).
| String Representation | Tree Representation | Map to Relations | |
|---|---|---|---|
| Cara | Tiap elemen top-level disimpan sebagai field string pada tuple | Relasi nodes(id, parent_id, type, label, value) (opsional position) | Satu relasi per tipe elemen yang skemanya diketahui: id, atribut elemen, parent_id |
| Perlu DTD/skema? | Tidak | Tidak | Ya |
| Kelebihan | Simpan XML apa pun, akses elemen cepat bila string kecil | Simpan XML apa pun | Tidak disebut di slide |
| Kekurangan | Parsing string lambat | Terlalu banyak baris (overhead ruang), query sederhana butuh banyak join | Tidak disebut di slide; skema harus diketahui |
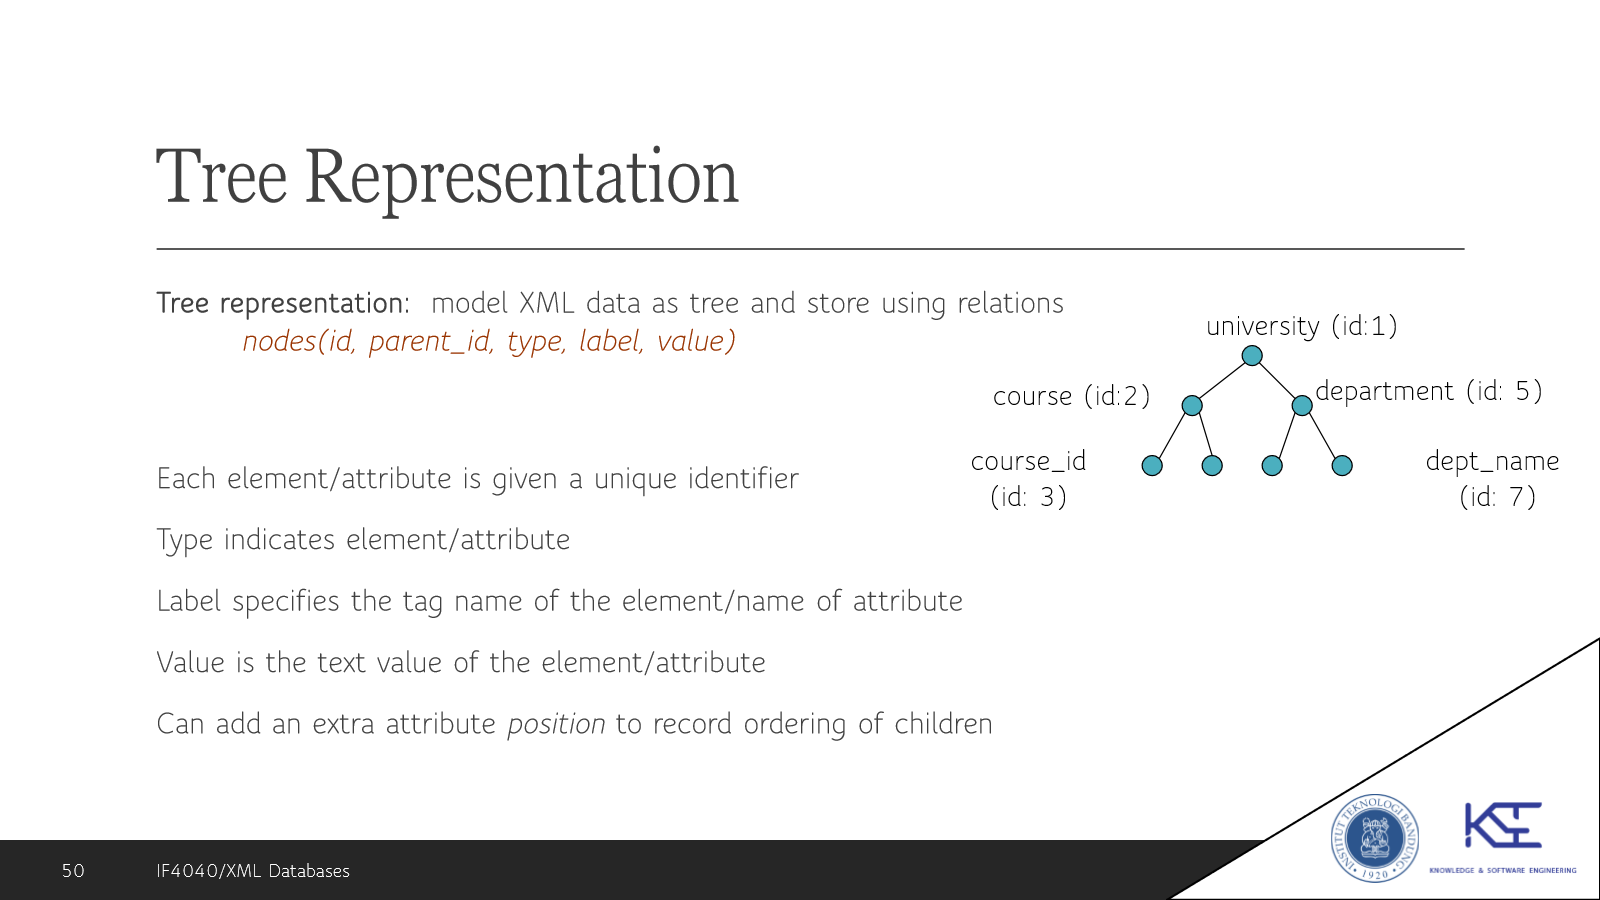
Pada string representation, nilai yang perlu diindeks disimpan sebagai kolom tambahan atau memakai function index. Pada map to relations: subelemen yang muncul sekali jadi atribut (subelemen kompleks menyimpan id-nya); subelemen berulang jadi tabel terpisah (seperti multivalued attribute pada ER-ke-tabel). Contoh department(id, dept_name, building, budget) dan course(parent_id, course_id, dept_name, title, credits). Publishing (relasional ke XML) dan shredding (XML ke tuple) didukung otomatis oleh XML-enabled database; banyak sistem punya tipe data xml native.
SQL/XML: ekstensi SQL untuk output XML bersarang (tiap tuple jadi elemen <row>): xmlelement (buat elemen), xmlattributes (atribut), xmlagg (forest dari hasil agregasi, sering dengan GROUP BY; contoh xmlelement(name "department", dept_name, xmlagg(xmlforest(course_id) order by course_id))).
Aplikasi: menyimpan dan menukar data kompleks (ODF untuk OpenOffice, OOXML untuk Microsoft Office, ChemML, MathML); standar pertukaran untuk Web services (SOAP: pemanggilan prosedur lintas aplikasi dengan XML sebagai input/output; WSDL: deskripsi Web service; UDDI: direktori Web service); data mediation (format bersama untuk menjembatani sistem).
XML database (dari Wikipedia). Sistem data persistence yang memungkinkan data dispesifikasikan dan kadang disimpan dalam XML; salah satu jenis document-oriented database (kategori NoSQL). Alasan: perusahaan sudah punya banyak XML berstandar; data perlu diekspos/diterima sebagai XML sehingga format lain memaksa double-modeling; XML cocok untuk data sparse, bersarang dalam, dan mixed content; bisa dibaca manusia; metadata sering XML; data semantic web tersedia sebagai RDF/XML; mengatasi object-relational impedance mismatch (ketidakcocokan model objek program dan tabel database). XML-enabled database (relasional): XML disimpan ke CLOB, di-shred ke tabel sesuai skema, atau ke native XML type (ISO 9075-14; IBM DB2 pureXML, Microsoft SQL Server, Oracle, PostgreSQL). Native XML database: dibuat khusus, memakai struktur data khusus yang dioptimalkan untuk penyimpanan dan query (BaseX, eXist, MarkLogic Server, Oracle Berkeley DB XML, Sedna, Qizx).
2.10 Studi Kasus Tugas Kelompok (Nimonspedia)
Sumber: 1_Project1_Basis_Data_Dokumen_dan_KeyValue (catatan tugas, bukan materi kuliah). Slide dosen meminta mempelajari “case study tugas masing-masing”, jadi bagian ini merangkum kasus tugasmu sebagai bahan latihan menerapkan 2.2 sampai 2.6. Isinya diambil dari catatan tugas apa adanya, termasuk keputusan yang di sana masih ditandai belum final.
Kasus: Nimonspedia, e-commerce yang berawal dari spesifikasi tugas besar IF3110 WBD (Milestone 1: user, store, product, cart, order; Milestone 2: auction/lelang, chat, push notification, feature flag). Project-0 membuat basis data relasional (15 tabel) dengan ERD. Project-1 meminta: implementasi sebagian atau seluruh kasus ke satu DBMS dokumen + satu DBMS key-value, menentukan bagian mana yang tepat memakai masing-masing, membuat model lojik dari ER (dengan konvensi), mengimplementasikan dengan data yang sama, menjalankan semua query (20 query dari project-0) dan membandingkan kinerja dengan relasional.
Pilihan DBMS: MongoDB (dokumen) dan Redis (key-value).
Desain dokumen (MongoDB), 12 collection: users, stores, categories, products, carts, orders, auctions, auction_bids, chat_rooms, chat_messages, push_subscriptions, feature_access.
- Memakai denormalisasi/snapshot (misalnya
store: {_id, name}di product dan order), hanya dengan field yang ada di spesifikasi. - Konkurensi tanpa distributed lock: conditional update (compare-and-set, misalnya
stock >= qty,status = X),$incdengan guard balance, dan Mongo transaction optimistic (retry saat conflict); butuh replica set. - Ada partial unique index untuk aturan “satu auction aktif per seller”.
Desain key-value (Redis): awalnya hanya cache/ephemeral state (session, presence, unread counter, hot bid cache, feature-flag cache, rate limit, dedup notifikasi), bukan source of truth. Masalahnya: bila Redis hanya cache, jawaban atas pertanyaan brief “bagian mana yang tepat key-value” menjadi 0% key-value. Karena itu minimal satu bagian harus authoritative di Redis; kandidatnya feature_access (point lookup per user_id + feature, tanpa query kompleks), dan carts juga secara alami cocok key-value. Implementasi saat ini: key feature:{feature}:{user_id} sebagai Redis hash {is_enabled, reason, updated_at}, ditambahkan di samping data di Mongo (jadi masih duplikat); belum diputuskan final apakah feature_access dicabut dari Mongo. Redis memakai AOF (--appendonly yes) agar data bertahan setelah restart, dan kebijakan volatile-lru hanya membuang key yang punya TTL.
Hasil sejauh ini: repo punya project0/ (relasional) dan project1/ (bootstrap Mongo untuk 12 collection beserta index, seed generator dengan formula sama seperti seed.py, dan 20 query MQL; satu query membaca dari Redis, yaitu unread messages di user:{uid}:unread). Smoke test berhasil: jumlah dokumen sesuai target (mis. products 550 ribu, orders 550 ribu, chat_messages 1,1 juta, feature_access 330 ribu) dan DBSIZE Redis = 330.000.
Cara memakai kasus ini untuk latihan UTS:
- Soal bergaya sample UTS (2.2 ke 2.6): ER ke relasional, lalu ke dokumen (embedding vs referencing, 2.6) dan ke key-value (2.5, pola TTL dan aggregate).
- Alasan memilih model: query mendorong desain; key-value untuk point lookup, dokumen untuk entitas dengan atribut terkait dan relasi dalam satu objek; kolom dan graf untuk skala tulis dan relasi (2.7, 2.8).
- Perbandingan kinerja relasional vs NoSQL: join di relasional vs embed di dokumen (2.6), trade-off denormalisasi (redundansi vs lebih sedikit lookup).
3. Sengaja Tidak Dicakup (Rinci di Note Sumber)
| Yang dilewati | Ada di |
|---|---|
Contoh SQL lengkap (create table section, contoh delete/update/insert lain, with clause lebih panjang) | 14_Relational_Data_Model |
Contoh JSON/XML lengkap dokumen customer dan seluruh contoh perintah MongoDB insert/remove/update/find | 17_Document_Database |
Pseudo-code fungsi getCustAttr/setCustAttr dan seluruh contoh entry TrackerNS | 16_Key_Value_Database |
University DTD dan XML Schema lengkap, contoh kode XQuery (join, nested, grouping, sorting, fungsi), contoh XSLT CD catalog, serta contoh data university-3 | 20_XML_Database |
| Pseudo-code Cypher dan Gremlin lengkap | 19_Graph_Database |
| Diagram Mermaid (hierarki specialization, aggregation, ring, Cassandra peer-to-peer) | 13_ER_Modeling, 16_Key_Value_Database, 18_Column_Family_Database |
| Flashcard asli tiap note (tetap di note sumber supaya kartu plugin tidak dobel) | masing-masing note 12-20 |
4. Peta Pembahasan
| Note sumber | Topik | Bagian di file ini |
|---|---|---|
| 12 | Info mata kuliah, CPMK, kebijakan Gen-AI | 0, 2.1 |
| 13 | Desain database, ER, weak entity, extended ER, isu desain | 2.2 |
| 14 | Model relasional, reduksi ER, SQL | 2.3 |
| 15 | Keterbatasan relasional, karakteristik NoSQL, column store, graph, tipe lain | 2.4 |
| 16 | Key-value: istilah, arsitektur, key design, pattern, studi kasus TGTS Tracker | 2.5 |
| 17 | Dokumen, embedding vs referencing, partitioning, studi kasus Customer Manifest | 2.6 |
| 18 | BigTable, komponen, 7 guideline, indexing, HBase vs Cassandra, studi kasus | 2.7 |
| 19 | Graph, properti, Cypher dan Gremlin, desain, studi kasus rute | 2.8 |
| 20 | XML, DTD, XML Schema, XPath, XQuery, penyimpanan, SQL/XML, XML database | 2.9 |
| Tugas Project-1 | Kasus Nimonspedia: Mongo + Redis | 2.10 |