Teknik Menentukan Sifat Independensi Sample
Asumsi penting dalam teknik statistik: variabel random yang diamati independen dari suatu distribusi. Jika asumsi ini tidak berlaku (sample yang dikumpulkan dari waktu ke waktu biasanya dependen/berkorelasi), analisis statistik bisa tidak valid.
Untuk memeriksa independensi, bisa digunakan plot langsung dari pengamatan:
- Plot korelasi terhadap lag — bila data independen, plot akan terletak di sekitar sumbu-x (korelasi tidak jauh dari nol).
- Plot penyebaran vs — bila data independen, titik-titik tersebar random di kuadran (tidak membentuk pola/tren).
Hipotesis Kelompok Distribusi
Langkah pertama menentukan distribusi: tentukan kelompok distribusi (eksponensial, normal, Poisson, dst) tanpa dulu memeriksa nilai parameternya — bisa ditebak dari sifat data. Contoh: nasabah datang satu per satu dengan laju konstan dan antar-selang waktu saling independen → diduga distribusi Eksponensial. Waktu layanan tidak mungkin berdistribusi Normal murni (karena Normal punya nilai negatif, sedangkan waktu selalu positif).
Statistik sampel yang bisa membantu menebak kelompok distribusi:
- Maksimum, minimum:
- Mean:
- Median: (ganjil) atau (genap)
- Variansi:
- Koefisien variansi:
- Lexis ratio: (untuk data diskrit)
- Skewness — memeriksa sifat simetri data (mis. distribusi Normal bernilai 0)
Estimasi Parameter (MLE)
Setelah kelompok distribusi ditentukan, langkah berikutnya menaksir parameter distribusi tersebut. Teknik umum: MLE (maximum-likelihood estimator). Fungsi likelihood (untuk data independen):
Contoh — distribusi eksponensial (, ):
Untuk menyederhanakan, maksimalkan log-likelihood . Turunkan terhadap dan samakan dengan nol:
Jadi taksiran MLE parameter distribusi eksponensial adalah rata-rata sampel.
Uji Kecocokan Distribusi (Goodness-of-Fit)
Uji goodness-of-fit adalah uji hipotesis statistik untuk menentukan apakah data pengamatan adalah sample independen dari distribusi tertentu dengan fungsi distribusi . Hipotesis nul:
: adalah random variable IID dengan fungsi distribusi .
Uji Chi-Square
Distribusi yang dicocokkan dibagi menjadi selang (bisa atau ). Hitung = jumlah dalam selang ke- (dengan ), dan proporsi harapan dari selang ke- (integral densitas untuk kasus kontinu, atau jumlah untuk kasus diskrit). Statistik uji:
ditolak bila (subskrip adalah derajat bebas/degrees of freedom — banyaknya nilai yang masih bisa bervariasi bebas setelah dikenai kendala ; makin banyak selang , makin besar derajat bebasnya). Uji ini berlaku bila semua parameter distribusi diketahui. Ketentuan Yarnold (1970) untuk membagi selang: dan untuk semua .
Contoh: uji Chi-Square dengan data waktu antar kedatangan terhadap . Dibentuk selang dengan , sehingga (memenuhi syarat). Karena punya balikan, batas selang . Diperoleh , sedangkan — sehingga tidak ditolak pada .
Uji Kolmogorov-Smirnov (K-S)
Membandingkan distribusi empirik dengan distribusi hipotesis , tanpa perlu mengelompokkan data seperti Chi-Square (namun pemakaiannya tidak seluas Chi-Square). Fungsi distribusi empirik:
adalah fungsi tangga (step) kontinu-kanan, dengan . Statistik uji mencari jarak terjauh antara dan :
dimana dan .
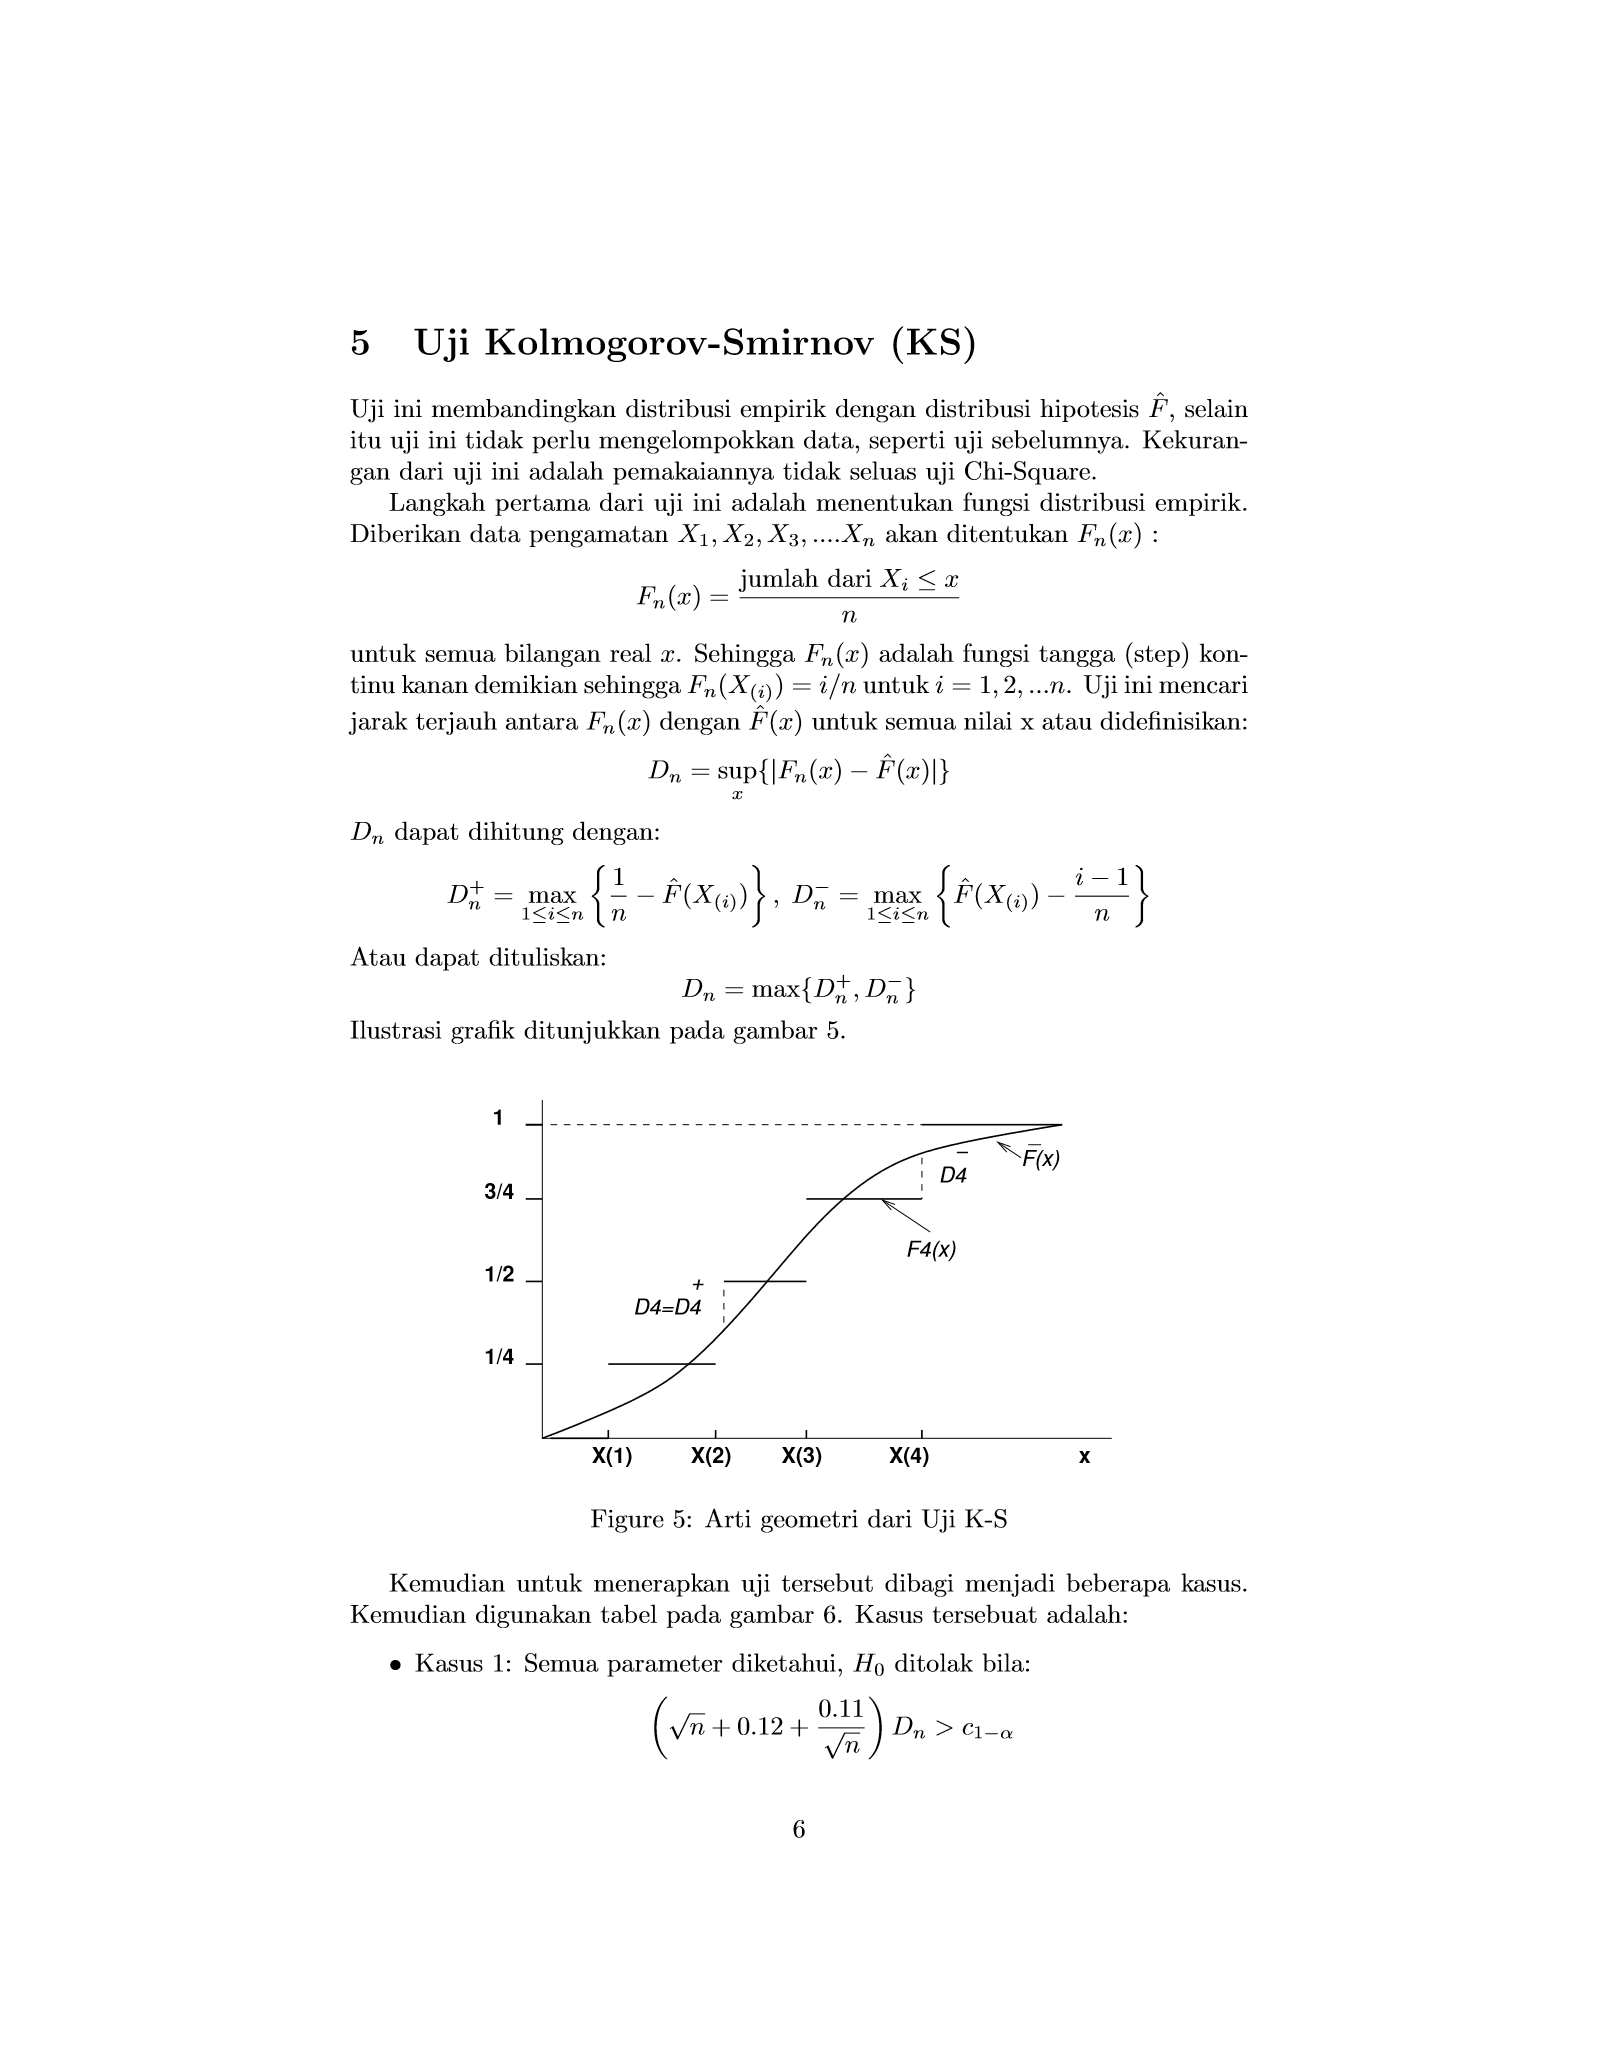
Diagram di atas menunjukkan makna geometris : jarak vertikal terbesar antara fungsi tangga (distribusi empirik) dan kurva (distribusi hipotesis yang diuji).
Tiga kasus penerapan uji K-S, masing-masing dengan statistik uji yang disesuaikan ( ditolak bila melebihi nilai kritis — ambang batas yang diambil dari tabel distribusi statistik uji ini di bawah , pada tingkat signifikansi yang dipilih):
| Kasus | Statistik uji (disesuaikan) |
|---|---|
| Semua parameter diketahui | |
| Normal , parameter tak diketahui (ditaksir dari data) | |
| Eksponensial , parameter tak diketahui (taksiran MLE) |
Nilai kritis dkk. dilihat dari tabel yang sudah disesuaikan (mis. untuk : kasus “semua parameter diketahui” ; kasus Normal ; kasus eksponensial ).
Sumber
- Materi kuliah IF4021 Model dan Simulasi, minggu 7 (JS/2021), berbasis Law & Kelton, Simulation Modeling and Analysis, Tabel 6.14.
Flashcard
flashcards Bagaimana cara memeriksa independensi sample X_1, X_2, … menggunakan plot? :: Dengan plot korelasi terhadap lag j (data independen → titik di sekitar sumbu-x, korelasi mendekati nol) atau plot penyebaran X_i vs X_{i+1} (data independen → titik tersebar random tanpa pola/tren). Sebutkan tiga statistik sampel yang membantu menebak kelompok distribusi data, selain mean dan variansi :: Lexis ratio (S²(n)/X̄(n), untuk data diskrit), koefisien variansi (√S²(n)/X̄(n)), dan skewness (memeriksa simetri data — distribusi normal bernilai 0). Jawaban lain valid: maksimum/minimum, median. Apa hasil taksiran MLE untuk parameter β distribusi eksponensial, dan bagaimana cara memperolehnya? :: β = X̄(n) (rata-rata sampel) — diperoleh dengan memaksimalkan log-likelihood l(β) = -n ln β - (1/β)ΣX_i, yaitu menurunkan terhadap β dan menyamakan dengan nol. Apa hipotesis nul (H0) yang diuji pada uji goodness-of-fit? :: X_i adalah random variable IID (independen, identik terdistribusi) dengan fungsi distribusi F̂ tertentu. Apa syarat Yarnold (1970) untuk membagi selang pada uji Chi-Square, dan kapan H0 ditolak? :: Syarat: k ≥ 3 selang dan np_j ≥ 5 untuk semua j. H0 ditolak bila statistik χ² = Σ(N_j - np_j)²/(np_j) melebihi nilai kritis χ²_{k-1,1-α}. Apa keunggulan dan kekurangan uji Kolmogorov-Smirnov dibanding uji Chi-Square? :: Keunggulan: tidak perlu mengelompokkan data ke dalam selang seperti Chi-Square. Kekurangan: pemakaiannya tidak seluas Chi-Square (lebih terbatas kasus penerapannya). Mengapa statistik uji Kolmogorov-Smirnov perlu “disesuaikan” berbeda-beda tergantung tiga kasus (parameter diketahui, Normal ditaksir, eksponensial ditaksir)? :: Karena ketika parameter distribusi ditaksir dari data yang sama yang diuji (bukan diketahui sebelumnya), nilai kritis dan bentuk statistik uji standar tidak lagi berlaku secara langsung — perlu faktor koreksi berbeda untuk tiap kasus distribusi & status parameternya.