Catatan: slide minggu ini (W10) mengulang isi slide Metadata dari minggu sebelumnya (lihat 10_DataOps_Metadata) sebelum masuk ke materi baru: Data Integration and Interoperability. Ringkasan Metadata tidak diulang di sini agar tidak duplikat — fokus catatan ini pada materi barunya.
Definisi Data Integration and Interoperability (DII)
DII menggambarkan proses-proses yang berkaitan dengan pergerakan dan konsolidasi data di dalam dan antar data store, aplikasi, dan organisasi.
Tasks dalam DII
- Data Migration
- Data Conversion
- Data Sharing
- Archiving Data
- Obtain and ingesting data (memperoleh dan menyerap data)
- Integrating structured and unstructured data
Extract, Transform, Load (ETL)
Tipe ETL
- Batch — diproses secara berkala/berkelompok.
- Event Driven or Realtime — diproses saat event terjadi/secara real-time.
Tiga Tahap ETL
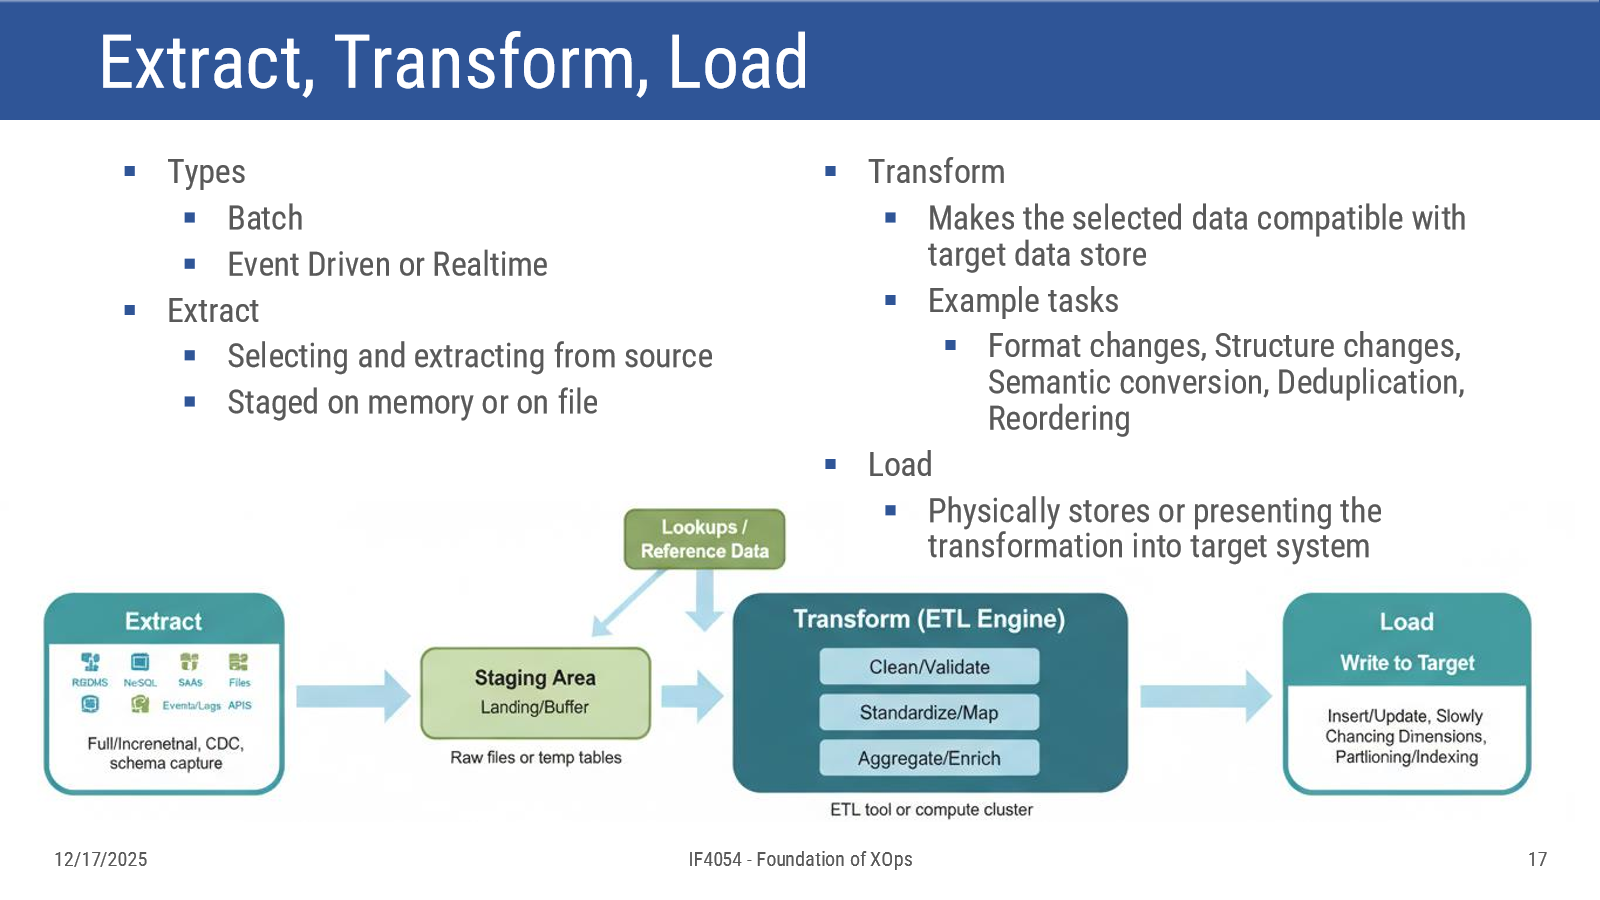
- Extract — memilih dan mengekstrak data dari sumber; data di-stage di memori atau file.
- Transform — membuat data yang dipilih menjadi kompatibel dengan target data store. Contoh task: format changes, structure changes, semantic conversion, deduplication, reordering.
- Load — secara fisik menyimpan atau menyajikan hasil transformasi ke sistem target.
Alur lengkap ETL: Extract (dari RDBMS, NoSQL, SaaS, Files, Events/Logs, APIs — full/incremental, CDC, schema capture) → Staging Area (Landing/Buffer — raw files atau temp table) → Transform (ETL Engine): Clean/Validate → Standardize/Map → Aggregate/Enrich (dengan Lookups/Reference Data sebagai input tambahan) → Load (Write to Target: Insert/Update, Slowly Changing Dimensions, Partitioning/Indexing).
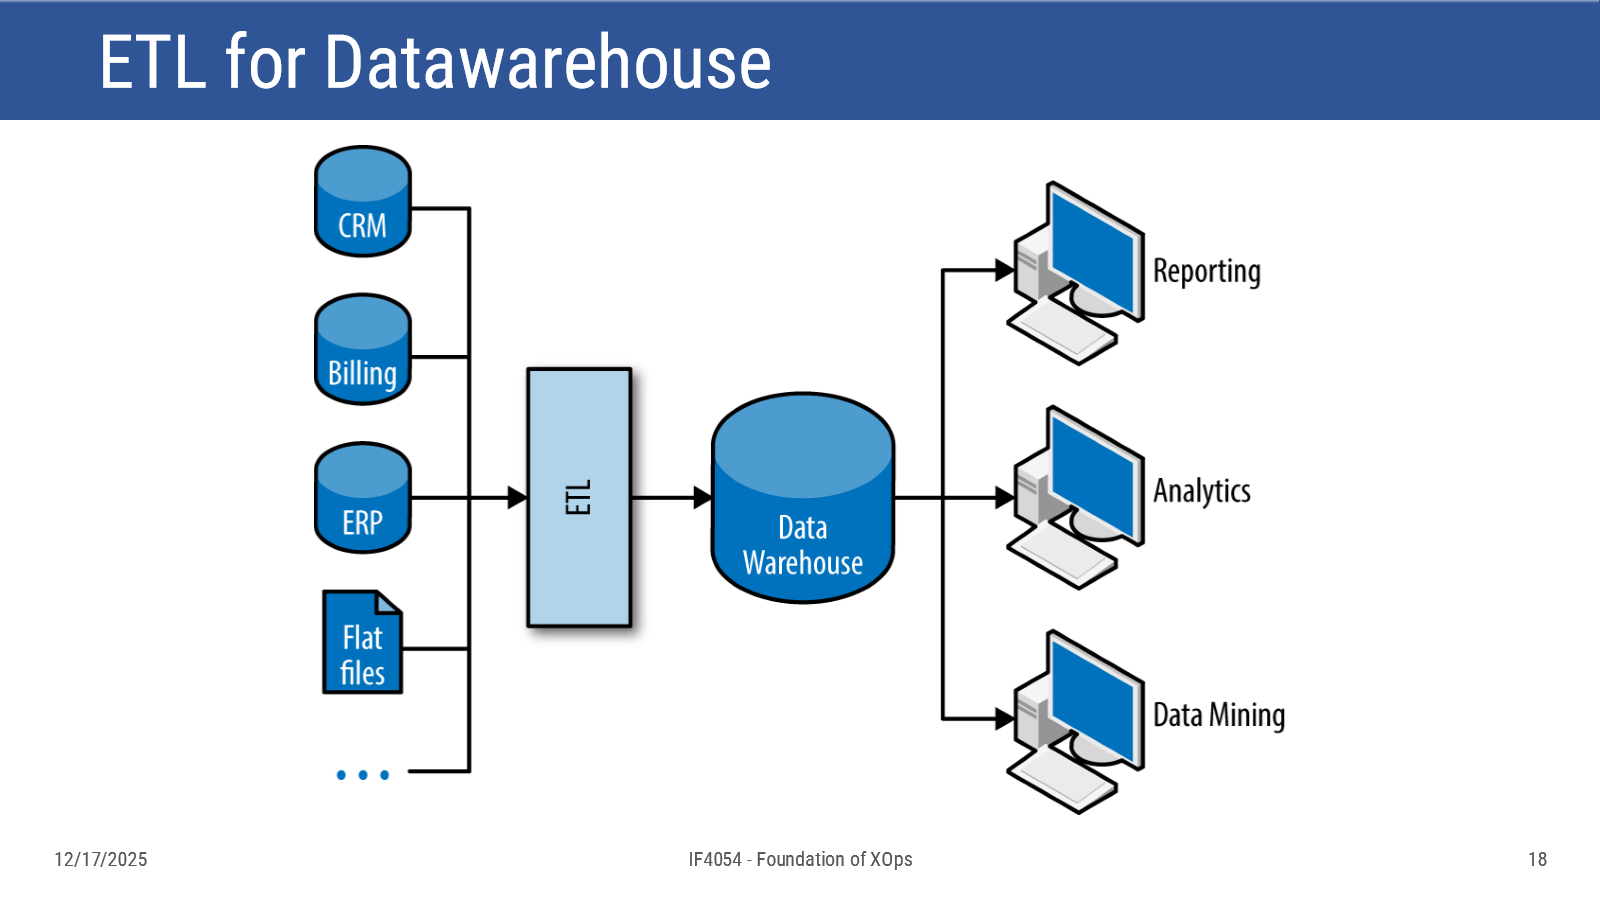
Contoh Penerapan: ETL untuk Data Warehouse
Sumber data (CRM, Billing, ERP, Flat files, dst.) → ETL → Data Warehouse → dikonsumsi oleh Reporting, Analytics, dan Data Mining.
Extract, Load, Transform (ELT)
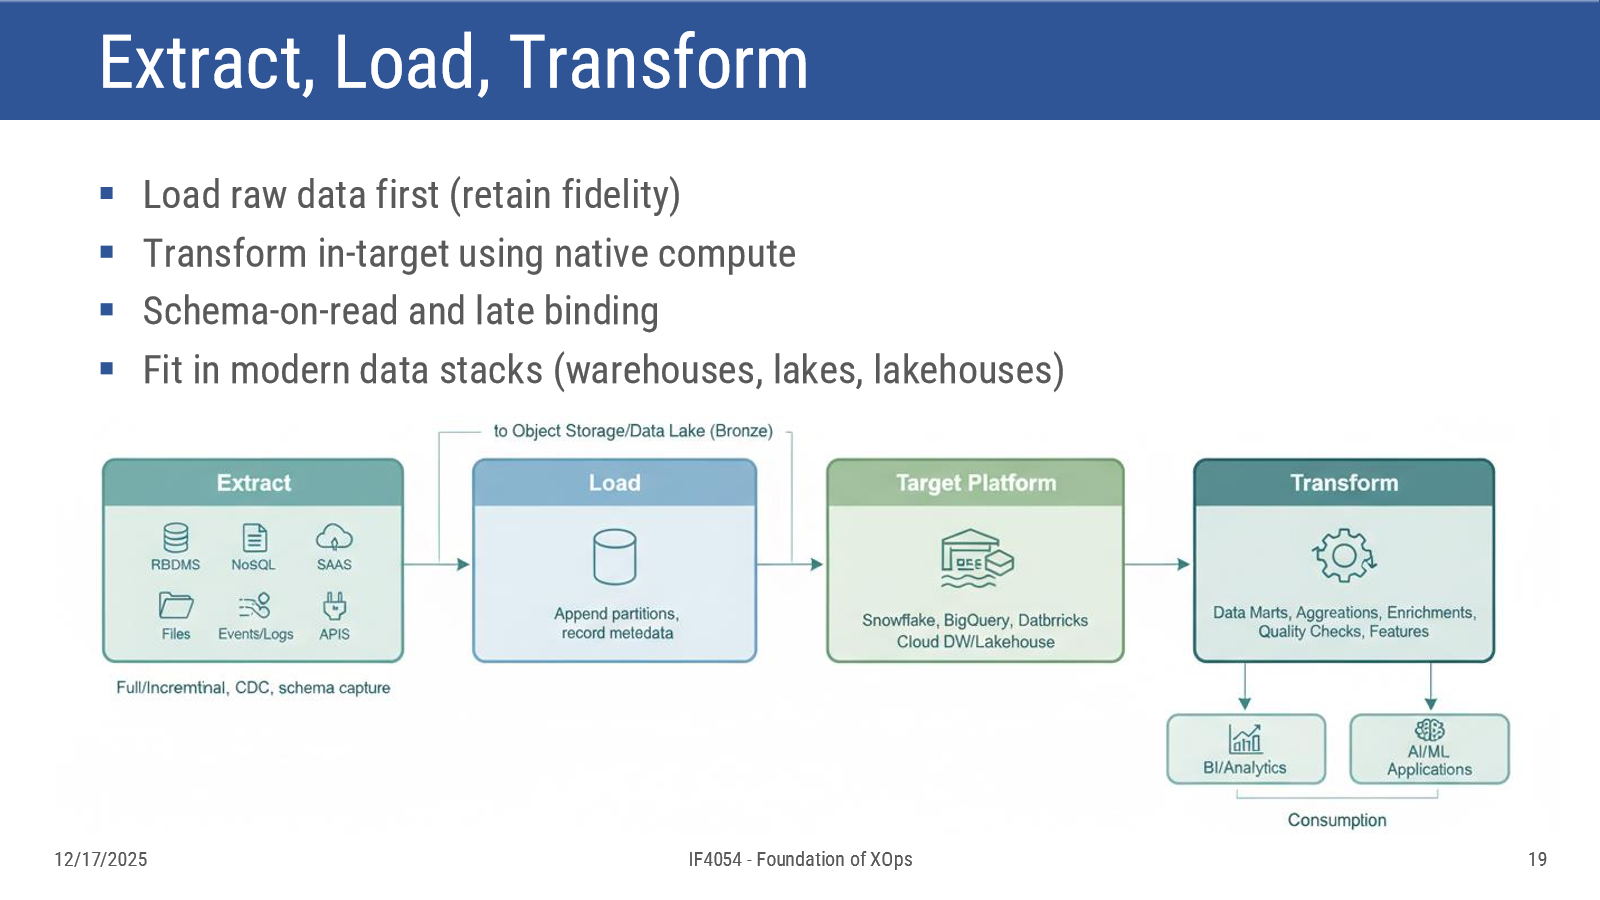
Pendekatan alternatif dari ETL, dengan prinsip:
- Load raw data first (memuat data mentah terlebih dahulu, mempertahankan fidelitas/keutuhan data asli).
- Transform in-target menggunakan native compute dari sistem target itu sendiri.
- Menerapkan schema-on-read dan late binding (skema baru ditentukan saat data dibaca, bukan saat ditulis).
- Cocok (fit) dengan modern data stack: data warehouse, data lake, lakehouse.
Alur ELT: Extract (RDBMS, NoSQL, SaaS, Files, Events/Logs, APIs) → Load ke Object Storage/Data Lake (Bronze layer — append partitions, record metadata) → Target Platform (Snowflake, BigQuery, Databricks, Cloud DW/Lakehouse) → Transform (Data Marts, Aggregations, Enrichments, Quality Checks, Features) → dikonsumsi oleh BI/Analytics dan AI/ML Applications.
Perbandingan ETL vs ELT
| Kategori | ETL (Extract, Transform, Load) | ELT (Extract, Load, Transform) |
|---|---|---|
| Definisi | Mengekstrak data mentah, mentransformasinya di server sekunder, baru dimuat ke destination | Mengekstrak data mentah, langsung memuatnya ke destination, baru ditransformasi di sana |
| Kecepatan Proses | Lebih lambat; transformasi terjadi sebelum loading | Lebih cepat; data dimuat dulu dan ditransformasi secara paralel |
| Volume Data | Terbaik untuk dataset kecil-menengah yang kompleks (misal data marketing) | Cocok untuk dataset besar yang butuh kecepatan (misal real-time analytics) |
| Output Data | Terutama data terstruktur | Data terstruktur, semi-terstruktur, dan tak terstruktur |
| Kompatibilitas Data Lake | Tidak kompatibel dengan data lake | Sepenuhnya kompatibel dengan data lake |
| Maturity | Sudah mapan, dipakai 20+ tahun, dokumentasi ekstensif | Pendekatan lebih baru, tools dan dokumentasi lebih sedikit |
| Efisiensi Biaya | Biaya lebih tinggi (butuh server dan infrastruktur pemrosesan terpisah) | Lebih hemat biaya, memanfaatkan skalabilitas cloud |
| Keamanan | Butuh solusi keamanan custom untuk melindungi data sensitif | Fitur keamanan bawaan seperti access control dan multifactor authentication |
| Lokasi Transformasi | Data ditransformasi di server sekunder sebelum loading | Data dimuat apa adanya dan ditransformasi di dalam sistem target |
| Fleksibilitas | Terbaik untuk transformasi data terstruktur | Menangani data terstruktur maupun tak terstruktur dengan mudah |
Flashcard
flashcards Apa definisi Data Integration and Interoperability (DII)? :: Proses-proses yang berkaitan dengan pergerakan dan konsolidasi data di dalam dan antar data store, aplikasi, dan organisasi. Sebutkan 3 tahap utama dalam ETL beserta fungsinya masing-masing. :: Extract (memilih dan mengekstrak data dari sumber), Transform (membuat data kompatibel dengan target melalui format/structure change, semantic conversion, deduplication, reordering), Load (menyimpan hasil transformasi ke sistem target). Apa perbedaan mendasar antara ETL dan ELT dari segi urutan proses? :: ETL mentransformasi data di server sekunder sebelum dimuat ke destination; ELT memuat data mentah langsung ke destination lebih dulu, baru mentransformasinya di dalam sistem target itu sendiri (in-target, menggunakan native compute). Mengapa ELT lebih cocok untuk data lake dan modern data stack dibanding ETL? :: Karena ELT menerapkan schema-on-read dan late binding (skema ditentukan saat data dibaca, bukan ditulis) serta memuat raw data apa adanya, mempertahankan fidelitas data, sehingga cocok dengan data lake/lakehouse yang menampung data mentah dalam berbagai format (structured, semi-structured, unstructured). Sebutkan 2 tipe ETL berdasarkan cara pemrosesannya. :: Batch (diproses berkala/berkelompok) dan Event Driven/Realtime (diproses saat event terjadi). Sebutkan minimal 4 dari 6 tasks dalam Data Integration and Interoperability. :: Data Migration, Data Conversion, Data Sharing, Archiving Data, Obtain and ingesting data, Integrating structured and unstructured data. Dalam perbandingan ETL vs ELT, mana yang lebih cocok untuk dataset besar yang butuh kecepatan seperti real-time analytics? :: ELT, karena data dimuat lebih dulu dan ditransformasi secara paralel di dalam sistem target sehingga lebih cepat untuk volume data besar. Apa itu “Bronze layer” dalam alur ELT modern? :: Lapisan penyimpanan awal (di Object Storage/Data Lake) tempat data mentah hasil extract dimuat apa adanya (raw), lengkap dengan append partitions dan record metadata, sebelum ditransformasi lebih lanjut menjadi data marts/aggregations di layer berikutnya.