Catatan: slide W11 ini berjudul sama dengan W07b (“Data Architecture and Flows”) dan mengulang sebagian isinya (definisi Data Architecture, Enterprise Data Model, dan Data Flow Design matrix/DFD — lihat 9_DataOps_Data_Architecture_and_Master_Data untuk pembahasan itu, tidak diulang di sini). Namun W11 ternyata adalah versi yang diperluas: menambahkan materi baru soal layers, architecture styles (Data Warehouse/Lake/Lakehouse/Fabric/Mesh), data lineage, karakteristik dan pola aliran data, serta best practices. Catatan ini fokus ke materi tambahan tersebut.
Data Architecture sebagai Blueprint
Data architecture adalah blueprint (cetak biru) bagaimana data bergerak melalui organisasi.
(Definisi lengkap “organized/structured arrangement…” sama seperti di 9_DataOps_Data_Architecture_and_Master_Data.)
Lapisan (Layers) Data Architecture
- Data Sources Layer — sistem operasional, log, API, perangkat IoT, data eksternal.
- Ingestion Layer — tools ETL/ELT, platform streaming (Kafka, Kinesis).
- Storage Layer — data lake, data warehouse, lakehouse (Snowflake, Databricks).
- Processing Layer — batch processing (Spark), stream processing (Flink, Kafka Streams).
- Consumption Layer — BI tools (Tableau, Power BI), model ML, API, dashboard.
Architecture Styles
| Pattern | Deskripsi | Use Case |
|---|---|---|
| Data Warehouse | Penyimpanan terpusat (centralized), terstruktur | BI tradisional dan reporting |
| Data Lake | Penyimpanan terpusat, data mentah (raw) | Big data analytics, ML |
| Data Lakehouse | Menggabungkan warehouse + lake | Platform analitik terpadu (unified) |
| Data Fabric | Terdistribusi, digerakkan oleh metadata (metadata-driven) | Integrasi enterprise-wide |
| Data Mesh | Terdesentralisasi, berorientasi domain | Organisasi besar dengan otonomi tim |
Pertimbangan kunci: pilih arsitektur berdasarkan skala organisasi, kebutuhan governance, dan use case.
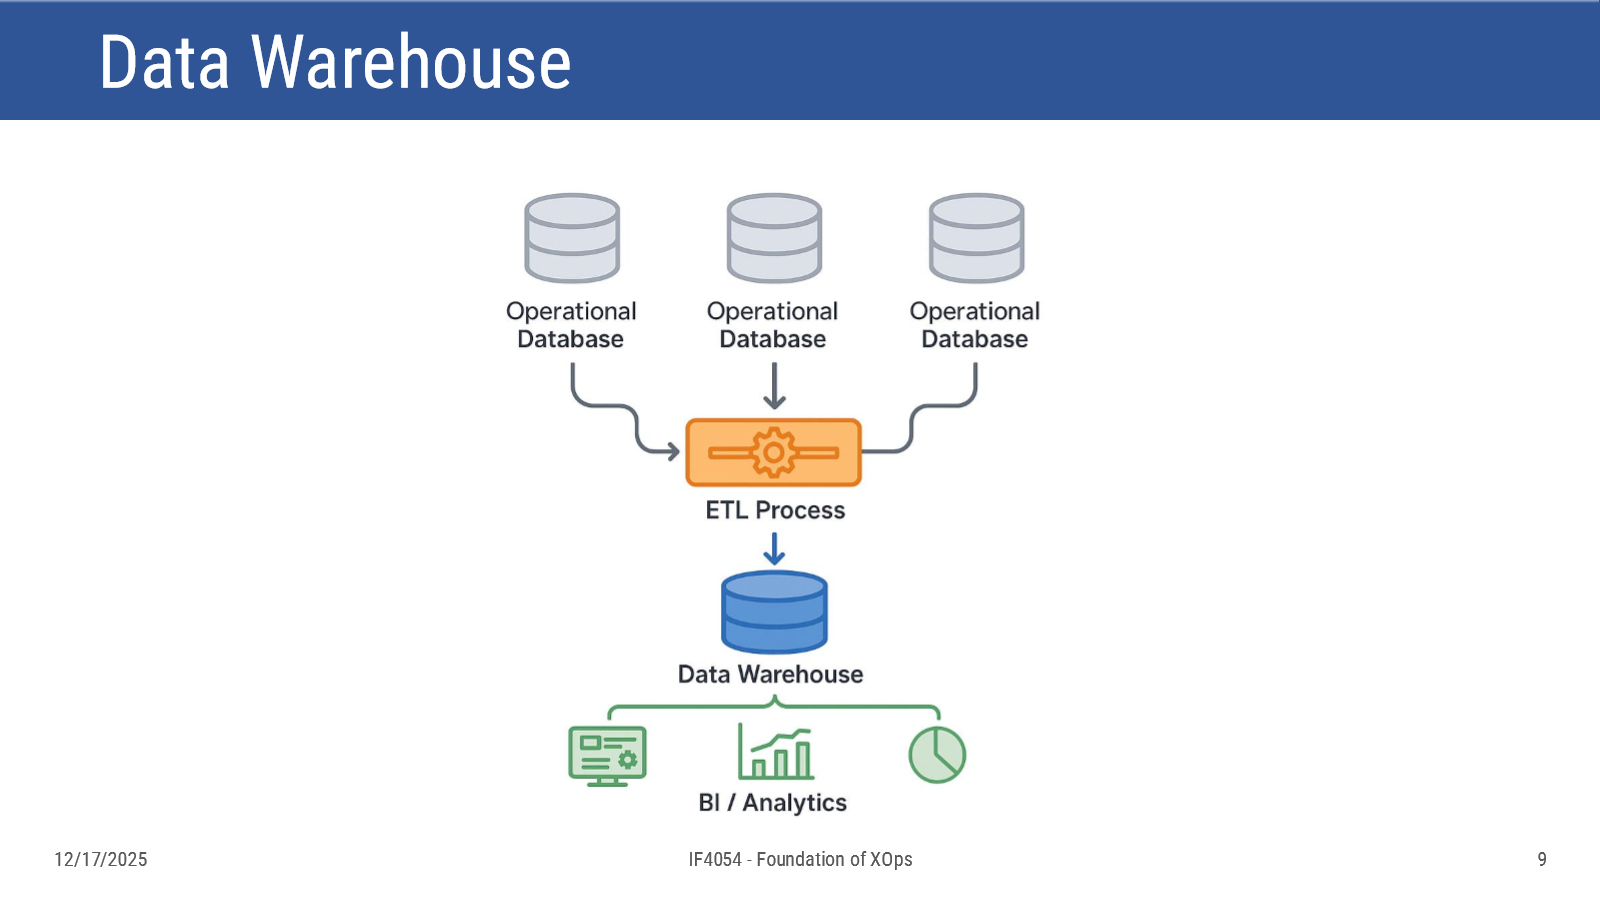
Data Warehouse
Beberapa Operational Database → ETL Process → Data Warehouse → dikonsumsi oleh BI/Analytics.
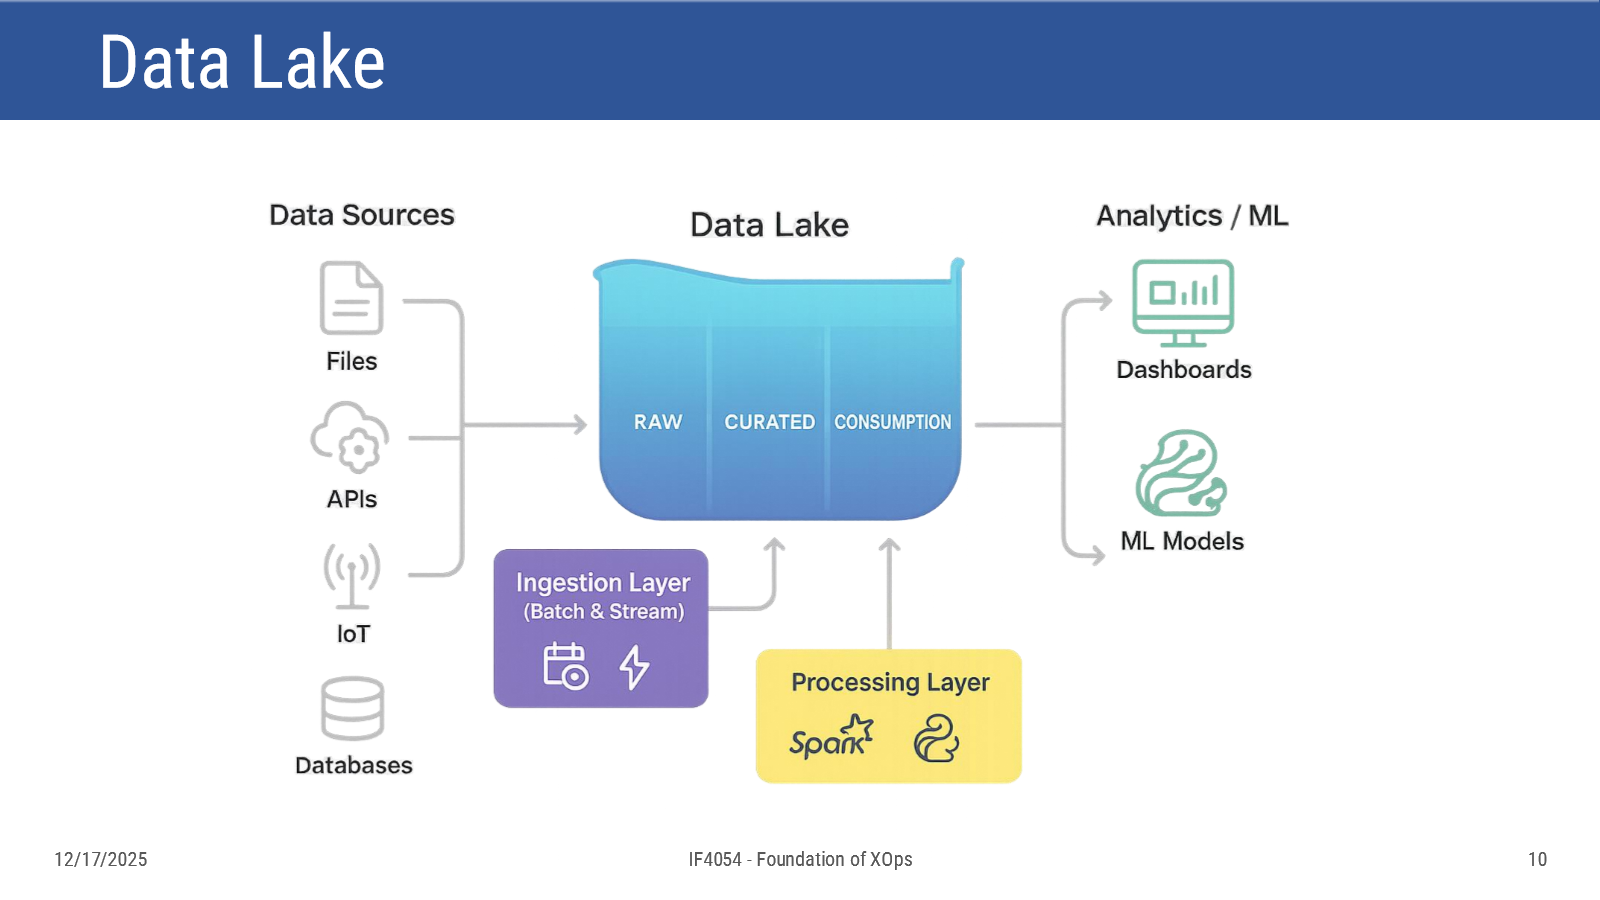
Data Lake
Data Sources (Files, APIs, IoT, Databases) → Ingestion Layer (Batch & Stream) → Data Lake dengan 3 zona: RAW → CURATED → CONSUMPTION (diproses oleh Processing Layer: Spark, Python) → dikonsumsi oleh Analytics/ML (Dashboards, ML Models).
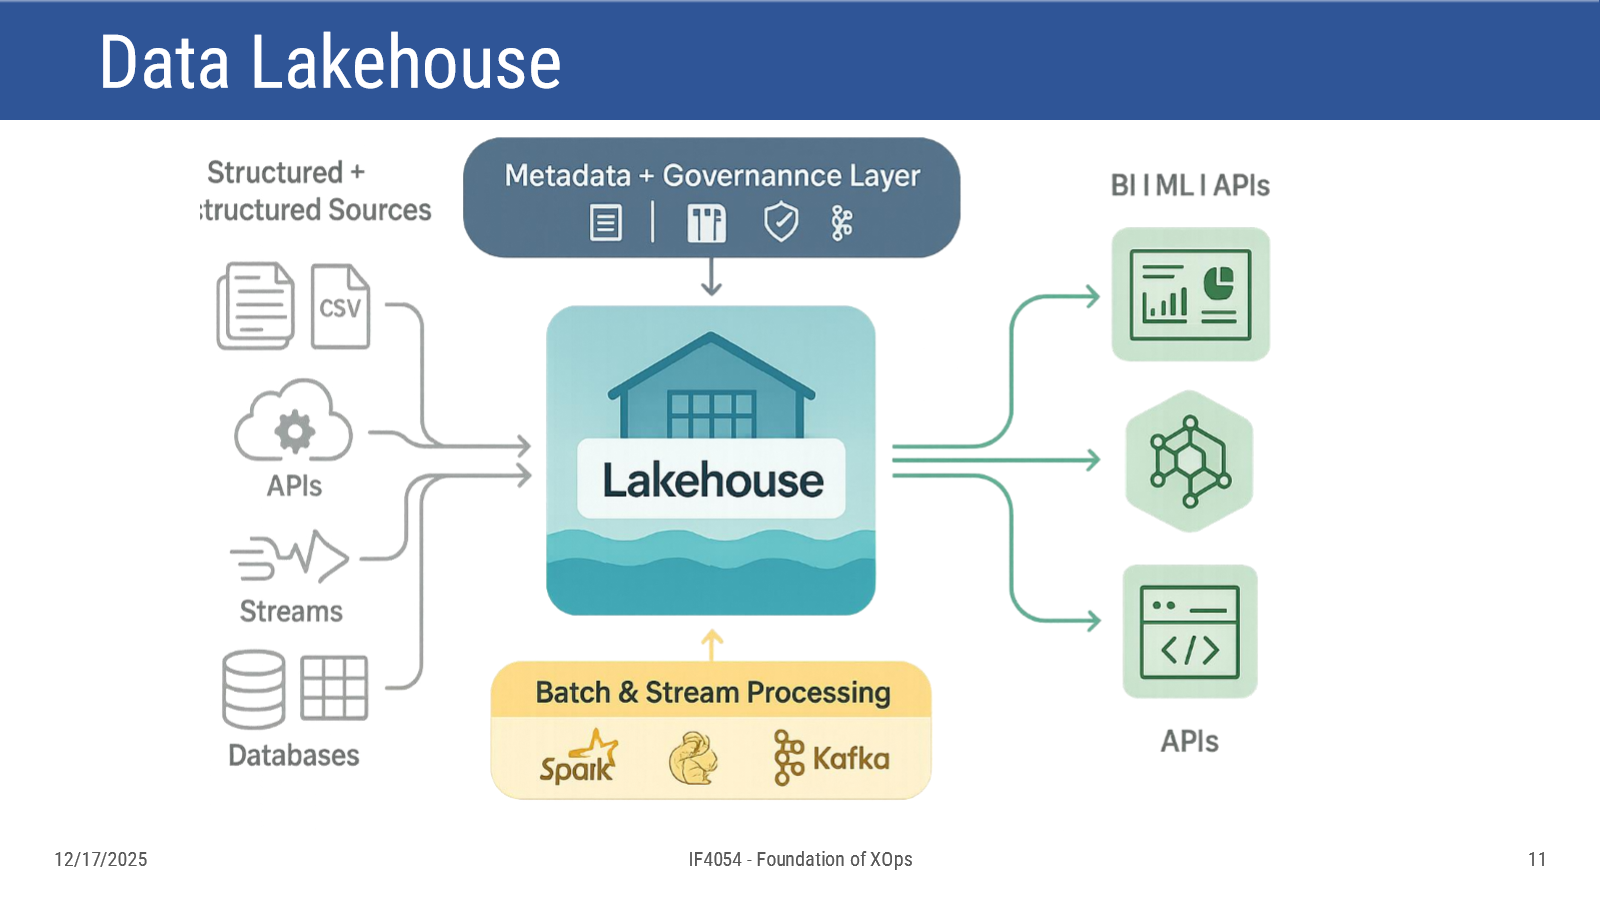
Data Lakehouse
Sumber Structured + Unstructured (CSV, APIs, Streams, Databases) → Lakehouse (dipayungi Metadata + Governance Layer, diproses oleh Batch & Stream Processing: Spark, Kafka) → dikonsumsi oleh BI, ML, APIs.
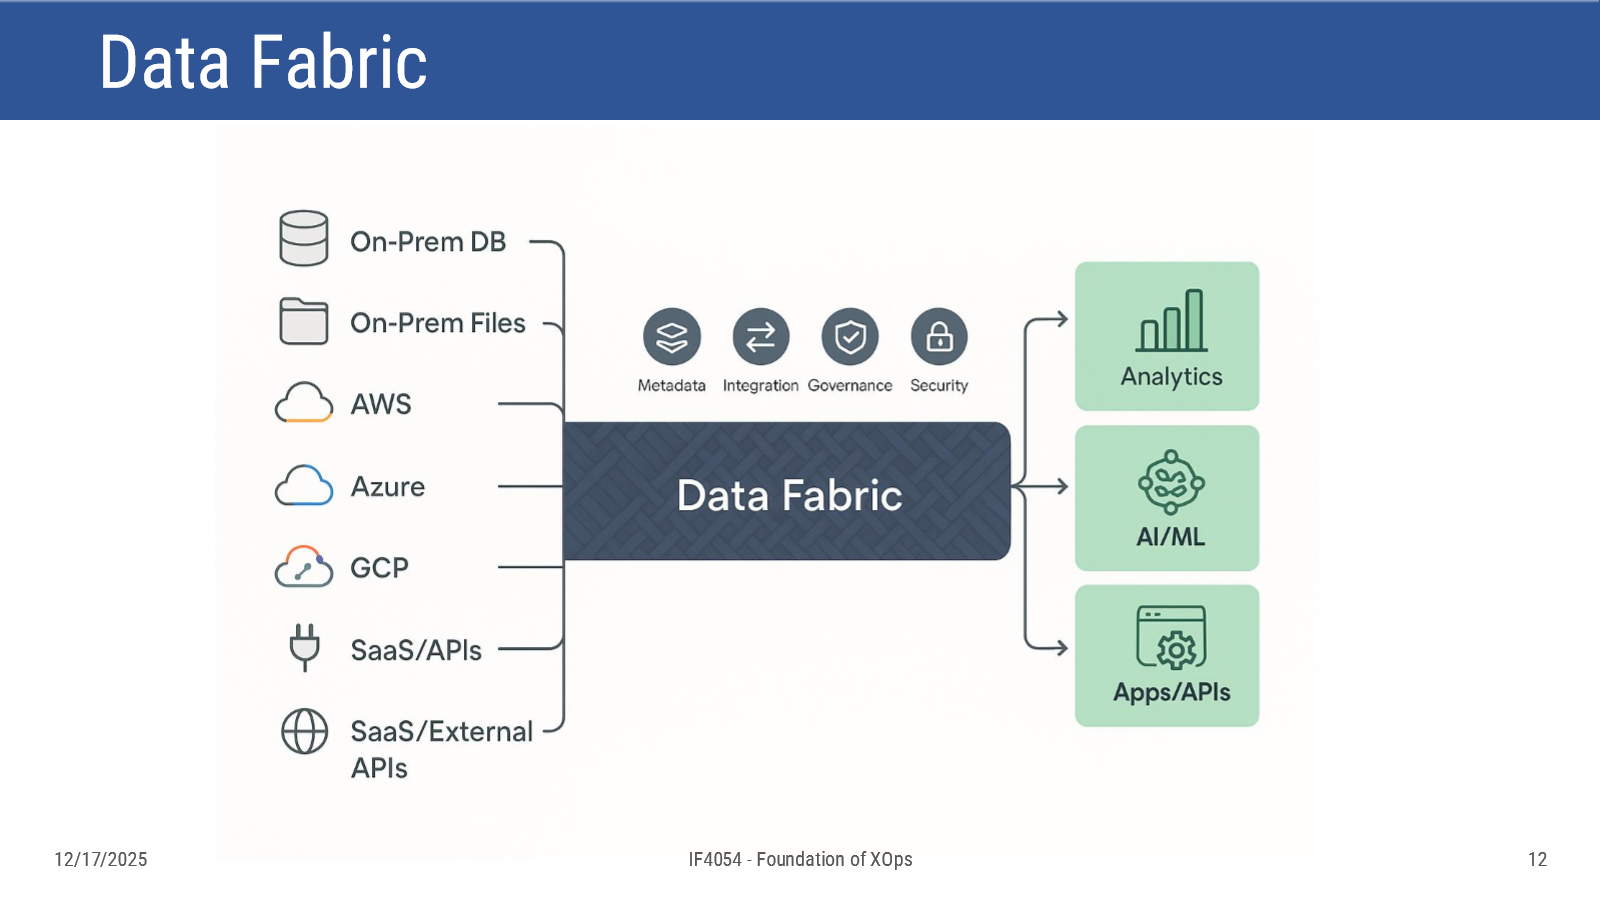
Data Fabric
Berbagai sumber (On-Prem DB, On-Prem Files, AWS, Azure, GCP, SaaS/APIs, SaaS/External APIs) → Data Fabric (dengan layanan inti: Metadata, Integration, Governance, Security) → dikonsumsi oleh Analytics, AI/ML, Apps/APIs.
Data Mesh
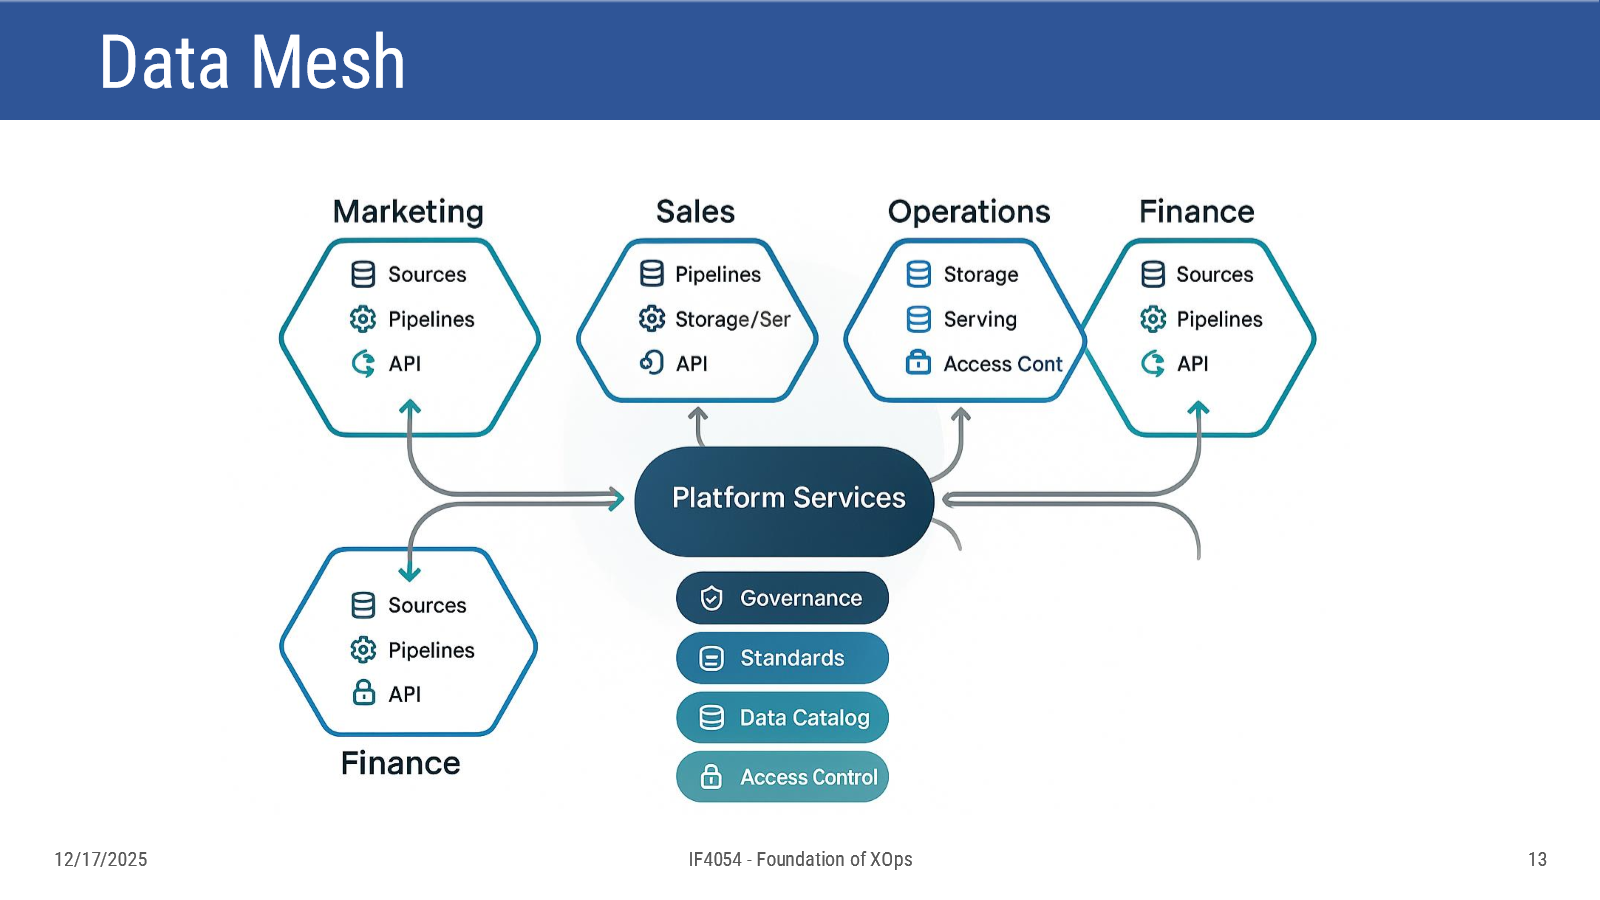
Setiap domain bisnis (Marketing, Sales, Operations, Finance) memiliki data product-nya sendiri (Sources, Pipelines, Storage/Serving, API, Access Control) yang bersifat desentralisasi (dikelola tim domain masing-masing), namun tetap terhubung ke Platform Services bersama yang menyediakan: Governance, Standards, Data Catalog, Access Control.
Data Lineage dan Metadata Management
- Data Lineage: melacak asal-usul, pergerakan, dan transformasi data.
- Metadata Management: mengatalogkan aset data, skema, dan relasinya.
- Mengapa penting:
- Memungkinkan observability dan debugging.
- Mendukung compliance dan audit (GDPR, HIPAA).
- Meningkatkan kualitas dan kepercayaan (trust) terhadap data.
Karakteristik Data Flow
- Direction: Upstream (sumber) → Downstream (konsumen).
- Frequency: Real-time vs Batch.
- Complexity: Pipeline sederhana vs workflow multi-tahap.
- Flow Types:
- Batch Processing — pergerakan data terjadwal dan periodik (misal job malam hari/nightly jobs).
- Real-Time/Streaming — penyerapan data berkelanjutan (event-driven).
- Transformation Approaches:
- ETL — transformasi dilakukan sebelum dimuat ke storage.
- ELT — data mentah dimuat dulu, ditransformasi belakangan (lihat 11_DataOps_Data_Integration_and_Interoperability untuk detail).
- Synchronous vs Asynchronous:
- Synchronous — butuh respons segera.
- Asynchronous — pemrosesan yang decoupled dan digerakkan oleh event.
Pola Umum Data Flow (Common Data Flow Patterns)
- Lambda Architecture — menggabungkan pemrosesan batch dan real-time untuk analitik yang komprehensif.
- Kappa Architecture — pendekatan stream-first; semua data diperlakukan sebagai event.
- Change Data Capture (CDC) — menangkap perubahan inkremental dari database secara real-time.
- Event-Driven Flows — dipicu oleh event (misal upload file baru, pemanggilan API).
- Contoh alur umum: RAW Zone → CURATED Zone → CONSUMPTION Zone.
Best Practices Data Flow
- Metadata-Driven Design — gunakan metadata untuk mengotomasi dan mengatur (govern) alur data.
- Modular Pipeline Design — bangun komponen yang reusable dan composable.
- Observability Integration — pantau setiap tahap pipeline.
- Automation Over Manual Processes — kurangi human error dan tingkatkan kecepatan.
- Version Control — lacak perubahan pada pipeline dan skema data.
- Data Quality Checks — validasi data pada tahap ingestion dan transformasi.
- Documentation — pelihara dokumentasi yang jelas untuk semua data flow.
Flashcard
flashcards Sebutkan 5 lapisan (layers) Data Architecture beserta contoh teknologinya. :: Data Sources Layer (sistem operasional, API, IoT), Ingestion Layer (ETL/ELT, Kafka/Kinesis), Storage Layer (data lake/warehouse/lakehouse seperti Snowflake/Databricks), Processing Layer (Spark untuk batch, Flink/Kafka Streams untuk stream), Consumption Layer (Tableau/Power BI, model ML, API). Sebutkan 5 architecture style data beserta use case utamanya. :: Data Warehouse (BI/reporting tradisional), Data Lake (big data analytics/ML), Data Lakehouse (platform analitik terpadu), Data Fabric (integrasi enterprise-wide, metadata-driven), Data Mesh (organisasi besar dengan otonomi domain, desentralisasi). Apa perbedaan mendasar antara Data Fabric dan Data Mesh? :: Data Fabric bersifat terdistribusi namun digerakkan oleh metadata secara terpusat untuk integrasi enterprise-wide; Data Mesh bersifat desentralisasi berbasis domain, di mana tiap domain bisnis (Marketing, Sales, dst) memiliki dan mengelola data product-nya sendiri, terhubung ke Platform Services bersama untuk governance dan standar. Sebutkan 3 zona umum dalam Data Lake. :: RAW (data mentah), CURATED (data yang sudah dibersihkan/diproses), dan CONSUMPTION (siap dikonsumsi oleh dashboard/ML models). Mengapa Data Lineage dan Metadata Management penting? :: Karena memungkinkan observability dan debugging, mendukung compliance dan audit (GDPR, HIPAA), serta meningkatkan kualitas dan kepercayaan terhadap data. Jelaskan perbedaan Lambda Architecture dan Kappa Architecture. :: Lambda Architecture menggabungkan pemrosesan batch dan real-time sekaligus untuk analitik komprehensif; Kappa Architecture mengambil pendekatan stream-first di mana semua data (termasuk data historis) diperlakukan sebagai aliran event. Apa itu Change Data Capture (CDC)? :: Pola data flow yang menangkap perubahan data secara inkremental dari database sumber secara real-time, tanpa perlu memindai seluruh data setiap kali. Sebutkan 4 dari 7 best practices dalam merancang data flow. :: Metadata-driven design, modular pipeline design, observability integration, automation over manual processes (juga: version control, data quality checks, documentation).