UTS NLP (IF5153 Advanced Natural Language Processing)
Bahan belajar UTS yang disusun dari catatan 1, 2, 3, 5, 6, dan 7. Ini studi sheet, bukan pengganti catatan asli: tiap bagian me-link ke note sumber untuk detail, contoh lengkap, dan flashcard aslinya. Istilah singkat ada di Glosarium_NLP.
Cara pakai: baca Prasyarat dulu, lalu Materi inti dari atas ke bawah. Urutannya disusun menurut ketergantungan konsep, jadi sebuah konsep selalu dijelaskan sebelum dipakai. Konsep yang sudah dijelaskan tidak diulang, hanya dirujuk (“lihat 2.x”).
0. Cakupan dan Peta CPMK
Cakupan: semua materi di _Materi/NLP/ppt-baru/: Pengantar Kelas, Klasifikasi Teks (02a dan 02b), HAL/LDA/GloVe, Transformer Encoder, Decoder, dan Sentence Comparison (serta Exercise on Transformer Encoder, yang dicatat sebagai tugas di 3_Exercise_Transformer_Encoder). Peta ke note: 1, 2, 3, 5, 6, 7. Note 4 (BEAM/Boxology) tidak ada di folder itu, jadi tidak dibahas di sini. Materi Transformer Encoder dan Decoder di sini sudah memakai versi slide terbaru (bagian “Tambahan dari Versi Slide Terbaru” di note 5 dan 6).
| Luaran (CPMK) | Bagian di file ini | Status |
|---|---|---|
| 1. Menjelaskan pendekatan machine learning untuk berbagai task NLP | 2.1 (task), 2.2 (klasifikasi, fitur, Naive Bayes, CNN, RNN), 2.3 (word representation) | Tercakup |
| 2. Menjelaskan pendekatan berbasis transfer learning untuk berbagai task NLP | 2.4 sampai 2.8 (Transformer, BERT, prompting, fine-tuning, PEFT, sentence comparison) | Tercakup |
| 3. Mengembangkan model NLP dengan pendekatan machine learning | 2.2 (contoh scikit-learn), 2.3 (perhitungan HAL, LDA, GloVe) | Tercakup sebagian (pengembangan ada di lab dan project) |
| 4. Mengembangkan model NLP dengan pendekatan transfer learning | 2.5 (fine-tuning BERT), 2.6 sampai 2.8 | Tercakup sebagian (pengembangan ada di lab dan project; lihat 1_Lab_Work_4) |
1. Prasyarat: Istilah yang Harus Dipahami Dulu
Istilah di bagian ini dipakai di note tanpa penjelasan (hanya disebut atau diberi rumusnya). Dicek dengan pencarian teks di note NLP 1-7 dan folder Glosarium-Teknis; slide PDF mentah tidak diperiksa. Penjelasannya adalah tambahan di luar materi kuliah. Istilah yang sudah dijelaskan di note (softmax, dropout, hidden state, logits, cosine similarity, epoch, dan lain-lain) tidak ada di sini, cukup lihat Glosarium_NLP.
| Istilah | Penjelasan (tambahan) |
|---|---|
| Vektor, matriks, dot product, norm | Vektor adalah deretan angka; matriks adalah tabel angka. Dot product dua vektor adalah jumlah hasil kali elemen yang bersesuaian (ukuran seberapa searah). Norm adalah panjang vektor. |
| Eigenvalue dan eigenvector | Pasangan angka dan arah khusus dari sebuah matriks: arah yang tidak berubah saat dikalikan dengan matriks itu, hanya diskalakan oleh sebuah angka (eigenvalue). Dipakai pada SVD (2.3). |
| Probabilitas dasar dan logaritma | Probabilitas bernilai 0 sampai 1; logaritma mengubah perkalian jadi penjumlahan dan dipakai pada TF-IDF, mutual information, dan GloVe. |
| Supervised vs unsupervised | Supervised: model belajar dari data berlabel. Unsupervised: model belajar dari data tanpa label (menemukan pola sendiri). |
| Neuron, layer, ReLU | Jaringan saraf tiruan tersusun dari layer berisi neuron yang menghitung jumlah berbobot lalu menerapkan fungsi aktivasi. ReLU adalah fungsi aktivasi yang mengubah nilai negatif menjadi 0 dan membiarkan nilai positif. |
| Backpropagation dan gradient descent | Gradient descent mengubah bobot sedikit demi sedikit ke arah yang menurunkan loss. Backpropagation menghitung arah itu (gradient) dari output ke input. SGD dan AdaGrad adalah variasinya. |
| Loss dan cross-entropy | Loss adalah angka yang menyatakan seberapa salah prediksi model. Cross-entropy adalah loss umum untuk klasifikasi: makin kecil bila probabilitas kelas yang benar makin besar. |
| Learning rate | Seberapa besar langkah perubahan bobot di tiap update. |
| Overfitting | Model hafal data latih sehingga bagus di data latih tetapi jelek di data baru. |
| Residual connection | Menambahkan input sebuah sub-layer langsung ke outputnya (output = x + sublayer(x)) supaya informasi dan gradient mengalir lebih mudah. |
| Layer normalization (LayerNorm) | Menormalkan nilai satu vektor (rata-rata 0, sebaran tertentu) supaya training stabil. Di Transformer dipakai pada langkah “Add & Norm”. |
| Metrik: BLEU, F1, EM, akurasi | BLEU: seberapa mirip terjemahan mesin dengan terjemahan referensi (lebih tinggi lebih baik). F1: rata-rata harmonik presisi dan recall. EM (exact match): persentase jawaban yang persis sama dengan jawaban benar. Akurasi: persentase prediksi yang benar. |
| Naive Bayes | Algoritma klasifikasi probabilistik sederhana yang menghitung peluang tiap kelas dari kata-kata yang muncul dengan asumsi kata saling bebas. |
| RLHF | Reinforcement Learning from Human Feedback: tahap melatih model memakai penilaian manusia agar jawabannya sesuai preferensi. |
| Kuantisasi (quantization) | Menyimpan bobot model dengan angka berpresisi lebih rendah (misalnya 4-bit) supaya memori lebih kecil. |
| Autoregressive | Menghasilkan keluaran satu demi satu, tiap langkah memakai keluaran langkah sebelumnya sebagai masukan. |
2. Materi Inti (Urut Menurut Ketergantungan Konsep)
2.1 Pengantar NLP dan Kategori Task
Sumber: 1_Pengantar_Kelas
Kuliah: IF5153 Advanced NLP (S2 ITB), semester 1 2026/2027, dosen Ayu Purwarianti; Senin 13.00-14.40 dan Rabu 10.00-10.50. Penilaian: exercise/homework, projects (paper exploration dan implementasi NLP task), practicum, mid term, final term. Kebijakan AI: boleh untuk belajar, tidak boleh secara default untuk mengerjakan tugas; pengecualian pencarian literatur (tetap wajib membaca sendiri). Project: tim 3 orang, satu pipeline berisi 3 task NLP (1 task per anggota), presentasi minggu 14-15 (demo dan PPT dengan error analysis). Student Outcome: mampu mendesain dan membangun solusi berbasis komputasi lewat pendekatan interdisipliner. Silabus: (1) basic NLP tools (lexical, syntactic, semantic, reference resolution); (2) task (text classification, text comparison/similarity, sequential labelling, sentiment analysis, QA, dialogue system); (3) teknik (shallow machine learning, word representation, transfer learning encoder/decoder); (4) evaluasi NLP/LLM.
CL vs NLP:
| Computational Linguistics (CL) | Natural Language Processing (NLP) | |
|---|---|---|
| Fokus | Mempelajari proses komputasional dalam bahasa (memahami, menghasilkan, mempelajari bahasa) | Metode untuk menyelesaikan masalah praktis dengan bahasa manusia |
| Orientasi | Bagaimana linguistik didukung metode komputasional (mirip computational biology) | Aplikasi konkret, mis. machine translation, question answering |
Dalam praktik CL ≈ NLP.
Definisi NLP: Goldberg (2017): bidang yang mendesain metode dan algoritma yang menerima input atau menghasilkan output berupa data bahasa alami tidak terstruktur. Eisenstein (2018): desain dan analisis algoritma komputasional serta representasi untuk memproses bahasa alami. Ringkas: metode, algoritma, dan representasi untuk input/output bahasa alami (teks maupun speech).
Mengapa penting: triliunan dokumen di internet; kebutuhan proficiency bahasa lokal; teknologi yang human friendly. Pemain: Google, Siri, GPT/ChatGPT, Gemini, Copilot, dan lokal (Prosa.ai, Bahasa.ai, Kata.ai).
Ruang lingkup teks: NLU (memahami makna), NLG (menghasilkan teks), Text Analytics. Input: suara (speech recognition), bahasa isyarat, dokumen, media sosial, web, dokumen fisik (OCR). Output: knowledge graph, ringkasan, dashboard, penilaian otomatis, chatbot.
Empat kategori task NLP:
| Kategori | Pola | Contoh |
|---|---|---|
| Text Classification | Seluruh teks → label | Spam filtering (spam/bukan), sentiment analysis (positive/negative/neutral), emotion detection, language identification |
| Text Comparison | Dua teks → label | Document clustering (mirip atau tidak), plagiarism detection, short answer scoring, information retrieval (relevan atau tidak) |
| Sequential Labeling | Tiap token → label token (memakai label token sebelumnya sebagai konteks) | POS tagger; Named Entity Tagger (contoh “KSTI was held at ITB”: KSTI=Event, ITB=Loc, lainnya Other); QA factoid (token jawaban dilabeli Answer, lainnya O); aspect-based sentiment analysis (sequential labeling untuk aspect/sentiment marker plus text classification untuk nilai sentimen) |
| Seq2seq | Teks → teks (generatif) | Machine translation, summarization, chatbot, lexical normalization (MultiLexNorm) |
Benchmark: NLPProgress.com (state of the art per task); GLUE (CoLA, SST-2, MRPC, STS-B, QQP, MNLI, QNLI, RTE, WNLI); SemEval/Senseval (shared task tahunan sejak 1998, mis. semantic textual similarity, aspect based sentiment analysis).
Sejarah:
| Dekade | Perkembangan |
|---|---|
| 1940-1950 | Machine Translation rule-based; jurnal Mechanical Translation 1954; konferensi MT pertama 1952 |
| 1960 | Konferensi Teddington 1961 (morfologi, sintaks, semantik, leksikon); ALPAC Report 1966 mengkritik MT sehingga riset bergeser ke task lain |
| 1970 | Conceptual ontologies |
| 1980 | Rule-based parsing, semantik, RST (Rhetorical Structure Theory) |
| 1990 | Metode stokastik, HMM |
| 2000 | Machine learning unsupervised dan semi-supervised |
| 2010 | Representation learning, DNN |
| 2018 | Transfer learning, era Language Model (BERT, GPT) |
2.2 Text Classification: dari Preprocessing sampai Classifier
Sumber: 2_Klasifikasi_Teks (memakai 2.1)
Text classification memberi label ke seluruh teks. Variasi: output single label vs multi label; input pendek (SMS) vs dokumen, user generated content vs kalimat formal, teks lengkap vs tidak lengkap. Studi kasus spam filtering: spam vs not spam (ham). Alur: Preprocessing → Feature Extraction → Classification (rule/model).
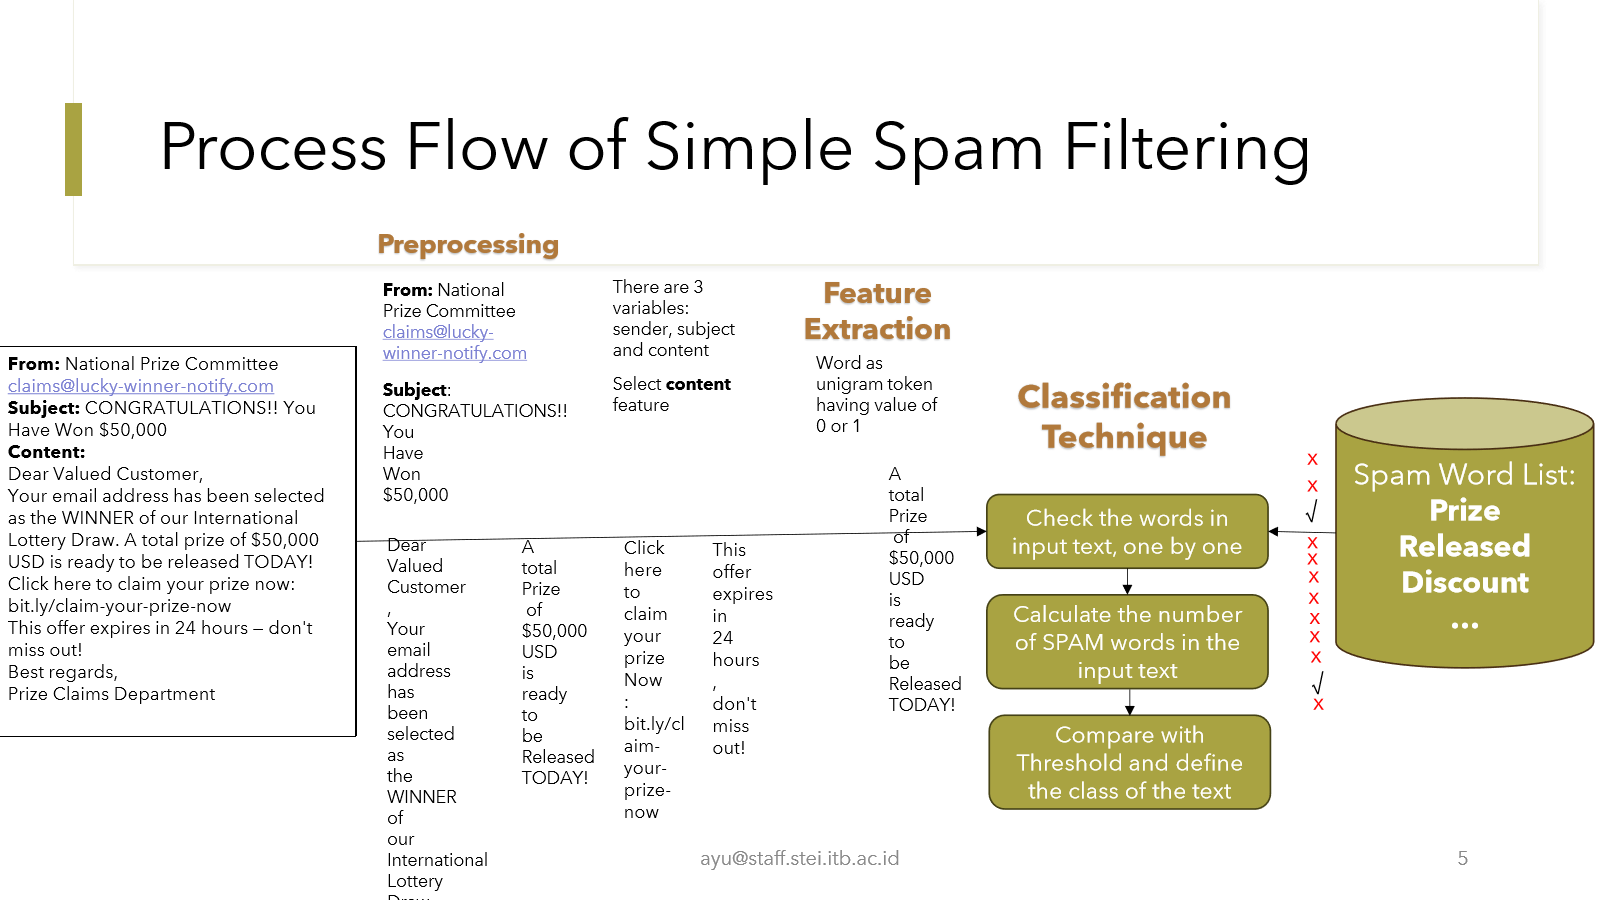
Pendekatan paling sederhana memakai spam word list dan threshold jumlah kata spam. Kelemahan: kata spam bisa kata umum (butuh stop word elimination); kata spam bisa muncul di teks non-spam (butuh feature selection dengan word weight); urutan kata berbeda bisa mengubah label (“Click here now to claim your free 500 gift card…” bukan); daftar kata bisa manual atau dipelajari dari corpus.
Preprocessing (tidak semua wajib): tokenization; lemmatization (kata ke lema, writing → write); morphological analyzer (kata ke dasar + afiks, writ + ing); stemming (dipotong ke stem, writing → writ, mis. Porter); lowercase; entity masking (nomor telepon, URL); spelling correction; word normalization (akronim); stop word elimination (hapus kata umum; contoh “The place is nice but the food is not recommended” → “place nice food recommended”; daftar bisa manual, default NLTK, atau dari word weight/POS).
| Konsep | Definisi | Contoh (writing) |
|---|---|---|
| Morphological analyzer | Memecah kata jadi afiks | writ + ing |
| Lemmatization | Ke lema valid secara gramatikal | write |
| Stemming | Memotong ke stem, bisa bukan kata valid | writ |
Morfologi adalah studi pembentukan dan struktur internal kata (Fromkin dkk., 2018). Sentence splitter memeriksa apakah ”.”, ”?”, ”!” menandai akhir kalimat (EOS) karena ambigu (titik pada “etc.”). Tokenizer memecah kalimat (spasi untuk Inggris/Indonesia); bahasa tanpa spasi (Mandarin) atau noun compound panjang (Jerman) butuh word segmentation. Maximum Matching (baseline greedy): pointer di awal; cari kata kamus terpanjang yang cocok dari pointer; pindahkan pointer ke akhir kata; ulangi. Contoh Thecatinthehat → the cat in the hat.
Feature extraction. Vectorization mengubah fitur token menjadi angka. Bag of words: unigram (juga bigram, trigram) sebagai fitur, nilai 1 bila ada dan 0 bila tidak, dengan kolom Class sebagai target; juga dipandang sebagai matriks Term × Document yang membentuk Vector Space Model, nilai sel bisa Boolean, TF, atau TF×IDF. Mengurangi jumlah fitur: lemmatization, stemming, stop word elimination, dan pilih term berskor tinggi:
- TF×IDF:
w(x,y) = tf(x,y) × log(N/df_x);tf(x,y)frekuensi term x di dokumen y;df_xjumlah dokumen berisi term x;Ntotal dokumen. Variasi idf:1/dfataulog(N/df). - Mutual Information:
MI(t,l) = log2 [p(t,l)/(p(t)p(l))] ≈ log2 [A×N / ((A+B)(A+C))];Njumlah dokumen berlabel,Ajumlah kata t dengan label l,Bjumlah kata t tanpa label l,Cjumlah dokumen berlabel l tanpa term t.
Classifier. Setelah fitur dan label, pakai algoritma ML: SVM, Neural Network, XGBoost, Decision Tree, Naive Bayes. Contoh scikit-learn: RegexpTokenizer → CountVectorizer (bag-of-words dengan stop word bawaan) → MultinomialNB, akurasi 0.982 pada contoh. CNN (Yoon Kim, 2014): kalimat jadi matriks n × k (tiap baris vektor kata, ada channel static dan non-static) → convolutional layer dengan beberapa lebar filter → feature map → max-over-time pooling (tiap feature map jadi satu nilai) → fully connected dengan dropout dan softmax. RNN/LSTM: memproses kata satu per satu secara sekuensial (pola many-to-one, satu output di akhir sequence), output akhir h jadi representasi untuk klasifikasi (Nowak dkk., 2017).
2.3 Word Representation
Sumber: 2_Klasifikasi_Teks dan 3_Word_Representation (memakai 2.2)
Dari bag of words ke word representation. Bag of words merepresentasikan tiap token sebagai satu skor, sehingga kata sinonim dianggap independen. Solusinya: satu token = satu vektor angka, sehingga kata bermakna mirip berjarak lebih kecil.
Taksonomi:
- One-hot: vektor dengan satu angka 1 pada posisi index kata; tidak menangkap kemiripan makna.
- Distributed representation:
- Count-based: matriks co-occurrence term × term (dalam window) atau term × context, lalu dimensional reduction (mis. SVD).
- Predict-based (word embedding): tanpa konteks (word2vec, GloVe, fastText; satu vektor tetap per kata); dengan konteks (BERT, XLNet, ELMo; vektor berubah menurut kalimat).
SVD / Latent Semantic Indexing (LSI/LSA). Term dan dokumen dipetakan ke ruang makna laten berdimensi lebih rendah. A(n×p) = U(n×n) S(n×p) V^T(p×p): U kolomnya eigenvector AA^T (memetakan term), V kolomnya eigenvector A^TA (memetakan dokumen), S diagonal berisi singular value (akar eigenvalue, terurut menurun). Input baru dipetakan dengan q = Q^T U S^{-1} dan d = D^T U S^{-1}. Contoh numerik: A = [[1,2],[0,1],[1,1]], A^TA = [[2,3],[3,6]], λ² − 8λ + 3 = 0 sehingga λ = 4 ± √13 (7,6055 dan 0,3944), singular value 2,7578 dan 0,6281, v1 = (0,47; 0,88); hasil akhir U = [[0,815; 0,099],[0,319; 0,751],[0,491; −0,652]], S = diag(2,7578; 0,6281), V^T = [[0,47; 0,88],[−0,88; 0,47]].
Word2Vec (Mikolov dkk., 2013): berdasar distributional hypothesis (kata mirip muncul di konteks mirip; contoh window “dog” pada “The fluffy dog barked as it chased a cat” adalah {fluffy, barked, it}). Relasi aljabar: V_king − V_man + V_woman = V_queen.
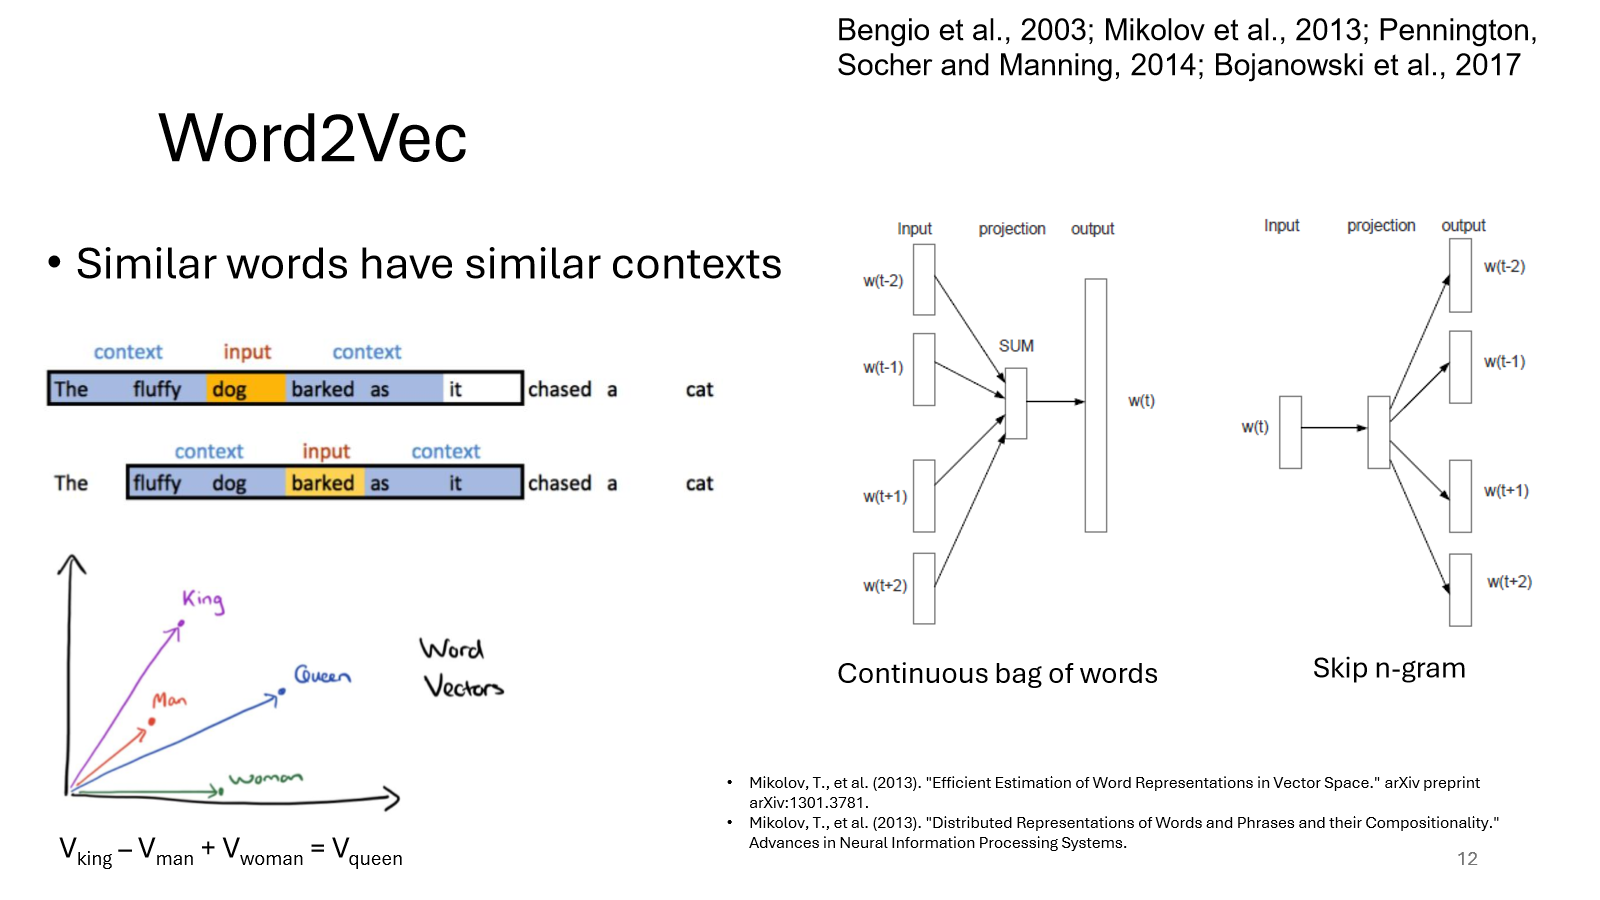
- CBOW: memprediksi kata target
w(t)dari kata konteksw(t−2), w(t−1), w(t+1), w(t+2)(dijumlahkan di layer proyeksi). - Skip-gram: kebalikannya, dari kata target memprediksi kata konteks. Input one-hot (mis. 10.000 dimensi) dikalikan hidden layer weight matrix (mis. 300 neuron); matriks bobot ini setelah training menjadi word vector lookup table. Output berupa probabilitas tiap kata muncul berdekatan dengan kata input.
Peta metode (urutan konseptual): TF-IDF → LSI → HAL → LDA → GloVe → Word2Vec. TF-IDF dan LSI menangkap relasi word–document; HAL word–word lokal dalam window (deterministik); LDA membentuk ruang laten Topic secara generatif probabilistik; GloVe hybrid (statistik global dari co-occurrence word–word, tetapi vektor dipelajari lewat gradient); Word2Vec murni prediktif lewat neural network.
HAL (Hyperspace Analogue to Language). Co-occurrence dari sliding window; tiga sifat: local context (hanya kata di sekitar), distance-weighted (makin dekat makin besar kontribusi), direction-sensitive (sebelum dan sesudah dilacak terpisah). Bobot w(d) = W − d + 1 (W ukuran window, d jarak); untuk W=2: w(1)=2, w(2)=1.
- Contoh: D1 = “ball player goal ball”, D2 = “president player”, stream
ball player goal ball president player, V = {ball, player, goal, president},W=2. Matriks R (konteks sesudah): baris ball (0,3,1,2), player (1,0,2,0), goal (2,0,0,1), president (0,2,0,0). Matriks L (konteks sebelum) adalahL = R^T: ball (0,1,2,0), player (3,0,0,2), goal (1,2,0,0), president (2,0,1,0). Vektor katav(w) = [R[w,:] ‖ L[w,:]]berdimensi2V; contohv(ball) = (0,3,1,2, 0,1,2,0). - Reduksi dimensi: variance-based selection (pilih kolom bervarians tertinggi) atau SVD. Vektor dokumen:
v(d) = (1/|d|) Σ count(w,d) × v(w); contohv(D1) = (0,75; 1,5; 1,0; 1,25; 1,0; 1,0; 1,0; 0,5). Pipeline: token stream → window → bobot jarak → R dan L → concatenate → vektor kata → agregasi → vektor dokumen → cosine similarity.
LDA (Latent Dirichlet Allocation). Model probabilistik generatif, ruang laten Topic. Dua asumsi: (1) dokumen adalah campuran topik (θ_d, vektor proporsi topik, mis. 55% Olahraga dan 45% Politik); (2) topik adalah distribusi atas kata (φ_k, mis. Olahraga: bola 0,40, pemain 0,35, gol 0,20). Proses generatif: untuk tiap dokumen θ_d ~ Dir(α); untuk tiap kata z_{d,n} ~ Multinomial(θ_d), lalu w_{d,n} ~ Multinomial(φ_{z_{d,n}}). Dirichlet: α = (0,3; 0,3; 0,3) sparse (didominasi satu topik, dipakai LDA); α = (1,1,1) neutral; α = (8,8,8) terkonsentrasi di tengah (campuran merata). Contoh numerik (K=2, Sport dan Politics): θ1 = (0,90; 0,10), θ2 = (0,05; 0,95), θ3 = (0,55; 0,45); φ_Sport = (0,40; 0,35; 0,20; 0,02; 0,02; 0,01) dan φ_Politics = (0,02; 0,03; 0,01; 0,40; 0,35; 0,19) atas kata (ball, player, goal, president, party, election).
- Inferensi (collapsed Gibbs sampling):
P(z_{d,n}=k | …) ∝ (n_{d,k} + α) × (n_{k,w} + β);n_{d,k}jumlah kata di dokumen d yang kini di-assign topik k;n_{k,w}jumlah kemunculan kata w di seluruh korpus yang di-assign topik k; diulang sampai konvergen. - Vektor: matriks
φ(K × V): kolom = vektor kata berdimensi K (mis.v(ball) = (0,40; 0,02)); matriksθ(D × K): baris = vektor dokumen (mis.v(D3) = (0,55; 0,45)). Cosine similaritysim(wi,wj) = vi·vj / (‖vi‖ ‖vj‖):sim(ball, player) ≈ 0,999,sim(ball, president) ≈ 0,10; dokumen:sim(D1,D3) ≈ 0,93,sim(D1,D2) ≈ 0,14.
GloVe (Global Vectors). Hybrid. Langkah 1: matriks co-occurrence simetris X_ij (window simetris, X_ij = X_ji; sebagian implementasi memakai bobot 1/d); pada contoh, X = R + L, mis. X[ball][player] = 3+1 = 4. Rasio co-occurrence membawa makna lebih kaya daripada probabilitas mentah (contoh ice vs steam: solid rasio besar, gas rasio kecil, water dan fashion ≈ 1). Langkah 2 (model): w_i · c_j + b_i + bc_j = log(X_ij); w_i vektor target, c_j vektor konteks, b_i, bc_j bias; dimulai dari nilai acak. Fungsi bobot: f(x) = (x/x_max)^α jika x < x_max, selain itu f(x) = 1 (umumnya x_max = 100, α = 0,75; contoh f(4) ≈ 0,089). Langkah 3 (loss): J = Σ_{i,j} f(X_ij) (w_i·c_j + b_i + bc_j − log X_ij)², diminimalkan dengan SGD atau AdaGrad (bukan closed-form seperti SVD). Tiap kata punya dua vektor (w dan c); satu epoch adalah satu putaran atas semua pasangan dengan X_ij > 0. Satu update manual: pasangan (ball, player), X=4: dot product plus bias = −0,005; target log 4 ≈ 1,386; error −1,391; bobot 0,089; gradient terhadap w(ball) ≈ (−0,0373; −0,0124); dengan learning rate 0,05, w(ball) baru ≈ (0,1019; −0,1994). Vektor final: v(word_i) = w_i + c_i (mis. ball (1,17; 0,27) dan player (1,17; 0,27), mirip karena co-occurrence kuat).
| Metode | Sumber statistik | Cara memperoleh vektor |
|---|---|---|
| LSI | Word–document (global) | Dibaca langsung dari SVD (closed-form) |
| HAL | Word–word dalam window (lokal) | Dibaca langsung dari matriks R/L (deterministik) |
| LDA | Word–document (global) | Inferensi probabilistik (Gibbs Sampling/variational) |
| GloVe | Word–word (global) | Optimisasi gradient (SGD/AdaGrad) atas loss numerik |
| Word2Vec | Word–word dalam window (lokal, via neural net) | Neural network, prediktif murni |
2.4 Transformer
Sumber: 5_Transformer_BERT (memakai 2.2 dan 2.3)
Motivasi: RNN/LSTM memproses kata satu per satu secara sekuensial; Transformer menghapus komputasi sekuensial sehingga training bisa diparalelkan.
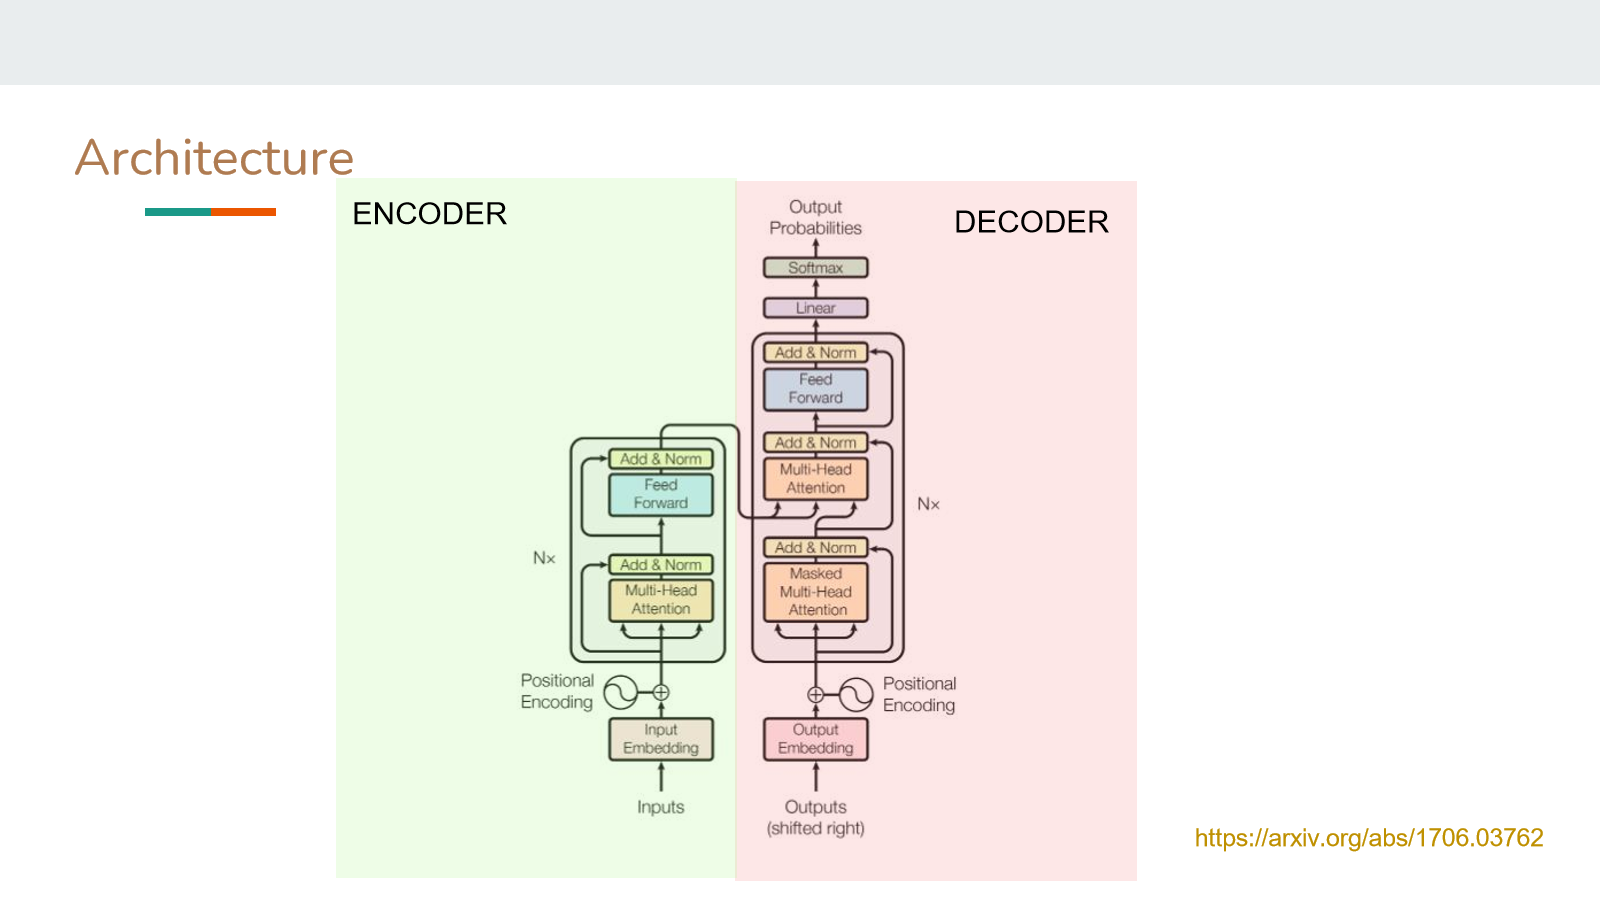
Arsitektur encoder-decoder. Encoder membaca seluruh kalimat sekaligus, ditumpuk N kali; blok: Multi-Head Attention → Add & Norm → Feed Forward → Add & Norm (residual di tiap sub-layer). Decoder menghasilkan output token demi token, juga N kali; blok memuat Masked Multi-Head Attention, ditambah satu Multi-Head Attention yang menghubungkan ke output encoder.
Tokenizer memecah teks menjadi token: BERT memakai WordPiece (sub-word, potongan lanjutan diawali ##, mis. capitalization → capital + ##ization); GPT-2 memakai BPE (Byte Pair Encoding) (menggabung pasangan karakter/byte yang paling sering muncul bersama); Flan-T5 memakai SentencePiece (language-independent, tidak bergantung spasi). Granularitas: word → subword → character → byte; subword adalah titik tengah (menangani out-of-vocabulary tanpa semahal karakter/byte).
Token → index → vector. Token dipetakan ke ID lewat vocabulary (mis. [PAD]=0, [UNK]=1, I=2, love=3, NLP=4, AI=5; ["I","love","NLP"] → [2,3,4]). ID hanya index baris, tanpa makna semantik. ID dipakai untuk lookup ke embedding matrix E (vocab × dimensi; contoh 6×4), yang nilainya dipelajari saat training; hasil lookup menjadi matriks X (3 token × 4 dimensi).
Positional encoding. Transformer tidak tahu urutan kata secara bawaan, jadi vektor posisi dijumlahkan (bukan dikonkatenasi) ke embedding kata: p_t^(i) = sin(ω_k t) untuk i = 2k dan cos(ω_k t) untuk i = 2k+1, dengan ω_k = 1/10000^{2k/d}.
Self-attention. Tiap embedding dikali tiga matriks bobot terlatih W^Q, W^K, W^V menjadi Query, Key, Value: Attention(Q,K,V) = softmax(QK^T/√d_k) V (d_k dimensi key, penskalaan agar dot product tidak terlalu besar). Alur komputasi (scaled dot-product): Q,K → MatMul → Scale → Mask (opsional) → SoftMax → MatMul dengan V. Contoh “Thinking Machines”: score q1·k1 = 112 dan q1·k2 = 96; dibagi √d_k = 8 jadi 14 dan 12; softmax 0,88 dan 0,12; z1 = 0,88 v1 + 0,12 v2 (rata-rata berbobot semua value). Contoh ["I","love","NLP"]: attention weight query “I” terhadap (I, love, NLP) = 22,9%, 32,1%, 45,1%; “love” = 21,3%, 31,7%, 47,0%; “NLP” = 19,8%, 31,2%, 49,0%; z(I) = 0,229 v(I) + 0,321 v(love) + 0,451 v(NLP), yaitu z1 ≈ 1,352 dan z2 ≈ 1,444; untuk love (1,348; 1,452) dan NLP (1,345; 1,458). Intuisi: pada “The animal didn’t cross the street because it was too tired”, kata “it” mendapat bobot besar ke “The animal”.
Multi-head attention: self-attention dihitung beberapa kali paralel (mis. 8 head), tiap head punya W^Q, W^K, W^V sendiri: (1) embed, (2) split ke head, (3) attention per head menghasilkan Z_0..Z_7, (4) konkatenasi lalu kalikan W^O. Alasan: tiap head bisa fokus pada relasi berbeda (multi-head: Linear → Scaled Dot-Product Attention ×h → Concat → Linear). Pada encoder, setelah attention ada Add & Normalize LayerNorm(X + Z) lalu feed forward per posisi lalu Add & Normalize lagi.
Decoder. Masked self-attention: e_ij = q_i·k_j untuk j < i, dan −∞ untuk j ≥ i supaya tidak “mengintip” masa depan (setelah softmax menjadi 0, tetapi tetap bisa diparalelkan dalam satu operasi matriks). Cross-attention (encoder-decoder): Key dan Value dari encoder (output h_1..h_n, berperan seperti memori), Query dari decoder (z_1..z_n); k_i = K h_i, v_i = V h_i, q_i = Q z_i. (Anotasi slide “K, Q from encoder; V from decoder” dianggap salah cetak.) Decoding berjalan autoregresif per time step: input decoder = output langkah sebelumnya, ditambah K_encdec dan V_encdec dari encoder (encoder hanya dijalankan sekali). Output akhir: Linear (ke ukuran vocabulary, menghasilkan logits) → Softmax → argmax → kata.
Self-attention vs RNN/CNN (n = panjang sequence, d = dimensi, k = ukuran kernel, r = neighborhood):
| Layer | Complexity per layer | Sequential operations | Maximum path length |
|---|---|---|---|
| Self-Attention | O(n²·d) | O(1) | O(1) |
| Recurrent | O(n·d²) | O(n) | O(n) |
| Convolutional | O(k·n·d²) | O(1) | O(log_k n) |
| Self-Attention (restricted) | O(r·n·d) | O(1) | O(n/r) |
Self-attention paralel penuh dan dependensi jarak jauh mudah, dengan harga kompleksitas kuadratik terhadap n. Machine translation (newstest2014): Transformer base 27,3 BLEU EN-DE dengan 3,3×10^18 FLOPs; Transformer big 28,4 (EN-DE) dan 41,8 (EN-FR), mengalahkan GNMT+RL, ConvS2S, dan MoE dengan biaya training jauh lebih rendah (model lain 10^19 sampai 10^21 FLOPs).
2.5 BERT
Sumber: 5_Transformer_BERT (memakai 2.4)
BERT (Bidirectional Encoder Representations from Transformers) hanya memakai bagian encoder, untuk NLU (sequence classification, QA, NLI). Contoh sentiment analysis: teks → BERT → classifier (fully-connected + softmax) → positive 0,87, negative 0,13.
Pre-training (tanpa label manual):
- Masked Language Model (MLM): 15% token di-mask (
[MASK]); output BERT di posisi itu → FFNN + Softmax atas seluruh kosakata untuk memprediksi kata asli. Karena melihat konteks kiri dan kanan, representasinya bidirectional. - Next Sentence Prediction (NSP): pasangan kalimat A dan B (
[CLS] A [SEP] B [SEP]), prediksiIsNextatauNotNextdari output posisi[CLS].
Input embedding BERT = jumlah tiga embedding: token embedding (WordPiece), segment embedding (E_A atau E_B, kalimat A atau B), position embedding (dipelajari, bukan sin-cos tetap).
Fine-tuning: tambahkan classifier lalu latih ulang seluruh model; prediksi dari hidden state [CLS]. Tugas: sentence pair classification (MNLI, QQP, QNLI, STS-B, MRPC, RTE, SWAG), single sentence classification (SST-2, CoLA), QA (SQuAD v1.1, output start/end span), tagging (CoNLL-2003 NER). Contoh: AutoModelForSequenceClassification.from_pretrained("bert-base-uncased", num_labels=3). Feature extraction (alternatif): BERT dibekukan, ambil contextualized embedding dari satu atau beberapa layer (konkatenasi atau rata-rata dari 12 layer), lalu pakai sebagai fitur untuk algoritma ML terpisah (bukan model yang di-fine-tune).
Hasil.
| System | Rata-rata GLUE |
|---|---|
| BiLSTM+ELMo+Attn | 71,0 |
| Pre-OpenAI SOTA | 74,0 |
| OpenAI GPT | 75,1 |
| BERT-Base | 79,6 |
| BERT-Large | 82,1 |
GLUE per task (BERT-Large): MNLI 86,7/85,9, QQP 72,1, QNLI 92,7, SST-2 94,9, CoLA 60,5, STS-B 86,5, MRPC 89,3, RTE 70,1. SQuAD 2.0: BERT-Large single test F1 83,1 (dev EM 78,7 dan F1 81,9; test EM 80,0), mendekati manusia (test F1 89,5) dan di atas MIR-MRC F-Net (78,0) serta nlnet (77,1).
Detail training: data Wikipedia (2,5 miliar kata) + BookCorpus (800 juta kata); batch 131.072 kata (1024 sequence × 128 atau 256 sequence × 512); 1 juta step (~40 epoch); AdamW, learning rate 1e-4, linear decay. BERT-Base: 12 layer, hidden 768, 12 head, ~110 juta parameter. BERT-Large: 24 layer, hidden 1024, 16 head, ~340 juta parameter. Pretraining mahal (64 TPU chip, 4 hari), fine-tuning praktis di satu GPU: “pretrain once, finetune many times”.
Varian: RoBERTa (training lebih lama dengan data lebih besar, tanpa NSP); ALBERT (parameter sharing antar hidden layer dan factorized embedding); SpanBERT (mask span kontigu); DistilBERT (distillation, model “murid” meniru model “guru”).
Studi kasus Lab Work 4 (1_Lab_Work_4): BERT, RoBERTa, XLM-R di-fine-tune untuk sentimen 3-kelas atas tweet politik; tokenizer WordPiece (bert-base-uncased), Byte-level BPE (roberta-base), SentencePiece/Unigram (xlm-roberta-base); fine-tuning penuh (bukan feature extraction) dari representasi [CLS]; class-weighted loss karena kelas timpang (23% negative, 34% neutral, 43% positive); dynamic padding.
2.6 Decoder, Prompting, dan Fine-tuning
Sumber: 6_Decoder_Prompting_PEFT (memakai 2.4 dan 2.5)
Recap self-attention formal (CS224n): x_i = E w_i; q_i = Q x_i, k_i = K x_i, v_i = V x_i; e_ij = q_i^T k_j; α_ij = exp(e_ij) / Σ exp(e_ij'); o_i = Σ_j α_ij v_j. Masked self-attention dan cross-attention sama seperti 2.4.
Mengapa LLM: model AI tradisional satu model untuk satu task, sedangkan LLM satu model untuk berbagai task lewat prompting.
Prompting. Base model bukan assistant: hasil pretraining murni hanya melanjutkan dokumen internet, sering menjawab pertanyaan dengan pertanyaan lain; bisa “ditipu” lewat prompt engineering (mis. “Here is a poem about bread and cheese:”). Empat elemen prompt: Instruction (task), Context (informasi tambahan), Input Data (pertanyaan/input), Output Indicator (format output). Contoh QA berbasis konteks (OKT3): jawaban “Mice.”
Contoh task lewat prompt: summarization (“Explain the above in one sentence”), code generation (komentar natural jadi kode; skema tabel jadi query SQL), sentiment analysis zero-shot (berita deflasi Indonesia → negative dengan alasan per frasa), aspect-based sentiment analysis (aspect term, sentimen, kategori dari daftar kategori).
Zero-shot vs few-shot. Zero-shot: instruksi tanpa contoh berlabel. Few-shot: disisipi beberapa contoh berlabel sebelum data target (disebut in-context learning, karena tidak ada gradient update; Brown dkk., 2020: spesifikasikan task dengan menempelkan contoh di depan, mis. gaot => goat dan terjemahan Inggris-Prancis).
Chain-of-Thought (CoT) (Kojima dkk., 2022), empat variasi: (a) few-shot tanpa langkah penalaran (jawaban salah, “8” bukan “4”); (b) few-shot-CoT (contoh menyertakan langkah penalaran, jawaban benar); (c) zero-shot (salah); (d) zero-shot-CoT (cukup menambah “Let’s think step by step”, jawaban benar tanpa contoh). Auto-CoT: (1) question clustering (partisi pertanyaan ke cluster), (2) demonstration sampling (pilih satu pertanyaan representatif per cluster, bangkitkan penalaran dengan Zero-Shot-CoT memakai heuristik, mis. panjang pertanyaan ~60 token dan ~5 langkah). Self-Consistency: sample beberapa rantai penalaran, ambil jawaban paling sering (contoh umur adik: dua output “67”, satu “35”, maka 67). Generate Knowledge Prompting: (1) knowledge generation (model membangkitkan beberapa pernyataan pengetahuan lewat prompt demonstrasi), (2) knowledge integration (digabung untuk menjawab; contoh golf: skor terendah menang, jawaban “No”).
Downside prompt-based learning: (1) inefisien (prompt diproses ulang tiap prediksi); (2) performa umumnya lebih buruk dari fine-tuning (Brown dkk., 2020); (3) sensitif terhadap wording (Webson dan Pavlick, 2022) dan urutan contoh (Zhao dkk., 2021; Lu dkk., 2022); (4) tidak jelas apa yang dipelajari, bahkan label acak tetap bekerja (Min dkk., 2022). Risiko keamanan (Shaikh dkk., 2023): zero-shot CoT pada prompt berbahaya menurunkan refusal rate (78% menjadi 25% pada satu contoh).
Fine-tuning. Base model → fine-tuned model: teks tanpa label → pretraining → base model (pretrained LLM); teks berlabel → fine-tuning → fine-tuned model. Paradigma pretraining/finetuning: pretraining berfungsi sebagai inisialisasi parameter. Step 1 pretrain (language modeling, banyak teks, belajar hal umum tentang bahasa); step 2 finetune pada task (tidak butuh banyak label). Scaling up finetuning: finetune pada banyak task sekaligus. Instruction finetuning (FLAN-T5, Chung dkk., 2022): kumpulkan banyak pasangan (instruction, output) lintas task, finetune satu LM, lalu evaluasi pada unseen tasks; inilah yang membuat model bisa mengikuti instruksi umum (“menjadi assistant”).
2.7 Parameter-Efficient Fine-Tuning (PEFT)
Sumber: 6_Decoder_Prompting_PEFT (memakai 2.6)
Mengapa PEFT: full fine-tuning (update semua parameter) tidak praktis untuk model besar, dan model SOTA over-parameterized sehingga PEFT bisa menyamai performanya. Definisi: menyesuaikan model pretrained ke task/domain spesifik dengan meminimalkan parameter tambahan dan resource komputasi, dengan menyesuaikan sebagian kecil parameter dan membiarkan sisanya beku (frozen).
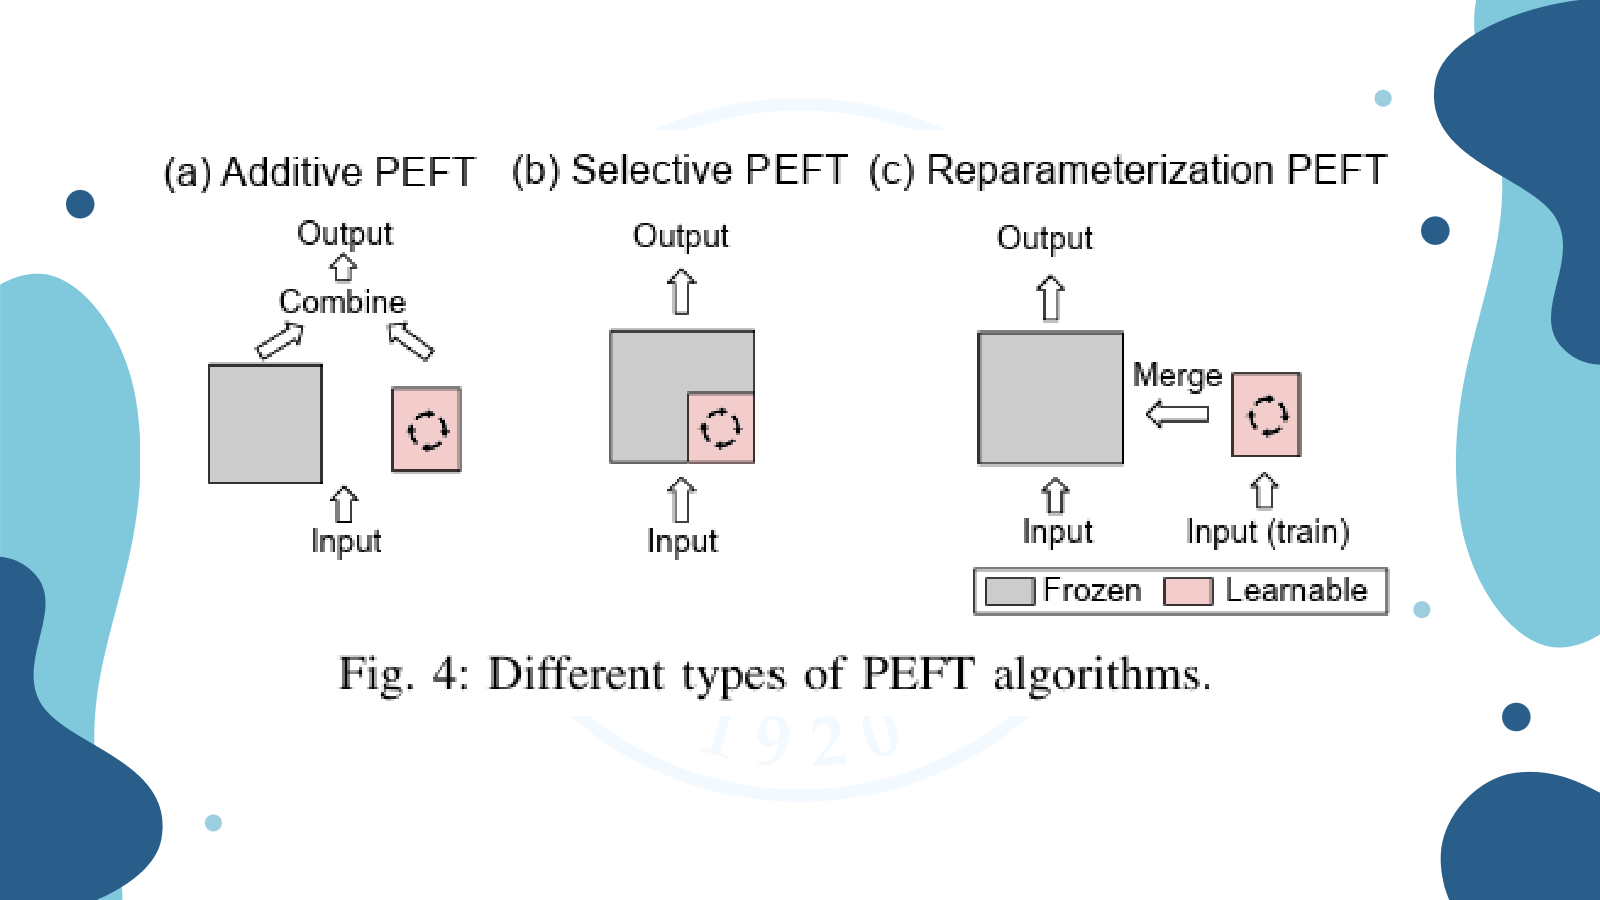
| Kategori | Prinsip | Contoh |
|---|---|---|
| Additive | Menambah komponen baru ke model beku lalu menggabungkan outputnya | Adapter, soft prompt (prefix-tuning), (IA)³, SSF |
| Selective | Memilih subset parameter yang sudah ada untuk di-update, tanpa parameter baru | BitFit (hanya bias), masking tidak terstruktur/terstruktur |
| Reparameterized | Struktur low-rank dilatih terpisah lalu di-merge ke bobot asli (tanpa tambahan latensi inference) | LoRA, DyLoRA, DoRA |
| Hybrid | Gabungan beberapa pendekatan | UniPELT, MAM Adapter |
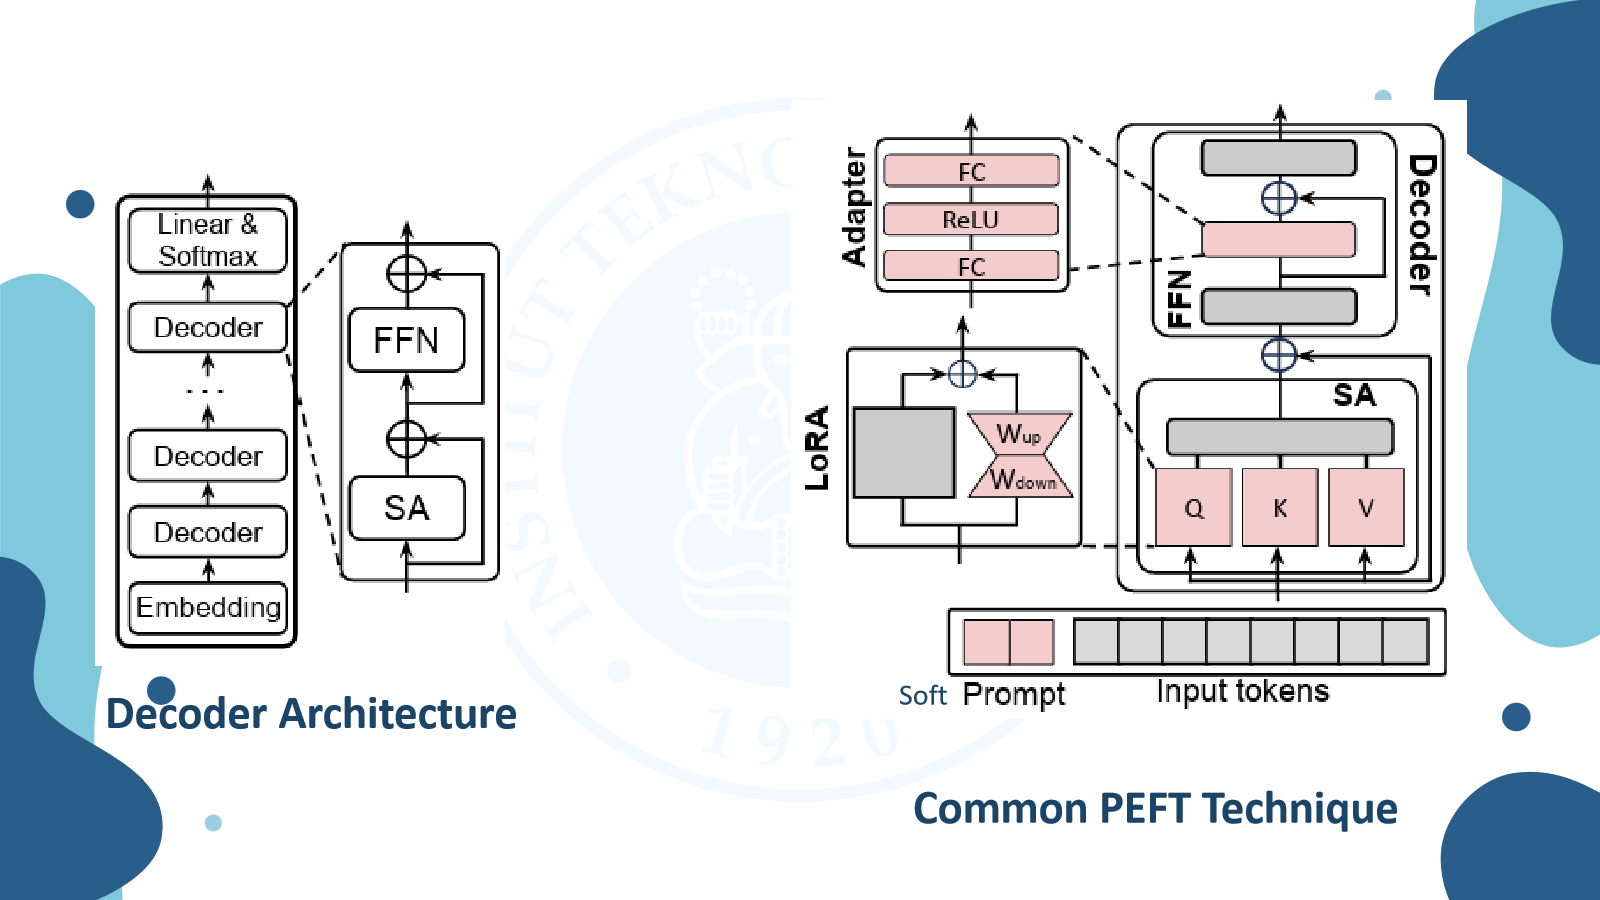
Letak di blok decoder: LoRA paralel pada proyeksi Q (dan biasanya K/V) di self-attention; Adapter setelah sub-layer FFN; Soft Prompt berupa token learnable di depan input.
- Adapter:
Adapter(x) = W_up σ(W_down x) + x(turunkan dimensi → aktivasi → naikkan dimensi → residual). Varian: Serial (berurutan setelah sub-layer), Parallel (paralel dengan sub-layer), CoDA (hanya memproses top-k token). Multi-task: AdapterFusion (semua adapter dengan modul fusion), MerA (menggabung adapter jadi satu lewat optimal transport), Hyperformer (hypernetwork bersama membangkitkan adapter per task dan layer; task baru cukup mempelajari task embedding). - Soft prompt / prefix-tuning: vektor learnable di-prepend ke key dan value di semua layer;
X^(l) = [s_1^(l), …, s_{N_S}^(l), x_1^(l), …, x_{N_X}^(l)]. Memakai reparameterization (MLP membangkitkan prefix agar optimasi stabil); setelah selesai hanya prefix yang disimpan, sehingga satu set prefix kecil per task (bukan satu salinan model penuh per task). - (IA)³: tiga vektor rescaling
l_k, l_v, l_ffuntuk key, value, dan aktivasi FFN:SA(x) = Softmax(Q(l_k ⊙ K^T)/√d_head)(l_v ⊙ V);FFN(x) = W_up(l_ff ⊙ σ(W_down x)). SSF: layer SSF-ADA setelah tiap operasi (MSA, FFN, layer normalization) melakukan scaling dan shifting; hanya SSF-ADA yang di-update dan saat inference bisa di-merge ke bobot (tanpa overhead). - Selective: binary mask
M = {m_1..m_n},θ_i' = θ_i − η · m_i · ∂L/∂θ_i;m_i=1parameter dilatih,m_i=0beku. Unstructural masking (acak tersebar) vs structural masking (mengikuti struktur, mis. BitFit hanya melatih bias). - LoRA:
W_0 ∈ R^{d×k}dibekukan; ditambahW_up ∈ R^{d×r}danW_down ∈ R^{r×k}denganr ≪ min(d,k)yang dilatih; hasil kali ditambahkan ke outputW_0dan bisa digabung kembali setelah training. DyLoRA: melatih pada rentang rank (rhinggar_max) sekaligus. DoRA: dekomposisi bobot jadi magnitudemdan directionV,W_0 = m · V/‖V‖_c; hanya direction yang di-update lewat LoRA. - Efficient PEFT design: pruning (AdapterDrop, LoRAPruning), quantization (QLoRA: LoRA di atas model dasar 4-bit), memory-efficient (Side-Tuning, LST, GaLore).
2.8 Sentence Comparison
Sumber: 7_Sentence_Comparison (memakai 2.3 dan 2.5)
Lexical-based: kalimat jadi vektor sparse (bag-of-words), dibandingkan dengan cosine similarity; contoh “Institut Teknologi Bandung” vs “Bandung Institute of Technology”: cos = 1/(2√3) = 0,1667. Mengukur jarak leksikal; cocok untuk information retrieval dan clustering; skor cosine lebih tinggi berarti lebih mirip. Sentence embedding (semantik): vektor dense hasil sentence embedding; cosine mengukur jarak makna (contoh yang sama naik ke 0,667).
Sentence embedding dari encoder PLM (tiga cara): (1) hidden state [CLS] sebelum dikali bobot klasifikasi (mis. O_CLS = [2,4043; 1,8935; 1,7433; 1,5045]); (2) rata-rata semua hidden state termasuk [CLS] dan [SEP]; (3) rata-rata hidden state token hasil tokenisasi saja.
Fine-tuning khusus perbandingan kalimat: BERT dasar hanya MLM dan NSP.
- NLI: (kalimat 1, kalimat 2, kelas): entail (kalimat 2 konsekuensi logis kalimat 1), contradict, neutral.
- STS (STS-Benchmark): (kalimat 1, kalimat 2, skor 0-5), mis. “A man is playing a large flute” vs “A man is playing a flute” = 5,0; vs “A man is spreading shredded cheese on a pizza” = 0,0.
- SBERT: di-fine-tune dua kali berurutan, NLI lalu STS.
Variasi SBERT:
- SimCSE unsupervised: dua kali forward pass per kalimat; karena dropout acak, dua vektor sedikit berbeda, disebut anchor dan positive. Untuk n kalimat didapat n×2 vektor; hitung matriks kemiripan anchor dengan semua positive, bagi dengan temperatur, softmax, loss, update bobot. Supervised: dataset NLI, plus kalimat contradiction sebagai vektor negatif.
- E5: (1) contrastive pre-training dengan pasangan positif dari data weakly supervised (judul Wikipedia + paragraf pertama, judul Reddit + komentar teratas, query + dokumen yang diklik); prefix
"query:"atau"passage:";L = −log [ e^{cos(u,v+)/τ} / Σ_i e^{cos(u,v_i)/τ} ]. (2) Supervised fine-tuning (NLI, retrieval, QA) dengan hard negative (mis. query “Apa ibu kota Prancis?”, positive “Paris adalah ibu kota Prancis”, hard negative “Lyon adalah kota terbesar kedua di Prancis”). - BGE-M3: multilingual (>100 bahasa). Multi-Linguality (termasuk cross-lingual), Multi-Functionality (dense:
u_dense = pooling(h_1..h_n); sparse:Σ_{t∈Q∩D} w_t^Q w_t^D; multi-vector:Σ_{q_i∈Q} max_{d_j∈D} cos(q_i,d_j)), Multi-Granularity (kalimat sampai dokumen 8192 token). Kontribusi: data curation, hybrid retrieval (s_rank = w1·s_dense + w2·s_lex + w3·s_mul), self-knowledge distillation, efficient batching.
Klasifikasi dua kalimat: Paraphrase Identification (duplicate/not duplicate); NLI; QNLI dan RTE (entailment vs not entailment); Fact Verification (supports/refutes/not enough info); Stance Detection (agree/disagree/discuss/unrelated, mis. headline “Vaccines cause autism” vs artikel yang menyangkal = disagree).
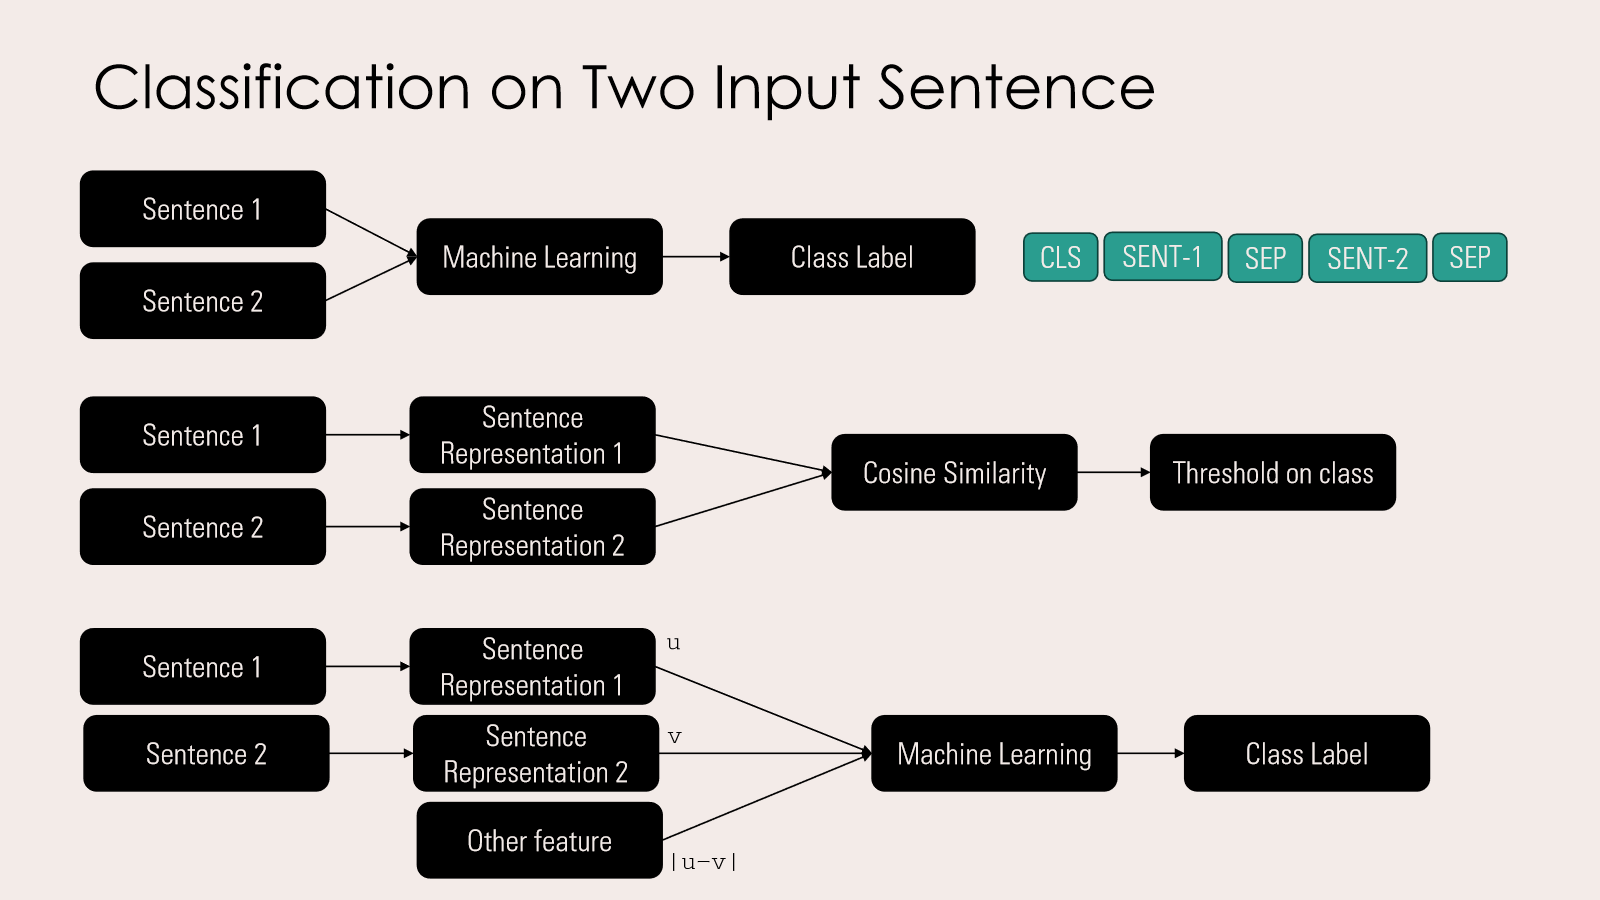
Tiga arsitektur:
| Arsitektur | Cara kerja | Kelebihan dan kekurangan |
|---|---|---|
| Cross-Encoder | Dua kalimat jadi satu input ([CLS] SENT-1 [SEP] SENT-2 [SEP]), langsung diklasifikasi | Paling akurat (attention saling melihat sejak awal) tetapi mahal: N forward pass penuh untuk 1 kalimat vs N kalimat; tidak bisa di-precompute |
| Bi-Encoder + Cosine Similarity | Tiap kalimat di-encode terpisah (bisa di-cache), dibandingkan dengan cosine, lalu threshold | Efisien untuk skala besar (gaya SBERT) |
| Bi-Encoder + Classifier | u dan v plus fitur |u−v| (selisih absolut elemen-wise) dimasukkan ke model ML | Fitur gabungan lebih kaya daripada cosine |
Perbedaan “Machine Learning” pada tiap arsitektur: pada Cross-Encoder input adalah token mentah (sequence), jadi hanya model neural sequence (transformer) yang bisa memprosesnya; classical ML (SVM, decision tree, dst.) tidak bisa. Pada Bi-Encoder + Classifier input sudah vektor berukuran tetap (u, v, |u−v|), jadi classical ML apa pun bisa dipakai; decision tree butuh vektor fitur sama seperti SVM.
Zero-shot classification dengan NLI (XLM-RoBERTa-Large-XNLI): model encoder multilingual (>100 bahasa) di-fine-tune pada XNLI (15 bahasa). Caranya: kalimat input jadi premise, tiap kandidat label jadi hypothesis "this text is {class}", jalankan NLI per pasangan, ambil kandidat dengan P(entailment) tertinggi. Contoh “I just adopted a puppy and I’m so excited!” → “this text is pets” P(entailment)=0,94, sehingga kelas pets.
3. Sengaja Tidak Dicakup (Rinci di Note Sumber)
| Yang dilewati | Ada di |
|---|---|
| Kode scikit-learn lengkap (Naive Bayes) dan kode Hugging Face lainnya | 2_Klasifikasi_Teks |
Perhitungan SVD lengkap (eigenvector U), contoh numerik LDA lengkap (matriks dan cosine tiap pasangan), dan seluruh langkah satu update GloVe | 2_Klasifikasi_Teks, 3_Word_Representation |
| Tabel hasil lengkap SQuAD 2.0 dan machine translation (tiap model) | 5_Transformer_BERT |
| Taksonomi PEFT lengkap dengan seluruh nama metode, dan seluruh contoh prompt (CoT, Auto-CoT, Generate Knowledge, ABSA) | 6_Decoder_Prompting_PEFT |
| Glossary istilah di akhir note Sentence Comparison (tetap di note sumber) | 7_Sentence_Comparison |
| Flashcard asli tiap note (tetap di note sumber supaya kartu plugin tidak dobel) | masing-masing note |
| Soal exercise hitung manual Transformer encoder (dicatat sebagai tugas, tidak dikerjakan) | 3_Exercise_Transformer_Encoder |
4. Peta Pembahasan
| Note sumber | Topik | Bagian di file ini |
|---|---|---|
| 1 | Kuliah, CL vs NLP, definisi, kategori task, benchmark, sejarah | 2.1 |
| 2 | Spam filtering, preprocessing, tokenizer, fitur, TF-IDF, MI, Naive Bayes, CNN, RNN | 2.2 |
| 2 dan 3 | Taksonomi word representation, SVD/LSI, Word2Vec, HAL, LDA, GloVe | 2.3 |
| 5 | Transformer, tokenizer, positional encoding, self/multi-head attention, decoder, kompleksitas, MT | 2.4 |
| 5 | BERT, MLM, NSP, input embedding, fine-tuning, hasil, varian, Lab Work 4 | 2.5 |
| 6 | Cross-attention, LLM, prompting, CoT, fine-tuning, instruction finetuning | 2.6 |
| 6 | PEFT: additive, selective, reparameterized, efficient design | 2.7 |
| 7 | Lexical dan semantic comparison, SBERT, SimCSE, E5, BGE-M3, cross vs bi-encoder, zero-shot NLI | 2.8 |